

部署大语言模型只是实现生产就绪型服务的第一步。制作团队还需要在可用的 GPU 基础架构上为尽可能多的并发用户提供服务,同时保持保持应用响应速度的交互性。
这种权衡对于代理式 AI 工作负载更为重要,因为在这些工作负载中,提示可能很长,上下文可以跨步骤重复使用,而且应用程序通常会将扩展响应流式传输回用户。
NVIDIA NIM 将模型和 GPU 感知的服务选择打包到可部署的微服务中。开发者无需从空白运行时配置开始,而是获得经过验证的服务配置和受支持的部署路径,同时保留根据自己的流量对 NIM 进行基准测试的能力。
NIM 的新增功能:性能工程和生产就绪
推理性能属于系统属性。精度与内核、并行、调度、批处理、内存分配、前缀重用、模型特定状态缓存和解码策略都会相互作用。只有在提高吞吐量的同时保持在应用程序延迟目标范围内的配置才有用。
NIM 将这种优化工作转变为一个经过测试的起点。NVIDIA 工程师会验证所支持的模型、GPU 和精度组合的配置,然后将运行时和模型构件封装到标准 API 中。对于生产部署,NIM 认证通过 NVIDIA AI Enterprise 增加了定期推理堆栈更新、CVE 处理、更广泛的硬件验证和商业支持。
NIM 在一个部署路径中提供两个优势:经验证的性能工程以及企业就绪的容器生命周期和支持模型。
案例研究:Nemotron 3 Ultra NIM 可将代理式工作负载的吞吐量提升高达 2.5 倍
本文中使用的基准测试定义为:
- 硬件:4xB200
- 代理工作负载:64K/ 400/ 76+ KV 复用/ 50 TPS/ 用户 ( 20 毫秒 ITL)
此 Parito 图表将开源基准服务堆栈 (NIM Off) 与完全优化的 NIM 2.0.12 服务堆栈 (NIM On) 进行了比较。
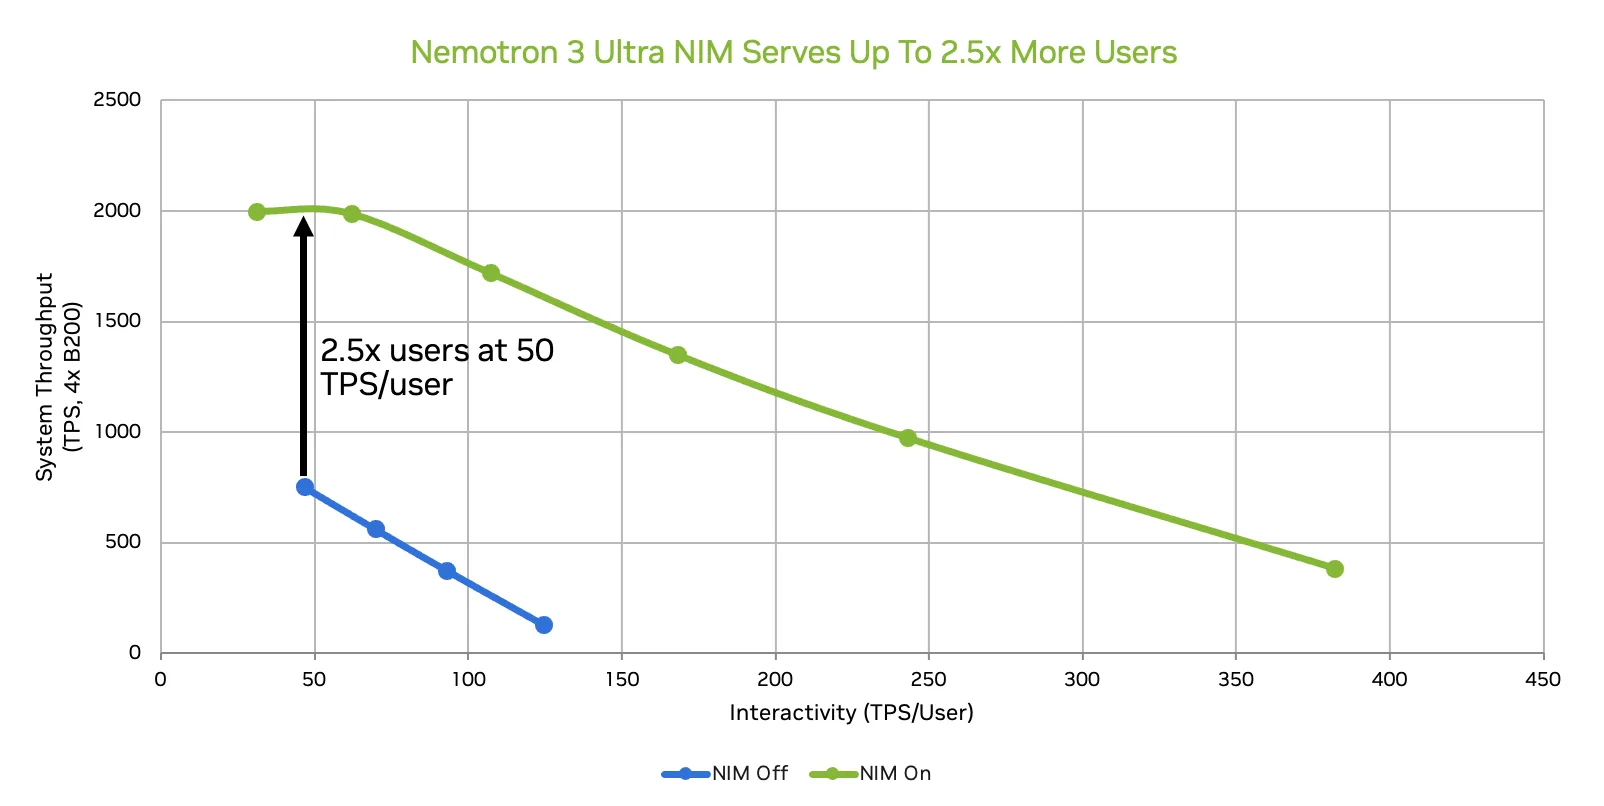
| 配置 | 原生最大 256K 上下文 | 它代表什么 |
|---|---|---|
| NIM 关闭基准 | 718 托克/ 秒 | 无 NIM 优化 |
| NIM 开启 (2.0.12) 优化的服务堆栈 | 1997 tok/s 2.5 倍与基准测试 | 优化的 NIM 堆栈:缓存/ 状态重用、MTP 预测解码和相关修复、自动调整内核、部分前缀匹配、调度程序、批处理、内存和并行调优 |
NIM 2.0.12 优化的服务堆栈工作原理
测量的收益来自交互的配置包,而不是独立的交换机,后者的百分比可以简单地增加。主要优化层包括:
- 精度和自动调整的模型感知内核。自动调整的混合专家模型和 Mamba 内核可将混合架构高效映射到 NVIDIA Blackwell GPU。
- 并行执行。张量并行将模型分布在四个 GPU 上,而专家感知执行可提高混合专家层的利用率。
- 前缀和模型状态重用。前缀缓存可避免重新计算重复上下文,当只有部分前缀匹配时,部分前缀匹配可恢复重用,并且针对模型架构调整了 Mamba 状态缓存设置。
- 调度程序、批处理和内存调优。 并发序列限制、批量标记限制、块大小和 GPU 显存分配可在运行中完成更多工作,且不会超出延迟目标。
- MTP 预测解码。 NIM 2.0.12 优化的服务堆栈 (包括 MTP) 将 MTP 及其相关修复添加到相同的优化服务堆栈中。提升性能取决于接受率和可用内存空间。
根据您自己的工作负载对 NIM 进行基准测试
发布的曲线只是一个起点,并不是每个应用程序都能看到相同结果的承诺。确定适合度的最快方法是回放具有代表性的流量,并为对用户至关重要的延迟指标构建 Pareto 曲线。
- 部署确切的软件版本。使用NIM 2.0.12 (或更新版本) ,并为每次运行固定图像标签或摘要。
- 准备代表性流量。使用月饼格式的 JSONL 追踪或捕获受控 NIM 请求,并对敏感数据进行适当的访问控制和清理。
- 衡量性能。使用 NVIDIA AIPerf 回放具有代表性的流量并获得性能基准测试
- 选择与 SLO 相会的 Pareto 点。在满足 SLO/ 延迟限制的点之间比较输出吞吐量,并确定是否适合部署:
for C in 1 4 8 16 32 64; do
   aiperf profile \
 	--model nvidia/nemotron-3-ultra-550b-a55b \
 	--endpoint-type chat --streaming \
 	--url localhost:8000 \
 	--input-file ./agentic-trace.jsonl \
 	--custom-dataset-type mooncake_trace \
 	--no-fixed-schedule \
 	--concurrency "$C"
 done
AIPerf 并发扫描示例。将追踪、请求计数和端点详细信息替换为您要建模的工作负载。
下载并运行 Nemotron 3 Ultra NIM
从 Nemotron 3 Ultra NIM 页面 开始,接受管理条款,然后选择 NIM 2.0.12 标签或确切发布的摘要。下载后,找到并选择一个配置文件。以下列出了 NIM 中打包的所有配置文件:
 export NGC_API_KEY=<your-personal-api-key>
 export LOCAL_NIM_CACHE=$HOME/.cache/nim
 export NIM_TAG=2.0.12
 mkdir -p "$LOCAL_NIM_CACHE"
 echo "$NGC_API_KEY" | docker login nvcr.io \
   --username '$oauthtoken' --password-stdin
 docker run --gpus all --shm-size=16GB \
   -e NGC_API_KEY \
   -e NIM_MODEL_PROFILE \
   -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
   -p 8000:8000 \
   nvcr.io/nim/nvidia/nemotron-3-ultra-550b-a55b:$NIM_TAG list-model-profiles
要为 4 – GPU B200 系统上的代理式工作负载选择优化配置文件,您可以将 NIM_MODEL_PROFILE 设置为 vllm-nvidia-b200-nvfp4-tp4-pp1-throughput-90.0 并启用预测解码:
 export NGC_API_KEY=<your-personal-api-key>
 export LOCAL_NIM_CACHE=$HOME/.cache/nim
 export NIM_TAG=2.0.12
 export NIM_MODEL_PROFILE=vllm-nvidia-b200-nvfp4-tp4-pp1-throughput-90.0
 mkdir -p "$LOCAL_NIM_CACHE"
 echo "$NGC_API_KEY" | docker login nvcr.io \
   --username '$oauthtoken' --password-stdin
 docker run --gpus all --shm-size=16GB \
   -e NGC_API_KEY \
   -e NIM_MODEL_PROFILE \
   -e NIM_SPECDEC_ENABLE=1 \
   -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
   -p 8000:8000 \
   nvcr.io/nim/nvidia/nemotron-3-ultra-550b-a55b:$NIM_TAG
注重性能的生产起点
NVIDIA NIM 将模型和 GPU 感知型优化服务打包到可部署的微服务中。对于 4xB200 系统上的 Nemotron 3 Ultra,这些优化使组织能够以 50 TPS/ 用户的速度为多达 2.5 倍的用户提供服务,而非 NIM 基准,同时保持部署路径对于真正的多用户服务是切实可行的。
NIM 通过 NVIDIA AI Enterprise 将经过验证的性能工程与定期推理堆栈更新、CVE 处理、硬件验证和商业支持相结合。在更广泛的模型中规划性能更优化的 NIM 配置,为开发者提供更多经过验证的起点,以实现自己的延迟、吞吐量和成本目标。
开始使用
从 NGC 下载 Nemotron 3 Ultra NIM 2.0.12,在您的 NVIDIA GPU 基础架构上运行,然后使用 NVIDIA AIPerf 回放具有代表性的流量,以选择符合您应用程序目标的 Pareto 点。
资源


