

为了高效应对 AI 工作负载,数据中心正在被重构。这是一项非常复杂的工作,因此,NVIDIA 目前正在交付以 NVIDIA 机架级架构为单位的 AI 工厂。为了让 AI 工厂发挥最佳性能,许多加速器需要以更大的带宽和更低的延迟在机架规模上协同工作,并以最节能的方式支持尽可能多的用户。
设计满足这些需求的机架会面临许多技术挑战。这需要高密度的加速器、网卡(NICs)、交换机以及纵向扩展和横向扩展网络,所有这些都紧密相关。这种高密配置对于提供当今 AI 所需的高级计算能力和背板带宽至关重要。
传统的风冷方法通常不足以满足此类高密部署的需求,因此需要高密度液冷机架,例如 NVIDIA NVLink 高速纵向扩展互连技术。图 1 说明了 NVLink 和更大的纵向扩展域如何提供最佳性能。NVIDIA 机架式扩展解决方案提供了一条经过验证的可扩展路径,通向更快速、更高效的基础设施。
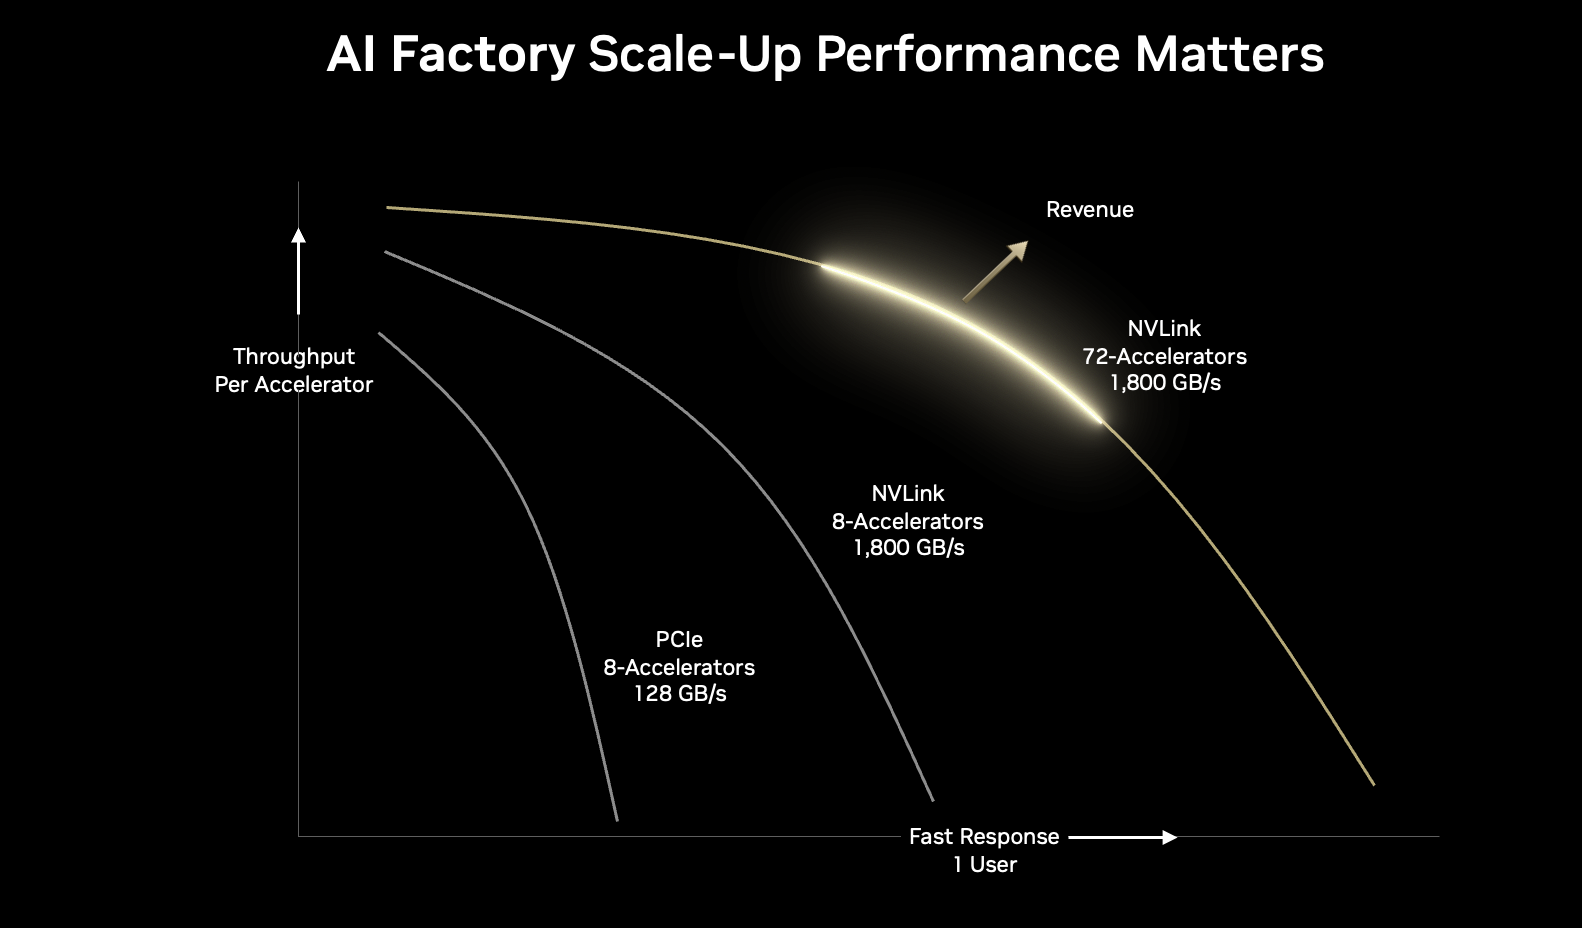
图 1. 性能随着 NVIDIA NVLink 域的扩大而提升
NVIDIA AI 工厂生态系统
NVIDIA 为 AI 工厂建立了成熟的生态系统。其中包括先进 GPU 技术和用于纵向扩展计算网的 NVIDIA NVLink。NVIDIA NVLink Switch 芯片可在 72 个 GPU的 NVLink 域中实现 130 TB/s 的 GPU 带宽。NVIDIA Quantum-X800 InfiniBand、NVIDIA Spectrum-X Ethernet 和 NVIDIA Bluefield-3 DPU 支持扩展到数十万个 GPU。
此外,与领先的传统 CPU 相比,NVIDIA Grace 等高性能 CPU 可提供高达 2 倍的能效,并在低功耗的情况下提供惊人的带宽。这种机架级架构在广大的 OEM 和 ODM 合作伙伴网络的支持下,已经部署到各大云提供商,奠定了现代 AI 工厂的基础。
面向半定制 AI 基础架构的 NVIDIA NVLink Fusion
新推出的 NVIDIA NVLink Fusion 是一种面向芯片的技术,可让超大规模企业利用 NVIDIA NVLink 生态系统构建半定制 AI 基础设施。
NVLink Fusion 使用户能够半定制 ASIC 或 CPU,从而 实现出色的性能扩展。那些超大规模企业可以直接用到 NVLink、 NVIDIA NVLink-C2C 、 NVIDIA Grace CPU 、NVIDIA GPU、 NVIDIA CPO 网络、机架扩展架构和 NVIDIA Mission Control 软件的创新成果。
由于超大规模企业已经在部署完整的 NVIDIA 机架级解决方案,这使他们能够在 AI 工厂中提供异构芯片产品,同时在单一可扩展的硬件基础设施上实现标准化。凭借 NVIDIA 丰富的基础设施合作伙伴生态系统,NVLink Fusion 使用者可轻松进行大规模部署和管理。
NVIDIA NVLink 纵向扩展互连
NVLink Fusion 的核心是突破性互连技术 NVLink。为了充分发挥大规模 AI 模型的潜力,机架内每个 GPU 之间的无缝通信至关重要。第 5 代 NVLink 可为每个 GPU 提供 1.8 TB/s 的双向带宽,是 PCIe Gen5 带宽的 14 倍,可在非常复杂的大型模型中实现无缝高速通信。它还通过面向集合通信的网络计算技术提高了吞吐量并降低了延迟。NVLink 带宽每扩展 2 倍,即可将机架级 AI 性能提升 1.3-1.4 倍。
半定制 AI 基础架构的行业应用
NVLink Fusion 使超大规模企业能够将其半定制 ASIC 无缝集成到高度优化和广泛部署的数据中心架构中。NVLink Fusion 包含 NVLink 芯片,可通过相同的 NVIDIA 机架级扩展架构来纵向扩展 NVIDIA 和半定制 ASIC 的混合基础设施,并与 NVIDIA CPU、NVIDIA NVLink 交换机、NVIDIA ConnectX Ethernet SuperNIC、NVIDIA BlueField DPU 以及用于横向扩展解决方案的 NVIDIA Quantum 和 NVIDIA Spectrum-X 交换机搭配使用。领先的超大规模企业已经在部署 NVIDIA NVLink 全机架解决方案,并且通过使用 NVLink Fusion 在同一机架架构上实现异构芯片数据中心的标准化,从而加快产品上市时间。
NVLink Fusion 技术还为 AI 创新者开辟了另一种集成途径,即通过 NVIDIA NVLink-C2C 技术将半定制 CPU 连接到 NVIDIA GPU。合作伙伴可以将其先进的 CPU 技术与 NVIDIA GPU 相结合,实现内存一致性,从而提供 NVIDIA 全栈 AI 基础架构产品。NVIDIA NVLink-C2C 最初应用于 NVIDIA Grace Hopper 和 NVIDIA Grace CPU 超级芯片,可提供 900 GB/s 的一致性互连带宽。
图 2 显示了不同的 NVLink Fusion 组合选项。

图 2. NVLink Fusion 机架部署示例
专为 AI 工厂打造的软件
通过 NVLink Fusion 连接的 AI 工厂可以由 Mission Control 提供支持,这是一个统一的运营和编排软件平台,可自动执行 AI 数据中心和工作负载的复杂管理。
从配置部署到验证基础设施,再到编排任务关键型工作负载,Mission Control 可增强 AI 工厂运营,帮助企业更快地启动和运行前沿模型
NVLink Fusion 合作伙伴生态系统
NVIDIA 生态系统涵盖定制芯片设计师、CPU、IP 和 OEM/ODM 合作伙伴,提供通过 NVIDIA 来大规模部署定制芯片的完整解决方案。借助 NVLink Fusion,他们可以与 NVIDIA 合作伙伴生态系统合作,将 NVIDIA 机架级解决方案部署集成到数据中心基础设施中。高性能 AI 工厂可以快速纵向扩展,以满足模型训练和代理式 AI 推理等严苛工作负载的需求。
面向 AI 的 加速网络 平台
NVIDIA Quantum-X800 InfiniBand 平台、NVIDIA Spectrum-X Ethernet 网络平台、NVIDIA Bluefield-3 DPU 和 NVIDIA Connect-X SuperNIC 可以为大规模 AI 数据中心提供可扩展的性能、效率和安全性。
NVLink Fusion 可为系统中的每个 GPU 提供 800 Gb/s 的总数据吞吐量,并与 Quantum-X800 和 Spectrum-X 平台无缝集成,使 AI 工厂和云数据中心能够在没有瓶颈的情况下处理万亿参数模型。
NVIDIA 光电一体化(CPO) 交换机是 NVIDIA Quantum-X 和 Spectrum-X 平台的一部分,通过集成硅光技术取代了可插拔光模块,与传统网络相比,其能效提高了 3.5 倍 ,网络可靠性提高了 10 倍,信号完整性提高了 63 倍,部署时间缩短了 1.3 倍。
NVIDIA 的 CPO 网络简化了管理和设计,为计算基础设施提供更强大的功能。这些优势对于迈向未来百万级 GPU 的 AI 工厂至关重要。
BlueField-3 DPU 扩展到整个数据中心,可加速 GPU 对数据的访问、保障云上多租户的安全和高效的数据中心运营。NVIDIA GB300 NVL72 架构率先在 GPU 和 ConnectX-8 SuperNIC 之间引入 PCIe Gen6 连接,无需独立的 PCIe 交换机接口。新的 I/O 模块将在同一设备上配备两个 ConnectX-8 芯片,为系统中的每个 GPU 提供全速的 800 Gb/s 网络连接。
总结
AI 变革所需的基础设施不但强大,还要敏捷、可扩展且高效。仅靠添加更多的独立服务器或组件已不再可行。未来依赖于深度集成的机架级解决方案,使海量计算资源能够作为一个统一的整体运行。NVIDIA 的 NVLink 技术一直在其 GPU 平台上处于纵向扩展架构的前沿。现在,借助 NVLink Fusion,NVIDIA 将这种经过验证的出色性能扩展能力应用到半定制芯片领域。

