

在强化学习 (RL)后训练期间,通过对当前策略模型运行推理,动态生成训练轨迹。为提高训练效率,通常会在分解设置中的单独 GPU 资源上并行运行推理和训练。虽然策略模型仅在训练 GPU 上更新,但系统必须使用训练 GPU 上生成的最新参数定期刷新推理 GPU 上的权重。训练 GPU 与推理 GPU 之间的模型权重转移称为重构。
改装涉及两个构成挑战的决定性特征。首先,推理和训练具有不同的计算要求,因此通过具有不同的并行映射 (数据、上下文、张量、专家和工作流并行) ,权重在推理和训练实例中的分布情况各不相同。
其次,由于 Refit 必须更新推理 GPU 上的所有模型权重,因此通信负载按模型权重总大小的顺序排列。对于最新的前沿模型来说,这种负载已经非常大,并且预计会继续增长。这些特性共同表明,改装需要在各种分布式源和目标布局中实现高性能通信。
本文将介绍 AI 训练框架如何使用 Reshard 集合通信来应对这些改装挑战。Reshard 集合通信是一种新型集合通信,主要用于加速 RL 权重改装。NCCL M2N Reshard 是 Reshard 集合的开源参考实现,可通过 NVIDIA/nccl-extensions GitHub 资源库获取。
当前权重重构方法在模型规模方面面临的挑战
现有的重构实现通常使用收集和广播方法来处理训练和推理布局之间的差异。
每个模型参数的典型收集和广播权重重拟合序列的结构如下:
- 训练 GPU 会收集其本地分片,以重建完整的参数。
- 完整的参数张量将广播至推理 GPU。
- 每个推理 GPU 都保留其本地布局所需的分片。
使用完整的张量作为中间表示,可以直接在不同布局之间迁移权重。但是,即使推理 GPU 仅需要分片,它也会接收完整的参数。这一过程在采集和广播阶段都会产生冗余通信,而这是次优通信。
此通信的大小随着模型大小的增加而增长,而模型的规模会继续扩大。例如,Kimi K3 包含 2.8 万亿个参数,而 Qwen 3.8 2.4 T A95B 包含 2.4 万亿个参数。假设 BF16 权重为每个参数 2 个字节,则其权重大小分别约为 5.6 TB 和 4.8 TB。
同时考虑到所有收集阶段和广播阶段后,得出的估计逻辑有效载荷约为模型权重大小的两倍 (表 1) 。
| 模型 | 字节大小 | 改装有效载荷估算 ( all-gather+broadcast) |
| Kimi K3 | 5.6 TB | ~ 11.2 TB |
| Qwen 3.8 2.4 T A95B | 4.8 TB | ~ 9.6 TB |
对于当今最大的开放式权重模型,通信负载每次改装已达到约 10 TB,必须在每个训练步骤中执行。随着大语言模型 (LLM) 的不断扩展,与这种大型有效载荷相关的开销将变得更加巨大。因此,需要一种更复杂的方法来执行重量改装,在适当考虑不同重量布局的同时减少实际有效载荷大小。
将重构重新表述为一个由 DTensor 到 DTensor 的传输问题
为了克服这些限制,首先要遵循的原则是,重构应仅传输理论上最小数量的权重数据。然而,实现这一目标存在一些挑战。训练和推理实例可以使用不同的并行配置和 GPU 数量,从而产生不同的分片边界。因此,可能需要将目标分片从多个源分片的各个部分组合起来,反之亦然。
复制使映射变得更加复杂,因为多个源 GPU 或多个目标 GPU 可能需要相同的权重。确定哪个源 GPU 应将哪些张量区域发送到每个目标,同时在所有可能的配置中实现高性能,这一点非常重要。
应对这一挑战的关键是为这种独特的通信模式确定正确的抽象。该团队采用了现有的 PyTorch 分布式张量 (DTensor) 抽象,该抽象旨在表示在不同形式的数据和模型并行下跨 GPU 进行分片或复制的张量。其中的关键之处在于,无论两个实例使用何种并行配置,权重重构均可被重新表述为将 DTensor 从训练布局重新分片到推理布局。
DTensor 布局由张量的全局形状、指定 GPU 逻辑安排的设备网格以及指定如何在该网格中分片或复制张量的放置位置来描述。Refit 可以使用源描述来指定更新的权重所在的位置,并使用目标描述来指定每个推理 GPU 所需的权重。
例如,考虑使用 8 x 8 的权重矩阵拆分两个训练 GPU 上的行以及四个推理 GPU 上的列。假设张量在训练 GPU 的行维度中进行分片,并在推理 GPU 的列维度中进行分片,则每个训练 GPU 拥有 4 x 8 分片,而每个推理 GPU 需要 8 x 2 分片。通过从每个源接收 4 x 2 区域,每个目的地都可以获得所需的分片。如图 1 所示,这些区域直接源自源分片和目标分片之间的重叠部分。
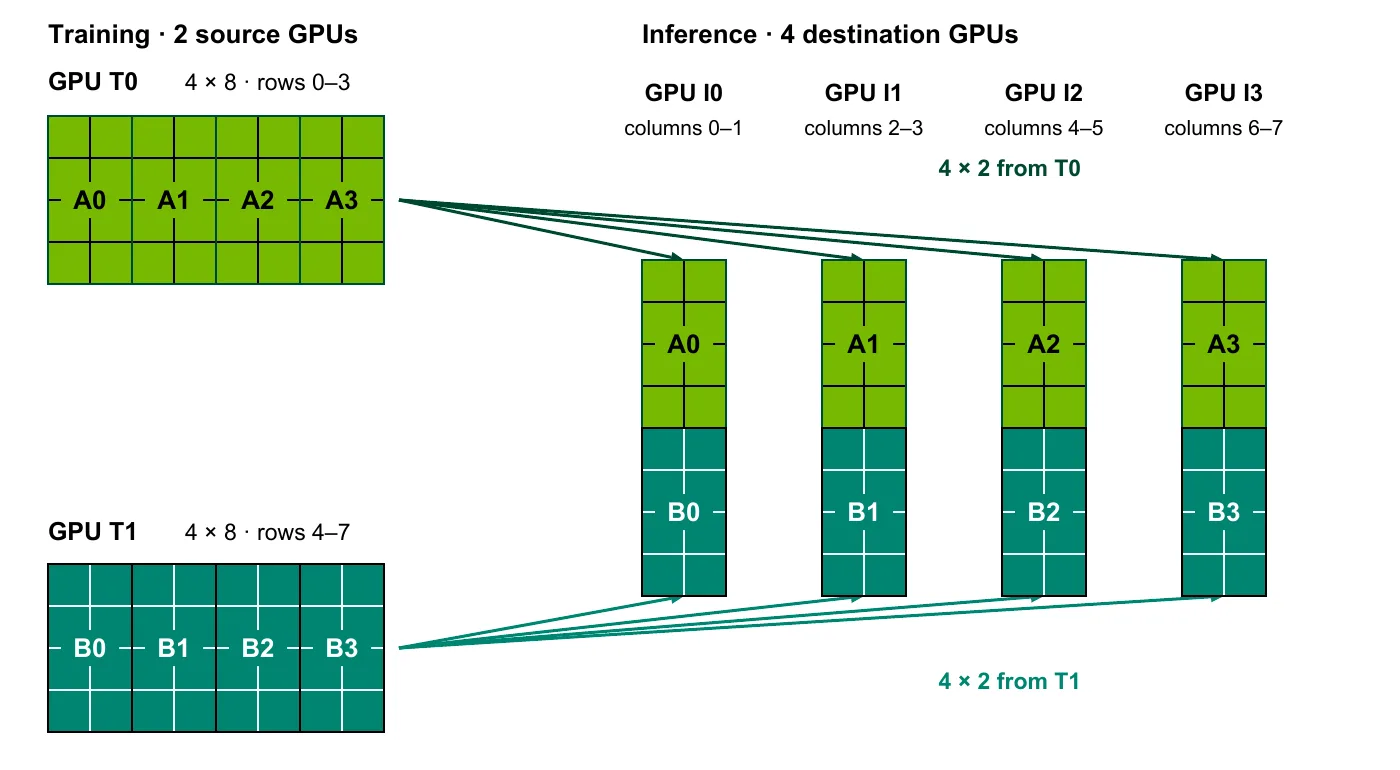
如图所示,任何类型的分片张量都可以轻松表示为 DTensor 格式,并且可以将重构重新定义为 DTensor-to-DTensor Reshard 问题。这一发现为 Reshard 集合论奠定了基础。
用于 DTensor 到 DTensor 传输的 Reshard 集合通信
Reshard 是一种新型集合通信调用,用于任意的 DTensor 到 DTensor 传输。与 all-reduce、reduce-scatter、all-gather、broadcast 等类似,Reshard 定义了应用可以作为一个操作调用的通信模式。它将逻辑张量的值从源分布传输到目标分布。
Reshard 调用可以简单地通过源和目标的 DTensor 描述来指定。这种抽象不仅简化了重构问题,而且还将通信逻辑封装到库中,使底层算法能够独立于应用进行发展和改进。
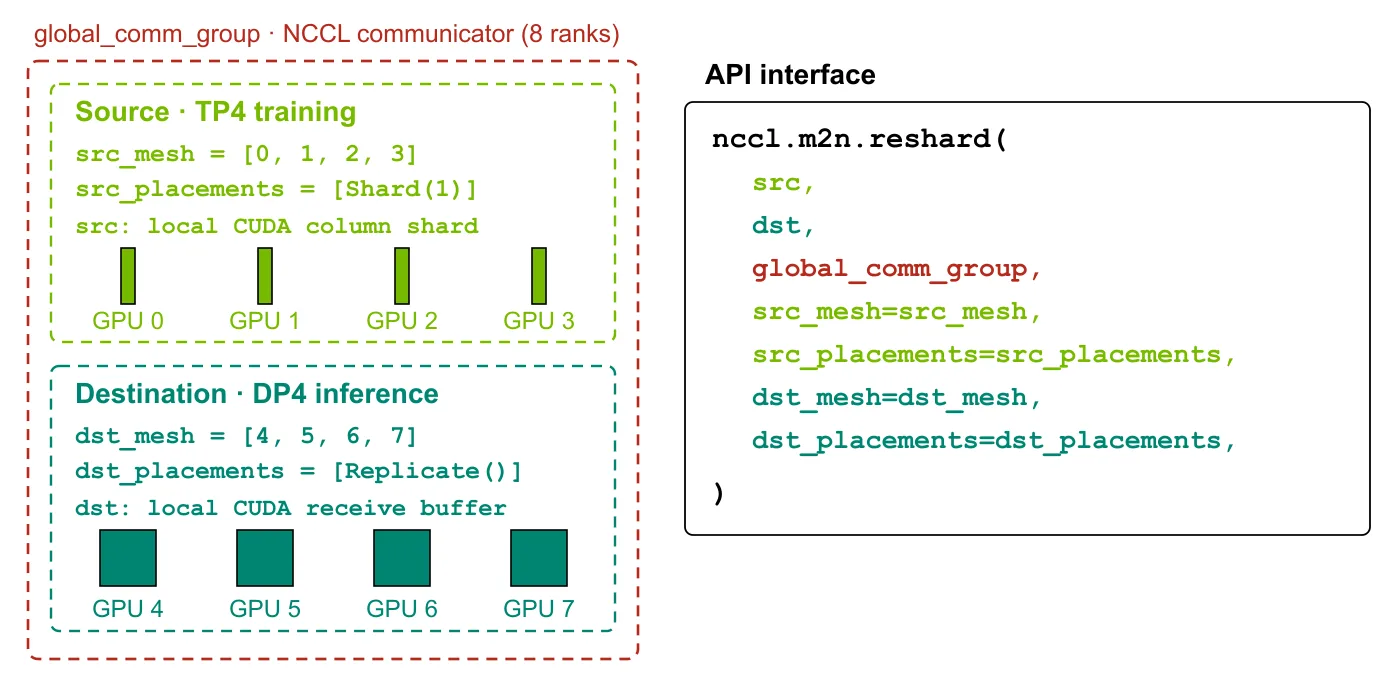
NCCL M2N Reshard 是开源的,作为 Reshard 集合的第一个参考实现提供给社区。此实现基于 NCCL 构建,可将分布在 M 源 GPU 上的张量传输到 N 个目标 GPU 所需的布局中。在 RL Refit 中,训练 GPU 构成源组,推理 GPU 构成目标组。
图 2 显示了此实现如何接受布局描述和本地缓冲区来执行 Reshard 运算。
NCCL M2N Reshard 如何释放最大网络带宽
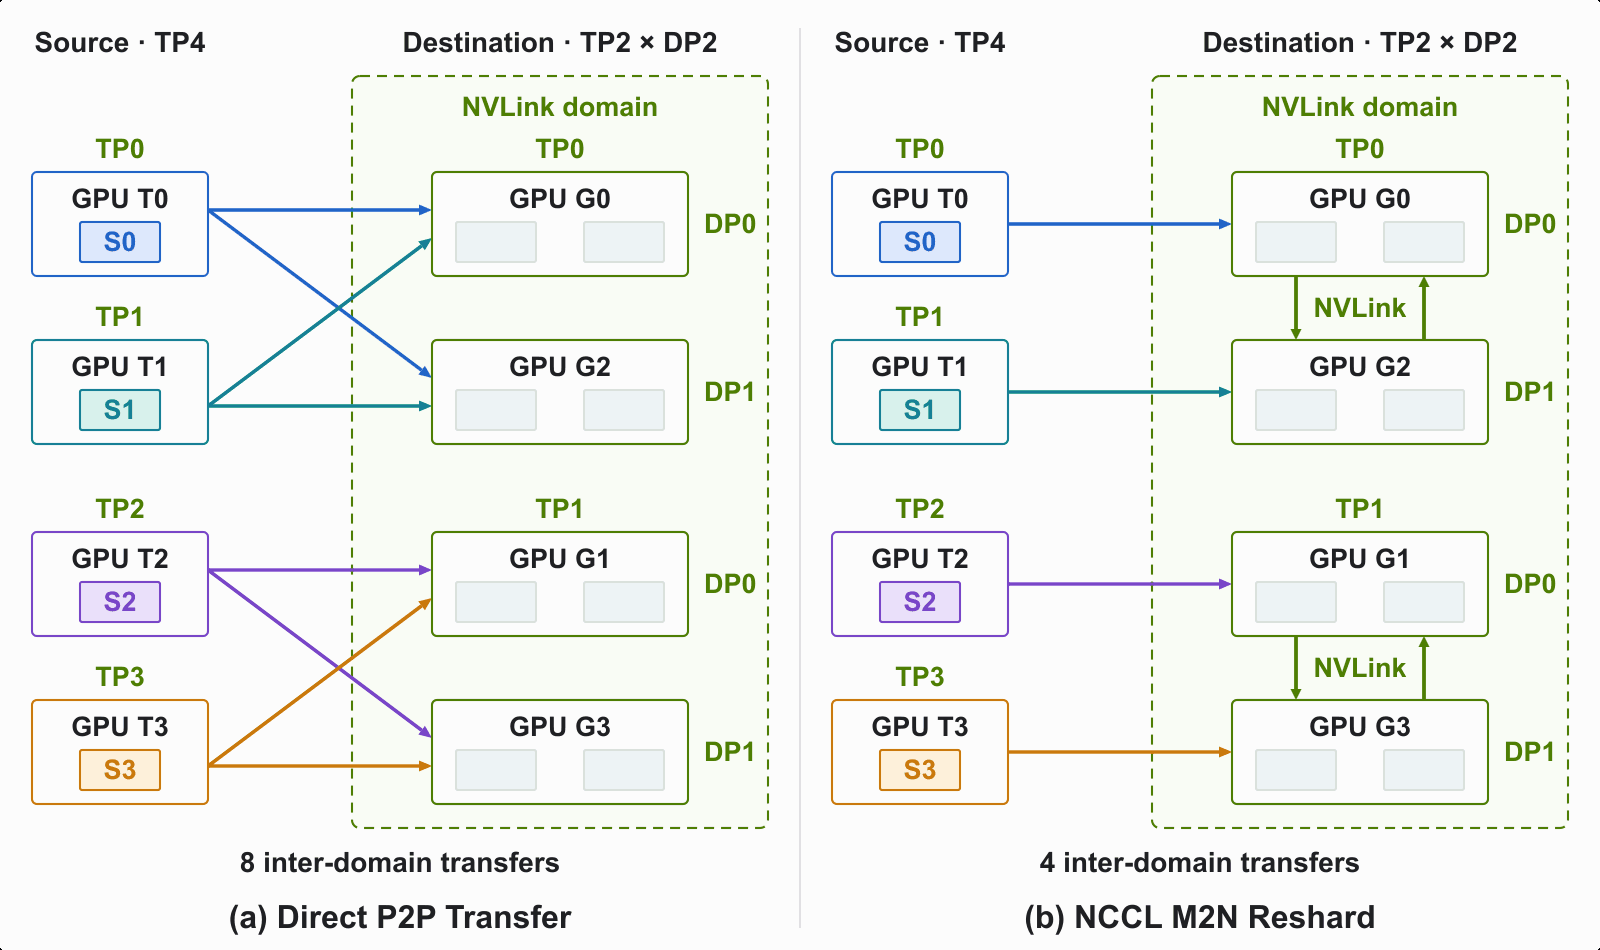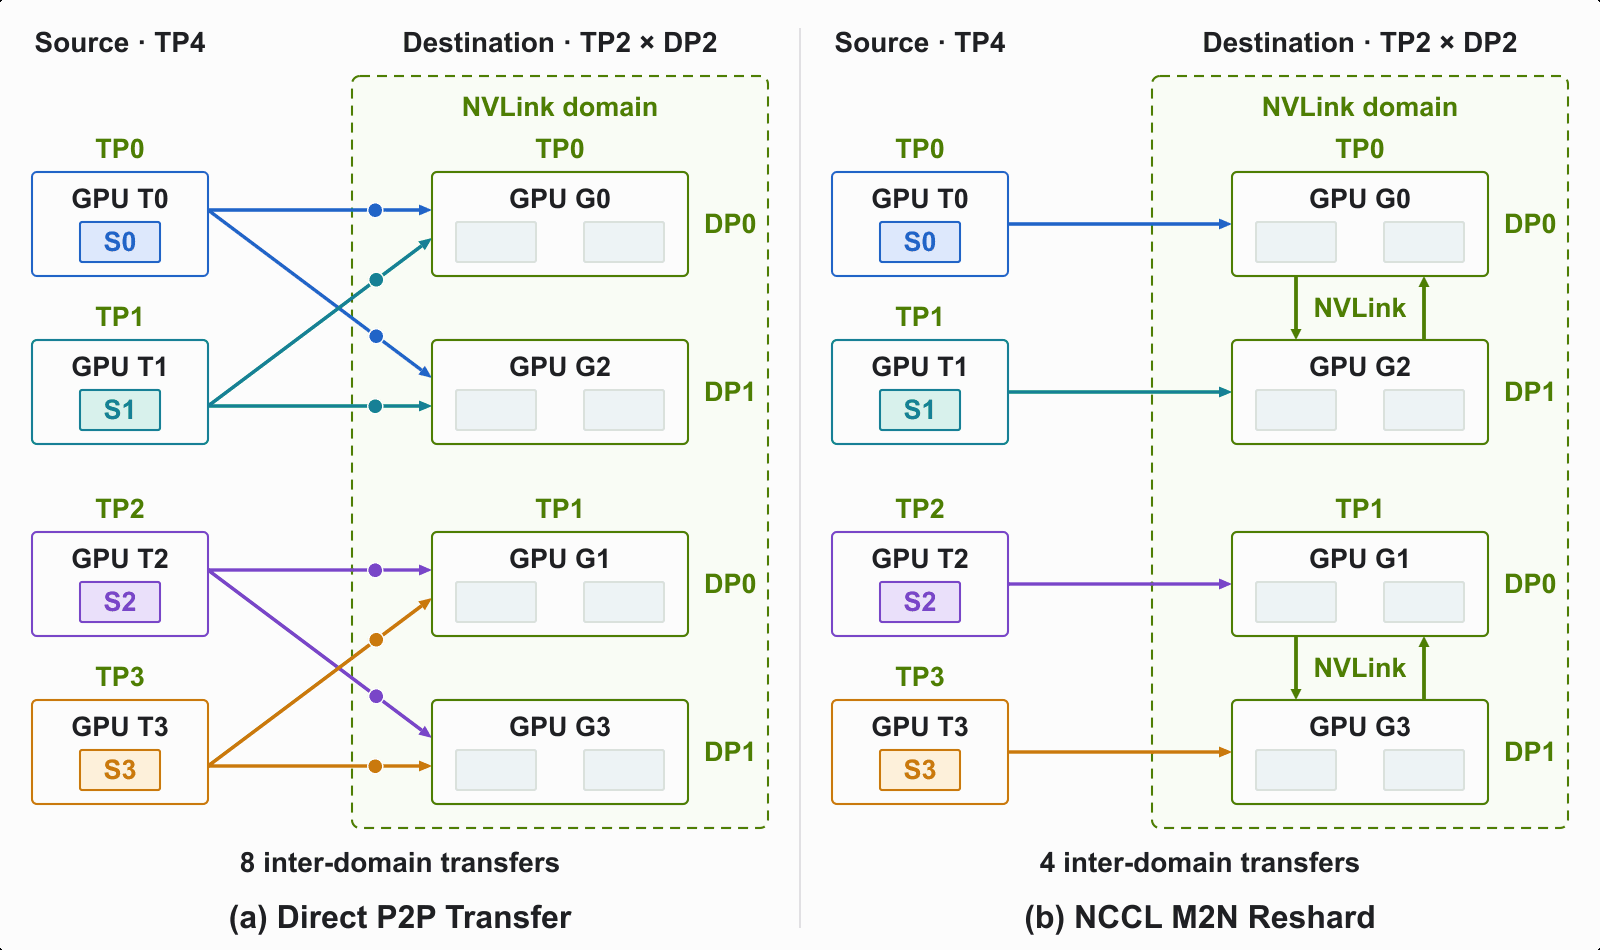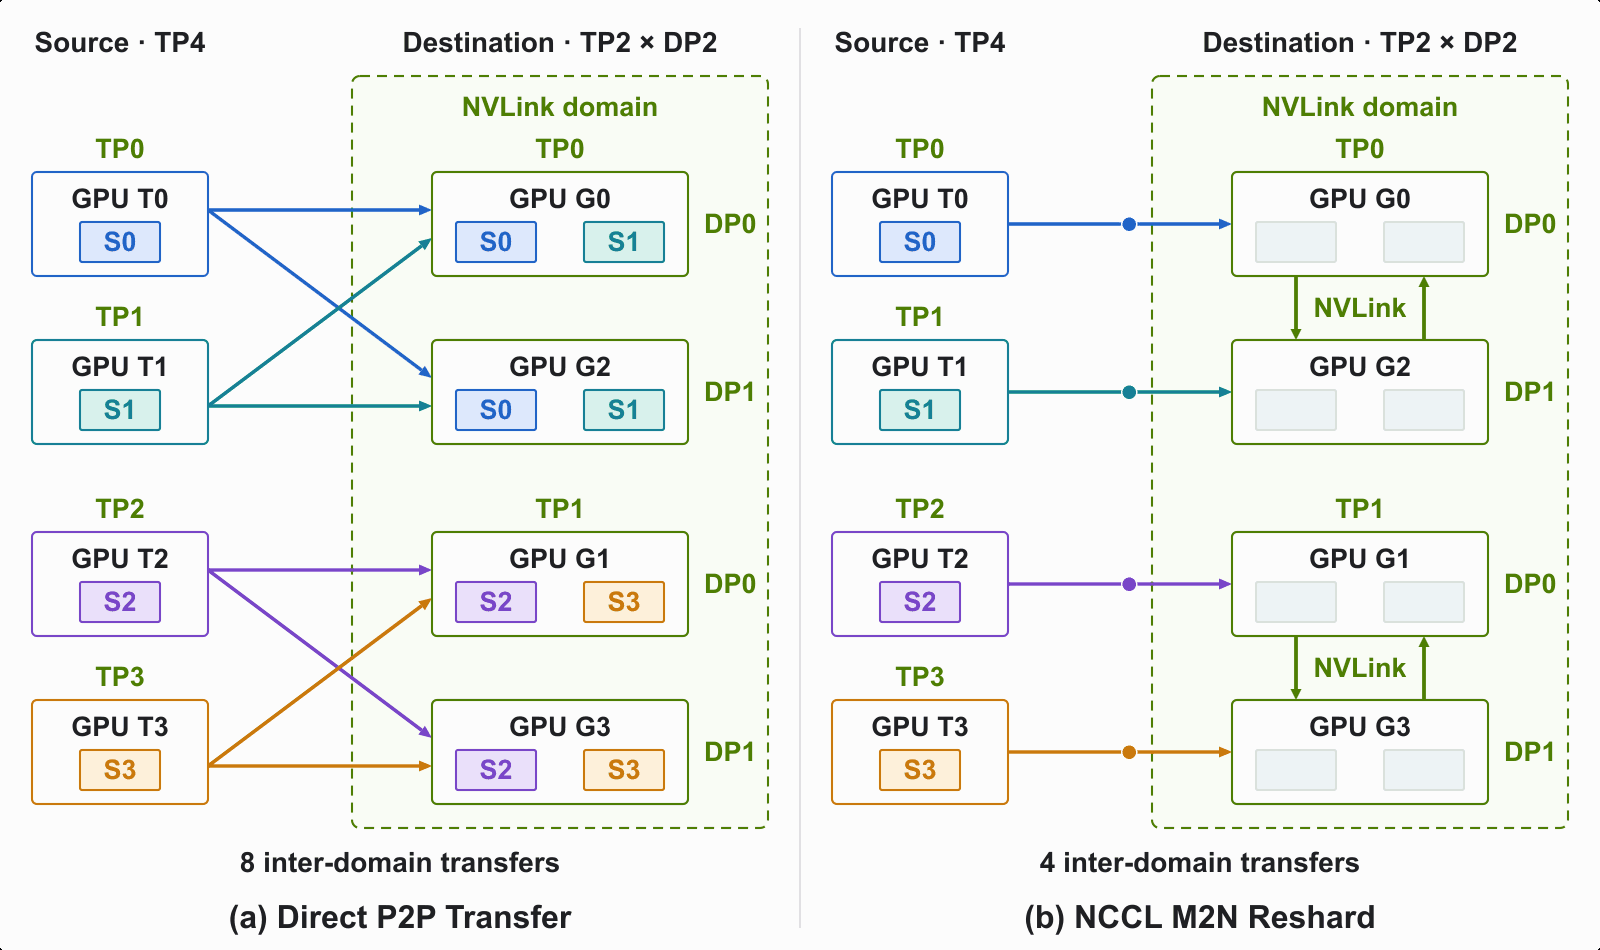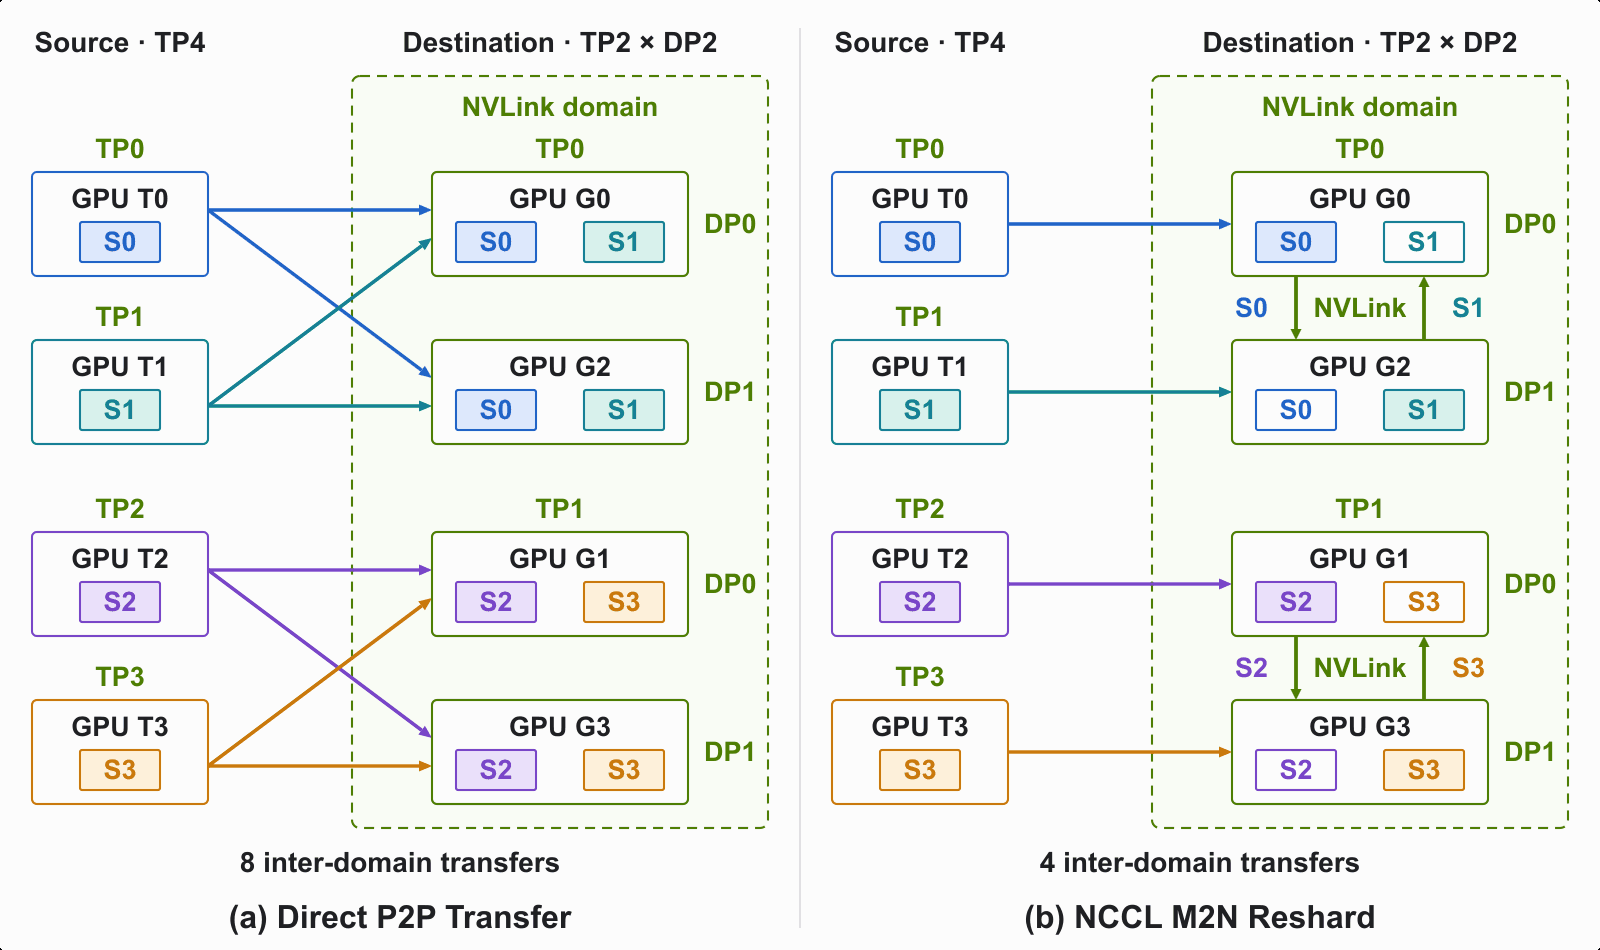
NCCL M2N Reshard 首先推导出源分片和目标分片之间的精确交集,然后将这些传输映射到物理 GPU 网络拓扑上。NCCL M2N 按 NVIDIA NVLink 域对副本进行分组,而不是将每个源贡献单独发送到每个目标副本。在每个域中,它尽可能均匀地在副本秩中分配传入贡献,因此每个接收秩都会通过网络接收不同的总数据子集。
然后,接收 rank 通过 NVLink 交换这些子集,使每个副本都能组装完整的分片,而不会复制网络流量。如果副本跨越多个 NVLink 域,则每个贡献的一个副本将通过域转发,并且每个域内都会发生相同的平衡本地交换。网络传输和 NVLink 复制通过流水线化的方式来隐藏彼此的延迟。
图 3 展示了此数据移动方案,该方案适用于从源上的 TP4 移动到目标上的 TP2 x DP2 的张量,且所有四个目标 GPU 都位于一个 NVLink 域中。通过直接点对点传输 (图 3a) ,每个源分片将发送到两个数据并行 (DP) 副本。因此,每个分片会通过网络冗余传输两次。这意味着每个分片可获得大约一半的网络带宽 (假设每个分片使网络带宽饱和) 。
NCCL M2N Reshard 只需在网络中传输一次源分片,即可为每个目标 GPU 提供所需数据的一半 (图 3b) 。目标 GPU 通过 NVLink 交换缺失的一半。例如,目标 GPU 0 通过网络从源 GPU 0 接收 S0,通过 NVLink 从目标 GPU 2 接收 S1。网络传输和 NVLink 交换同时进行。这样,每个分片都能获得完整的网络带宽。
使用 NVIDIA NeMo RL 演示 Reshard 集合
为了证明 Reshard 集合对于权重重构的有效性,NVIDIA NeMo RL 框架中提供了一个参考实现。NeMo RL 是一个开源框架,旨在简化和扩展 RL 后训练。Reshard 集合的清晰抽象使得框架中所需的实现相对简单。对于给定的并行配置,框架只需要为训练和推理实例的每个参数提供一个 DTensor 描述,这应该很简单,因为 DTensor 就是为此目的而设计的。
然而,在实践中,由于层类型多种多样,而且训练和推理引擎在每个并行配置下对参数进行分片的方式多种多样,因此通过 Reshard 集合处理每个边缘用例都具有挑战性。
为了开发高效且可持续的设计,我们基于一项关键观察结果,即 Transformer 块中的前馈投影权重在权重改装负载中占据主导地位。在最新的 LLM 中,这些权重约占模型参数的 95%。
根据这一观察结果,我们的设计使用了一种混合方法,其中主要的前馈投影权重采用重新硬化路径,而所有其他小权重 (例如,QKV 投影或曼巴权重) 则使用传统的收集和广播重构路径,该路径经过优化,可实现广泛的功能覆盖。这种方法结合了适用于大多数有效载荷的高效重硬化通信,并具有与传统收集和广播改装相同的功能覆盖范围。
在故障恢复期间,随着节点的添加或删除,分片布局可能会在运行时发生变化。为适应 GPU 成员资格的变化,框架可以销毁并重建通信组,也可以使用 NCCL 缩小和增长 API 来调整现有的通信组。NeMo RL 目前使用第一种方法提供弹性支持。计划在未来的更新中使用 NCCL shrink and grow API 提供弹性支持。
RL 权重改装性能基准测试结果
表 2 总结了使用上述 NeMo RL 实现 测量的基于 Reshard 的改装延迟。这些基准测试涵盖了 NVIDIA DGX H100 (NVL8) 和 NVIDIA DGX GB200 (NVL72) 系统上的一系列模型。在各种基准测试中,重制版改装的速度比传统的采集和广播改装快 2.7 倍至 5.7 倍。
| 平台 | 模型 | 训练+ 推理布局 | 收集并广播改装延迟 | 修复改装延迟 |
| NVIDIA DGX H100 | Qwen 3 235B | TP4 x PP8 x EP16 TP8 x DP16 | 6.4 秒 | 1.9 秒 |
| NVIDIA DGX H100 | DeepSeek v3 671B | PP16 x EP16+ TP32 x DP8 | 14.9 秒 | 2.6 秒 |
| NVIDIA DGX GB200 | DeepSeek v3 671B | PP16 x EP16+ TP32 x DP8 | 6.1 秒 | 2.3 秒 |
| NVIDIA DGX GB200 | Nemotron Ultra v3 | TP8 x EP32 x PP2+ TP8 x DP8 | 8.2 秒 | 2.3 秒 |
这种新的改装专为万亿参数模型而设计。在我们仅进行改装的微基准测试中,对 Qwen3.8 2.4 T BF16 模型进行 Reshard 改装仅需 4.3 秒,这证明了其在设计万亿参数规模时的有效性。
开始使用 NeMo RL 进行重构重量改装
借助 NVIDIA NeMo RL 框架中的参考实现,您可以将这种方法应用于自己的 RL 工作负载并进行扩展。
要在 NeMo RL 中启用重构重构路径,请使用以下配置:
policy:
  generation:
    colocated:
      enabled: false
    refit_transport: nccl_reshard
NeMo RL 改装指南 和 NCCL Reshard 配置要求 描述了此功能支持的后端、布局和精度模式。
致谢
我们由衷地感谢 Ke Wen、Ching-Hsiang Chu、Guyue Huang、Seonjin Na 和 Nitin Nitin 为 NeMo RL 中的 NCCL M2N Reshard 和 nccl-reshard 权重改装所做的贡献。


