

在科学和工业领域,实时分析传感器测量结果有助于 AI 调整流程、指导实验并寻找更好的操作条件。然而,测量数据移动和处理速度的限制往往决定了仪器的设计方式,从读出电子元件到采集定时。如果处理过程能够与传感器保持同步,科学仪器制造商可以简化或实现哪些目标?
NVIDIA DAQIRI 是一个软件定义的数据采集库,可将高带宽仪器和传感器数据迁移到 GPU 就绪型工作流中。它使开发者能够在采集期间处理测量数据,而无需先将其写入磁盘。作为 NVIDIA Holoscan 平台库,DAQIRI 将针对测量进行优化的传感器与可编程 GPU 平台连接起来,用于科学分析、AI 推理和反馈应用。
对于现有的支持以太网的仪器,这为添加处理和反馈功能提供了机会,正如上一篇文章中所述,使用 NVIDIA DAQIRI 实现用于高速数据采集的实时 AI 。对于新的仪器,它提供了从一开始就重新考虑获取限制的机会。
本文将探讨新的电子显微镜摄像头和 GPU 处理如何在采集过程中实现分析。然后,它引入了新的 DAQIRI 功能,包括硬件数据包重新排序、库中的性能和吞吐量改进,以及用于时间敏感型数据包处理的低延迟 NIC 轮询模式。
案例研究:将高动态范围成像连接到 GPU 处理
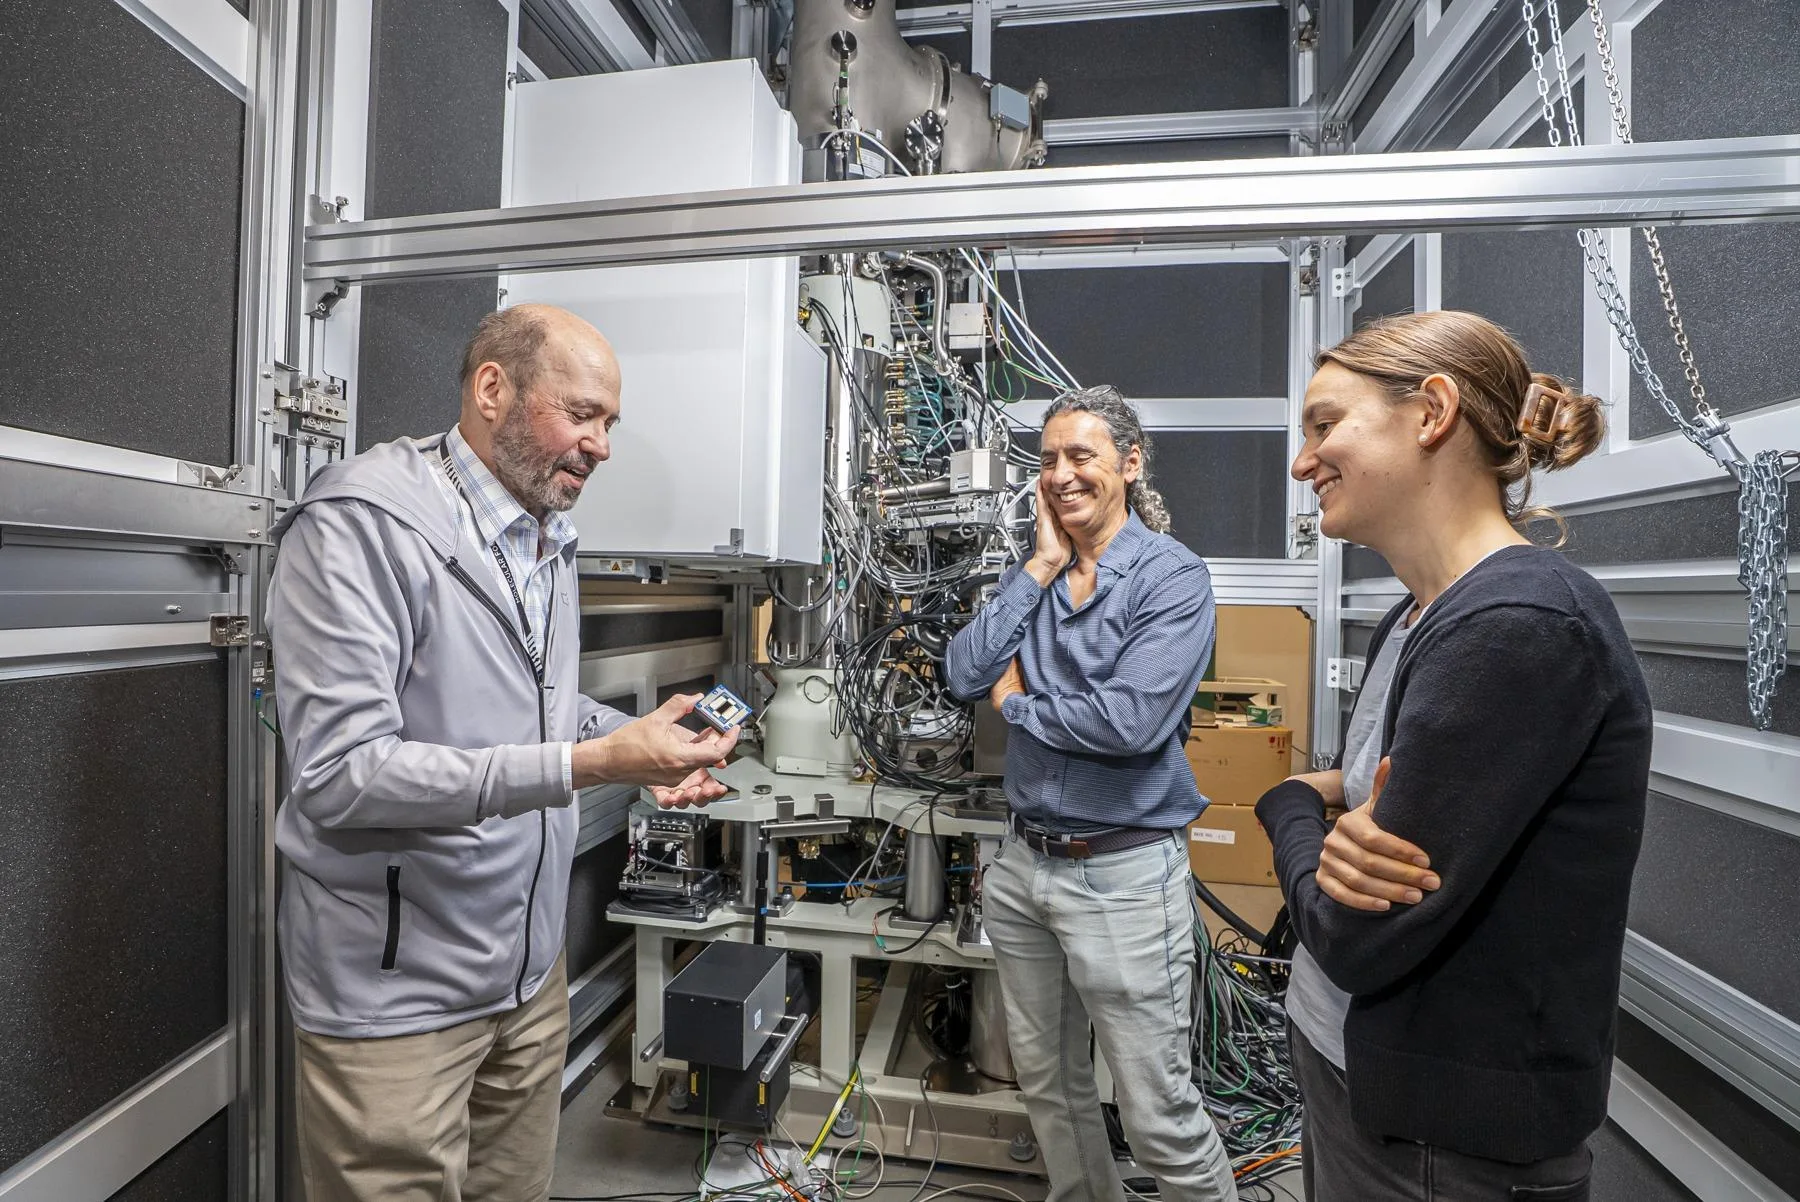
劳伦斯伯克利国家实验室 ( Lawrence Berkeley National Laboratory ) 的 Molecular Foundry 开发的高动态范围电子显微镜相机展示了将先进的检测器和 GPU 处理技术协同工作的可能性。
电子能量损失光谱 (EELS) 可测量电子与样本相互作用时损失的能量,帮助科学家确定存在哪些元素以及它们是如何键合在一起的。这些测量包含强信号和弱信号。为了捕捉这些强度差异,传统方法快速连续使用两个单独优化的采集过程。
这需要精确协调电子光学、曝光定时和检测器读出。然后,需要对生成的测量结果进行调整和组合,从而增加采集和处理的复杂性。Molecular Foundry 开发的新型高动态范围摄像头可同时捕获强信号和弱信号。
这一进步简化了实验设置和光学显微镜,但每秒可生成超过 500 GB 的数据 (Gbps) ,必须接收和处理这些数据流才能使这些测量结果在采集过程中发挥作用。这比传统的 EELS 数据流快 500 倍以上,大大增强了可用于进一步处理和分析的原始检测器信息。
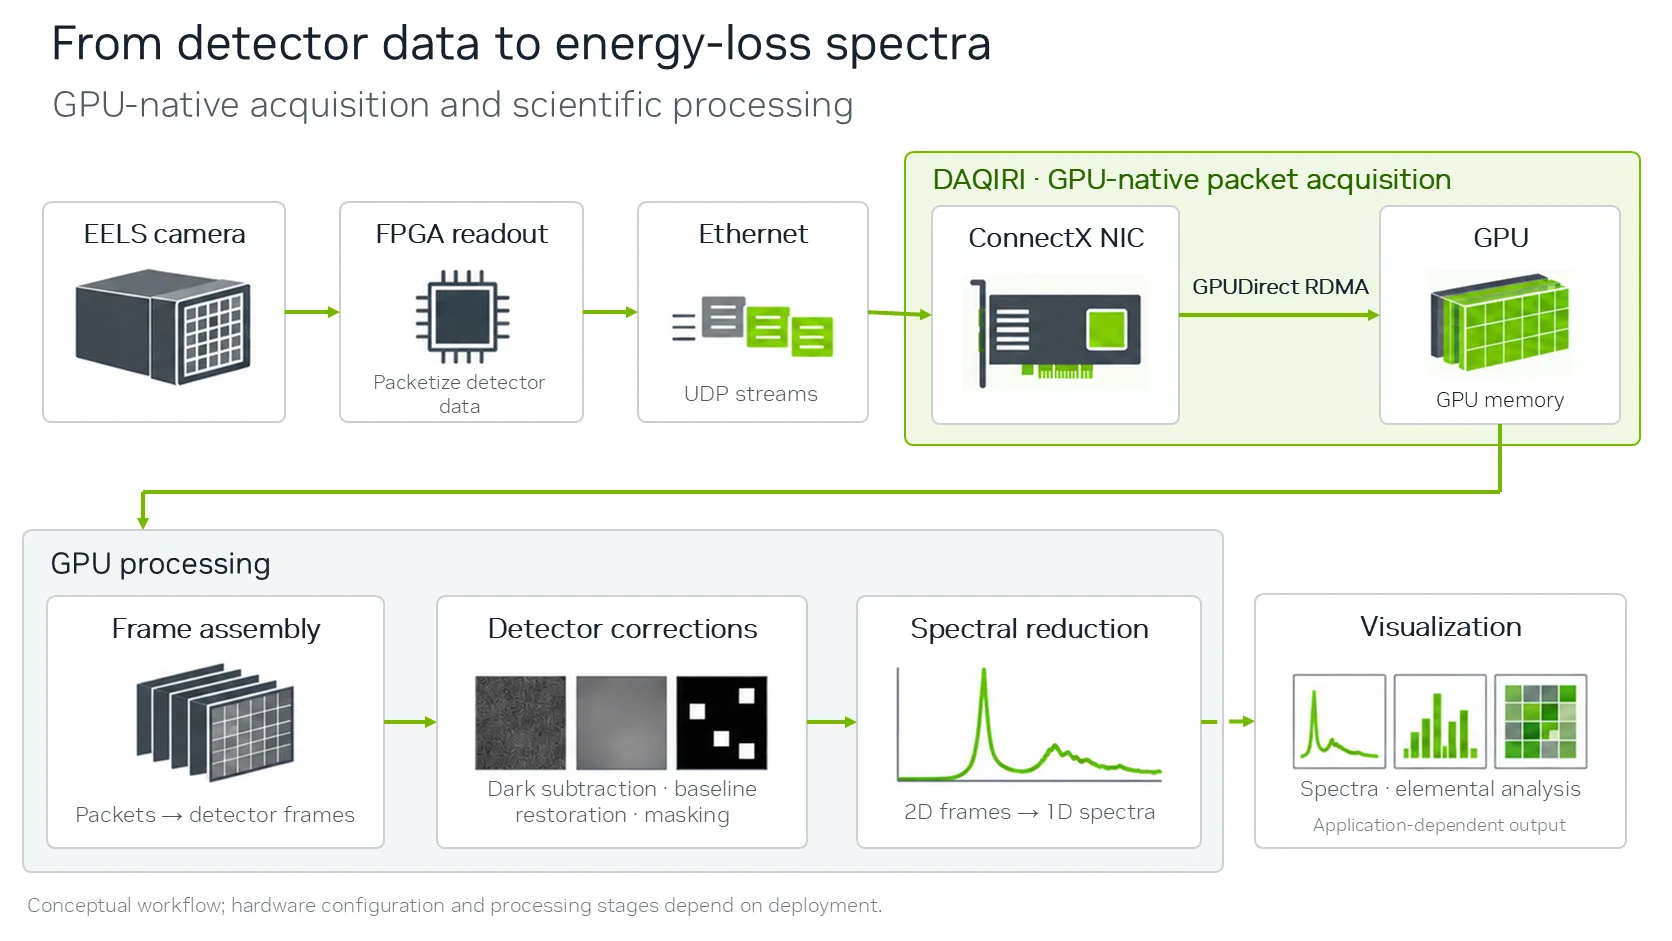
处理该流需要一个与摄像头保持同步的采集和处理工作流。Berkeley Lab 与 NVIDIA 的合作将摄像头、DAQIRI 和 GPU 加速处理整合在一起。FPGA 读出电子设备通过以太网传输检测器数据,DAQIRI 直接将数据包接收到 GPU 显存中,GPU 处理则组装并纠正检测器帧,然后再将其降低到能量损失频谱。
计算还可改进从检测器中恢复的空间信息,实现 5 微米宽的传感器像素的亚微米空间分辨率。通过此工作流,该团队能够在测量期间检查数据,并实时调整采集参数和相关区域,同时以超过 500 Gbps 的速度处理传入的高带宽数据。
这种方法的优势不仅限于电子显微镜。将传感器连接到 GPU 处理可以从测量中提取更多信息,并使仪器制造商在获取、分析数据和处理数据方面具有更大的灵活性。实现这些优势需要高效的数据传输、有序的有效载荷准备处理,以及用于反馈的低延迟通信。
设计智能仪器的采集路径
最新版本的 DAQIRI 增加了硬件数据包重新排序、用于提高吞吐量的优化库后端,以及用于低延迟数据包传输和接收的直接轮询。
使用 NIC 硬件对收到的数据重新排序
大多数网络依靠协议处理或接收端缓冲来处理乱序数据包,这会增加延迟和内存开销。DAQIRI 现在可以将数据包重新排序任务卸载到受支持的 NVIDIA ConnectX-7 或更高版本的 NIC,从而保留 CPU 和 GPU 资源用于分析。对于兼容的序列格式,NIC 会解析序列字段,并将每个有效载荷直接放置到内存中的有序位置。应用无需执行单独的软件重新排序复制步骤,即可接收经过组合且有序的数据。
此处为特定的接收队列定义了基于硬件的重排序。配置决定了如何解析报文头的序列号、使用的重新排序方法,以及如何处理丢失的报文。
- name: "rx_reorder_seq_1024"
  reorder_engine: "hw"          # NIC places payloads in order
  cyclic_sequence: true         # Confirm compatible cyclic numbering
  missing_action: “drop”        # Drop partial batches on RX timeout
  reorder_type: "gpu"           # Deliver packets to GPU memory
  memory_region: "Reorder_RX_GPU"
  payload_byte_offset: 42       # Skip 42-byte Ethernet/IPv4/UDP header
  packet_size: 8192             # Payload bytes per output slot
  flow_ids: [201]               # Apply reorder to RX flow 201
  method:
    seq_packets_per_batch:      # Reorder by one sequence field
      sequence_number:
        bit_offset: 336         # Sequence starts at bit 336
        bit_width: 32           # 32-bit sequence field
      packets_per_batch: 1024   # 1024 packets per output buffer
使用 ibverbs 引擎进行高效采集
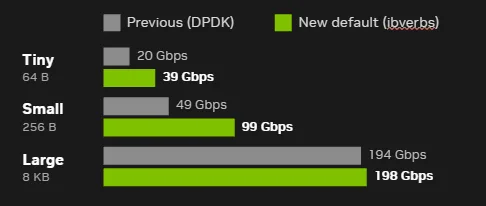
DAQIRI 引入了用于高速接收和传输原始以太网数据包的 ibverbs 引擎。该引擎基于 libibverbs 和 NVIDIA DevX 构建,默认为原始以太网流选择该引擎。开发者还可以通过在其 DAQIRI 配置中添加 engine:“ibverbs”来显式选择它,而无需更改应用程序 API 的使用方式。根据在 NVIDIA DGX Spark、NVIDIA IGX Thor 和 NVIDIA RTX PRO 服务器平台上执行的基准测试,通过减少每数据包 CPU 开销,ibverbs 引擎在小数据包大小 (高达 1024 字节) 和超高数据速率 (超过 200 Gbps) 下的每核心吞吐量大约是之前默认 DPDK 后端的两倍。
通过直接轮询减少反馈延迟
智能仪器可能需要 GPU 分析提供对延迟敏感的反馈,以调整采集或控制设置。DAQIRI 直接轮询模式允许应用程序线程直接接收和提交数据包,从而减少通信延迟,从而避免将数据包交给单独的 I/ O 工作节点。在带线缆的回环基准测试中,在直接轮询模式下,应用程序从发送到接收的延迟约为 2-4 微秒。使用 ibverbs 引擎时,开发者可以选择直接轮询控制队列,同时保留对高吞吐量数据流的批量处理。
在延迟敏感型 TX 和 RX 控制队列中设置 poll_mode: "direct" ,以便应用程序线程直接提交和接收数据包。
# TX/RX queue settings in example configuration file
tx:
  queues:
  - name: "control_tx"
    id: 0
    poll_mode: "direct"         # App thread submits packets
    memory_regions: ["Control_TX"]


rx:
  queues:
  - name: "control_rx"
    id: 0
    poll_mode: "direct"         # App thread polls received packets
    memory_regions: ["Control_RX"]
在同一主机上的 TX 和 RX 端口之间使用带线缆的回环运行直接轮询延迟基准测试。
首先,将配置的硬件地址占位符和其他系统特定设置替换为系统的值:
sudo ./build/examples/daqiri_bench_raw_latency
examples/daqiri_bench_raw_latency_ibverbs.yaml --samples
10000 --warmup 1000 --csv latency.csv
开始使用 GPU 原生数据采集
在制造科学仪器的过程中,GPU 原生数据采集使您能够围绕要测量的内容和所需的响应方式进行设计。高级检测器和 GPU 处理可以协同工作,以重新思考采集限制。
新的 DAQIRI 功能扩展了高效移动和组织测量以及将分析与实验控制连接的选项。这意味着更多的工程工作可以专注于测量质量和科学见解。
要探索这些功能,请从 DAQIRI 文档 和 DAQIRI 配置示例 开始。然后,使用 DAQIRI 基准测试 来评估硬件的吞吐量和通信延迟。
如需了解详情,请查看以下相关资源:
- 探索 NVIDIA/daqiri GitHub 存储库
- 浏览 DAQIRI+ TensorRT 串流推理参考应用
- 为您的硬件生成 DAQIRI 配置


