

将 AI 模型添加到本地应用中需要一种可移植的模型格式、可靠的运行时和跨目标系统的加速。
立即执行推理 (DIN) Deploy 是一个开源实用 C++ 示例集合,可弥合这一差距。它将 ONNX Runtime 与 NVIDIA TensorRT RTX 执行提供程序 相结合,帮助开发者从模型检查点迁移到 Windows 和 Linux 上的原生硬件加速应用程序。相同的 ONNX 运行时 API 也可以通过 WinML 2.0 访问。
从 ONNX 导出到 C++ 实现
每个 DIN Deploy 示例都从 Python 导出器开始,该导出器从 Hugging Face 下载模型检查点,并将其转换为 ONNX 构件。应用端是基于 ONNX 运行时 (ORT) 构建的原生 C++ CLI。这种分割将模型转换与部署逻辑分开,开发者可以将导出的模型引入本地应用程序,而无需模型特定的运行时。
大多数示例代码使用 C++ 中的 ONNX 运行时会话和张量 API。供应商特定代码 (包括 CUDA API 和内核) 仅在可选的加速路径中显示。支持所需 ONNX 运行时张量 API 的执行提供程序可以运行共享代码。
ORT 的复制张量 API使数据局部性易于管理,无需在共享代码中使用专用的供应商 API。
为了对导出的模型推理进行预处理和后处理,FLUX.2 示例使用 ONNX Runtime 的图形互操作功能 (在版本 1.25 中引入) ,并使用 Vulkan 和 DirectX 进行采样。
该库提供适用于 Windows 和 Linux 的 CMake 预设,包括 Arm64 变体。DirectX 仅在 Windows 上可用。
DIN Deploy 支持的 AI 任务
对于自动语音识别 (ASR) ,DIN Deploy 支持离线和流式传输工作流。OpenAI Whisper 涵盖各种模型大小的离线转录,而 NVIDIA Parakeet TDT 和 NVIDIA Nemotron ASR Streaming 则提供流式传输工作流。
这些示例展示了如何在本地应用程序中移动音频,并在可用的地方使用 GPU 加速返回转录结果。
Meta SAM 2.1 示例支持图像和视频的交互式遮罩。它们将模型输出转化为分割掩码,原生应用可将其用于选择、跟踪和其他计算机视觉工作流。
表 1 比较了在 DGX Spark 上测量的选定 DIN 部署工作负载的 GPU 和 CPU 性能。
| 模型 | GPU ( DGX Spark) | CPU ( DGX Spark) |
|---|---|---|
openai/whisper-large-v3-turbo |
58.5 倍 | 3.8 倍 |
nvidia/nemotron-3.5-asr-streaming-0.6b |
39.01 倍 | 3.24 倍 |
nvidia/parakeet-tdt-0.6b-v3 |
206.41 x | 14.44 倍 |
facebook/sam2.1-hiera-base-plus |
38.3 FPS | 0.5 FPS |
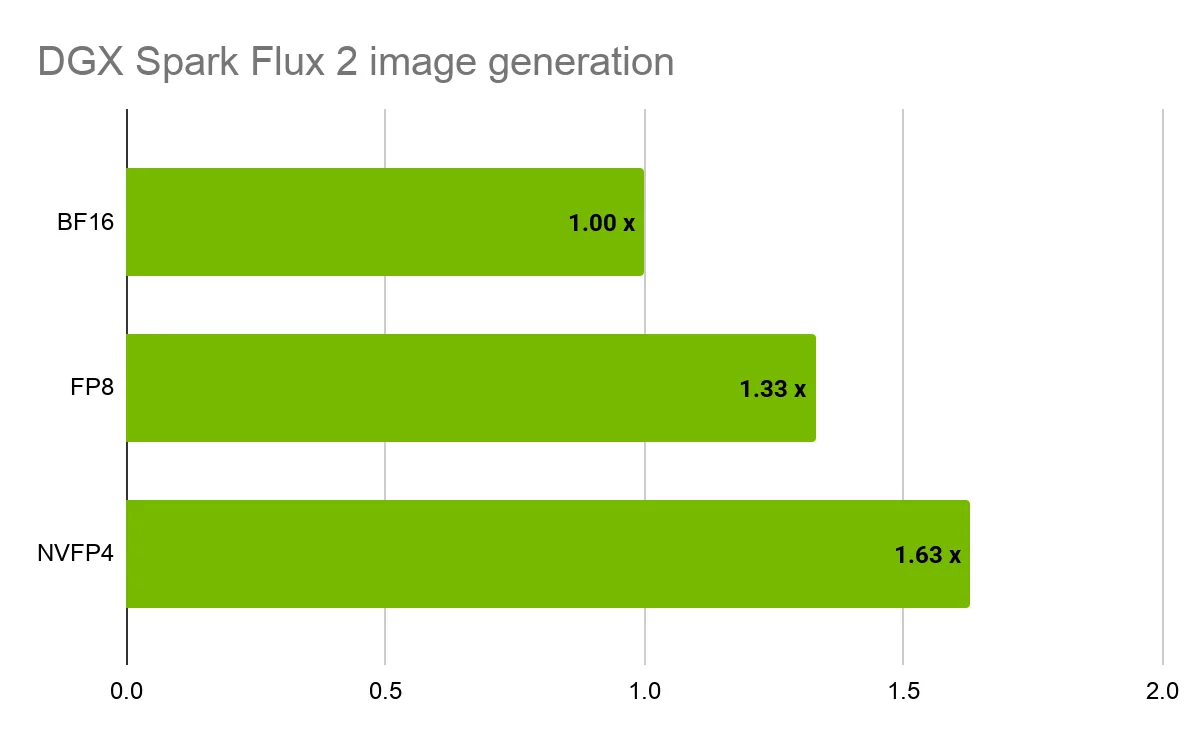
FLUX.2-klein-4B 示例可生成提示驱动的图像。该示例包括与 Vulkan 和 DirectX 的图形 API 交互,允许应用通过跨供应商着色器界面集成 GPU 驻留资源。它还展示了使用 NVIDIA Model Optimizer 的后训练量化 (PTQ) 如何生成量化的 ONNX 模型。量化依赖于硬件,但由于 ONNX 接口保持不变,量化模型是无需更改应用代码的直接替代品。
开始使用 DIN Deploy
从资源库中适用于 Windows、Linux、x86-64 和 Arm64 的 CMake 预设开始。配置和构建项目后,将模型导出到 ONNX 并使用 TensorRT RTX 运行 CLI,或者将代码复制到您自己的应用程序并使用工作流实现。默认情况下,CMake 可下载 ONNX Runtime 和 TensorRT RTX。
详细了解 TensorRT for RTX、NVIDIA Local AI 和 DIN Deploy 库,以及 NVIDIA 关于模型量化的系列博客。

