

训练新一代机器学习原子间相互作用势 (MLIP) 需要真值:对不同结构和化学中的能量、力和应力进行数千万到数亿的密度泛函理论 (DFT) 计算。
以 VASP 为主要实现的平面波 DFT 是生成此类数据的黄金标准。它是准确的,在各种材料类别中得到充分验证,并且在大规模运行这些计算的国家实验室和研究机构中无处不在。
随着 MLIP 训练数据集的增加,以更快、更低的成本生成 DFT 数据的压力也在增加。但是,MLIP 数据生成中常见的小型单元和密集 K-Point网格可能会闲置大量 GPU 性能。VASP 的 OpenACC 实现显著提高了速度,尤其是在大型系统计算方面。但是,对于较小的系统,顺序 K-Point 处理会限制 GPU 利用率。与此同时,AI 工作负载正在将 GPU 硬件开发重塑为更低精度的数据类型,这使得现代 NVIDIA GPU 的性能与仅使用 FP64 的 HPC 代码进行优化的性能之间的差距越来越大。
本文将介绍两项可解决这些瓶颈的新 NVIDIA 功能。第一个是 Daviator,它通过 K-Point 和自旋批量 GPU 内核解决了小系统 GPU 性能问题。特别是,批量 Davidson 求解器可提供显著的性能提升。第二个层是新的混合精度执行层,可进一步提升性能,尤其是在具有高 FP32:FP64 吞吐量比的推理级 GPU 上。
对于预测的参考数据集工作负载,结果显示,与 CPU 执行相比,解决问题的速度提高了 22 倍,成本降低了 75%,具体取决于硬件和配置。
平面波 DFT 中的 GPU 瓶颈
在周期系统中,电子波函数通过晶体动量进行参数化,晶体动量是一组离散的 K-Point,用于对布里渊带进行采样。对于具有小单元单元的周期结构,需要数百到数千个不可归约的 K-Point才能获得良好收的结果。
每个 k-point 求解在很大程度上是独立的;例如,在 Davidson eigensolver 步骤期间不需要 k-point 间通信。尽管存在这种独立性,VASP 的 OpenACC GPU 端口仍会依次处理 K-Point。对于大型系统而言,每个 K-Point的工作量可以使 GPU 完全饱和,但对于具有密集 K-Point网格的小型系统而言,每步数百个小型 GPU 调度会导致内核启动用度主导计算时间。结果:具有 752 K-Point 的单原子铁系统在更昂贵的 GPU 硬件上的运行速度比在 CPU 上慢 8 倍。因此,在这种规模下工作的研究人员可以根据作业规模手动做出路线规划。
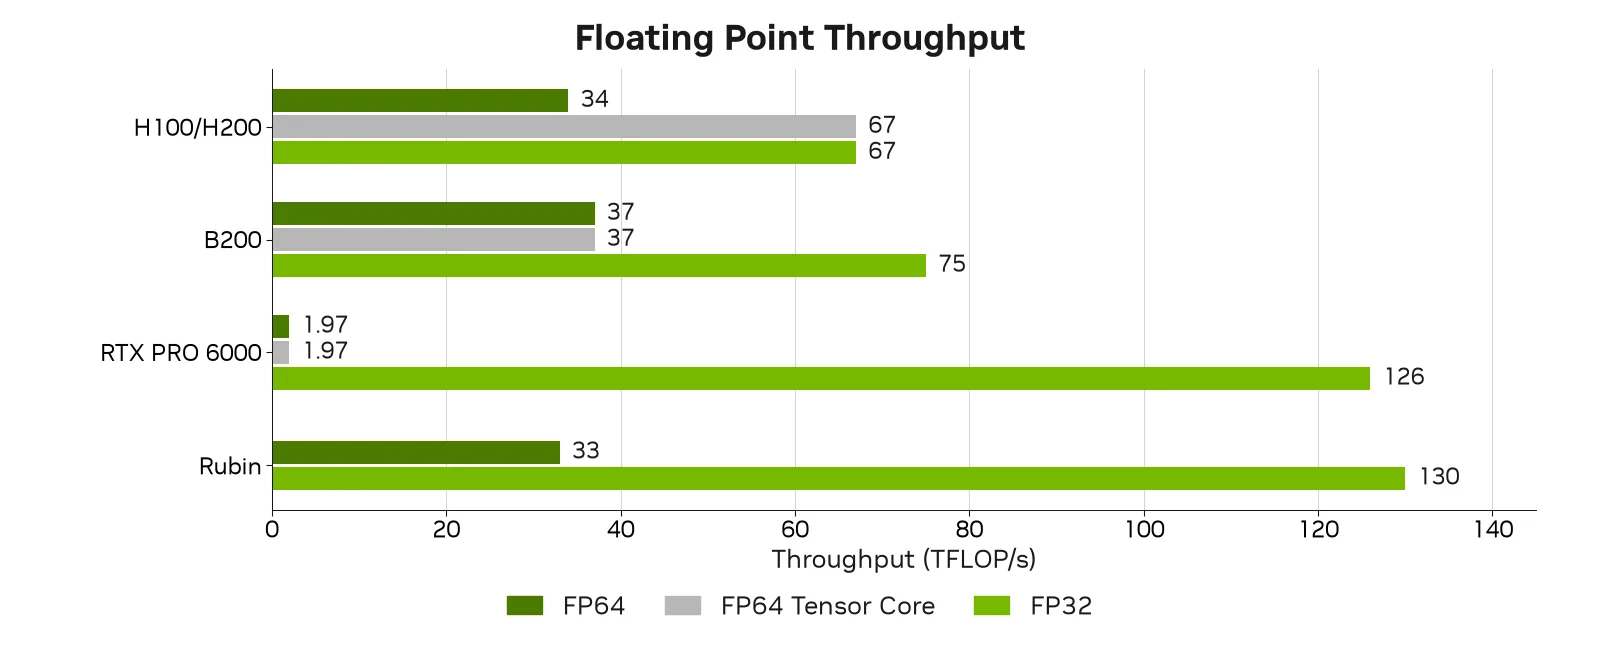
此外,平面波 DFT 通常在 FP64 中运行,这是一种保守的默认设置,可保证整个求解器工作流的准确性。但在这方面,GPU 硬件已不再是对称的。在数据中心 GPU 上,NVIDIA Hopper、Blackwell 和 Rubin GPU 的 FP64 吞吐量一直保持稳定,而 FP32 吞吐量继续增加。推理级 GPU 和 RTX PRO 6000 等工作站 GPU 以 64:1 的 FP32:FP64 比率进一步推动了这一趋势 (图 1) 。随着 AI 工作负载推动硬件开发转向较低精度的数据类型,仅适用于 FP64 代码的峰值 GPU 吞吐量所占的比例停滞不前。
Daviator:批量处理 K-Point 以实现 GPU 饱和度
Daviator 是 NVIDIA 开发的 GPU 内核库,可将平面波 DFT 内循环中的连续每 K-Point 处理替换为批量 GPU 运算。该转换的核心在于批量 Davidson 特征求解器,该求解器可将导致延迟的顺序循环替换为批量 FFT、GEMM 和自定义内核。这大大减少了 GPU 内核启动次数,使 SM 占用率从容量的一小部分变为接近饱和。数据始终驻留在 GPU 显存中。VASP 保留对 SCF 循环、混合、对称和 I/ O 的全部所有权;Daviator 以定义明确的调用边界与设备上的现有数据集成。
运行计算
通过在 INCAR 中设置 LDAVIATOR = True,您可以通过 NVIDIA ALCHEMI VASP 微服务使用 Daviator。现有 VASP 输入无需修改即可工作。下面的 POSCAR、INCAR 和 KPOINTS 是 K-Point 密度金属系统的标准设置。
Daviator 在内部截取 Davidson 求解器 ( ALGO = Normal) ,并通过批量 GPU 运算对其进行路由。
POSCAR:
Fe1
1.0
   2.3017038599999999    0.0000000000000000   -0.8137751999999999
  -1.1508519300000000    1.9933340200000000   -0.8137751999999999
   0.0000000000000000    0.0000000000000000    2.4413256099999998
Fe
1
direct
   0.0000000000000000    0.0000000000000000    0.0000000000000000 Fe
INCAR:
ALGO = Normal
LDAVIATOR = True
EDIFF = 5e-05
IBRION = 2
ISIF = 3
ISMEAR = 1
ISPIN = 2
NBANDS = 12
NSIM = 6
LASPH = True
LMAXMIX = 4
LORBIT = 11
LREAL = False
LWAVE = False
MAGMOM = 1*5.0
NELM = 100
NSW = 3
PREC = Accurate
SIGMA = 0.05
KPAR = 1
KPOINTS:
Gamma-centred 30x30x30 mesh
0
Gamma
30 30 30
Daviator 的一些 GPU 内核专为满足的批量大小而设计,首次使用时可能会触发编译。
在启动 VASP 之前将这些行添加到您的工作脚本中,以确保高效缓存:
export CUDA_CACHE_PATH=/tmp/cudacache   # fast storage, not $HOME
export CUDA_CACHE_DISABLE=0             # make sure caching is on
最后,照常运行:
mpirun -np 1 vasp_std目前,采用 Daviator 的 VASP 仅限于单节点执行。多节点支持、非共线旋转系统 (vasp_ncl) 和仅显式运行 gamma 的系统 (vasp_gam) 预计将在稍后阶段发布。
结果
以下基准测试将 Daviator 与 NVIDIA H100/ H200 和 B200 上的 VASP 6.6.0 CPU 和 OpenACC 基准进行了比较。
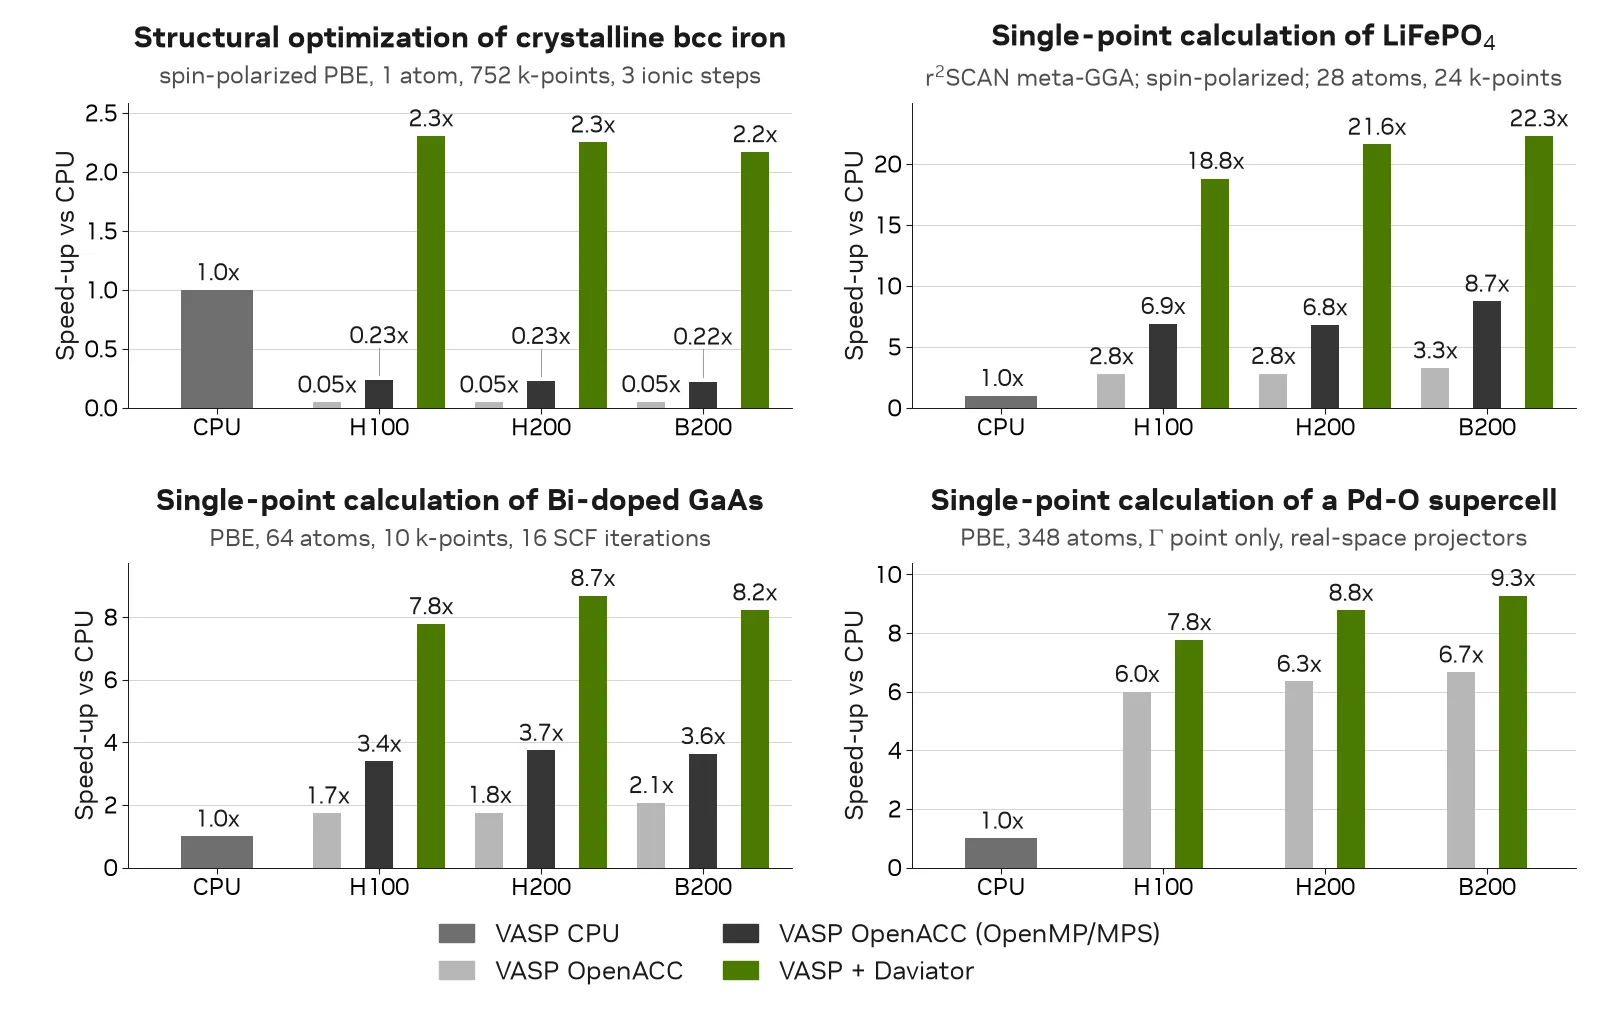
Daviator 克服了 OpenACC 端口的限制;相对于 CPU 基准,单个铁原子的速度提升了 2 倍以上 (图 2) 。精度更高的泛函得到提升:LiFePO4 r2SCAN 上的 Davidson 加速提高了 22 倍,能够在生产规模上实现更高的精度 Meta-GGA 运行。
对于 64 原子双杂化结构等中型系统,搭载 Daviator 的 VASP 可将执行时间缩短 85% 以上。即使只有 348 个原子和一个 K-Point,Daviator 也能显著改进 OpenACC 和 CPU 基准。VASP with Daviator 改进了之前所有系统尺寸的先进技术,无需根据系统大小在 CPU 和 GPU 之间分配作业。
借助混合精度实现更高的精度
Daviator 消除了 K-Point瓶颈,但目前依赖于 FP64 算法和存储。GPU 硬件正在转向较低精度的数据类型,而适应混合精度的 HPC 代码可以从现有硬件中重新获得显著的性能。
要进一步提高吞吐量,尤其是在高 FP32:FP64 比率的 GPU 上,需要利用 FP32 单元,但开发混合精度 Davidson 求解器并非易事。Davidson 工作流中的每个内核并非都具有同等的精度敏感度,但只需在 FP32 中运行每个内核并与 FP64 进行比较,就会得到通过/ 失败的结果。
此外,故障可能是隐性的。硬故障显而易见:求解器会拒绝条件较差的输入。软故障不是:能量漂移、不正确的收、MD 轨迹离散,这些在临时检查时似乎是有效的。要想获得真正的混合精度,需要确切了解精度边界所在的位置。
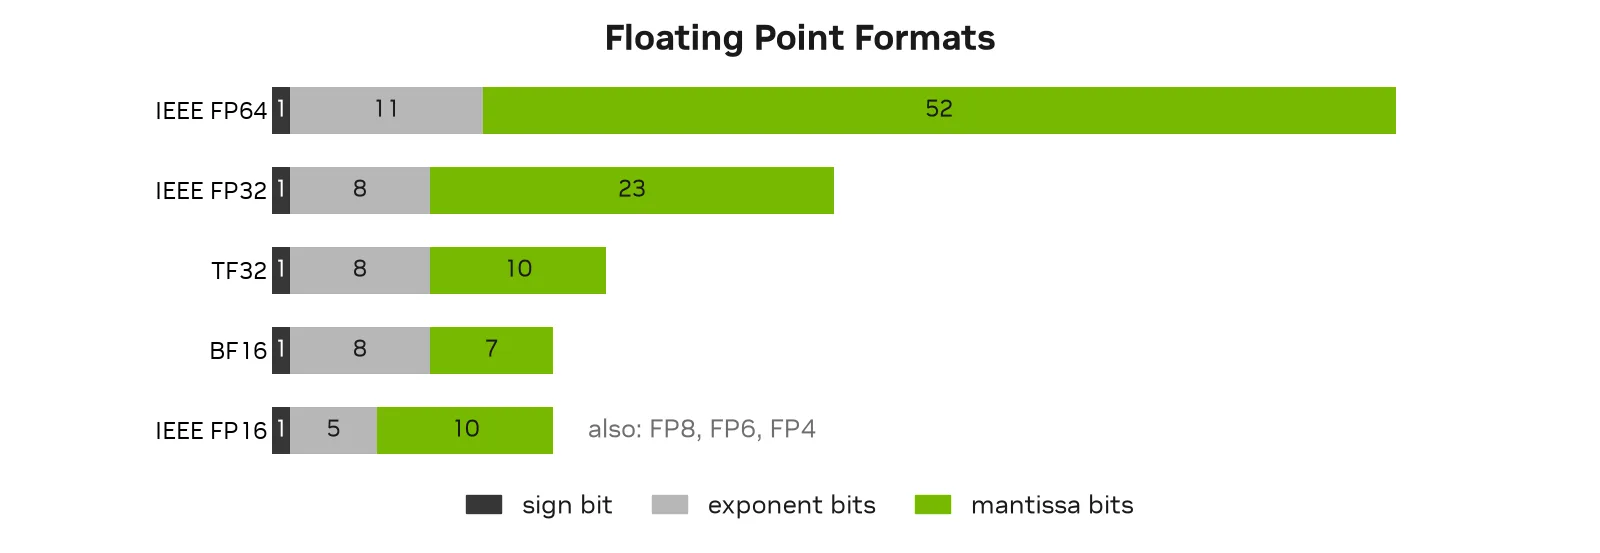
通过使用具有可配置尾数和指数位的通用浮点类型,我们可以确定每个仍能生成正确结果的最小所需位数。下一节将介绍精度要求分析的一般工作流程,该工作流程也可根据其他代码进行调整。
了解每个内核的确切精度要求,可以告知是否将其切换到 FP32、改进实现以将其引入 FP32 范围,或将其保留为 FP64 孤岛。
实现此方法在很大程度上取决于特定代码,但始终需要以下构建块:
- 代码的仪器化版本,使用具有可配置尾数和指数位计数的通用浮点类型。
- 使用特定精度设置和输入执行代码的运行脚本。
- 比较脚本,用于根据引用检查结果的准确性。
- 筛选脚本为每个内核多次运行仪器代码,首先是减少尾数位,直到比较失败,然后是最小的工作尾数大小和减少的指数位。
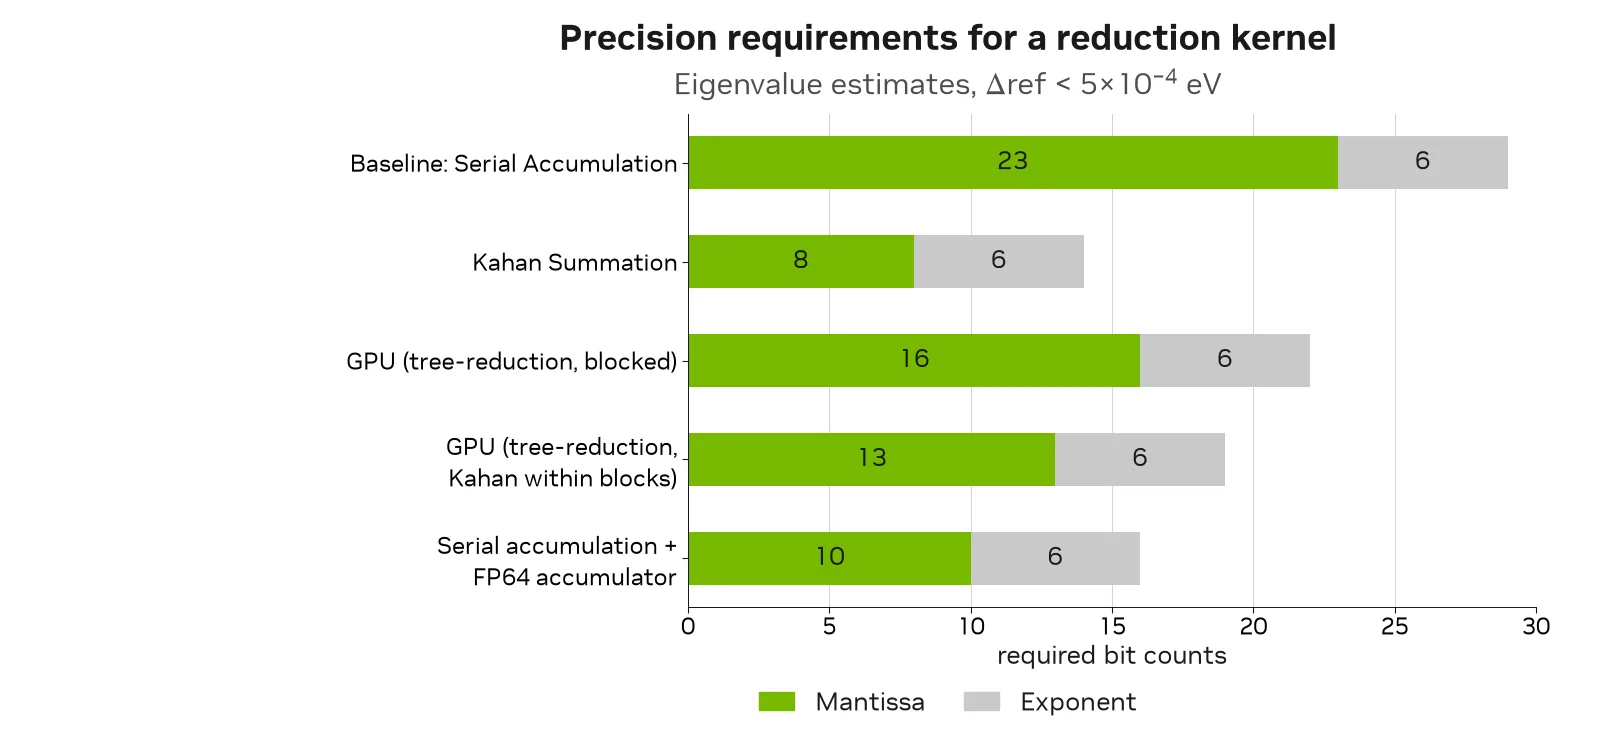
设置就绪后,在每次代码更改后重新运行筛选,以跟踪精度要求。不同归约核函数实现的测量精度要求各不相同 (图 3) 。
结果取决于输入和比较值。此处,所有内核都将通过简单的 FP32 运行 (图 4) ,而无需深入了解数值属性。如果输入量稍大或进行更严格的比较,基准可能会失败。算法选择可能还会受到其他限制。
代码分析可在三个级别上执行:
- 库级别:一些库提供可配置的精度,但程度有限。例如, cuBLAS 中的模拟矩阵乘法允许通过显式设置尾数位计数来筛选 GEMM 的精度要求。
- The 语言级别: 原生浮点类型可以替换为通用类型。 NVIDIA CCCL 提供这种类型,具有尾数位和指数位的编译时和运行时配置。
- 编译器级别:通过在编译期间将浮点运算替换为软件实现,可以实现完全非侵入性且主要是自动化的仪器分析。 Verificarlo 项目在其 VPREC 后端采用这种方法,但仅限于 CPU 代码。
完整的仪器还涵盖依赖项和标准数学函数。分析代码的速度要慢得多,但可以在 HPC 资源之间进行大量并行运行。
要从分析转向实施,请先围绕应用的热路径或其子集添加 FP64+ FP32 转换基础架构。然后,在该区域创建函数和核函数的可类型配置版本。在初始实施中,将超出 FP32 要求的所有内容保留为 FP64 孤岛;后续每次迭代都可以进一步减少 FP64 占用空间。
按照此工作流程,对基于 Verificarlo 的 Davidson 算法的原始分析表明,代码的大部分可以使用 FP32 算法和存储运行。FFT、哈密顿量的应用和轨道更新均在 FP32 中运行,而子空间特征问题、子空间矩阵背后的高瘦 GEMM 以及能量和收度量仍在 FP64 中运行。
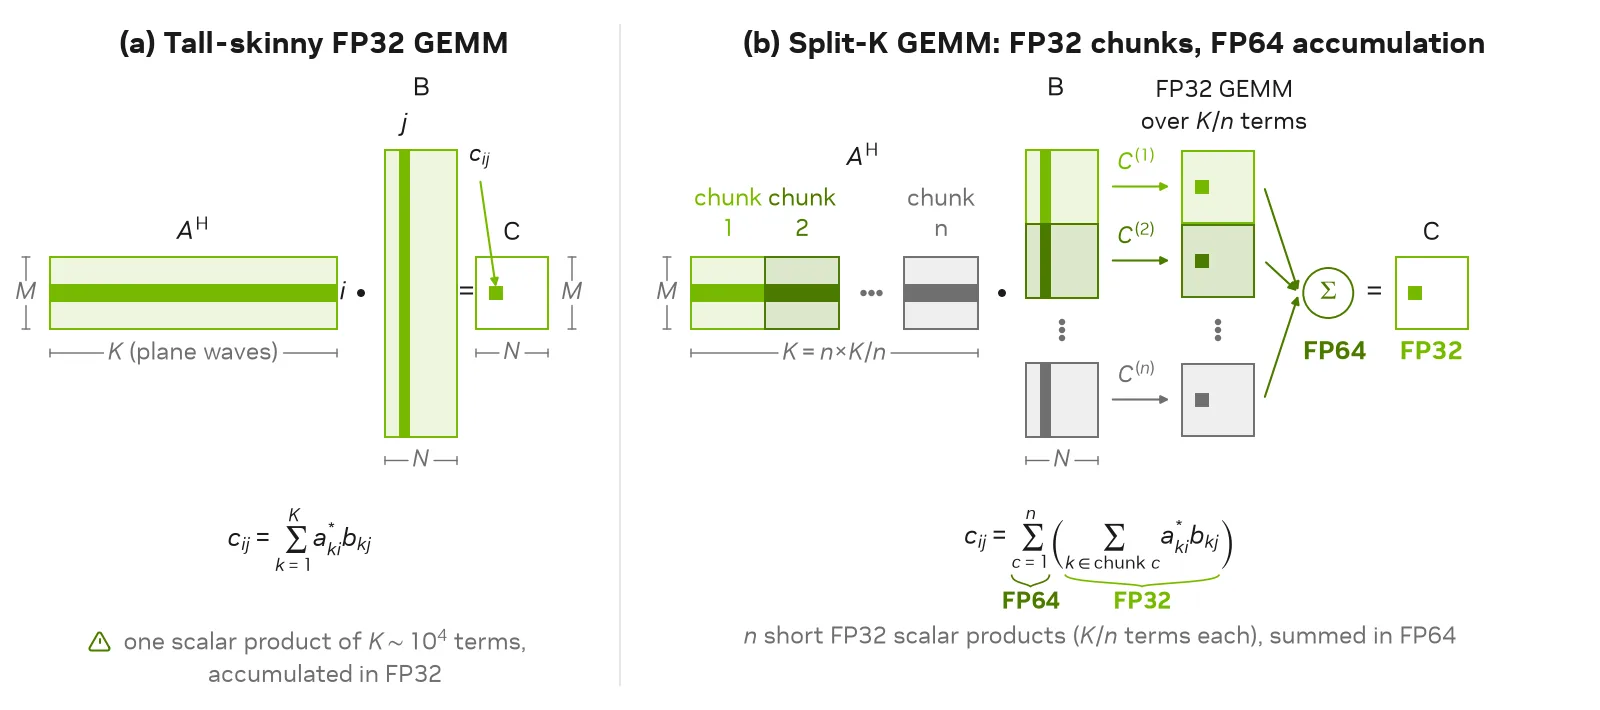
Rayleigh-Ritz 投影中高瘦 GEMM 是 FP64 的剩余瓶颈。此处的纯 FP32 累加是不够的,因为输出直接输入到数值敏感的特征值求解器中。split-k 算法通过最后的 FP64 累加步骤将点积分解为 FP32 块来解决此问题 (图 5) 。
结果
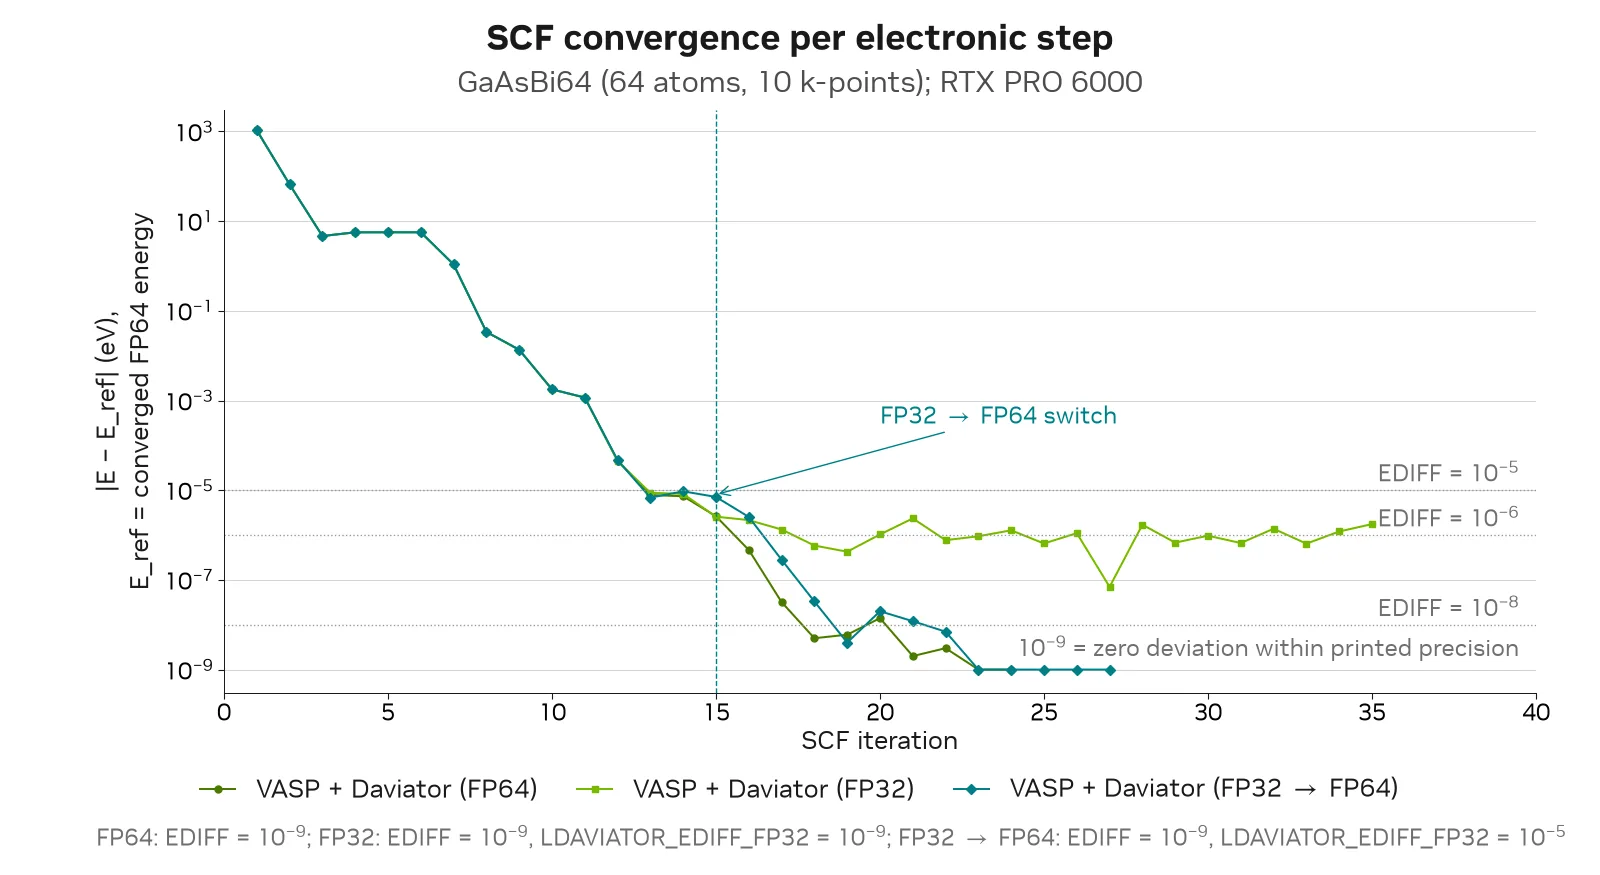
在 VASP 中,收由 EDIFF 参数控制,该参数指定了离子步骤内电子迭代之间的总能量变化值。低于该值,即可达到收。
默认值为 10-4 eV,而部分计算值则降至 10-6 eV 或更低。作为参考,FP32 提供了大约 7 位重要的小数位精度。EDIFF 是一个绝对值,因系统而异,通常随原子数量而扩展,因此没有单一的最佳设置。
混合精度 Davidson 实现会收到 10-4 到 10-6 eV 的 EDIFF,具体取决于输入;继续使用 FP64 允许计算在 FP32 噪声本以下收。在 GaAsBi-64 上,FP32 在 EDIFF = 10-5 eV 时可将速度提高 2%,而在 EDIFF = 10% eV 时,FP32+ FP64 的组合运行速度比纯 FP64 快 1.5% (图 6) 。
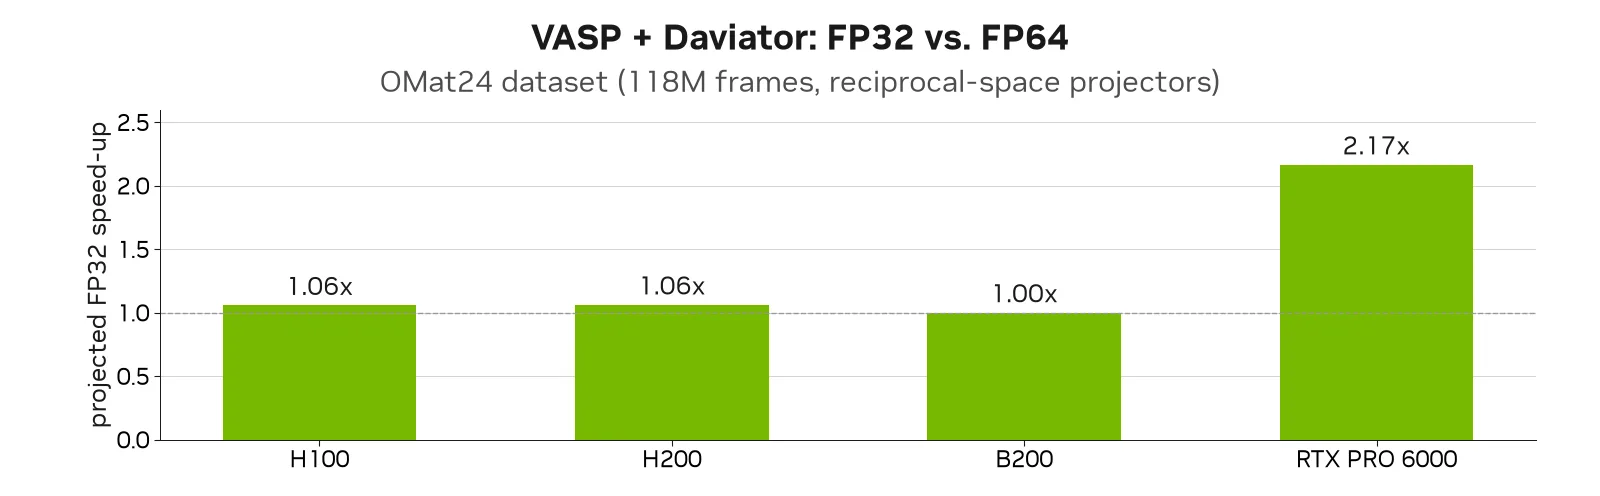
在 FP64 Tensor Core 与 FP32 吞吐量相匹配的 H100 和 H200 上,混合精度只能提供有限的端到端增益。其优势主要集中在具有高 FP32:FP64 比率的硬件上,例如 RTX PRO 6000,其中 FP32 Davidson 求解器的运行速度提高了 3 倍至 7 倍,可提供大约 2 倍的端到端加速 (图 7) 。
实现混合精度
通过将 LDAVIATOR_MIXED_PRECISION 设置为 1 ( 0 表示 FP64) ,可以启用 Daviator 的混合精度。在离子步长内,计算以混合精度 (使用 FP32 存储) 开始,直到达到可配置的值 DAVIATOR_EDIFF_FP32 或多个 SCF 步长 DAVIATOR_SWITCH_TO_FP64_AFTER_STEP。对于大多数输入,LAVIATOR_EDIFF_FP32 可在 10-4 到 10-5 的范围内正常工作。
以下 INCAR 参数可用于配置专为 Daviator 使用的混合精度 (表 1) 。
| INCAR 参数 | 价值观 | 说明 |
|---|---|---|
| LDAVIATOR_MIXED_PRECISION | 假 = FP64 真 = FP32 | 启用/ 禁用混合精度 ( FP32+ Daviator 中的混合运算和 FP32 存储) |
| DAVIATOR_EDIFF_FP32 | 电动汽车中的实际数量 > 0 | FP32 的 EDIFF 值 |
| DAVIATOR_SWITCH_TO_FP64_AFTER_STEP | 整数 N > = 0,在电子步骤 N 后切换到 FP64 ( N = 0 表示 FP64) -1 = 仅 FP32,即。收到 DAVIATOR_EDIFF_FP32,然后 stop-2 = dynamic。即。在 DAVIATOR_EDIFF_FP32 收后切换到 FP64 | 选择离子步进从降低精度切换到 FP64 的时间。 |
在 EDIFF = 5-5 eV 之前使用 FP32,然后在 EDIFF = 5-7 eV 之前切换到 FP64 的运行 INCAR 如下所示:
ALGO = Normal
EDIFF = 5e-07
[...]
LDAVIATOR = True
LDAVIATOR_MIXED_PRECISION = True
DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2
DAVIATOR_EDIFF_FP32 = 5e-05
硬件要求和可用性
需要 VASP 用户许可证。Daviator 及其混合精度选项将通过 NVIDIA ALCHEMI VASP 微服务在任何 NVIDIA GPU 上提供;添加上述 INCAR 参数即可激活。
这两层可大规模提供的内容
Open Materials 2024 (OMat24) 无机材料数据集包含超过 1 亿个 VASP 数据点 (总能量、力和应力) ,这些数据点来自分子动力学 ( “AIMD” ) 、松 ( “rattled-relax” ) 和静态 ( ““rattled” ”) 计算,用于 MLIP 训练和验证。
为了估算计算此数据集的时间和成本,我们从数据集系统大小分布中的 13 个具有代表性的输入的基准样本中推断。我们对单个基准运行进行了调整,以更大限度地提高资源利用率和整体吞吐量,前提是每个节点有多个并行运行。虽然 OMat24 是使用真实空间投影仪生成的,但此处的基准测试和投影使用 VASP 中更精确的倒数空间投影仪设置 ( INCAR:LREAL = False) 。
在相同数量的云实例上,VASP+ Daviator 在 CPU 节点上的速度比 VASP 快 22 倍,在 GPU 上不使用 Daviator 的情况下,比 VASP 快 7 倍 (图 8) 。对于一个 GPU 上的 8 个小型系统,NVIDIA ALCHEMI VASP 微服务将吞吐量进一步提高了 3 – 5 倍。
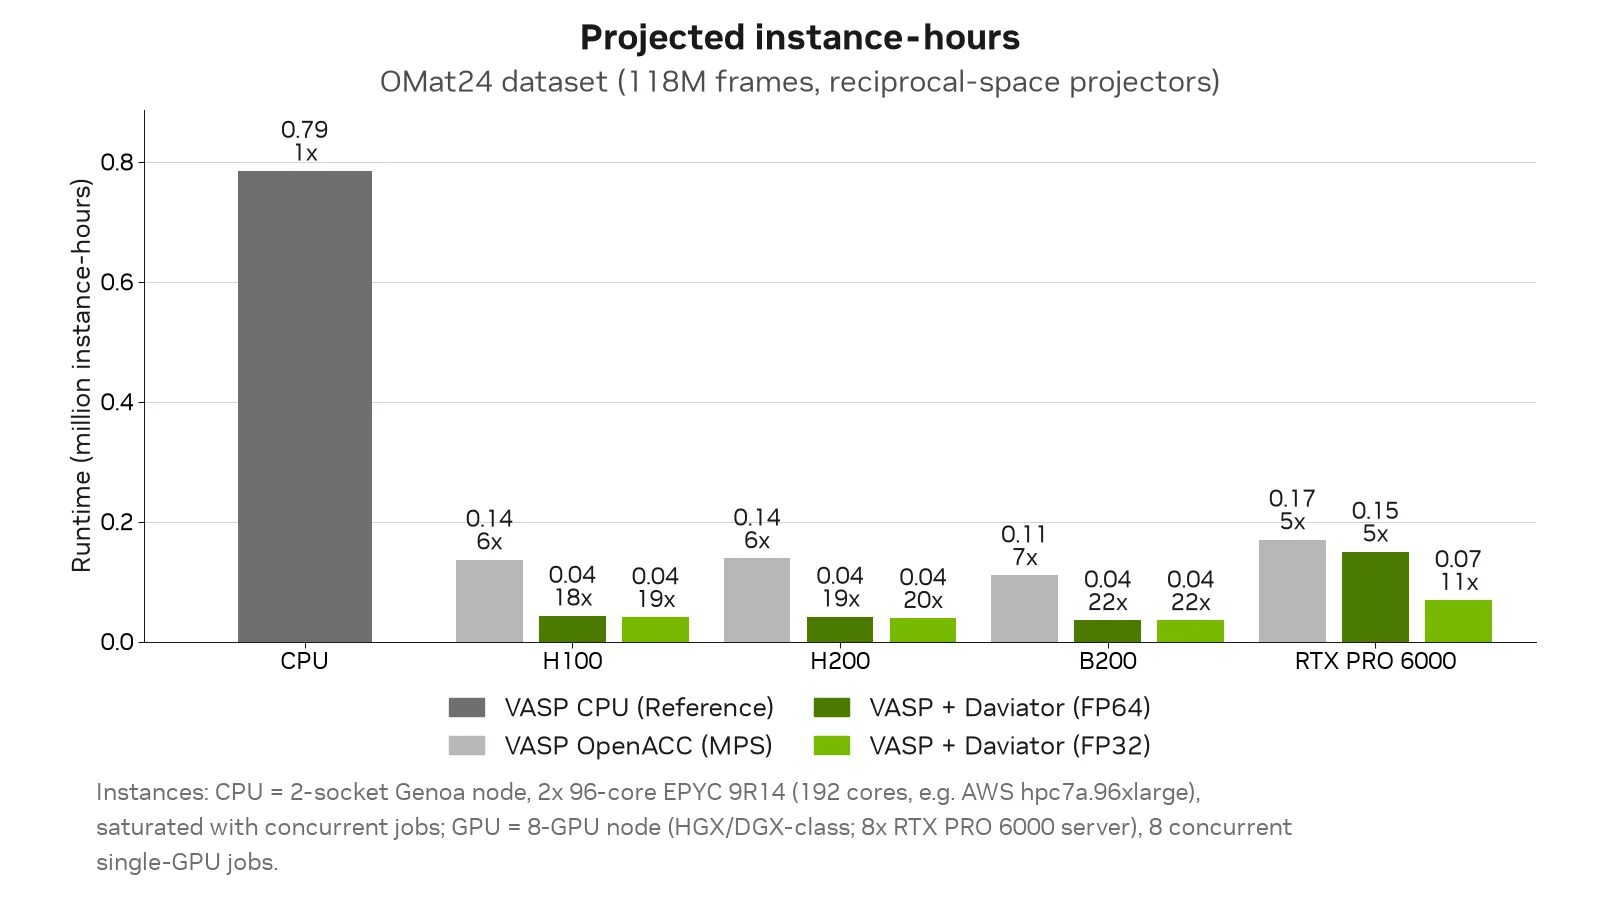
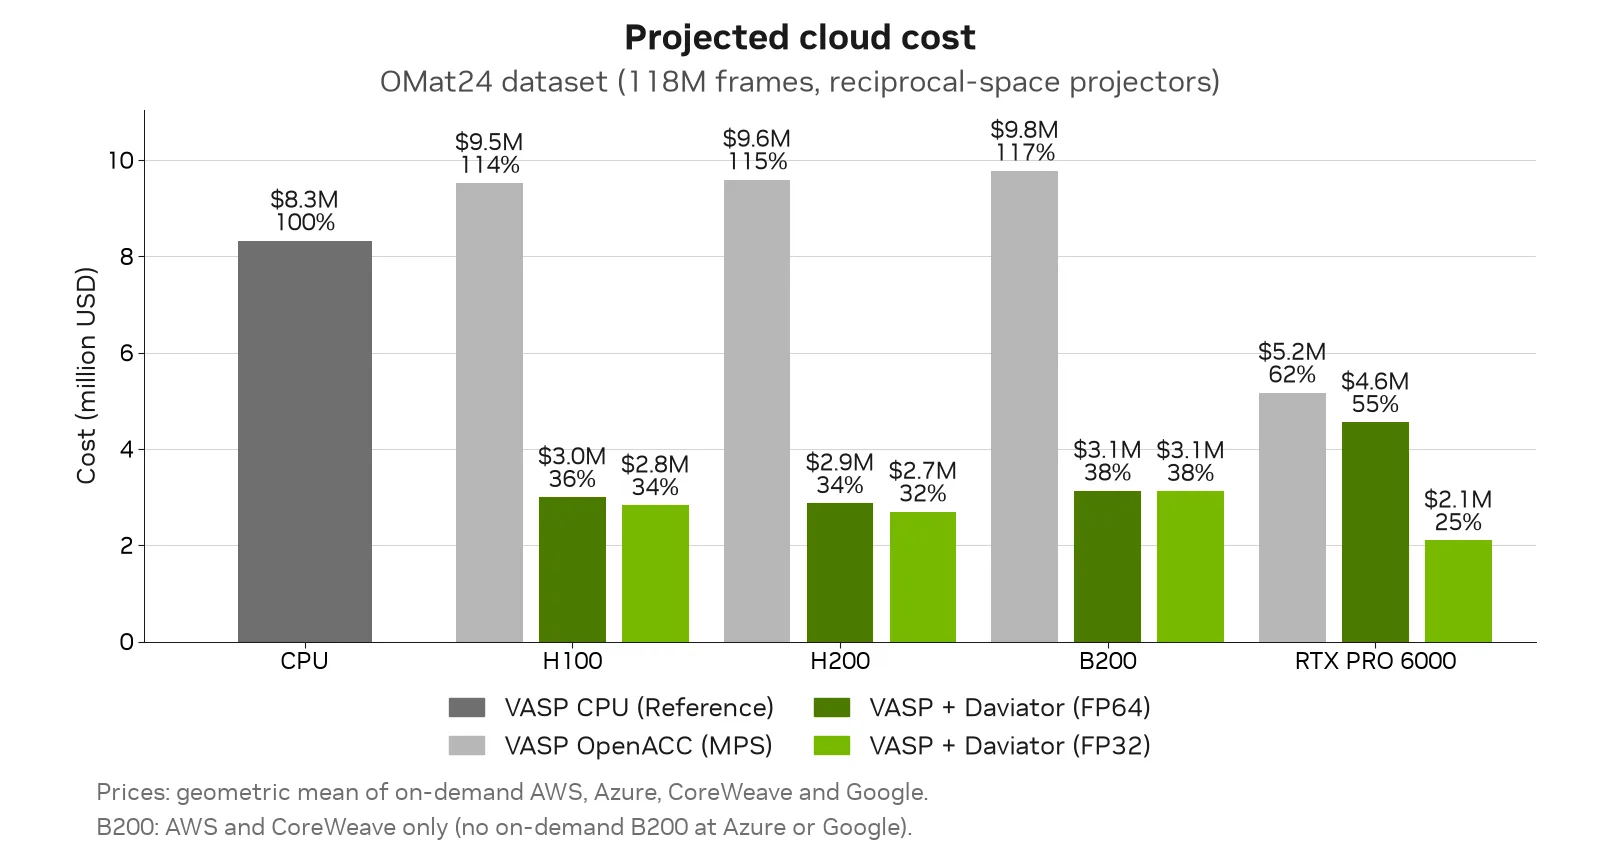
为了估算数据集生成的价格,我们应用了 AWS、Azure、CoreWeave 和 Google 按需价格的几何平均值。在数据中心 GPU 上,VASP 中现有的 OpenACC GPU 支持比相应的 CPU 计算更昂贵。
但是,与 Daviator 的结合可将 H100/ 200 和 B200 的 CPU 成本降低至约 35%,混合精度可额外节省高达 20 万美元。RTX PRO 6000 使用搭载 Daviator 和 FP32 的 VASP 实现了整体的最低价格点 (约为 CPU 成本的 25%) (图 9) 。
GPU 原生 DFT 的未来发展方向
对于标准 DFT,GPU 现在是 VASP 的明确选择。对于以 OMat24 及更大规模构建 MLIP 训练流程的团队,VASP™ Daviator 提供了端到端 GPU 原生工作流,成本比 CPU 节省了 60 – 75%,对于 OMat24 大小的数据集,成本约为 500 – 600 万美元。
对于运行 RTX PRO 6000 或其他具有高 FP32:FP64 比率的 NVIDIA GPU 的团队,混合精度的速度比 FP64 快 2 倍,其优势超越了数据集生成。Daviator 还提供了以前在 GPU 规模上无法实现的工作负载分类。像 R* SCAN 这样的 Meta-GGA 功能现在可以用于生产;据报告,LiFePO® 的加速可能会使电池、催化剂和有缺陷的数据集的更高精度 DFT 触手可及。
致谢
VASP 开发团队和 Akhilesh Mishra 为此博文做出了贡献。


