

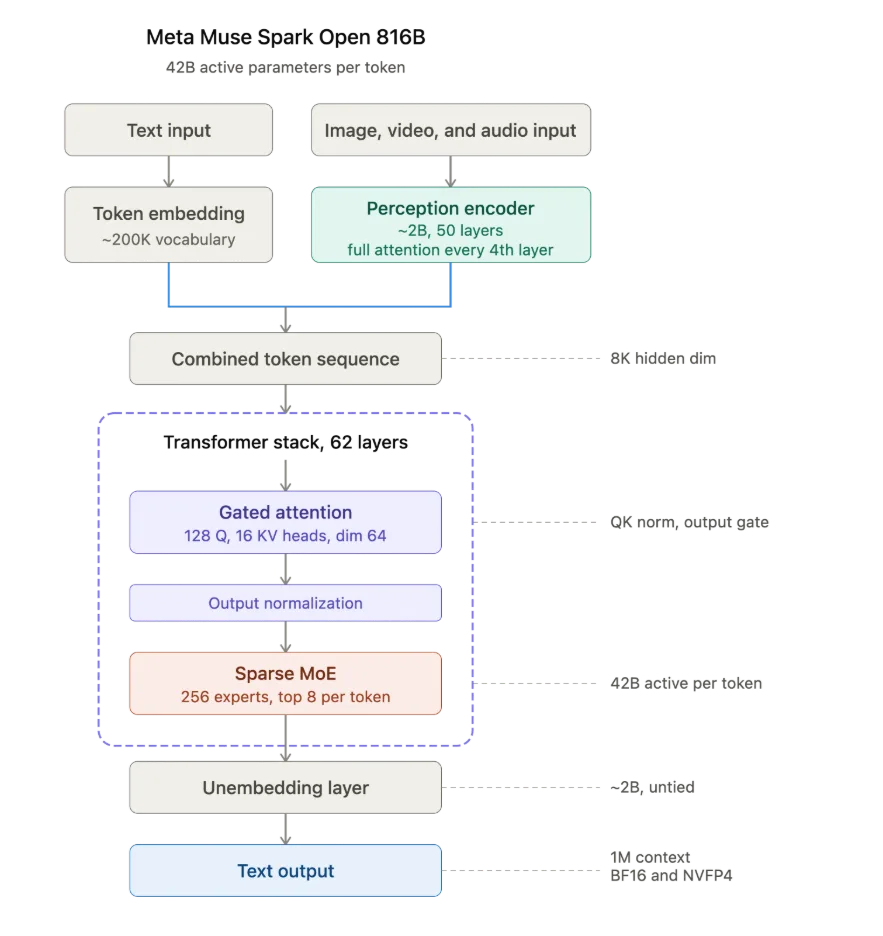
Meta 推出 Muse Spark Open,这是一个经过编码优化的 816B 混合专家 (MoE) 模型,具有 42B 个活动参数和 100 万个 token 上下文窗口。它在 NVIDIA GB300 NVL72 Blackwell Ultra 上专门针对代理式编码工作流进行训练,可提供更高的首次尝试准确性、可靠的工具调用以及跨资源库的深度代码库理解。100 万 token 上下文窗口可保存整个项目,包括复杂的依赖项、旧版代码和数千个文件,而无需将任务分解为多个部分。
作为一种推理模型,由 Meta 生成并针对 NVIDIA Blackwell Ultra 优化的 NVFP4 检查点通过原生 FP4 Tensor Core 加速缩小了所有 816B 参数的内存占用。减少每个 token 的移动字节数以增加每个用户每秒的 token 数,释放的内存支持更大的 KV 缓存,可用于并发长上下文会话,从而提供更高的吞吐量和更低的每 token 成本。
为跨文本、图像、视频和音频的代理式编码多模态理解而定制
通用编码模型针对单次完成进行了优化,例如生成函数、编写单元测试或建议内联修复。在上下文较少且答案显而易见的情况下,它们擅长处理分散的、范围很广的任务。代理式编码需要一些截然不同的东西。规划多文件重构、处理数千个文件、从失败测试中恢复以及长时间协调子代理,都需要一个专为持续的多步骤工作而构建的模型。
Muse Spark Open 专为这些工作负载而构建,可提供更高的首次尝试准确性、可靠的工具调用以及跨资源库的深度代码库理解。它负责规划、行动、观察和自我纠正。它支持多步骤任务执行,包括工具使用、输出评估和迭代优化。该模型使用目标调节来保持方向和上下文规整,以保留在长时间运行的会话中保持进展所需的知识。通过 100 万 token 上下文窗口,它可以保存整个项目,包括复杂的依赖项、旧版代码和数千个文件,而无需将任务分解为多个部分。
除了编码,它还可以搜索网页 (包括多模态浏览) ,生成并协调子智能体以执行可分解任务,并利用跨桌面、移动设备和浏览器统一的计算机使用功能。它在每个动作之前都会生成单独的评论,以便开发者了解智能体在做什么以及原因。
该模型的 18 亿感知编码器可原生处理交错的文本、图像、视频帧和音频,而无需为每种模态配备单独的工作流。这意味着模型会对其在单个统一通道中看到、听到和读取的内容进行推理。这适用于同一智能体会话中涵盖屏幕截图、图表、错误日志和视频演练的开发者工作流。稀疏 MoE 路由仅激活每个 token 8160 亿个总参数中的 42B,以同等规模下密集模型的服务成本的一小部分提供前沿代理能力。
在 GB300 NVL72 上实现 Muse Spark Open 的优化性能
NVIDIA GB300 NVL72 采用机架级架构,将 72 块 NVIDIA Blackwell Ultra GPU 集成到单个平台中。其 72-GPU 的大型 NVIDIA NVLink 域可实现 130 TB/s 的高效通信,消除了专家流量必须通过传统现有网络时出现的瓶颈。对于像 Muse Spark Open 这样的稀疏 MoE 模型,它将每个 token 路由给八个 (共 256 个专家) ,这种带宽直接决定了部署实现的理论吞吐量。
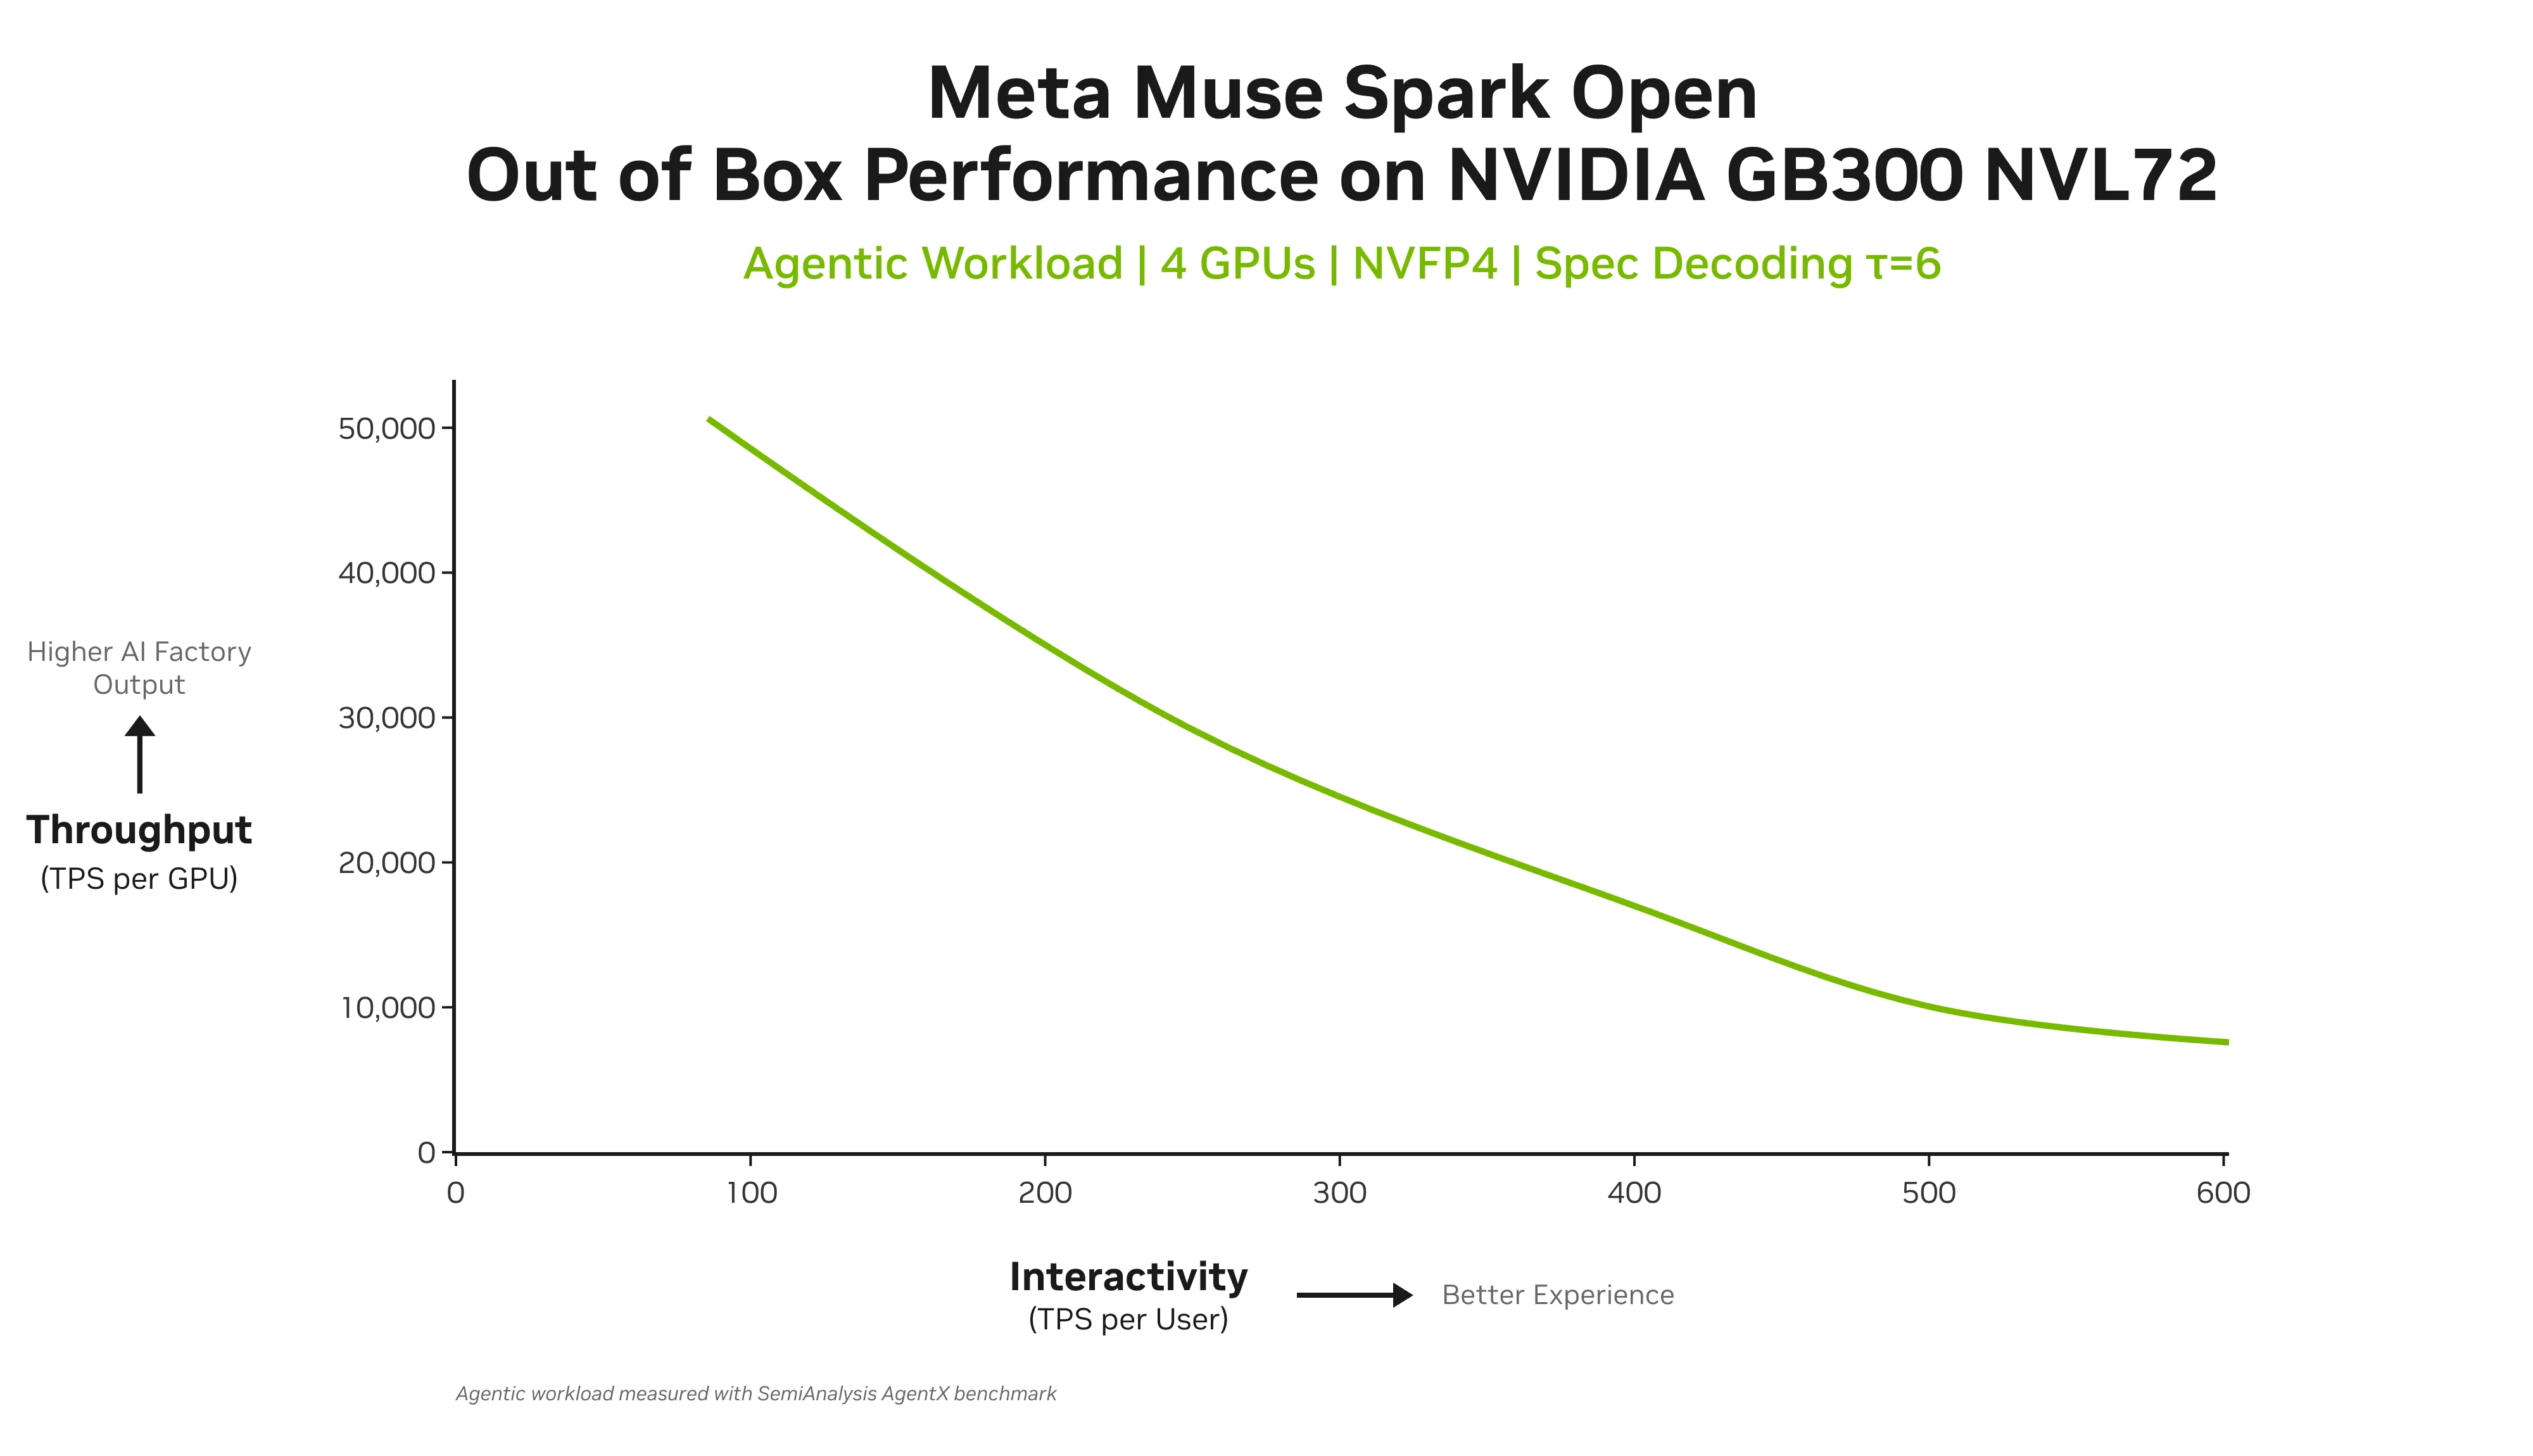
代理式工作负载将静态的单轮交互转化为多步骤工作流,从而进行推理、调用工具、协调子智能体,并将不断增长的上下文带到下一个回合。在 NVIDIA GB300 NVL72 上运行代理式工作负载的 Muse Spark Open 开箱即用,每个 GPU 每秒可提供高达 50K 个 token,每个用户每秒可提供高达 600 个 token,使 AI 工厂能够在生产中以高吞吐量和低延迟运行大参数模型。
适用于 Muse Spark Open 的灵活部署选项
NVIDIA 支持多个推理堆栈,可满足开发者的各种需求。SGLang,vLLM和TensorRT LLM,开发者可以直接控制 NVIDIA 加速计算平台上的服务配置、并行性和批处理。TensorRT LLM 增加了针对 NVIDIA GPU 调整的编译引擎。NVIDIA Dynamo发布这三种方法的部署方案,并在专用 GPU 池中将预填充与解码分离开来,因此受计算限制的提示处理不会减缓 token 生成速度。其 KV 缓存感知路由将每个请求发送给已持有相关前缀的工作者,从而避免预先计算,因为上下文会在长代理式会话中累积。
使用 NeMo AutoModel 和 Megatron 桥接器进行后训练的 Muse Spark Open
开发者可以使用 NVIDIA NeMo AutoModel,在特定领域的数据集上对 Muse Spark Open 进行后期训练。它支持开箱即用的完整 SFT 和 LoRA 微调,并针对各种行业特定案例的快速实验进行了优化。
当开发者准备进行大规模生产规模训练时,还可以利用 NVIDIA Megatron Bridge 将 Hugging Face 检查点转换为 Megatron 格式,以利用优化功能。
开始使用 GPU 加速的 Muse Spark Open
要开始使用,请从 Hugging Face 下载 Muse Spark Open NVFP4 权重。对于生产部署,请试用可下载的 NVIDIA NIM。NIM 将设置减少到单个命令,将基准测试和调优周期替换为容器,该容器可自动为检测到的硬件选择最佳服务后端和精度。

