

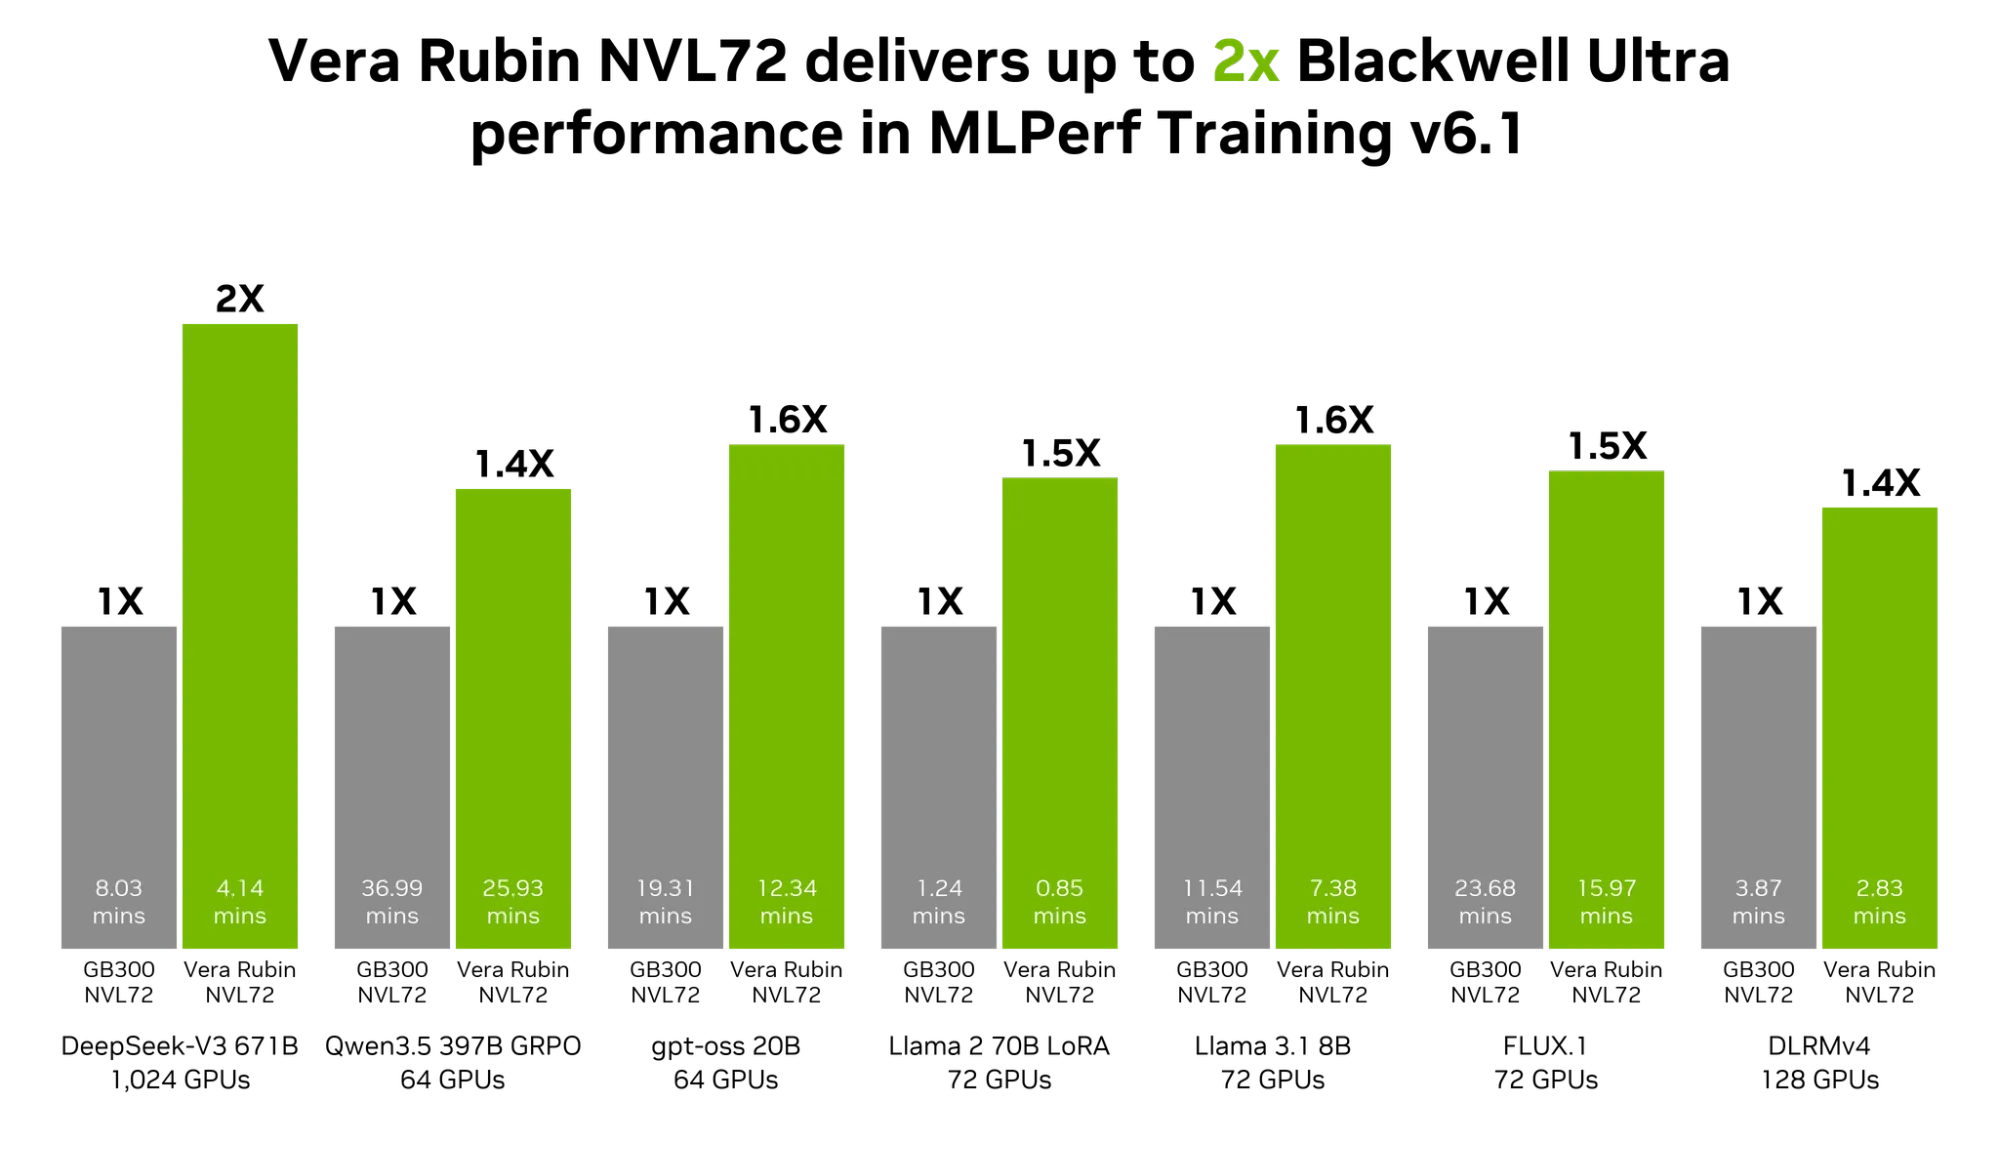
随着 AI 智能体处理日益复杂的工作流程,缩短训练时间对于快速迭代模型及其驱动的智能体至关重要。MLPerf Training v6.1 标志着 NVIDIA Vera Rubin 架构的首次亮相,这些早期结果证明其 CUDA 软件堆栈已经高度成熟。首次亮相时,Vera Rubin NVL72 平台在七个基准测试中的六个测试中实现了最快的训练速度,比高度优化的 NVIDIA GB300 NVL72 基准性能高 2 倍。
在第七项基准测试 (即 DeepSeek-V3 671B) 中,NVIDIA 在 10240-GPU GB300 NVL72 集群上展示了大规模性能,从而获得了本轮测试中的绝对最快速度。这种双平台方法刻意展示了这两个系统的优势。GB300 测试结果凸显了 NVIDIA 目前部署的大规模、可靠的集群规模,而 Vera Rubin 则展示了其卓越的扩展架构,在从 256 个 GPU 扩展到 1024 个 GPU 时,其整体效率保持在 97% 以上。NVIDIA 平台共同在 v6.1 中的每个基准测试中拥有更快的训练时间。
NVIDIA 平台也是唯一提交所有七个基准测试结果的平台,Vera Rubin 在其首次运行中成功完成了整个套件的测试。对于开发者而言,这种广度与任何顶级数字一样重要。这证明,从一开始就继承的性能提升涵盖了整个建模流程,全面支持从大规模预训练到现代 AI 智能体所需的强化学习后训练等所有内容。
在所有 MLPerf 训练基准测试中提供全面的 AI 性能
阅读本轮测试的最简单方法是使用基准测试:新平台在同一模型上为每个 GPU 提供了多少性能?
| 模型类型 | 基准测试 | GPU 数量 | Vera Rubin NVL72 与优化后的 GB300 NVL72 | 提交 ID (Vera Rubin/ GB300) |
|---|---|---|---|---|
| 混合专家模型 | DeepSeek-V3 671B | 1,024 | 2x | 6.1-0116 / 6.1-0030 |
| 混合专家模型 | Qwen3.5 397B GRPO ( RL) | 64 | 1.4 倍 | 6.1-0135 / 6.1-0020 |
| 混合专家模型 | gpt-oss 20B | 64 | 1.6 倍 | 6.1-0135 / 6.1-0049 |
| 密集 | Llama 2 70B LoRA | 72 | 1.5 倍 | 6.1-0123 / 6.1-0138 |
| 密集 | Llama 3.1 8B | 72 | 1.6 倍 | 6.1-0073 / 6.1-0138 |
| 扩散 | FLUX.1 | 72 | 1.5 倍 | 6.1-0124 / 6.1-0138 |
| 推荐系统 | DLRMv4 | 128 | 1.4 倍 | 6.1-0129 / 6.1-0038 |
MLPerfTraining v6.1 结果于 2026 年 11 月 16 日从 www.mlcommons.org 的以下条目检索到:6.1-0116、6.1-0030、6.1-0135、6.1-0020、6.1-0049、6.1-0123、6.1-0138、6.1-0073、6.1-0124、6.1-0129 和 6.1-0038。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org 。
MLPerfTraining v6.1 结果于 2026 年 11 月 16 日从 www.mlcommons.org 的以下条目检索到:6.1-0116、6.1-0030、6.1-0135、6.1-0020、6.1-0049、6.1-0123、6.1-0138、6.1-0073、6.1-0124、6.1-0129 和 6.1-0038。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org 。
模式很明确。最大的收益来自于最大、通信最密集的模型。虽然该平台在整个套件中的速度稳定在 1.4 倍到 1.6 倍之间,但在大规模 DeepSeek-V3 基准测试中,代际优势进一步扩大。
该套件涵盖自然语言、图像生成、推荐和强化学习,因此收益在多种模式以及不同的模型形状和架构中保持不变。
DeepSeek-V3 671B:在最困难的工作负载上,每个 GPU 的性能提升 2 倍
DeepSeek-V3 671B 是一个包含 6710 亿个参数的无下降 token 的多专家模型 (MoE) ,是该套件中要求最苛刻的工作负载。专家并行将每次迭代转化为多对多的突发通信,因此网络效率直接在训练时显示出来。
Vera Rubin NVL72 在 16 个机架中使用 1024 个 GPU,在 4.14 分钟内完成了基准测试训练。GB300 NVL72 在 8.03 分钟内运行了相同的 1024-GPU 配置,每个 GPU 接近 2 倍,是本轮最大的一次代际改进。将训练时间减半大约会使团队在一个季度内可以进行的实验数量翻倍,而实验吞吐量是影响模型质量的因素。
在更大范围内,GB300 NVL72 产生的绝对结果在本轮测试中最快:在 10240 个 GPU 上为 1.38 分钟。这是一项分布在 160 个机架上的训练作业,每个机架都有自己的 NVLink 域,它展示了平台的横向扩展结构在作业用完单个机架后很久仍处于停滞状态。
后期训练到来,由 Vera Rubin 领导
MLPerf Training v6.1 增加了其首个代理式 LLM 强化学习后训练基准测试 Qwen 3.5 397B GRPO ,反映了 AI 开发的根本性转变。后训练已成为提高代理准确性的关键差异化因素,使得 GRPO 工作负载具有独特的要求。生成部署、评分和更新权重的持续循环通过强制在推理引擎和训练引擎之间不断进行大规模权重迁移,将系统架构推向极限。
Vera Rubin NVL72 在 1024 个 GPU (6.1-0117) 下达到了这一新基准测试的最快时间 10.44 分钟,而在相同规模下,GB300 NVL72 (6.1-0031) 则为 13.78 分钟。Vera Rubin 平台还通过在两个不同的推理后端提交内容证明了其灵活性:使用 TensorRT-LLM 的 NVIDIA NeMo RL 需要 10.44 分钟,使用 vLLM 需要 10.94 分钟 (6.1-0118) 。这项新技术在基准测试上提供了两个可行的推理后端,这对软件的成熟度和芯片的成熟度都有同样的影响。
教授这些模型进行观察、推理和行动需要在模拟环境中运行每次部署,并执行工具调用、代码或 API 验证。由于驱动这些仿真受到强烈的 CPU 限制, NVIDIA Vera CPU 是该架构不可或缺的一部分,可在单个 Vera CPU 机架中跨 256 个 CPU 支持 22500 多个并发 RL 环境。
GPU 可处理大规模 token 生成和快速权重更新,而 Vera CPU 则同步模拟环境,确保加速器持续获得完善智能体工作流程所需的丰富反馈。
NVLink、Quantum-X 和 Spectrum-X:用于高效 AI 扩展的共同设计网络
上述每个结果也是一个网络结果。现代 AI 训练需要数千个处理器作为一个整体,NVIDIA 通过共同设计内部机架域和外部集群结构来解决这一挑战。
在机架内部,Vera Rubin NVL72 通过铜质 NVLink 6 Spine 连接 72 个 GPU 和 36 个 CPU。该 all-to-all 域可为每个 GPU 提供 3.6 TB/s 的性能,为每个机架提供 260 TB/s 的性能,从而使 MoE 专家调度偏离关键路径。在机架之外,该平台通过 ConnectX-9 SuperNIC 通过 Quantum-X800 InfiniBand 或 Spectrum-X 以太网进行扩展。为了管理突发 MoE 流量,两种网络都使用自适应路由和拥塞控制,以将多对多通信隐藏在计算层后面。
这种紧密结合的设计直接转化为效率。在 DeepSeek-V3 基准测试中,Vera Rubin NVL72 从 256 个 GPU 扩展到 1024 个 GPU ( 4 到 16 个机架) ,实现了超过 97% 的扩展效率。GB300 NVL72 展示了该平台的大规模功能,可扩展到 10240 个 GPU,以捕获本轮测试中最快的绝对结果。
由于 NVL72 架构提供了一致的 72-GPU 域,因此开发者可以在不改变其操作模型的情况下,每一代都能实现可预测的性能提升。每个周期都能在同一一致的网络上提供更多的计算和带宽。
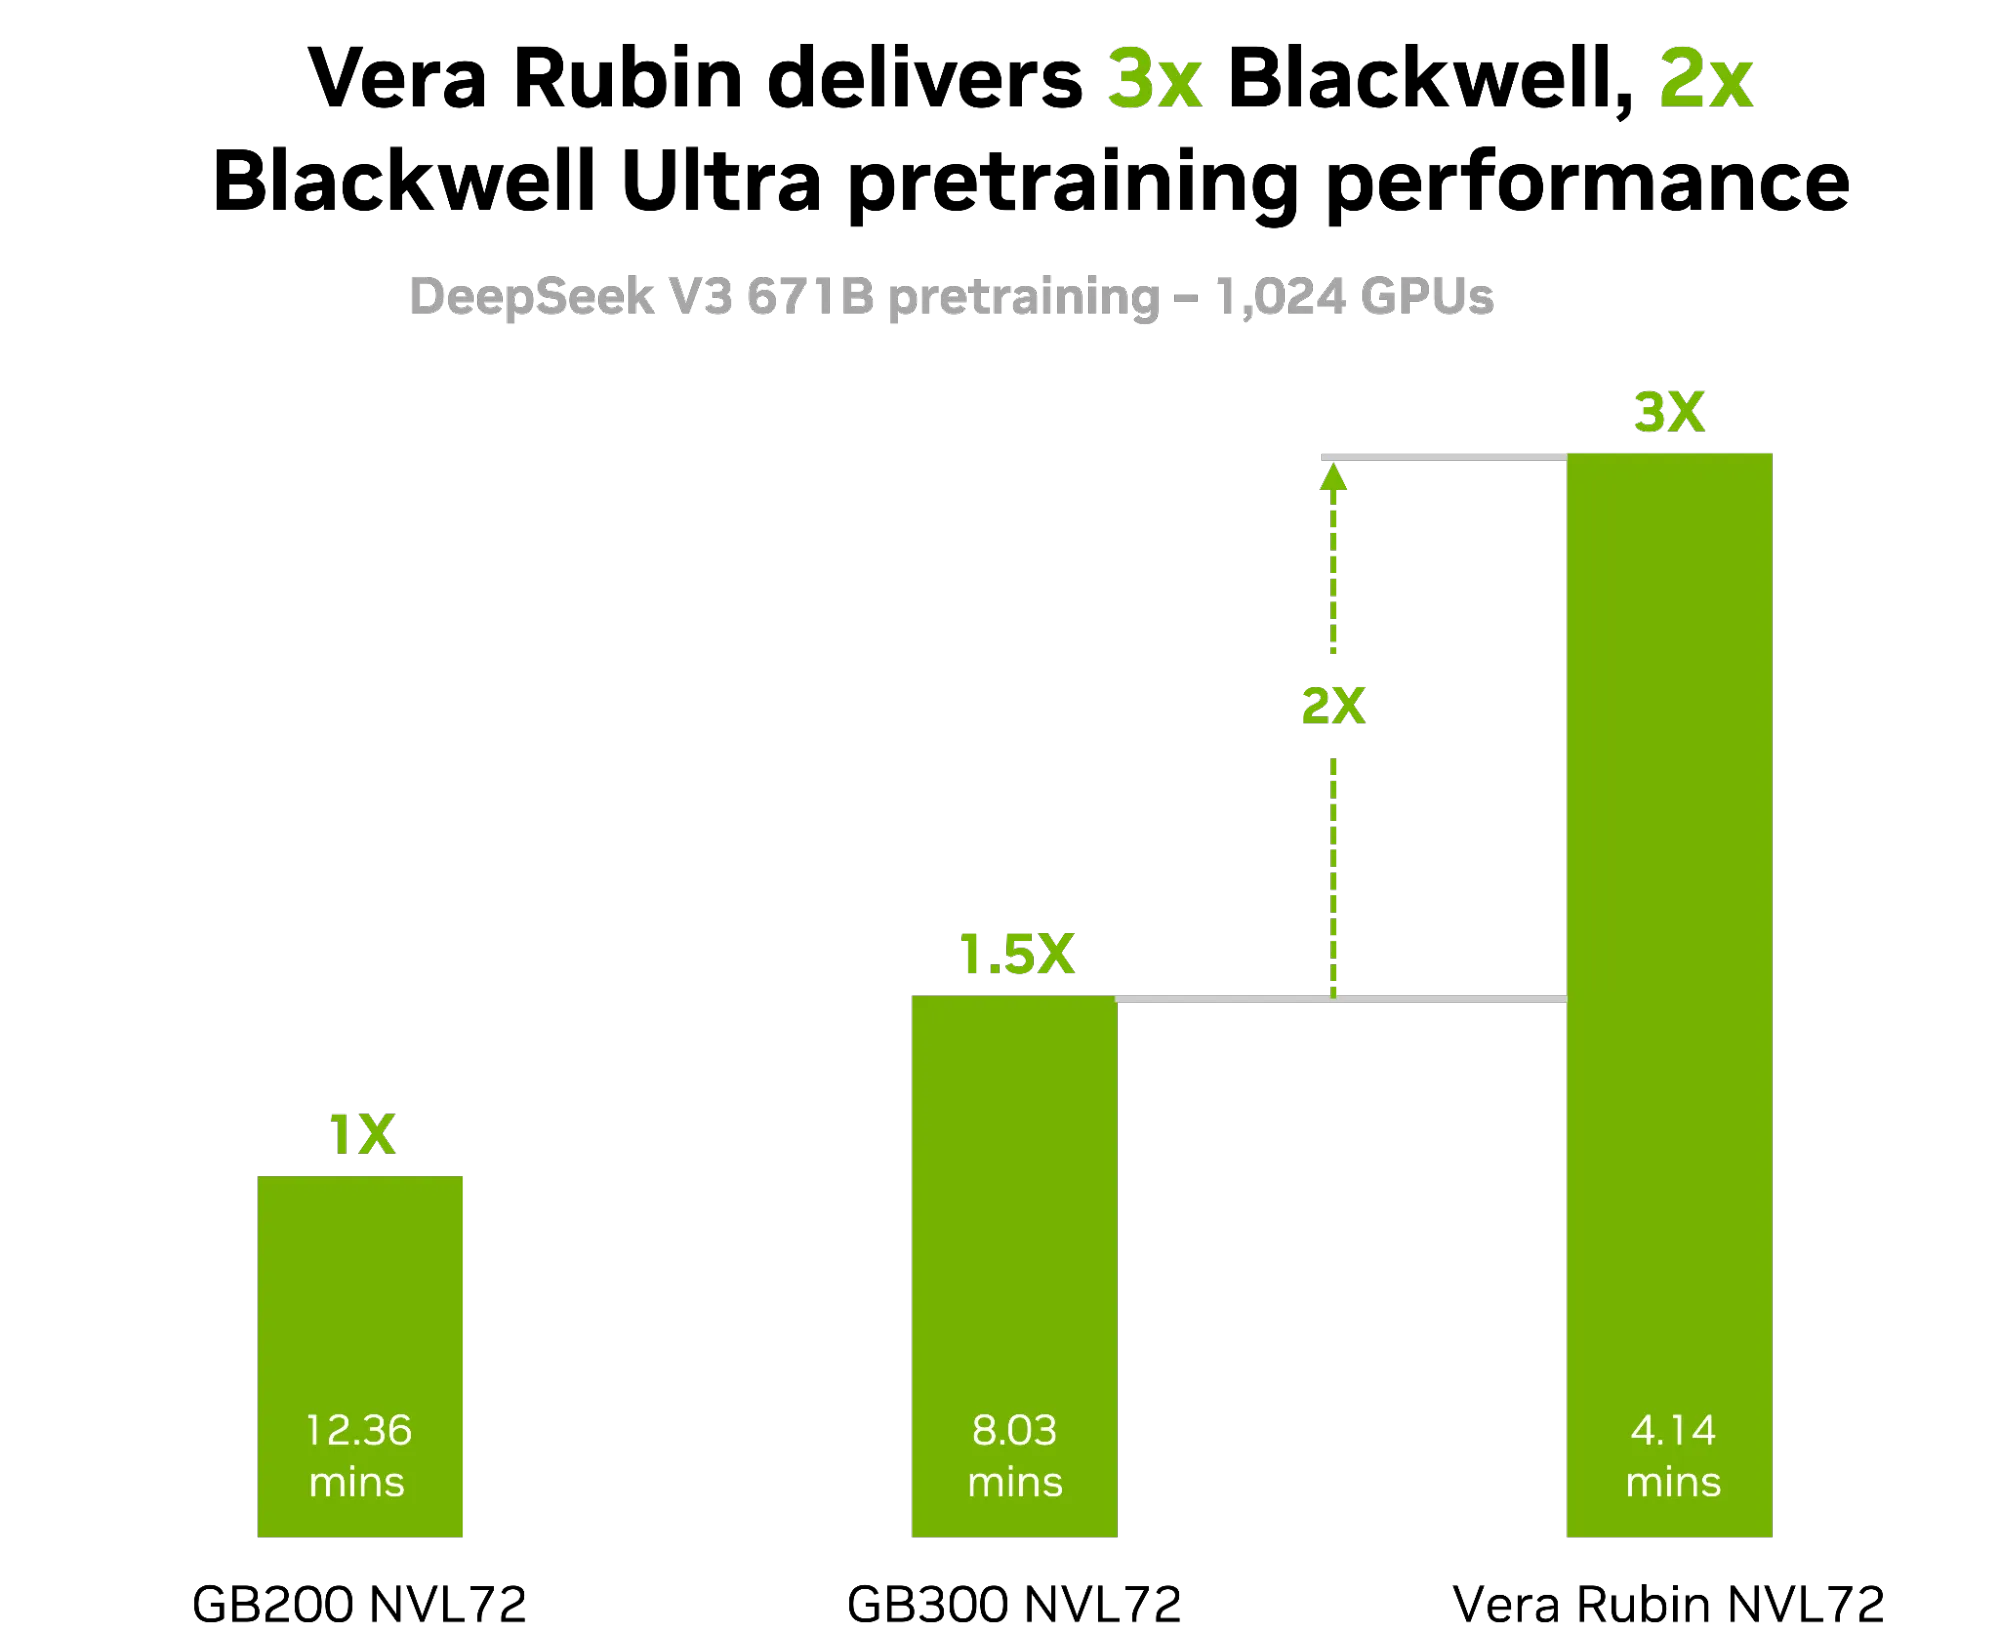
MLPerfTraining v6.1 结果于 2026 年 11 月 16 日从 www.mlcommons.org 的以下条目检索到:6.1-0045、6.1-0030 和 6.1-0116。比率四舍五入。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org 。
持续软件优化:无需硬件升级即可实现更快的预训练
Vera Rubin 的结果来自客户收到的 NVIDIA AI 软件堆栈:用于预训练基准测试的 NVIDIA NeMo Framework 26.09 、用于强化学习基准测试的 NVIDIA NeMo RL ,以及用于 FLUX.1 和 DLRMv4 的 NVIDIA PyTorch 版本。我们在 MLPerf Training v6.0 回合中介绍了这些优化。
回合结束后,堆栈也会不断移动。由于 v6.1 提交已完成,我们已在相同的硬件和配置上使用较新的软件版本重新运行了几个基准测试。这些是未经验证的结果,而不是 MLCommons 提交,我们分享这些结果,因为它们展示了持续优化如何使 NVIDIA 基础设施具有高产、耐用和可替代的特点。
| 基准测试 | GPU 数量 | GB300 NVL72 MLPerf v6.1 运行 (MLPerf ID) | Vera Rubin NVL72 MLPerf v6.1 运行 (MLPerf ID) | 2026 年 11 月未经验证的结果 GB300 NVL72+ | 2026 年 11 月未经验证的结果 Vera Rubin NVL72+ |
|---|---|---|---|---|---|
| Llama 3.1 8B | 72 | 11.541 分钟 ( 6.1-0138) | 7.162 分钟 (6.1-0073) | 9.211 分钟 | 6.140 分钟 |
| gpt-oss 20B | 64 | 18.24 分钟 ( 6.1-0049) | 11.213 分钟 ( 6.1-0135) | 13.151 分钟 | 8.080 分钟 |
| DLRMv4 | 128 | 3.871 分钟 ( 6.1-0038) | 2.829 分钟 ( 6.1-0129) | 2.940 分钟 | 1.628 分钟 |
| 基准测试 | GPU 数量 | Vera Rubin NVL72 MLPerf v6.1 运行 (MLPerf ID) | 2026 年 11 月未经验证的结果 Vera Rubin NVL72+ |
|---|---|---|---|
| Llama 3.1 8B | 8 | 36.242 分钟 (6.1-0125) | 31.737 分钟 |
| gpt-oss 20B | 8 | 37.521 分钟 ( 6.1-0125) | 32.553 分钟 |
| DLRMv4 | 8 | 12.646 分钟 ( 6.1-0128) | 9.140 分钟 |
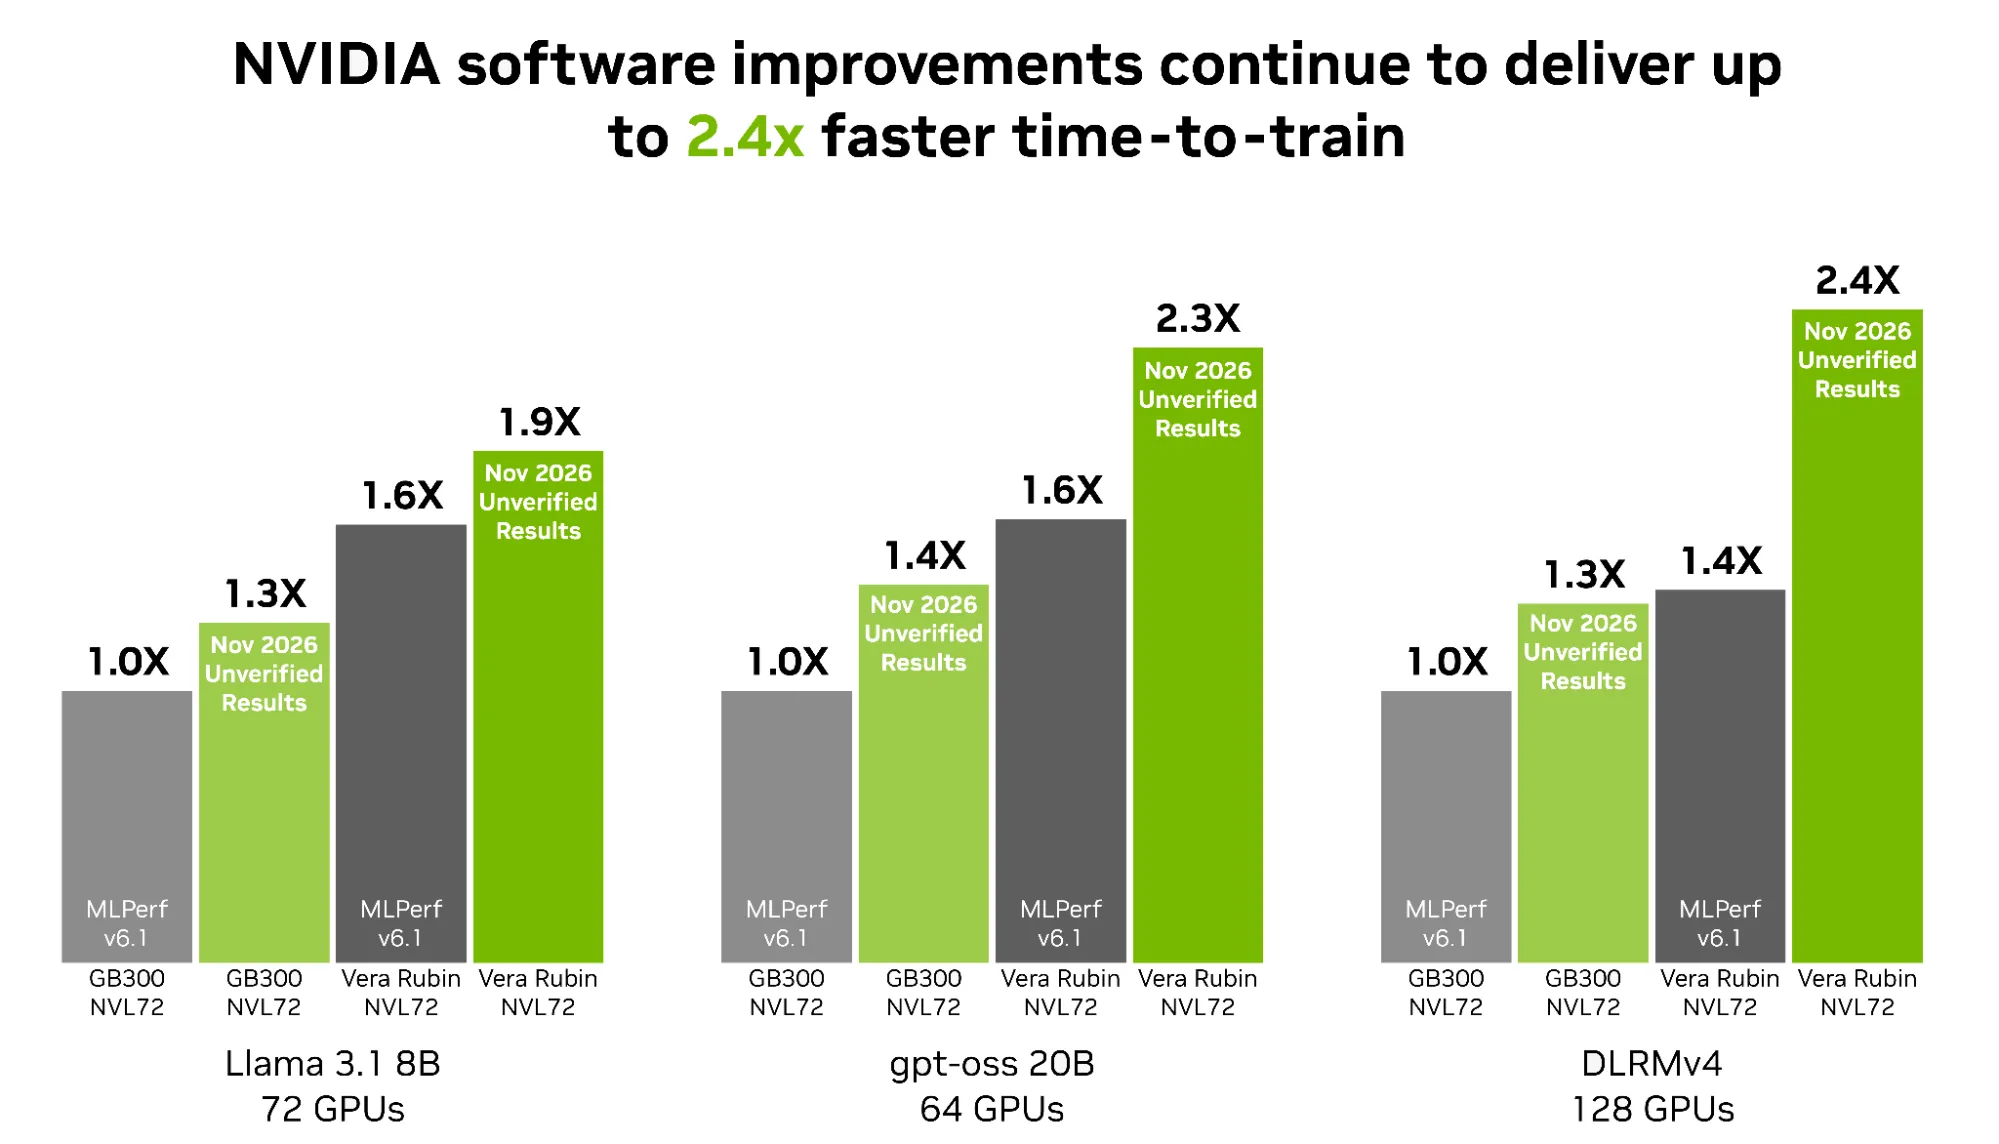
图 3. 使用更新的软件堆栈进行未经验证的重新运行表明,与 MLPerf 6.1 GB300 NVL72 提交相比,训练 Vera Rubin NVL72 的速度提高了 2.4 倍
MLPerfTraining v6.1 结果于 2026 年 11 月 16 日从 www.mlcommons.org 的以下条目中检索到:6.1-0138、6.1-0073、6.1-0049、6.1-0135、6.1-0038 和 6.1-0129。比率四舍五入。未经验证的结果尚未经过 MLCommons 协会的验证。未经验证的结果尚未通过 MLPerf 评审,并且可能使用与 MLPerf 规范不一致的测量方法和/ 或工作负载实现来验证结果。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的注册商标和非注册商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org 。
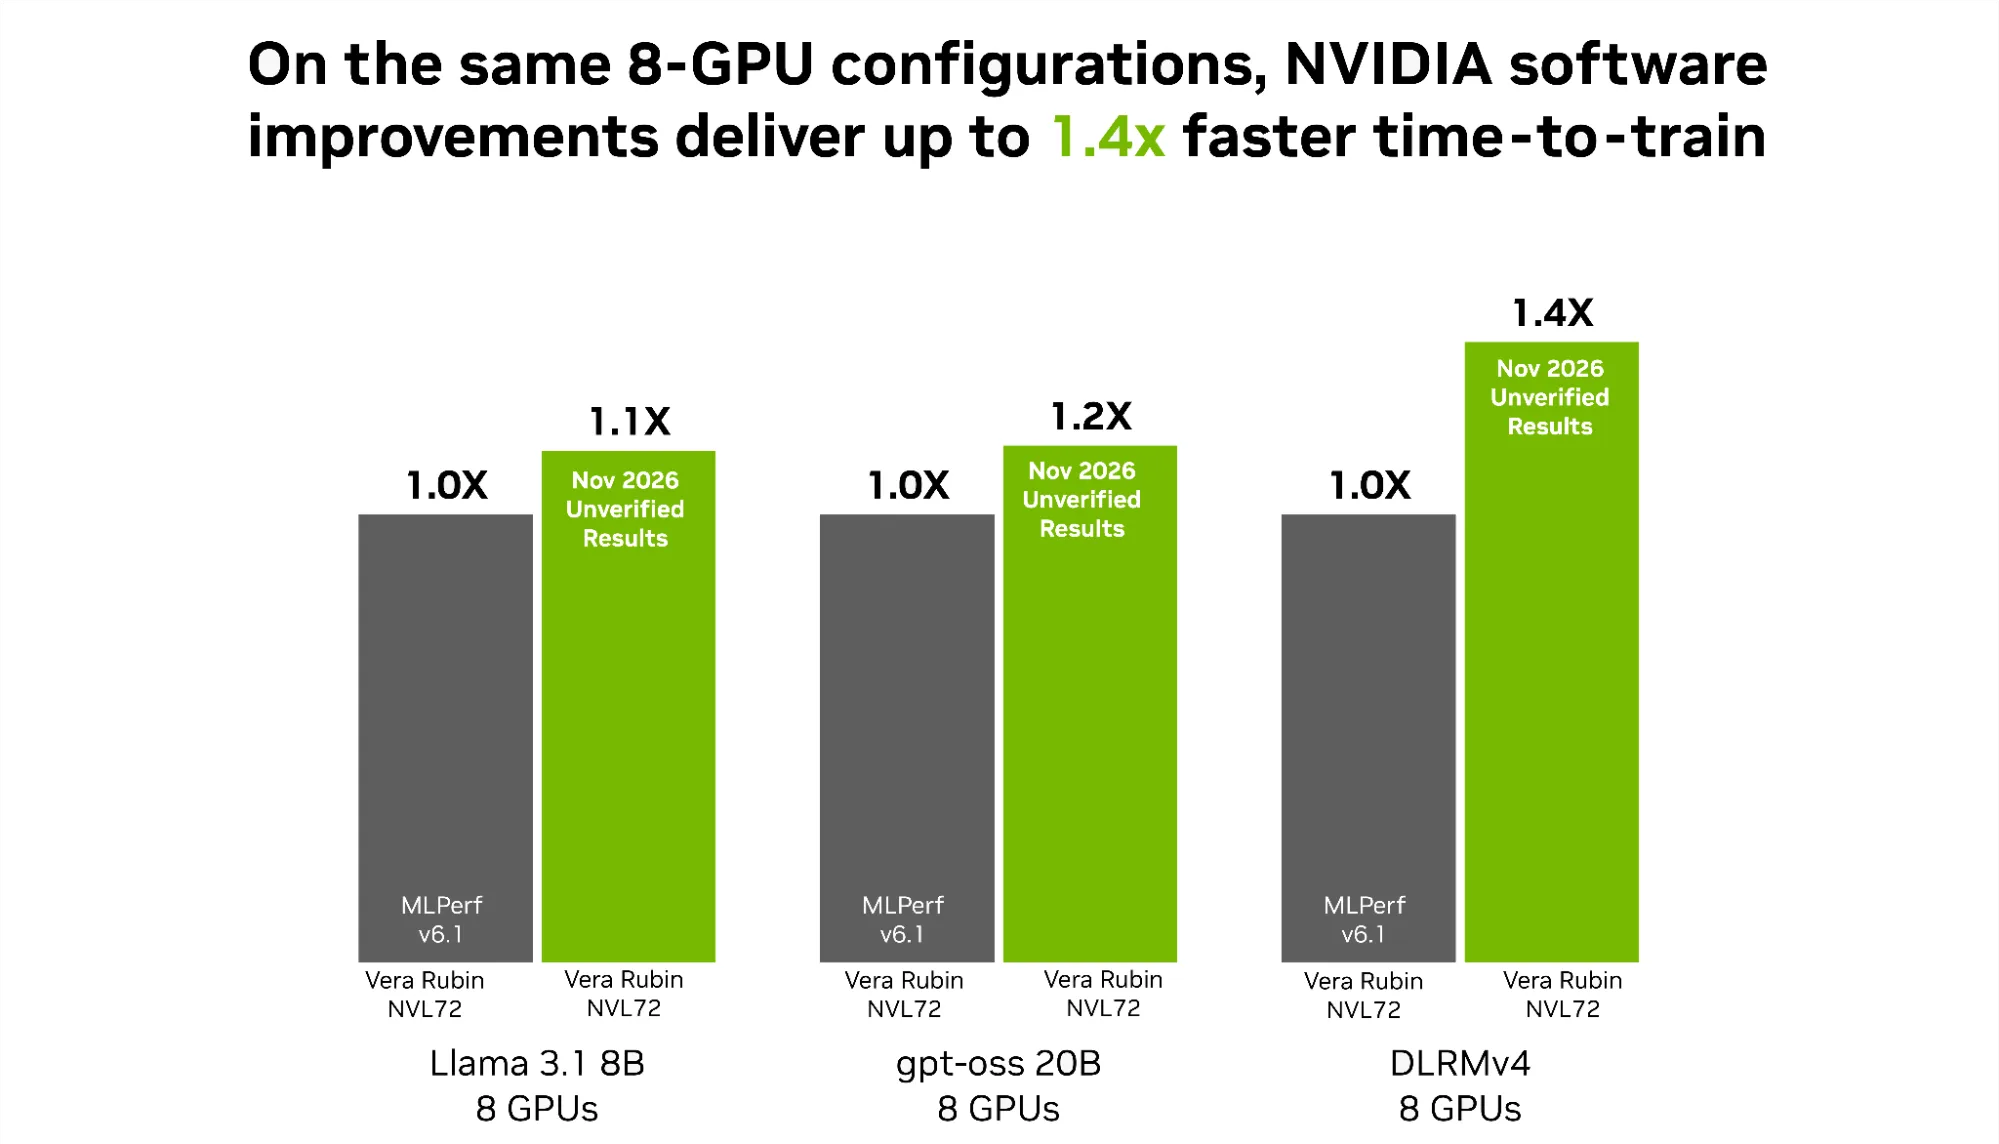
MLPerfTraining v6.1 结果于 2026 年 11 月 16 日从 www.mlcommons.org 的以下条目中检索到:6.1-0125 和 6.1-0129。比率四舍五入。未经验证的结果尚未经过 MLCommons 协会的验证。未经验证的结果尚未通过 MLPerf 评审,并且可能使用与 MLPerf 规范不一致的测量方法和/ 或工作负载实现来验证结果。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的注册商标和非注册商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org 。
这就是成熟软件堆栈对客户的意义所在。基础设施在交付后变得更快,并且改进会继续到来,从而延长平台的生产周期和创收潜力。
由于 CUDA 平台具有高度可编程性,因此客户可以自行释放更多性能。例如, Thinking Machines Lab 在 GB300 NVL72 上为其 Inkling 2 Small 模型开发了 NVFP4 训练方法和自定义内核,将 NVFP4 用于前向传递 MoE GEMM,将 MXFP8 用于梯度。与完整的 MXFP8 训练相比,它将预训练和微调速度提高了 8%,将强化学习速度提高了 20%,对准确性的影响微乎其微。
一个在首发日即发货的生态系统
Vera Rubin 在 MLPerf Training v6.1 中的首次亮相证明了该架构专为即时全球部署而构建。在 20 个合作伙伴组织的所有封闭部门提交作品中,80% 都在 NVIDIA 平台上运行,这些基准代表了跨云和 OEM 的可重现性能,而不是孤立的实验室峰值。
各种系统已经在各种云基础设施合作伙伴中全面可用,补充了全球各地的大量 AI 工厂部署。如今,Vera Rubin 在所有七个工作负载中的每个 GPU 性能都处于领先地位,而 Blackwell 和 Blackwell Ultra 则保持了这一规模记录。Azure 的 2560 节点、10240-GPU GB200 NVL72 提交结果与 NVIDIA 10240-GPU GB300 NVL72 运行结果一致,声称拥有本轮最大的集群。
合作伙伴也在节点层面突破架构限制:Firmus 使用 AI 驱动的内核生成技术,并结合自动性能测试和数学验证,发布了本轮最快的 GB300 8-GPU 结果,训练 GPT-OSS 20B 只需 52.90 分钟 (6.1-0091) ,训练 Llama 3.1 8B 只需 52.40 分钟 (6.1-0094) 。由于这些平台共享不断优化的 CUDA 软件堆栈,开发者可以预期,在下一轮 MLPerf 测试开始之前,这些初始指标会稳步上升。
随着 Vera Rubin 软件堆栈像 Blackwell 堆栈一样成熟,预计这些初始性能优势将在平台的整个生命周期中继续释放更大的价值。
详细了解 NVIDIA Vera Rubin NVL72 平台,查看完整的 MLPerf Training v6.1 结果,或阅读我们的 MLPerf Endpoints v1.0 博客,了解 Vera Rubin 如何在代理式推理领域引领行业发展。

