许多 AI 工作负载只需要 GPU 的一小部分。为每台 GPU 配备整台设备会导致容量闲置;共享 GPU 可让平台团队使用现有基础架构为更多工作负载提供服务。
NVIDIA GPU 已支持多种共享方法。多实例 GPU (MIG) 可将 GPU 拆分为硬件隔离的实例,这些实例对应用程序透明,时间片分允许多个进程轮流执行,而无需强制显存,而多进程服务 (MPS) 则允许它们在单独的地址空间 (sm-sharing) 中并发运行。
现在,CUDA 13.4 通过新的时间共享模式以及 MPS 中已存在的计算共享模式 (sm-sharing) 强制执行对应用程序透明的内存边界。
以下是 CUDA 版本 的内容:
- 确切的显存容量:工作负载会询问显存容量,而 CUDA 会将其保留在该容量。与在较小的 GPU 上一样,超过该大小的分配将失败。
- 范围: 当显存可用时,工作负载将获得有保证的最小值以及可扩展到的最大值。
- 计算模式:每个工作负载都可以选择在 SM 共享模式下使用其计算,而不是使用默认的时间共享模式。
- 透明显存限制:每个工作负载只能看到一小部分 GPU 显存。
缺失的部分:通过 Kubernetes 实现
CUDA 提供内存执行功能,但 Kubernetes 集群无法自行使用。在每个 GPU 节点上,必须:
- 运行并监督这些功能所依赖的守护程序
- 在进程开始前应用每个 Pod 容器的内存限制和计算模式
- 报告每个分数的实际使用情况,而非整个 GPU 的使用情况
此工作属于节点,独立于工作负载的调度程序。
GPU 分:开源 Kubernetes 运算符
新的开源 Kubernetes Operator gpu-fractioning 托管在 GitHub 上的 KAI Scheduler 组织下。它在 NVIDIA GPU Operator 旁边运行,后者提供驱动和容器运行时设置。
GPU 分运算符可处理三项作业:
- 它在每个 GPU 节点上设置并运行 MPS。
- 它应用每个工作负载的内存限制和计算模式。
- 它衡量的是每分数 (而非每 GPU) 的内存和计算使用量。
调度器如何将 GPU 分配传递给 Operator
开发者在 POD YAML 中编写资源和模式标注。然后,调度程序为工作负载选择 GPU,并在每个容器的 Pod 标注中记录其内存分配和计算共享模式。GPU Fractioning Operator 会读取这些标注并配置分配的 GPU,以应用工作负载的内存限制和计算模式:
| 注释 | 含义 |
|---|---|
nvidia.com/container.<name>.gpu-memory.request |
GPU 显存有保证 |
nvidia.com/container.<name>.gpu-memory.limit |
容器的最大容量 |
nvidia.com/container.<name>.gpu-compute.mode |
时间片 (默认) 或 SM 共享 |
nvidia.com/container.<name>.gpus.devices |
为容器分配了哪些 GPU |
任何能够编写这些标注的 Kubernetes 调度程序都可以使用 CUDA 执行 GPU 分数。调度程序仍然有自己的工作:选择具有足够可用内存的 GPU,并且永远不会在一个 GPU 上混合计算模式。
将 GPU 分数分析与 KAI 调度程序结合使用
KAI Scheduler 是首个与 gpu-fractioning 集成的调度程序。从 v0.18.0 开始,KAI Scheduler 具有名为 NvFractions 的 GPU 共享模式。KAI Scheduler 选择每个工作负载获取的 GPU 切片,并写入标注 (请参阅上文表 1) ,然后 gpu-fractioning 在节点上执行这些标注。
KAI Scheduler 的其他共享模式仍然可用,管理员可以为每个集群选择一种共享模式。可以在安装 KAI 时启用:
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set global.nvFractions.set=true
这也会将 gpu-fractioning 安装为依赖项。从那时开始,您将使用 Pod 标注来描述部分工作负载。
有四个重要的注释可以回答四个问题:
1. 需要多少内存
2。工作负载的增长幅度
3。计算共享方式
4。它覆盖了多少个 GPU
内存容量:请求
请求内存的方法有两种:
1. 作为绝对大小:使用每个容器的 NVIDIA 标注和标准 Kubernetes 单元:
容器名称 (app) 是密钥的一部分,因此它始终以正确的容器为目标。
2。使用 KAI Scheduler 的现有标注作为 GPU 的一部分:
gpu-fraction: "0.5"它可以增长多远:极限
这是 KAI Scheduler 中的一项新功能。工作负载可以声明一个有保证的最小值 (请求) ,以及在内存空闲时可能爆发的最大值。您使用哪种标注限制取决于您编写请求的方式:
| 请求类型 | 注释 | 示例 |
|---|---|---|
| 绝对大小 | nvidia.com/container.<c>.gpu-memory.limit | “80Gi” |
| A 部分 | kai.scheduler/container.<c>.gpu-memory.portion.limit | “0.8” |
限制是可选的。如果省略该限制,则该限制等于请求,并且工作负载的上限与其请求的完全相同。部分限制必须大于 gpu-fraction 且小于 1。
计算共享方式:分时共享或 SM 共享
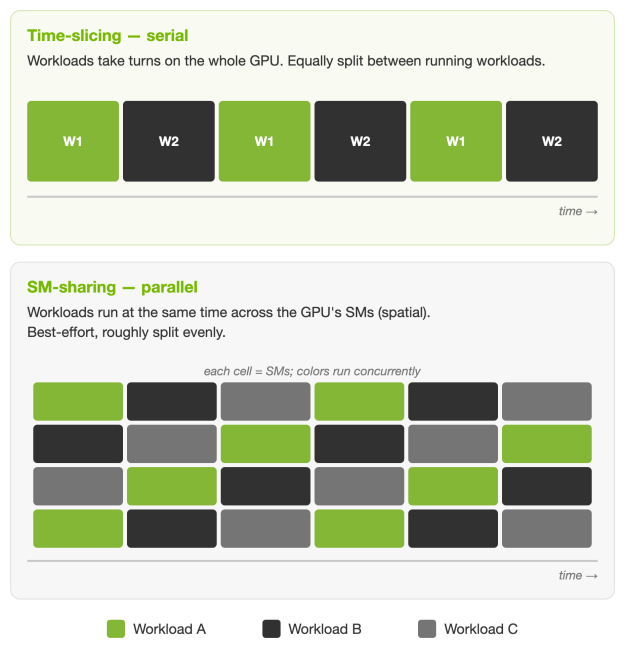
计算现在可以分割。调用共享 GPU 的工作负载的数量:无论哪种方式,每个工作负载都获得大约 1/n 的计算,不同之处在于它们是轮班还是一起运行。
- 时间片是串行的:工作负载轮流在整个 GPU 上运行,当每个 GPU 使用其完整的切片时,每个 GPU 获得大约 1/n 的时间。一个工作负载未使用的时间由其他工作负载平均分配。这是默认值。每个工作负载都在其自己的错误域中运行,即。完全错误隔离。
- SM 共享是并行的: GPU 的流式多处理器 (SM) 在工作负载之间分割,并且所有 SM 均可同时连续运行。没有任何东西是预先雕刻出来的。GPU 硬件会在工作负载需要时分配和释放 SM。当每个工作负载都很忙时,分割结果大约为 1/n;当一个工作负载安静运行时,SM 会转到另一个工作负载,而单个活动工作负载可以使用所有 SM。在此模式下,工作负载共享一个错误域。
计算模式现在是显式的,可以按容器设置:
nvidia.com/container.app.gpu-compute.mode: "sm-sharing" # or "time-slicing"共享 GPU 一次运行一种计算模式,因此 KAI Scheduler 绝不会在同一 GPU 上放置时间片工作负载和 SM 共享工作负载。KAI Scheduler 会按 GPU (而非每个节点) 追踪这一点,因此一个节点可以在不同的 GPU 上同时运行两种模式。
使用了多少个 GPU
要在多台设备上获得部分容量,请添加:
gpu-fraction-num-devices: "4"
该请求适用于每台设备。拥有四台设备的 40Gi 请求在四块 GPU 上各获得 40Gi。
总结:GPU 分示例
具有绝对大小,可在具有 SM 共享功能的四个 GPU 上运行:
apiVersion: v1
kind: Pod
metadata:
  name: inference
  labels:
    kai.scheduler/queue: default-queue
  annotations:
    nvidia.com/container.app.gpu-memory.request: "40Gi"
    nvidia.com/container.app.gpu-memory.limit: "60Gi"       # optional
    nvidia.com/container.app.gpu-compute.mode: "sm-sharing" # optional, default time-slicing
    gpu-fraction-num-devices: "4"                           # optional, default 1
spec:
  schedulerName: kai-scheduler
  containers:
    - name: app
      image: nvcr.io/nvidia/cuda:13.0.2-base-ubuntu24.04
这是一个分为四个 GPU 的推理服务器,每个 GPU 上都需要有保证的 40Gi,在相邻 GPU 空闲时可以使用多达 60Gi,并且可以与其他工作负载一起运行,而不是等待轮到它。SM 共享将工作负载置于一个错误域中,因此请将其用于您信任的一起运行的工作负载。
在两个 GPU 上使用时间切片时,一半的 GPU 可能会增长到 80% (默认) :
metadata:
  annotations:
    gpu-fraction: "0.5"
    gpu-fraction.limit: "0.8"  # optional
    nvidia.com/container.app.gpu-compute.mode: "time-slicing"    # optional
    gpu-fraction-num-devices: "2"                                # optional
spec:
  schedulerName: kai-scheduler
  containers:
    - name: app
这是一个开发或批处理作业的示例,例如 Notebook 或小型微调运行,需要保证两个 GPU 各占一半,并且在显存可用时可以增长到 80%。时间片划分为每个工作负载提供了自己的错误域,因此一项作业的崩溃不会影响其相邻作业。在容器中运行 nvidia-smi 应显示两个 GPU,每个 GPU 都具有此工作负载的部分内存共享。
开始使用
KAI Scheduler 和 GPU Fractioning Operator 都在 GitHub 上,由 KAI Scheduler 组织管理,并提供所有三种共享机制的安装和配置说明 (请参阅管理员和用户指南) 。加入 Slack 频道或每两周一次的社区会议,提出您的问题并做出贡献。
有关 CUDA 13.4 的更多信息,请参阅公告。
您还可以参加于 KubeCon CloudNativeCon NA 2026 在 11 月 9 日至 12 日在犹他州盐湖城举办的