NVIDIA Snapshot 是 NVIDIA DSX AI Factory Platform 的新开源组件,使初始化的 GPU 工作负载能够在推理副本中重复使用,从而加快启动和恢复速度。
当推理需求高峰或副本失败时,可用的 GPU 不会立即转化为服务容量。初始化 LLM 工作负载 (即冷启动过程) 可能需要几分钟时间,从而延迟扩展和恢复。
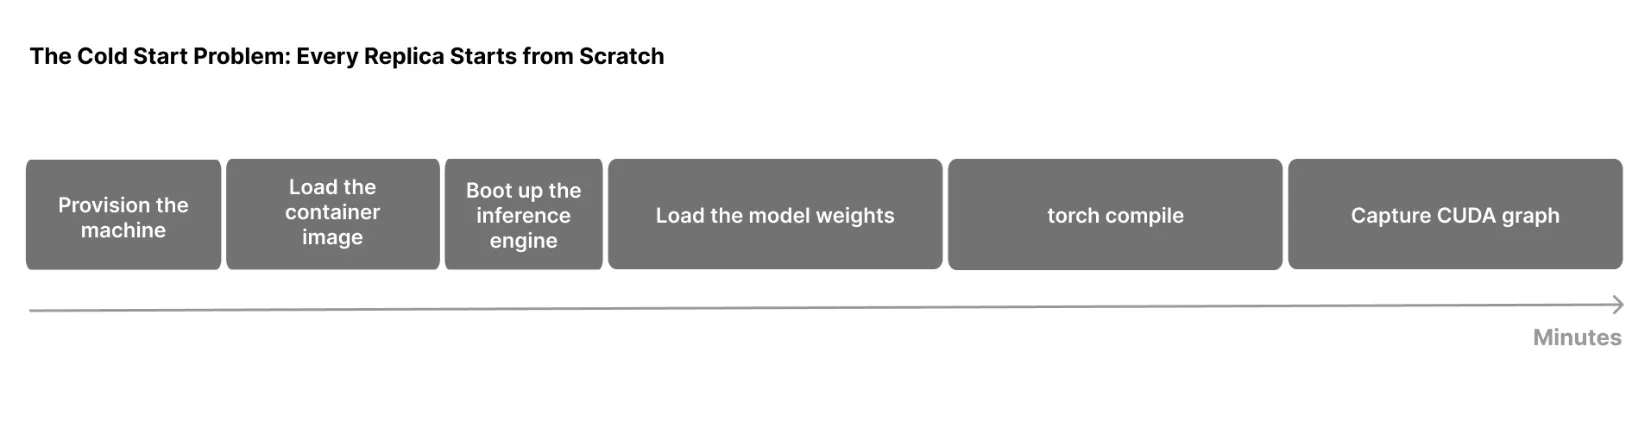
快照是 Kubernetes 上用于 GPU 工作负载的检查点和恢复系统。它可以捕获完全初始化的工作负载 (包括 CPU 和 GPU 显存) ,并在兼容的基础设施上恢复该状态,从而在数秒内 (而非几分钟) 实现推理能力上线。图 1 显示了启动序列。快照会跳过重复的工作负载初始化;基础架构配置和容器镜像加载仍在测量的恢复路径之外。
本文将介绍 Snapshot 如何检查并恢复 GPU 工作负载、平台团队如何集成这些工作负载,以及在三个推理引擎中,如何将恢复时间与冷启动时间进行比较。
AI 工厂运营快照
Snapshot 最初是为 NVIDIA Dynamo 推理工作者开发的,提供检查点和恢复功能,可供其他推理引擎、调度器、控制器和平台集成。
Snapshot 为 GPU Pod 提供了两项操作:
- Checkpoint :工作负载完全初始化后,将其 CPU 和 GPU 显存捕获为可移植的构件。
- 恢复:在具有相同 GPU 型号和驱动程序的任意节点上,从该构件启动新的 Pod。该过程从设置检查点的位置继续进行,因此会跳过权重加载、编译和图形捕获。
这两项操作都使用 Kubernetes 自定义资源。要检查已在运行的 Pod,请创建 PodSnapshot 并为其命名。要从模板启动 Pod 并在其准备就绪后立即设置检查点,请改为创建一个 SnapshotJob 。要恢复,请将标注 nvidia.com/restore-from 添加到新的 Pod 中,并将其命名为要恢复的 PodSnapshot 。工作负载只需在检查点前稍作握手,即可暂停,并在恢复后继续。该库包含 vLLM、SGLang 和 NVIDIA TensorRT LLM 的现成示例。
快照可以检查点和恢复跨单个节点上多个 GPU 的兼容工作负载,作为跨 rank 的单个检查点构件。这支持使用张量并行 (TP) 、数据和专家并行 (DEP) 以及解码上下文并行 (DCP) 等并行策略快速启动大型混合专家 (MoE) 模型。工作负载必须满足 Snapshot 的检查点/ 恢复和运行时兼容性要求。查看示例配置。
基准测试
设计合作伙伴还根据自己的工作负载评估了 Snapshot:
- Snapshot 的上游贡献者 Crusoe 在 NVIDIA HGX B300 上将 GLM-5.3 Pod 就绪时间从大约 8 分钟缩短到了 31 秒。
- Token 工厂平台 Saturn Cloud 对 NVIDIA HGX B300 上的 vLLM 启动时间从 2 – 8.5 分钟缩短到 6 – 34 秒。
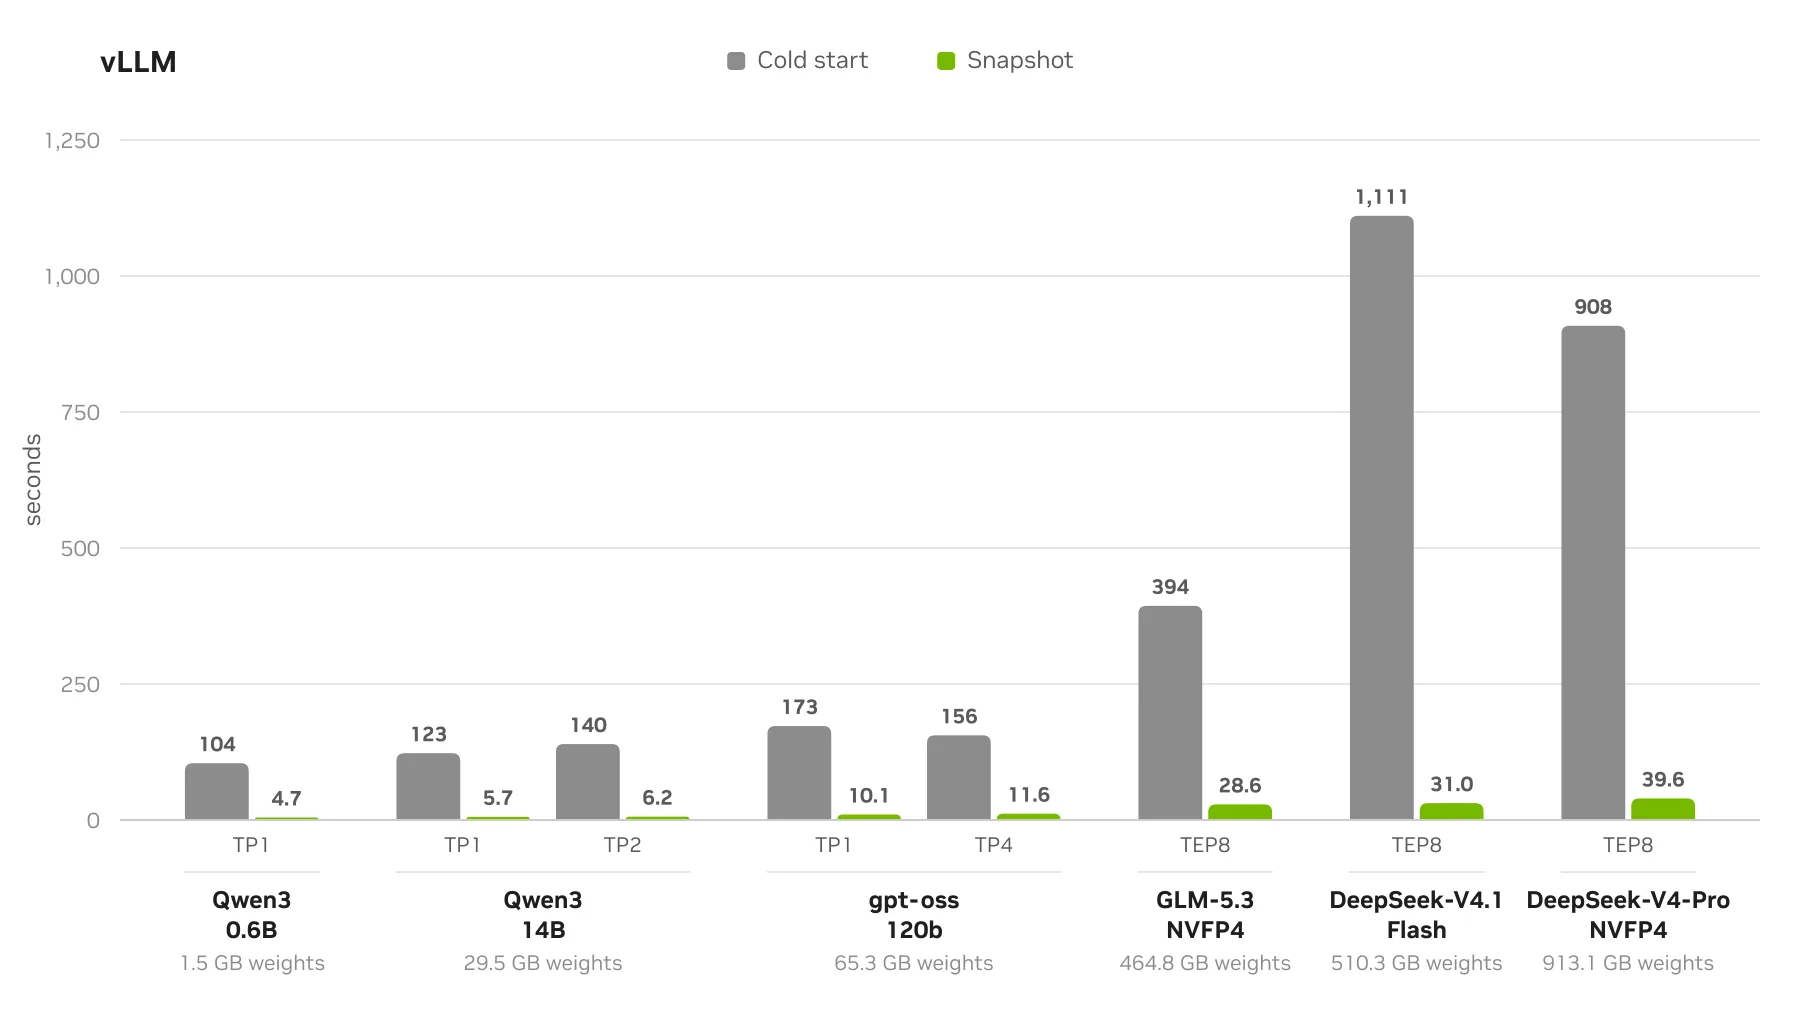
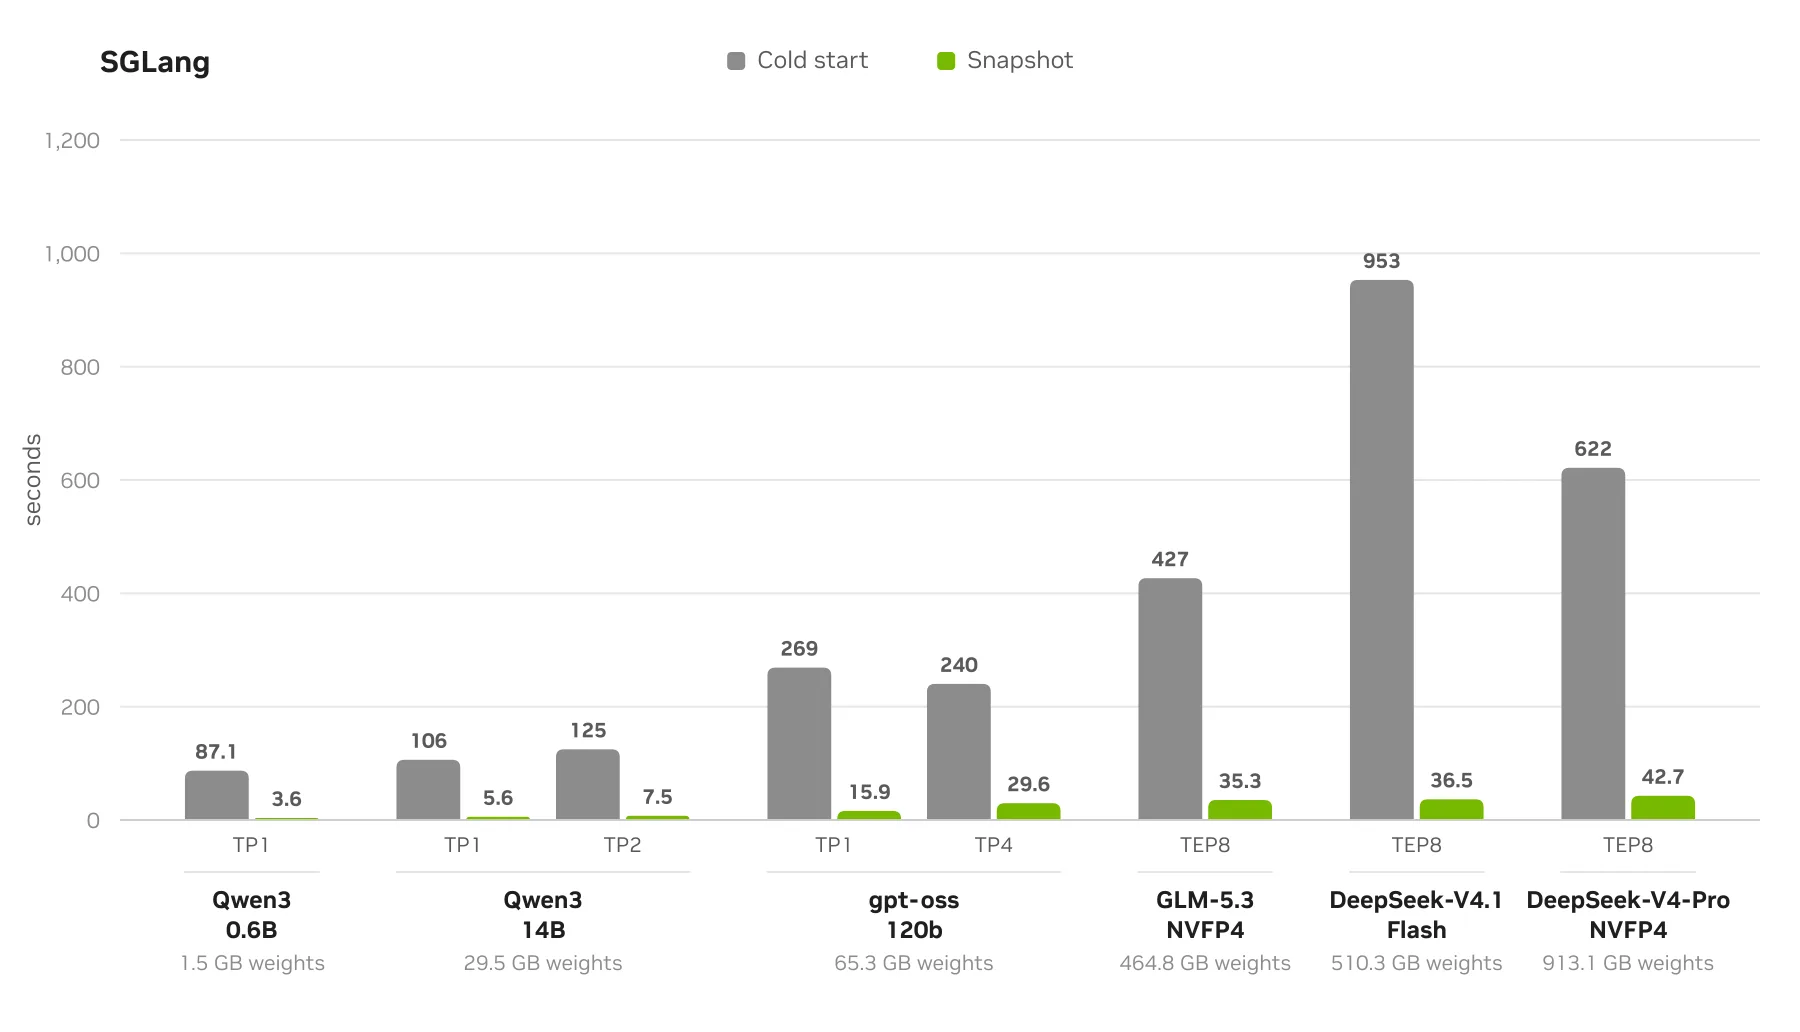
以下基准测试展示了 Snapshot 如何在 vLLM、SGLang 和 NVIDIA TensorRT LLM (TRT-LLM) 中加速推理启动,模型包含 6 亿个参数,以及 8 个 GPU 上具有 1 TB 检查点的混合专家模型 (MoE) 。在所有测试配置中,Snapshot 可在 45 秒内恢复副本,比冷启动快 8 到 36 倍。
方法
每种配置都在相同的硬件和软件堆栈上使用两种策略进行测试:
- 冷启动: 工作负载从头开始。时钟从进程启动开始运行,直到引擎初始化返回,然后再进行推理。测量分为四个阶段 (表 2) :
- 启动: 启动引擎和工作进程,导入 Python 库,并在 GPU 之间建立通信。此处还会执行一些即时 (JIT) 核函数编译。
- 模型加载: 读取模型权重并构建模型张量,包括加载时完成的任何特定于引擎的转换或重新包装。
- 初始化:准备要服务的加载模型:内存分析、分配键值 (KV) 缓存和运行时缓冲区,以及其他内核和运行时准备。
- 编译、自动调整和图形捕捉:编译内核 (例如,使用
torch.compile) 、针对 GPU 自动调整内核,以及捕捉 CUDA 图形。
- 快照: 工作负载从检查点恢复。时钟从要求快照恢复的那一刻起开始运行,直到工作负载重新开始运行。测量分为四个阶段 (表 3) :
- 智能体设置: 节点上的 Snapshot 智能体找到检查点构件并准备目标 Pod 和 GPU。
- 用户空间中的检查点/ 恢复 (CRIU) 恢复: CRIU 是用于设置检查点进程的标准 Linux 工具,可将进程镜像从存储读取到主机内存。速度主要由存储后端设置。
- CUDA 恢复:将 GPU 状态复制回 GPU 显存。
- 唤醒/ 重新映射:根据新节点调整进程并唤醒引擎。
这两项测量均不包括提取容器镜像和设置容器运行时。在每个检查点之前触发 KV 缓存释放,因此它不是构件的一部分。
表 1 还会报告检查点时间和大小:捕获完全初始化的副本所需的时间以及存储的构件所需的存储空间。这是每个模型和配置的一次性成本。
设置
- GPU:NVIDIA B200
- NVIDIA 驱动程序: 615.71.09
- 存储后端: VAST (NFS)
- 推理引擎:
- vLLM 0.31.0
- SGLang 0.5.21
- TensorRT LLM 1.3.0
结果
基准测试显示了四个主要结果。
- 恢复时间不到 43 秒:在所有测试配置中,Snapshot 可在 3.6 到 42.7 秒内恢复副本,比冷启动快 8 到 36 倍。大型 MoE 模型在 8 个 GPU 上具有大约 600 GB 到 1 TB 的检查点,恢复时间不到 43 秒,而冷启动时间为 6 到 19 分钟。
- 恢复跳过的不仅仅是权重加载:冷启动时间包括加载权重、编译和自动调整内核以及捕获 CUDA 计算图。快照可恢复初始化的工作负载,跳过这些重复步骤。
- 检查点会通过第一个恢复的副本得到回报:在每个测试配置中,检查点时间和恢复时间都比单次冷启动更短。创建检查点需要 15 秒到 5.5 分钟,具体时间取决于模型和配置。
- 移动 GPU 状态主导大型恢复:对于 8 – GPU MoE 配置而言,恢复 GPU 状态需要 18 到 29 秒。使用 CRIU 恢复 CPU 进程状态需要 4.2 到 10.8 秒。
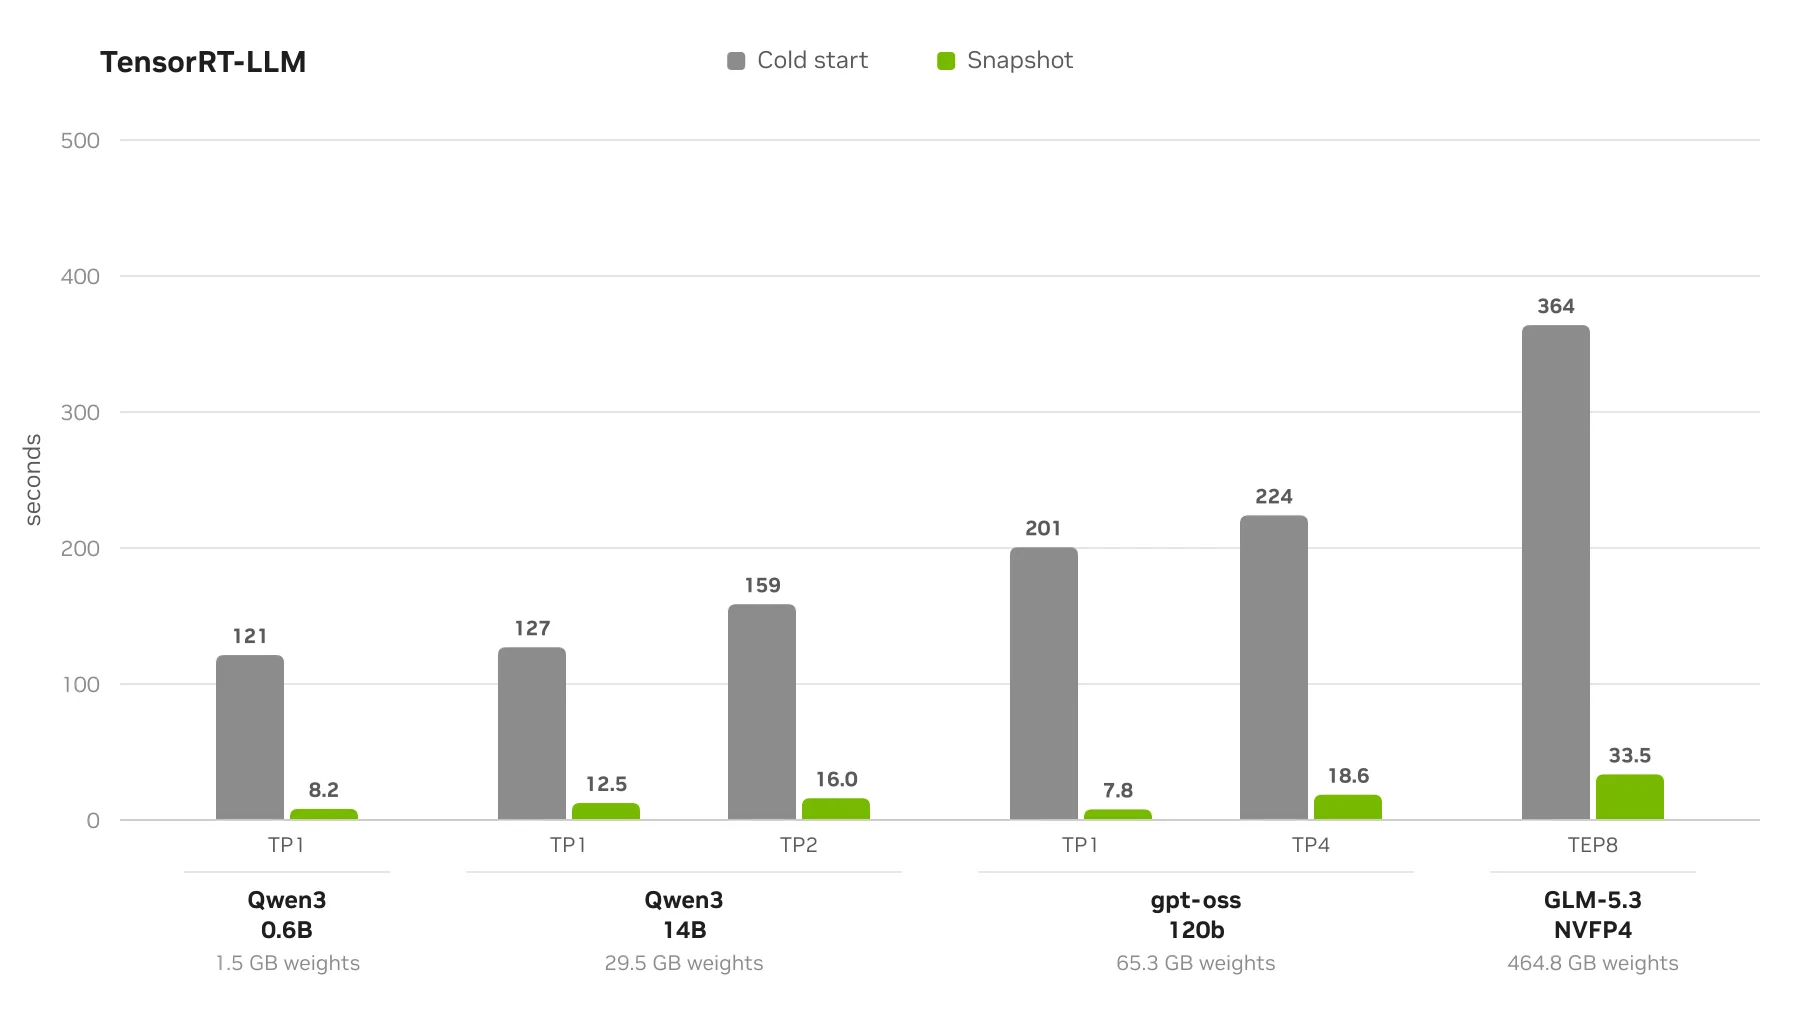
图 2 至 4 比较了 vLLM、SGLang 和 TensorRT LLM 在测试模型和并行配置中的冷启动和快照恢复时间。表 1 提供了每种配置的数据,包括检查点时间和大小。所有时间都以秒为单位。在图和表格中, TEP8 表示跨 8 个 GPU 的张量和专家并行性。
| 模型 | 引擎 | 并行性 | 重量大小 (GB) | 检查点大小 (GB) | 检查点时间 | 冷启动 | 快照 智能体恢复 |
加速 |
|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6 B | vLLM | TP1 | 1.50 | 8.13 | 15.30 | 104.43 | 4.66 | 22.40 倍 |
| Qwen3-0.6 B | SGLang | TP1 | 1.50 | 9.42 | 20.71 | 87.08 | 3.59 | 24.26 倍 |
| Qwen3-0.6 B | TRT-LLM | TP1 | 1.50 | 8.04 | 20.07 | 121.26 | 8.15 | 14.88 倍 |
| Qwen3-14B | vLLM | TP1 | 29.54 | 37.71 | 19.98 | 122.76 | 5.72 | 21.45 倍 |
| Qwen3-14B | vLLM | TP2 | 29.54 | 48.29 | 38.37 | 139.63 | 6.19 | 22.55 倍 |
| Qwen3-14B | SGLang | TP1 | 29.54 | 40.19 | 26.17 | 106.26 | 5.60 | 18.96 倍 |
| Qwen3-14B | SGLang | TP2 | 29.54 | 51.93 | 33.88 | 124.72 | 7.45 | 16.75 倍 |
| Qwen3-14B | TRT-LLM | TP1 | 29.54 | 36.38 | 23.72 | 127.02 | 12.50 | 10.16 倍 |
| Qwen3-14B | TRT-LLM | TP2 | 29.54 | 47.97 | 42.90 | 158.66 | 15.99 | 9.92 倍 |
| gpt-oss-120b | vLLM | TP1 | 65.25 | 81.56 | 44.37 | 172.80 | 10.09 | 17.12 倍 |
| gpt-oss-120b | vLLM | TP4 | 65.25 | 119.69 | 133.01 | 155.66 | 11.62 | 13.40 倍 |
| gpt-oss-120b | SGLang | TP1 | 65.25 | 172.32 | 55.63 | 268.96 | 15.94 | 16.87 倍 |
| gpt-oss-120b | SGLang | TP4 | 65.25 | 693.89 | 174.20 | 240.17 | 29.64 | 8.10 倍 |
| gpt-oss-120b | TRT-LLM | TP1 | 65.25 | 77.87 | 29.98 | 200.55 | 7.79 | 25.75 倍 |
| gpt-oss-120b | TRT-LLM | TP4 | 65.25 | 111.34 | 85.29 | 223.96 | 18.58 | 12.05 倍 |
| GLM-5.3-NVFP4 | vLLM | TEP8 | 464.82 | 604.00 | 282.80 | 393.65 | 28.64 | 13.74 倍 |
| GLM-5.3-NVFP4 | SGLang | TEP8 | 464.82 | 669.49 | 327.20 | 426.70 | 35.34 | 12.07 倍 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 464.82 | 628.30 | 231.33 | 363.90 | 33.55 | 10.85 倍 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 510.30 | 647.18 | 274.75 | 1110.65 | 30.96 | 35.87 倍 |
| DeepSeek-V4.1-Flash | SGLang | TEP8 | 510.30 | 743.35 | 286.77 | 953.09 | 36.54 | 26.08 x |
| DeepSeek-V4-Pro-NVFP4 | vLLM | TEP8 | 913.09 | 996.53 | 193.84 | 908.48 | 39.56 | 22.96 倍 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | TEP8 | 913.09 | 1039.09 | 253.72 | 621.55 | 42.69 | 14.56 倍 |
表 2 分解了冷启动时间,显示了还原跳过的初始化阶段。
| 模型 | 引擎 | 并行性 | 初创公司 | 模型负载 | 初始化 | 编译、自动调整和图形截取 | 总计 |
|---|---|---|---|---|---|---|---|
| Qwen3-0.6 B | vLLM | TP1 | 31.37 | 17.27 | 14.58 | 41.21 | 104.43 |
| Qwen3-0.6 B | SGLang | TP1 | 33.74 | 11.67 | 8.41 | 33.26 | 87.08 |
| Qwen3-0.6 B | TRT-LLM | TP1 | 25.79 | 3.79 | 40.64 | 51.04 | 121.26 |
| Qwen3-14B | vLLM | TP1 | 31.16 | 26.15 | 15.30 | 50.15 | 122.76 |
| Qwen3-14B | vLLM | TP2 | 42.18 | 18.96 | 15.29 | 63.20 | 139.63 |
| Qwen3-14B | SGLang | TP1 | 33.45 | 20.79 | 8.28 | 43.74 | 106.26 |
| Qwen3-14B | SGLang | TP2 | 47.62 | 18.93 | 8.29 | 49.88 | 124.72 |
| Qwen3-14B | TRT-LLM | TP1 | 25.35 | 11.54 | 39.36 | 50.77 | 127.02 |
| Qwen3-14B | TRT-LLM | TP2 | 27.42 | 8.88 | 70.62 | 51.74 | 158.66 |
| gpt-oss-120b | vLLM | TP1 | 35.15 | 38.69 | 10.49 | 88.47 | 172.80 |
| gpt-oss-120b | vLLM | TP4 | 49.91 | 24.71 | 12.13 | 68.91 | 155.66 |
| gpt-oss-120b | SGLang | TP1 | 42.54 | 34.44 | 0.36 | 191.62 | 268.96 |
| gpt-oss-120b | SGLang | TP4 | 57.97 | 49.06 | 1.33 | 131.81 | 240.17 |
| gpt-oss-120b | TRT-LLM | TP1 | 26.21 | 47.50 | 42.85 | 83.99 | 200.55 |
| gpt-oss-120b | TRT-LLM | TP4 | 34.28 | 42.72 | 22.34 | 124.62 | 223.96 |
| GLM-5.3-NVFP4 | vLLM | TEP8 | 65.47 | 65.88 | 48.88 | 213.42 | 393.65 |
| GLM-5.3-NVFP4 | SGLang | TEP8 | 60.77 | 73.98 | 2.66 | 289.29 | 426.70 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 31.58 | 90.39 | 120.43 | 121.50 | 363.90 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 63.96 | 184.90 | 77.25 | 784.54 | 1110.65 |
| DeepSeek-V4.1-Flash | SGLang | TEP8 | 56.18 | 74.21 | 38.50 | 784.20 | 953.09 |
| DeepSeek-V4-Pro-NVFP4 | vLLM | TEP8 | 64.42 | 95.14 | 64.87 | 684.05 | 908.48 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | TEP8 | 58.80 | 87.68 | 42.55 | 432.52 | 621.55 |
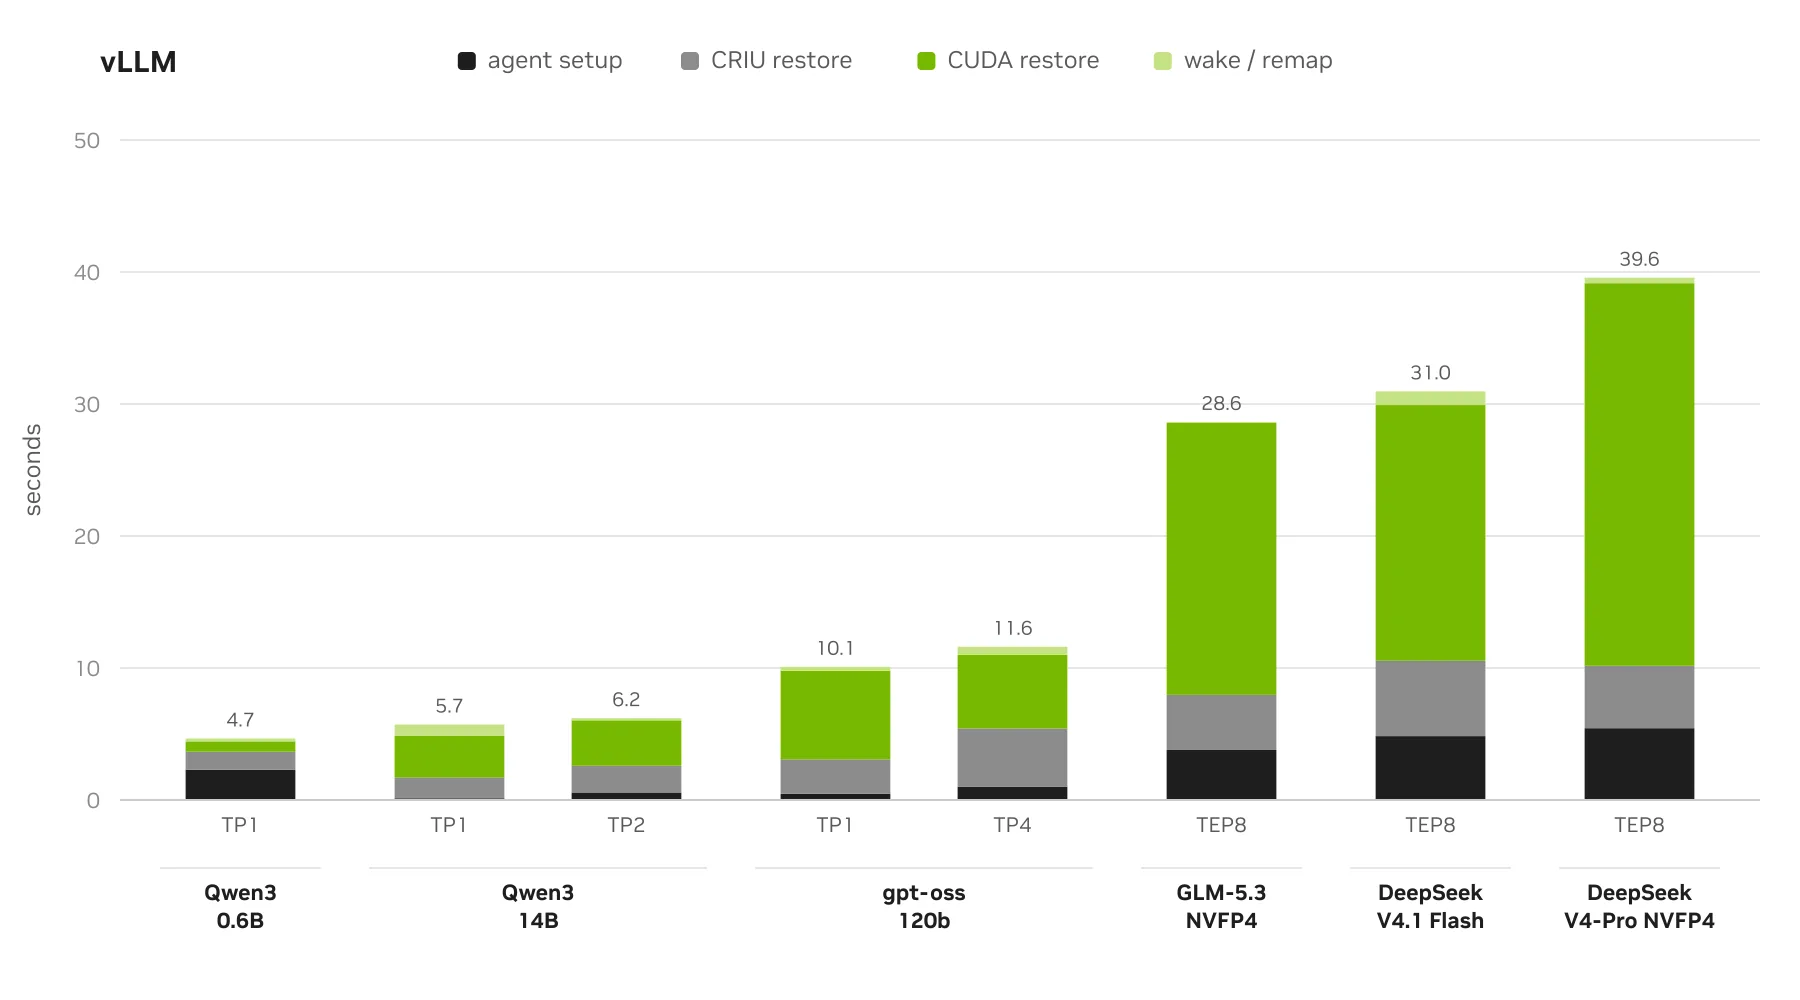
表 3 将恢复时间分解为智能体设置、CRIU 恢复、CUDA 恢复和唤醒/ 重新映射。
| 模型 | 引擎 | 并行性 | 快照:智能体设置 | 快照:CRIU 恢复 | 快照:CUDA 恢复 | 快照:唤醒/ 重映射 | 总计 |
|---|---|---|---|---|---|---|---|
| Qwen3-0.6 B | vLLM | TP1 | 2.30 | 1.36 | 0.78 | 0.22 | 4.66 |
| Qwen3-0.6 B | SGLang | TP1 | 0.24 | 1.33 | 1.02 | 0.99 | 3.59 |
| Qwen3-0.6 B | TRT-LLM | TP1 | 5.72 | 1.43 | 0.84 | 0.16 | 8.15 |
| Qwen3-14B | vLLM | TP1 | 0.13 | 1.58 | 3.16 | 0.85 | 5.72 |
| Qwen3-14B | vLLM | TP2 | 0.57 | 2.03 | 3.43 | 0.17 | 6.19 |
| Qwen3-14B | SGLang | TP1 | 0.24 | 1.35 | 3.67 | 0.34 | 5.60 |
| Qwen3-14B | SGLang | TP2 | 0.92 | 2.17 | 3.49 | 0.87 | 7.45 |
| Qwen3-14B | TRT-LLM | TP1 | 6.80 | 2.70 | 2.82 | 0.18 | 12.50 |
| Qwen3-14B | TRT-LLM | TP2 | 9.65 | 3.52 | 2.41 | 0.41 | 15.99 |
| gpt-oss-120b | vLLM | TP1 | 0.48 | 2.60 | 6.71 | 0.30 | 10.09 |
| gpt-oss-120b | vLLM | TP4 | 1.02 | 4.40 | 5.57 | 0.62 | 11.62 |
| gpt-oss-120b | SGLang | TP1 | 0.26 | 1.69 | 13.46 | 0.54 | 15.94 |
| gpt-oss-120b | SGLang | TP4 | 2.69 | 4.34 | 21.69 | 0.93 | 29.64 |
| gpt-oss-120b | TRT-LLM | TP1 | 0.28 | 1.51 | 5.74 | 0.26 | 7.79 |
| gpt-oss-120b | TRT-LLM | TP4 | 9.99 | 3.30 | 4.34 | 0.95 | 18.58 |
| GLM-5.3-NVFP4 | vLLM | TEP8 | 3.79 | 4.18 | 20.61 | 0.06 | 28.64 |
| GLM-5.3-NVFP4 | SGLang | TEP8 | 3.27 | 10.80 | 19.96 | 1.31 | 35.34 |
| GLM-5.3-NVFP4 | TRT-LLM | TEP8 | 9.81 | 5.32 | 18.17 | 0.25 | 33.55 |
| DeepSeek-V4.1-Flash | vLLM | TEP8 | 4.84 | 5.71 | 19.37 | 1.04 | 30.96 |
| DeepSeek-V4.1-Flash | SGLang | TEP8 | 4.34 | 9.77 | 21.40 | 1.03 | 36.54 |
| DeepSeek-V4-Pro-NVFP4 | vLLM | TEP8 | 5.44 | 4.73 | 28.98 | 0.42 | 39.56 |
| DeepSeek-V4-Pro-NVFP4 | SGLang | TEP8 | 3.13 | 10.13 | 28.60 | 0.83 | 42.69 |
图 5 显示了 vLLM 的恢复时间分解。
开始使用
要在 Kubernetes 上使用 GPU 工作负载试用 Snapshot,请先参阅 NVIDIA Snapshot 资源库中的安装说明和使用指南。
您可以尝试使用 NVIDIA Dynamo,按照用户指南恢复工作节点。
要讨论集成或提供反馈,请提出问题或加入 NVIDIA Dynamo Slack 工作空间并访问#snapshot-dev 频道。
在 KubeCon 上参观 NVIDIA 170 号展位,了解 Kubernetes 的深入探讨和现场演示。