

随着人工智能和加速计算不断突破极限,最新的 NVIDIA CUDA 版本将解锁前所未有的性能和规模。
NVIDIA CUDA 13.5 可跨主要新平台提供全面可用 (GA) 功能。NVIDIA Vera Rubin 支持从开发者早期访问转移到正式发布 (GA) ,为企业生产做好准备。从 CUDA 13.4 开始,Arm 上的 Windows 支持现已扩展到适用于 Windows 的 NVIDIA DGX Station。
CUDA 13.5 还引入了更多关于如何通过局部性域和 NVIDIA 多进程服务 (MPS) 调度 GPU 工作的自定义功能。CUDA 13.5 提供跨库、编译器、NVIDIA CUDA Tile 和开发者工具的创新。
本文将展示 CUDA 13.5 的亮点。
CUDA 13.5 增强功能
CUDA 13.5 随附的一些显著增强功能包括:
局部域增强
CUDA 13.5 允许应用在跨本地域或包含所有可用 SM 的分区之间选择统一的流式多处理器 (SM) 分区。默认情况下,本地化的绿色上下文分区使用相同的保证 SM 每个域的数量,将补充 SM 留在这些分区之外。
新的 cudaDevSmResourceGroupLocalityDomainSupplementalSms 标志与 cudaDevSmResourceGroupLocalityDomainId 相结合,在每个选定域中都包含这些额外的 SM。这使得应用在跨本地域进行分区时能够使用所有设备 SM,尽管生成的分区大小可能有所不同。
应用程序可以使用 cudaDevSmResourceSplit() API 中的发现模式来获取每个分区的 SM 数量,并相应地分配工作。这样,您便可以在每个局部性域的统一 SM 大小的一致性和可预测性之间进行选择,也可以选择每个局部性域拥有的最大 SM 数量,并尽可能多地利用 GPU 硬件。有关更多信息,请参阅 CUDA 运行时 API。
NVIDIA MPS
从调度单个服务器到向客户端组分配资源,MPS v3 可让您更好地控制工作负载共享 GPU 的方式。
加权时间切片
加权时间切片可以让您为托管有需要的工作负载的服务器提供更长的计算周期。设置基础时间,按 MPS 服务器进行缩放,并独立调整 GPU 在工作负载之间切换的主动性。
SM 分区负载均衡
SM 分区负载均衡允许工作负载在资源可用时使用超出其基本分区的容量。使用 --max-chunks 启用借用,并允许分区在未连接客户端的情况下借出其 SM。这些设置是独立的,因此分区可以借用或借出,也可以同时执行这两种操作。MPS 会先回收借用的资源,然后再重新分配这些资源,而应用程序会继续看到稳定的基本分区大小。
基于 Cgroup 的路由
基于 Cgroup 的路由将工作负载启动程序的进程分组连接到 MPS 资源策略。将 cgroup v2 子树映射到 MPS 命名空间,然后通过守护程序的主套接字连接的客户端将自动路由到该命名空间。
SM 分区分配
按命名空间 SM 分区分配允许您为每个设备选择一次分区,然后将该选择应用于路由到命名空间的每个客户端。您不再需要为这些客户端单独配置 CUDA_MPS_SM_PARTITION。命名空间分配优先,而未分配的设备保留环境变量回退。
用于内存计算的基于轮询的回退
基于轮询的内存记帐可提供备用功能。当 cgroup 值通知缺失或不可靠时,在驱逐决策期间,MPS 可以读取当前使用情况,并直接进行限制,而不是依赖缓存的通知状态。如要强制轮询,请在内存计算开始前运行 nvidia-cuda-mps-control memacct set force_polling=true。这增加了每个驱逐决定的工作量,但消除了对通知传递的依赖。
CUDA 计算图中的批量一维副本
CUDA 13.5 增加了对批量一维显存复制的 CUDA Graph 支持。应用现在可以在流截取中包含现有的 cudaMemcpyBatchAsync 调用,而无需更改批量复制调用语法,从而允许在可重复使用的图形工作流中捕获和回放多个传输。应用还可以显式添加批处理复制节点,并更新兼容的复制地址和大小,而无需更改批量结构。
NVIDIA Rubin 上的 Windows 驱动程序模式
从 NVIDIA Rubin 架构开始,CUDA 支持 Windows 驱动程序显示模型 (WDDM) 和 Microsoft 计算驱动程序模型 (MCDM) ,其中 MCDM 提供了仅计算的驱动程序模型。Rubin 及更高版本的 GPU 不支持 Tesla 计算集群 (TCC) 。采用 TCC 模式的应用程序和部署工具应为其目标系统使用受支持的 WDDM 或 MCDM 配置。
CUDA 图块更新
CUDA Tile 中的多 GPU 通信
CUDA 13.5 增加了对直接在 CUDA Tile 内核中进行多 GPU 通信 的支持。单播指针允许内核访问另一个通过 NVLink 连接的 GPU 上的内存,而组播指针和专用的多内存操作则支持在 NVIDIA NVSwitch 结构上的多个 GPU 上进行归约和存储,并支持 NVIDIA NVLink SHARP。应用在启动前准备共享内存映射,然后在内核中将通信与计算相结合,从而实现融合矩阵乘法和跨 GPU 归约等工作负载。
平铺到单指令多线程 (SIMT) 互操作性 (公开预览)
CUDA 13.5 允许 CUDA Tile 内核直接调用 SIMT 库设备函数。在此版本发布之前,Tile 和 SIMT 库代码只能跨内核边界进行组合,数据通过它们之间的全局内存。通过此预览,使用 cuTile Python 或 CUDA Tile C++ 编写的核函数可以从其代码中间的 SIMT 库中调用设备函数,而这些函数所使用的数据是寄存器或共享内存中已有的数据。这些库包括 NVIDIA NVSHMEM、NVIDIA CCCL Coop、NVIDIA Warp 和 NVIDIA MathDx,涵盖了 NVIDIA cuFFTDx、NVIDIA cuBLASDx、NVIDIA cuSolverDx 和 NVIDIA nvCOMPDx,并且这些库很快将启用这种互操作支持。
图块库 (.tilelib) 为 SIMT 库函数提供了界面和实现信息包。编译器按照库预期的方式跨线程对每个图块进行分区,传达任何共享内存和同步要求,并生成单个内核。要在 C++ 中启用预览,请使用 nvcc --tile-preview simt 进行编译,并将 tilelib 传递给图块编译器。在 cuTile Python 中,使用 cuda.tile_preview 包提供的 cuda.tile_preview.foreign_call。
在 13.5 中,Tile-SIMT 互操作预览仅涵盖库函数。我们计划在未来的版本中从平铺代码中调用您自己的 __device__ 函数。如需了解更多信息,请参阅文档。
NVIDIA CUDA Python
NVIDIA CUDA Python 继续扩展 Python 对 CUDA 编程的访问。CUDA Python 核心库 cuda.core 1.2 引入了批量内存复制、编程依赖启动 (PDL) 、更简单的运行时编译以及更灵活的 CUDA 图形更新。
批量内存复制
新的 cuda.core.utils.copy_batch() 通过一次 CUDA 驱动程序调用来提交多个缓冲区副本。CopyOptions 提供对源访问顺序、内存位置提示和重叠行为的控制,使应用能够更好地控制数据移动。
以下示例使用现有源缓冲区和目标缓冲区提交两个独立的副本:
from cuda.core.utils import copy_batch

# Each source and destination pair must have matching sizes.
# Copies within the batch must not alias.
copy_batch(
    stream,
    srcs=[src_a, src_b],
    dsts=[dst_a, dst_b],
)

stream.sync()
Python 中的 PDL
LaunchConfig 现在通过 programmatic_stream_serialization 选项公开 PDL。在具有 9.0 或更高版本计算能力的 GPU 上,协作内核可以在同一 CUDA 流中重叠执行,从而允许相关内核在其前代内核完成之前开始独立工作。这使得 Python 应用能够访问内核间重叠,同时保留对启动配置的明确控制。请参阅 LaunchConfig 文档。
from cuda.core import LaunchConfig, launch

config = LaunchConfig(
    grid=num_blocks,
    block=256,
    programmatic_stream_serialization=True,
)

# The kernel must implement the PDL synchronization protocol.
launch(stream, config, dependent_kernel, *kernel_args)
更灵活的 CUDA 计算图更新
应用可以在未来实例化之前更新图形定义节点,并通过 graph[node] 视图修改可执行图形节点,而无需重新实例化图形。支持的更新包括内核参数、内存复制、内存集、子图形、事件和主机回调。这些功能可在应用程序参数发生变化时简化图形的复用。
from cuda.core import LaunchConfig
from cuda.core.graph import GraphDefinition

# Define a graph with one kernel node.
graph_def = GraphDefinition()
node = graph_def.launch(
    LaunchConfig(grid=1, block=256),
    kernel,
    output_a,
)

# Instantiate once and run with the original output buffer.
graph = graph_def.instantiate()
graph.launch(stream)
stream.sync()

# Update the executable node's arguments without reinstantiating.
graph[node].update(args=(output_b,))

# The same graph now launches the kernel with output_b.
graph.launch(stream)
stream.sync()
CCCL
CUDA 工具包 13.5 引入了 CCCL 3.5,其中包含适用于 CUB 的公开调优 API、可重现的浮点扫描、新的批量 Top-K 选择和归约,可直接从 GPU 显存中消耗问题大小。这些新增功能可让开发者更好地控制算法执行,并简化与数据相关的工作负载的工作流。
使用公共调优 API 自定义 CUB 性能
CCCL 3.5 为 CUB 设备级算法引入了公共调优策略。开发者可以在执行环境中通过 cuda::execution::tune(...) 自定义参数,例如每个线程块的线程数、每个线程的项目数、向量化和算法选择。
以下示例显示了策略选择器如何为 GPU 计算能力选择调整参数。此选择器将返回 cub::ReducePolicy 以实现设备范围的归约;扫描选择器将返回 cub::ScanPolicy。不提供自定义策略的应用程序将继续使用 CUB 的默认调优。有关示例,请参阅 CUB 调优文档。
struct ReduceTuning
{
    __host__ __device__
    constexpr cub::ReducePolicy
    operator()(cuda::compute_capability cc) const
    {
        auto pass = cub::ReducePassPolicy{
            .threads_per_block = 256,

            // Use 20 items per thread for compute capability 10.0
            // and newer, and 16 for older GPUs.
            .items_per_thread =
                cc >= cuda::compute_capability{10, 0} ? 20 : 16,

            .vec_size = 4,
            .reduce_algorithm = cub::BLOCK_REDUCE_WARP_REDUCTIONS,
            .load_modifier = cub::LOAD_LDG
        };

        // Provide tuning for both multi-tile and single-tile reductions.
        return {.multi_tile = pass, .single_tile = pass};
    }
};

// Attach the selector to the execution environment using the public tuning API.
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::tune(ReduceTuning{})
};

// Keep using the public device-wide API. CUB applies the custom policy
// supplied through the environment.
auto status = cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
批量处理 Top-K 选择
Top-K 选择是 AI 工作负载中的一项重要操作,包括在文本生成期间选择token以及选择相关token以进行稀疏注意力。新的 cub::DeviceBatchedTopK 可在许多片段中独立选择最小或最大的 K 项,支持键和键值对、可变片段大小以及可能因片段而异的 K 值。NVIDIA 在开发该算法时已将 AI 工作负载考虑在内。CUB 的批量 Top-K 集成到 FlashInfer 中,这是一个用于 LLM 推理的 GPU 内核库。
constexpr int segment_size = 4;
constexpr int k = 2;

auto segments_in = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_input), segment_size);
auto segments_out = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_output), k);

auto env = cuda::std::execution::env{
    ...
};

auto status = cub::DeviceBatchedTopK::MaxKeys(
    segments_in,
    segments_out,
    cuda::args::constant<segment_size>{},
    cuda::args::constant<k>{},
    num_segments,
    env);
可复制的浮点扫描
cub::DeviceScan 增加了对浮点求和的运行到运行再现性的支持。现在,您可以通过执行环境请求固定的归约顺序,从而在输入和构建配置相同的同一 GPU 上生成可重复的结果。
以下示例要求获得包含性总和的可再现结果。详情请参阅 cub::DeviceScan 文档。
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
在 GPU 上保持依赖数据的归约
CUB 归约现在可以使用 cuda::args::deferred 消耗存储在设备可访问内存中的元素数量。前面的核函数或选择操作可以生成该计数,并且归约可以按流顺序读取该计数,而无需将其传输到主机。这还允许在每次 CUDA 图形回放中处理不同的元素数量,而无需更新或重新截取图形。
例如,在选择运算将其输出计数写入 d_count 后,归约可以直接消耗它:
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
详情请参阅 cub::DeviceReduce 文档。
新的开发者工具
适用于 AI 的 NVIDIA Nsight Perf SDK – 公开预览
CUDA 工具包 13.5 推出了适用于 AI 的 NVIDIA Nsight Perf SDK 的公开预览版,可为长时间运行的训练和推理工作负载提供全天候分析。该 SDK 保留了原始运行中选定的 GPU 和 CPU 性能指标以及执行上下文,可帮助开发者调查难以重现的间歇性性能问题。开发者可以在 Perfetto 中探索所收集的数据。单击此处了解详情
其他功能
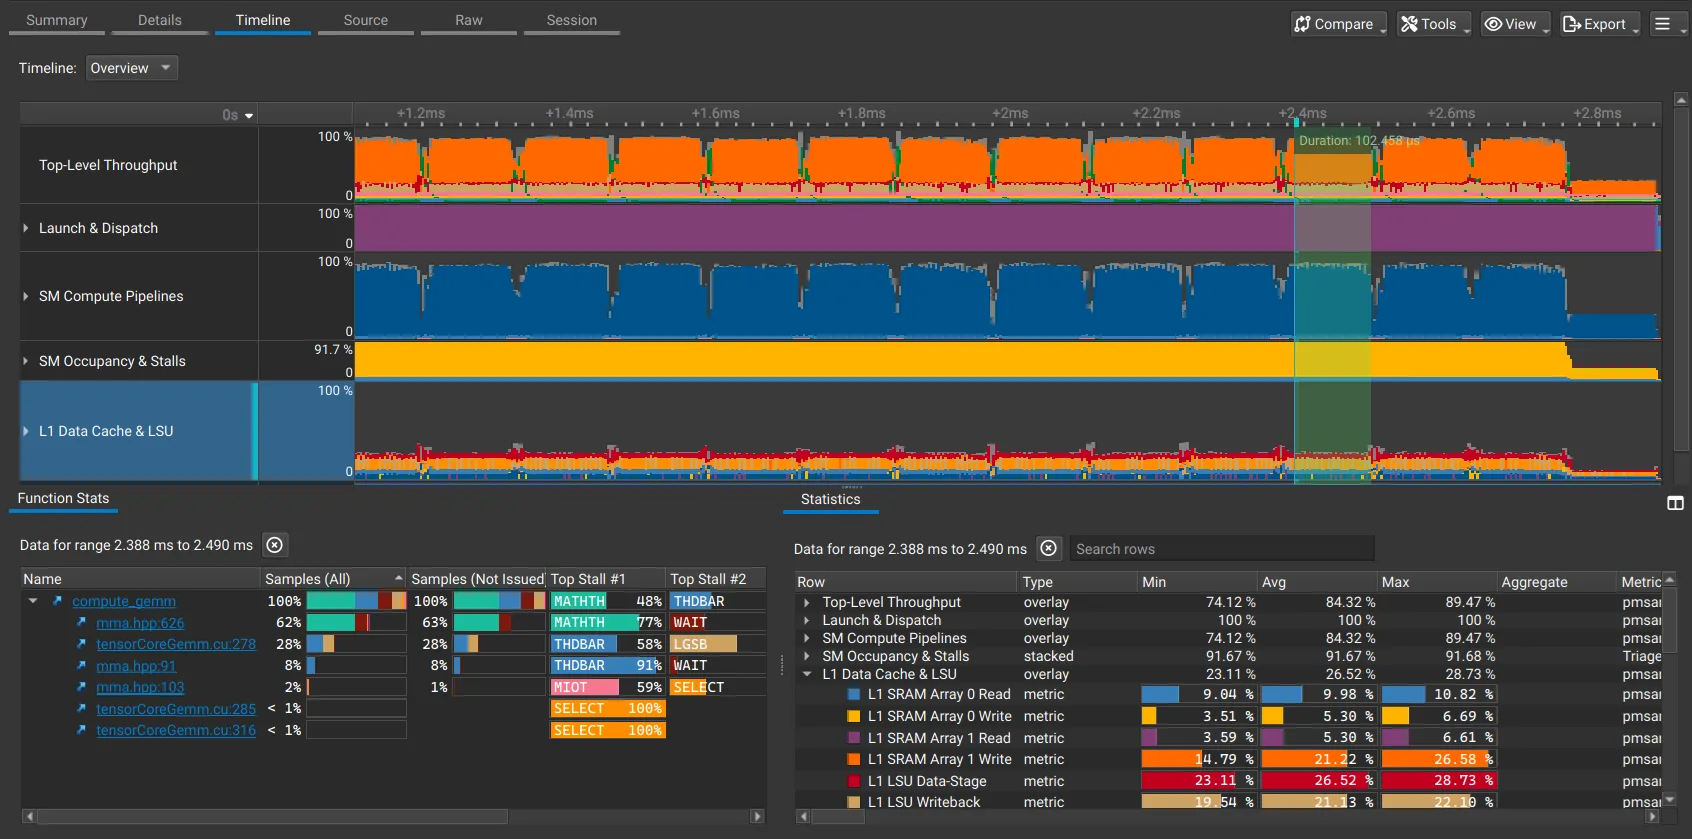
NVIDIA Nsight Compute 2026.4 在 NVIDIA Nsight Compute 中引入了专门的时间轴页面,可让您更轻松地探索 GPU 工作负载随时间变化的性能。该页面将时间分辨率分析数据引入中央视图,以帮助开发者识别聚合指标可以隐藏的工作负载阶段、瞬态停顿以及硬件利用率变化。开发者可以在时间轴之间切换,无需离开页面即可访问集成的功能统计分析,从而将相关性能见解汇总在一起。详细信息页面中的直接链接可简化相关时间轴的导航,而内置指南可帮助用户在报告不包含时间轴数据时快速入门。
CUDA 工具包 13.5 在 CUDA-GDB 中增加了对停止执行 CUDA 驱动程序日志事件的支持,可帮助开发者在发生错误时进行调查。可配置规则按线程、严重程度或消息模式过滤事件,因此开发者可以专注于相关诊断。当匹配事件停止执行时,开发者可以检查主机侧调用堆栈,以追踪触发代码并确定根本原因。
此版本还支持在启用 CUPTI 追踪的同时生成 GPU 核心转储文件。开发者可以在发生异常时捕获 GPU 状态,并在稍后使用支持的调试器检查转储文件,而无需在禁用追踪的情况下重现故障。
一项新的 NVIDIA Compute Sanitizer 智能体技能可帮助 AI 编码智能体选择正确的诊断方法,并解释 CUDA 内存、竞争条件和同步错误。
NVIDIA Nsight Cloud 现在通过 OpenTelemetry 追踪集成 和 NVIDIA Dynamo 部署的分析配置,帮助开发者大规模研究 AI 工作负载性能。
数学库
CUDA 13.5 中的核心 CUDA 数学库现已在 Vera Rubin 上实现性能提升。cuBLAS 将 Ozaki-II 方案扩展到 FP64 对称 rank-k 更新。其他新功能和显著的性能改进包括:
NVIDIA cuBLAS
- 在 NVIDIA Vera Rubin 上运行更快的 GEMM:更新的启发式算法和内核调优可改善 Vera Rubin 上的开箱即用型 NVFP4 和 MXFP8 matmul 性能,包括混合专家模型 (MoE) LLM 训练形状。训练和推理工作负载可获得更高的吞吐量,而无需逐形状自动调整。
- 用于 FP64 对称 rank-k 更新的 Ozaki-II:在 NVIDIA Ampere 和更新的 GPU 上,Ozaki-II 方案现在支持 {D,Z}SYR{K,2K,KX} 和 ZHER{K,2K,KX}。因此,练习 Cholesky 分解和基于 cuSOLVER 构建的最小二乘法求解器的应用现在也可以为这些例程获得 Tensor Core 加速。
- NVIDIA Blackwell 上更快的原生 FP64 对称更新:SYR2K、HER2K、SYRKX 和 HERKX 在双精度和双复数精度下在 NVIDIA B200 上速度最高可提升 1.5 倍。使用原生 FP64 对称更新(例如特征求解器和矩阵分解)的科学代码在不更改代码的情况下实现加速。
- 针对未对齐形状优化的 BF16 内核:BF16 matmuls 的维度不是 8 的倍数,现在使用与 NVIDIA Hopper 和更新的 GPU 上的 FP16 相同的优化内核。层大小不规则的模型 (包括通过 NVIDIA cuDNN 发送的卷积) 不再因选择 BF16 而非 FP16 而受到惩罚。
- Arm 上的 Windows 支持 Blackwell GPU:cuBLAS 增加了对 Arm 上 Windows 上 Blackwell GPU (包括 GB300 工作站) 的功能支持。基于 Arm 的 Windows 系统上的开发者可以运行 cuBLAS 加速的应用程序,而无需切换平台。
NVIDIA cuSPARSE
- 采用 ALG3 的更快 FP32 和 FP64 CSR SpMM:可将数据中心 GPU 的性能提高 1.65 倍至 2.27 倍,从而加速稀疏矩阵密集型矩阵乘法。
- 新的 SpSV ALG2 算法:以几何平均值衡量,其求解性能比 ALG1 快 2.7 倍,可加速重复求解稀疏三角形系统的工作负载。
- 更快的 SpSV 分析:在分析阶段实现 2.79 倍的几何平均值加速,缩短稀疏三角形求解的设置时间。
- 降低 SpSV 显存占用:减少稀疏三角形求解的显存占用,为应用程序数据留出更多 GPU 显存。
- 扩展的混合索引支持:在 SpMV (CSR、SELL)、SpMM (CSR)、SpSV (SELL) 和稀疏到密集/密集到稀疏转换 (CSR、CSC) 中使用 32 位索引的 64 位偏移量,从而实现更大的稀疏矩阵,同时将索引内存使用率保持在低于全 64 位索引的水平。
- 混合精度 CSR SpMV:在
cusparseSpMV中将 FP16 或 BF16 矩阵值与 FP32 输入/输出向量和 FP32 计算相结合,在保持 FP32 累加的同时减少矩阵存储需求。 - 新的实验性
cusparseSpMVGenericAPI:在对称矩阵上执行 SpMV,同时仅存储上下三角形,通过避免重复对角线外条目来降低存储需求。 - 新的实验性
cusparseSpMatConvertAPI:在 CSR 和 CSC 格式之间转换,使稀疏矩阵布局更容易适应不同的运算。 - 使用
csrcolor加快图形着色速度:--dump-elf-symbols9: 以几何平均值衡量,实现约 3 倍的性能提升,从而减少在稀疏矩阵着色上花费的时间。
nvJPEG
- GPU 混合解码吞吐量:
NVJPEG_BACKEND_GPU_HYBRID后端的解码吞吐量可提高 10% 至 600%,具体取决于图像大小以及是否使用标准 Huffman 表。 - 自动后端选择:在使用
nvjpegDecodeAPI 时,NVJPEG_BACKEND_GPU_HYBRID现在也被视为自动后端选择的一部分 (以前只考虑NVJPEG_BACKEND_HYBRID和NVJPEG_BACKEND_HARDWARE)
更新的编译器
在打包期间使用 nvprune 预编译设备代码
CUDA 13.5 在 nvprune 中引入了 --precompile 选项,允许开发者在剪枝步骤中将中间设备代码 ( PTX、TileIR) 编译为原生 SASS/ ELF。
对于将胖二进制文件部署到已知目标架构 (例如。云提供商、软件包分销商) 。
您应选择与部署环境相匹配的目标,并在要支持的 GPU 架构中验证由此产生的构件。
扩展 CompileIQ 支持
CUDA 13.5 将高级控制文件 (ACF) 支持扩展到 PTX 编译器和 NVVM 库。这使得基于这些库构建的编译工作流能够应用由 CompileIQ 生成的编译器控制。
更好地控制 TMA 寻址和更快的基于周期的三角函数
CUDA 13.5 扩展了 PTX 和设备内部功能,可帮助开发者优化数据移动和数学运算。
在内核中配置 TMA 越界寻址
平铺计算经常遇到张量边界,其中图块的一部分落在张量维度之外。高效处理这些破烂的图块对于 MoE、矩阵乘法和卷积等工作负载非常重要。
CUDA 13.5 扩展了 PTX tensormap.replace 指令,因此内核可以直接更新张量映射的 Tensor Memory Accelerator (TMA) 越界寻址模式。这让开发者能够在重用张量映射描述符时控制寻址行为,并且可以避免受影响工作负载中非法寻址失败的高性能替代方案。
使用基于周期的输入进行快速的近似单精度三角函数计算
CUDA 13.5 添加了 __sin2pif、__cos2pif 和 __sincos2pif 设备内部函数,可使用以周期表示的输入进行快速的近似单精度三角计算。
此功能对于使用快速近似三角函数结果的基于相位的计算非常有用。
通过使用相应的 PTX .2pi 变体的 sin 和 cos 指令,对于已使用基于周期的相位的工作负载,可避免额外的角度转换运算。
使用 cuobjdump 更轻松地读取 CUDA 二进制符号
CUDA 13.5 改进了 cuobjdump 中的 ELF 符号表输出,使其更容易理解 CUDA 二进制文件中包含的函数和变量。
| 列 | 说明 |
| 类型 | 标识符号类型,例如函数或对象 |
| 绑定 | 显示符号的绑定,例如本地或全局 |
| 可视化 | 显示符号可见性 |
| 其他 | 识别 CUDA 特定属性,例如内核入口点和内存空间属性 |
以前,符号信息和特定于 CUDA 的属性显示为原始的十六进制字段,开发者必须手动解码。更新后的输出按照 readelf -s: 用户熟悉的约定,以四列形式呈现描述性值
这有助于更轻松地区分内核入口点与设备功能,并检查与全局变量、常量变量、共享变量和受管理变量相关的属性。当应用多个 CUDA 属性时,输出将列出它们的名称。无法识别的属性值仍以 UNKNOWN(0xNN) 的形式显示。
增强功能适用于现有的 --dump-elf 和 NV_skp_1 选项。例如,开发者可以使用以下命令检查 CUDA 二进制文件:
cuobjdump --dump-elf-symbols application.cubin
无需额外的选项即可获取描述性输出。现有信息 (包括符号名称、值、大小和部分索引) 仍然可用。
如果您使用脚本来解析这些符号表转储文件,请更新脚本解析器以适应新列和命名属性值。
开始使用 CUDA 工具包 13.5
CUDA 工具包 13.5 为 NVIDIA Vera Rubin GPU 架构提供 GA 支持、更新的 GPU 资源管理和通信功能,以及跨 CUDA Python、CCCL、CUDA Tile、NVIDIA Nsight 开发者工具和核心数学库的增强功能。
下载 CUDA 工具包 13.5 并查看 CUDA 工具包 13.5 版本说明,获取功能、受支持平台和兼容性信息的完整列表。
在这篇博客中,Jackson Marusarz、Mahender Hari、Mridula Prakash、Daniel Rodriguez 和 Sandeep Hiremath 为这项工作做出了贡献。
