

世界各地的超级计算中心都在集成量子处理器。北美、欧洲和亚洲的国家项目正在推动量子处理器 (QPU) 与高性能计算 (HPC) 系统的安装。每台超级计算机最终都将成为量子 – 经典混合设备,利用量子处理器扩展科学研究的可能性。
首批成为量子 GPU 超级计算高级用户的科学家已经在 HPC 系统上运行了模拟和工作流。化学、天气建模、工程模拟和其他传统上以 HPC 为中心的领域将受益于某些工作负载的量子加速。对于这些科学家来说,QPU 只是超级计算中心已经提供的 CPU 和 GPU 之外的另一种加速器。
要让科研人员将量子处理器引入工作流程,就必须让量子计算机随时可用、易于编程,并且熟悉大规模访问、保留和执行。到目前为止,一个关键的缺失部分是工作负载管理器。 Slurm 26.11 通过分层资源 (HRES) 插件改变了这一点,该插件允许站点通过简短、可移植的 Lua 插件将 QPU 调度为原生集群级资源。
本文将介绍 QPU 与之前用于 CPU 和 GPU 的 Slurm 调度模型不匹配的原因。然后解释解决方案:HRES 如何对 QPU 进行建模,以及在 Slurm 26.11 中添加了哪些 HRES 插件,包括中间件团队构建的 API 回调和功能。它还探讨了社区驱动的接口 (如 QRMI 和 QDMI ) 如何在这些 API 上构建开源插件,以及量子生态系统和超级计算中心的初始采用情况。
构建量子 GPU 超级计算
在超级计算中心集成 QPU 需要的不仅仅是物理安装。QPU 必须与现有的计算基础设施联网,并且用户必须能够像请求 CPU 和 GPU 一样在作业提交时请求 QPU。必须对其使用情况进行跟踪、监控和问责,并且必须遵守特定于站点的政策。换言之,调度程序或工作负载管理器必须像管理任何其他计算资源一样管理 QPU。
到目前为止,调度器还没有对 QPU 进行建模的原生方式,因此大多数集成都是针对每个新的超级计算站点或 QPU 构建器反复定制的。造成碎片化的代价将由所有相关人员承担:
- 每个站点的用户界面都不同。
- 管理员必须维护自定义代码,以免升级变得复杂。
- QPU 供应商为每个客户重建集成,且不具备可移植性。
- 全球系统集成商 (GSI) 无法提供可重复的部署。
在 QPU 方面,QRMI 和 QDMI 等开源项目正在统一 HPC 软件描述和控制此类设备的方式。目前缺少的是超级计算中心用于将 QPU 集成到 HPC 部署的调度程序中的统一接口。
为什么现有 Slurm 资源模型无法适应 QPU
QPU 通常是集群范围内的加速器,而不是节点的一部分。Slurm 通用资源 (GRES) 是用于 GPU 的机制,属于单个计算节点。将 QPU 建模为 GRES 会将其绑定到一个节点,因此只有该节点上的作业才能使用它。例如,如果该节点发生故障,在管理员重新配置集群之前,QPU 一直无法访问。
相反,许多集成会结合使用 SPANK 许可 (代表整个集群的资源) 进行调度,并使用 SPANK 插件进行用户界面和节点设置。这种方法有效,但存在几个问题:
- 空闲节点: 如果没有许可证,SPANK 仅在 Slurm 已分配节点后发挥作用,因此作业可能会在等待 QPU 期间保持计算节点空闲。
- 双标志请求:在未持有许可证的情况下,任何操作都不会阻止作业传递设备选项。
- 多个 QPU: 在一个集群上托管多个 QPU 很困难,因为它们的 SPANK 插件会争夺相同的命令行选项。
- 升级风险: 在实践中,许多 SPANK 插件将第三方代码与 Slurm 内部 API 绑定,因此每次 Slurm 升级都有可能破坏集成。
- 无设备感知: Slurm 无法自行判断 QPU 何时重新校准或离线,因此会不断启动在设备重新上线之前无法使用设备的作业。
Slurm 26.11 中的 HRES 插件如何实现集成
Slurm 26.11 引入了一个 HRES 插件接口来填补这些空白,以便 HPC 和量子社区可以在不更改 Slurm 本身的情况下与 Slurm 集成。其第一个实现 hres/lua 运行一个简短的 Lua 脚本。该插件会向调度程序报告设备运行状况,在资源请求中接受设备选项,并在作业的每个阶段运行设置和拆解代码。
网站会在 resources.yaml 中将 QPU 描述为集群级 HRES,并将其指向插件。这两个文件会将工作分开。 resources.yaml 会在系统管理员的控制下保存站点特定的详细信息和策略,例如端点以及哪些节点可以访问设备。该插件包含设备逻辑,因此社区或 QPU 供应商只需编写一次,即可将其发布到部署 Slurm 26.11 的每个站点。
将 QPU 建模为分层资源
HRES 作为测试版功能添加到 Slurm 25.05 中,是许可证的演变。与许可证一样,HRES 是不属于任何单个节点的资源计数。与许可证不同,该计数与一组特定节点 (即允许使用它的节点) 相关联 (图 1) 。Slurm 26.11 还开始支持对节点与 HRES 之间的关系进行更动态的建模。
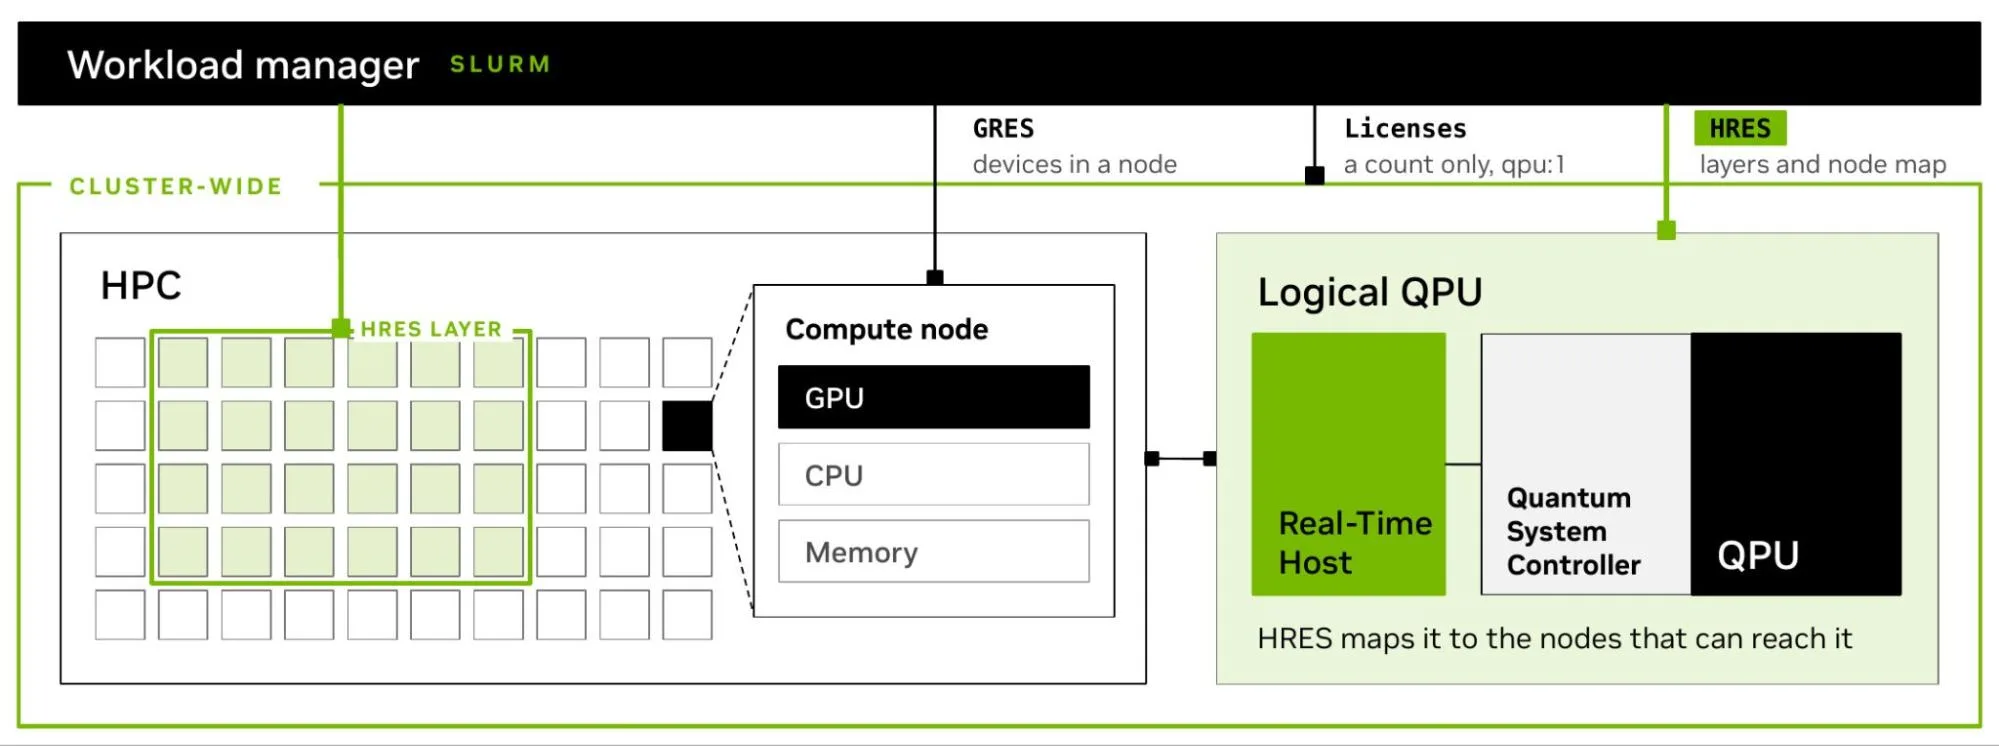
HRES 在 resources.yaml 中定义,其目录与 slurm.conf 相同。每个资源都有一层或多层,每层都有名称、节点列表和计数。对于 QPU,最简单的定义是覆盖可到达设备的节点的单层 (数量为 1) 。plugin 块附加 Lua 脚本及其站点特定设置:
- resource: qpu
  mode: MODE_1
  plugin:
	type: hres/lua
	config:
  	- name: path
    value: /etc/slurm/hres_qpu.lua
  	- name: endpoint               	# site settings, never secrets
    value: https://qpu-gateway.example.org
	maintenance_cycle: 30            	# seconds between health checks
  layers:
	- layer_name: qpu1
  	nodes: ["node[0001-0123]"]
  	count: 1
根据此定义,当与作业所分配节点重叠的层拥有足够的可用资源时,请求就会得到满足。请求 QPU 的作业仅在该层的节点上运行。作业通过 --resources=qpu:1 请求资源。
中间件是 HPC 和 QPU 之间的边界
在图 2 所示的模型中,Slurm 和 Lua 插件都不会直接与 QPU 对话。第三方访问中间件位于 HPC 系统和 QPU 之间,为不同的量子硬件 API 提供统一的接口。因此,中间件是 HPC 系统和 QPU 之间的边界。
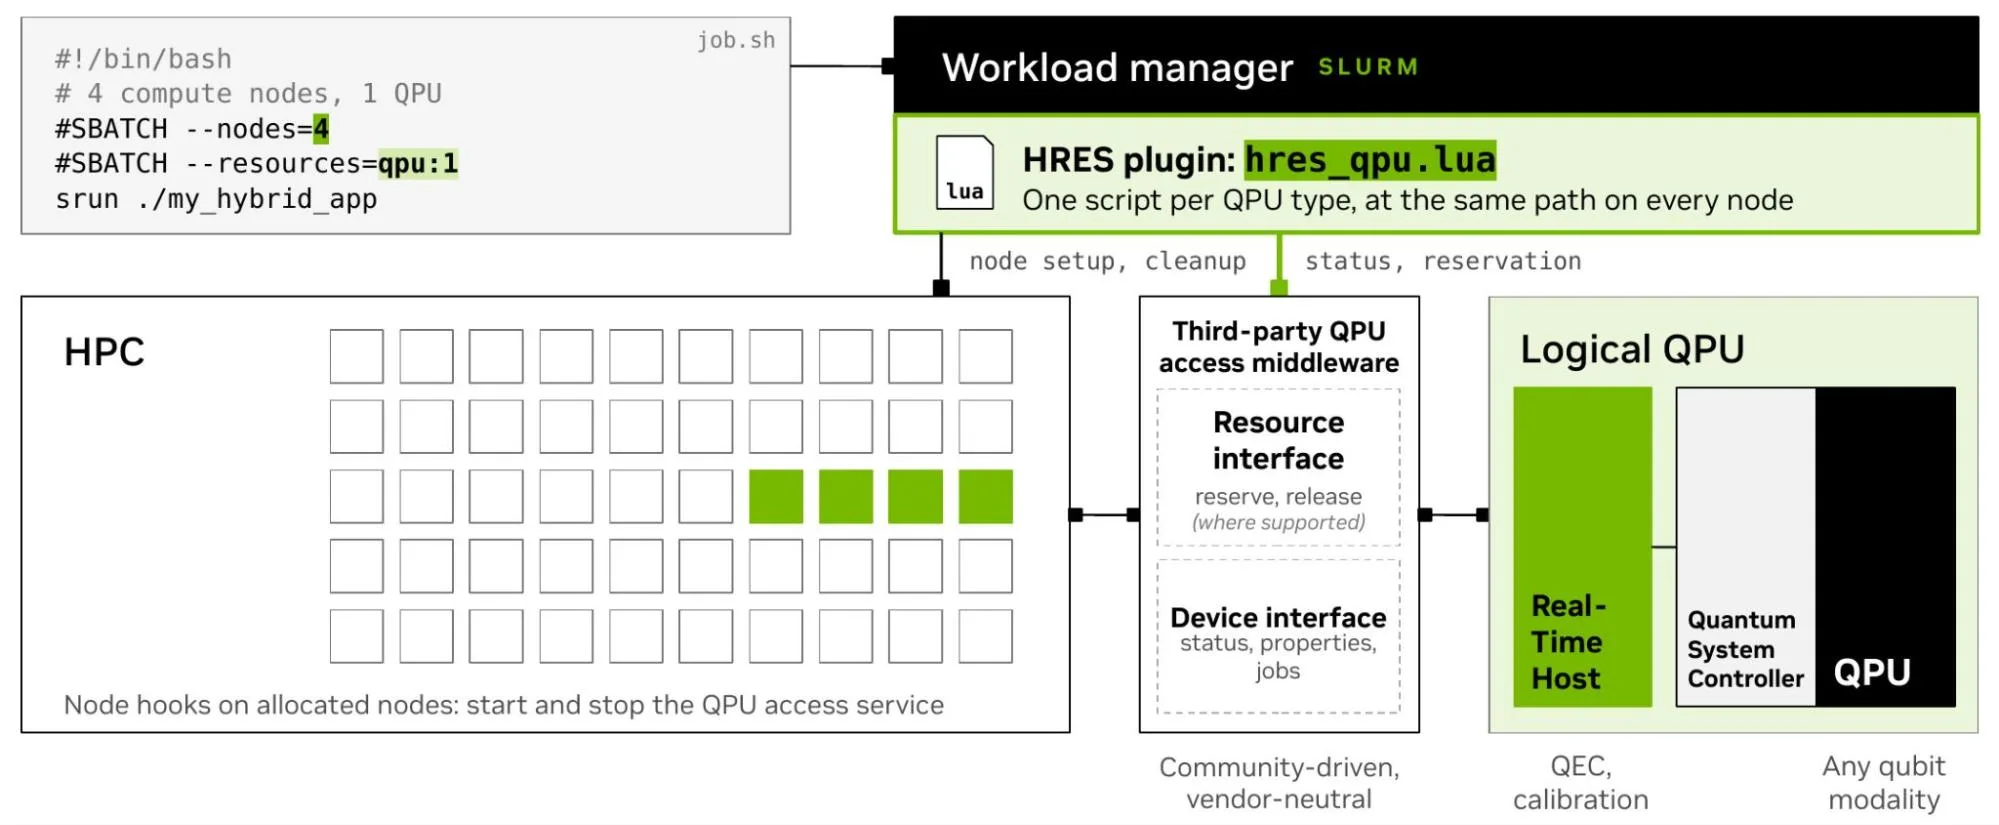
Slurm 将 QPU 视为单个可调度单元。它决定该单元是否可用、哪个作业拥有它、使用多长时间以及来自哪些节点。重要的是,Slurm 不会在设备内部编排任何内容:校准、纠错和设备控制均保留在 QPU 及其自己的软件运行时中。因此,该方法既适用于当今噪声较大的中尺度量子 (NISQ) 设备,也适用于未来的纠错系统。
插件会在两侧之间转换。它要求中间件提供状态和保留,并按照 Slurm 的术语向 Slurm 报告结果:层是否禁用、作业是否可以启动,以及作业节点的有效载荷。
HRES 插件 API
目前,HRES 插件的实现会运行由社区或设备供应商编写的 Lua 脚本。
Lua
Lua 插件是一个纯文本文件,供应商可以独立于 Slurm 的发布周期进行发布和更新。它不与 libslurm 关联,libslurm 的 API 会更改每个版本,因此无需为每次 Slurm 升级进行重建。Lua 速度也很快,可以在 C 语言中清晰地嵌入,并且 Slurm 的作业提交和 CLI 过滤器插件已经使用了 Lua。脚本必须位于控制器和每个节点上的相同路径上,而且由于其大多数函数以 root 或 SlurmUser 的身份运行,因此只有 root 能够对其进行写入。
主要功能包括:
- 堆叠性: slurmctld 为定义插件的每个资源创建单独的插件上下文。一个集群可以托管多个 QPU 和多种 QPU 类型,而不会发生 SPANK 插件遇到的选项冲突。
- 站点配置: 端点和其他设置位于插件的
config列表中,Slurm 会将其传递给插件,而无需解释。配置、作业参数和任何有效载荷会随作业一起到达其节点,作业的用户可以在其中读取它们。这意味着他们都不可能保守秘密。 - 用户输入:用户向请求附加
name=value参数,例如--resources='qpu:1[shot=1000]'。Slurm 会在不进行解释的情况下将其传递给插件,这样就不需要第二个命令行标志。 - 运行状况检查:每隔
maintenance_cycle秒,维护回调就会询问中间件 QPU 是否准备就绪,并在每层设置或清除disable_layer,以停止或恢复分配。 - 作业开始和结束: 作业完成调度后,在其节点分配之前,控制器预运行可以接收或保持该作业,因此作业在等待 QPU 时永远不会占用空闲节点。由于预运行会持有控制器的作业锁定,因此预留 QPU 等缓慢的工作属于可选的异步预运行,其负载 Slurm 将发送到作业的节点。如果作业未开始,则 revoke 回调函数会撤消保留,而控制器 Epilog 则会在作业结束时将其释放。
- 故障处理: 回调函数可返回
ESLURM_HRES_REMOTE_FAIL,以报告外部服务不可用而非损坏。如果预运行失败,作业将处于待处理状态,而失败的节点 Prolog 或 Epilog 不会耗尽节点。
插件会按照回调函数在作业中的运行顺序来实现表 1 中的回调函数。
| 回调 | 运行 | QPU 使用示例 |
|---|---|---|
hres_create_context |
slurmctld,用于读取配置时具有插件的每个资源。此时,每一层都未显示任何已使用的内容 | 检查是否可以访问服务并设置连接或状态 |
hres_maintenance |
slurmctld,每秒钟 maintenance_cycle | 查询中间件的状态;设置或清除每层的 disable_layer |
hres_controller_job_prerun |
slurmctld,作业完成调度后,在其节点分配之前,位于作业锁定下 | 承认或保留作业,例如缓存设备状态 |
hres_controller_job_async_prerun (optional) |
slurmctld,在一个单独的线程中 | 在服务上保留 QPU;返回作业节点的负载 |
hres_controller_job_revoke |
slurmctld,预运行成功后作业仍未开始 | 撤消预订 |
hres_node_job_prolog |
作业的每个节点一次,在 Prolog 脚本之前 | 启动访问服务或编写每作业文件 |
hres_node_task_prolog |
slurmstepd,在每个任务开始之前以 root 身份执行 | 针对每个任务的授权设置 |
hres_node_user_task_prolog |
slurmstepd,在每个任务开始之前以用户的身份执行 | 用户的每个任务设置 |
hres_node_task_epilog |
slurmstepd,每个任务结束后 | 逐任务清理 |
hres_node_job_epilog |
作业的每个节点一次,在 Epilog 脚本之后 | 停止服务;删除每个作业的文件 |
hres_controller_job_epilog |
slurmctld,在作业的所有节点结束之后,在返回其资源之前 | 取消预约 |
hres_destroy_context |
slurmctld,在再次读取配置之前 | 紧密连接并释放脚本保存的任何内容 |
hres_create_context 以及 hres_destroy_context 也可在 slurmctld 读取其配置时运行大多数集成只需要几个回调。以下骨架显示了插件的形状:运行状况检查、分配任何节点之前的准入决定以及作业结束时的发布。 middleware_* 调用代表中间件自己的客户端库。
-- Callback names, arguments, fields, and return codes are Slurm's hres/lua API.
-- middleware_* calls are placeholders for your middleware's client library.
  -- Health: slurmctld, every maintenance_cycle seconds
function hres_maintenance(ctx, layers)
  local ready = middleware_status(ctx.config.endpoint)
  for _, layer in ipairs(layers) do layer.disable_layer = not ready end
  return slurm.SUCCESS
end

-- Admission: once the job is scheduled, before its nodes are allocated
function hres_controller_job_prerun(ctx, job, prep)
  if not middleware_can_admit(ctx, prep.plugin_args) then   -- cached, no network
	return slurm.ESLURM_HRES_REMOTE_FAIL                	-- the job stays pending
  end
  return slurm.SUCCESS
end

-- Release: after the job's node epilogs
function hres_controller_job_epilog(ctx, job, prep)
  middleware_release(ctx.config.endpoint, prep.payload)
  return slurm.SUCCESS
end

-- The remaining required callbacks return slurm.SUCCESS.
HRES 插件的社区集成示例
构建 QPU 访问中间件的团队通常会编写 HRES 插件。其中两个社区 QRMI 和 QDMI 已发布基于 Slurm 26.11 API 构建的开源插件。两者都仅在 QPU 可用的情况下才允许作业,在这两种情况下,层的数量会设置一个 QPU 可以同时使用的作业数量。QRMI 插件可在每个作业运行之前获取对其 QPU 的访问权限。QDMI 插件仅接收作业,然后每个作业都会将其工作与提供程序一起排队。无论使用哪种插件,运行 Slurm 26.11 的站点都可以将其集群连接到多个提供商的量子计算机。
QRMI:获取每个作业的 QPU
每个 HRES 资源都以 QRMI 配置文件中的资源命名。在作业运行之前,插件会使用用户自己的凭据在调度程序关键路径之外的单独线程中预订对 QPU 的访问,并在作业结束后将其释放。根据后端,预订是预订还是会话。现有应用程序的运行不会改变,因为作业会看到与 QRMI SPANK 插件相同的环境变量。有关完整的配置、插件和容器化测试集群,请访问 QRMI HRES 插件库。
QDMI:将队列留给提供程序
每个 HRES 资源都是一个设备,以其 QDMI 设备 ID 命名。插件的维护回调会检查设备的状态,并仅在设备报告自身处于空闲或忙碌状态时才会接收作业。插件不会保留任何内容:每个作业都通过 QDMI 提交其工作,而提供商的队列会在设备上调度。有关完整的配置和插件,请访问 MQSC Orchestrator。
了解量子生态系统中的更多组织如何集成 HRES 插件:
用户作业提交
就用户而言,这两种集成在外观和感觉上都是一样的。工作脚本通过其 HRES 资源名称请求 QPU,就像它请求节点或 GPU 一样,并运行在包含为 HRES 分配的节点的分区中。Slurm 会一直保留该作业,直到插件报告 QPU 可用,并在中间件支持的位置保留该作业。以下模板适用于这两种集成;只有资源名称发生变化。
#!/bin/bash
#SBATCH --job-name=my-hybrid-job
#SBATCH --nodes=4
#SBATCH --time=00:30:00
#SBATCH --resources=<qpu_resource>

srun ./my_hybrid_app
开始使用 Slurm HRES 插件
Slurm 26.11 为 QPU 提供了调度程序中的原生位置。HRES 将 QPU 建模为与可访问 QPU 的节点相关联的集群级资源,Lua 插件则将该资源连接到管理设备的中间件。由于 Lua 插件几乎无法容纳特定于站点的内容,因此供应商或社区项目只需编写一次,每个 Slurm 站点都可以重复使用该插件,而管理员则可以控制自己的策略。
根据设计,这种方法适用于当代量子计算机和未来的容错系统,使其成为部署量子设备的超级计算中心的持久选择。
准备好开始了吗?部署 QRMI HRES 插件 或 QDMI HRES 示例,或将其用作集成的起点。如需了解详情,请查看 Slurm 26.11 版本说明,并阅读 HRES 文档 和 resources.yaml 参考资料。
致谢
我们感谢 QRMI 和 QDMI 社区基于 HRES 插件进行构建,以及他们对此博文的贡献。


