

代理式工作负载、长文档和大型代码库正在将上下文长度从数万个 token 推向数十万个 token。在这些长度下,注意力成为 Transformer 层最昂贵的部分。密集注意力针对每个键对每个查询进行评分,因此每次查询的成本随着上下文长度 N 而增长,在 128K 个 token 时,它可以在层中占用大部分预填充时间。
模型级解决方案是稀疏注意力,这是一种 Transformer 技术,其中每个查询仅关注每个查询所选择的上下文的一小部分,而非全部。这同时减少了长上下文中注意力的计算和内存流量。
对于设计在 NVIDIA GPU 上运行良好的稀疏注意力模型的模型开发者来说,本文是一篇实用入门文章。它侧重于模型级稀疏注意力,即在模型中训练稀疏性,而不是在训练后应用插入式方法,例如 BLASST、MInference 或 Quest 。产品级 FP8 内核用于扫描索引器的设计旋钮 (查询头、键头、头维度、压缩比和预测解码深度) ,衡量 Top-k 成本的扩展方式,并将 token 级与块级核心注意力进行比较。
每一部分都会解释硬件奖励的内容及其原因,并在最后给出您可以应用于自己设计的指南。本文采用的联合设计方法与之前关于密集关注和硬件友好型 LLM 设计的文章相同。
什么是稀疏注意力?为什么重要?
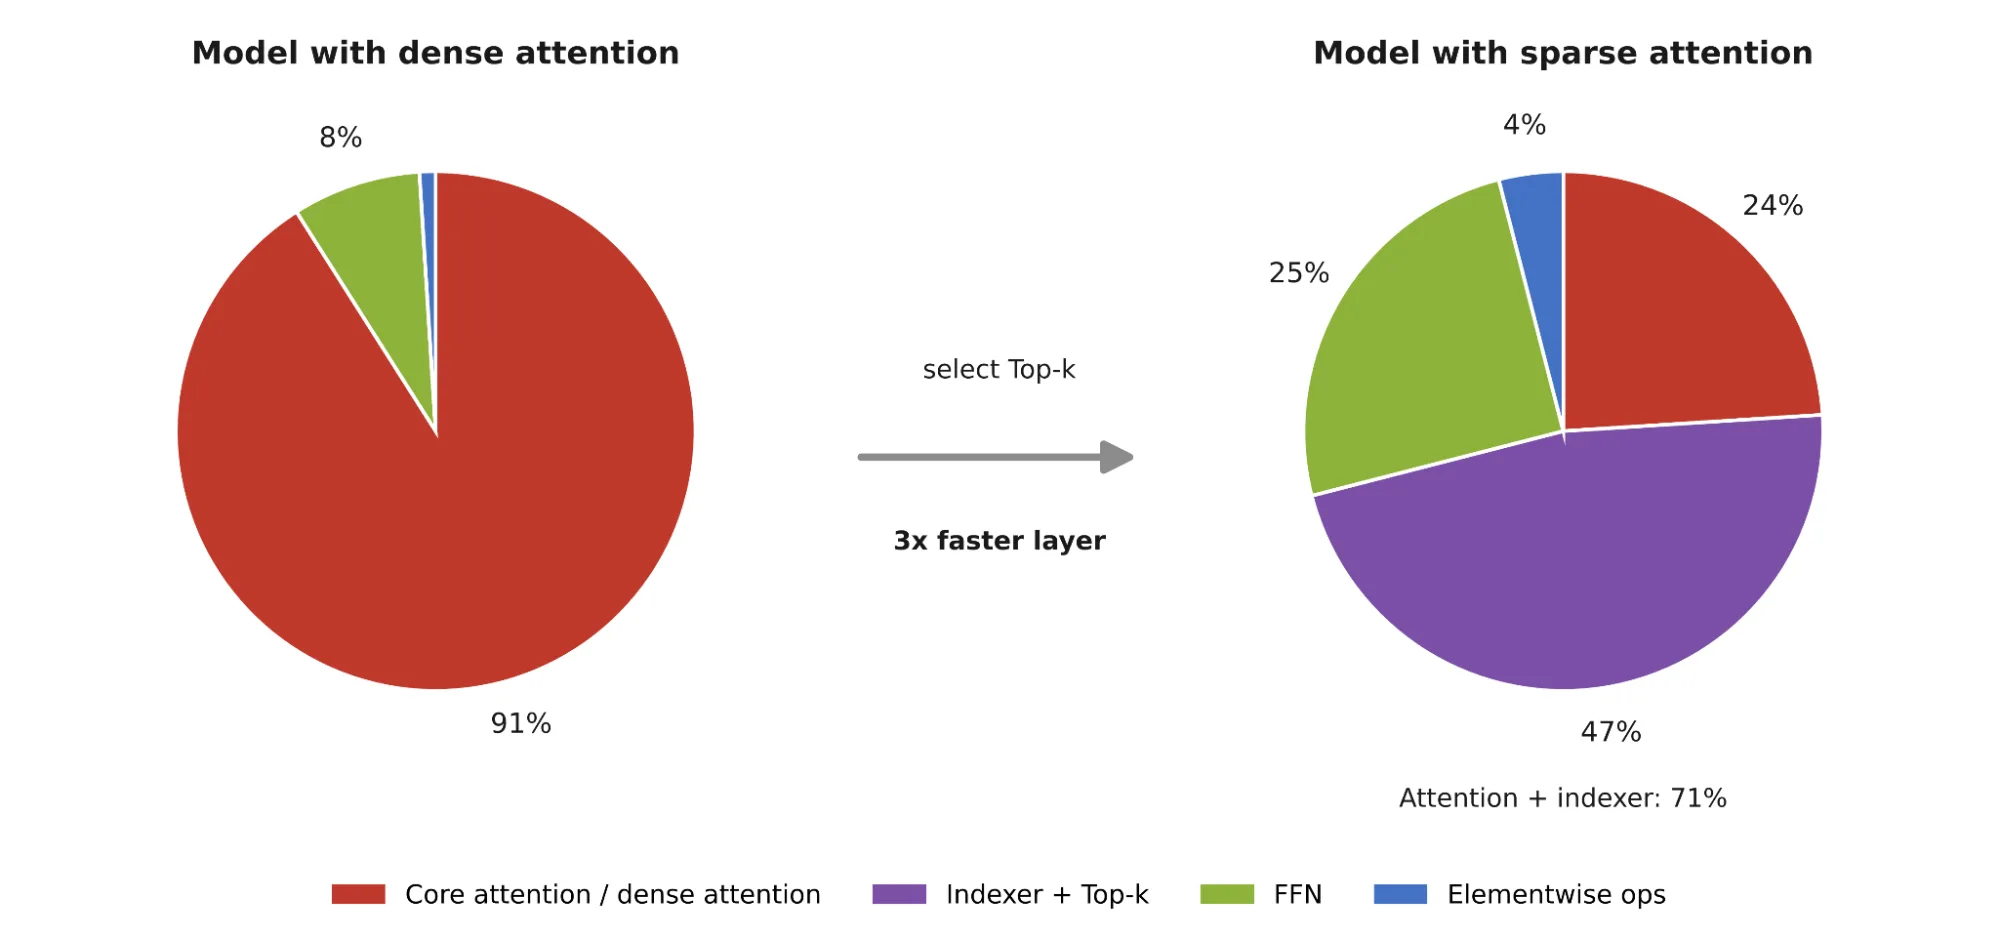
稀疏注意力是一种 AI 优化技术,可限制每个查询所关注的先验 token。每个查询仅关注最相关的 \(k\) 键,通常只有几千个,而不是关注整个上下文。然后,Core attention 停止随上下文进行扩展。但必须找到这些 \(k\) 密钥,而找到这些密钥的组件 (即索引器) 仍然会对所有 \(N\) 密钥进行评分。成本不会消失,而是会转移到索引器中。在图 1 中,Indexer 和 Top-k 占用 DeepSeek V3.2 预填充层的 47%。
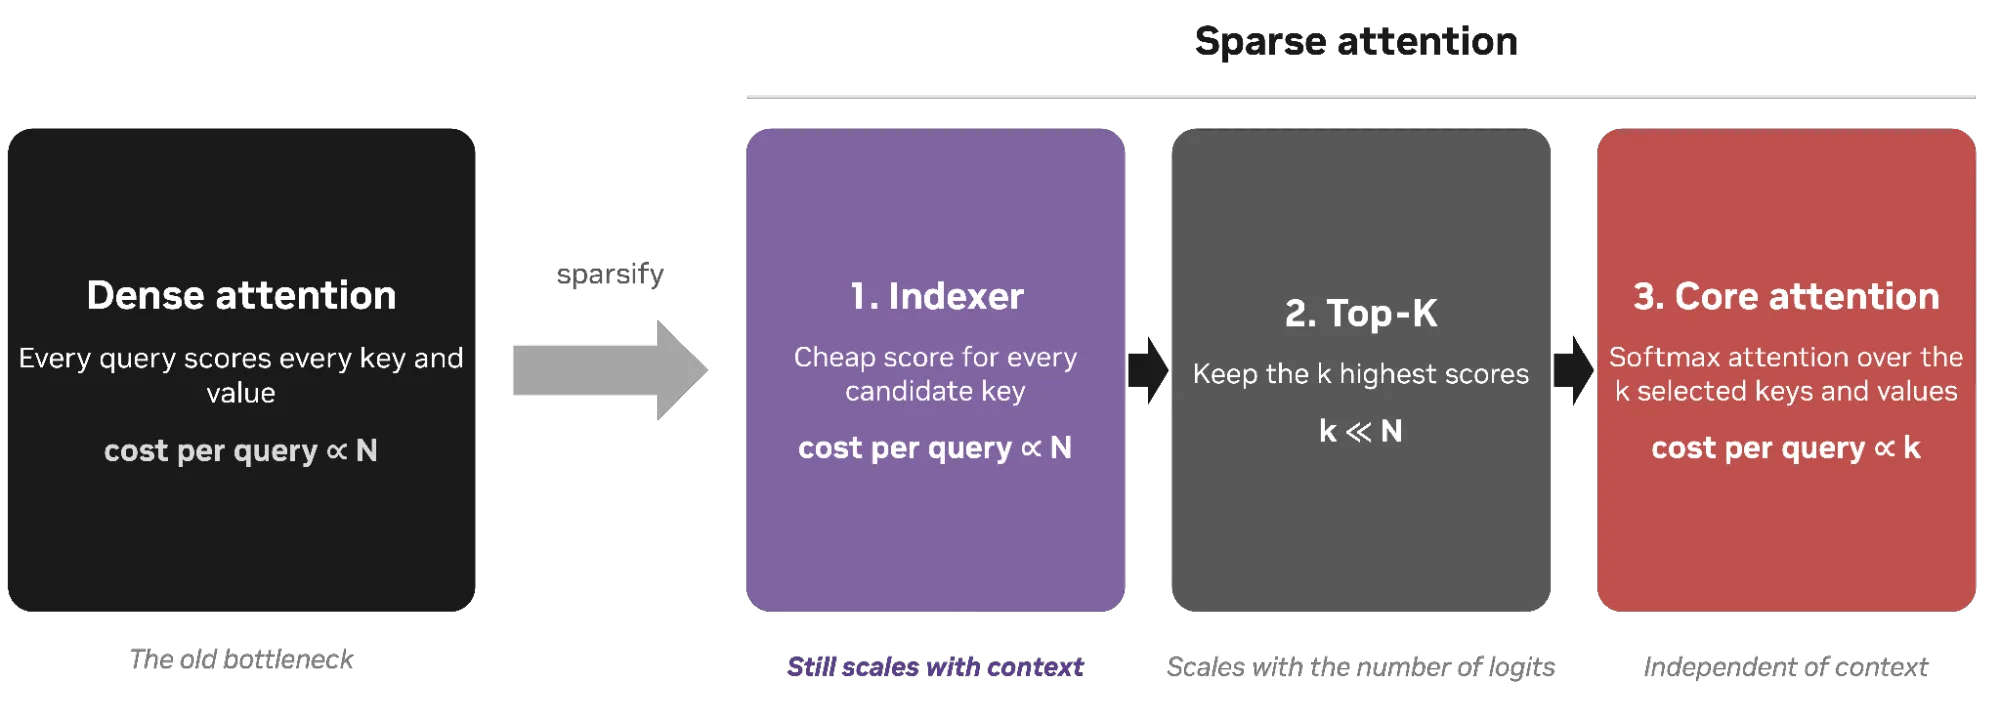
稀疏注意力分为三个阶段 (图 2) 。索引器为每个键打分,Top-k 保持 \(k\) 的最高分,核心注意力对这些 \(k\) 键和值运行 softmax 注意力。最后两个阶段使用 \(k\),索引器使用 \(N\)。
索引器设计空间
索引器是一个类似注意力的小块。查询头会针对索引器密钥缓存对当前查询进行评分,而后处理操作 (例如 ReLU 和加权总和) 则会将分数转换为每个密钥一个 logit。表 1 显示了最近的模型如何填充该数据。表 2 提供了本文中所用符号的关键帧。
| 模型/ 方法 | \(Q\) 头 | \(K\) 头 | 高频率 | 后处理 | CR | 选择粒度 | 注意事项 |
| 密集注意力 | 无 | 无 | 无 | 所有按键 | 基准。没有索引器,每个查询都会关注每个键 | ||
| DeepSeek 稀疏注意力 (DSA) | 64 | 1 | 128 | ReLU+ 加权和 | 1 | Token | 单独的 FP8 索引缓存 |
| GLM 5.2 | 32 | 1 | 128 | ReLU+ 加权和 | 1 | Token | 各层之间共享的索引 |
| GLM 5.3 闪存 | 32 | 1 | 128 | ReLU+ 加权和 | 4 | 4 尾块 | |
| LongCat LSA-Flash | 32 | 1 | 128 | ReLU+ 加权和 | 1 | Token | 分层式索引共享 |
| CSA | 64 | 1 | 128 | ReLU+ 加权和 | 4 | 压缩 token | |
| QWEN QSA | 4 | 1 | 128 | ReLU = sum | 4 | 4 尾块 | |
| MiniMax MSA | 4 (每组 1 个) | 1 | 128 | 最大池积分 | 1 | 128 块 | 对每个 token 进行评分,池化每个块的分数,不进行交叉头归约 |
| NSA | 64 | 4 | 192 | Softmax | 16 | 16 块 | |
| MoBA | 32 | 8 | 128 | \(K\) 上的均值池 | 4096 | 4096 块 | 评分前池化关键帧,无交叉头缩减 |
| 符号 | 含义 |
| \(N\) | 上下文长度:预填充中的 ISL,解码中的 KVSL |
| PB、DB | 预填充和解码批量大小 |
| QH、KH | 索引器查询头和索引器密钥头 |
| \(G\) | 组大小 = QH/ KH:查询头对一个共享 K 头进行评分 |
| 高频率 | 分度头尺寸 |
| ISL、KVSL | 输入序列长度 (预填充) ,当前解码步骤的 KV 缓存长度 |
| CR | 索引器密钥缓存的压缩比 (每个 CR token 一个索引器密钥) |
| \(D\) | 每个解码步骤 (预测解码) 的草稿 token,每个步骤的查询行 = \(D\)+ 1 |
| B, B_out | 每个输入元件的字节数 ( FP8 为 1) ,每个输出 logit 的字节数 ( FP32 为 4) |
大多数设计都使用 KH = 1,32 到 64 个查询头减少到一个分数,并使用 ReLU 和加权求和、Hsz = 128 以及 token 或小块选择。接下来的五个部分 (每个设计旋钮一个) 中的测量结果会显示哪些在 NVIDIA GPU 上是高效的,哪些应该改变。
索引器如何计算?
索引器是一个批量矩阵,具有融合的结语 (表 3) 。预填充会一次性对所有 ISL 查询 token 进行评分,因此 matmul 较大且受计算限制。解码仅对每个 KH 的每步 \(D\)+ 1 查询 token 进行评分,并从 HBM 流式传输整个密钥缓存以进行几行 logit。
| 运营 | 阶段 | 预填充形状 | 解码形状 | 运行条件 |
| 对 BMM 评分 ( Q = K) | 主循环 | [PB+ KH、ISL+ G、ISL/ CR、Hsz] | [DB = KH、 ( D+ 1) + G、KVSL/ CR、Hsz] | Tensor Core |
| 后处理 ( ReLU) | 结语 | [PB+ KH+ ISL+ G,ISL/ CR] | [DB = KH+ ( D+ 1) + G,KVSL/ CR] | CUDA 核心 |
| 交叉头消除 ( G 以上的加权和) | 结语 | [PB+ KH+ ISL、ISL/ CR] | [DB* KH* ( D+ 1) 、KVSL/ CR] | CUDA 核心 |
| Logit 商店 | 结语 | [PB+ KH+ ISL、 ( ISL/ CR) ] | [DB* KH* ( D+ 1) 、KVSL/ CR] | HBM 写入 |
通过计算 FLOPS、\(Q\) 和 \(K\) 读取以及 logit 写入,可以给出每个阶段的算术强度。在预填充中,\(Q\) 和 \(K\) 项会缩小为 1/ ISL,因此在长上下文中,只有 logit 写入存活。
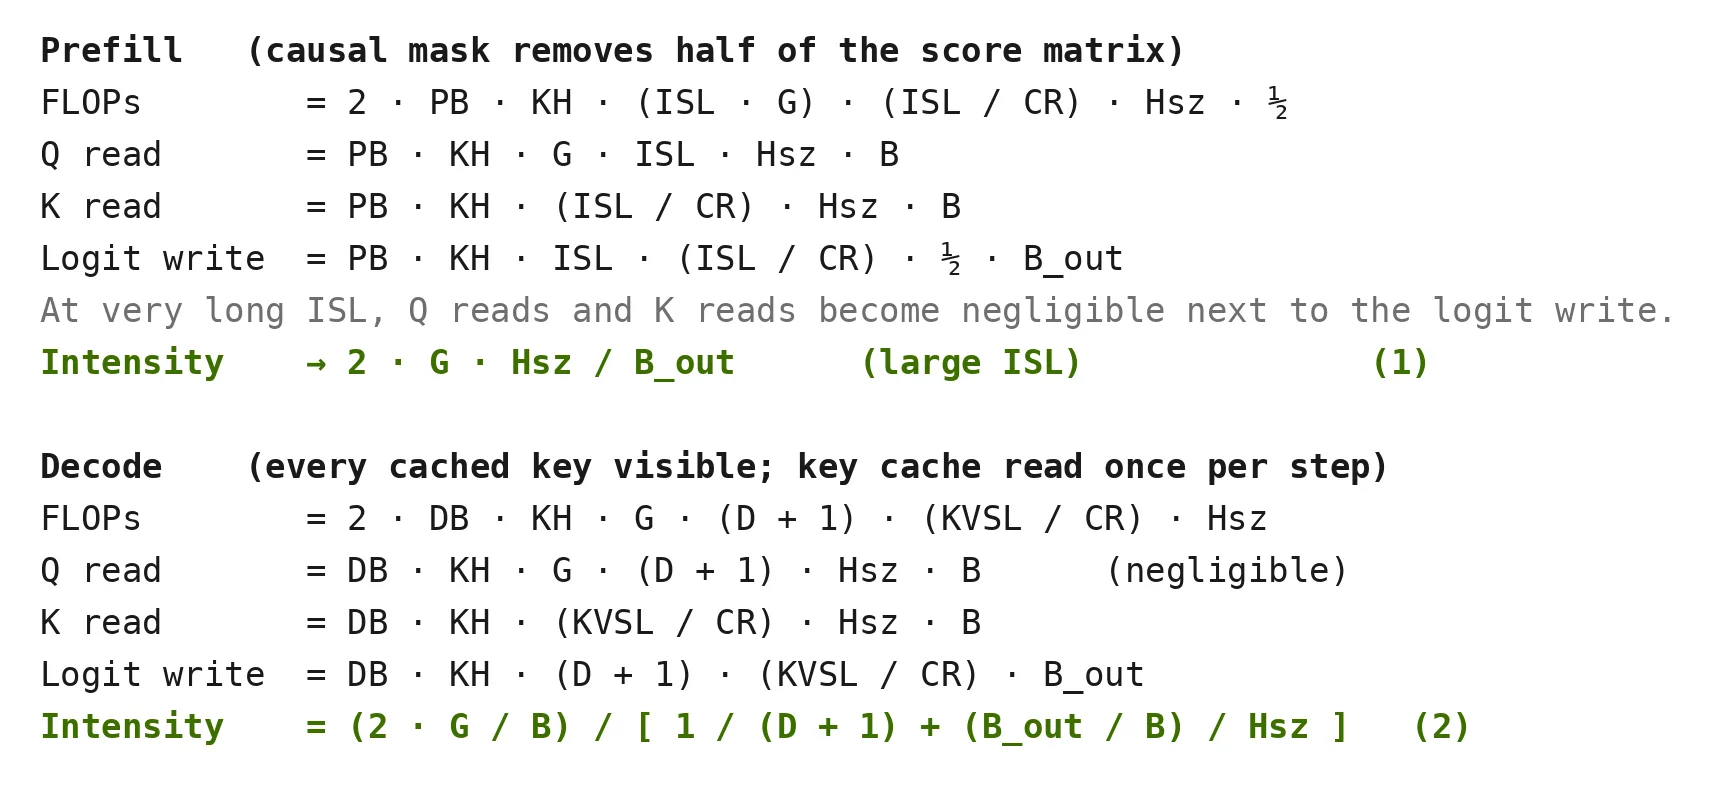
图 3. 预填充和解码中的索引器算术强度方程
根据图 3 所示的方程 1 和方程 2 得出三个观察结果:
- 序列长度 ( ISL、KVSL) 和 CR 在两个方程中都没有出现:它们可扩展总工作量,但无法扩展 FLOPS 与字节的比率。
- 这两种强度均与 \(G\)% QH/ KH 成正比。将一个组的 \(G\) 头数减少为 1 logit,可使每个 logit 写入的浮点运算能力增加 \(G\) 倍。未降低该系数的设计 ( MSA、MoBA) 会损失该系数。
- 随着 \(D\)+ 1,解码强度几乎呈线性增长,并且几乎独立于 Hsz,只要所有 \(D\)+ 1 查询 token 都适合密钥缓存的一次传递。
除非另有说明,否则测量结果使用具有 64K 索引键 (CR = 4) 、Hsz = 128、KH = 1、PB = 1 和 DB = 128 的 FP8 索引器内核。
查询标题、组规模和预测草稿长度
强度与组大小成正比,但预填充和解码的响应不同。预填充受计算限制,因此查询头数越多,相应时间就越长。解码受内存限制:读取密钥缓存是主要瓶颈。更多查询头会增加 FLOP,但不会增加新字节,因此运行时保持不变。图 4 确认了这两者。
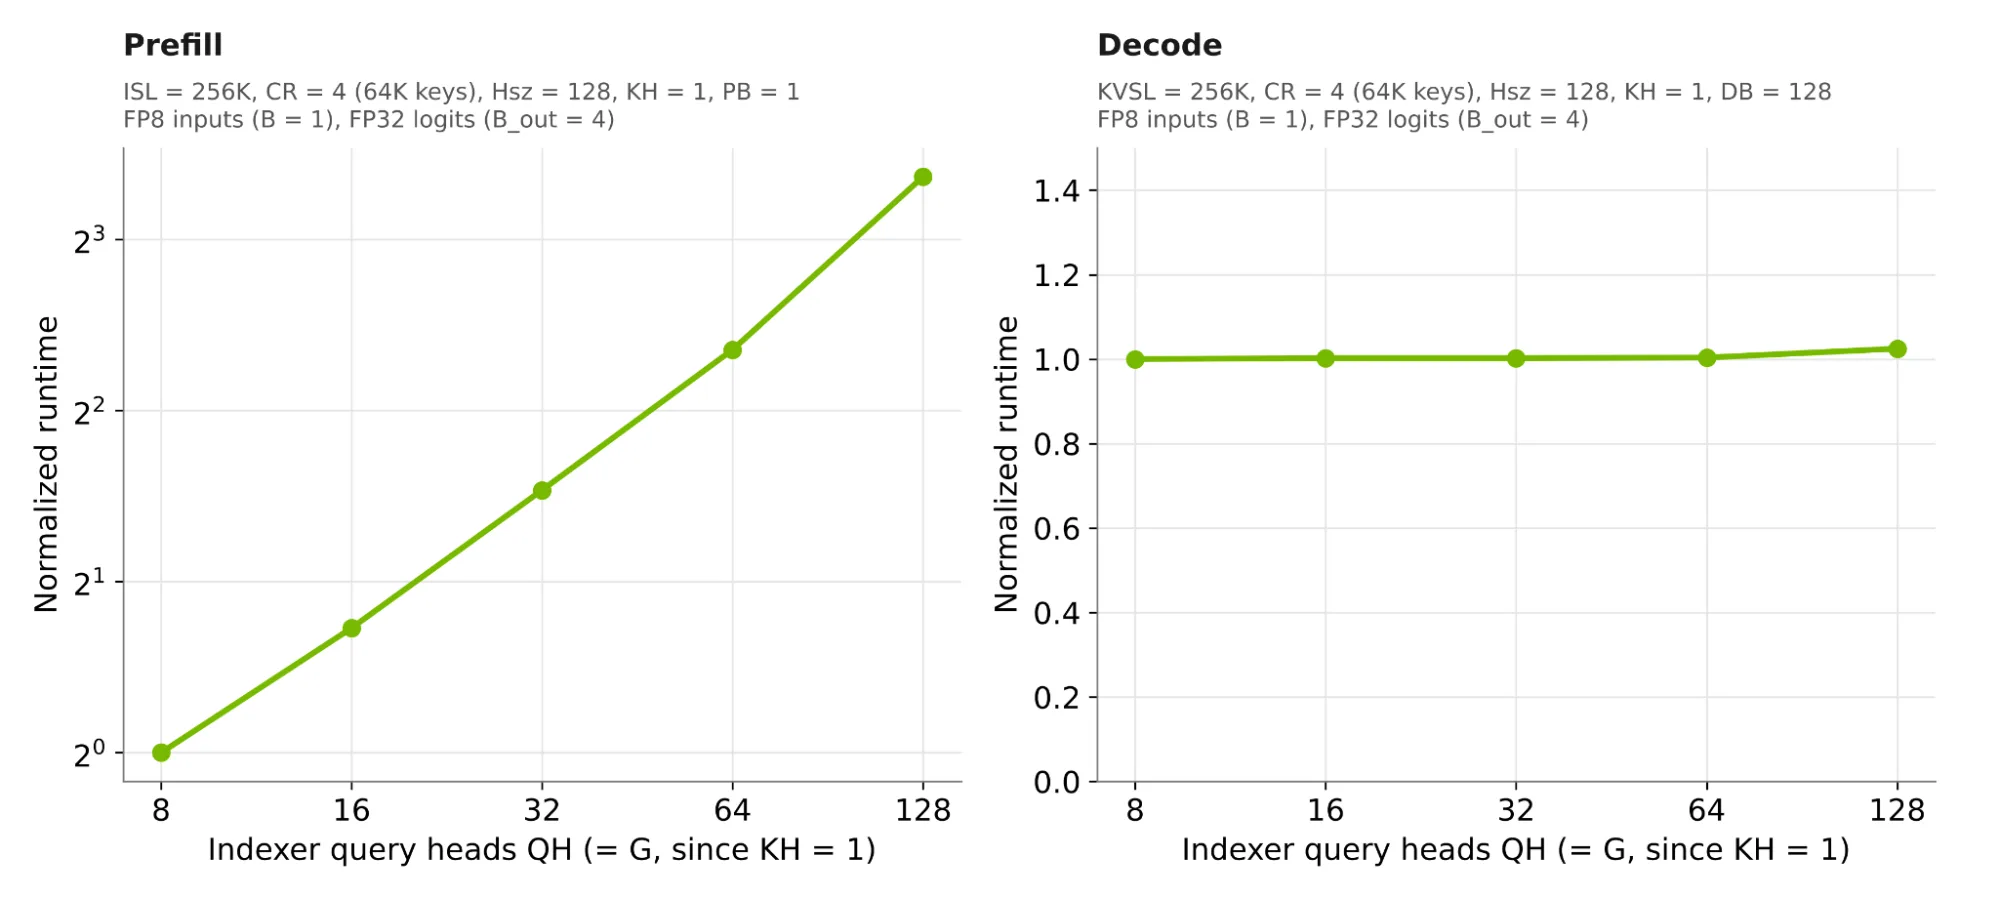
解码运行时仅会增加 2%,而 \(G\) 会增加 16 倍,因为单键缓存读取会设置运行时。在小型 \(G\) 下,预填充运行时间的增长速度要比 \(G\) 慢:将 \(G\) 从 8 翻倍到 16 会花费 1.66 倍,而不是 2 倍。这是因为 FP32 logit 写入在每个 logit 中发生一次,而与 G 无关,在较小的 G 中,它占据主导地位。在 \(G\) = 16 之上,matmul 占据主导地位,运行时随 \(G\) 增长。
方程 2 具有第二个解码强度杠杆:\(D\) + 1,即每个步骤的查询 token 评分。如果没有预测性解码,它就是 1。通过预测性解码,模型会起草 \(D\) token,并在一个步骤中使用新 token 进行验证。这意味着索引器针对相同的密钥缓存对 \(D\) + 1 查询 token 进行评分。与额外的查询头一样,额外的查询 token 会增加 FLOP,但没有新的字节,因此草稿 token 在一次传递时几乎是免费的。图 5 显示了此过程的停止位置。
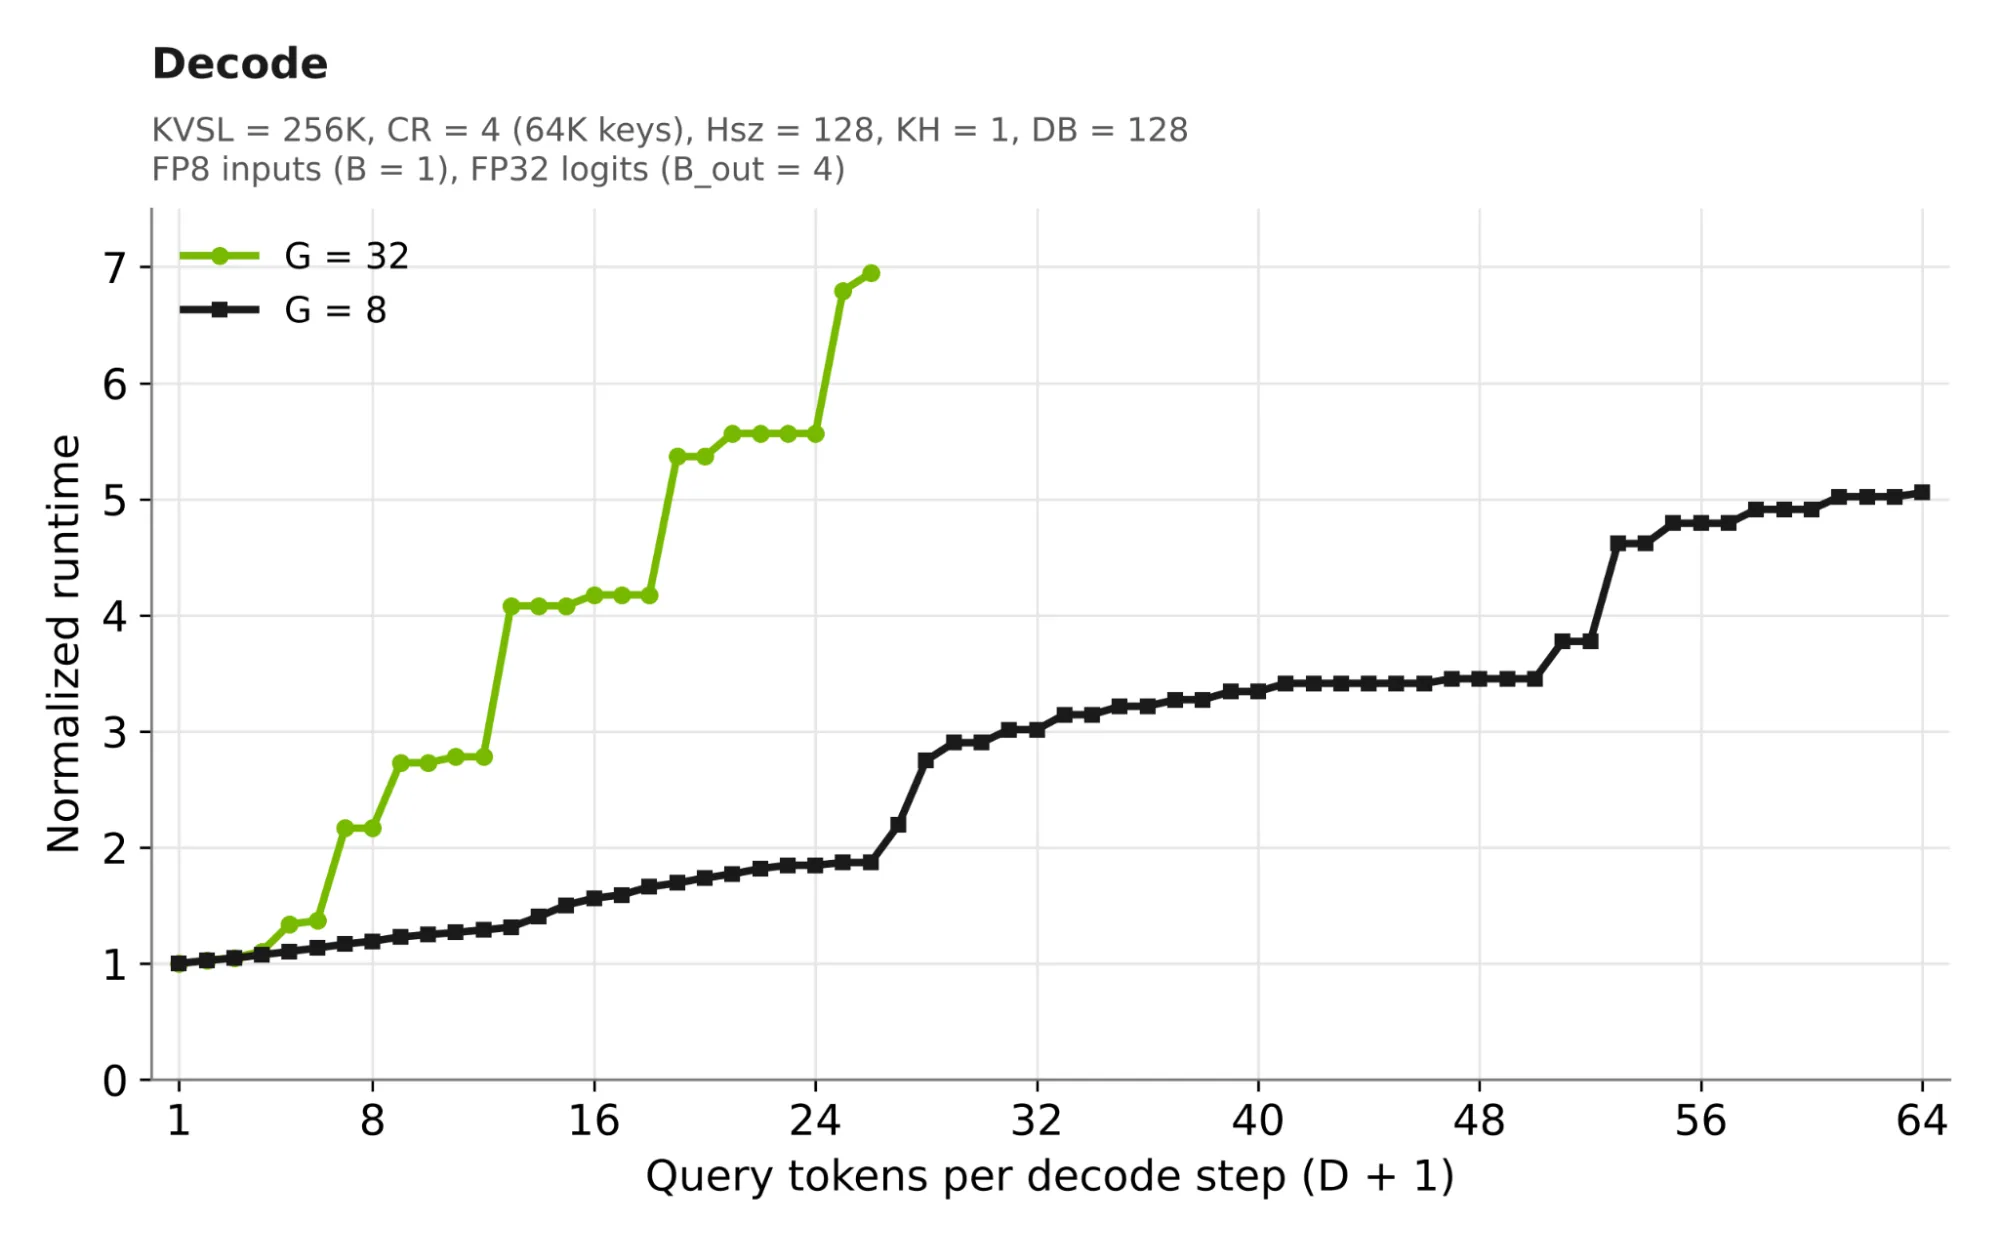
一个 Tensor Core 图块最多可容纳 256 行查询行。使用 FP32 结语时,寄存器压力将实际图块限制为大约 200 行,因此通过密钥缓存的一次传递可以将 \(G\) x (\(D\)+ 1) 评分高达大约 200:在 \(G\) = 32 时为 6 个查询 token,在 \(G\) = 8 时为 26 个。到那时,运行时间仅增加了 1.37 倍和 1.87 倍,而工作量则增加了 6 倍和 26 倍。超过此时间点后,这些行将无法再容纳在一个图块中,因此内核会启动更多 CTA,而运行时则会升级。
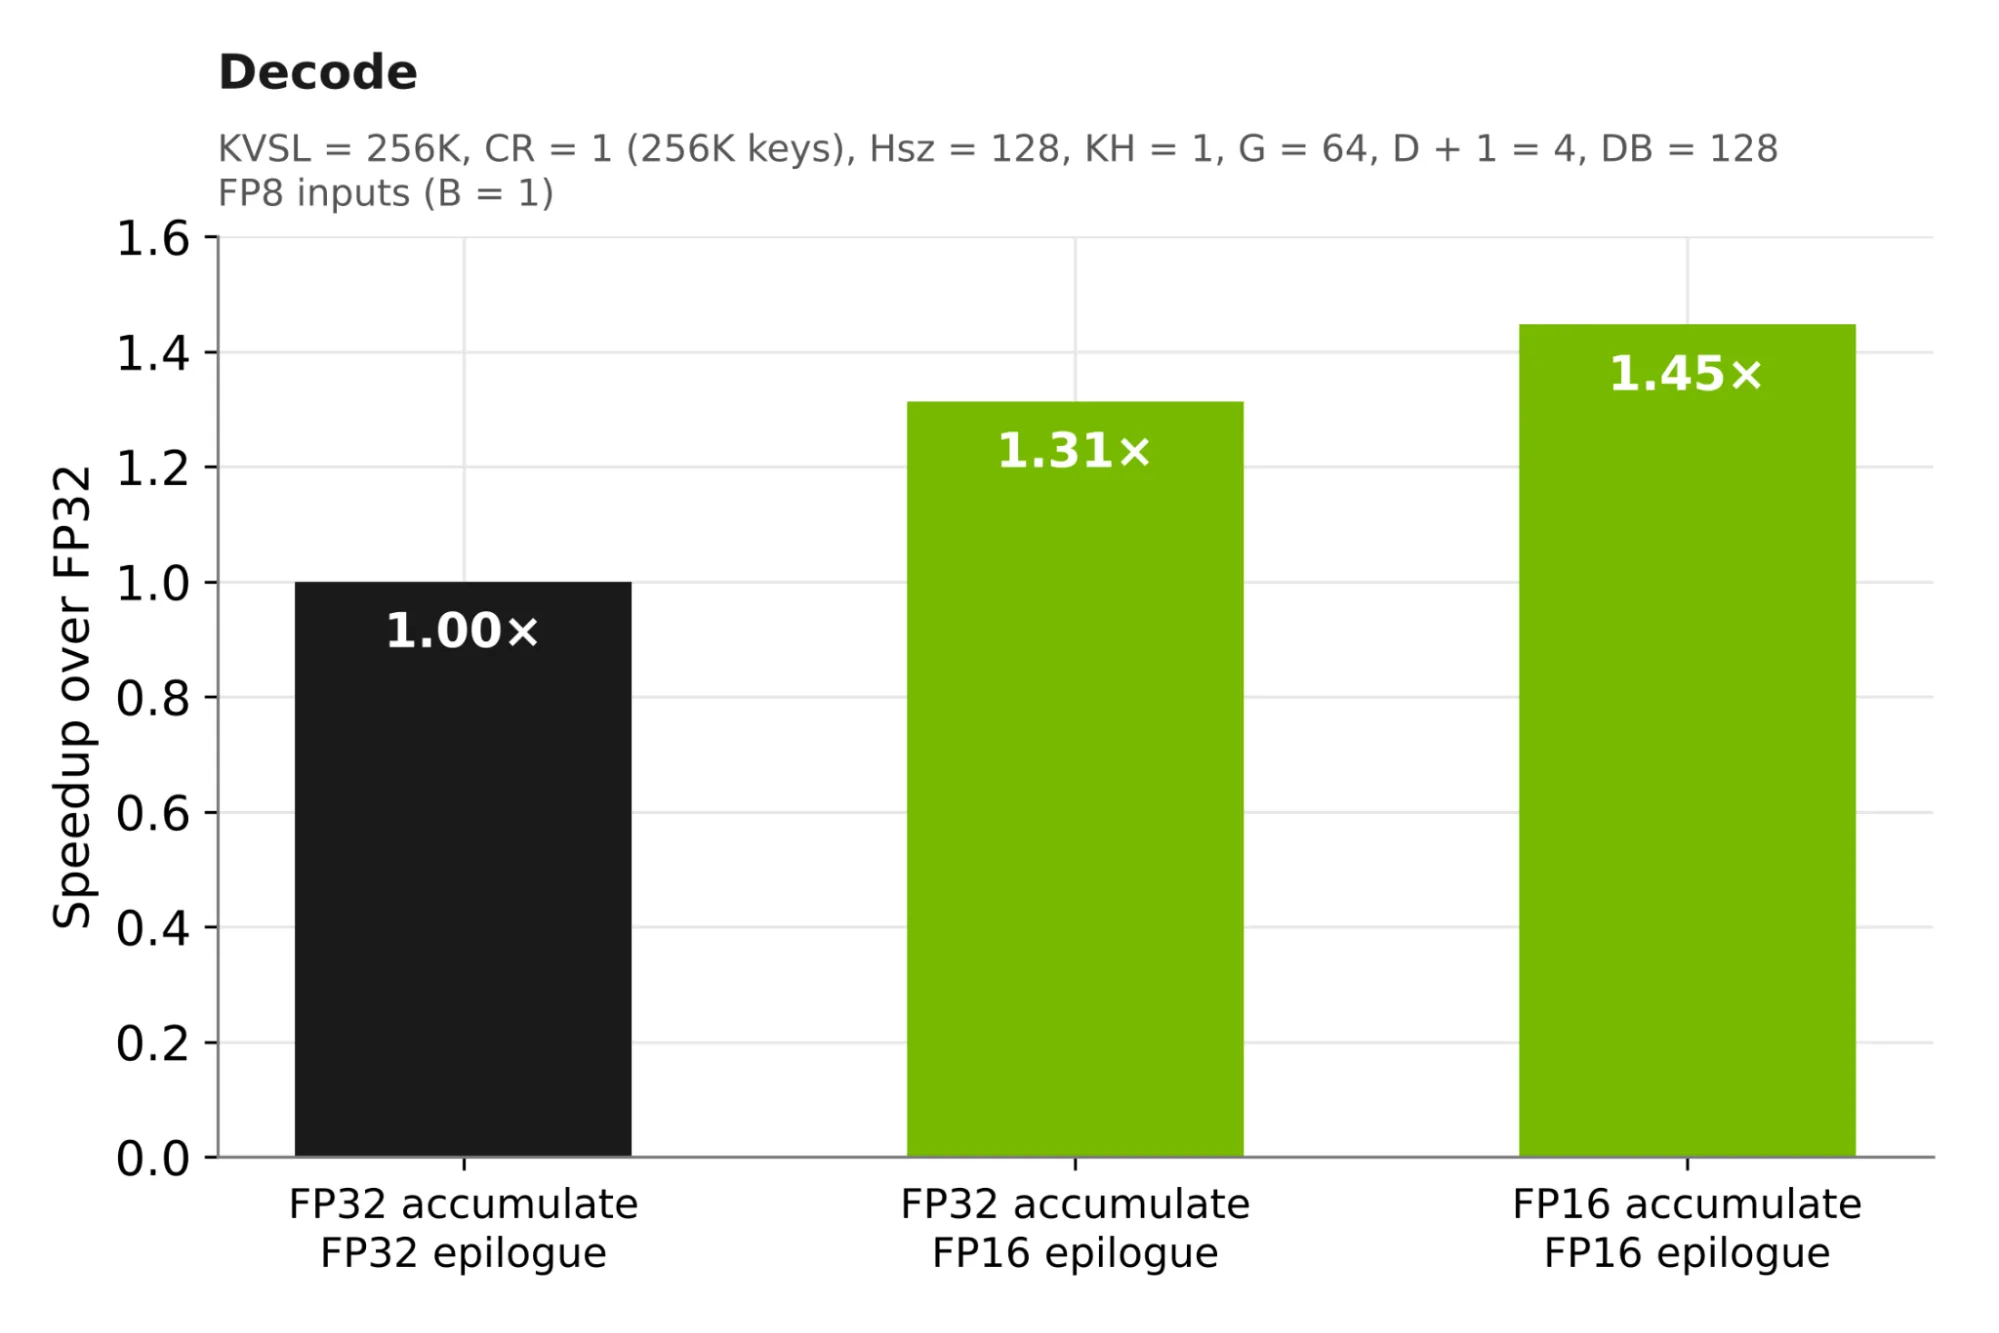
集团规模和猜测深度在同一领域展开竞争。FP16 结语将图块扩大到 256 行,并在 \(G\) = 64、\(D\) = 1 = 4 时给出 1.31 倍的结果 (图 6) 。在 FP16 中累加矩阵也可达到 1.45 倍,但前提是索引器 QK 缩放使矩阵输出保持在 FP16 范围内。
准则 1: 将 \(G\) x (\(D\)+ 1) 保留在一个 Tensor Core 图块内,大约 200 行 ( FP16 结尾部分为 256 行) 。
准则 2: 在 FP16 中运行索引器结语。也可使用 FP16 进行累加,前提是索引器的 QK 缩放使 Matmul 输出保持在 FP16 范围内。
键头 (KH)
在固定 QH 下增加 KH 会缩小 \(G\),从而降低预填充和解码的强度,但两者的收益不同。
在解码中,每增加一个 KH,就意味着再读一次完整的密钥缓存,再写一组 logit。键读取是解码流量的大部分,因此运行时间从 KH+ 1 到 8 呈线性增长,为 KH:7.6 倍 (图 7) 。FLOPS 保持不变,但 KH 乘以字节移动。
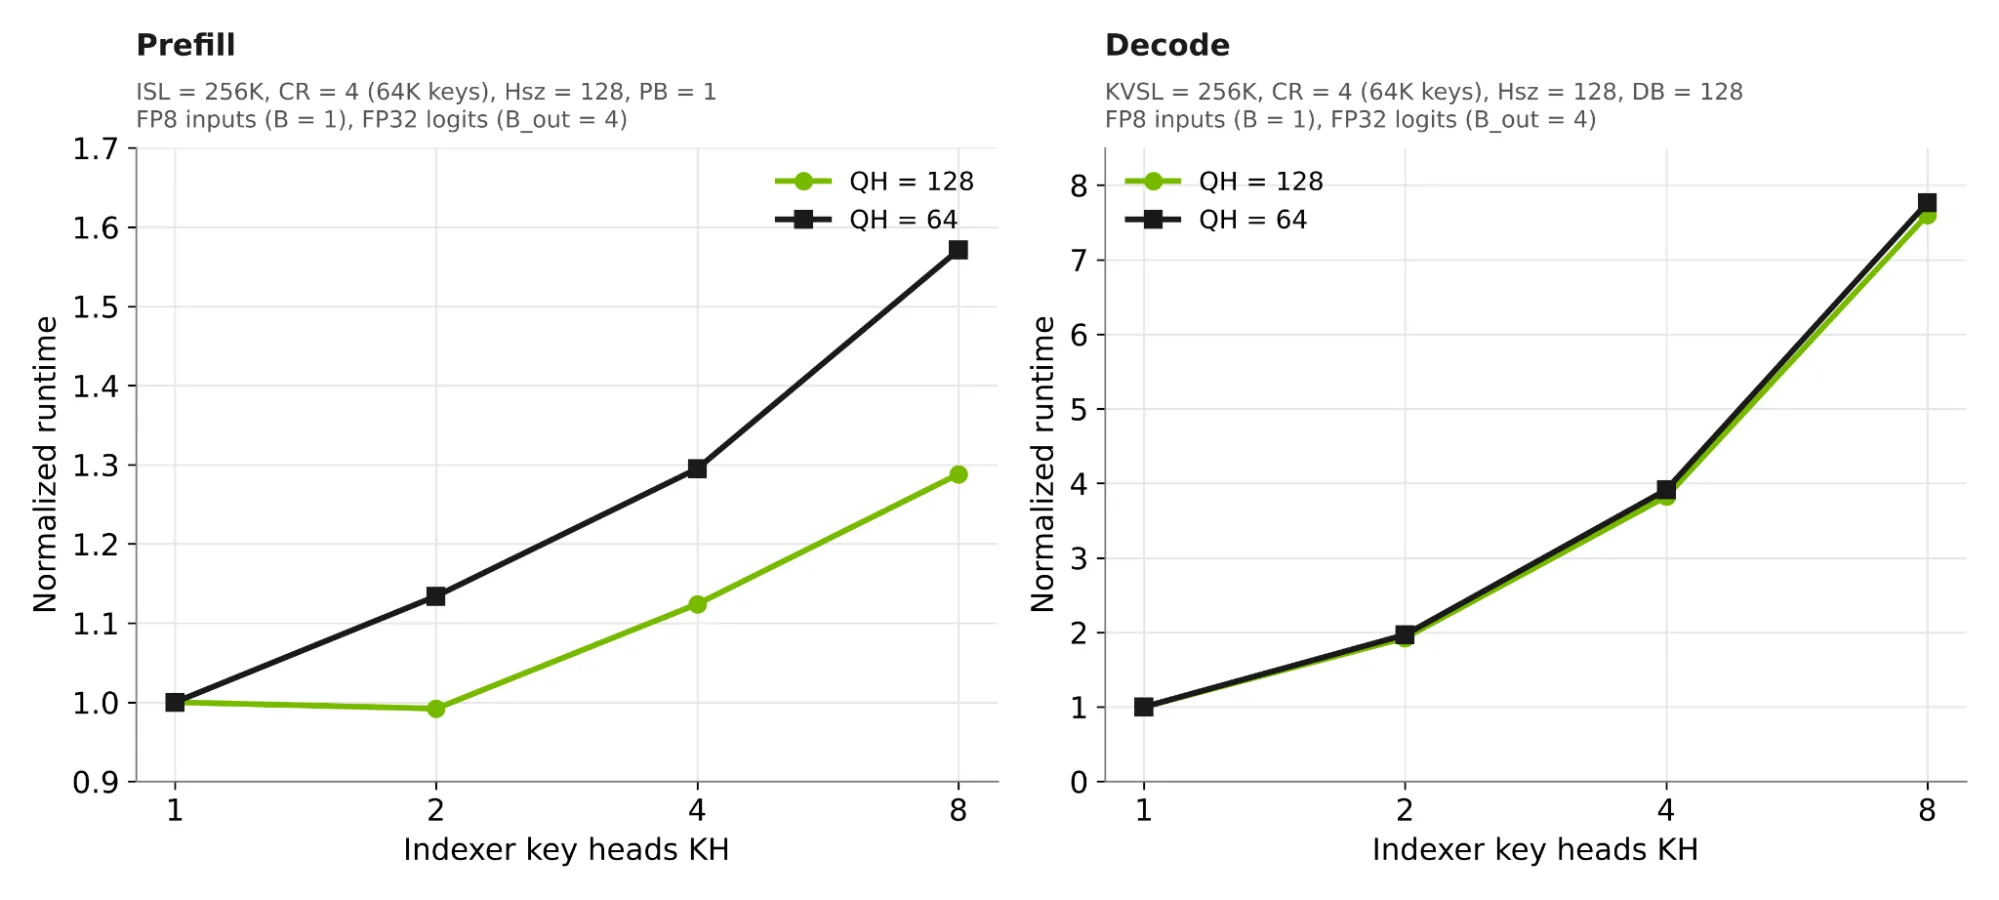
预填充的敏感度较低:KH = 1 到 8 时是预填充的 1.3 倍到 1.6 倍。FLOPS 不变,且在控制预填充流量的 logit 写入旁边,额外的键读取很小。每个 logit 的工作量会增加,因为每个键头都会为每个键编写自己的 logit。降低精度的结语 (准则 2) 和 Top-k 融合 (准则 6) 都缩小了这项工作。
准则 3: 使用 KH = 1,在 \(G\) (=QH) 查询头上进行交叉头归约,以便每个键写入一个 logit。
头部尺寸 (Hsz) 和结语
Hsz 直接进入方程 1,因此较宽的水头会提高预填充强度。它以最小限度进入方程 2,因此解码只需为额外的关键字节付费。
预填充具有第二个效果,方程 1 无法捕捉。结语 ( ReLU 和加权和) 适用于分数,分数的计数不依赖于 Hsz。只有 matmul FLOPS 随 Hsz 增长。在较小的 Hsz 下,预填充会受到 CUDA 核心结语的约束,而 Tensor 核心会等待。头部变宽会增加适合该等待时间的 matmul FLOPS,因此运行时的增长速度要比 Hsz 慢得多,直到两个平衡在 Hsz = 128 左右。
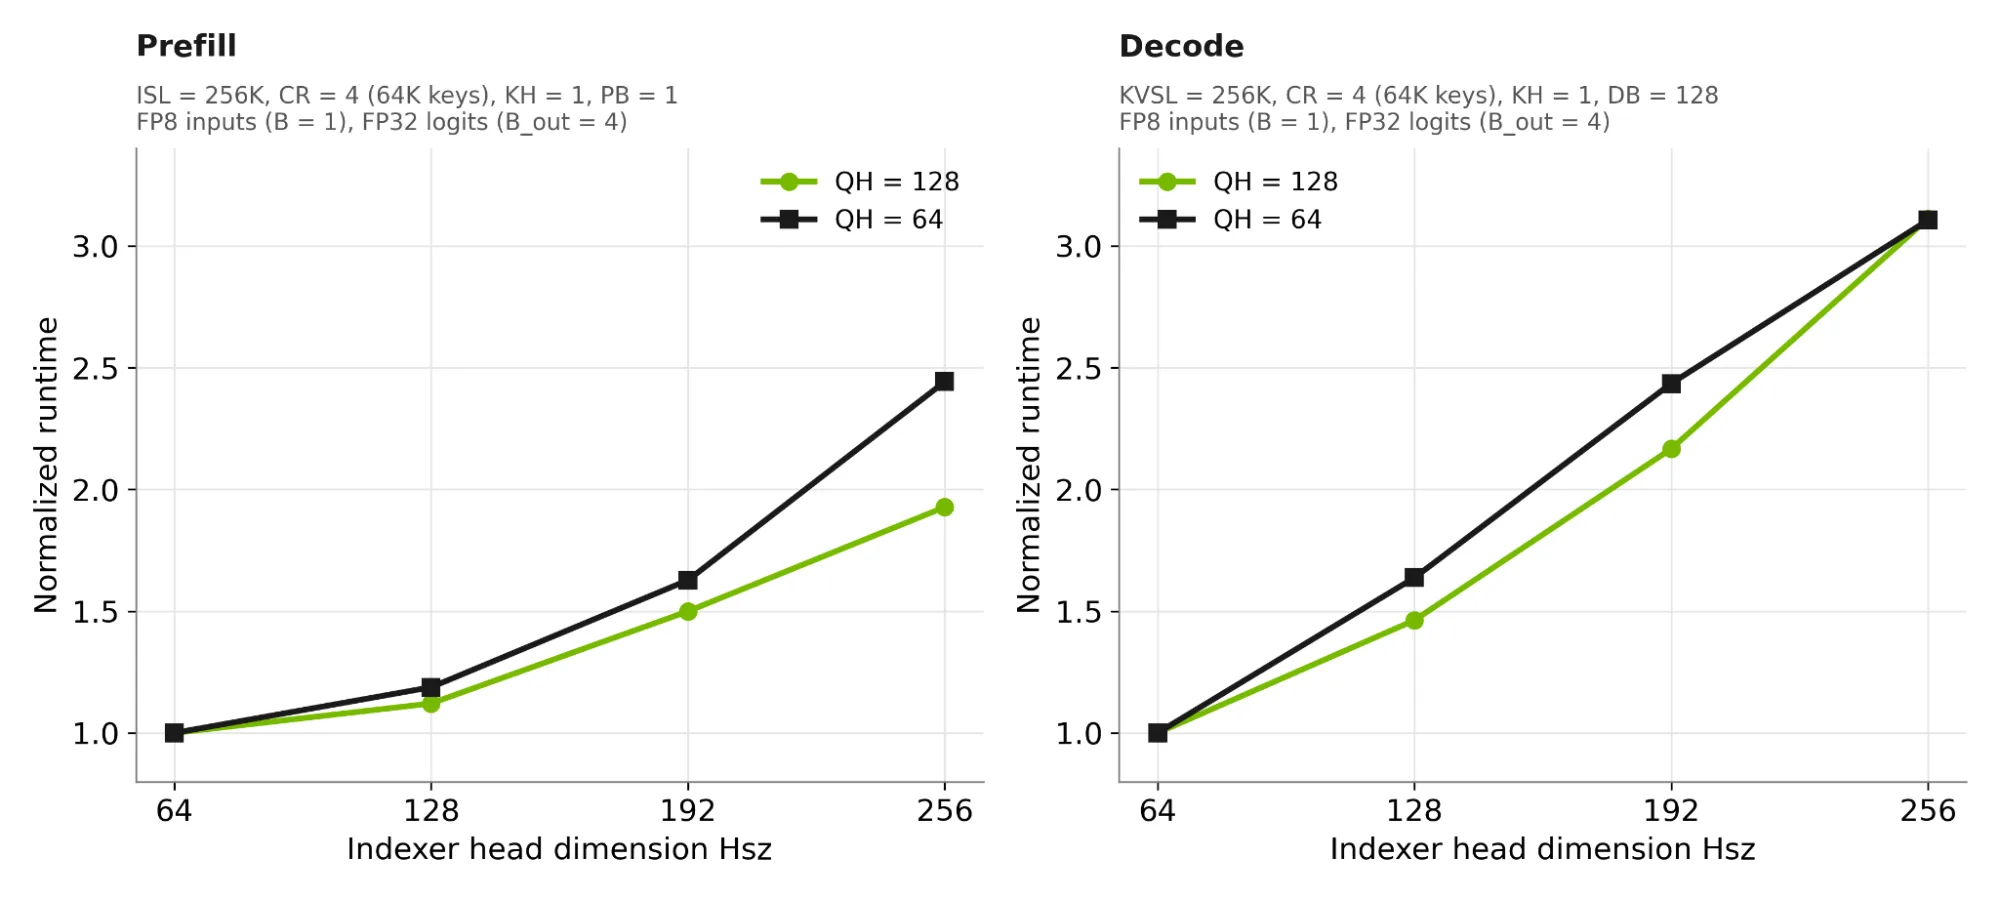
图 8 证实了这一点。在预填充中,Hsz = 64 到 128 的成本仅为 1.1 倍到 1.2 倍,而不是 2 倍,超过 128 时,运行时间会随着 FLOPS 的增加而增加。在解码中,由于每个额外的关键字节都是从 HBM 读取的,因此运行时在整个过程中都会随着 Hsz 的增长而增长。
准则 4: 使用 Hsz = 128 或 256。Hsz = 64 让 Tensor 核心等待结语。窄边框能够减少解码字节,因此大多数设计都能达到 128。
压缩比 (CR)
在 CR = 4 中,一个索引器关键帧表示四个 token。CR 是索引器的压缩比。Core Attention 可以单独压缩自己的 KV cache,主要是节省内存容量,而索引器 CR 则设置运行时。CR 不会出现在方程 1 或方程 2 中,因此它不会改变限制核函数的因素。在预填充和解码中,它以 1/ CR 的形式线性改变总工作量。
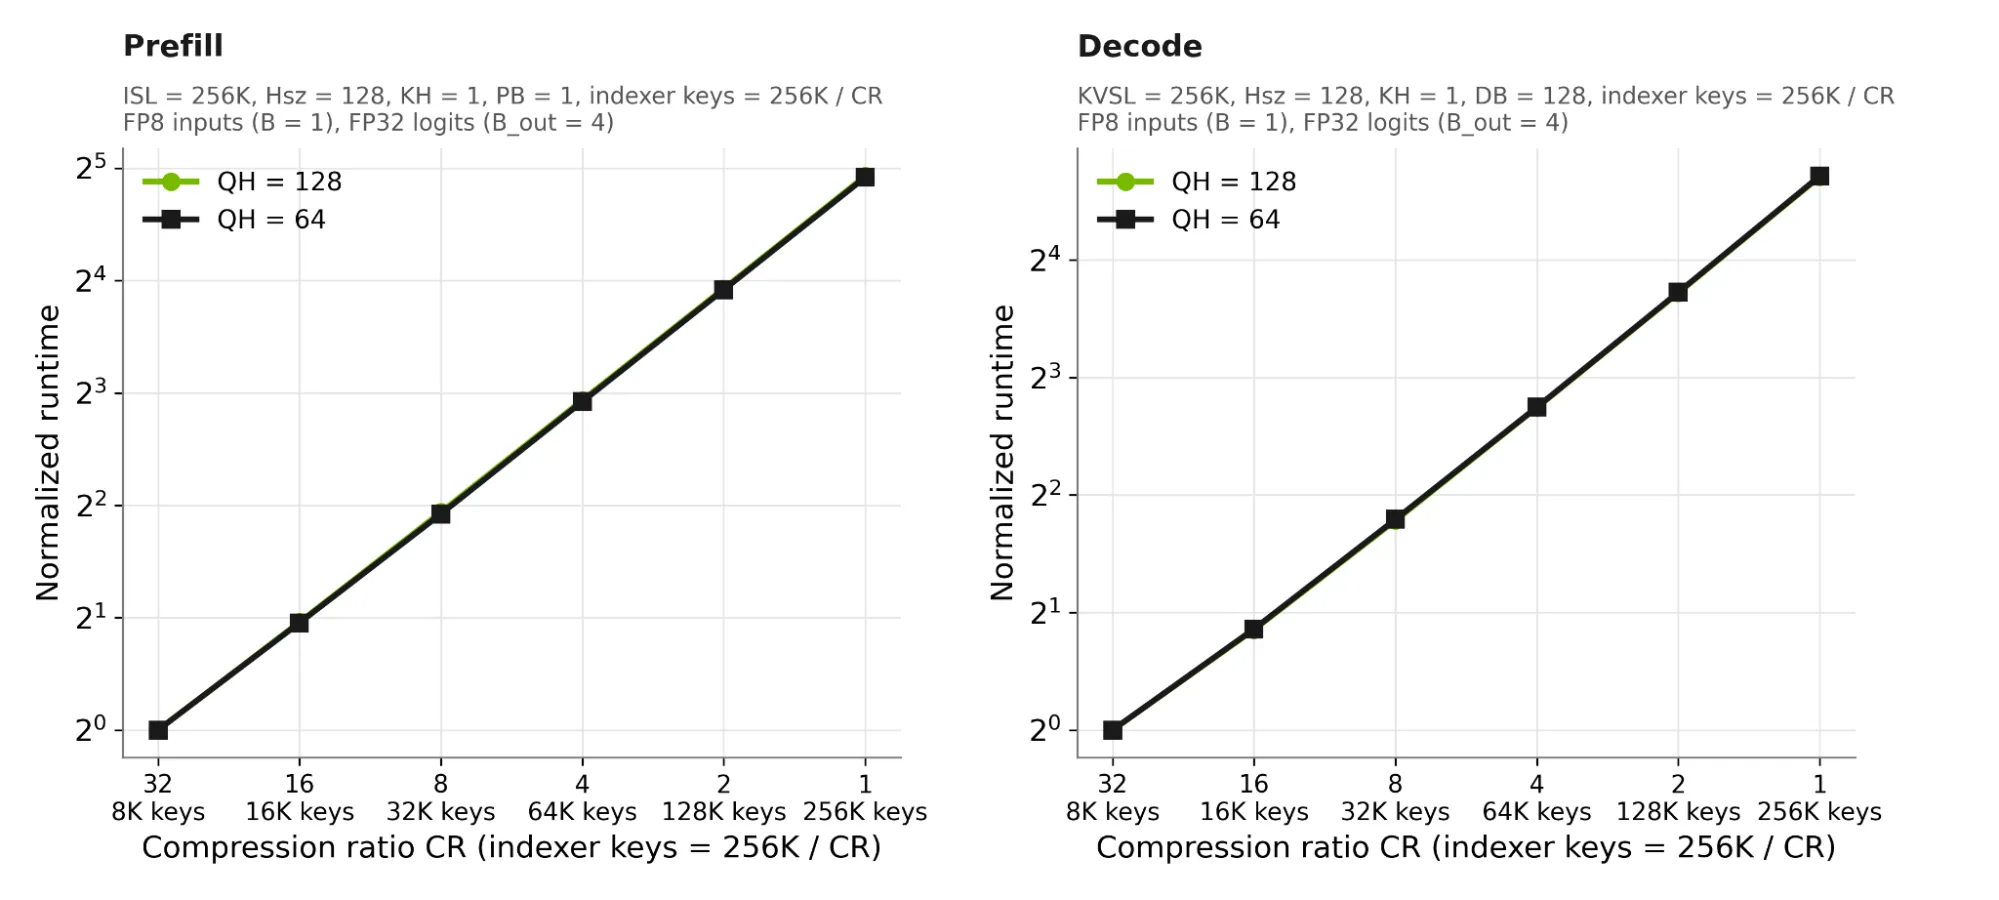
图 9 显示 CR 每减半,预填充运行时就会翻倍,因为删除的每个关键帧都会在 matmul、epilogue 和 logit write 中发挥作用。每减半一次,解码次数就会翻倍,但最小缓存 ( 8K 密钥,1.8 倍) 除外,此时密钥读取过短,无法达到完整的 HBM 带宽。
减少索引器工作量的唯一方法是减少关键帧评分。表 1 展示了三种方式:压缩索引器密钥 ( CSA、GLM 5.3 Flash、QSA、NSA、MoBA) 、分层索引 ( LSA-Flash) 和跨层索引共享 ( GLM 5.2、LSA-Flash) 。
准则 5: 借助压缩、分层索引和索引共享,降低索引器的关键帧得分。所有这些都不会改变算术强度,因此请将它们与准则 1 到 4 一起使用,而不是取而代之。
Top-k 选择
索引器为每个索引器密钥生成一个 logit。Top-k 会扫描这些 logits,并在 CUDA 核心的预填充和解码模式下,为每个查询保留最大的 \(k\)。图 10 显示其成本如何取决于评分和保留的关键帧数量。
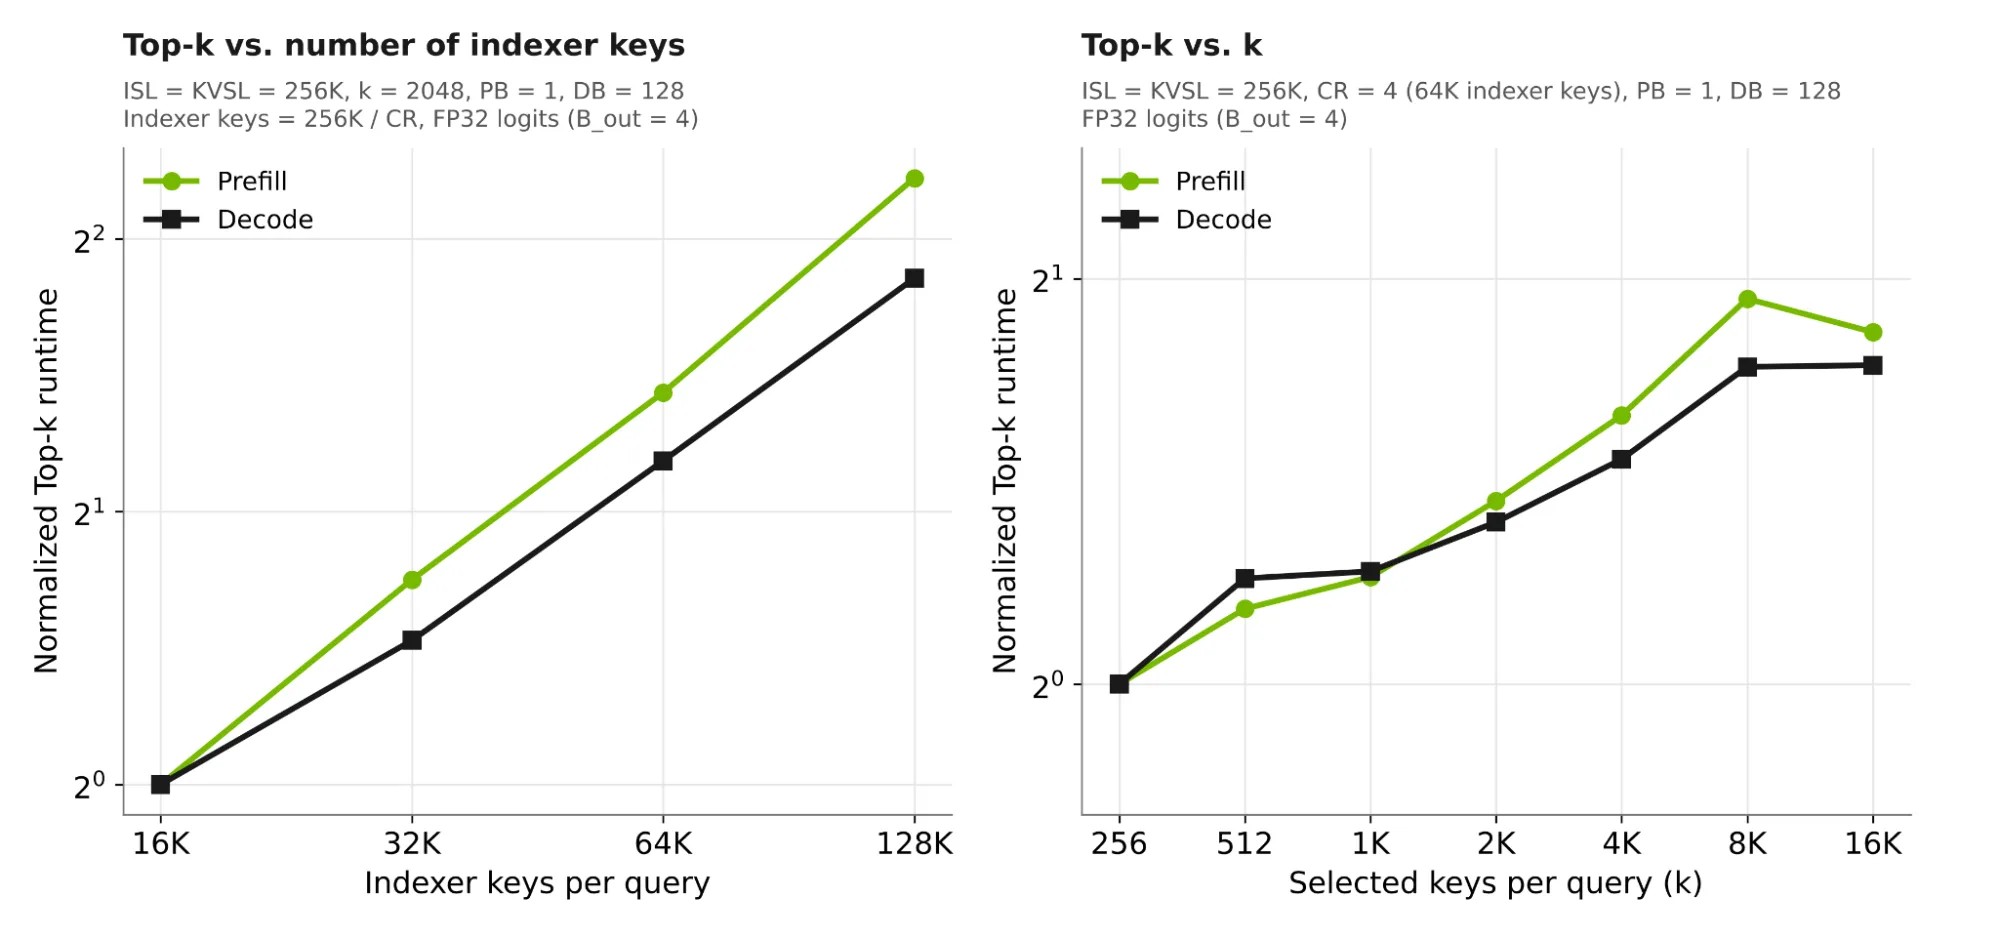
为更多密钥评分所需的成本更高 (图 10,左) :由于要比较每个 logit,因此密钥数量每翻倍一次的预填充成本和解码成本分别约为 1.7 倍和 1.5 倍。尽可能少地增加密钥数量 (图 10,右) :\(k\) 将 Top-k 时间提高 64 倍,而预填充时间和解码时间分别减少了 2 倍和 1.7 倍。因此,Top-k 上的杠杆与索引器上的相同,关键帧的得分数量,准则 5 对两者都有帮助。
两种内核技术可进一步降低 Top-k 成本。首先,所选关键帧在解码步骤之间变化不大。NVIDIA Guess-Verify-Refine Top-k 在 TensorRT LLM 中使用上一步的结果进行猜测,并通过 logits 进行一次性验证。在 DeepSeek V3.2 和 DeepSeek V4 解码上,其速度比标准基数选择快 2.1 到 2.4 倍。
其次,将 Top-k 融合到索引器中可以消除它们之间的 logit 写入和读取,从而节省时间,释放持有 logit 的 HBM,并节省移动 logit 的能量。一个开源示例是 FlashInfer 中的选择性 Top-k 路径,它在一个内核中进行评分、归约和过滤,并且绝不会写入完整的 logits 矩阵。
准则 6: 将 Top-k 视为索引器预算的一部分。其代价是根据关键帧的评分,而不是 \(k\)。将其与索引器融合,然后在解码中重复使用上一步的结果。
token 级与块级选择
选择粒度 (请参阅表 1) 表示索引器是否选择单个 token 或块。这一选择对于核心注意力核函数至关重要。
通过 token 级选择 ( DSA、GLM 5.2、LSA) ,选择的 \(k\) 键和值将分散在 KV 缓存中。内核为每个选定的 token 查找地址,并分别获取每个 token。由于每个查询 token 选择不同的 token,因此两次查询很少会共享一次获取。
通过块级选择 ( GLM 5.3 Flash、QSA、NSA、MSA、MoBA) ,选定的键和值将出现在连续块中。一个地址为一个完整的块提供批量获取服务,而选择同一块的查询会共享获取结果:内核会逐块获取每个块,针对选择它的每个查询进行计算,然后组合每个查询的部分结果。
块大小则用于设置成本。在图 11 中,每个查询的预算为 2048 个选定的密钥,块大小各不相同:16 个块 (共 128 个密钥) 、32 个块 (共 64 个) 或 64 个块 (共 32 个密钥) 。FLOP 和 KV 字节相同,但每个块都会增加查询负载、部分结果和合并步骤,因此核函数的时间会随其处理的块数量而变化。在预填充和解码方面,将块大小减半的运行时间几乎翻倍。
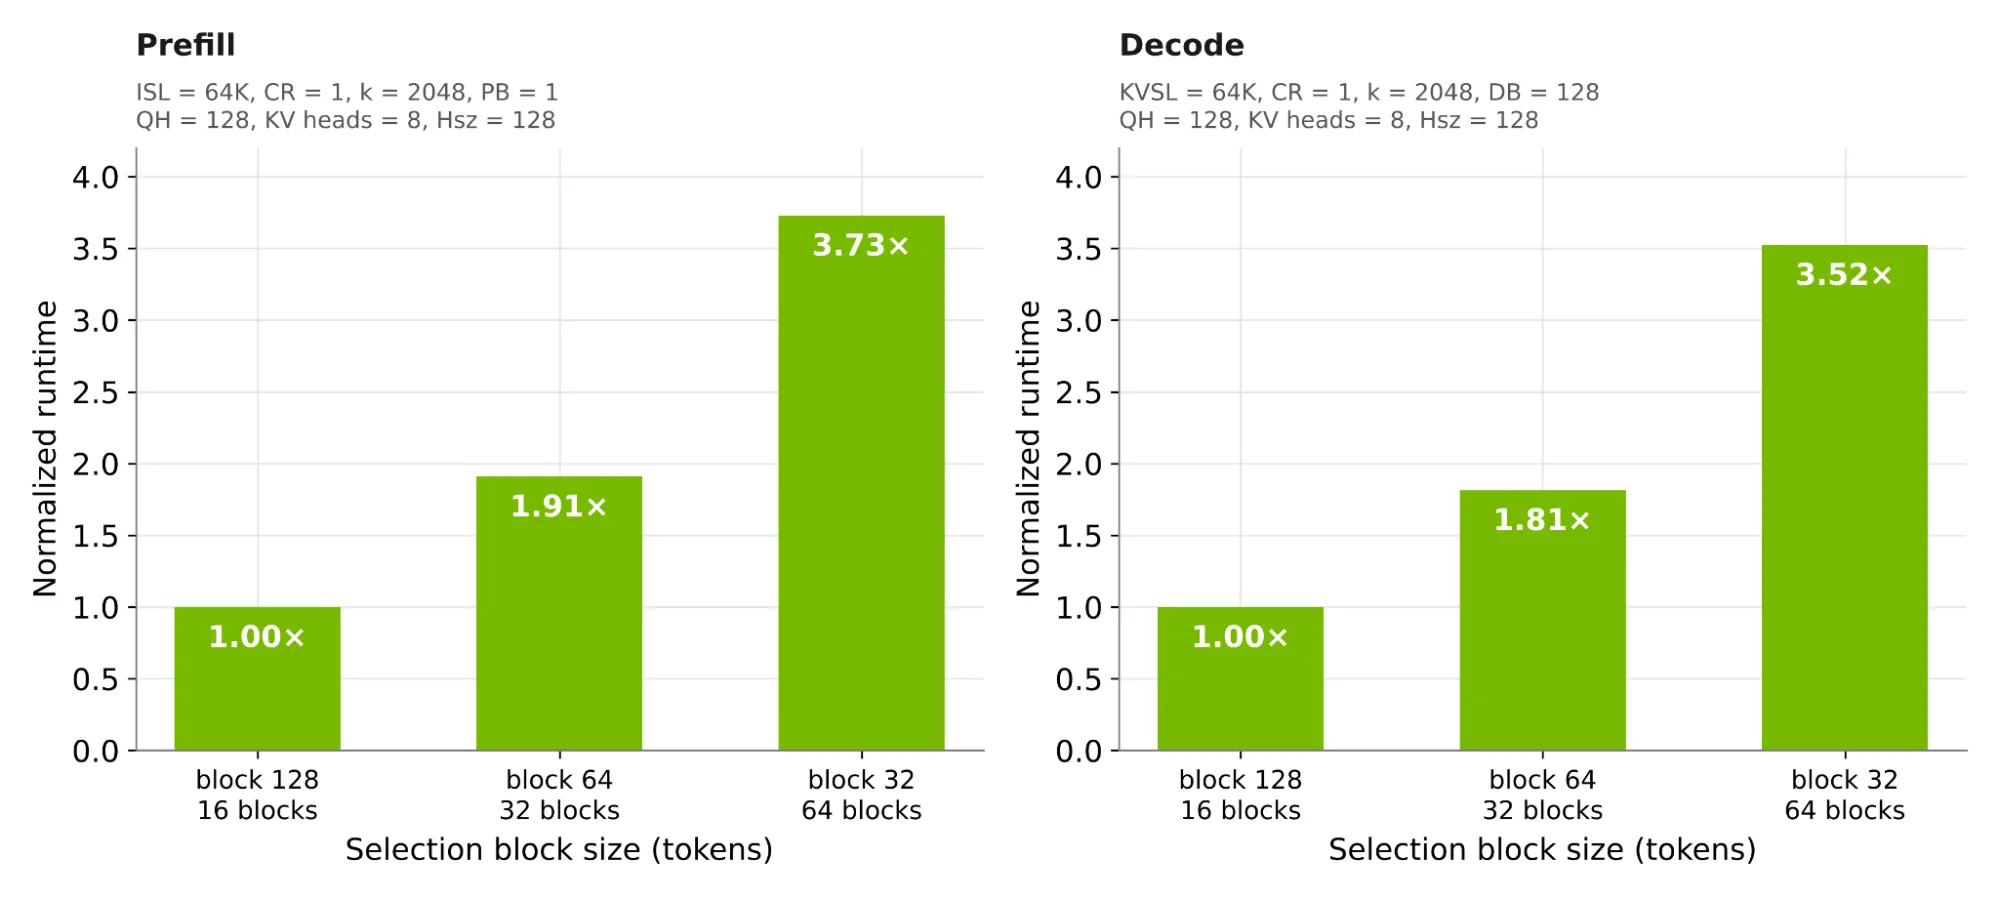
头部共享同样重要。在密集注意力中,每个查询 token 关注每个块,因此提取的块会在所有查询 token 中重复使用。在稀疏注意力中,每个查询 token 选择自己的块,因此重用仅限于共享 KV 头的一个 token 的查询头。由于组规模较大,其中许多查询头共享每个 KV 头,因此获取块可为所有查询头提供服务。
准则 7: 首选使用大块进行块级选择。token 级选择也有效,但块允许核心注意力批量获取关键帧,并在查询中共享这些关键帧。
准则 8: 使用较大的核心注意力组大小,以便多个查询头共享每个 KV 头。
开始使用稀疏注意力协同设计
稀疏注意力可提高核心注意力的成本效益,但选择关键帧的索引器仍会触及整个上下文,因此这正是稀疏模型的长上下文成本所在的位置。以下八条准则是在 NVIDIA GPU 上保持索引器、Top-k 和核心注意力高效的设计选择。
将本文中介绍的八条准则应用于您自己的设计:
- 准则 1: 将 \(G\) x (\(D\)+ 1) 保留在一个 Tensor Core 图块内,大约为 200 行 ( FP16 结语为 256 行) 。
- 准则 2: 在 FP16 中运行索引器结语。也可使用 FP16 进行累加,前提是索引器的 QK 缩放使 Matmul 输出保持在 FP16 范围内。
- 准则 3: 使用 KH = 1,并对 \(G\) (= QH) 查询头进行交叉归约。
- 准则 4: 使用 Hsz = 128 或 256。大多数设计方案的价格为 128。
- 准则 5: 借助压缩、分层索引和索引共享,降低索引器的关键帧得分。
- 准则 6: 将 Top-k 视为索引器预算的一部分。将其与索引器融合,然后在解码中重复使用上一步的结果。
- 准则 7: 首选使用大块进行块级选择。token 级选择也有效,但块允许核心注意力批量获取关键帧,并在查询中共享这些关键帧。
- 准则 8: 使用较大的核心注意力组大小,以便多个查询头共享每个 KV 头。


