

工具调用可以分块生成,参数可以被缩短,或者模型特定的标记可能会泄露到答案中。前端解析器会将作为 token ID 或解码文本接收的输出转换为应用可以使用的可见文本、推理和工具调用。
在本文中,您将了解工具调用解析的工作原理,并使用 AI 智能体为新模型构建解析器。您将使用 frontend-crates (NVIDIA Dynamo 工具调用解析器背后可重复使用的 Rust 组件) ,从天气请求和人工评审的测试集开始。
假设你问巴黎的天气。模型可能会生成推理,然后使用城市参数进行 get_weather 调用。前端准备并标记化提示词,然后推理引擎运行 LLM 以生成 token。解析器使用 token ID 或解码文本,并按顺序将推理、可见文本和工具调用分开。协议适配器可将这些事件转换为与 OpenAI 兼容的响应,并使用相同的解析路径进行批量 JSON 和流式传输更新。
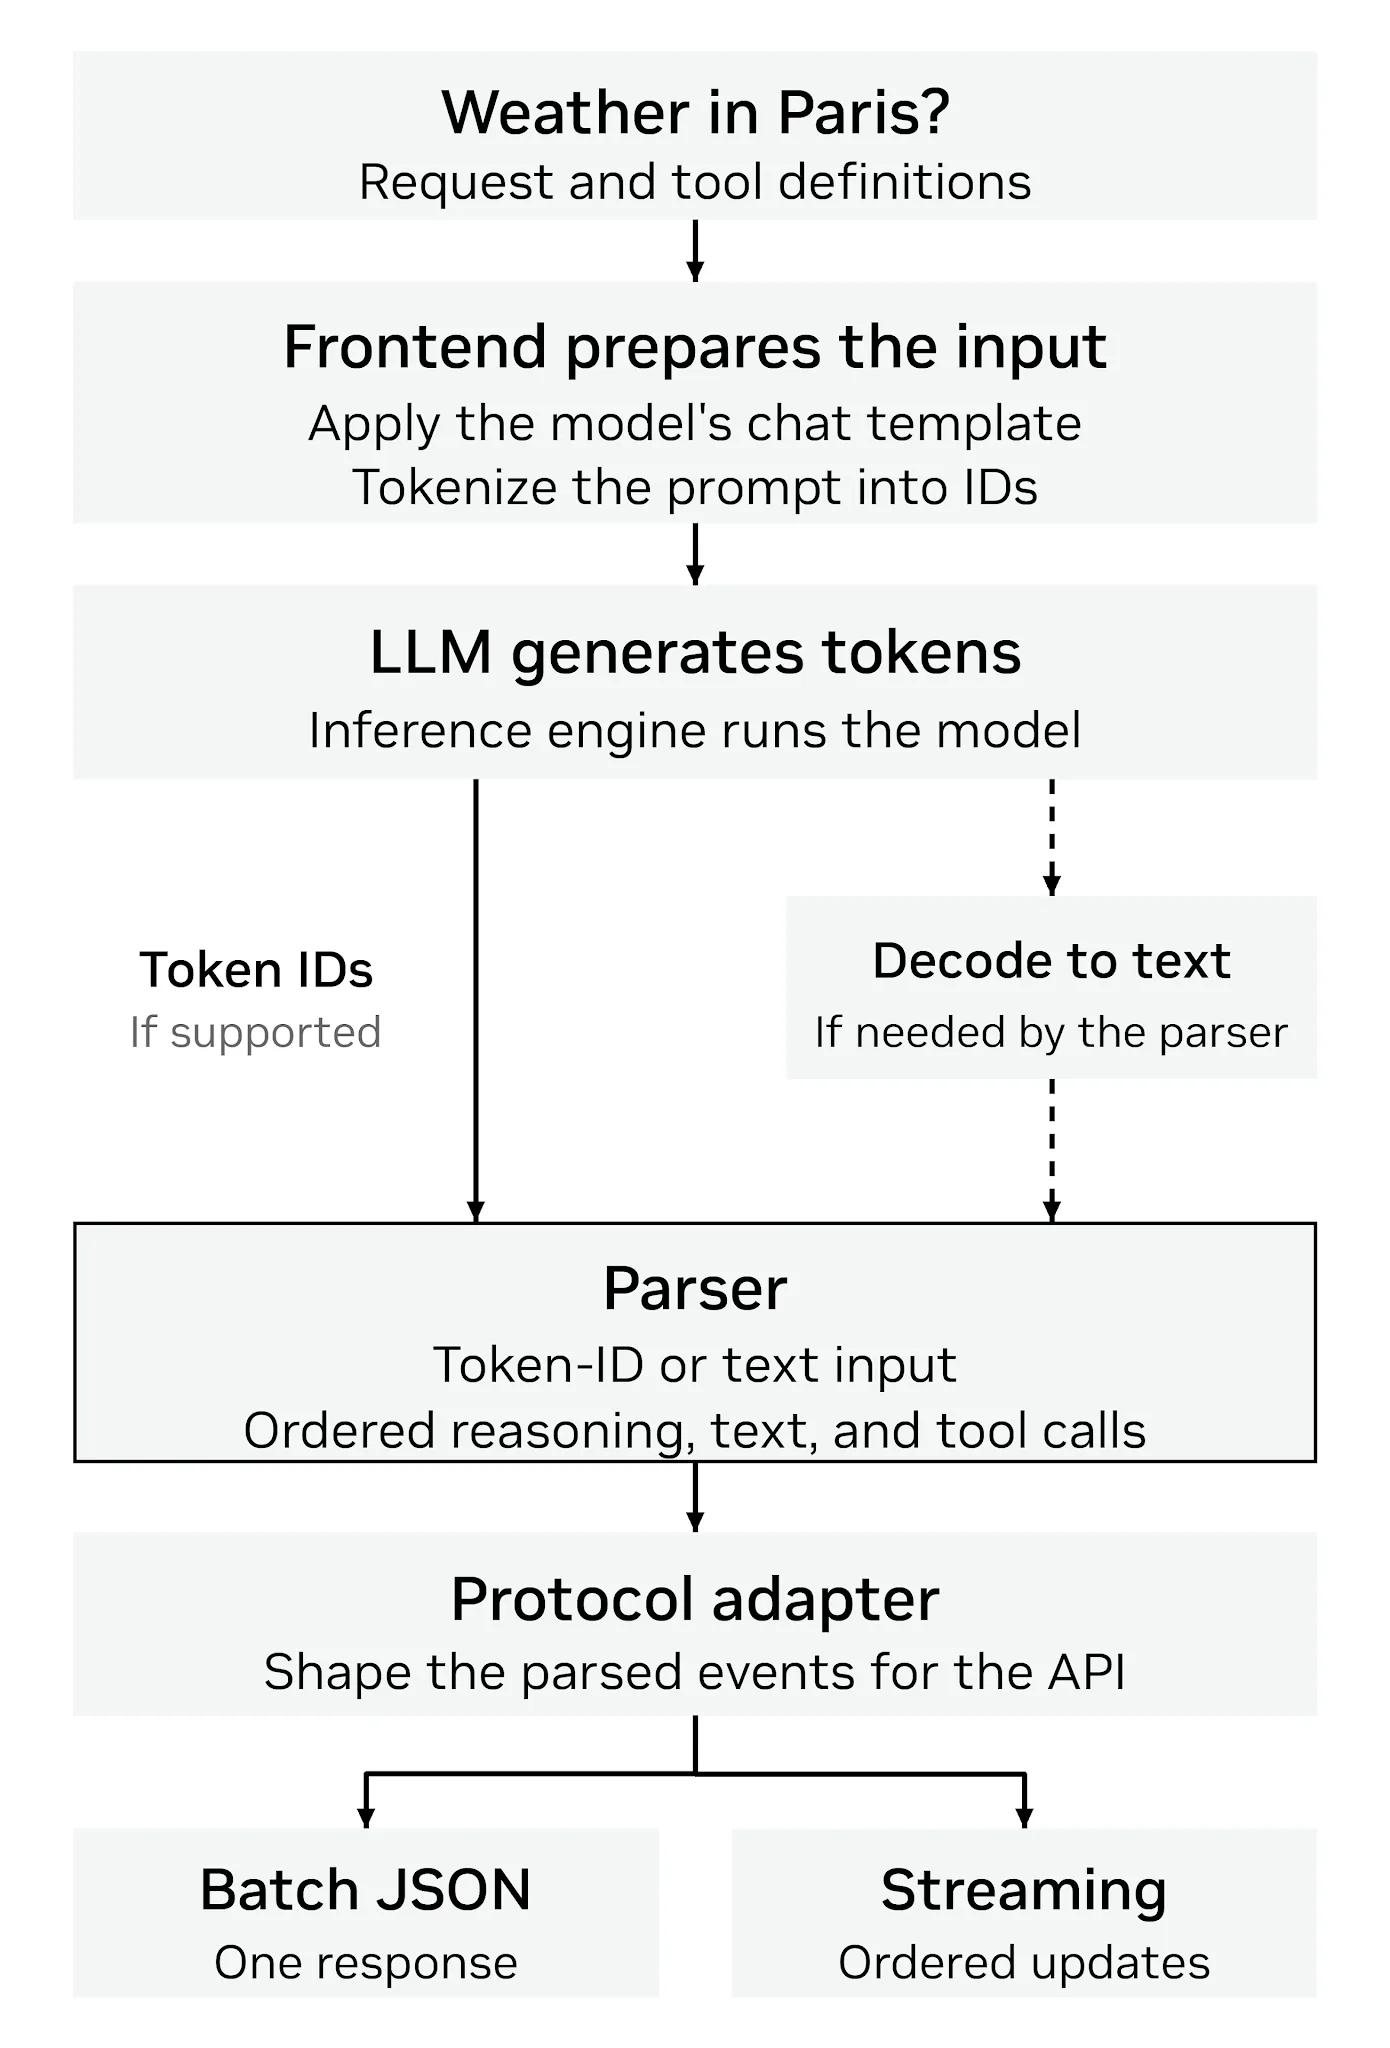
棘手的部分是识别每个部分的开始和结束位置。调用可能格式错误或不完整,参数中可能出现标记,或者调用周围可能出现普通文本。解析器必须处理这些边界,而不会丢失数据、重复调用或泄露模型特定的标记。
返回天气请求:模型可能会在城市名称的中途停留,或调用未提供的工具。两者都可能会中断智能体的下一个动作。以下 NVIDIA Nemotron 示例展示了这两个故障。
语法错误。参数和工具调用帧永远不会关闭,因此无法解析完整的调用。
</think><tool_call>
<function=get_weather><parameter=city>Par
语义错误。该帧有效,但请求中不包含命名工具。
</think><tool_call>
<function=unknown_tool><parameter=city>Paris</parameter></function>
</tool_call>
这些故障需要不同的处理方式。如果模型命名为不可用工具,解析器会报告其收到的调用,而服务层会验证工具可用性、授权、模式和调用策略。更改工具名称会隐藏模型实际生成的内容。
流已打开时,不完整的调用更难以判断。城市名称的其余部分可能会出现在下一个数据块中,标记也可能会被分割到不同的数据块中。答案发送得太早,语法泄露;等待太久,普通文本就会延迟。解析器需要一致的规则来确定要发出的内容、要缓冲的内容以及如何处理流的结尾。
解析器可能会遇到无限范围的输入。如果输入无效,则必须遵循记录的恢复规则,而不是猜测模型的意图。即使符合模式的语法有效的调用也可能是用户请求的错误选择。解析器需要一致的语法和恢复策略,以便保留有效数据,而不会发明调用或泄露模型特定的标记。
为了检查这些决策,前端在共享的一致性语料库中将模型输出与预期结果配对。
使用一致性语料库
使用一致性语料库检查适用的解析器如何处理在一个模型中首次观察到的行为。它与语言无关的 YAML fixture 将固定输入与预期输出配对,因此 Rust 解析器和 Python 引用可以运行相同的情况。针对标记泄露、重复调用或参数丢失的回归测试在适应语法时可以涵盖其他系列。
对于新解析器,请从模型系列中的所有 UNIFIED.* 用例开始。它们涵盖完整、格式错误、截断、多次和交错调用,以及流边界和输入结束行为。根据模型的语法和请求设置调整输入,添加模型特定的边缘用例,并解释排除项。您无法测试所有可能的输出,但可以重复使用其他格式的案例。
表 1 显示了解析器一致性表中的 UNIFIED.1-tool_only 用例。在本示例中,GOLDEN 测试集对四个模型特定的输入进行配对,其预期结果相同:get_weather 将城市设置为巴黎。标记各不相同,但每个案例都会测试相同的行为。调整输入格式后,相同的行为测试可在模型之间重复使用。
| 模型 | 原生输入 |
|---|---|
| Beam | <|start|>assistant to=get_weather<|channel|>analysis <|constrain|>xml<|message|><rfl:parameter name="city">Paris</rfl:parameter><|call|> |
| GPT-OSS | <|start|>assistant<|channel|>commentary to=functions.get_weather <|constrain|>json<|message|>{"city": "Paris"}<|call|> |
| Spark | <|start|>assistant to=get_weather<|message|><atem:function_calls><atem:invoke name="get_weather"><atem:parameter name="city">Paris</atem:parameter></atem:invoke></atem:function_calls><|eom|> |
| NVIDIA Nemotron 3 | </think><tool_call><function=get_weather><parameter=city>Paris</parameter></function></tool_call> |
教程:创建新解析器
现在,您可以为 frontend-crates 尚不支持的模型创建解析器。让您的 AI 智能体阅读此博文并学习教程,从第 1 步中的提示开始。您的模型规范定义了语法;共享案例提供了要测试的行为。
您需要 frontend-crates checkout、Rust 和 Cargo 以及一致性依赖项。解析器练习使用固定测试工装在 CPU 上运行,因此您不需要 GPU。端到端测试还需要适用于您模型的正常 Dynamo 运行时、发现服务和硬件。当您准备好端到端测试时,请在实际模型和 GPU 上使用 Dynamo 运行时启动测试。
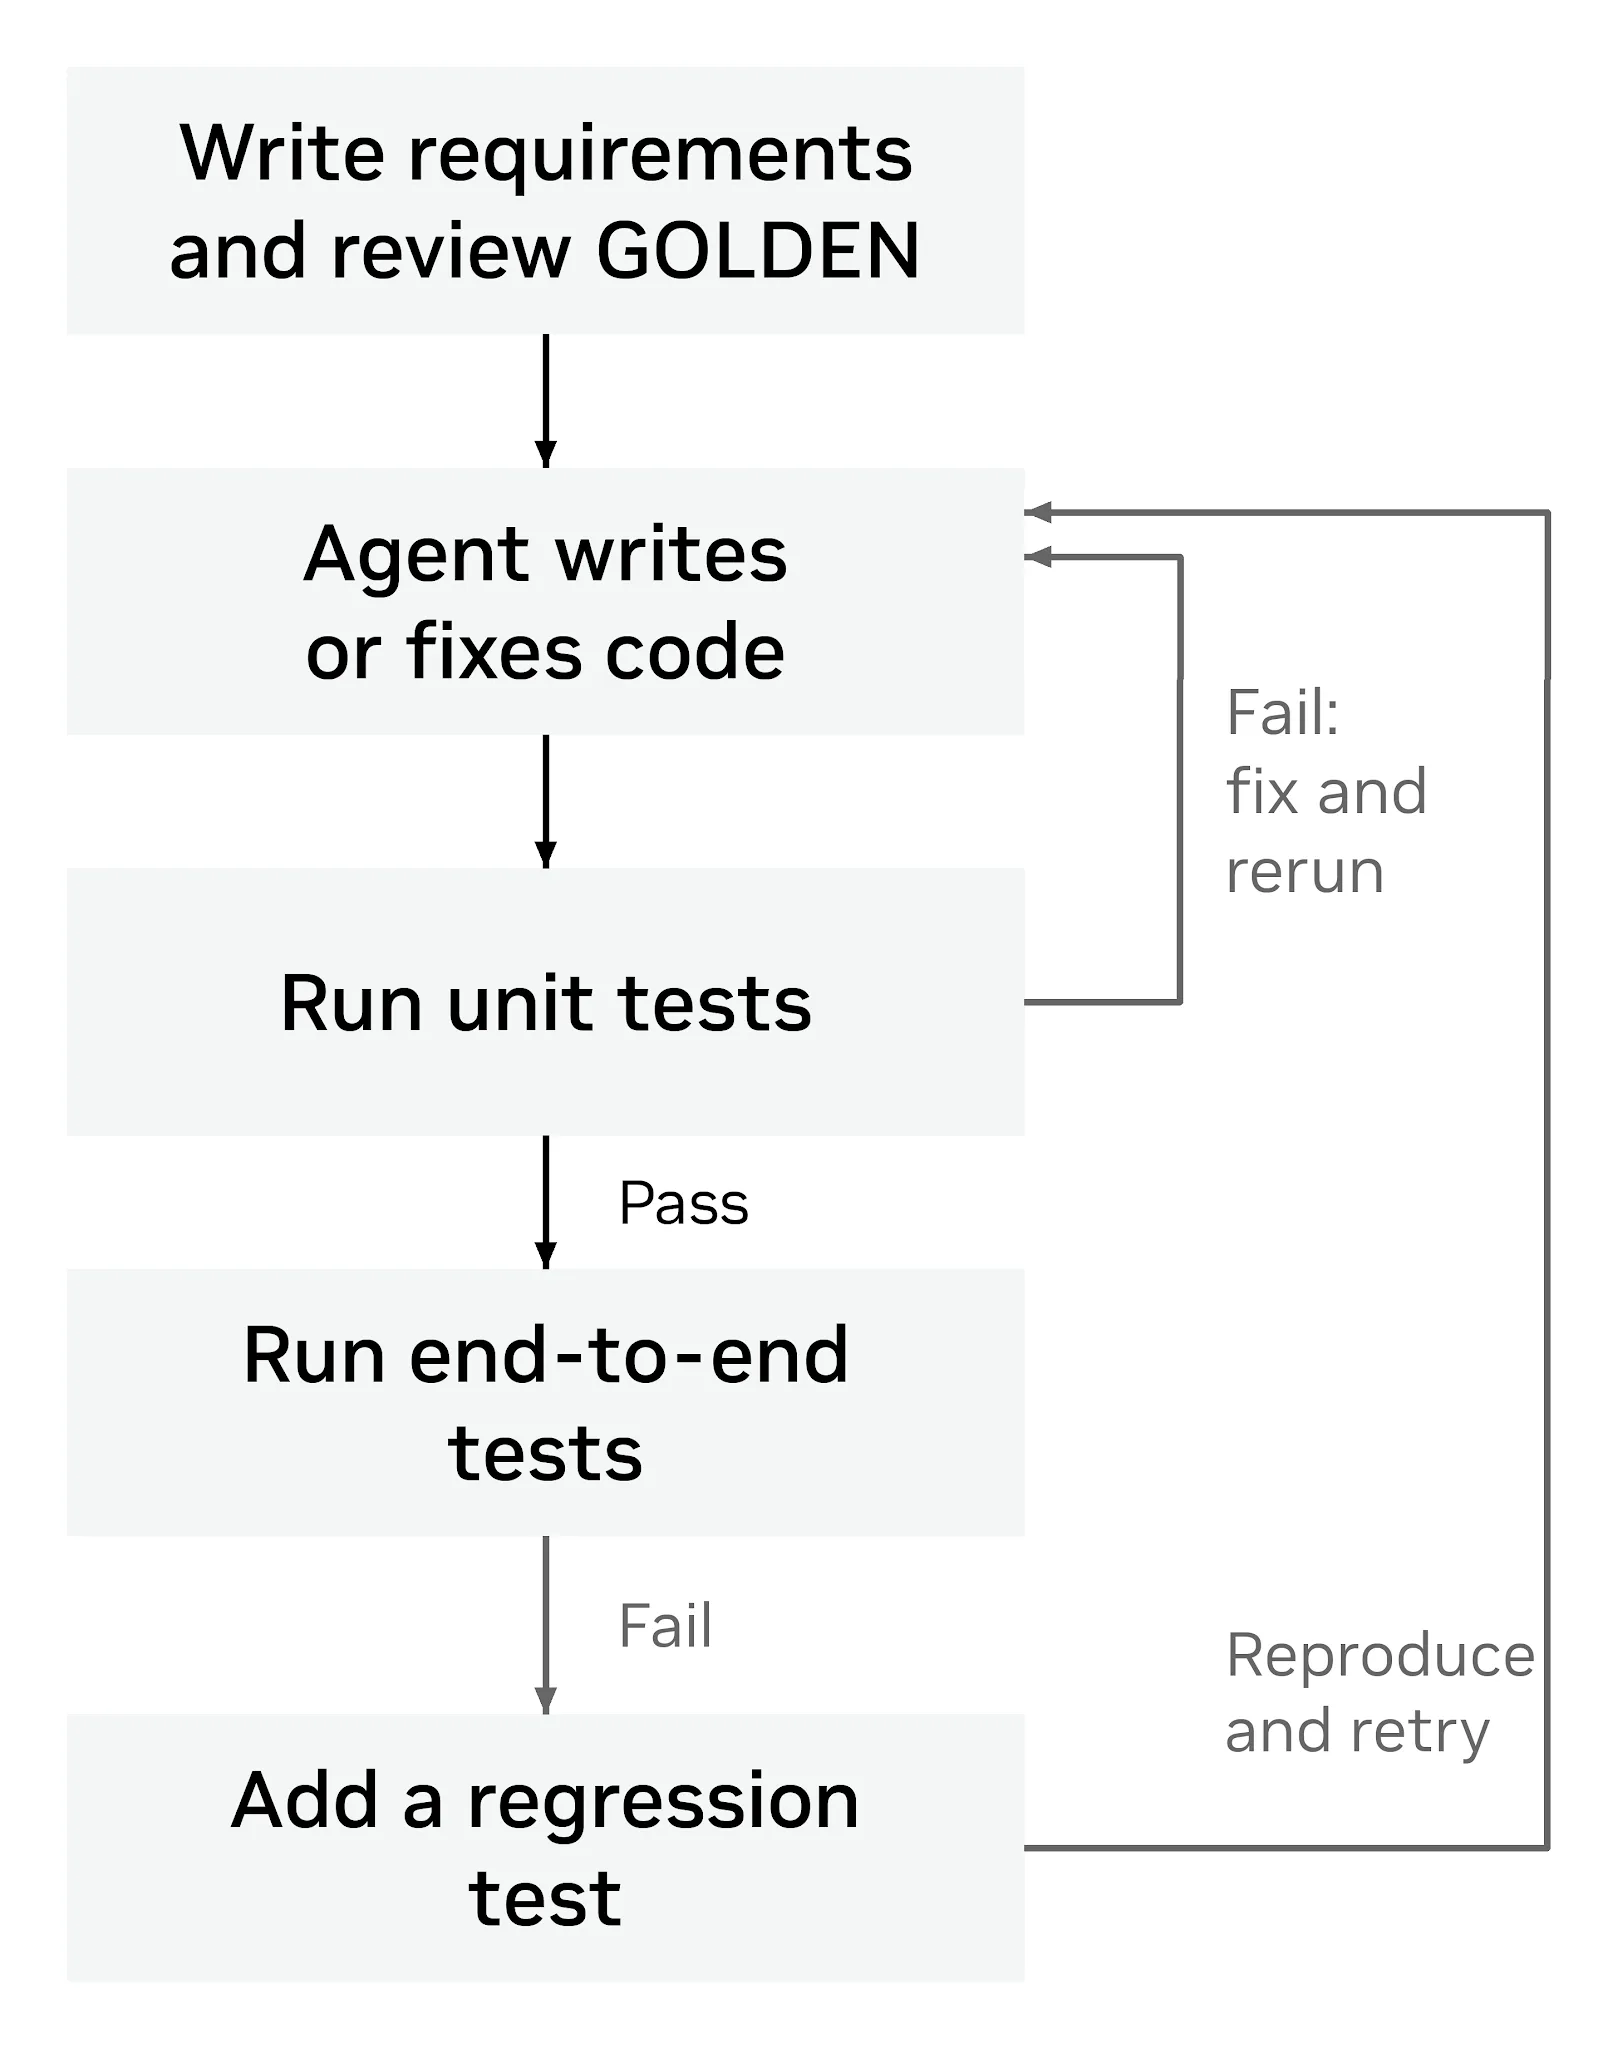
图 2 中的工作流程从模型的语法、恢复规则开始,并回顾了“黄金预期”。智能体编写或修复解析器,运行测试,并使用失败来指导下一次更改。如果它提议改变预期行为,请在接受之前审查该决定。
在申请部署支持之前,使用真实模型测试您的解析器端到端。规划分配计算机、加载模型、初始化运行时的时间,然后运行您自己的测试用例。将故障转化为智能体的单元测试,然后重新运行端到端测试以检查修复。
1. 从提示词开始
向智能体提供以下提示:在前端 – crates 结账窗口中,按照 .agents/skills/tool-parser-generator/ SKILL.md 为[MODEL_NAME]创建 v2 统一解析器。研究其语法并准备 GOLDEN 测试集,调整适用的 UNIFIED。个案例。暂停人工审核。批准后,实施、验证并提供本地一致性报告 URL,以供人工检查。
2. 定义黄金测试集
GOLDEN 测试集定义了解析器要测试的行为。使用步骤 1 中的提示,让智能体在 conformance/fixtures-unified-v2/families/<name>/inputs_and_golden.yaml 中生成初始测试集,独立于解析器结果。每个用例都会将输入与其预期输出 (称为“GOLDEN”) 配对。如果这些期望是错误的,解析器可能会通过测试,但仍然表现不正确。
以下示例将输入与其预期的 GOLDEN 输出配对。它省略了请求定义、工具、初始化和数据块设置;现有的 nemotron_v3/inputs_and_golden.yaml 显示了完整格式。
family: nemotron_v3
cases:
  UNIFIED.tool_only.nemotron_v3:
    input: |-
      </think><tool_call>
      <function=get_weather>
      <parameter=city>Paris</parameter>
      </function></tool_call>
    golden:
      - kind: tool_call
        name: get_weather
        arguments: {city: Paris}
要求代理进行对抗性审查,然后手动逐案审查。初始测试集可能包含错误,因为预期行为取决于智能体可能不具备的上下文。根据以下来源和要求进行审查:
- 模型格式和 API 规范。
- 参考实现。
- 其他解析器,包括 vLLM 和 SGLang。
- 语法、工具模式和请求设置。
- 相关论坛讨论和现有工单。
- 在延迟和复杂性方面,呼叫者的需求和恢复成本。
如果来源不一致,您可能需要进行评审。写下恢复规则和您选择它的原因,并记录任何黄金更改的原因。期望应遵循该决定,而非解析器的输出。
3. 实施解析器并检查结果
查看 GOLDEN 测试集后,要求智能体继续:构建解析器,运行所有适用的 UNIFIED.* 案例和共享回归测试,并修复故障。让它重新捕获结果,在本地生成 conformance/CONFORMANCE_v2.html ,并提供本地报告 URL,以便您检查其工作。
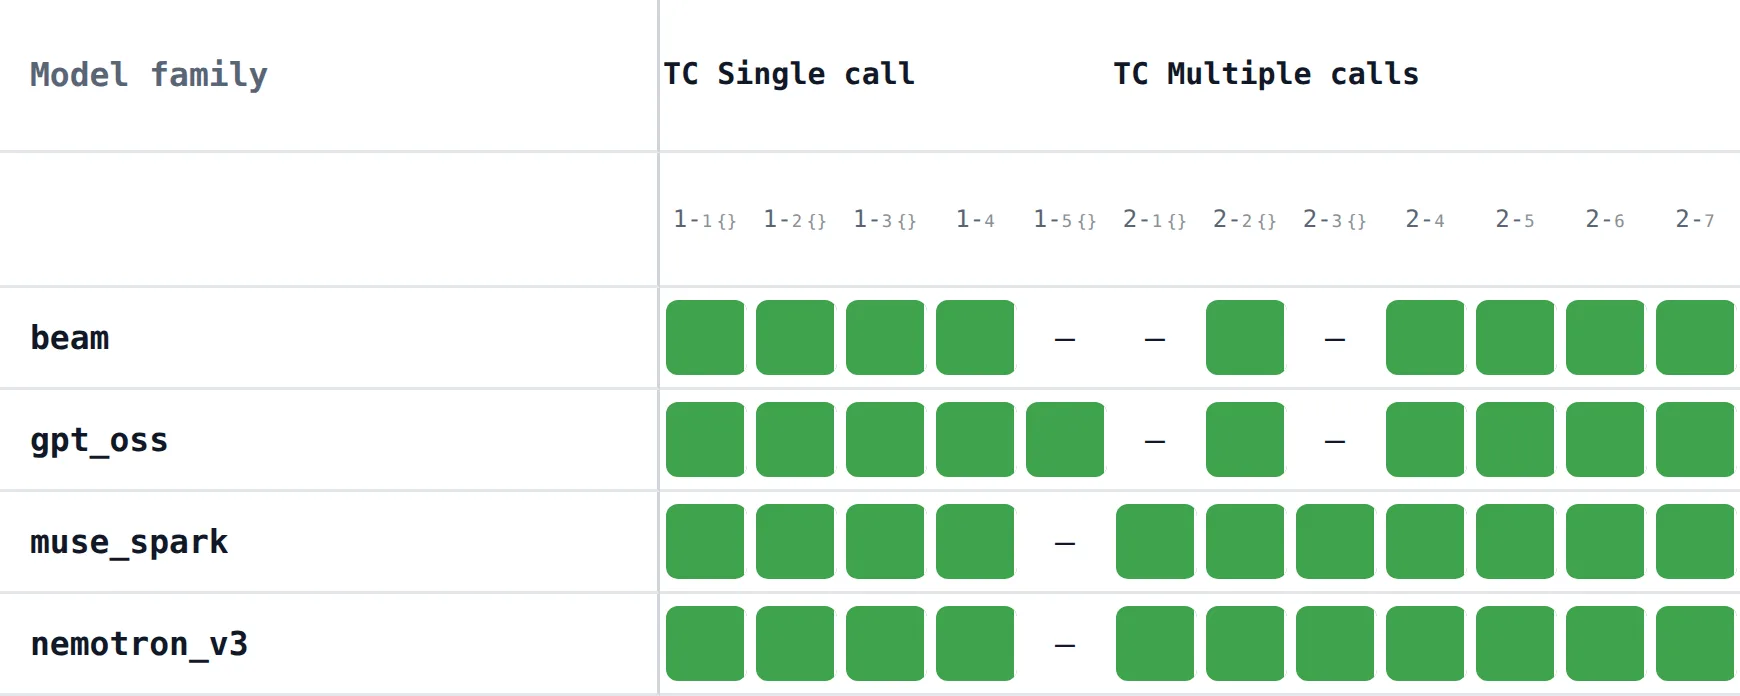
在浏览器中打开该 URL。本地报告将已发布的解析器一致性表的界面与本地结果结合使用。检查每个案例的输入、请求设置、金色和记录的输出。调查回归和捕获缺失。绿色表示输出与 GOLDEN 匹配,因此表格取决于您查看的期望。图 3 显示了报告界面。
引导式解码支持
智能体的实现步骤还包括引导式解码,它可以通过将生成限制为模型的标记和参数模式来减少格式错误的调用。要求您的智能体在解析器 README 中遵循“添加并验证结构标签”,并在智能体技能中遵循“实施并验证”。这些说明涵盖构建者注册、语法测试和后端资格认证。引导式解码无法确保模型选择正确的城市或防止截断,因此请保持解析器的恢复检查。
常见问题解答:速度、流式传输和内存
通过正确性测试只是智能体生成解析器的起点。实施可能仍然缓慢或占用过多内存。尝试使用纯文本、工具调用、长参数以及包含大大小小数据块的格式错误的输入。在相同的构建和硬件上测量吞吐量、执行第一个事件所需的时间,以及内存使用情况。将输入长度翻倍,以发现代码,从而持续重新扫描或复制已读取的内容。
借助流式传输,观看调用方在每个数据块到达时接收到的内容。解析器可以返回正确的最终结果,但仍然会让调用者等待结果。在每个拆分点回放简短的基境,然后尝试使用单字符和混合数据块,包括标记内的拆分、转义引号和参数。检查事件按顺序到达,参数保持不变。如果事件排队,请测试缓慢的消费者并取消。
另外,尝试通过标记或参数将流中断一半。检查恢复是否遵循记录的规则,而不会泄露标记、重复调用或丢失有效文本。解析器应处理接收到的输入,而无需猜测缺失的部分。
测试文本包含模型格式示例,以及根据记录的语法和引用处理策略进行的工具调用。当前的 v2 默认将识别的标记视为结构化标记,即使在引文中也是如此,因此仅使用引号无法在普通文本中保留完整的工具调用示例。记录已配置的策略并测试其预期行为。
向智能体发出此提示以检查是否存在常见问题:
查看此解析器,了解常见问题解答。针对使用不同数据块大小的短、长和格式错误的输入,对速度和内存进行基准测试。寻找重复扫描、复制或增长的缓冲区。验证输出是否以增量方式到达,并在数据块边界和截断部分中保持正确。在存在队列的情况下,测试缓慢的消费者、背压和取消情况。根据记录的语法和配置的引用处理策略,检查文本格式示例和真实的工具调用。报告测量结果、可重现的故障以及您无法验证的任何内容。
如何在您自己的 Rust 项目中使用解析器包
选择语法与您的模型相匹配的解析器。此示例使用现有的 NVIDIA Nemotron 解析器,并将标记和城市名称拆分成多个块。
此示例使用 Rust 1.96.1 和 dynamo-parsers-v2 0.10.3 进行了测试。运行 cargo new parser-demo ,然后运行 cd parser-demo 。在 Cargo.toml 的 [dependencies] 下添加以下条目:
anyhow = "1"
dynamo-parsers-v2 = "=0.10.3"
serde_json = "1"
将 src/main.rs 替换为:
use dynamo_parsers_v2::{
    Tool, UnifiedParserInit, UnifiedParserOutput, create_unified_parser_for_family,
};
use serde_json::json;

fn main() -> anyhow::Result<()> {
    let tools = [Tool {
        name: "get_weather".into(),
        description: None,
        parameters: json!({"type":"object","properties":{"city":{"type":"string"}},"required":["city"]}),
        strict: None,
    }];
    let mut parser = create_unified_parser_for_family("nemotron_v3", &tools)?;
    parser.initialize_request(UnifiedParserInit::default())?;
    let mut output = UnifiedParserOutput::default();
    for chunk in [
        "Check the forecast.</think><tool_",
        "call><function=get_weather><parameter=city>Par",
        "is</parameter></function></tool_call>",
    ] {
        let mut delta = UnifiedParserOutput::default();
        parser.parse_into(chunk, &mut delta)?;
        output.append(&mut delta);
    }
    output.append(&mut parser.finish()?);
    println!("{}", serde_json::to_string(&output.assembled())?);
    Ok(())
}
运行 cargo generate-lockfile ,然后运行 cargo run --locked 。结果包括推理,然后调用 get_weather,将城市设置为巴黎:
[{"kind":"reasoning","text":"Check the forecast."},
 {"kind":"tool_call","name":"get_weather","arguments":{"city":"Paris"}}]
为每个请求选择保留一个初始化解析器。
create_unified_parser_for_family选择语法。initialize_request设置起始状态。parse_into会占用每个数据块。- 完成一次:使用
finish()截断、取消或结束传输流。仅对后端确认的语法结束序列 (EOS) 信号使用finish_at_eos()。 - 使用
assembled()获得有序的结果。
在流式传输应用中,每次调用 parse_into 后,转发 delta.events 中的事件和 finish() 返回的事件。此示例收集事件以打印最终输出。在执行工具之前,请验证已完成的工具可用性、授权、模式和调用策略调用。
开始使用
要为您的模型构建解析器,请先从前端模型中的源、固定装置和指令入手,然后调整现有测试用例。向您的代理提供模型的格式规格和存储库说明,然后使用解析器一致性表查看解析器记录的输出与 GOLDEN 的对比情况。当您打开问题或拉取请求时,请包含准确的失败输入、案例标识符和测试结果,以便审核者可以重现该行为。
您可以在自己的 NVIDIA Dynamo 中使用这些解析器,也可以将其用作 NVIDIA Dynamo 的一部分,NVIDIA Dynamo 是一个使用前端模型的推理框架。开始之前,请查看最新的存储库说明,以便您和您的代理按照当前步骤操作。
致谢
Jesse Gu、Alec Flowers、Dong Xu、Qi Wang,以及帮助编写本博客和前端库的众多合作伙伴和审校人员。


