

生成式 AI 对计算和内存的需求日益超出单个 GPU 的能力。NVIDIA TensorRT 多设备推理是一项新功能,使单个 TensorRT 网络能够使用由NCCL支持的分布式集合在多个 GPU 上执行,同时保留 TensorRT 推理优化。从 TensorRT 11.0 开始,完全受支持。
NVIDIA Dynamo-Triton (以前称为 NVIDIA Triton 推理服务器) 版本 26.07 支持 TensorRT 后端的多设备推理功能。一个 Triton KIND_MODEL 实例可以拥有多个 GPU,创建每秩 TensorRT 执行上下文、CUDA 流和 NCCL 通信器,并为每个请求一起启动 rank。应用通过 gRPC 端点调用一个已命名的模型,而非自行协调 GPU 秩。
对于部署生成式 AI 的组织而言,这缩小了多 GPU 加速与可消耗推理服务之间的差距。团队可以使用额外的 GPU 资源来缩短请求延迟,保持应用程序界面和周围工作流程的稳定性,将引擎打包为版本化的 Triton 模型,并在客户端之外保留 rank 和 communicator 生命周期代码。对于延迟敏感型生成式媒体工作流而言,缩短生成结果的时间可以减少用户的等待时间,并加速审查和优化周期。
本文将介绍如何使用 NVIDIA Cosmos 3 Nano 视频生成技术进行集成,上一篇文章介绍了如何使用 NVIDIA TensorRT 和多设备推理支持 在多个 GPU 上扩展 AI 推理。扩散器继续编排提示、隐性、无分类器引导 (CFG) 、调度、VAE 解码和帧后处理。Dynamo-Triton 提供 36 层降噪转换器,TensorRT 多设备推理使用 Ulysses 上下文并行,在多达 8 个 NVIDIA GPU 上分配其 44160 个视频 token。
Dynamo-Triton 如何为 TensorRT 多设备模型提供服务?
在部署之前,将分布式 Ulysses 图形编译到每个 TensorRT 计划中。Dynamo-Triton TensorRT 后端加载版本化计划,创建多秩执行状态,并公开一个 gRPC 模型端点。客户端向该端点发送 Transformer 请求;它不协调参与的 GPU 秩。
Cosmos 3 Nano 模型提供了这一边界的实际示例。Transformer 占单 GPU 生成时间的 93.4%,是影响最大的加速阶段。在 35 个降噪步骤中,每个步骤都需要一个负或无条件预测以及一个基于提示条件的 CFG 预测。因此,Diffusers 代理每步进行两次连续的 Triton 调用,每代 70 个 Transformer RPC。每个请求都会携带准备好的张量,并将 noise_patches 返回至应用程序工作流程。
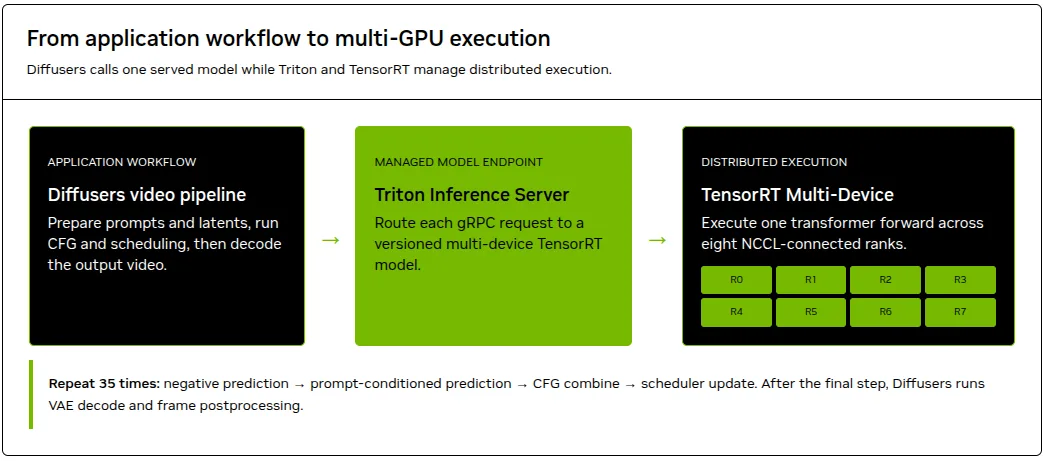
Dynamo-Triton 如何激活上下文并行的分布式 TensorRT 计划?
分布式图形被编译成每个上下文并行的 TensorRT 计划。Dynamo-Triton 配置会激活该计划;它不会将单个设备引擎转换为分布式引擎。单设备基准使用 GPU 0 上的标准 GPU 模型实例。2、4 和 8 GPU 变体使用 KIND_MODEL,启用 TensorRT 后端多设备路径,并识别参与的 rank。
# Excerpt from the generated CP8 config.pbtxt
name: "cosmos3_cp8"
backend: "tensorrt"
max_batch_size: 0

instance_group [
  { kind: KIND_MODEL count: 1 }
]
parameters [
  { key: "enable_multi_device" value: { string_value: "true" } },
  { key: "multi_device_gpus" value: { string_value: "0,1,2,3,4,5,6,7" } }
]
使用 Ulysses 上下文并行性分发 Cosmos 3
此示例中固定的 Cosmos 3 Nano 配置文件会生成 44160 个视频token。在上下文并行大小为 8 (CP8) 时,每个秩会处理 5520 个注意力外视频token。较短的 2992-token 文本路径仍会被复制。在 36 个 Transformer 层中的每一层中,Ulysses 都会围绕注意力改变分割轴,以便每个秩处理不重叠的头部子集的完整视频序列。
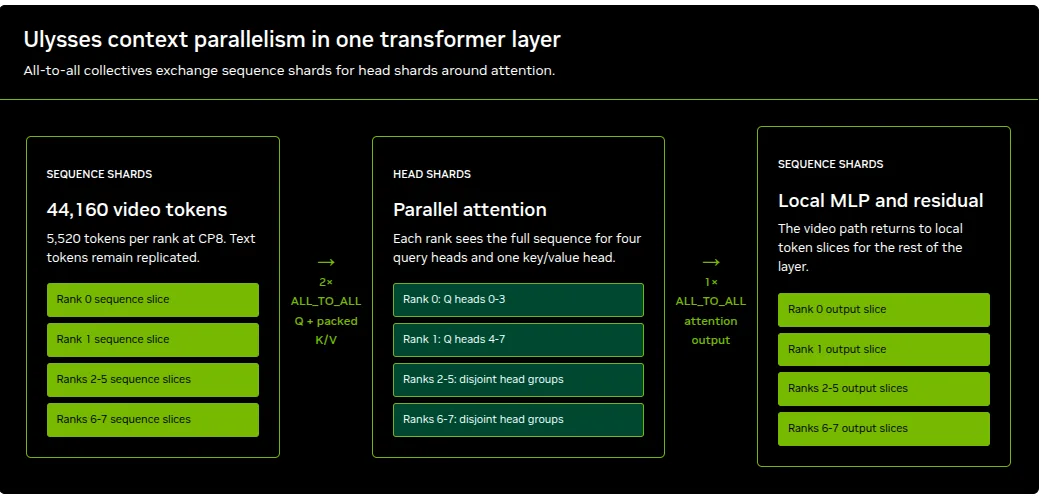
该引擎从 PyTorch 导出,并使用 Torch-TensorRT 进行编译。三个本地转换器将导出载波运算降低到 TensorRT 公共分布式集合层:reduce-scatter、all-to-all 和 all-gather。每个可接受的上下文并行计划都包含两个初始归约散射函数、36 个 Transformer 层中每个层中的三个 all-to-all 函数,以及一个最终的 all-gather 函数。得到的拓扑是两个 reduce-scatter,加上 108 个 all-to-all,加上一个 all-gather。
端到端生成延迟基准测试
这四种版本都在同一运行良好的 8 GPU NVIDIA 系统上运行。单设备基准测试使用 1 个 GPU;CP2、CP4 和 CP8 使用 2 个 rank、4 个 rank 和 8 个 rank。每次运行都使用 1280 × 720 输出,在 24 FPS 下使用 189 帧,降噪步长为 35。
每个结果都包括一次预热,然后是五次测量的完整代。计时涵盖提示作业、70 次 Dynamo-Triton 调用、CFG 和调度程序更新、VAE 解码和帧后处理。请注意,模型加载和 mp4 编码排除在外。
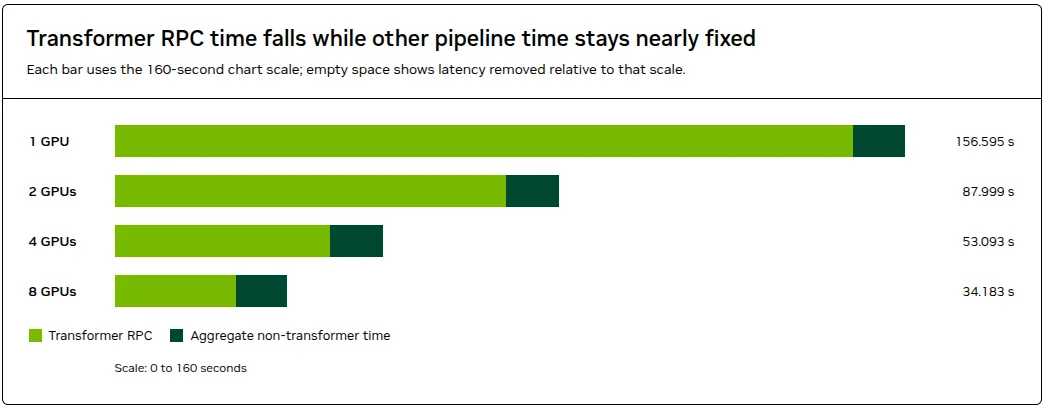
表 1 比较了 SD、CP2、CP4 和 CP8 Cosmos 3 的运行情况。端到端延迟从一个 GPU 上的 156.595 秒下降到 8 个 GPU 上的 34.183 秒,而 Transformer RPC 加速增加到 6.09 倍。
| 变体 | GPU | E2E 均值 | 端到端加速 | RPC 均值 | RPC 加速 | RPC 共享 |
|---|---|---|---|---|---|---|
| SD | 1 | 156.595 | 1.00 倍 | 146.192 | 1.00 倍 | 93.4% |
| CP2 | 2 | 87.999 | 1.78 倍 | 77.548 | 1.89 倍 | 88.1% |
| CP4 | 4 | 53.093 | 2.95 倍 | 42.661 | 3.43 倍 | 80.4% |
| CP8 | 8 | 34.183 | 4.58 倍 | 23.993 | 6.09 x | 70.2% |
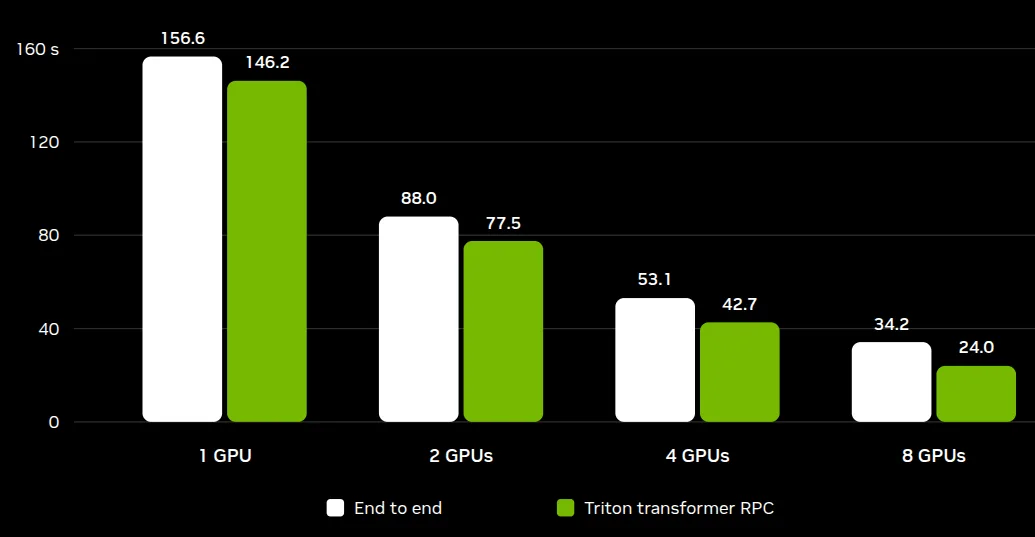
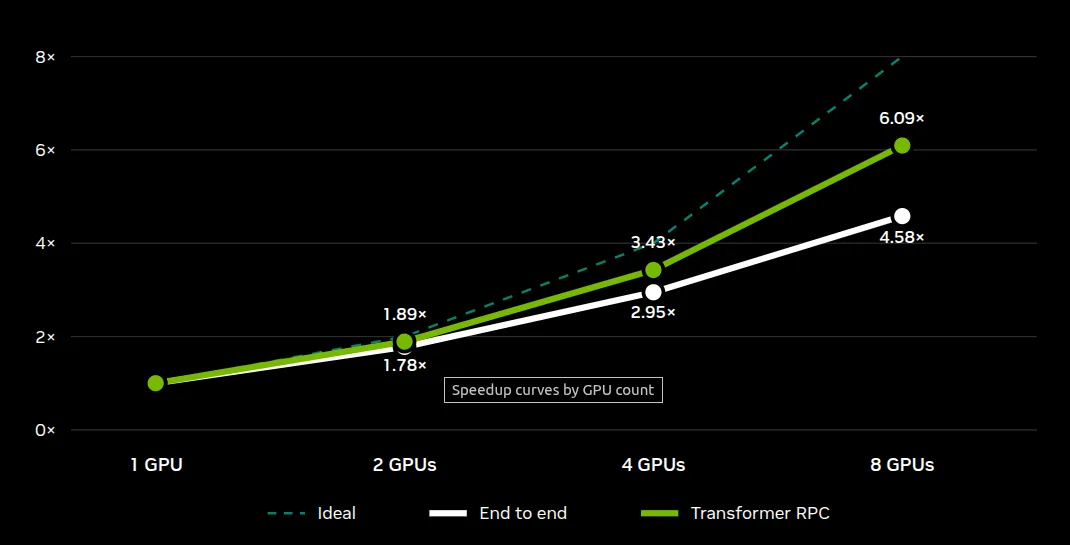
在一个 GPU 上,Transformer RPC 占生成时间的 93.4%。在 CP8 中,这一比例降至 70.2%。在测量的 RPC 路径之外的时间在不同配置下仍保持在 10.2 到 10.5 秒之间,因此提示工作、调度程序更新、VAE 解码、后处理和其他客户端用度在总用度中所占比例更大。
在声明性能之前验证生成的输出
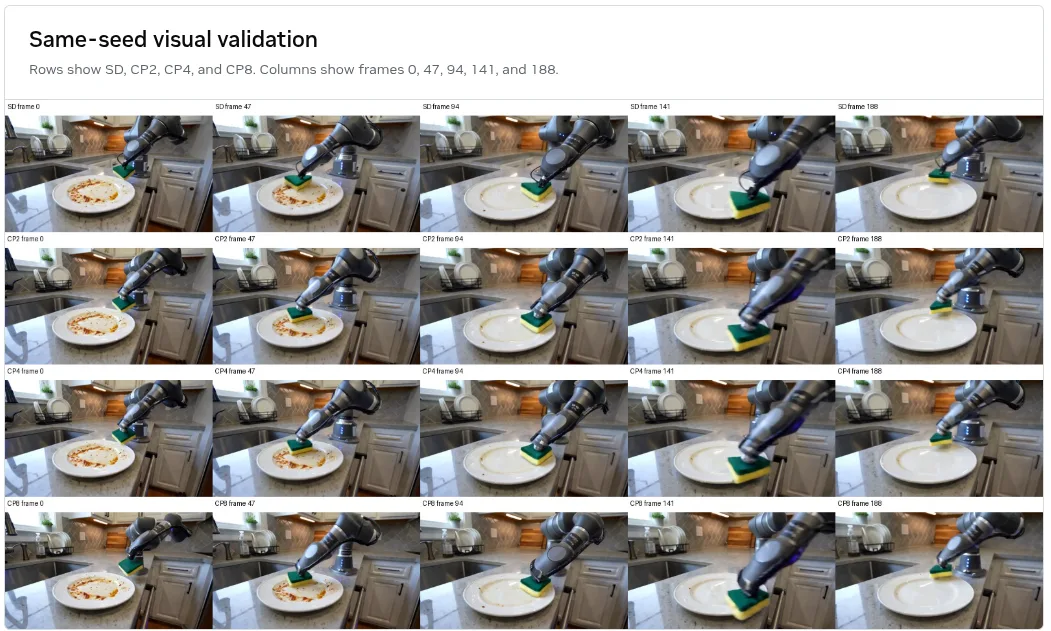
每个变体都使用相同的种子和生成配置文件。验证采样帧 0、47、94、141 和 188,检查格式和时间变化,并将每个上下文并行输出与单设备结果进行比较。CP2、CP4 和 CP8 通过了平均绝对误差 (MAE) = 25 和峰值信噪比 (PSNR) = 18 dB 的配置值测试。
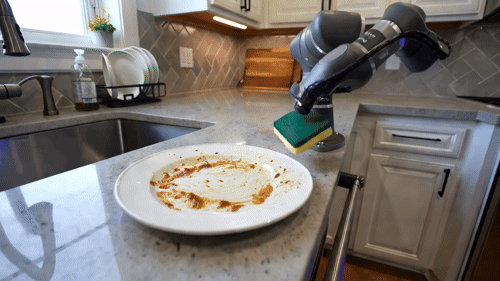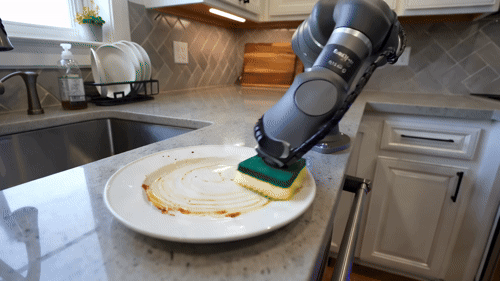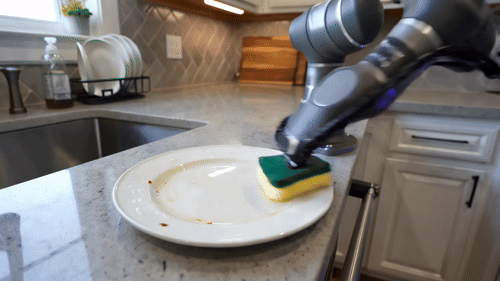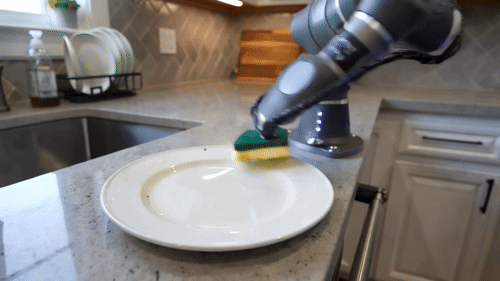
我们并未声明像素相同的输出。CP2 和 CP4 分别测量了 MAE 12.759 和 PSNR 21.111 dB。CP8 测量了 MAE 16.316 和 PSNR 19.400 dB。接触表还显示了整个夹子上相同的连贯动作:机械臂在清洁盘子。
开始简化多 GPU 模型服务
对于产品团队而言,当响应时间比最小化分配给一个请求的 GPU 更具有商业价值时,这些结果证明了一个切实可行的选择。之前需要超过 2.5 分钟才能完成的完整一代 Cosmos 3 大约需要 34 秒完成,而应用程序继续使用传统的模型服务接口。
团队仍然必须根据资源 – 延迟权衡来决定最佳方法。此基准测试不会衡量并发请求吞吐量、每个生成视频的成本或总拥有成本 (TCO) 。团队应根据自己的 SLO 和部署经济性来评估这些指标。
要在您自己的环境中重现本文中介绍的结果,请从 NGC 下载 NVIDIA Dynamo-Triton 26.07。然后使用链接的 TensorRT、Torch-TensorRT、Diffusers 和 Cosmos 资源。
如需了解详情,请查看以下相关资源:


