

在系统上部署模型。启动后,提示得到响应。难题是:速度快吗?
直觉可能会引导您发送 curl 命令、手动滚动异步脚本或另一个一次性负载生成器。所有这些路径都有相同的问题:单进程性能限制、Python 的 GIL 限制并发性,或根据您自己构建的引用测量的数字。无论采用哪种方式,最终都会得到无法完全信任的结果,附加到工具上,您必须重写需求变化的时刻。
您需要的是一个加载客户端,它可以使真实的服务器饱和而不会成为瓶颈,产生您可以采取行动的输出,并且需要五分钟来配置,而不是五个小时。这就是 NVIDIA AIPerf。
AIPerf 的不同之处在于
AIPerf 是 GenAI-Perf 的指定继承者,是一种全新的重写技术。设计选择反映了大规模运行 LLM 基准测试的惨痛教训:
- 彻底摆脱旧架构。 AIPerf 并不像 GenAI-Perf 那样在 Perf Analyzer 上运行。这是一次彻底的架构突破,也是 AIPerf 能够如此扩展的原因。如果您要移植现有工作流程,迁移指南将涵盖关键增量。
- 客户端不应成为瓶颈。大多数基准测试程序 (包括 GenAI-Perf) 都使用单进程架构,该架构在实际并发或请求速率下受到 GIL 限制。AIPerf 是一个多处理系统:工作进程生成负载,单独的记录处理器服务处理结果,一切都通过 ZMQ 进行协调。这种结构可防止 AIPerf 成为客户端瓶颈,从而实现更准确的服务器基准测试。
- 与您实际运行的内容相匹配的工作负载广度。AIPerf 支持超过 15 种端点类型:聊天、回复、NIM 排名、图像生成等,以及 ShareGPT 等公共数据集和 Mooncake、Baseten、WEKA (AgentX) 等的追踪回放格式。无论是运行快速的合成烟雾测试,还是回放捕获的生产流量,您都不需要使用其他工具。
- 加载您实际控制的形状。AIPerf 支持常数、泊松和 Gamma 到达模式,具有可调整的突发度、并发率和请求率的逐步提升,以及可变 ISL/ OSL 的合成分布 (包括 vLLM/ SGLang 范围比) 。您可以控制负载的形状,而不仅仅是体积。
初始基准测试:vLLM 上的合成 ISL/ OSL
在此演示中,我们将使用通过 vLLM 提供的 Qwen3-0.6 B。模型的选择是经过深思熟虑的;它足够小,可以在单个 GPU 上运行,并且足够快,无需等待即可进行迭代。重点不是专门对 Qwen3-0.6 B 进行基准测试,而是建立测量循环。完成此操作后,切换到不同的模型或端点就变成了单标志更改。
启动服务器
在启用推理解析器的情况下,拉取并启动 vLLM:
docker pull vllm/vllm-openai:latest
docker run --gpus all -p 8000:8000 -e HF_TOKEN vllm/vllm-openai:latest \
  --model Qwen/Qwen3-0.6B \
  --reasoning-parser qwen3 \
  --host 0.0.0.0 --port 8000
安装 AIPerf
我们可以使用 uv 安装中心副本:
uv tool install aiperf
或者对于虚拟环境:
uv venv venv
source venv/bin/activate
uv pip install aiperf
需要注意的一点是:在 aarch64 上,crick 依赖项仅作为源提供,并且需要一个 C 语言工具链 (build-essential 在 Debian/ Ubuntu 上,Development Tools 在 RHEL 上) 。如果软件包的安装出现卡顿,原因就在于此。
运行基准测试
服务器启动并安装 AIPerf 后,我们现在可以运行第一个配置文件:
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --synthetic-input-tokens-mean 128 \
  --synthetic-input-tokens-stddev 0 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 0 \
  --extra-inputs min_tokens:128 \
  --extra-inputs ignore_eos:true
此处的一些标志所做的工作超出了预期:
--synthetic-input-tokens-stddev 0 和 --output-tokens-stddev 0 将工作负载固定到每个请求的 128 个输入token和 128 个输出token。这再现了常用的静态基准测试,该基准测试使请求和输出长度保持不变。
--extra-inputs min_tokens:128 和 --extra-inputs ignore_eos:true 告知模型实际发出 128 个 token,而不是提早停止。如果没有这些参数,我们建议输出token数量。只要模型自然完成,它就会停止,这可能远远低于您的目标 OSL。吞吐量数值最终会低于预期值,并且无法在运行中重现。
如果您想测量 TTFT 和 ITL,--streaming 并非可选项。在不进行流式传输的情况下,服务器会在发送完整的响应之前对其进行批处理,并且没有要测量的初始事件或解码token事件。
您将看到的内容
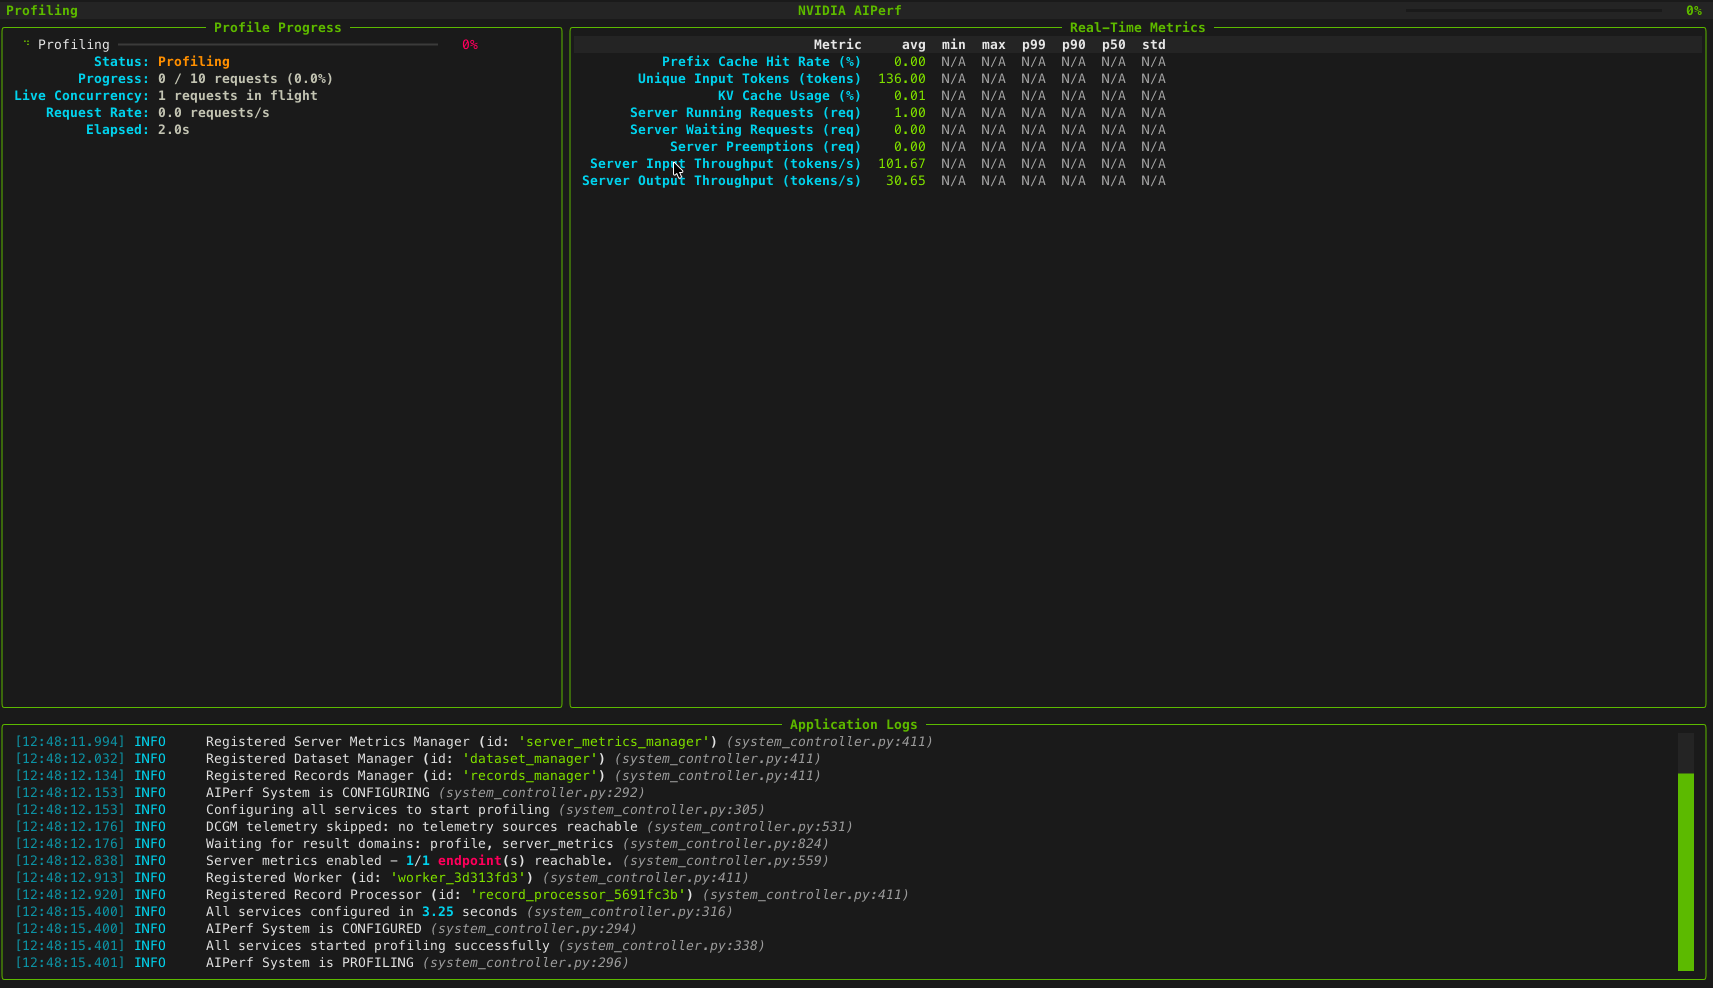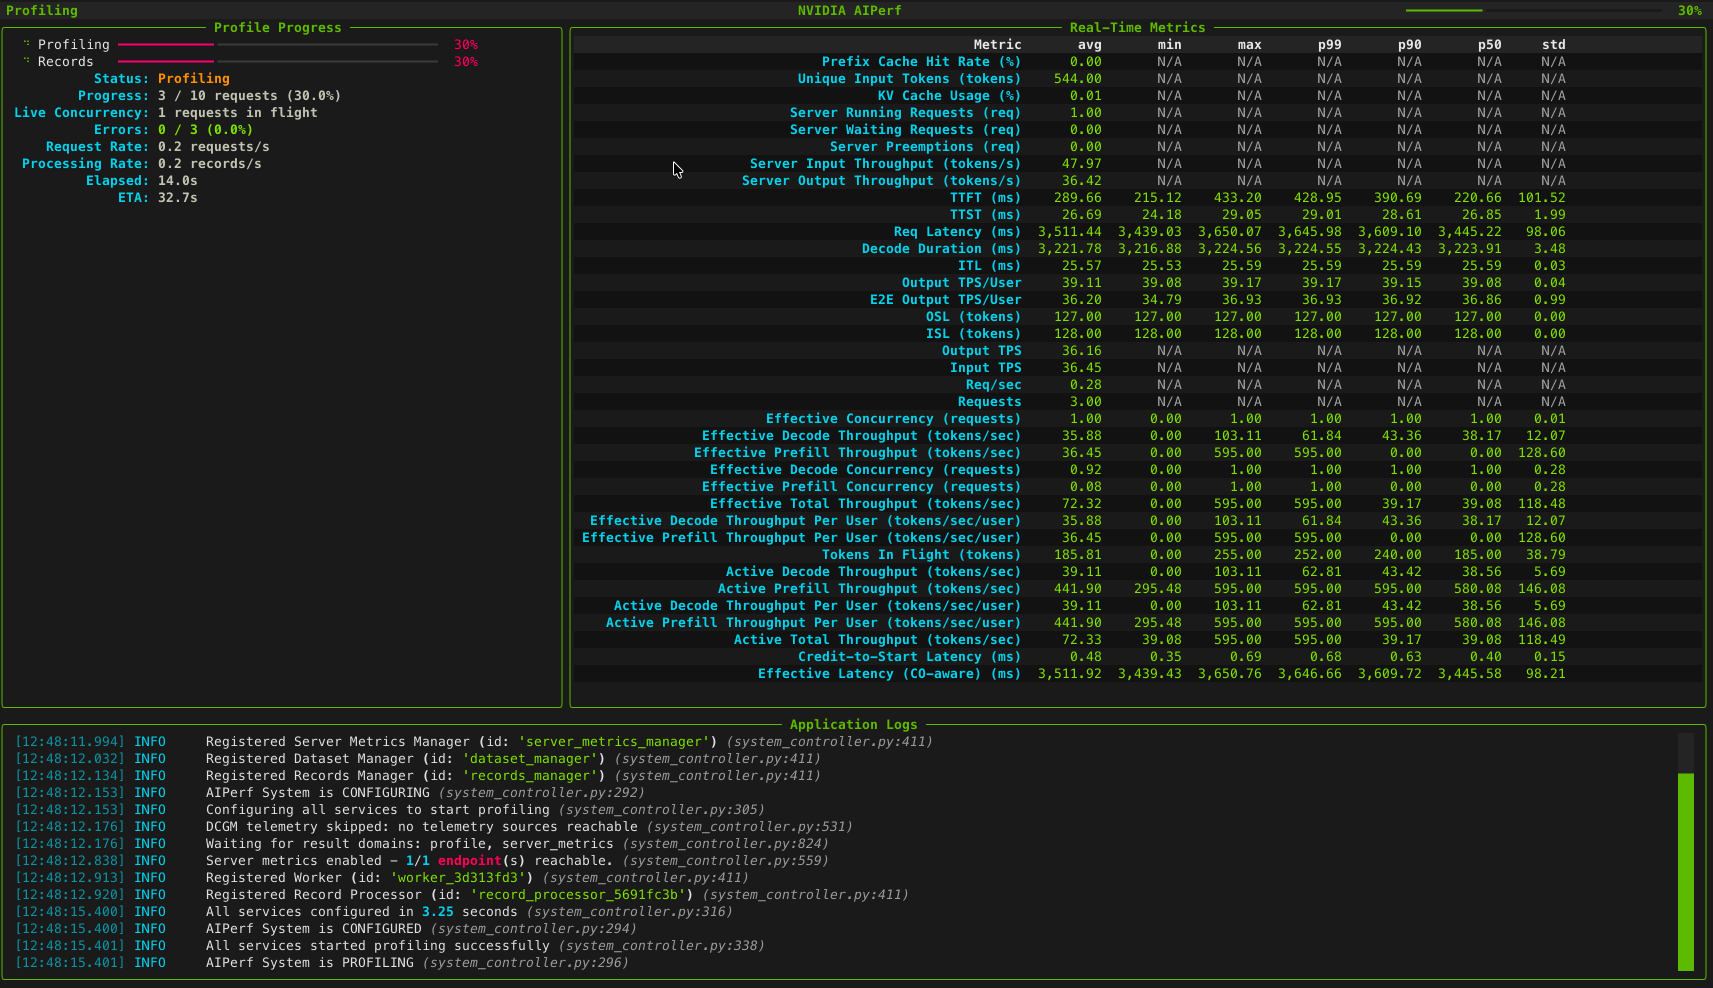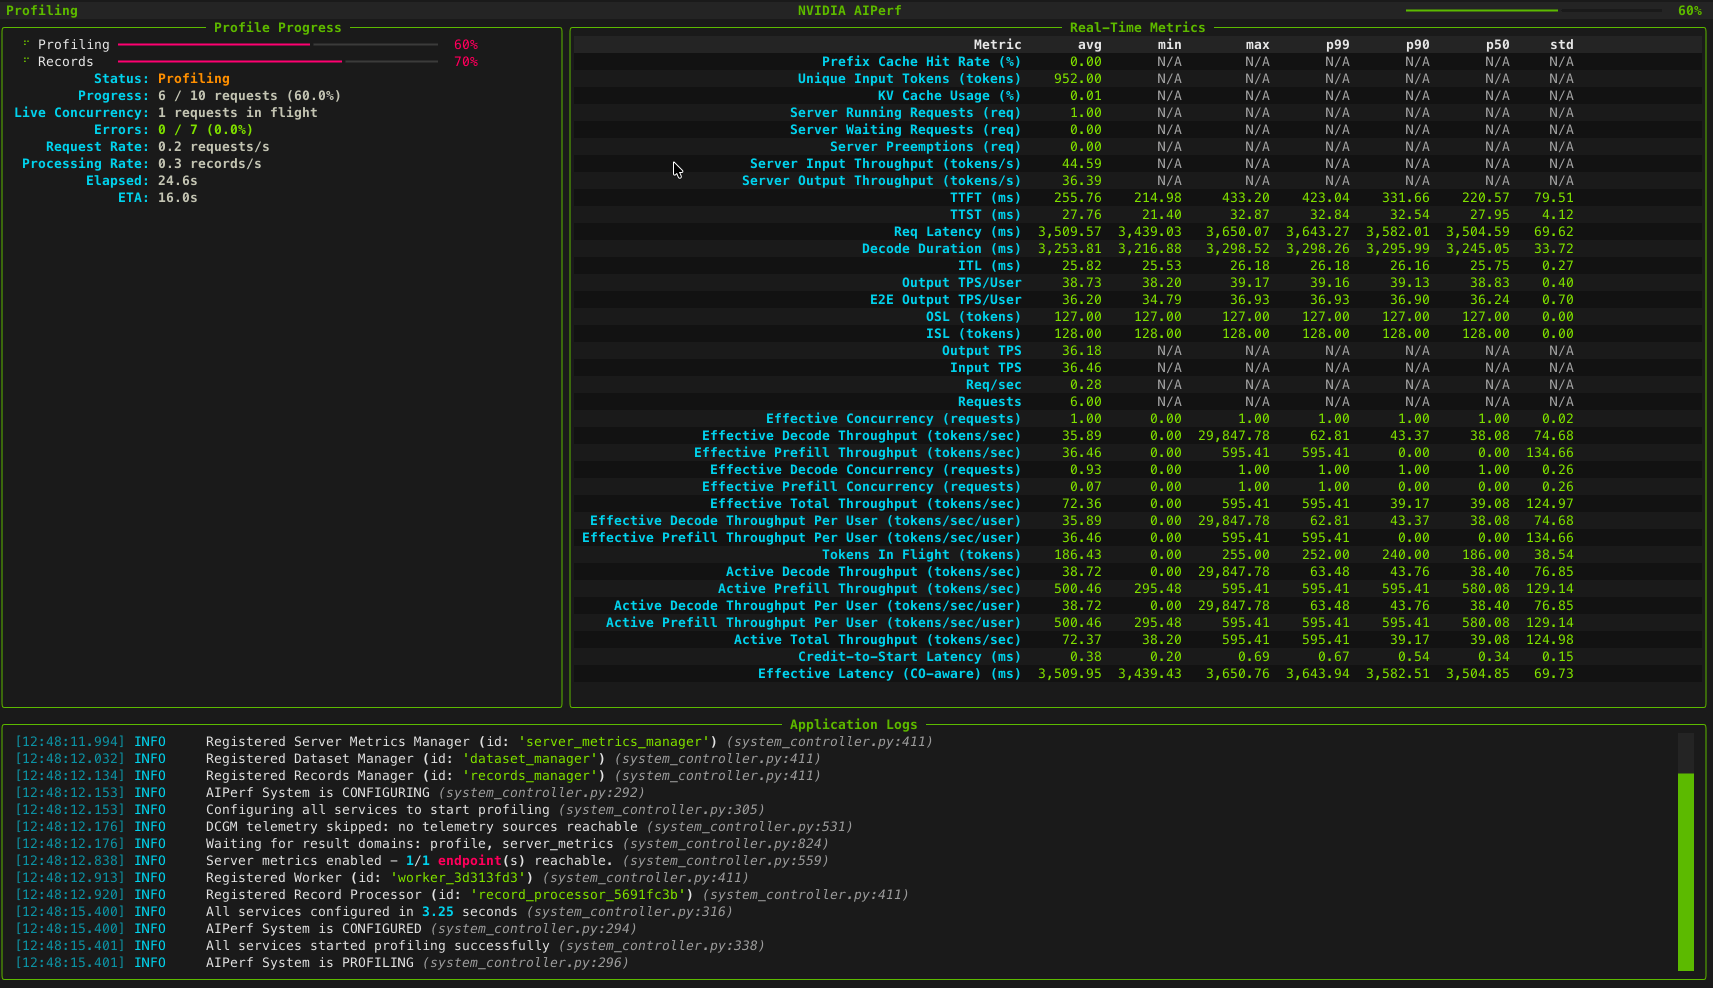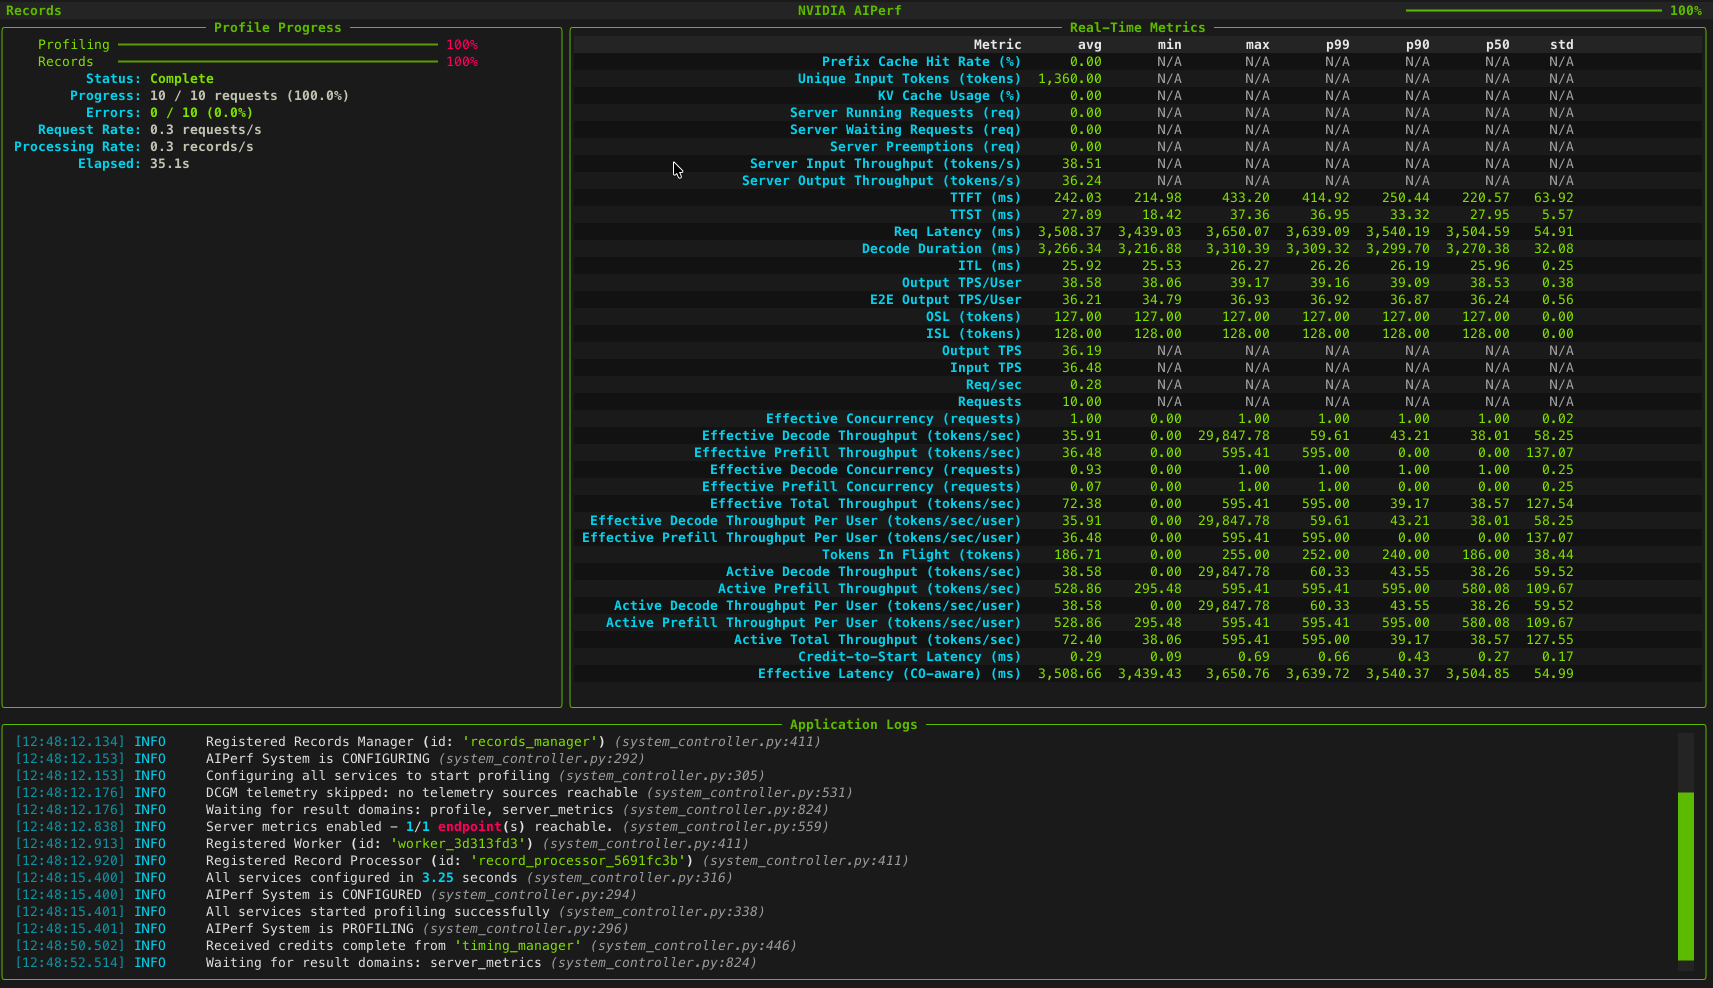
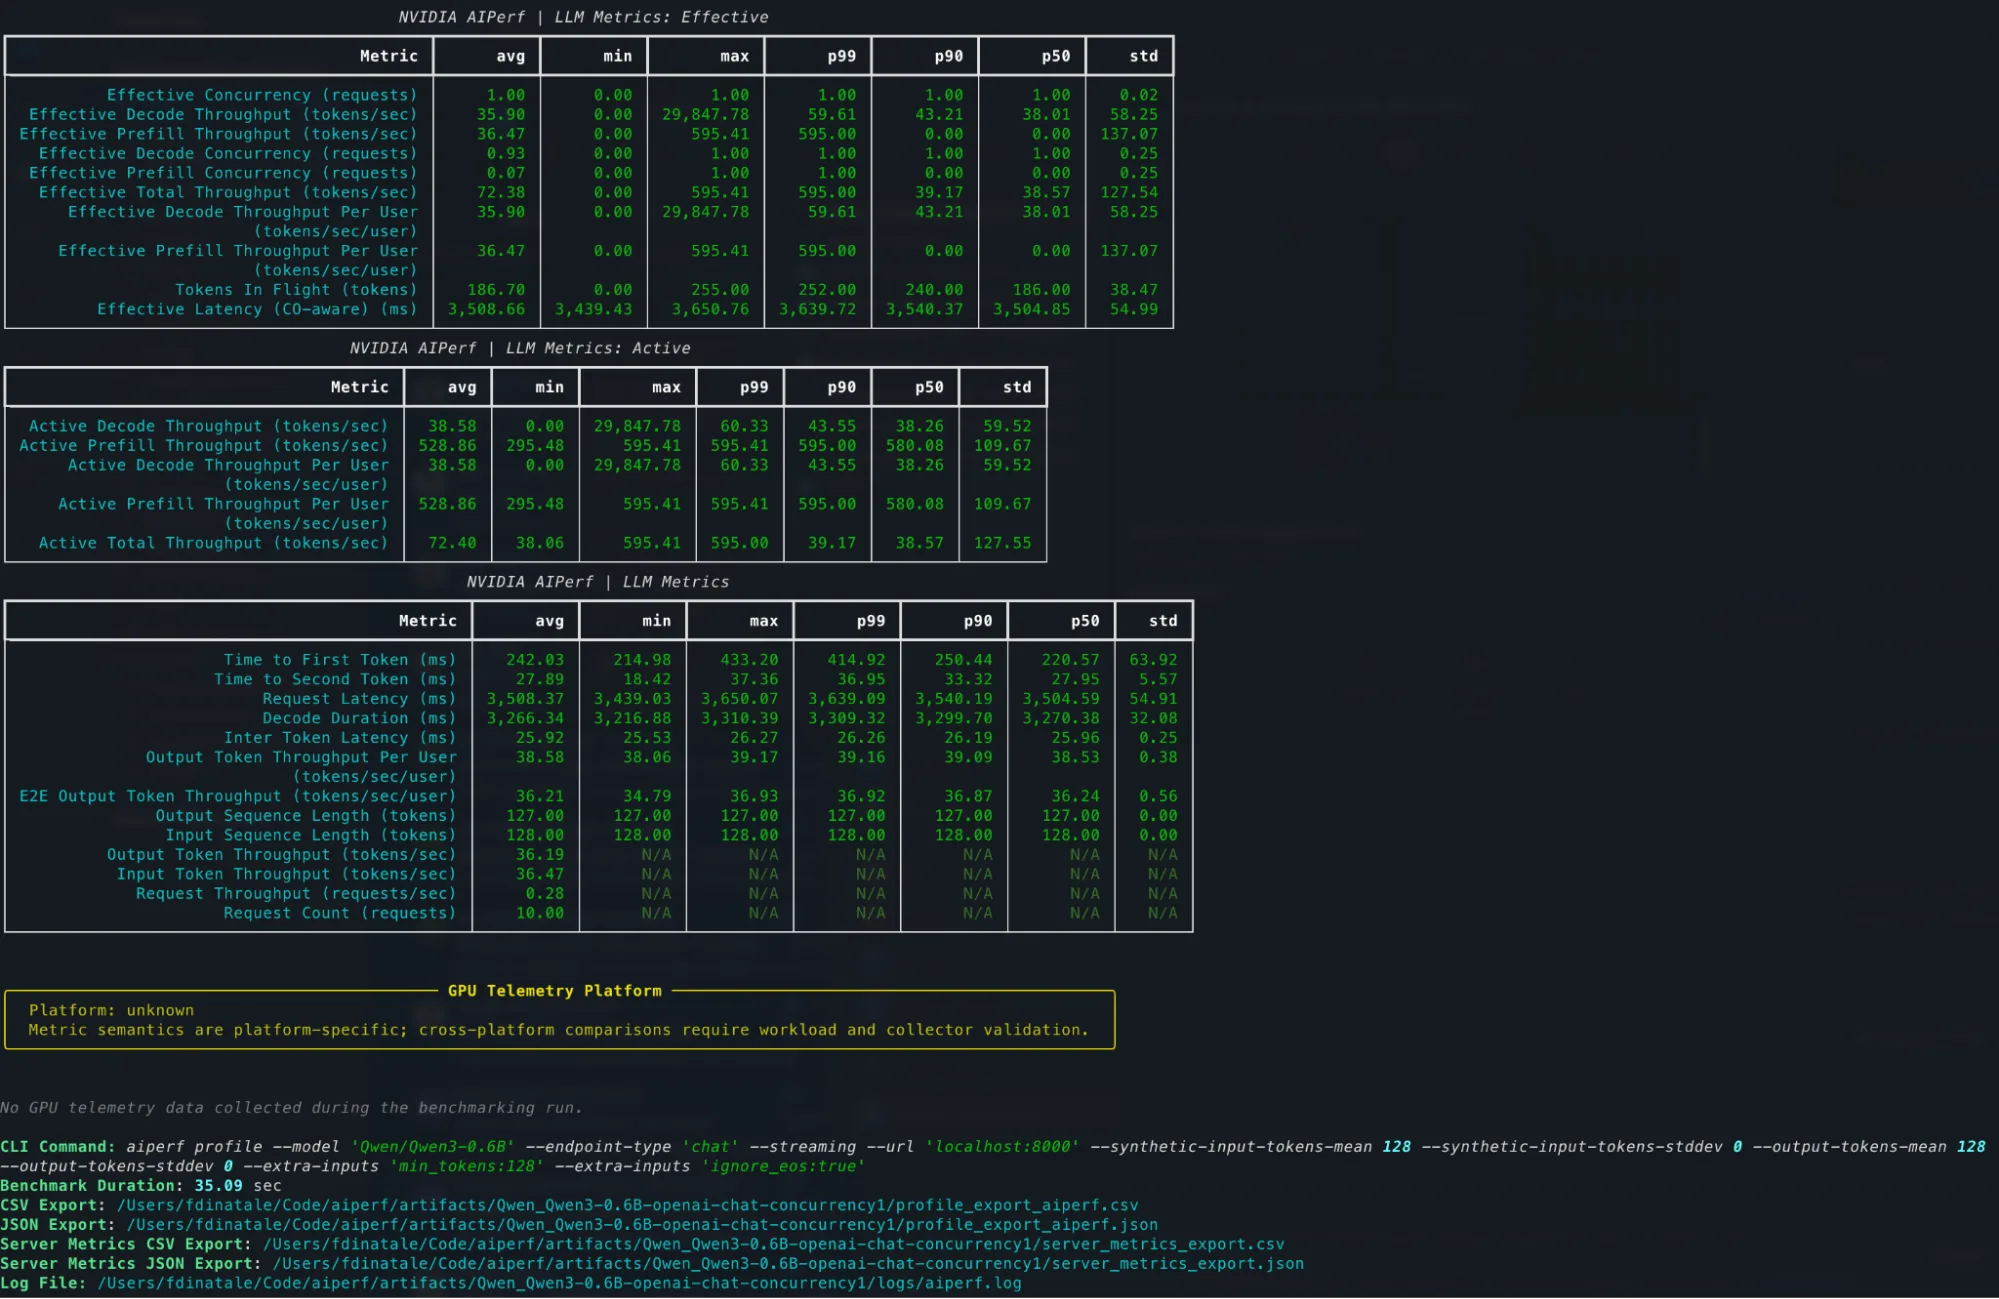
我们将在下一节中介绍如何读取这些数字。现在,请注意以下图 2 中的输出形状:按百分位数细分的延迟、每秒 token 吞吐量以及请求级统计数据,全部集中在一处。这是您将与其他一切进行比较的基准。
阅读数据:AIPerf 展示的内容
运行完成后,AIPerf 会将指标表打印到控制台,并将完整结果写入 CSV 和 JSON。这就是您要查看的内容。
核心四:
- TTFT (Time to First Token) — 从请求发送到收到第一个 Token 的时间。交互式用例的主要延迟信号。
- ITL (token间延迟) — 生成过程中连续token之间的时间。高 ITL 意味着解码阶段困难重重,即使 TTFT 看起来正常。
- 请求延迟 — 完整响应的端到端时间。将预填充和解码成本合并为一个数字。
- Output Token 吞吐量 — 所有并发请求每秒生成的 Token。容量规划的主要吞吐量信号。
有关这些以及所有其他指标 AIPerf 报告的完整定义,请参阅指标参考。
全面了解。上述各项均以百分位细分 ( p25、p50、p75、p90、p95、p99) 与其最小值、最大值、平均值和标准差一起报告。这些故障很重要,因为它们可以突出显示长尾分布;具有正常的均值 TTFT 和异常值 p99 的服务器总体而言看起来不错,会在生产中失败。
超越核心四。借助 DCGM 或 pynvml,AIPerf 还可将 GPU 功耗、利用率和显存消耗提取到相同的运行输出中。将延迟峰值与内存压力事件关联起来不需要单独的分析会话,遥测已经存在。
更进一步:配置流量模式
现在,在静态基准测试中,我们可以开始探索更动态的内容。上一节提供了一个极其固定的流量模式,但实际推理流量并不遵循静态模式。要使用不太严格的场景进行基准测试,我们可以使用 AIPerf 的一些合成工作负载旋钮来为请求引入可变性。
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --request-rate 10 \
  --arrival-pattern poisson \
  --synthetic-input-tokens-mean 512 \
  --synthetic-input-tokens-stddev 128 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 32 \
  --random-seed 42 \
  --request-count 200
与上面的静态基准测试相比,有一些变化。
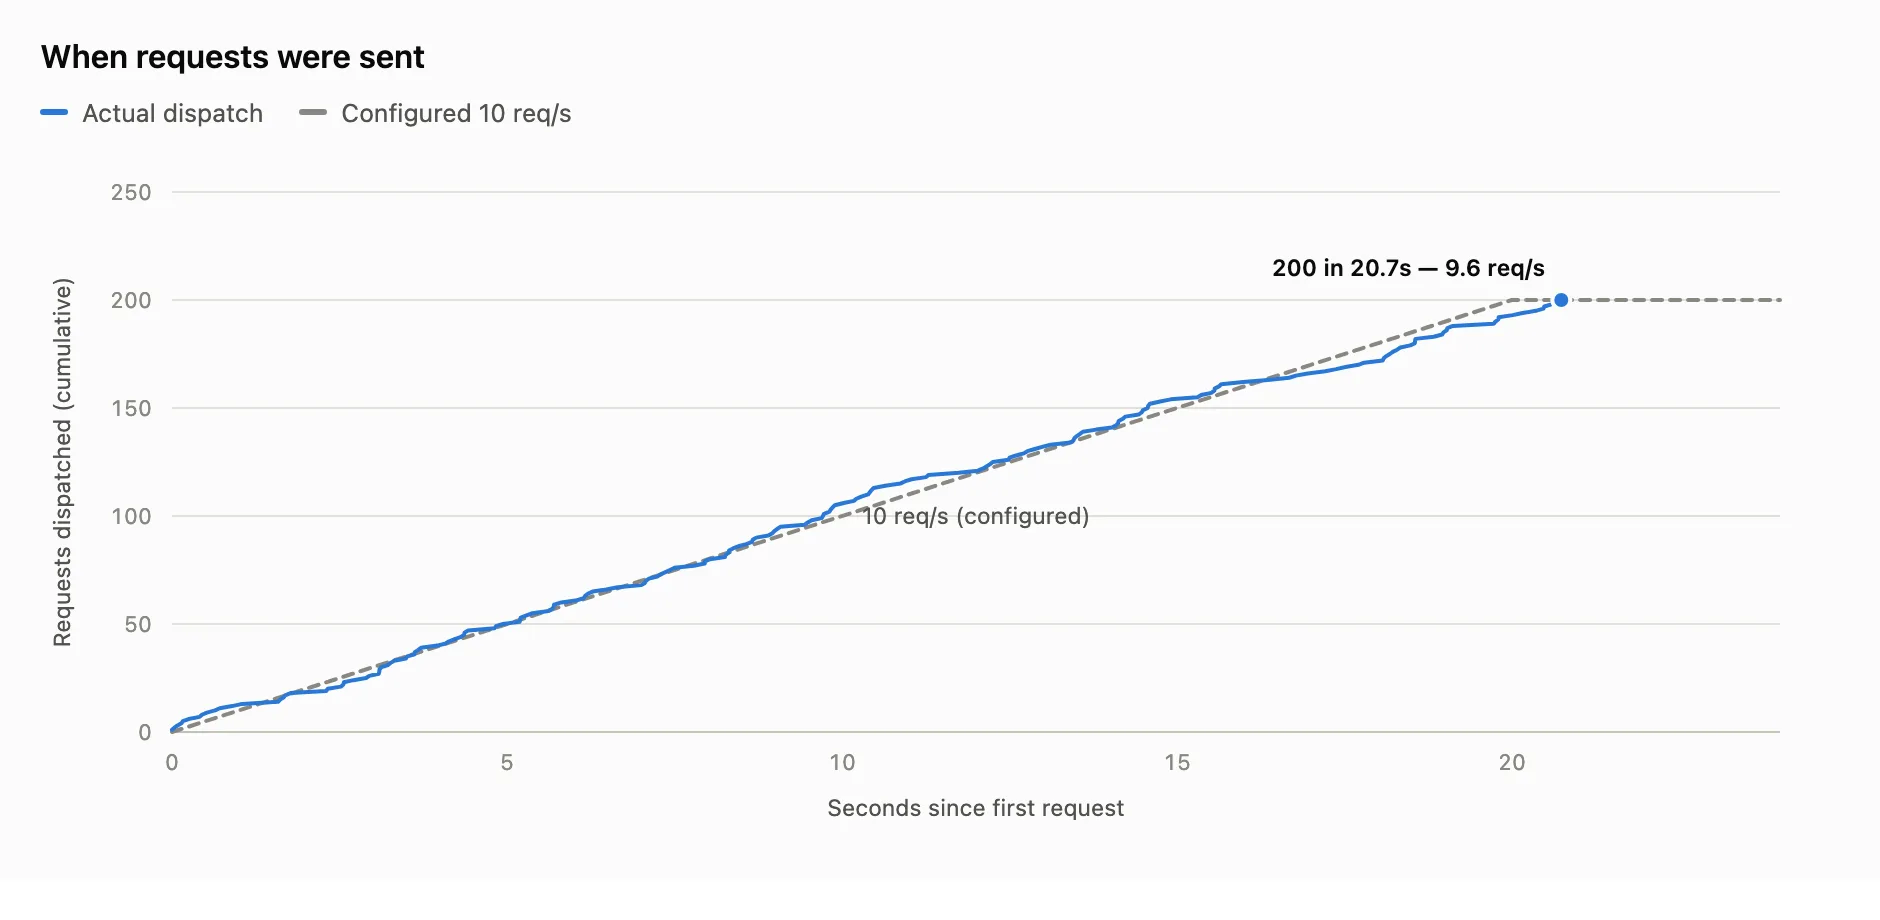
带有 --request-rate 10 的 --arrival-pattern poisson 意味着请求的平均到达速度为每秒 10 次,到达之间的时间是从指数分布中得出的。现在,服务器会遇到突发和缺口,而不是单个用户流,这就是在真实流量下排队的实际情况。
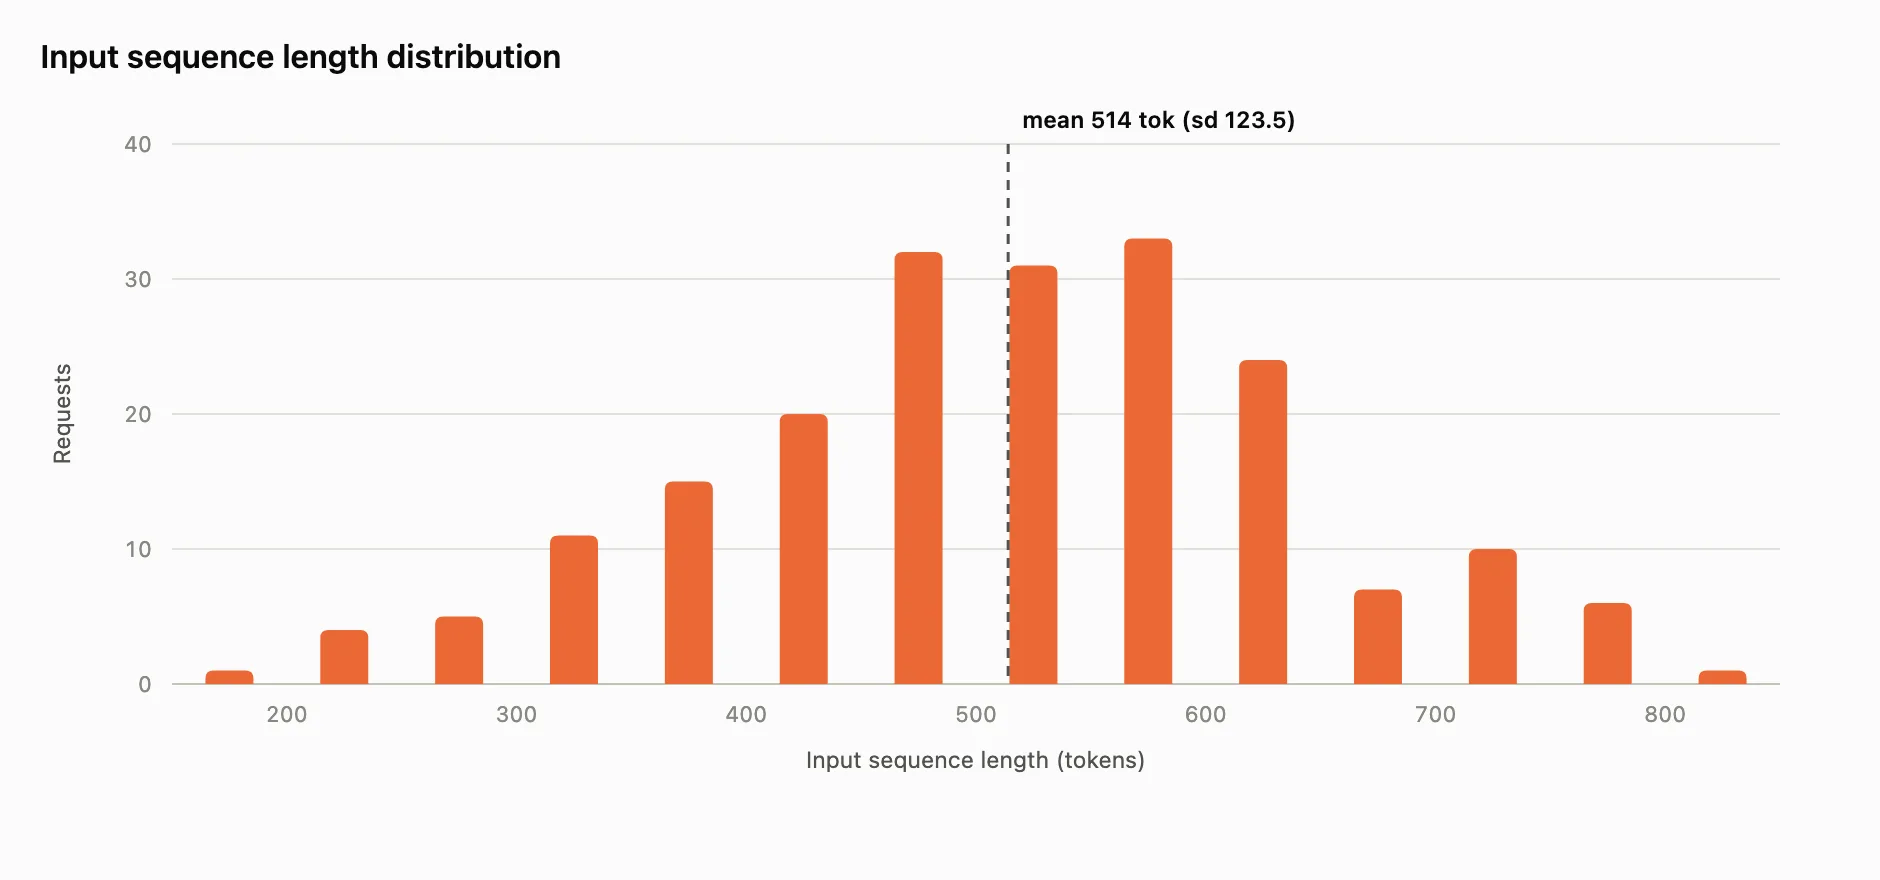
--synthetic-input-tokens-stddev 128 会在 512 个标记的均值周围引入方差,从而混合生成短提示词和长提示词。服务器必须在预填充期间处理可变的提示长度,而不是相同的长度。
--output-tokens-stddev 32 在输出端增加了方差。请注意,此命令中已不再包含 min_tokens 和 ignore_eos。在静态基准测试中,这些标记会将固定的输出精确标记为 128 个token,以保持基准的清晰度;我们会特意释放该约束条件,以便输出分布会有所不同。
--random-seed 42 可重现泊松计时和合成长度绘制。重新运行此命令会生成相同的请求序列。
--streaming 并非可选项。在不进行流式传输的情况下,服务器会在发送完整的响应之前对其进行批处理,而且无需测量初始或解码token事件。
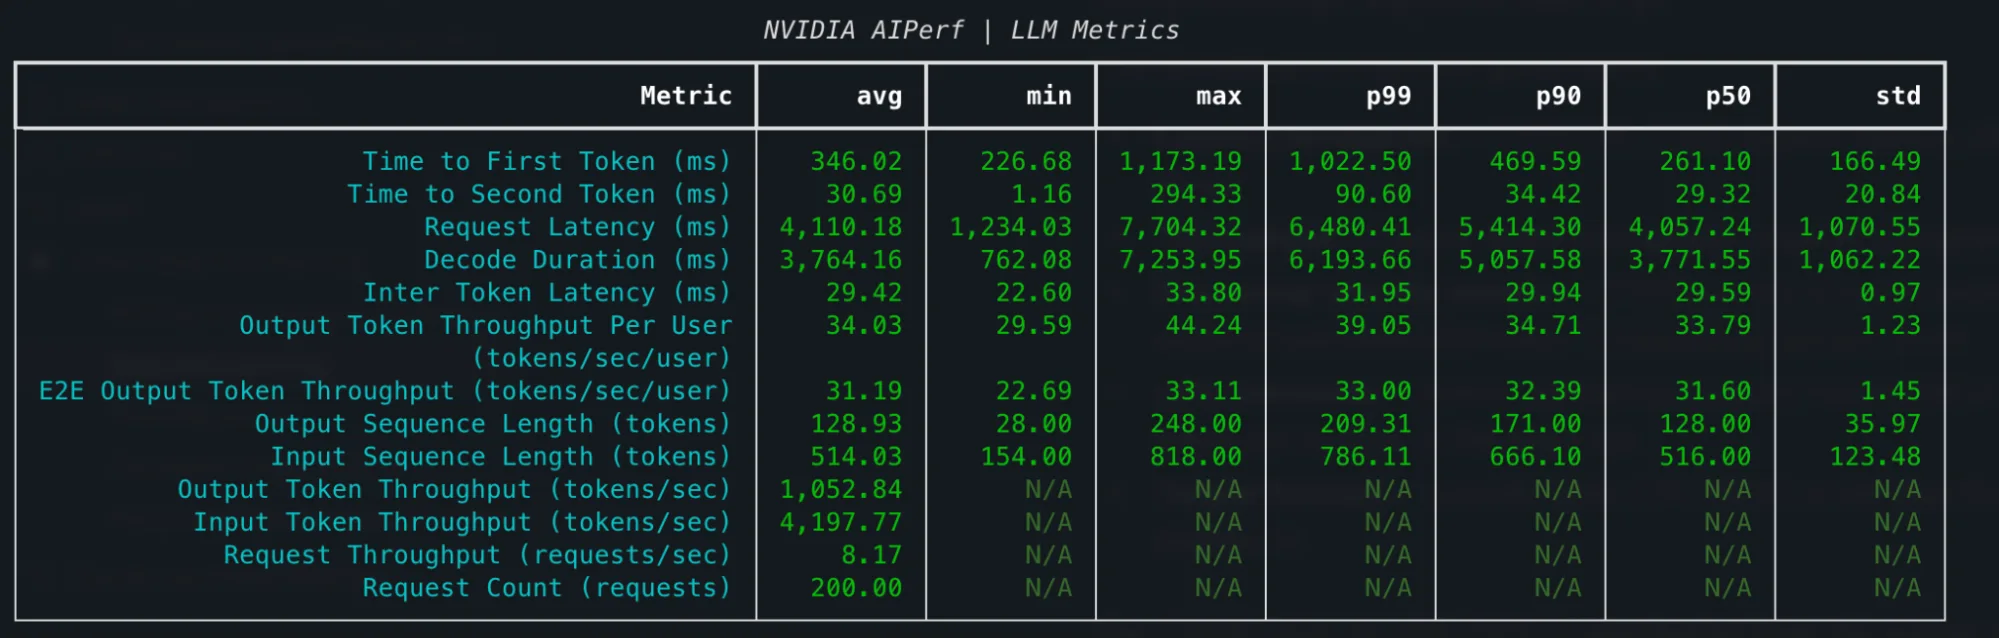
从本次运行的 LLM 指标来看,其分布明显比静态基准更宽,当更多请求同时争夺 GPU 访问权限且每个请求的预填充长度各不相同时,预计会出现这种情况。
在下方图 4 中的图表中,您可以看到泊松命令行引入了以 10 个请求/ 秒为中心但不完全匹配的请求速率。与保证每秒 10 个固定请求的常数模式相比,这种到达率可以模拟请求到达时的抖动。
您可以在下面的图 5 中看到,以 512 个token的均值为中心的请求长度存在差异,输入序列长度介于 254 至 818 个token之间。
通过比较两次运行之间的 TTFT,您可以看到泊松运行显示了更广泛的传播。越来越多的请求同时争夺 GPU 访问权限,预填充长度各不相同,预填充和解码操作重叠。单并发案例是一种理想的场景,一次运行一个请求,以牺牲吞吐量为代价,呈现尽可能低的 TTFT。
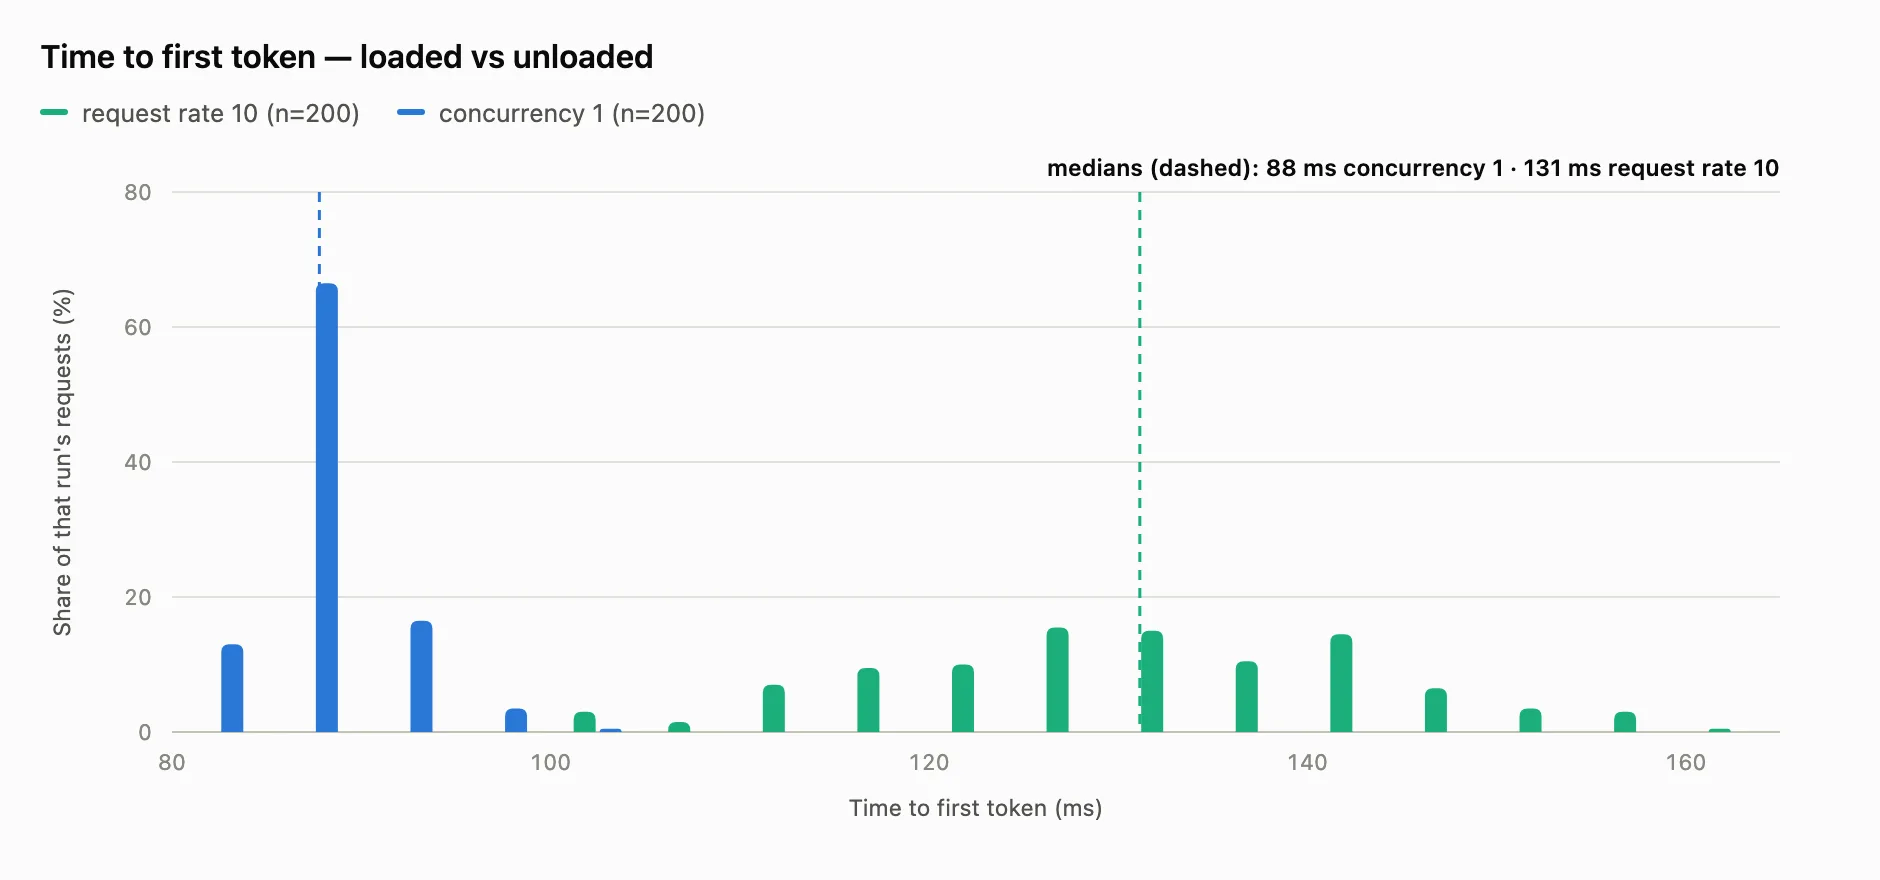
在上面的图 6 中,您可以看到,与泊松实验中变化更多的工作负载相比,单个用户运行时遇到的 TTFT 可变性较小。
还有更多内容值得探索
此演示涵盖了基础知识,但 AIPerf 也适用于更复杂的场景。
同一工具可处理多节点 Kubernetes 部署、KV 缓存重用预热机制、追踪生产流量回放、前缀合成、自定义数据集以及跨并发级别的扫描配置。
如果您正在大规模运行分布式推理,请参阅 NVIDIA Dynamo 1.0 如何为多节点信息提供支持
AIPerf 资源库中的教程是最快的方式。AIPerf 资源库和文档是新功能和贡献的标准参考。
致谢
AIPerf 是 NVIDIA 与外部贡献者之间的协作成果。感谢以下人员:Loki Ravi、Dan Ferguson 和 Sheng Moua (AWS) 在 AIPerf 上的持续协作、跨公司验证和标准化工作;Aaron Batilo (Coreweave) 用于 Weights& Biases 导出工具、接受长度规格解码数据集以及在并发下强化扫描/ 信用分配可靠性;Shounak Ray (Baseten) 用于忠实的 Baseten 追踪回放Cristian Lopez ( Pinterest) ,感谢他在 DAG 基准测试方法上的密切合作。我们非常感谢 Ben Hamm 在我们设计、规划和实施 AIPerf 时提供的产品指导。


