

功率是 AI 工厂 的决定性限制。由于 AI 工作负载需要一个完整的计算平台来为其提供服务,该平台的每个组件都必须在工厂有限的功耗预算内更大限度地提高输出。这使得每瓦性能 (而不是未经规范的原始吞吐量) 成为衡量 AI 平台价值的终极标准。
NVIDIA Vera Rubin 平台旨在大规模实现节能高效的 AI。其核心是 NVIDIA Vera Rubin NVL72,可在最广泛的 AI 计算需求 (从吞吐量优化的大批量到小批量的高交互性层,无论是开放模型还是封闭模型) 中提供强大的每瓦性能。
工厂级和机架级电源管理创新在这一重要指标上推动了 Vera Rubin 的性能提升。在工厂层面,NVIDIA DSX MaxLPS 软件可随着工作负载需求的变化在机架之间转移功率,使操作员能够恢复闲置功率,并在相同的现场功率范围内提供多达 40% 的 GPU,并将 token 吞吐量提高 35%。
在每个 Vera Rubin NVL72 中,机架级电容器以及先进的智能功耗平滑软件可以吸收训练和推理工作负载的突发功率峰值,因此可以围绕持续需求而不是最差情况峰值来规划工厂。这意味着每兆瓦的可部署计算能力更高。
交互性较高的层级带来了独特的挑战。为此,该平台增加了 NVIDIA Groq 3 LPX 作为低延迟加速器。本文将介绍单个 LPX 机架中的创新 (包括其确定性执行模型) ,这些创新使其成为 Vera Rubin 平台的节能贡献者。
NVIDIA Groq 3 LPX 机架采用哪些节能技术?
借助 Groq 3 LPX 确定性执行模型,LPU 编译器可以创建一个计划,精确地将每个数据移动到哪个特定的计算单元,以及该操作执行的精确时间,一直到时钟周期。它扩展到机架中的所有 256 个 LPU 芯片,在长上下文和电源管理技术 (利用这种确定性) 下实现超快的交互性。
在 LPU 编译器生成工作负载执行计划后,它可以预测该计划中每个周期的电流消耗。这反过来又实现了两项互补技术:
- 抢占式供电 (PEP):使供电系统在供电需求变化到来之前做好准备
- 时钟周期合成 (CPS):塑造需求的突然上涨和下降
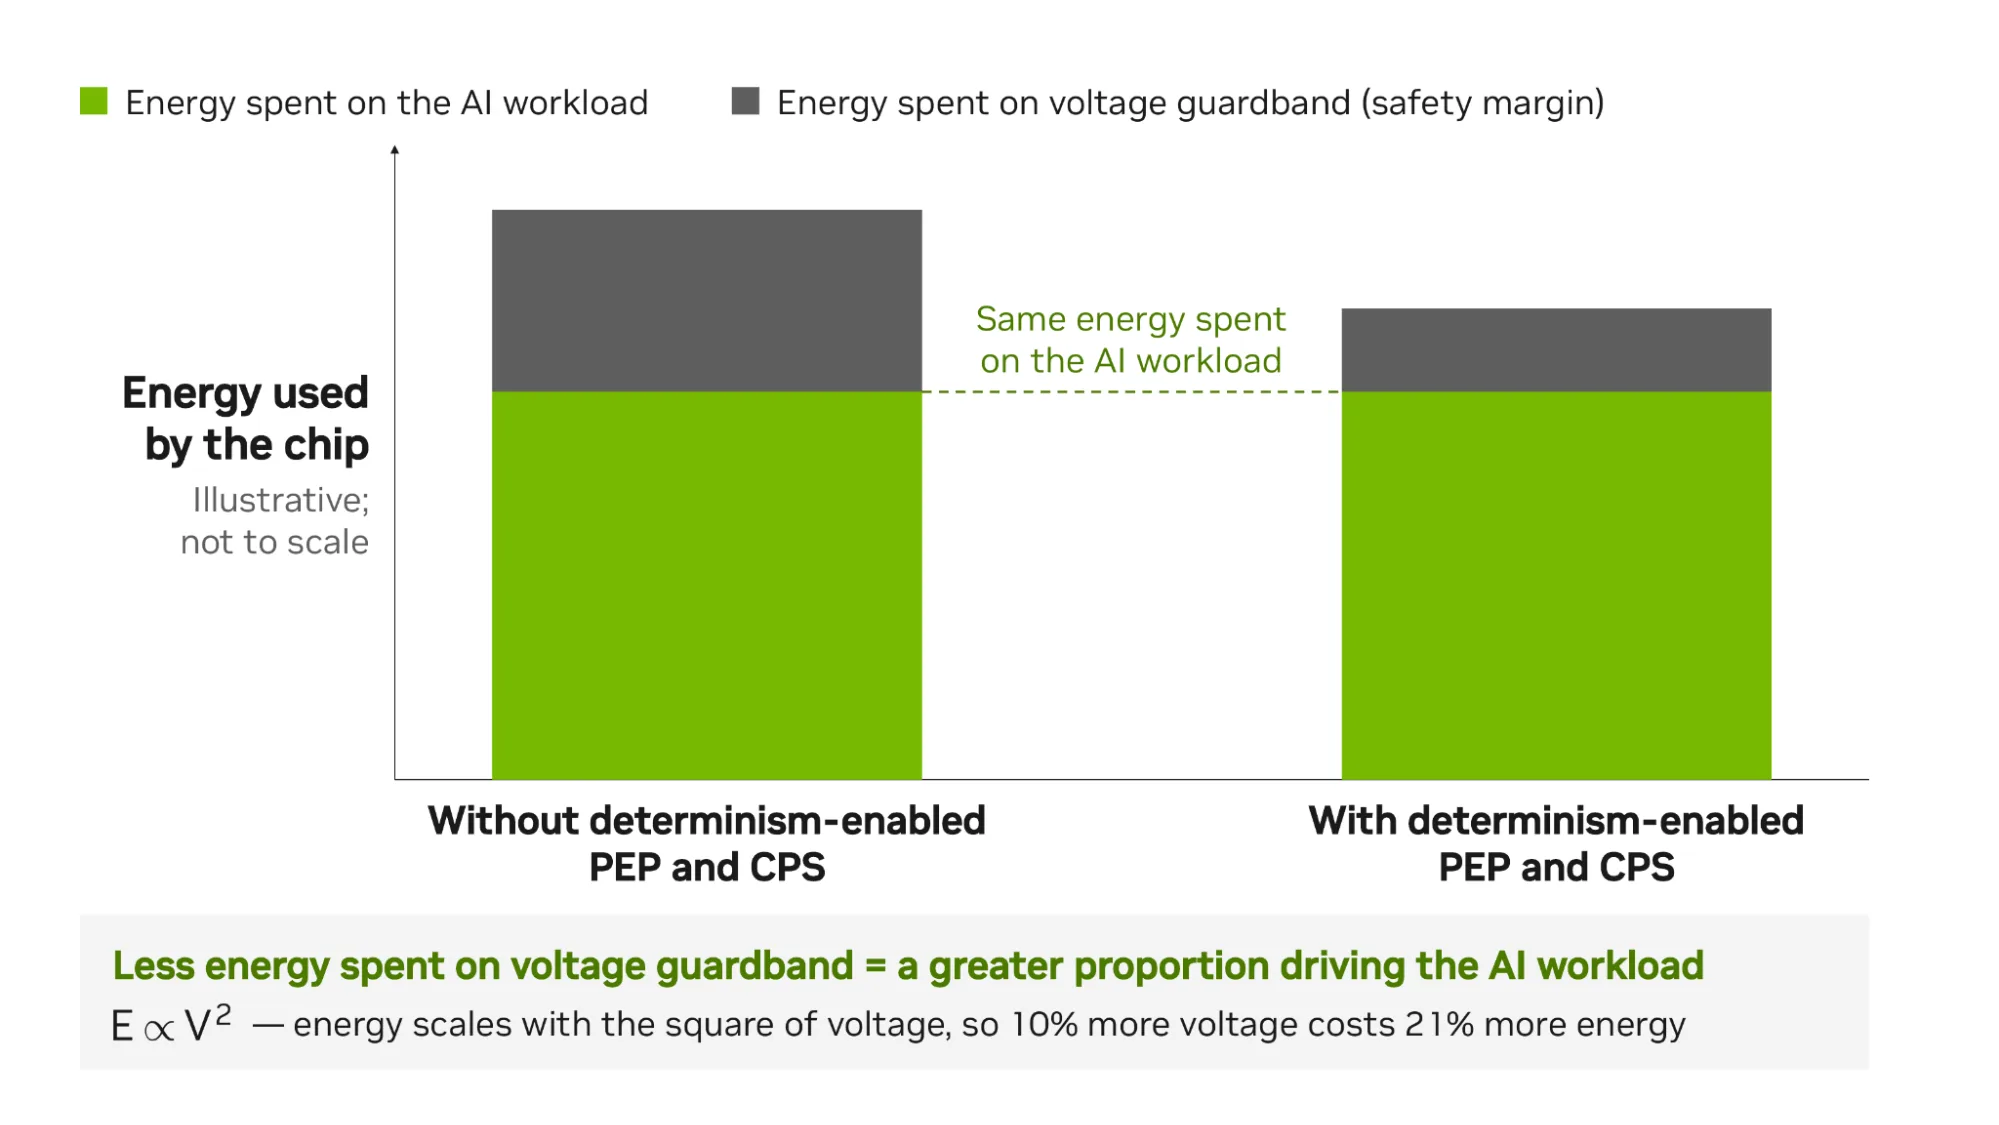
PEP 和 CPS 共同帮助减少了必须持续提供给任何一组芯片的“电压护带”或“电气安全边界”,尽管这些芯片不能直接为 AI 工作负载供电。降低此电压保护带意味着可以将更大比例的稀缺电力用于工作负载。
在需要时准确地为 AI 工作负载提供电力时,存在哪些挑战?
为了运行 AI 工作负载,芯片执行一系列指令,从简单的数据重塑到复杂的功耗密集型矩阵乘法,不一而足。几乎所有芯片都包含硬件功能,当工作负载运行时,当资源可用时,可在这些大量操作之间进行动态切换。这种灵活性意味着可以随时调度执行计算密集型操作。为芯片提供电流的系统必须能够处理此问题。
矩阵乘法和向量乘法使得 AI 工作负载在短时间内涉及大量晶体管切换,这增加了纳秒级芯片的当前需求。该芯片从最接近的可用源 (即位于芯片旁边的电容器,称为解电容器 (或解电容器)) 中获取额外的电流。放电会降低芯片的电压。
芯片的主板确实有一个电压调节器,这是一种专用电路,其任务是将芯片的电源电压固定在设定的目标上,但由于电感的原因,它无法立即响应,因为电感可以阻止其提供的电流快速上升。,尽管如此,电压调节器提供的电流最终会满足芯片的需求,使电压得以恢复。
这些暂时的电压下降最终由 AI 工作负载当前需求的急剧变化驱动,称为电压下降。其大小取决于电流的变化程度,以及电流的变化率 Di/dt。所有其他条件相同,较大的 Di/dt 会导致更大的电压下降;相反,在更长的时间内相同的绝对电流变化将导致更低的 Di/dt,从而减少电压下降。这些下垂通常不成问题。但是,所有芯片都有最低电压 (Vmin) ,低于该电压时,芯片将停止正常工作,从而导致错误的结果。
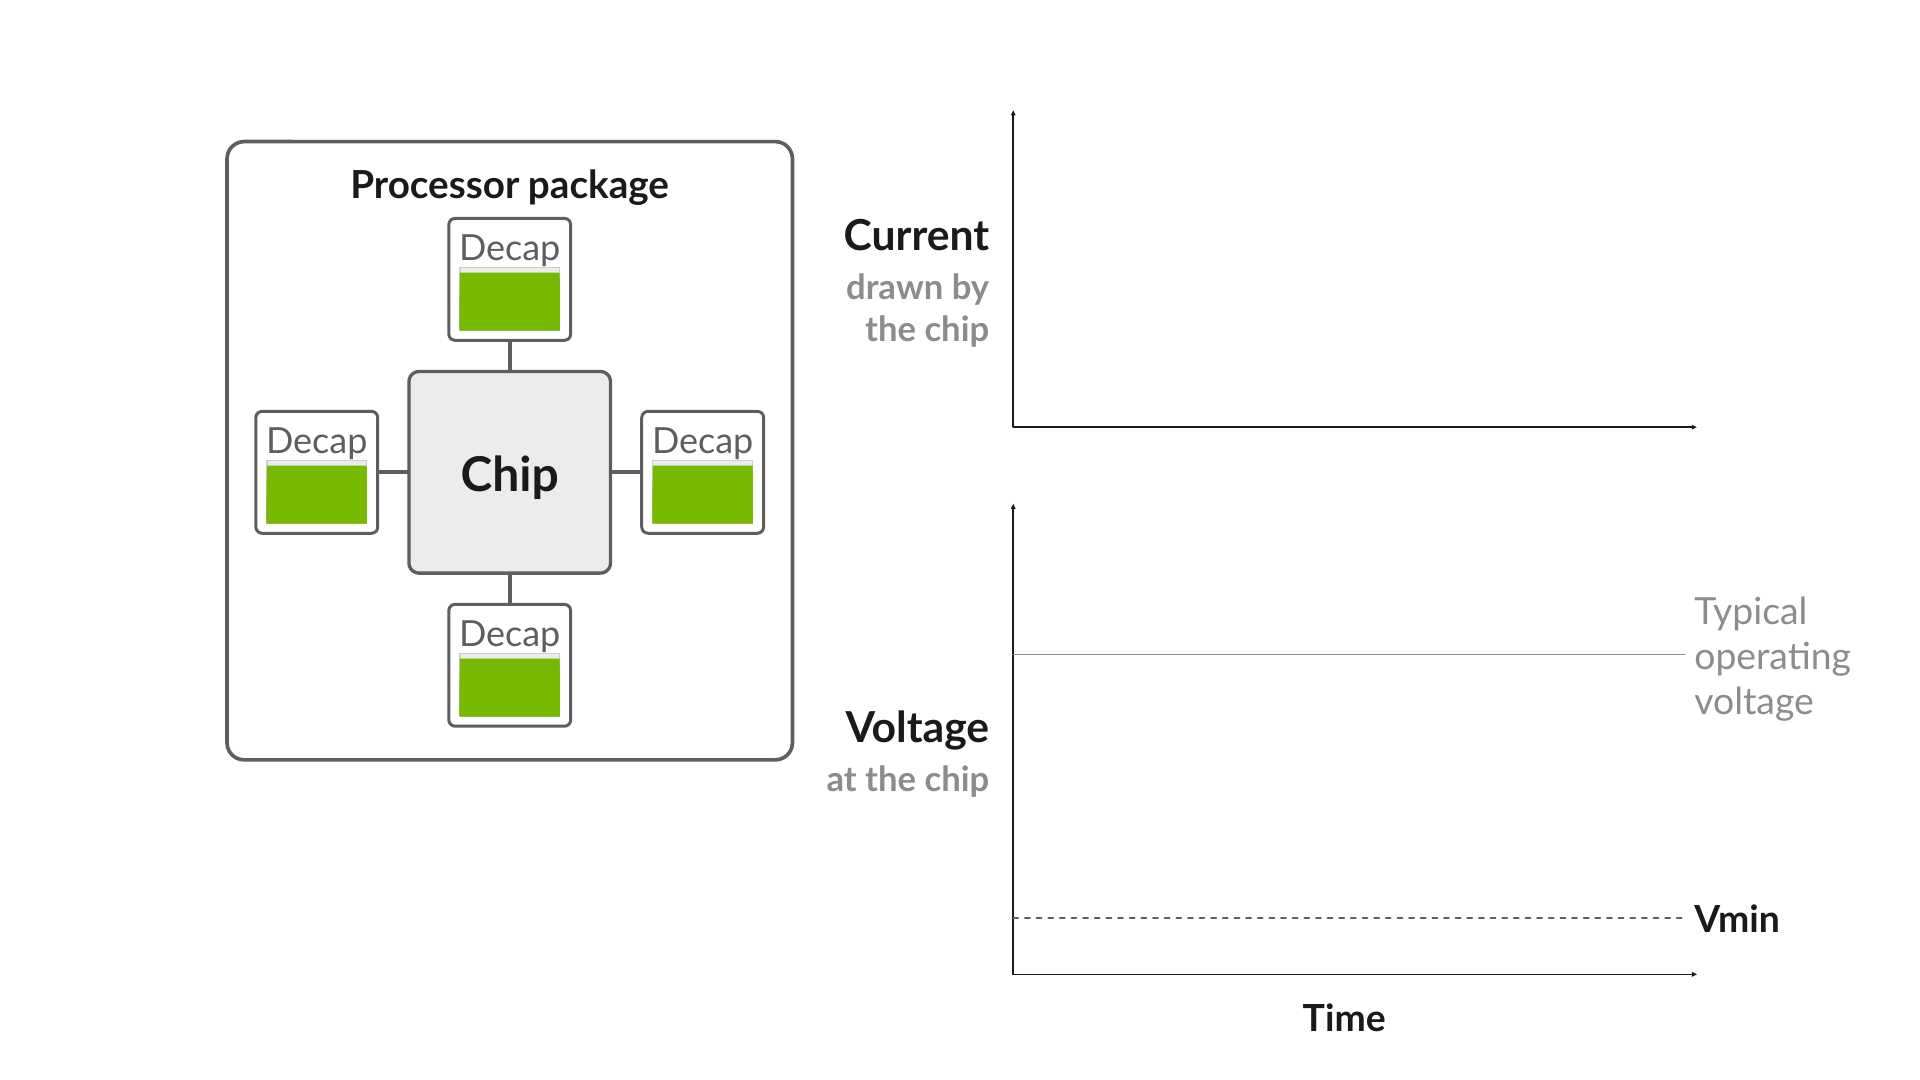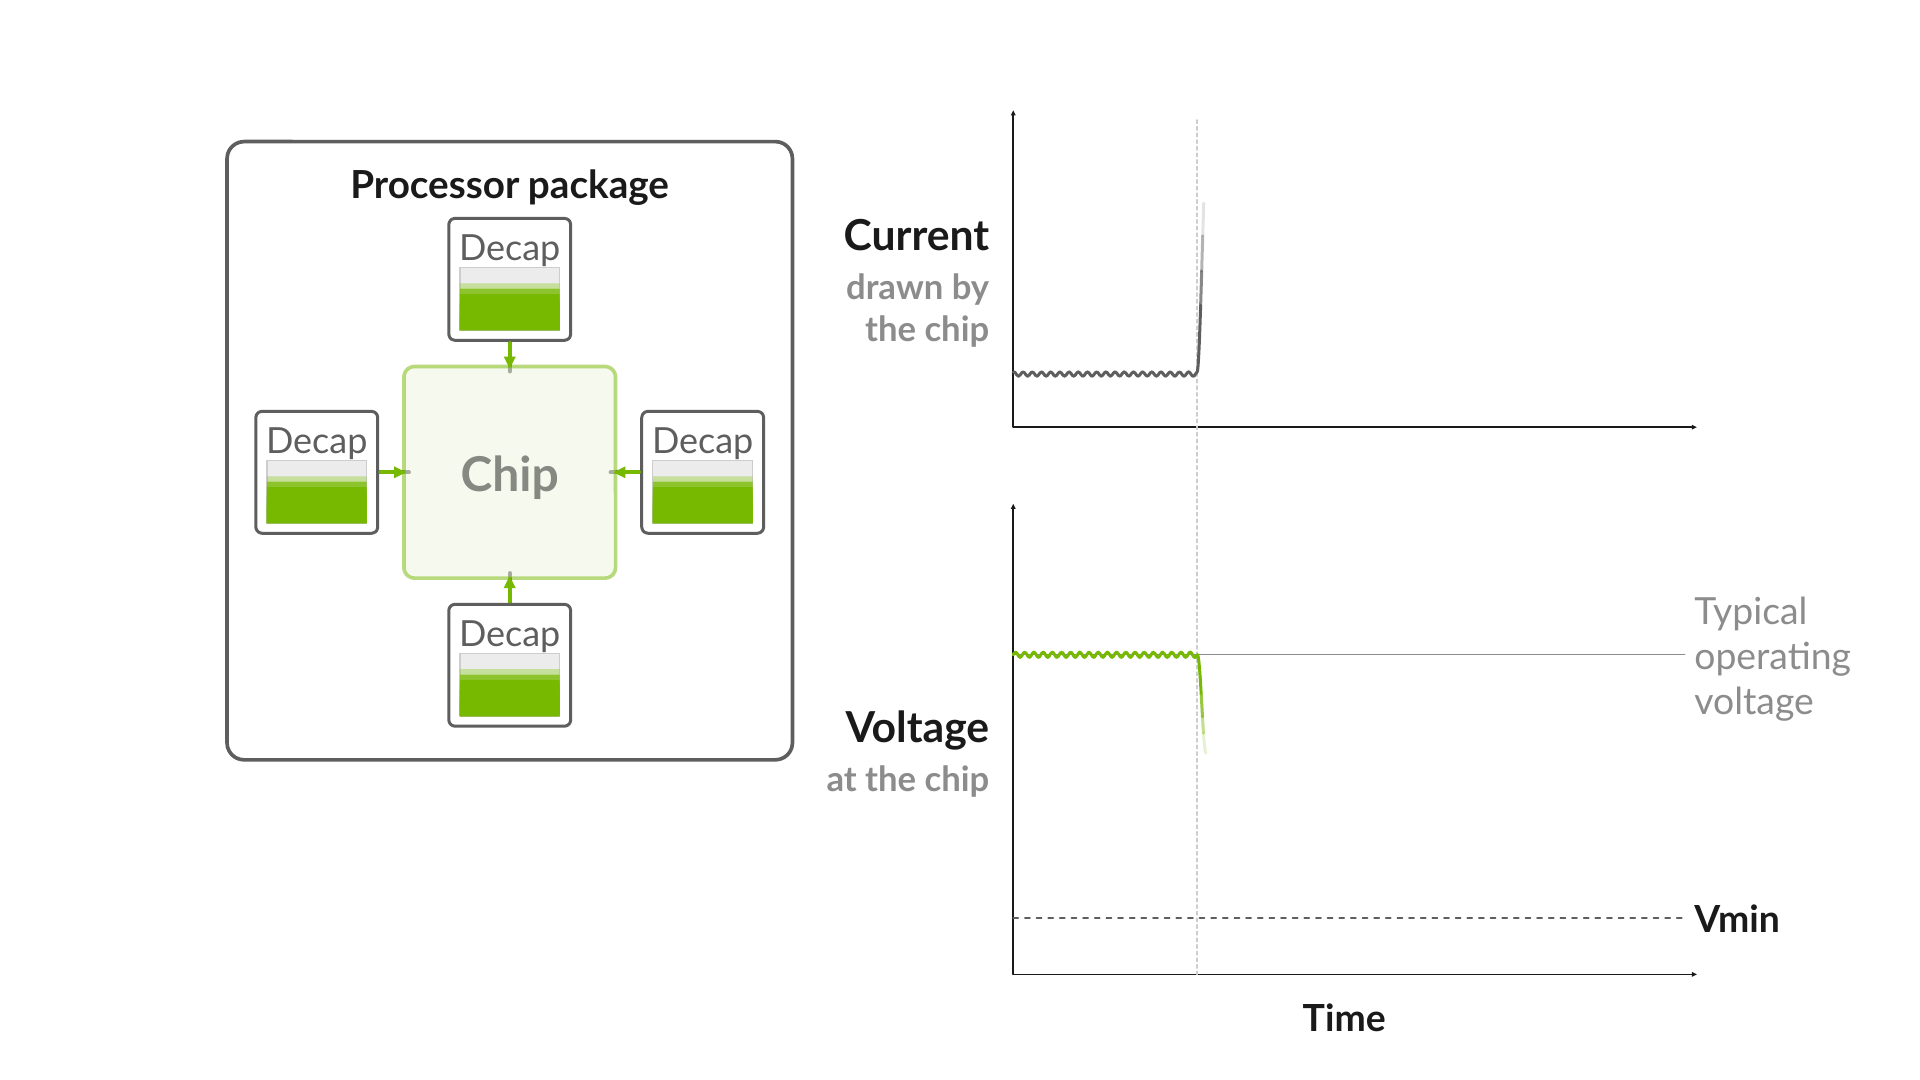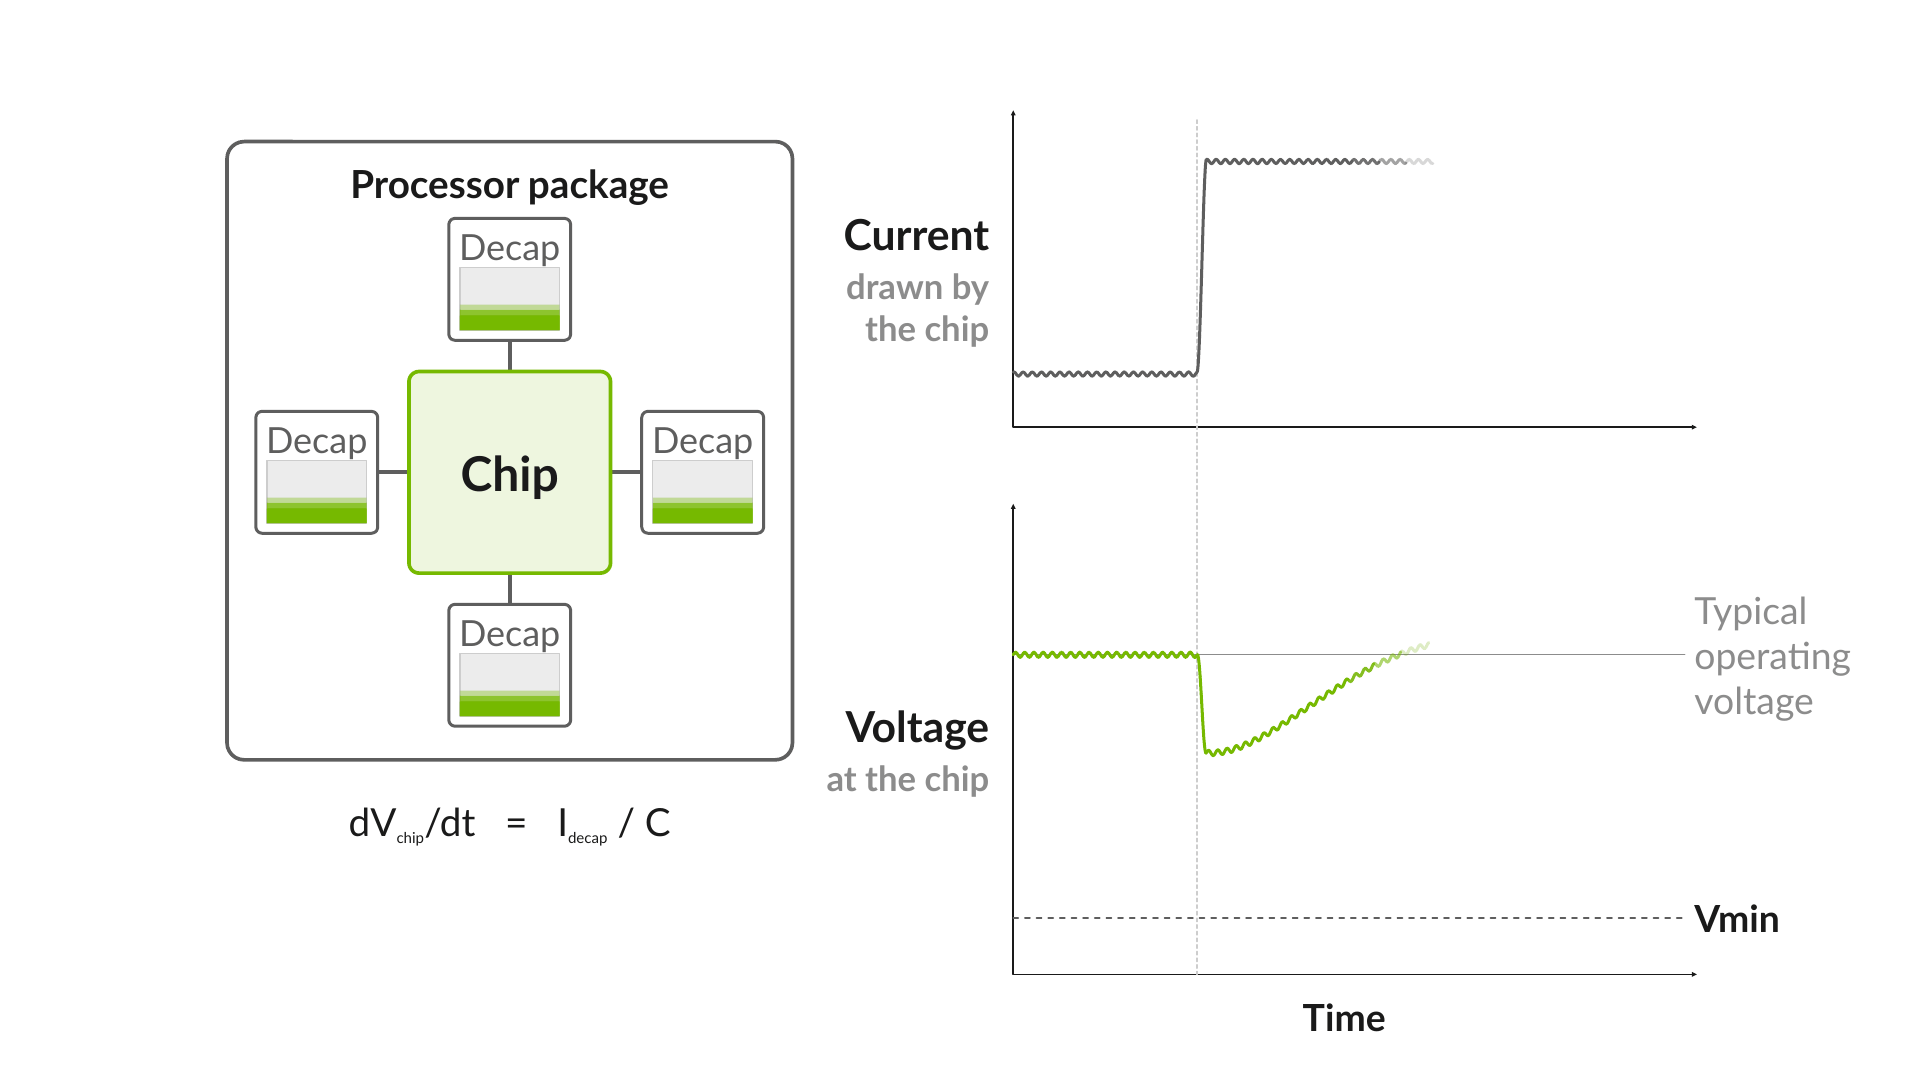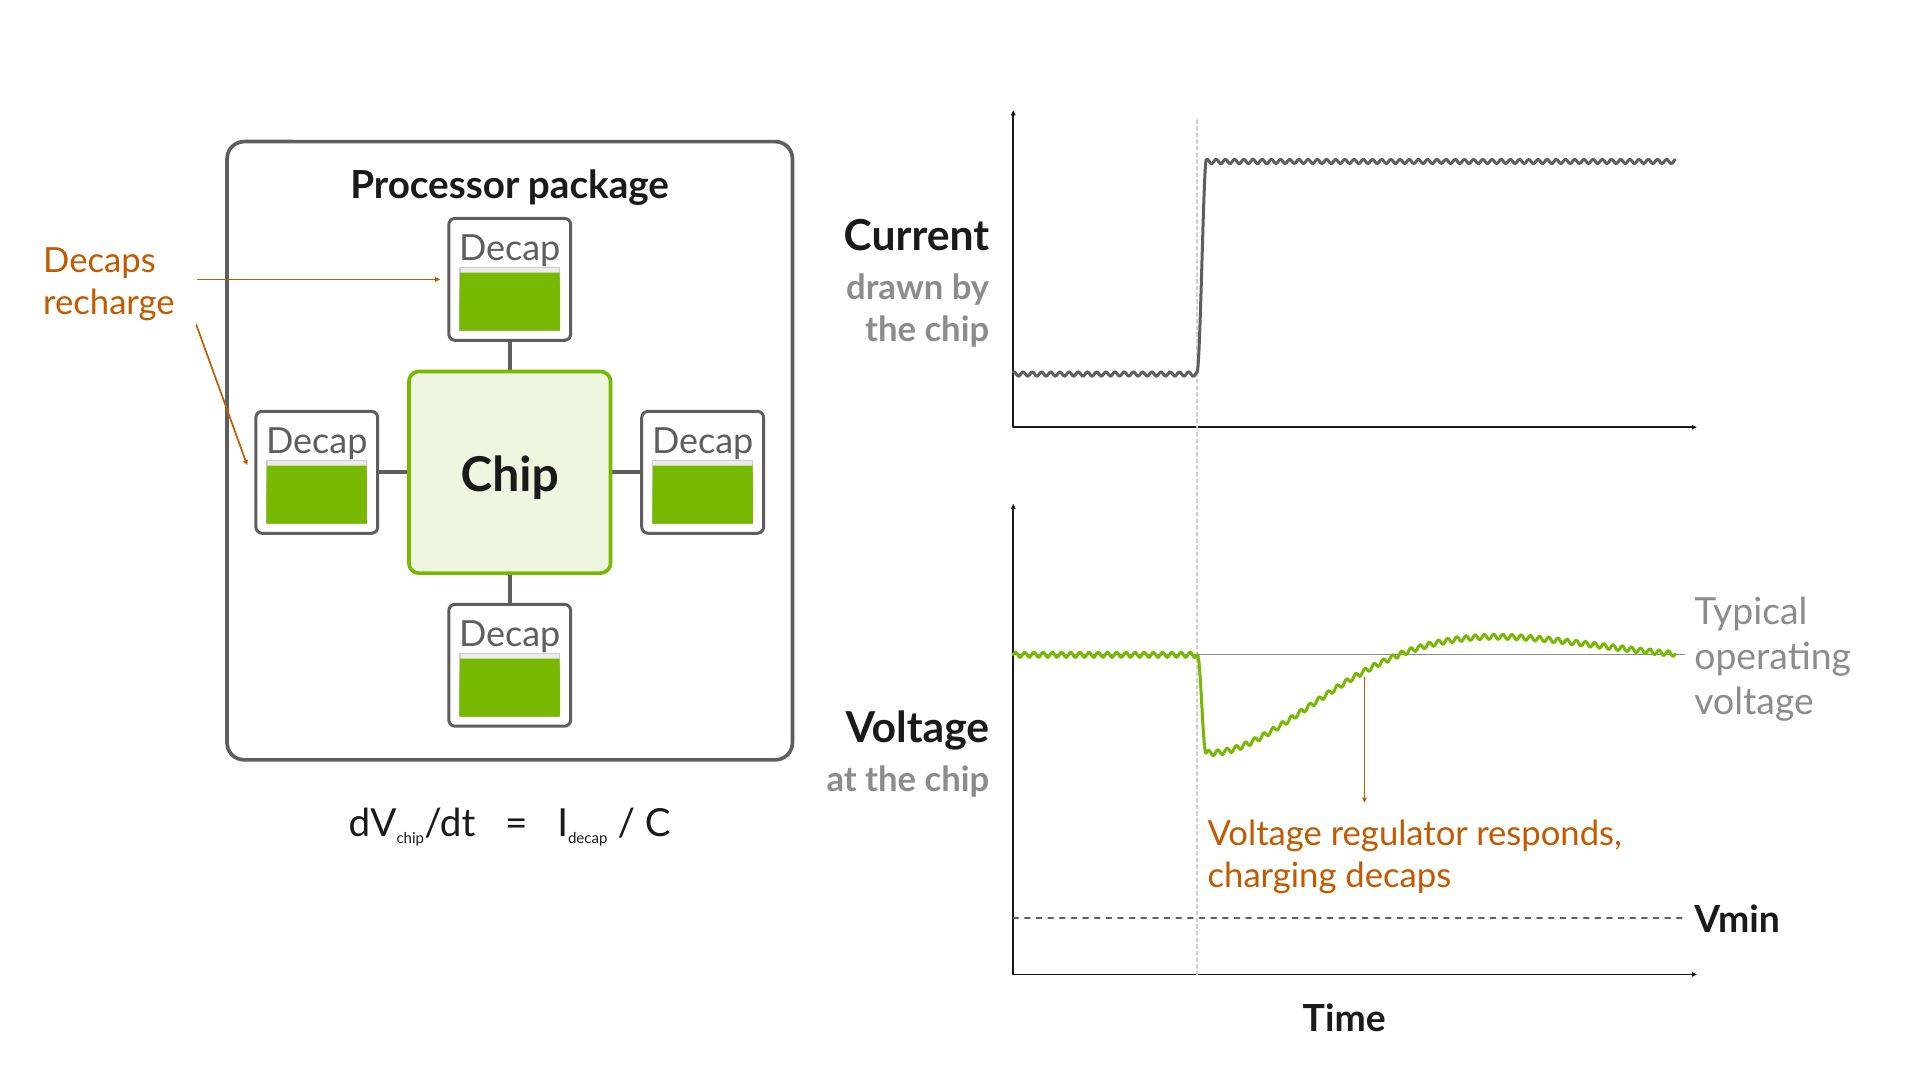
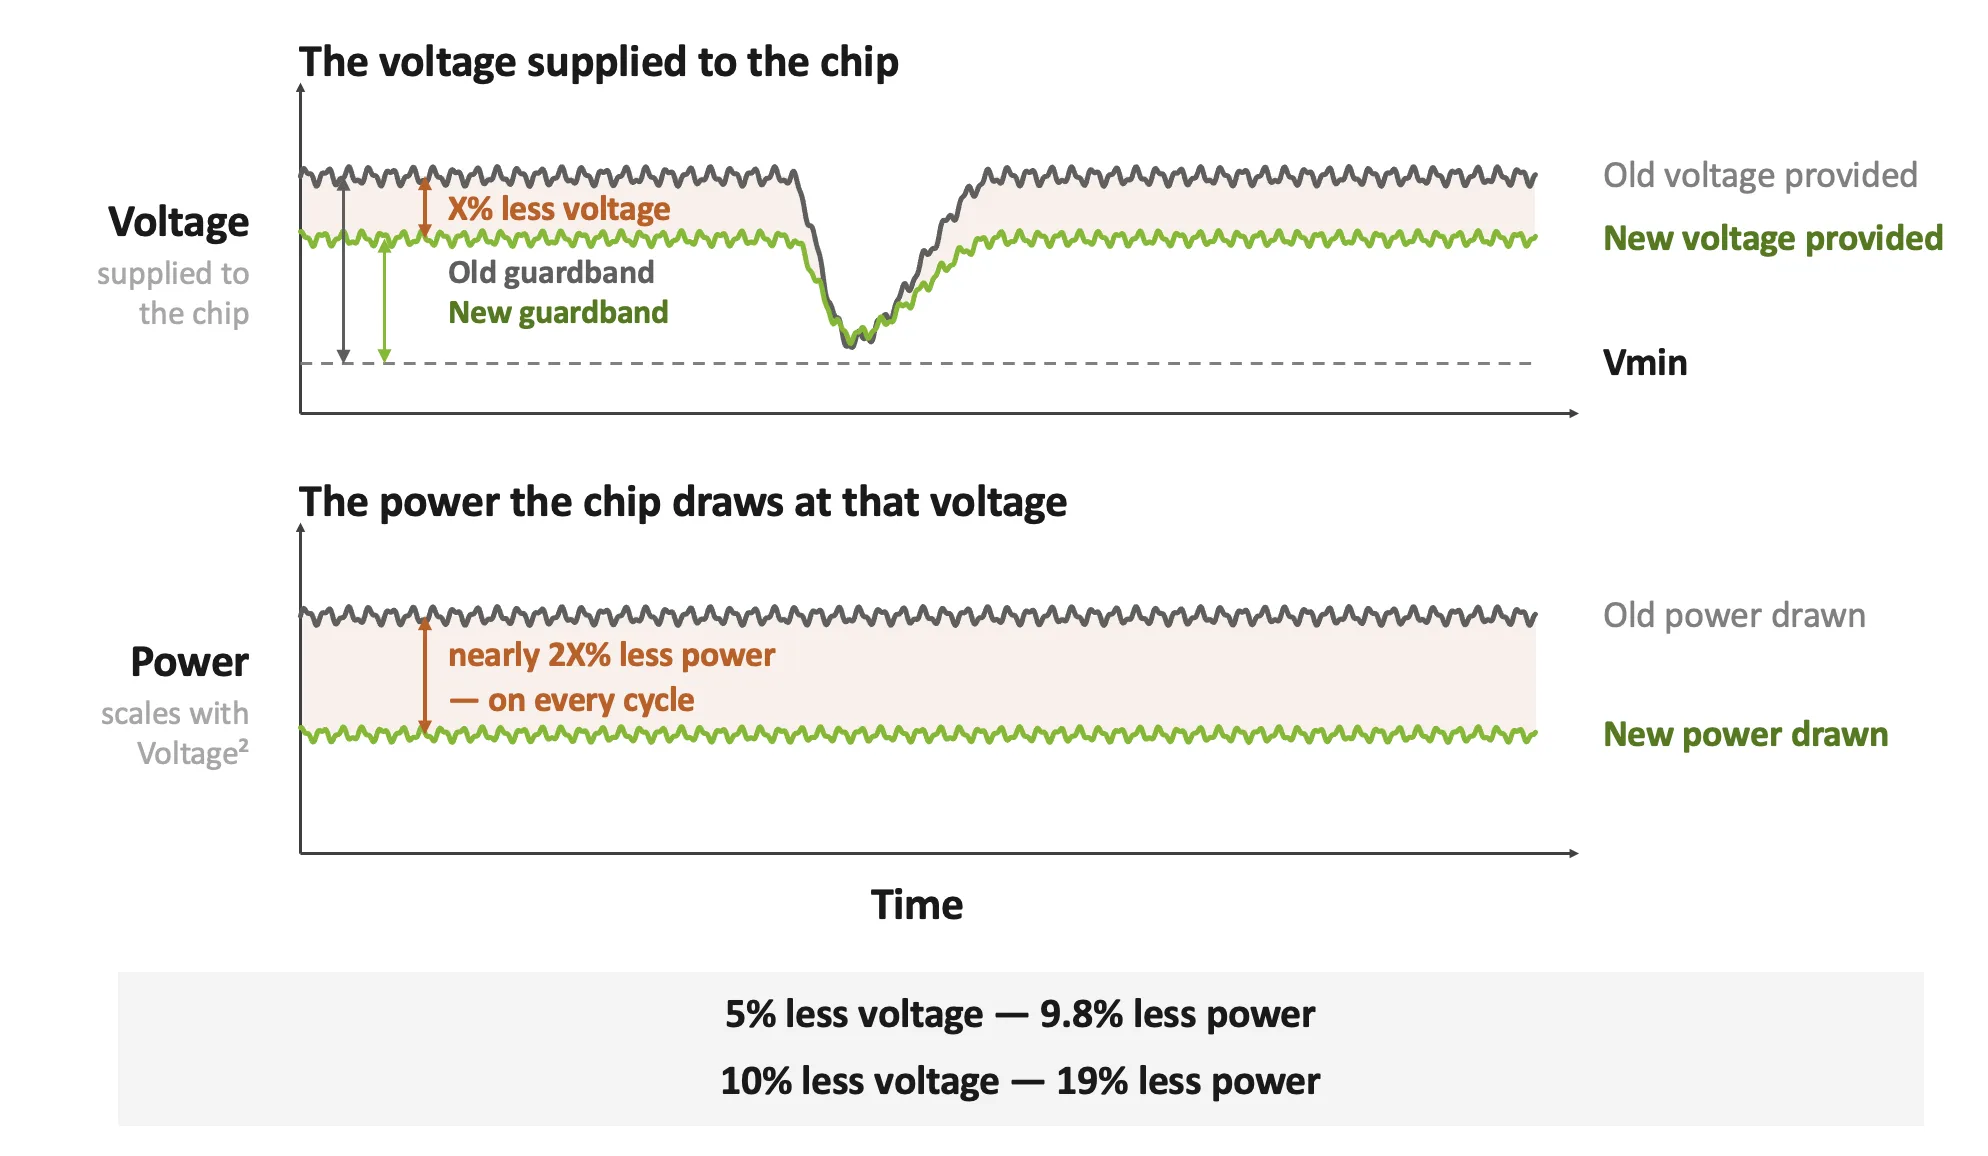
为了降低发生这种最坏情况的可能性,芯片采用了电压保护带,提供了足够的电源电压余量,使芯片在瞬态和最坏情况下仍能接收到所需的最低电压。大多数情况下,提供此防护带所需的功率实际上是多余的。此外,功率与电压平方成正比,因此持续供电的电压增加 10%,功率增加 21%。
NVIDIA Groq 3 LPX 周期精确调度如何使当前需求变得可预测?
Groq 3 LPX 确定性执行模型允许在开始工作负载之前,针对 AI 工作负载的运行方式 (包括操作和数据移动) 创建计划。单个 LPU 加速器具有相对较少的不同硬件元素,每个元素都可以可预测地快速执行最常见的操作:
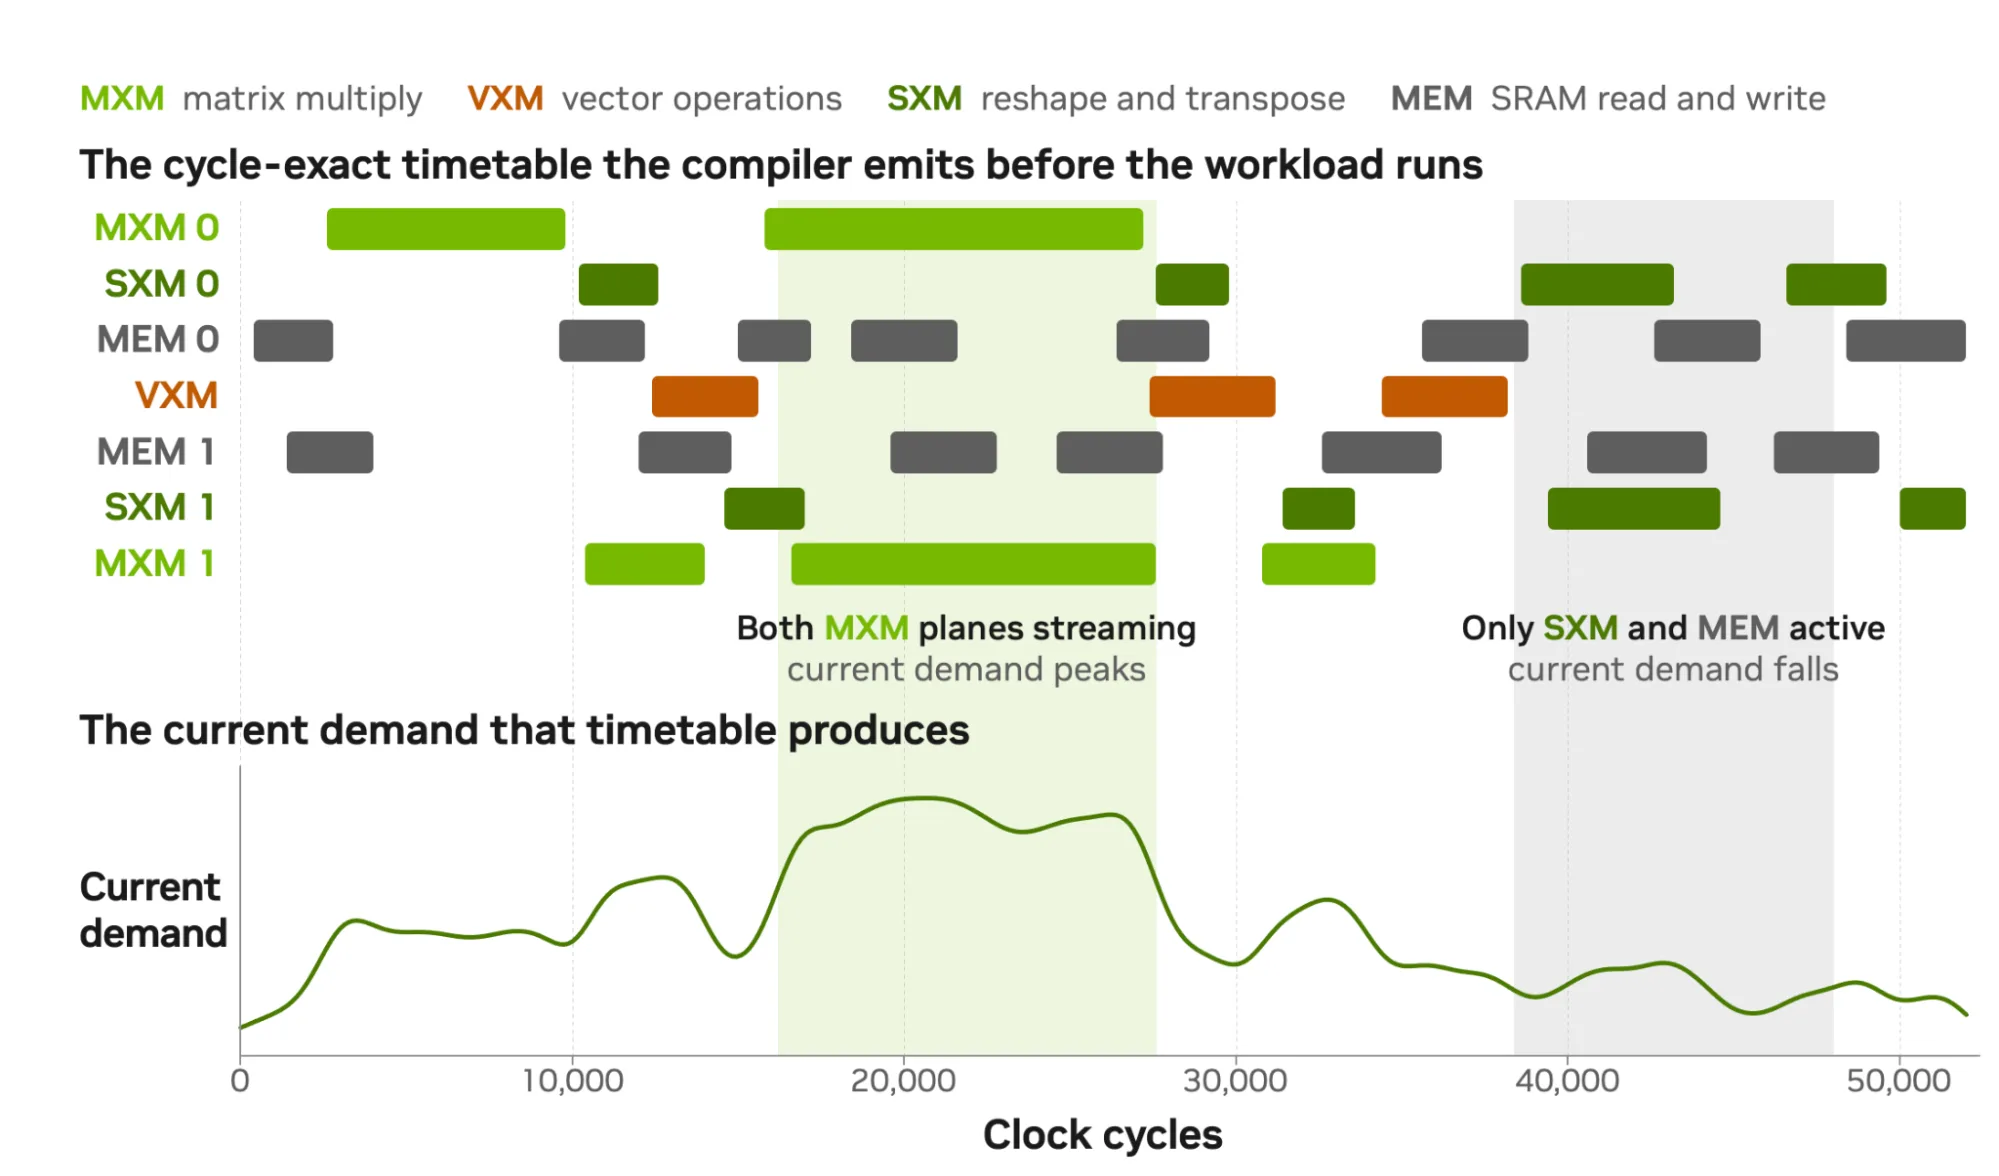
- 用于矩阵乘法的 MXM
- 用于向量运算的 VXM
- 用于转置和重塑的 SXM
单个加速器还配备硬件,可将这些计算单元保持同步,直至时钟周期。对于内存,每个芯片都具有无层次结构的片内 SRAM 存储库。在 LPX 系统层面,LPU 之间直接连接,而不是通过中间媒介,因此数据传输时间更可预测。
确定性将这些不同的硬件元素联系在一起:单个计算、内存读取和芯片间通信从运行到运行都需要相同数量的时钟周期。编译器可以利用这一点来规划数据何时需要在这些计算元素之间移动的计划,并在需要时到达需要的位置。这种计算和数据移动调度还允许编译器提前解决常见的资源冲突,例如两个硬件元素写入同一内存库。
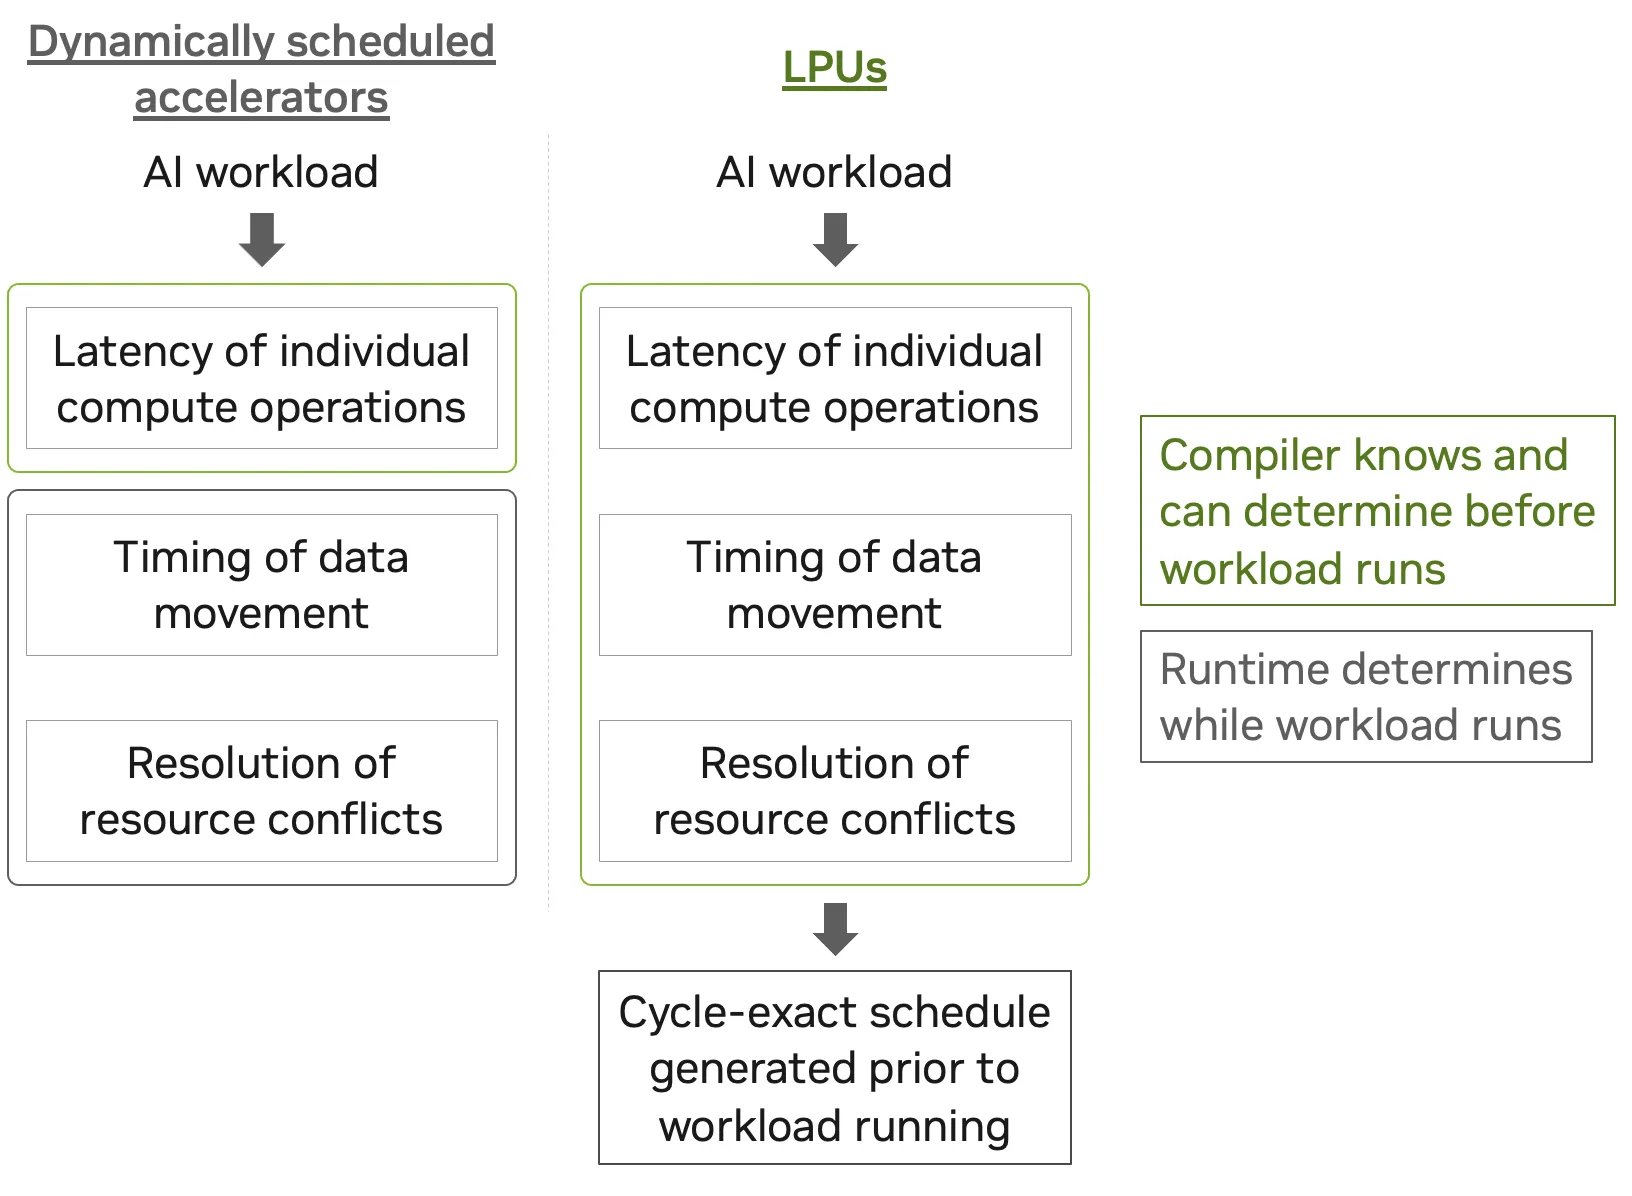
这种周期精确的调度还允许创建工作负载的当前需求随时间变化。编译器可以在时钟周期级别估算系统将消耗的电流。
执行模型如何实现主动电压和时钟控制?
周期精确调度和由此产生的电流需求曲线使 Groq 3 LPX 能够减少电压下降,并使用较小的电压保护带运行。由于编译器知道当前需求何时会上升和下降,一直到时钟周期,因此它可以提前为供电系统做好准备,并通过互补的 PEP 和 CPS 技术塑造需求的最大变化。
- PEP 是一种机制,通过该机制,芯片可以控制供电网络 (PDN) (即向 LPU 供电的物理电子设备) 来改变供电电压。由于编译器知道哪种循环电流会出现峰值,因此它可以尽早安排该命令,以便在需求到来之前提供的电压已经在移动。因此,解电容器可弥补的空隙较小,而当电流升高时,芯片的电压下降幅度也会减小。
- CPS 使编译器能够在要缩短或延长的工作负载中调度单个时钟周期。只有借助 Groq 3 LPX 同步时钟系统,才能实现逐周期调度,该系统可保持芯片和计算元素之间的时钟同步。与 PEP 相比,它可以对最大的电流变化进行更精细的控制。特别是,具有最高峰值电流的时钟周期可以延长,从而降低 Di/dt,即电流增加的速率。
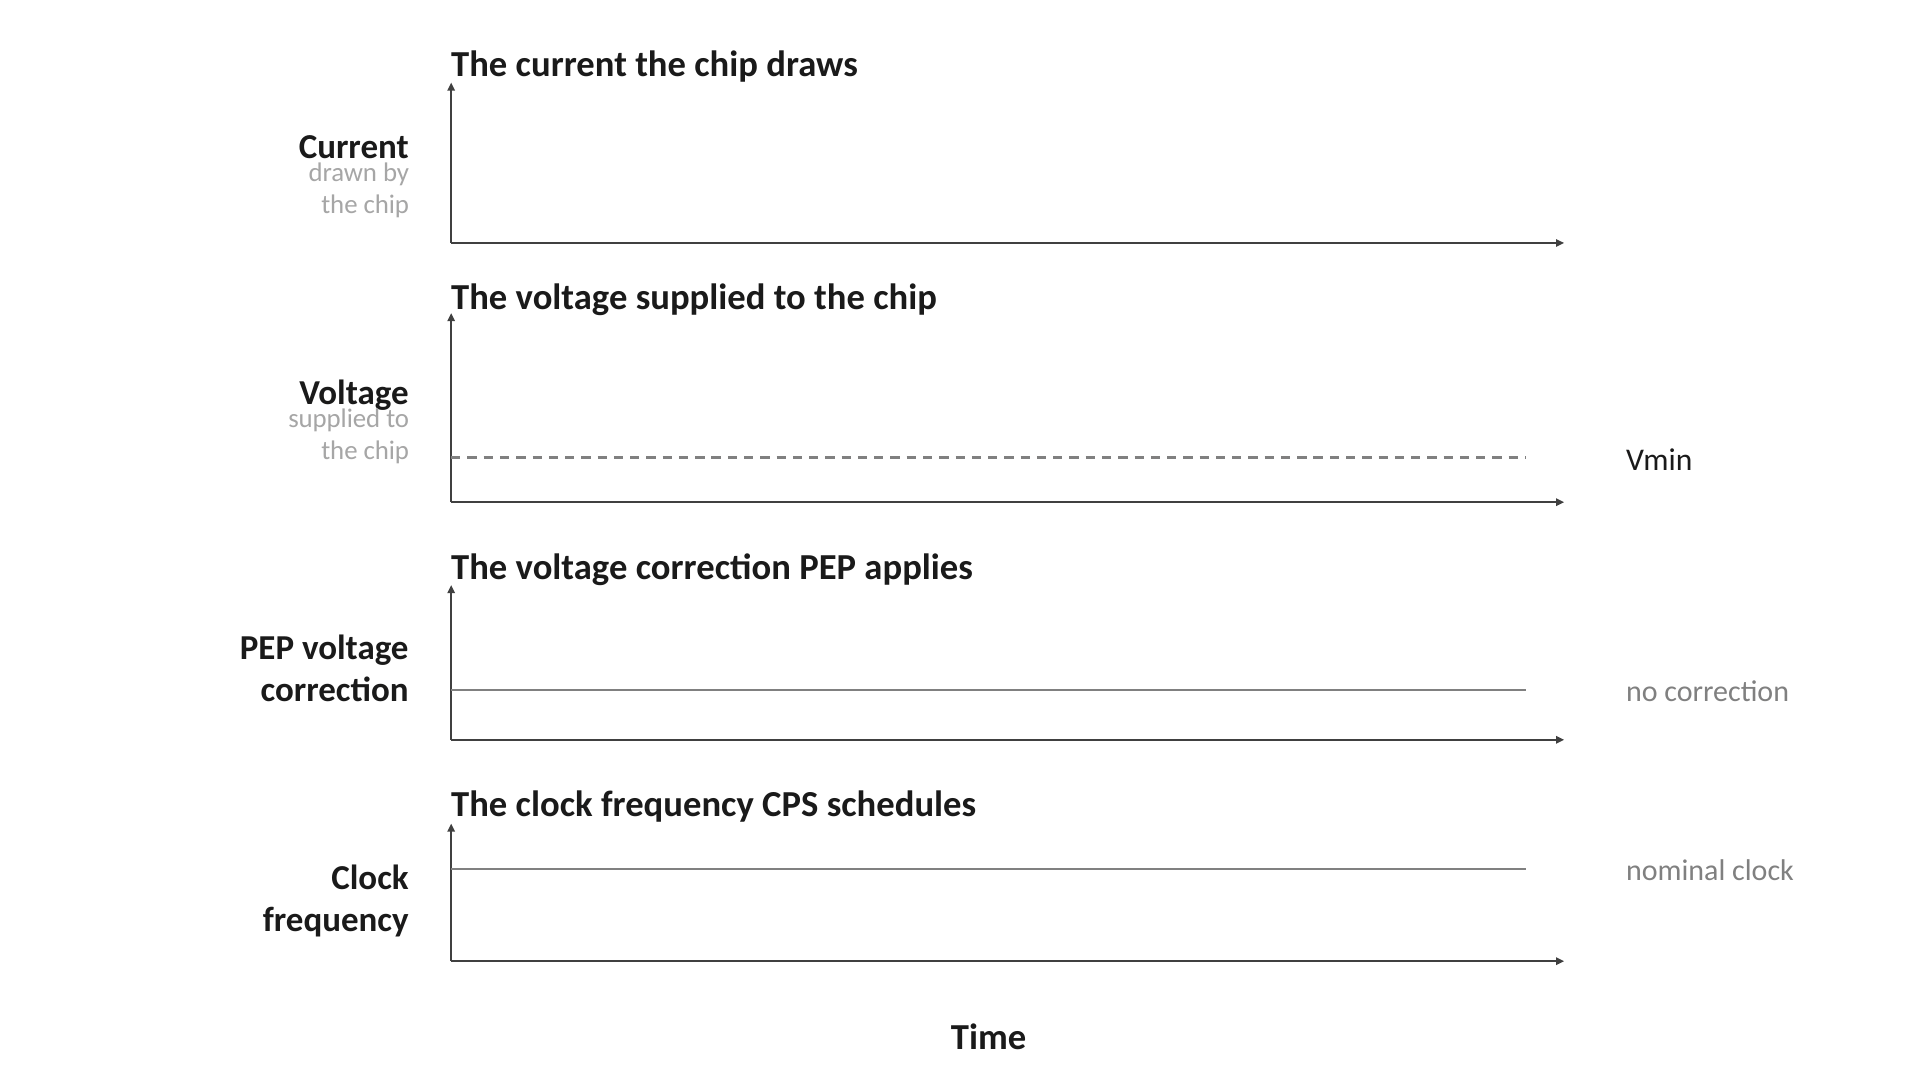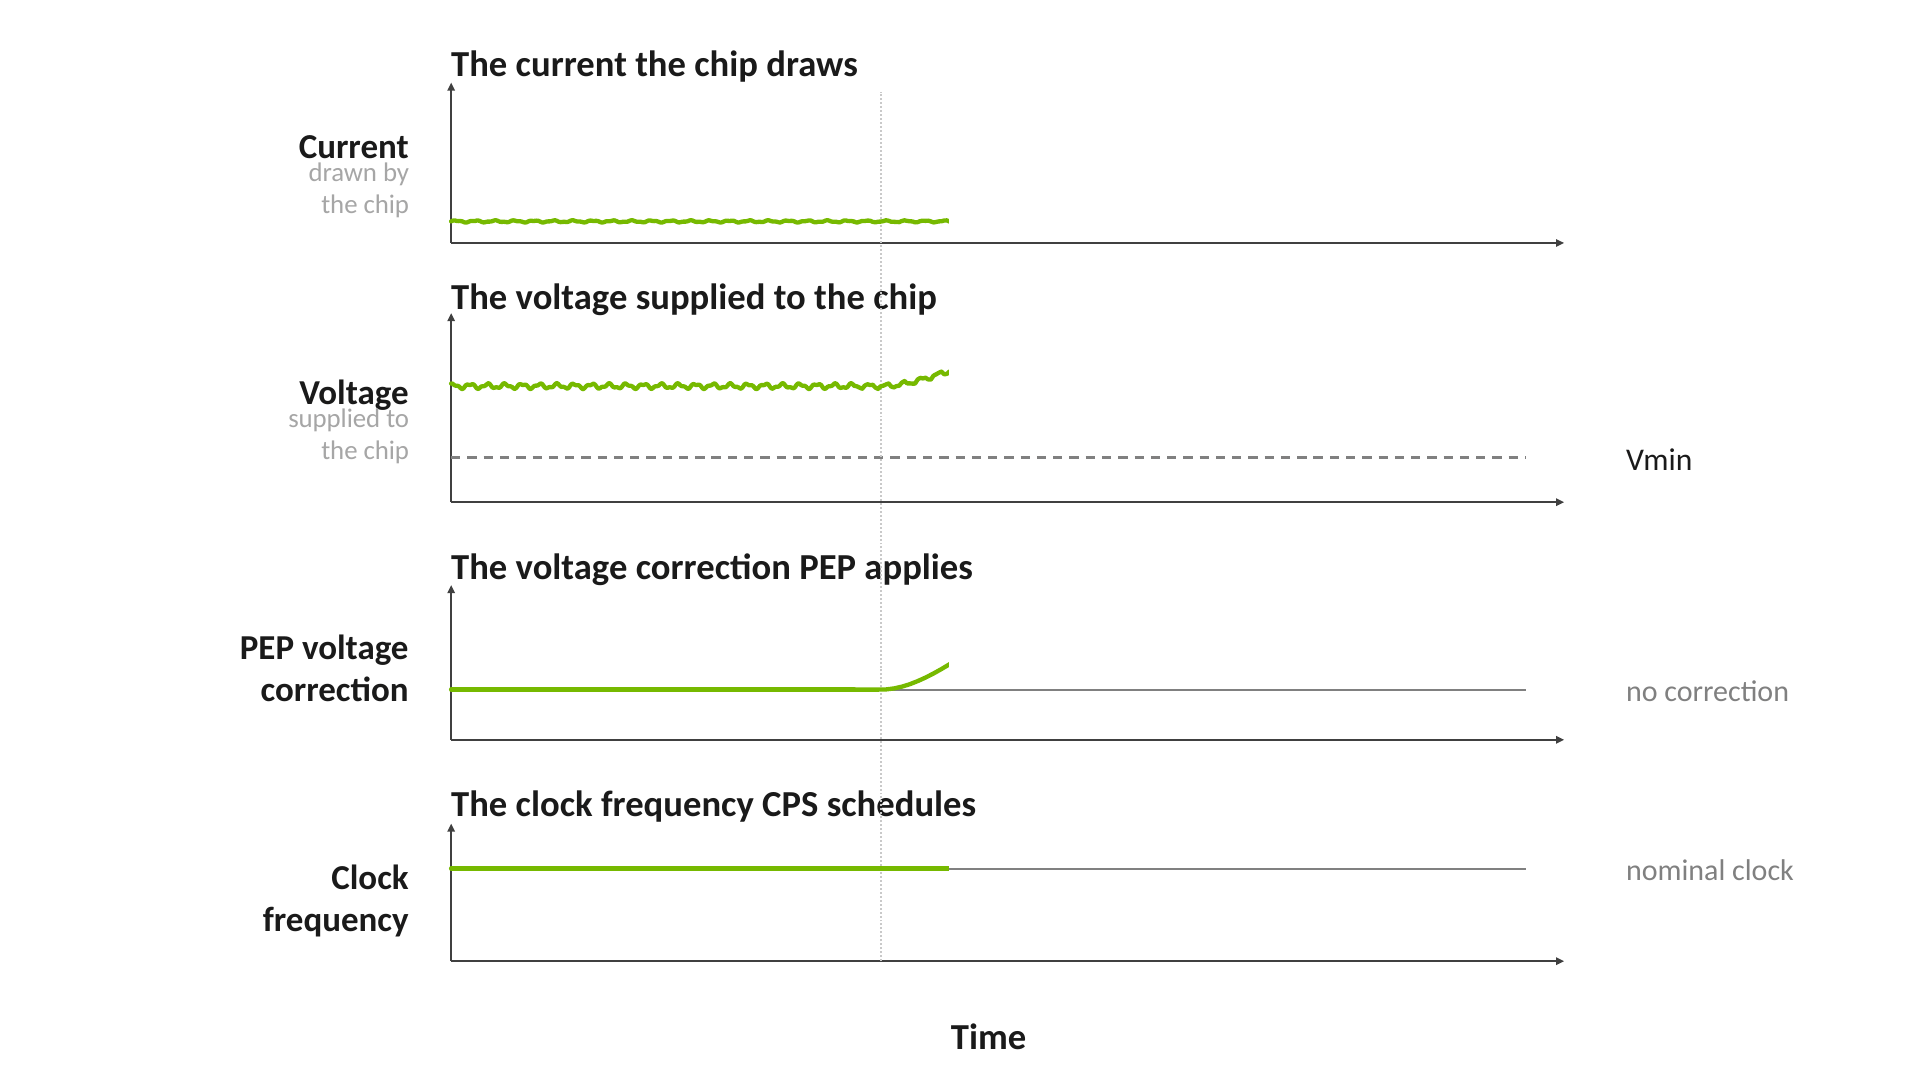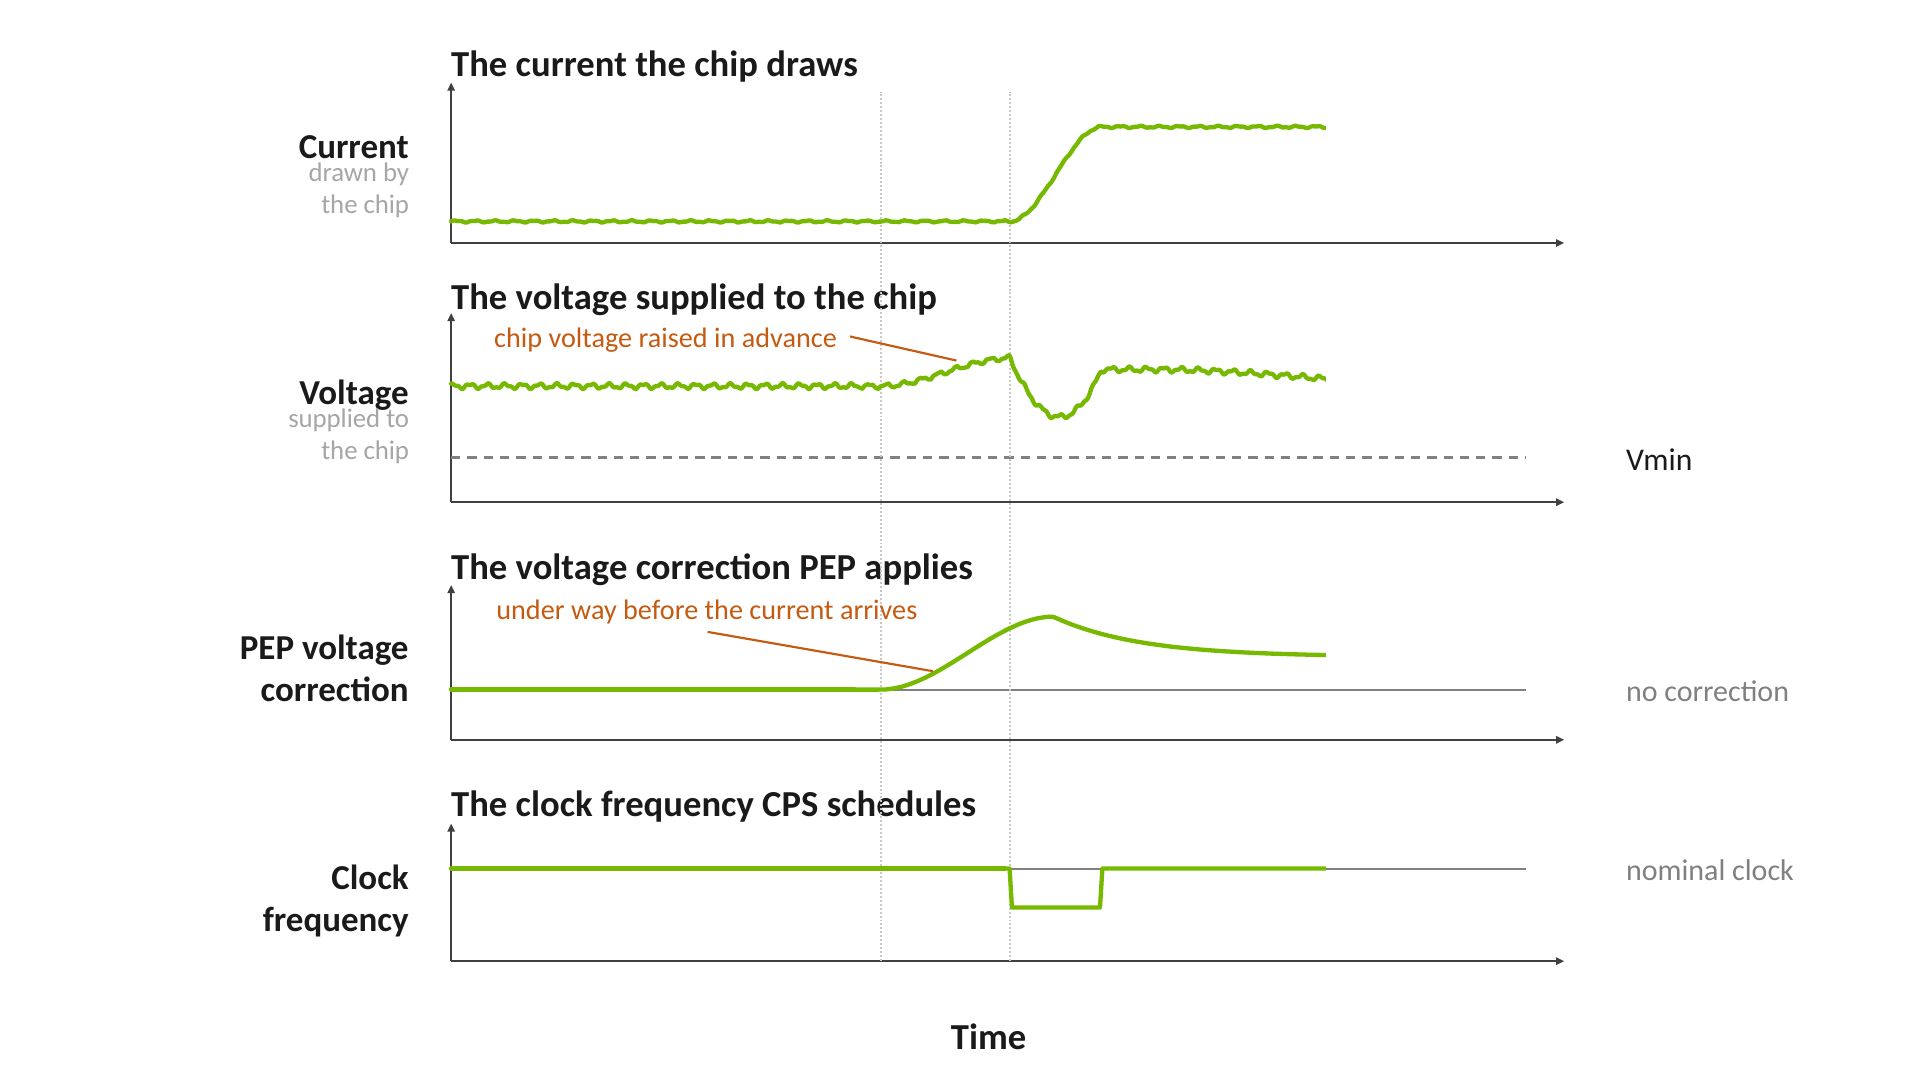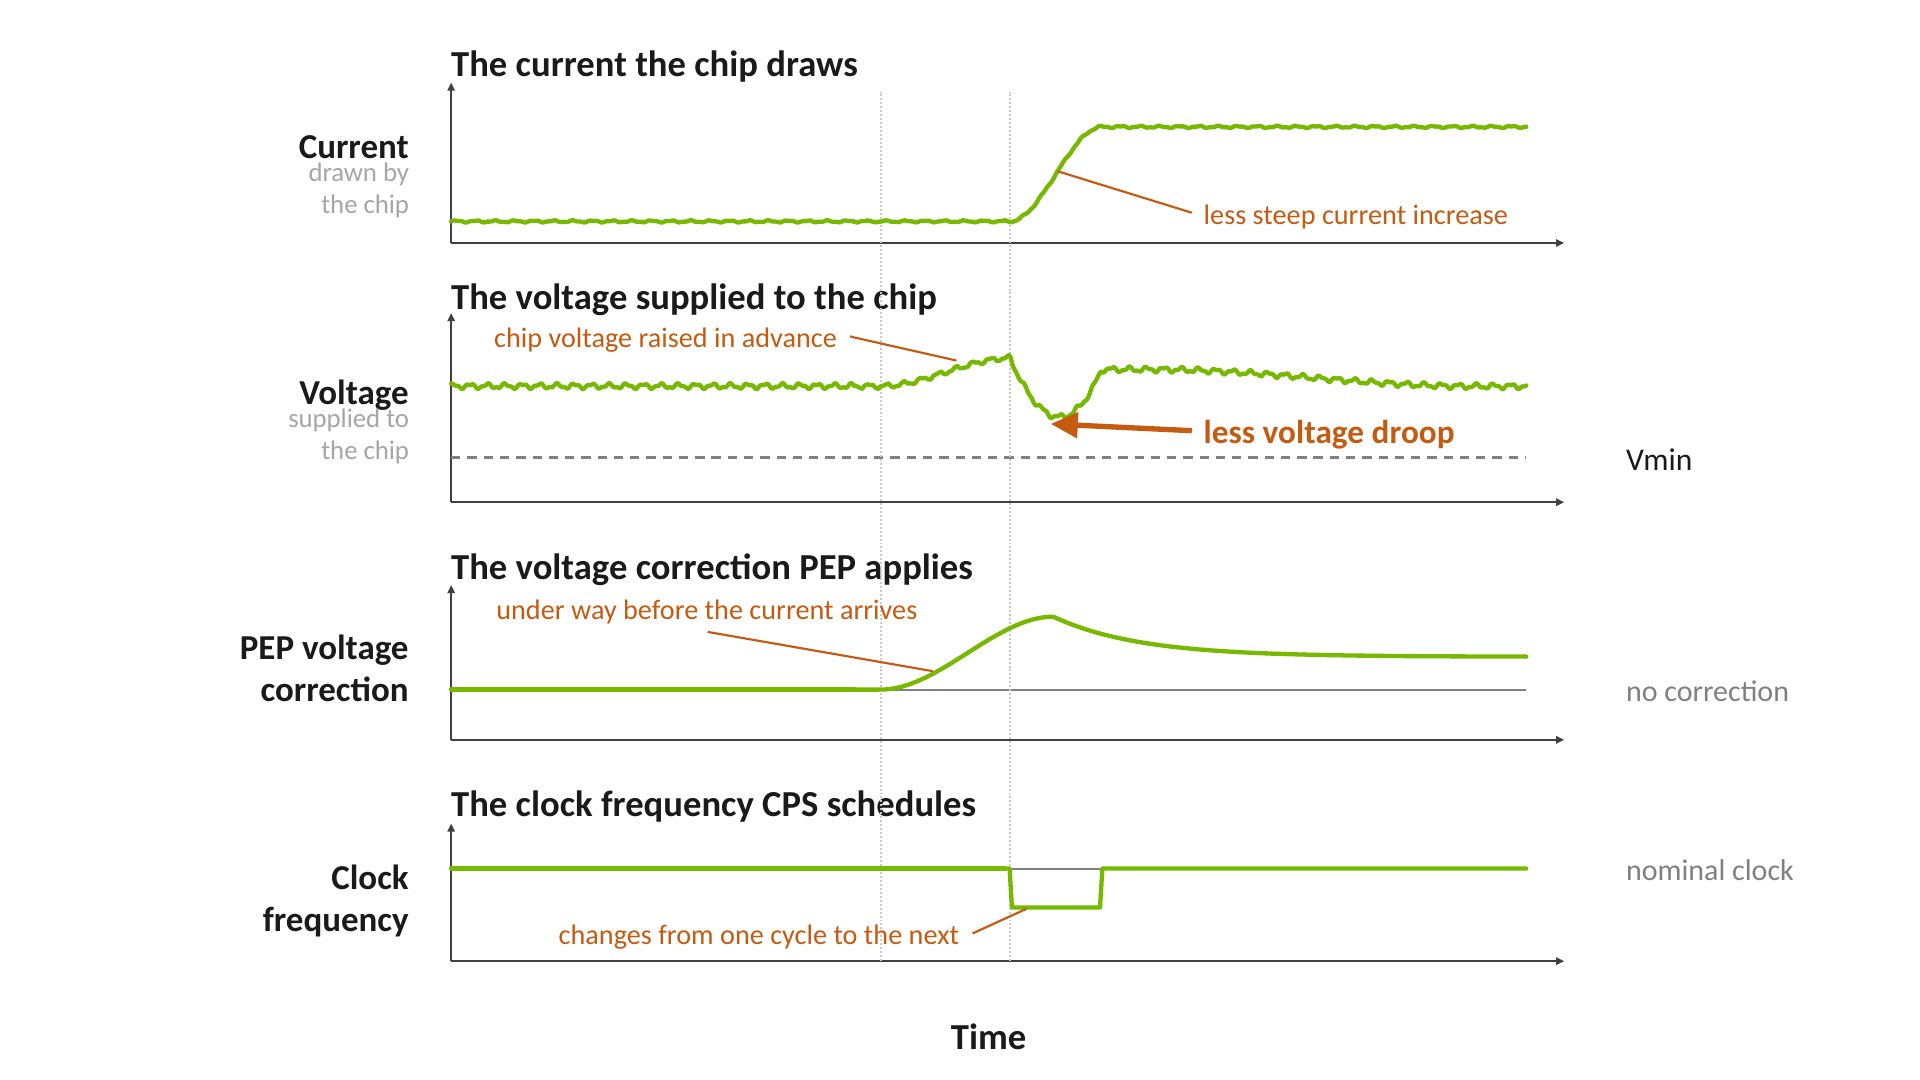
PEP 和 CPS 共同为编译器提供了调度电信号甚至时钟周期长度的工具,从而减少电压下降。对 Groq 3 LPX 系统进行的内部测试表明,这种方法可将电压降降低 60% 以上。据估计,这将导致电气系统必须不断为 AI 工作负载提供的基准电压大幅降低,达到个位数的百分比。这将导致更高的功耗下降百分比,因为功耗与电压平方成正比,而这一切都不会影响工作负载。
在高交互性下提供更高的每瓦性能
与类似指定的非确定性系统相比,Groq 3 LPX 确定性执行可以将运行相同工作负载所需的功耗降低到可能较低的两位数百分比。在功率受限的 AI 工厂中,降低开销可以将更多的固定功耗预算用于生成 token。
在 2026 年下半年,NVIDIA DSX MaxLPS 将这些支持确定性的功率控制引入 NVIDIA Vera Rubin 平台。它们补充了工厂层面的 NVIDIA DSX MaxLPS 和 Vera Rubin NVL72 机架内的智能 Power Smoothing 功能。每个模型都在不同的平台级别上运行,但都服务于相同的目标:每兆瓦都能获得更有用的 AI 推理。
在平台层面,在长上下文和高交互性下,将 Groq 3 LPX 与 Vera Rubin NVL72 搭配使用,可将 2T+ 参数模型的每兆瓦吞吐量提高 35 倍。对于 AI 工厂而言,这意味着在相同的功率预算下,在要求严苛的操作点提供更多 token。
致谢
这项工作得益于 Ashraf Essea、Kibibi Moseley、Graham Steele、Suhas Somnath、Sarah McKenney、Farshad Ghodsian 和 Eduardo Alvarez 的专业知识和工程贡献。


