

混合模型将状态空间模型 (SSM) 层与几个注意力层交织在一起。NVIDIA Nemotron 3、Qwen3.5 到 Qwen3.8、Kimi-K3 和 GLM-5.3-Flash 均以这种方式构建,并以 Mamba-2、门控 DeltaNet (GDN) 或 Kimi Delta Attention (KDA) 作为 SSM 层。
SSM 层旨在实现快速解码:它们使用固定大小的状态代替随上下文长度增长的键值 (KV) 缓存。但是,在提供批量大小时,SSM 层 (而非注意力) 可能会成为多达 10 万个上下文token的延迟瓶颈。SSM 层还使两种能够可靠地加速注意力解码的技术变得更加复杂:预测性解码和量化。
ReplaySSM 使 SSM 层再次成为快速部分。它将 SSM 状态表示为检查点和最近输入的缓冲区。这将输出计算与状态更新分离开来,并解决了当前 SSM 解码中的三个挑战:状态流量、预测解码回滚以及量化状态下的错误累积。
ReplaySSM 是 NVIDIA 与普林斯顿大学道氏 AI 实验室的合作项目。这篇名为ReplaySSM:Cache SSM Inputs,Not State (回放 SSM:缓存 SSM 输入,非状态) 的论文详细介绍了这三个优势,并给出了完整的评估结果。它在 arXiv 上提供,代码在GitHub上。它集成到 NVIDIA TensorRT-LLM、vLLM 和 FlashInfer 中,并在 GLM-5.3-Flash 和 Kimi-K3 中运行。
SSM 层为何会成为解码瓶颈
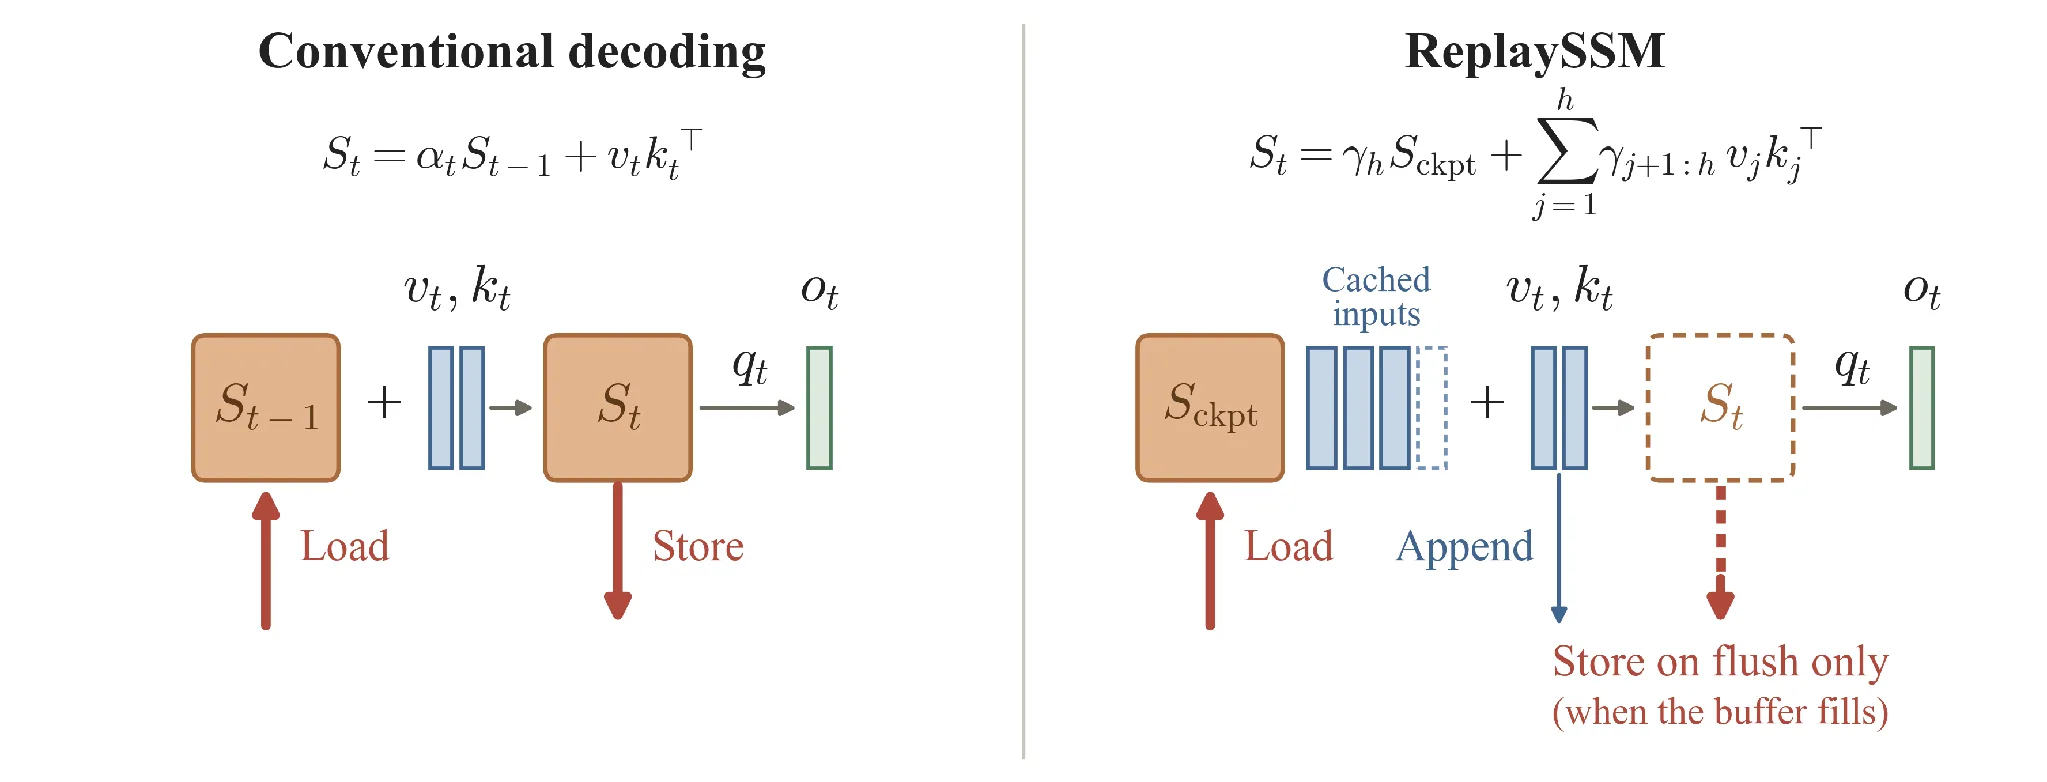
以 NVIDIA Nemotron 3 Ultra 中使用的 Mamba-2 图层为例。它以如下递归方式解码一个 token:
其中 StS_t 是状态,t* alpha_t 是数据依赖性衰减,vtv_t、ktk_t 和 qtq_t 是token的输入。每个步骤从高带宽内存 (HBM) 加载 St* 1S_ {t-1},应用衰减和 rank-1 更新,使用 qtq_t 计算输出,并存储 StS_t 返回。GDN 和 KDA 添加了增量规则校正,但其更新可以以相同的外积形式编写,因此接下来的内容也适用于它们。
在解码期间,状态执行两项任务。读取以生成此token的输出,并将其更新为下一个token的状态。传统解码会同时执行这两种操作:每个步骤都会更新状态,从中读取输出,并将其存储到下一步。这三个挑战都来自于这种融合。
状态内存流量
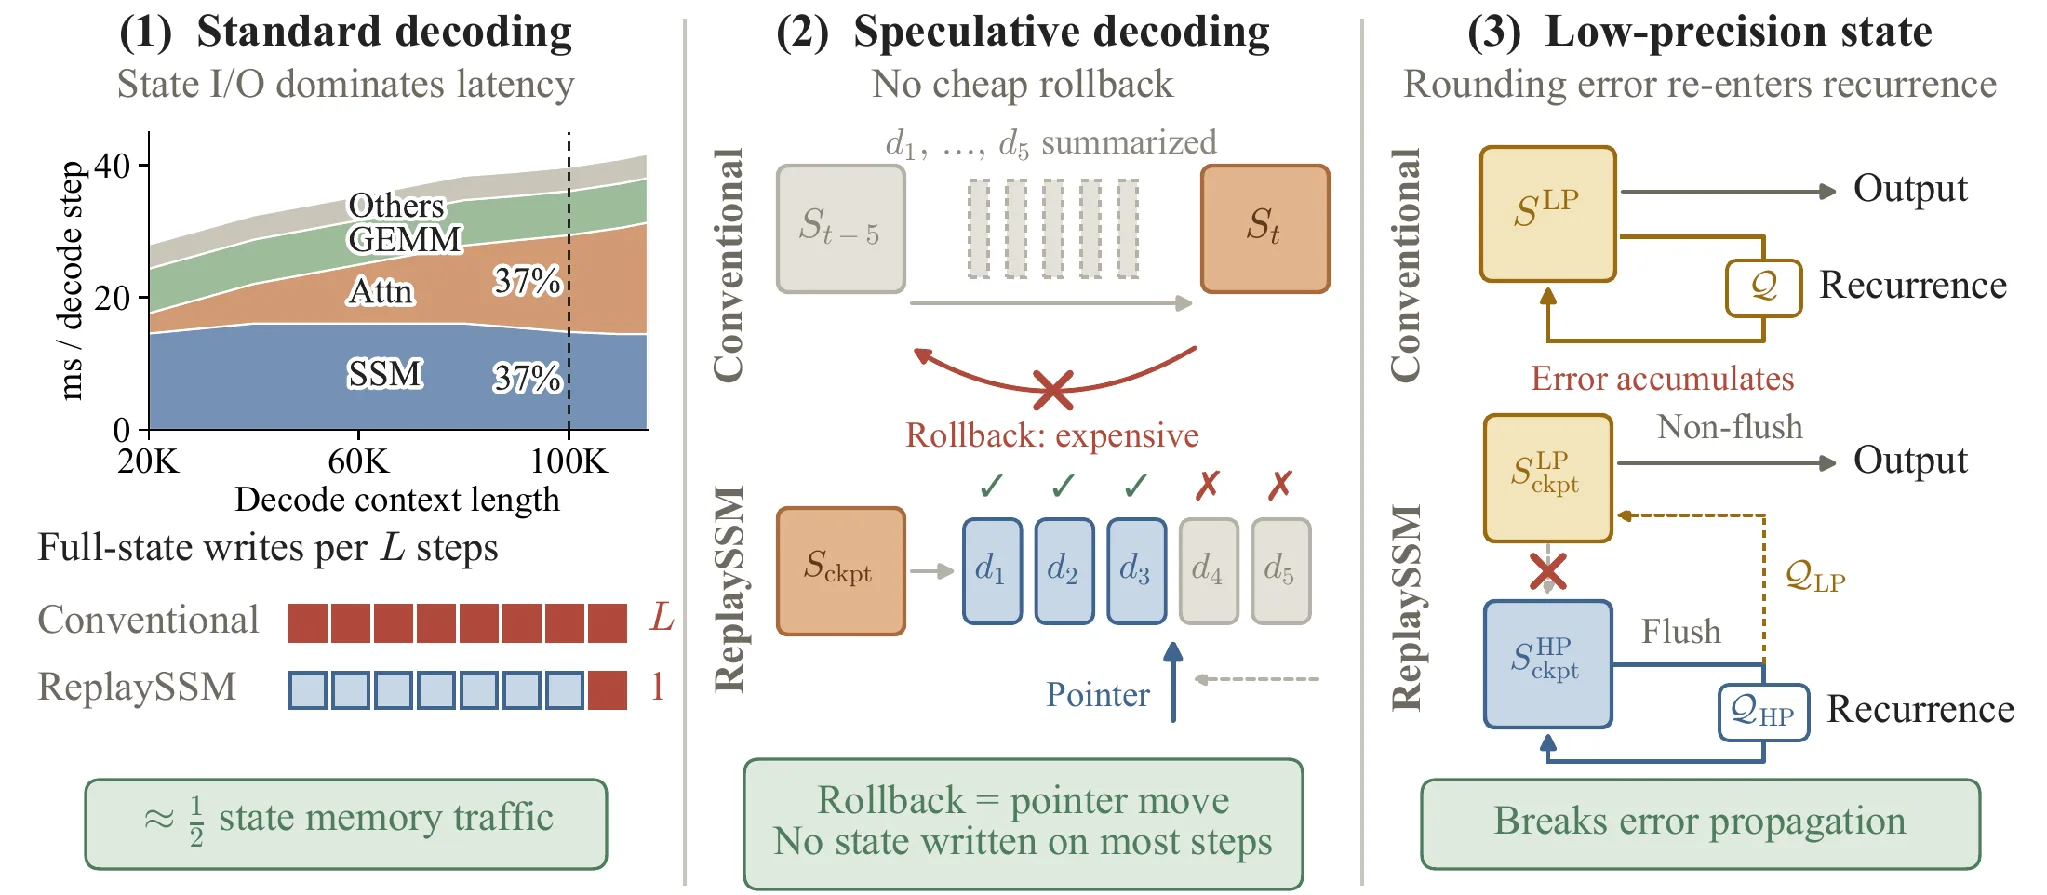
SSM 解码步骤加载和存储完整状态,同时对其执行少量运算,因此内核受 HBM 带宽而非计算的约束。在提供批量大小时,这使得 SSM 层 (而非注意力) 成为解码的最大组件,在 Nemotron-3 -Super-NVFP4 上的批量大小为 256 的 Nemotron-3 -Super-NVFP4 上增加了多达 10 万个 token (图 2,左) 。
两个因素推动了这一点:
- 层数量:该模型的 SSM 层数量是注意力层的五倍。
- 状态大小:一层的 FP32 状态为每个序列 4 MiB,而 FP8 KV 条目为每个 token 0.5 KiB,因此 SSM 层的状态是 8K token 的注意力层 KV 缓存的大小。
回滚,用于预测性解码
预测解码让起草者提出 T token,在目标模型的一次遍历中验证这些 token,然后回滚到最后一个被接受的 token。Attention 通过移动 KV 缓存指针自然支持回滚。但是,一旦 SSM 将草稿汇总到其状态,更新并不容易,因此回滚成本很高。vLLM 等服务引擎通过在每个草稿token后存储状态快照并选择与可接受的前缀相匹配的快照来解决此问题。即在显存受限的路径上,每步执行一次读取和 T 写入操作,而快照会限制 GPU 显存中容纳的请求数量。因此,预测性解码 (Transformer 的可靠加速) 对 SSM 的批量大小几乎没有帮助。
状态量化
量化状态会产生输出,是下一次更新的输入,因此其舍入误差会在每个步骤中重新进入循环。KV 缓存没有这样的循环:量化后的条目会被多次读取,但永远不会重新写入自身,这就是 KV 缓存所接受的精度低于 SSM 状态的原因。例如,Qwen3.5-122B-A10B-NVFP4 使用 NVIDIA NVFP4 4 位浮点格式作为其权重,具有 FP8 KV 缓存和 FP32 SSM 状态。
ReplaySSM 如何表示
可以在包含 h 个 token 的窗口上展开 SSM 递归:
其中 SckptS_ {\ mathrm { ckpt}} 是窗口前的状态,{gamma} 是累积衰减。传统的解码步骤是按照左侧的步骤进行的。ReplaySSM 使用右侧:它将状态表示为检查点以及 Mamba-2 的近期输入记录 ( j = alpha_j,vjv_j,kjk_j) 的小缓冲区。
在大多数步骤 (我们称之为非刷新步骤) 中,它会将当前输入附加到缓冲区,并计算检查点和缓冲区的输出,而不存储状态。当 L 记录的缓冲区填充时,刷新步骤会将缓冲的输入折叠到检查点中,将新检查点写入 HBM 一次,然后清除缓冲区。输出与传统解码乃至浮点差都不相同。ReplaySSM 的方法可以总结为三个问题:
ReplaySSM 有什么作用?
它缓存最近的 SSM 输入,并将状态表示为检查点和这些输入。
有什么变化?
它将输出计算与状态更新分开:计算每个步骤的输出,而检查点每个窗口更新一次。
这会实现什么目的?
它可减少状态内存流量,简化预测回滚,并支持低精度状态读取,而不会通过循环更新传播其舍入误差。
我们如何评估 ReplaySSM
我们对两个系列的四个混合模型进行了评估:Nemotron 3 (采用 Mamba-2 层) 和 Qwen3.5 (采用 GDN 层) ;从一个 NVIDIA H100 Tensor Core GPU 上的 4B 密集型模型到一个 NVIDIA Blackwell Ultra B300 GPU 上的 120B 级混合专家模型 (MoE) 模型 (表 1) 。我们在 vLLM 中实施了 ReplaySSM,并将其与 vLLM 自己的内核进行了比较,以其最佳启动配置。
性能运行将 SSM 状态保持在 FP32 (这些模型的默认精度) ,并使用 L = 16 的窗口 (所有四个模型的最佳窗口大小) 。预测解码测试使用每个模型的多token预测 (MTP) 头来生成草稿token。
| 模型 | SSM 层 | 权重 | GPU | SSM/ 注意力层 |
|---|---|---|---|---|
| Nemotron-3 -Nano-4B | Mamba-2 | BF16 | 1 × H100 | 21 / 4 |
| Nemotron-3 -Super-120B-A12B | Mamba-2 | NVFP4 | 1 = B300 | 40 / 8 |
| Qwen3.5-4B | GDN | BF16 | 1 × H100 | 24 / 8 |
| Qwen3.5-122B-A10B | GDN | NVFP4 | 1 = B300 | 36 / 12 |
优势 1:减少状态内存流量
在一个 L token窗口上,传统解码会读取状态 L 次,并将其写入 L 次。ReplaySSM 仍会在每个步骤中读取检查点,因为输出需要它,但在刷新期间仅写入一次。非齐平步骤有一项任务,即计算输出,并只写入新的输入记录,即几个向量而不是完整的矩阵。这大约将占主导地位的状态流量减半。
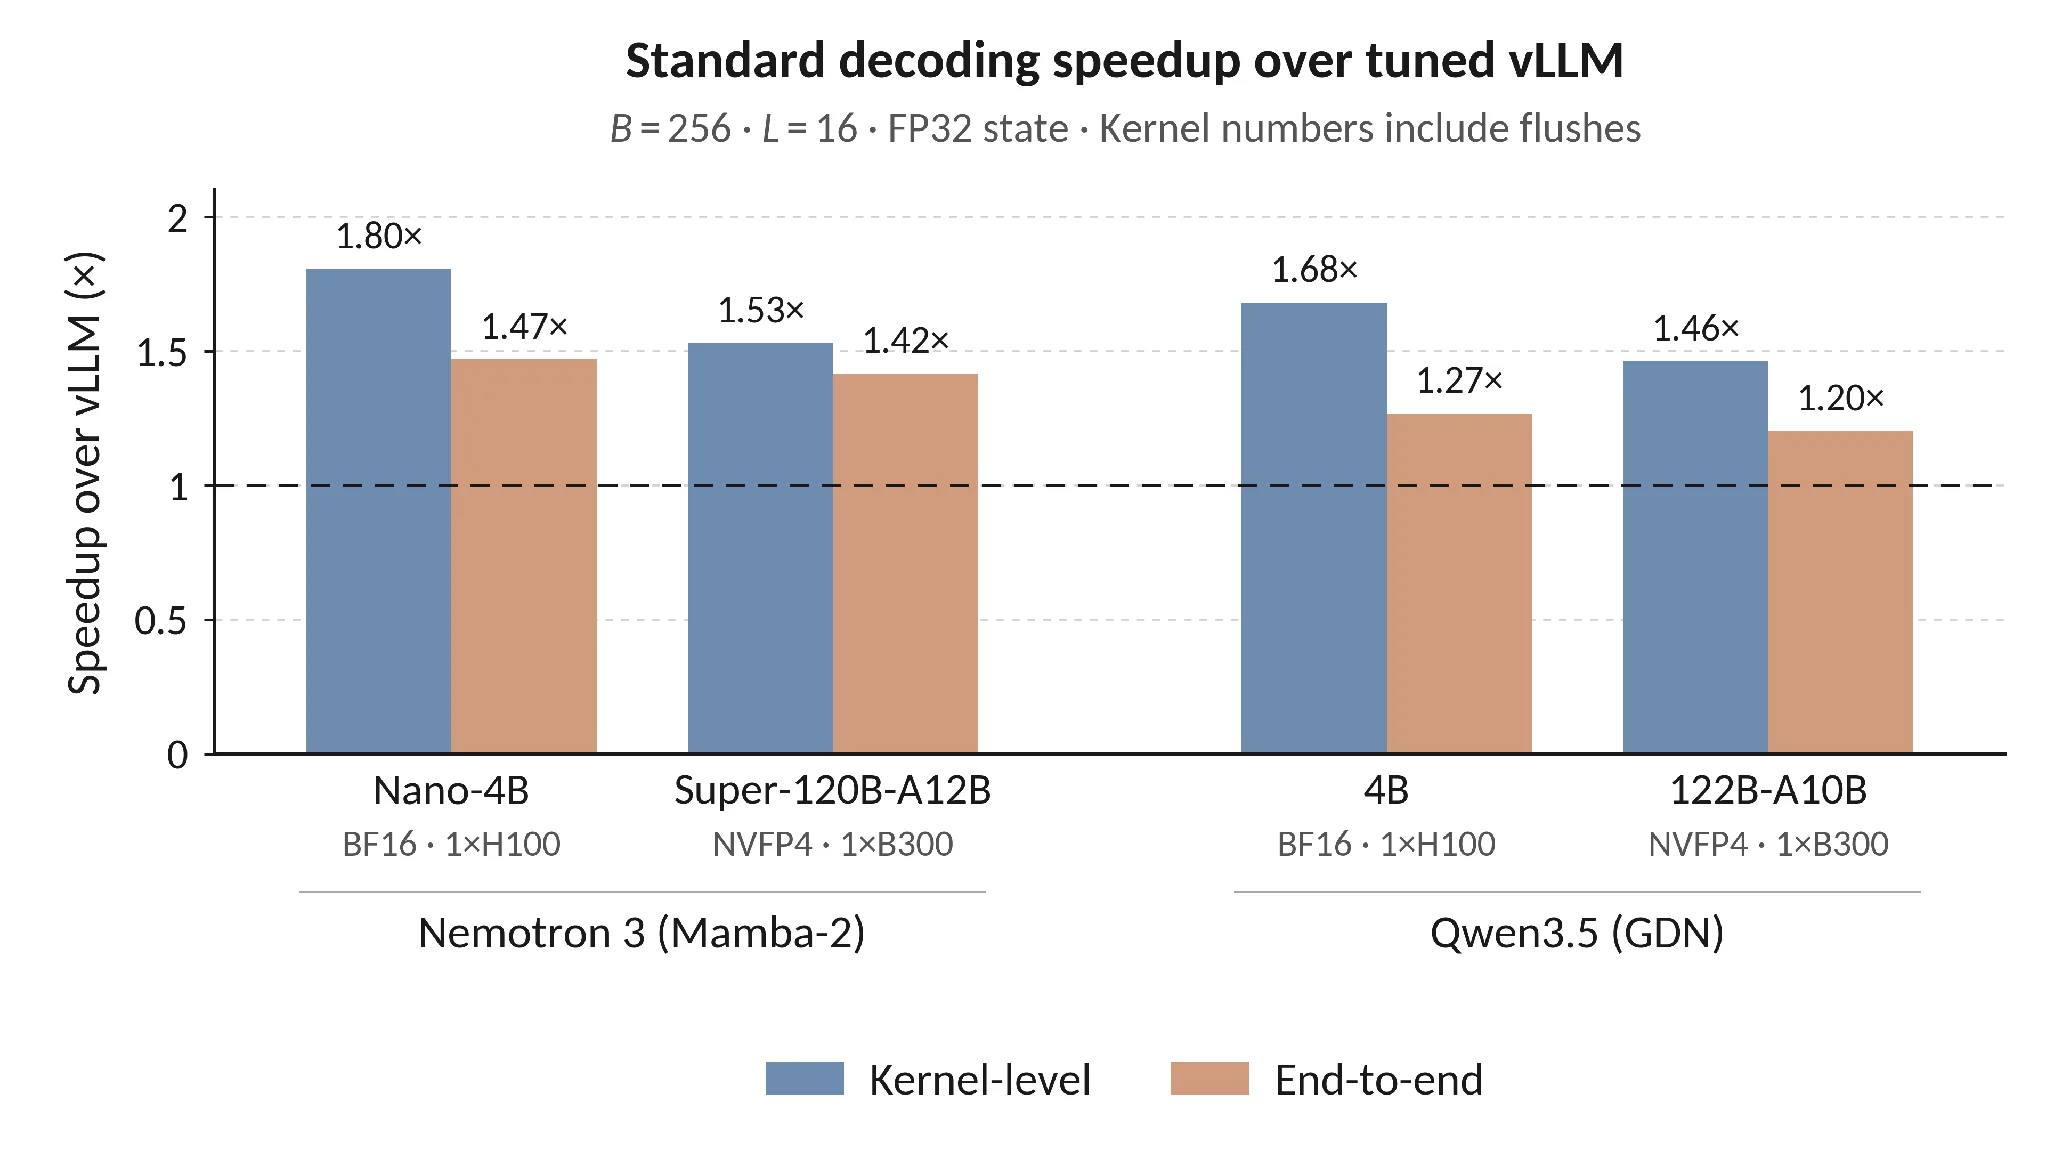
在提供批量大小时,内存带宽会限制传统内核的性能,因此减少状态内存流量会加快解码速度。在批量大小为 1 时,其他延迟来源占据主导地位,而 ReplaySSM 在这些测试中并没有提供加速。在批量大小为 256 时,核函数的运行速度比之前快 1.46% 到 1.80%,而解码步骤在四个模型中的运行速度比之前快 1.20% 到 1.47% (图 3) 。由于步骤中的 SSM 比例增加,端到端增益会随着批量大小的增加而增加。
优势 2:简化回滚并加速验证
在预测解码中,ReplaySSM 会在验证之前将所有 T 草稿token的输入附加到输入缓冲区,然后通过推进缓冲区指针来提交可接受的前缀。与 KV 缓存一样,超出指针的记录将被忽略,下一个附录将覆盖这些记录。每个草稿token都没有要保存的状态快照,也没有要恢复的状态 (图 2,中间) 。刷新折叠只将提交的记录输入检查点,因此它永远不会等待可接受的长度。
这种分离提供了另一个好处。传统解码必须为每个 token 生成两个内容,即输出和更新状态,因为下一个 token 会消耗状态。ReplaySSM 中的非齐平步骤仅生成输出,而仅计算输出会打开另一种计算方法。对于零状态的一次更新,
o=(vk⊤)q=v(k⊤q)o = (v k^\top)q = v(k^\top q)
。左侧的表达式构建了
dv×dkd_v \times d_k
状态并进行读取。右侧的表达式可形成标量并缩放向量,而无需构建状态。对于针对 h 个已提交记录的 T 草稿,同样的想法给出了以下表达式:
其中 D 代表拔模位置的累积衰减,W 代表因果遮罩的衰减矩阵。我们称之为纯输出评估。该检查点只用于所有 T 查询,其他所有内容都是缓存键、缓存值和草稿查询上的两个小矩阵乘积。不会形成中间状态,这可以节省片上内存和 FLOP,而 Tensor Core 可以加速这些计算。此外,
K⊤QK^\top Q
由一组中的所有值头共享。这与预填充核函数已使用的分块计算相同,将缓冲区和草稿用作分块。GDN 也可以使用此表单。仅输出评估也适用于标准解码,但在验证中,T 乘以每个步骤的运算,这一点至关重要。
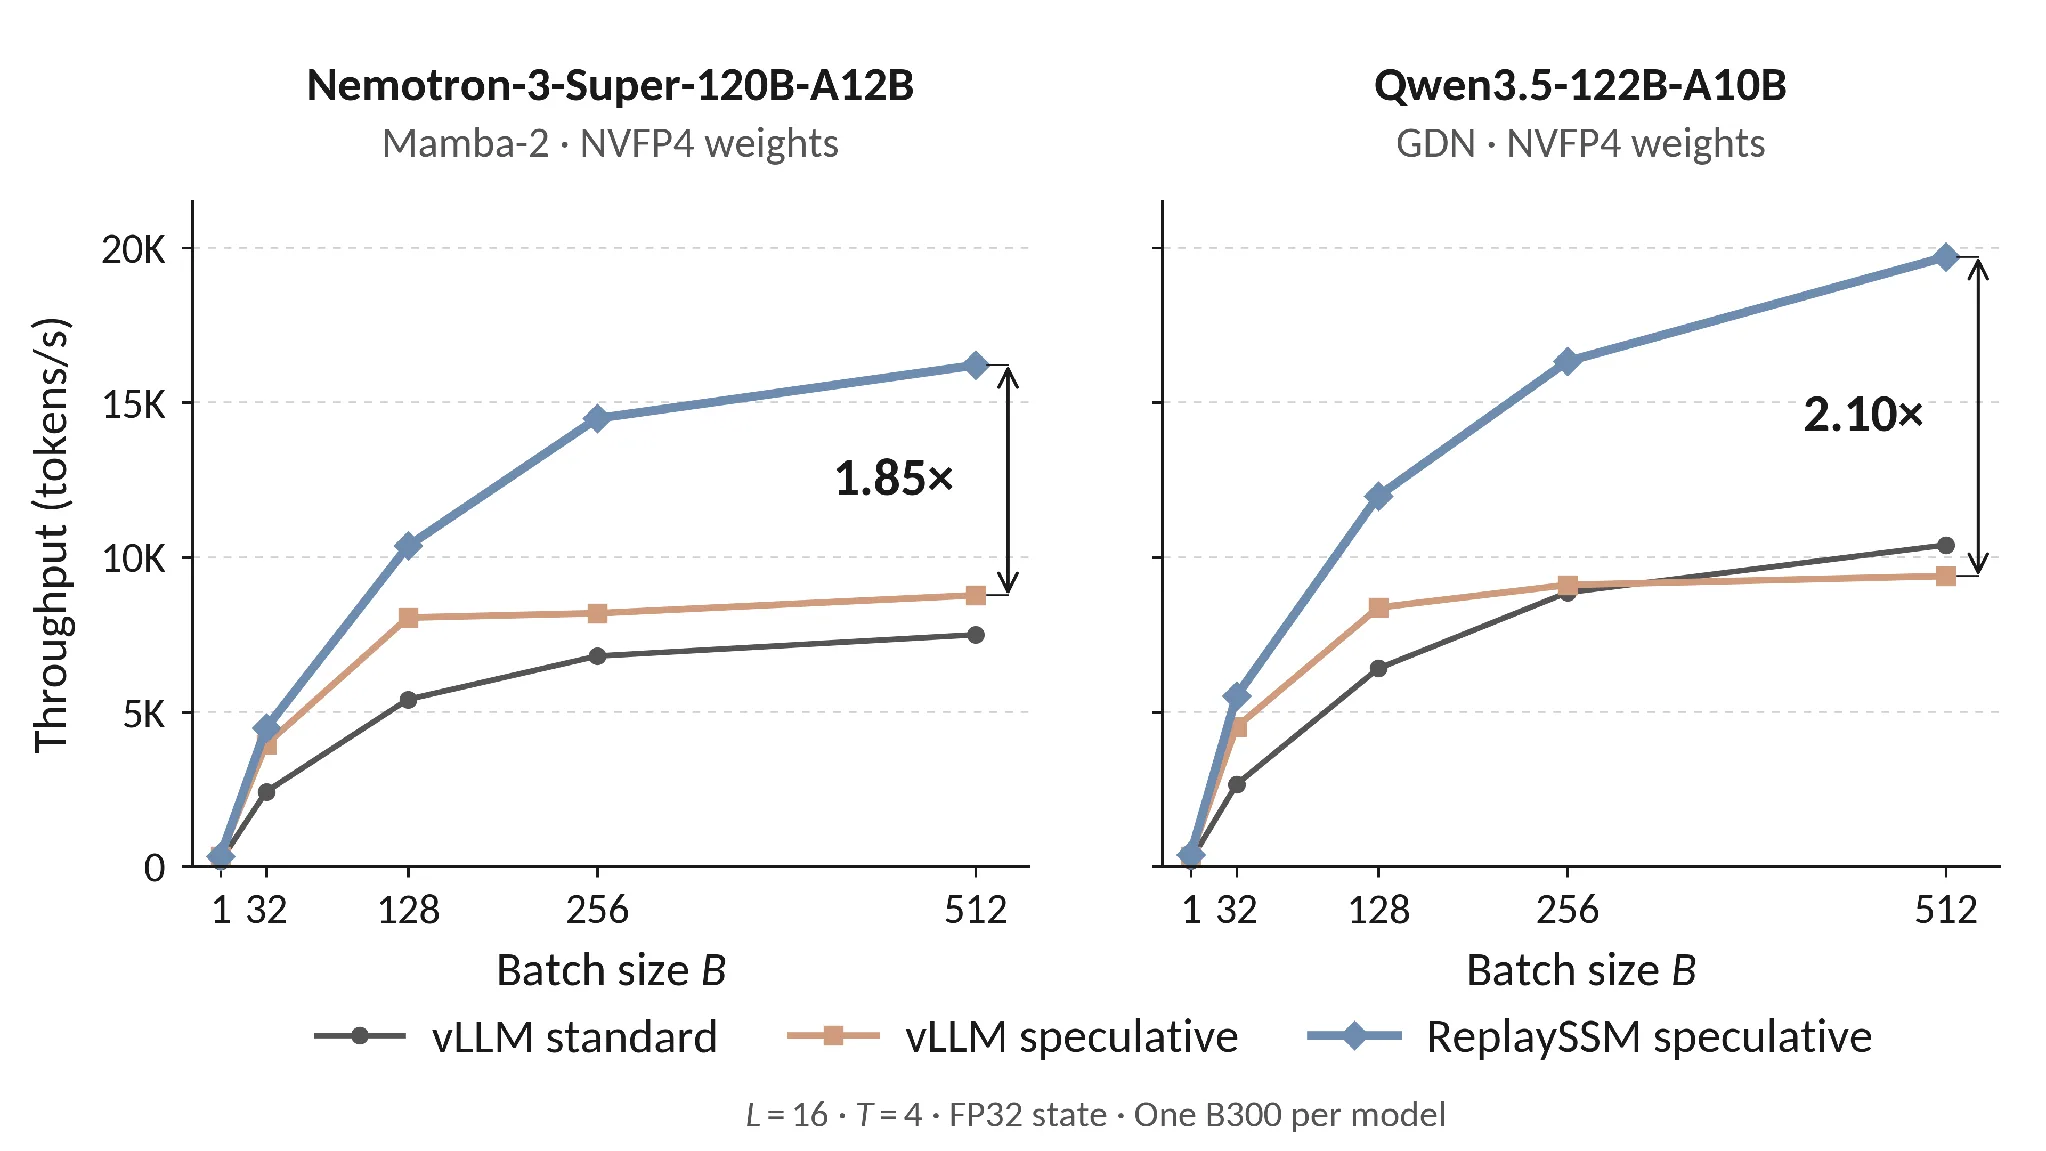
图 4 显示了两个 120B 级模型在 GSM8K 提示下的预测服务吞吐量 (T = 4) 。在批量大小为 512 时,ReplaySSM 可提供相较于 vLLM 预测解码的 1.85% 和 2.10% 的吞吐量,以及匹配的接收长度。
收益有两个来源。
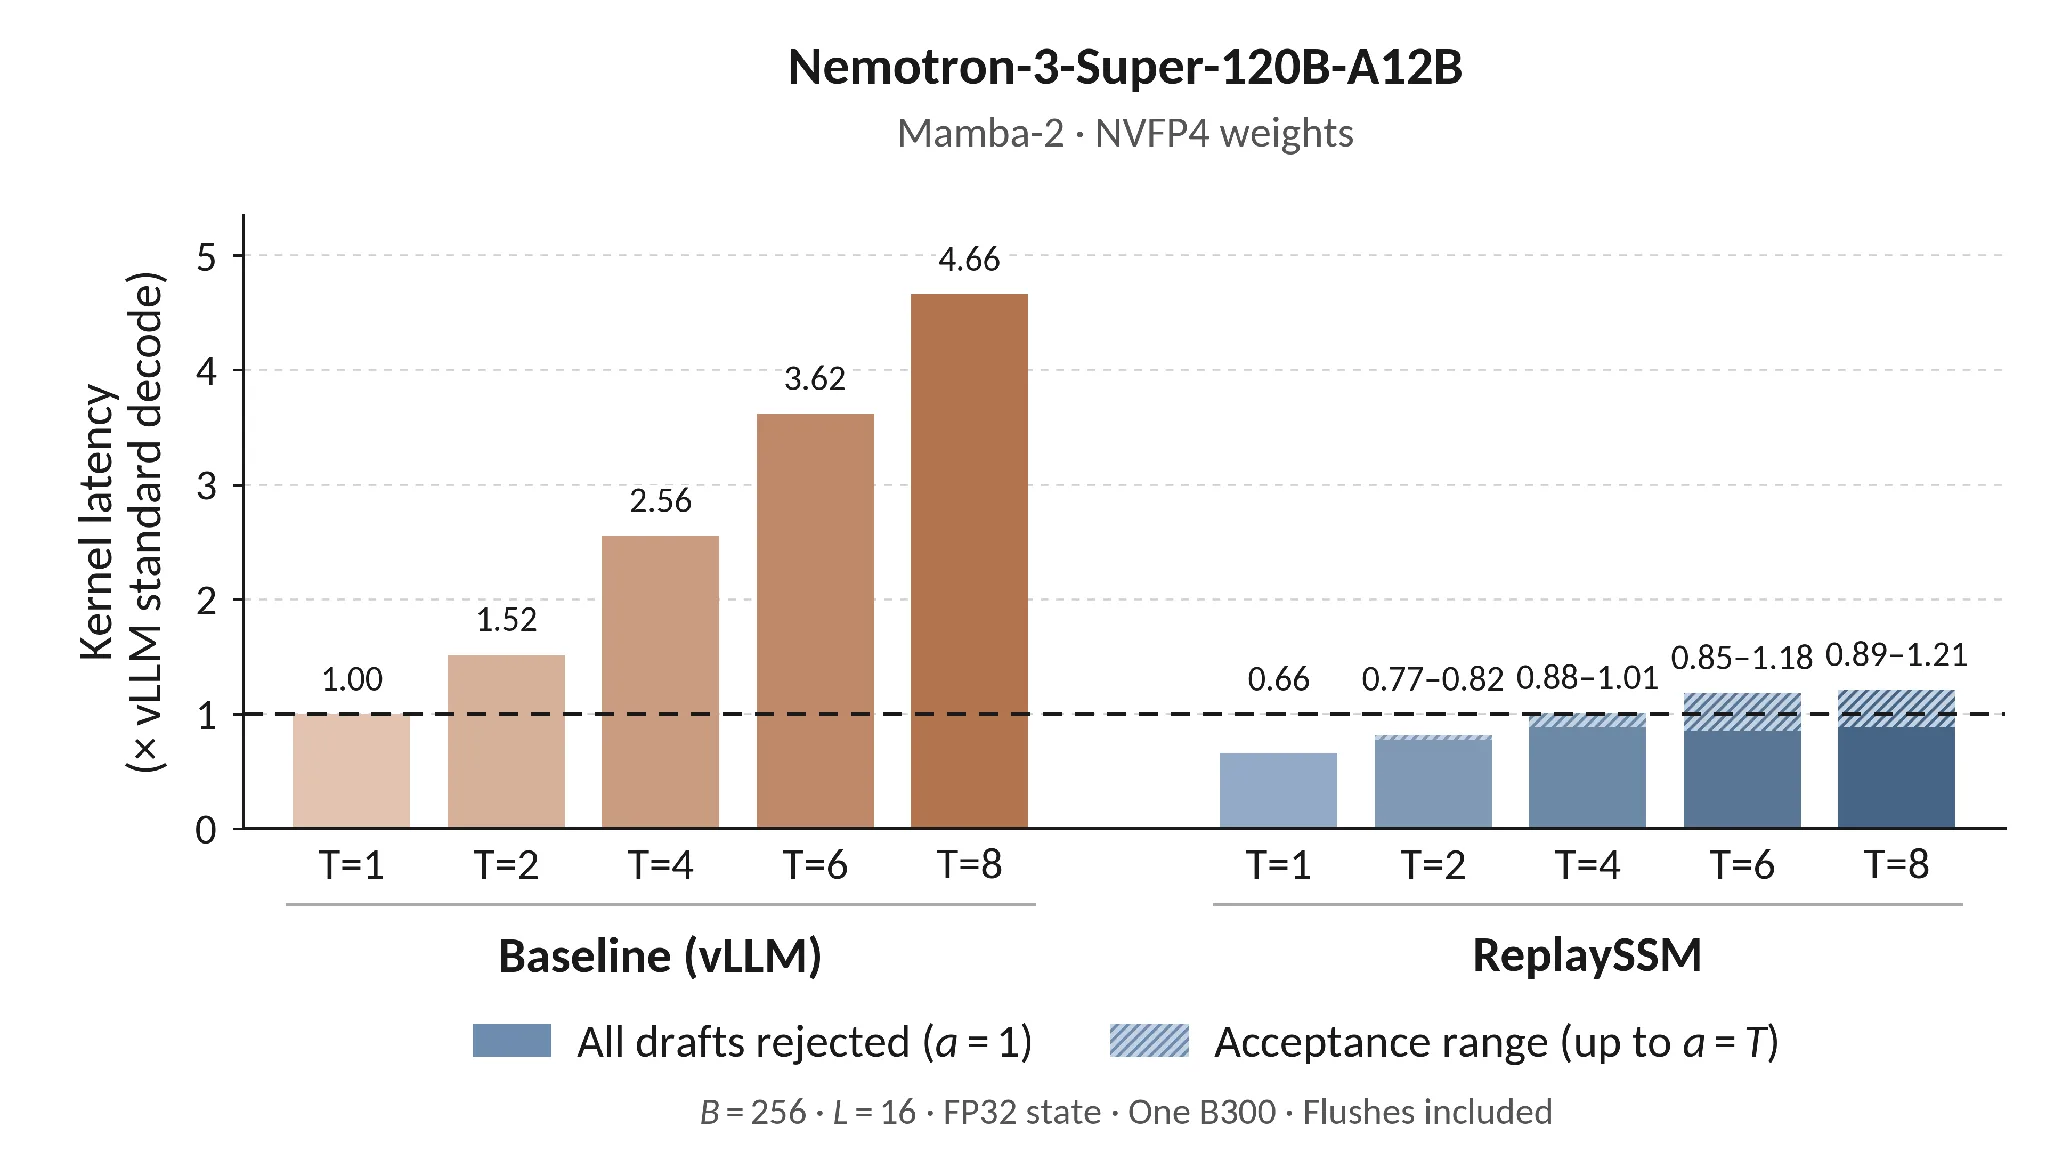
- 更快的验证速度:vLLM 的内核每个 token 存储一个快照,因此其延迟会随着 T 的增长而增长,在 T = 8 时,几乎是 vLLM 标准解码步骤的 5 倍。ReplaySSM 不会在大多数步骤中写入任何状态,因此它会在大约一个标准步骤 (包括刷新) 的时间内验证 8 个token (图 5) 。
- 更高的并发性:草稿状态快照会消耗 GPU 显存并限制并发性。传统的猜测不会超过批量大小 128,而在 Qwen3.5-122B-A10B-NVFP4 上,它在批量大小 512 时低于标准解码,而 ReplaySSM 会随着批量大小不断扩展。
优势 3:通过单独的精度限制误差累积
较低精度状态需要更少的字节,这可在内存带宽限制内核性能时减少延迟。在 Mamba-2 上,非刷新内核读取 NVFP4 状态时的运行速度比读取 FP32 状态时快 3.8%。
ReplaySSM 以两种方式改变了量化。首先,检查点文件在每个窗口中写入一次,而不是在每个步骤中写入一次,因此每个低精度检查点文件会在每 L 个步骤中舍入一次。《Nemotron 3 Ultra 报告》探讨了这种定期检查点方法。它降低了舍入频率,但舍入误差仍会进入后续更新。
其次,非刷新步骤仅在计算输出时读取状态,而刷新步骤则会更新后续状态更新中使用的检查点。这两个作业可以使用不同的精度。我们为循环保留高精度检查点,为非刷新读取保留低精度复制。刷新从高精度检查点开始,整合缓冲输入,并将结果单独投射为两种格式。低精度复制永远不会读回到递归中,因此其舍入误差仅影响当前窗口的输出,永远不会在递归中传播。在刷新期间编写额外的低精度副本会减少每个非刷新步骤中读取的数据量。接受、回滚和缓冲区管理保持不变 (图 2,右) 。
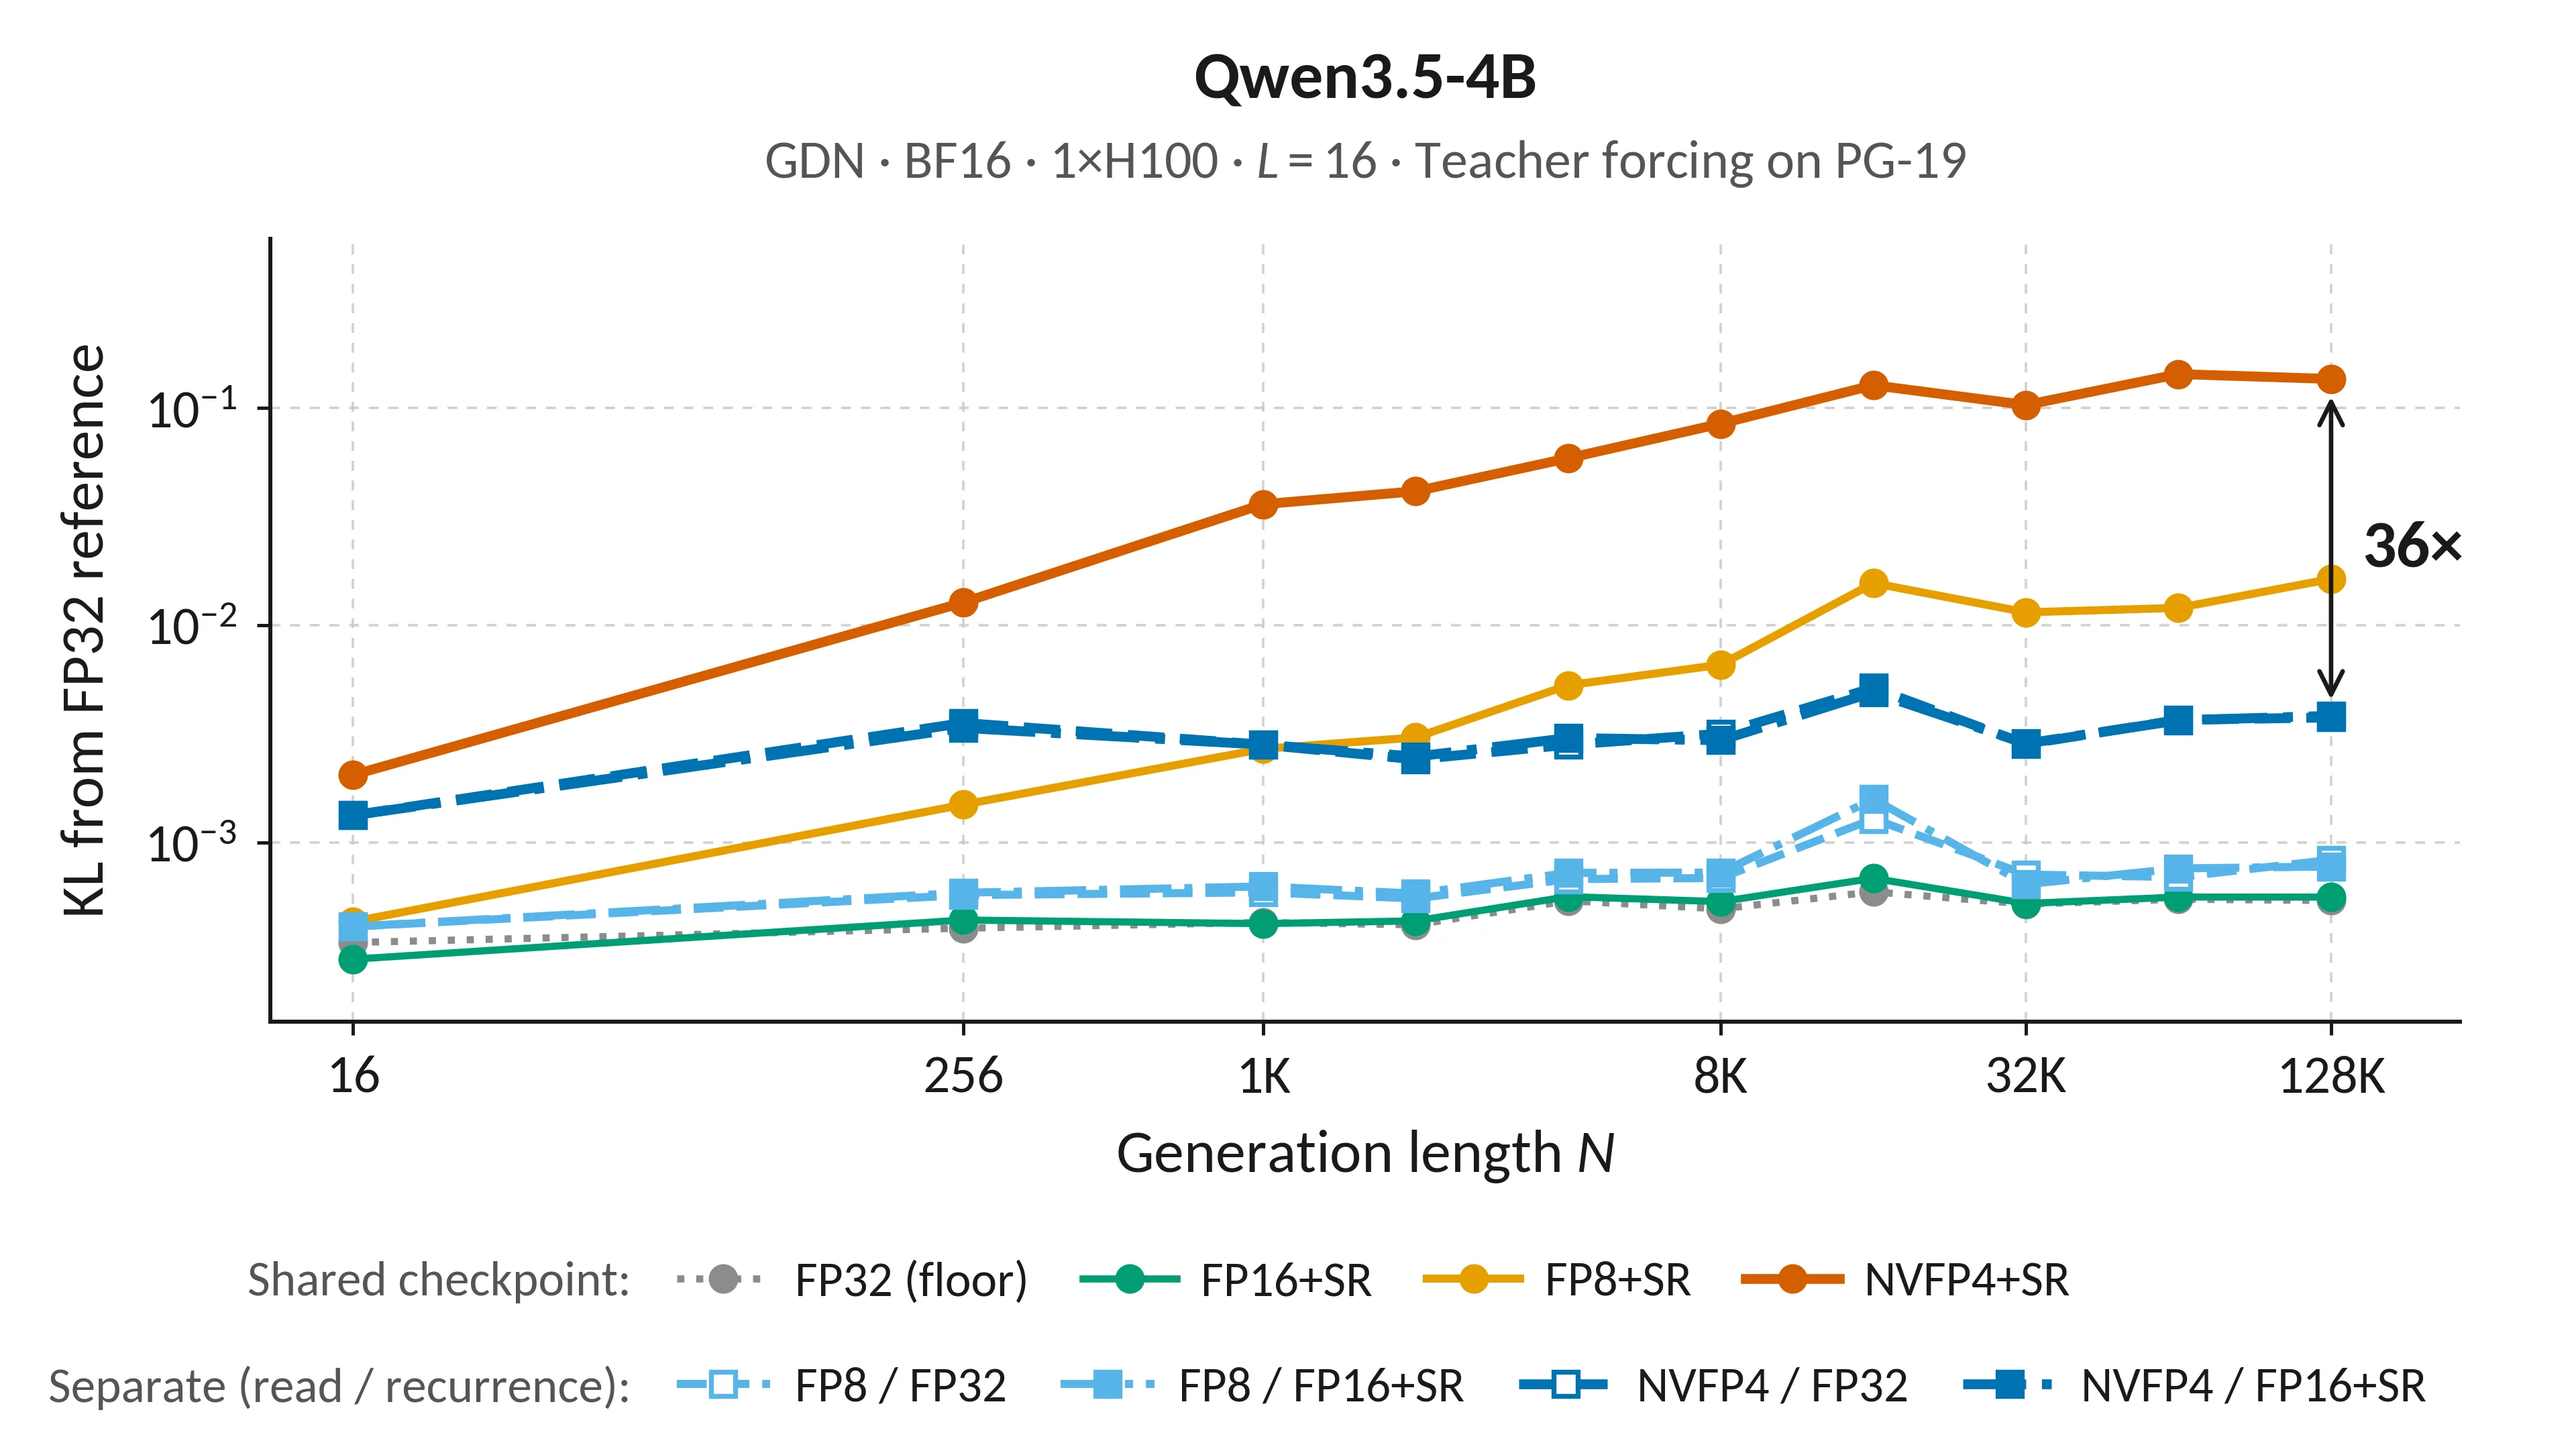
图 6 测量输出误差,即 Kullback–Leibler (KL) 在 PG-19 文本的教师强制下与 FP32 状态解码之间的偏差,等于 128K 生成的 token。共享的 FP8 或 NVFP4 检查点会随长度累积误差。在 FP32 中保持递归可以消除大部分增长:在 Qwen3.5-4B 上,NVFP4 读取的 FP32 递归值为 128K,将 KL 从 0.136 降低到 0.0038。剩下的是读取错误,该错误不会随着长度的增加而增长。
采用随机舍入 (SR) 的 FP16 递归函数会密切追踪 FP32,因此半精度递归检查点就足够了。更好地量化已读取的文案,例如沿状态和通道维度单独缩放,可以进一步减少剩余的读取误差。
我们还检查了 KL 差距是否以下游精度显示。表 2 显示了 GPQA-Diamond,这是使用我们运行的三代中最长的一代进行的基准测试。在四个模型中,一个共享的 NVFP4 检查点会损失 3 到 31 个百分点的准确性。使用 FP16 或 FP8 递归的 NVFP4 读取可恢复其中大部分内容,并将四个模型中的三个保持在 FP32 的约 2 个百分点内。
| GPQA-Diamond,与 FP32 (点) 的差异 | FP32 精度 | 共享 NVFP4 检查点 | NVFP4 读取,FP16+ SR 递归 | NVFP4 读取,FP8+ SR 递归 |
|---|---|---|---|---|
| Nemotron-3 -Nano-4B | 56.7 | + 31.3 | + 6.7 | + 5.6 |
| Nemotron-3 -Super-NVFP4 | 79.3 | + 12.5 | + 1.4 | + 1.4 |
| Qwen3.5-4B | 76.3 | + 3.2 | +0.7 | +1.5 |
| Qwen3.5-122B-A10B-NVFP4 | 82.7 | 5.2 | = 2.0 | + 1.7 |
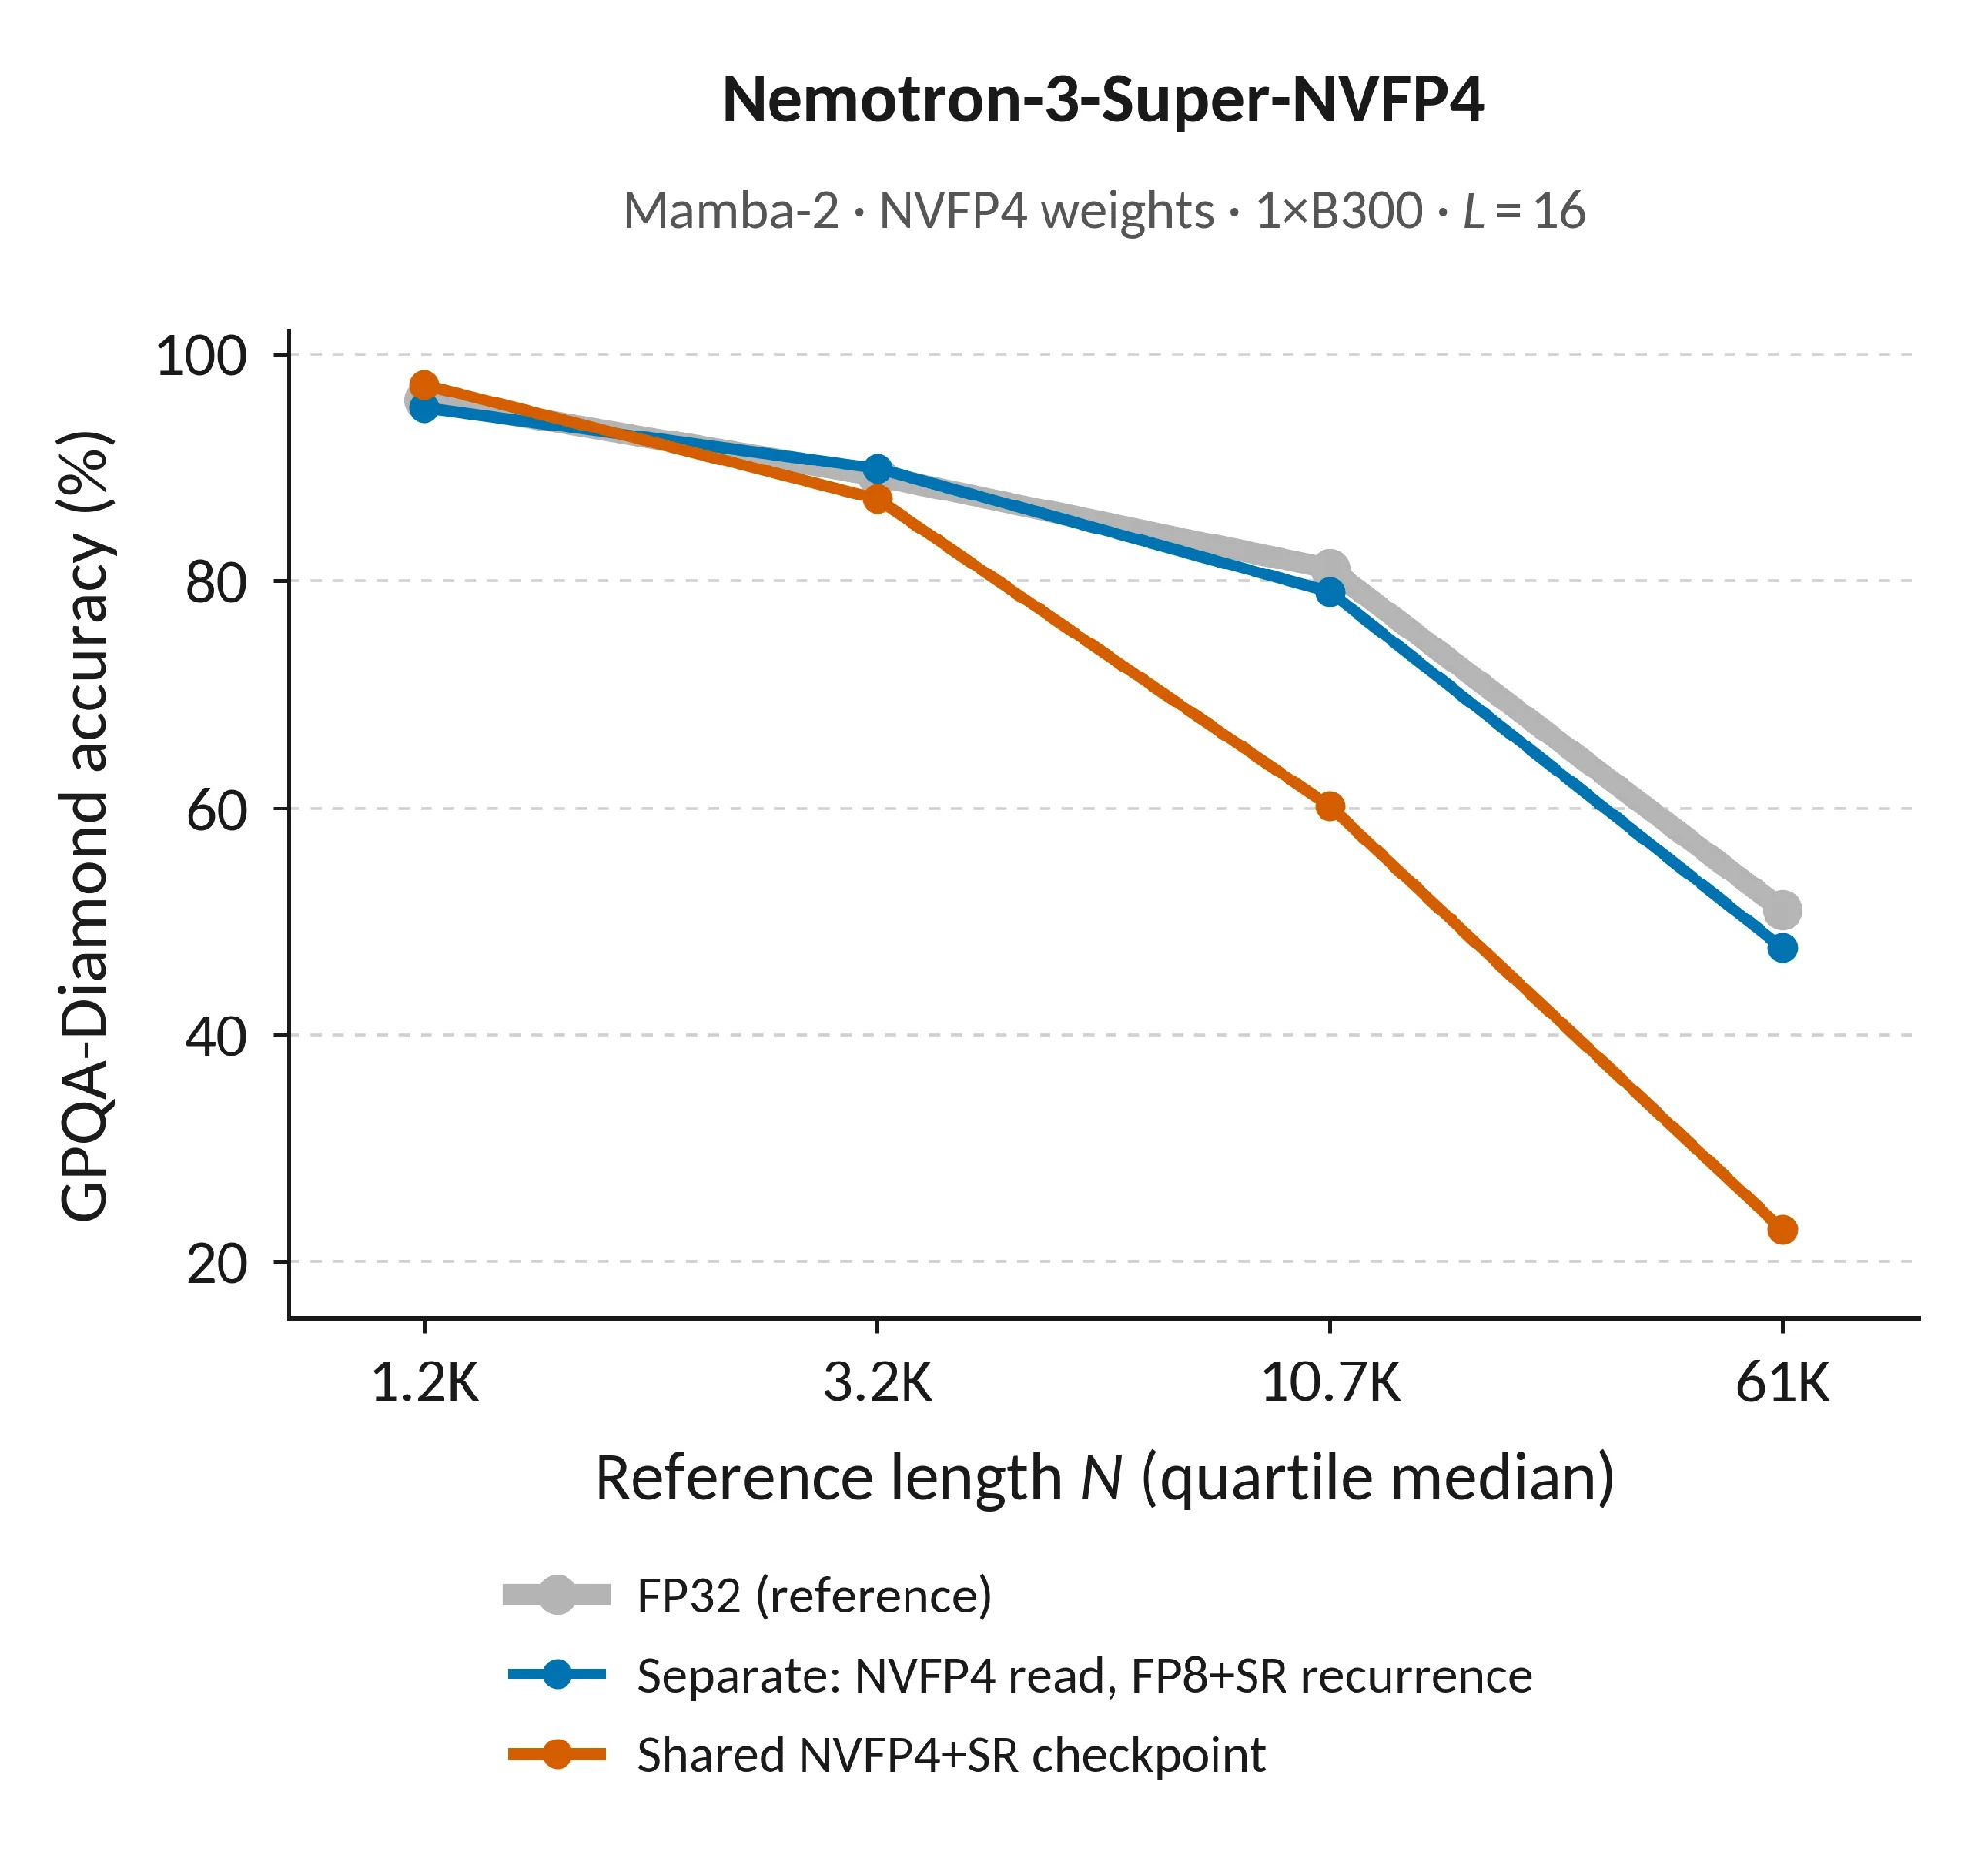
图 7 显示了精度损失如何随 GPQA-Diamond 的生成长度而变化。在三个基准测试中:
- GPQA-Diamond:在 Nemotron-3-Super-NVFP4 上,共享检查点会在较短的时间内跟踪 FP32 的准确性,但随着生成长度的增加,会偏离准确性。分离精度配置始终保持接近 FP32。
- MMLU-Pro 和 Math-L5:Generation 通常比 GPQA-Diamond 中的 Generation 更短。在使用共享 NVFP4 检查点时,四分之三的模型最多损失 3 个百分点的准确度,而单独的检查点配置平均保持在 FP32 的 0.5 个百分点以内。
该论文包括所有三个基准测试的结果和长输入 RULER 测试。
开始使用 ReplaySSM
ReplaySSM 已投入生产。GLM-5.3-Flash 与 ReplaySSM 一起提供服务,Z.ai 的基础架构报告 描述了将其添加到 KDA 解码核函数中的情况。Kimi-K3 缓存草稿token的 SSM 输入,以便在其 KDA 层中进行验证,并引用 ReplaySSM 作为并发方法。ReplaySSM 还集成到开源推理框架中,例如 TensorRT-LLM、vLLM、SGLang 和 FlashInfer。
如需了解详情,请查看以下资源:
- 阅读论文:ReplaySSM:缓存 SSM 输入,而非状态
- 试用代码:github.com/Johnny-Liou/ReplaySSM
- 在 TensorRT-LLM 中使用 ReplaySSM 提供混合模型: PR 14203、PR 16464
- 在 vLLM 中使用 ReplaySSM 提供混合模型: PR 48018、PR 52506、PR 52928
- 在 FlashInfer 中使用 ReplaySSM 内核: PR 3975、PR 4081
- 阅读Dao AI 实验室的早期文章,详细了解标准解码和预测解码


