

代理式工作负载对推理系统的要求越来越高。AI 智能体轮流传输不断增长的对话记录,并生成推理、工具调用和响应的组合。推理系统必须为用户提供大规模支持,同时保持快速响应。
MLPerfEndpoints v1.0 通过 API 端点使用编码和企业工作流来评估服务容量和响应速度之间的平衡。在性能运行期间,根据参考值检查生成的工具调用和工作流程意图。独立的 SWE 工作台验证评估可评估端到端任务解决能力。这些检查可评估更快的服务是否保留模型质量。
在 MLPerfEndpoints v1.0 中,NVIDIA Vera Rubin NVL72 初步结果显示,在共享的最低端到端交互性 (每位用户每秒 50 个 token) 下,每千瓦功率的吞吐量是 NVIDIA GB300 NVL72 的 10 倍以上。 1
本文将介绍基准测试结果,并概述提交作品中使用的硬件和软件优化。
1MLPerf® Endpoints v1.0,Kimi K3,标准化划分,可用类别,发布于 2026 年 11 月 9 日。NVIDIA Vera Rubin NVL72,32 个加速器,结果 1.0.1.kimi-k3.agentic_combined.1 p,运行 9:并发 = 1024 个查询,TTFT P90 = 4673.9 毫秒,系统 TPS = 41414.2 token/ 秒,E2E 平均交互性 = 每个用户 50.4 token/ 秒,运行功率 = 100.89 kW。NVIDIA GB300 NVL72,48 个加速器,1.0.0.kimi-k3.agentic_combined.1 结果,运行 6 个:并发 = 48 个查询,TTFT P90 = 2305.1 毫秒,系统 TPS = 2210.4 token/ 秒,E2E 平均交互性 = 每个用户 56.2 token/ 秒,运行功率 = 60 kW。基于每千瓦吞吐量的比较,共享的最小端到端平均交互性为每位用户 50 个 token/ 秒。资料来源: endpoints.mlcommons.org ,发布日期为 2026 年 11 月 9 日。GB300 结果已通过 MLCommons 协会验证。对于 Vera Rubin 的暂定结果:在等待 MLCommons 协会验证时,结果可能会发生变化,等待同行评审。MLPerf 名称和徽标均为 MLCommons 协会在美国和其他国家 地区的注册商标和非注册商标。保留所有权利。严禁未经授权使用。详情请参见 www.mlcommons.org。
多轮代理式 AI 的服务需求
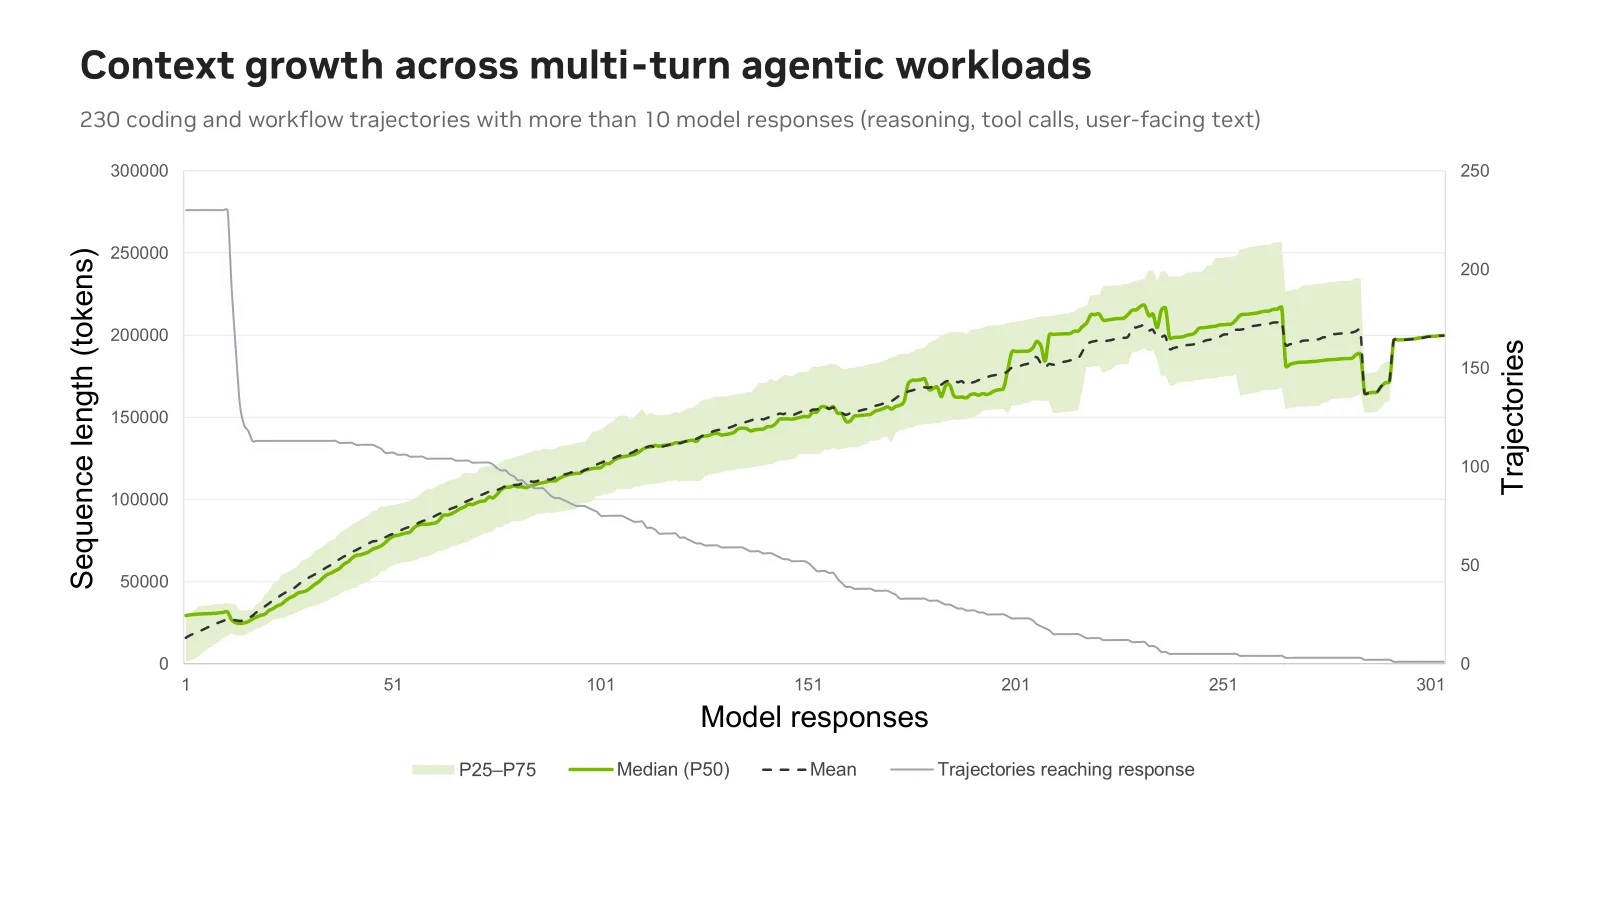
MLPerf Endpoints v1.0 数据集能够捕捉这些工作负载的特征:编码轨迹会累积多个回合的历史记录,而企业工作流则会重复使用共享指令、工具定义和业务规则。图 1 显示了在扩展智能体会话期间,上下文长度在模型响应中的增长情况。
Vera Rubin 可将每千瓦的代理吞吐量提高 10 倍以上
提交的作品涵盖 Kimi K3、Qwen3.6-35B-A3B 和 DeepSeek-V4.1-Flash。表 1 比较了 Vera Rubin NVL72 临时结果与在共享的最小端到端 (E2E) 交互值下每调配千瓦的吞吐量和匹配查询并发下的 E2E 交互性的验证 NVIDIA GB300 NVL72 结果。
| 模型 | 每提供的吞吐量千瓦比 | 端到端交互比 |
|---|---|---|
| Kimi K3 | 10 倍 | 3 倍 |
| DeepSeek-V4.1-Flash | 9 倍 | 5 倍 |
| Qwen3.6-35B-A3B | 5 倍 | 3 倍 |
图 2 显示了每置备千瓦级吞吐量与每条曲线中至少七个并发级别的端到端 (E2E) 交互性之间的权衡。曲线显示了每个系统在给定响应能力要求下提供的吞吐量。阶跃函数图不会在测量点之间进行插值,以便根据已展示的性能 (而非估算值) 进行比较。
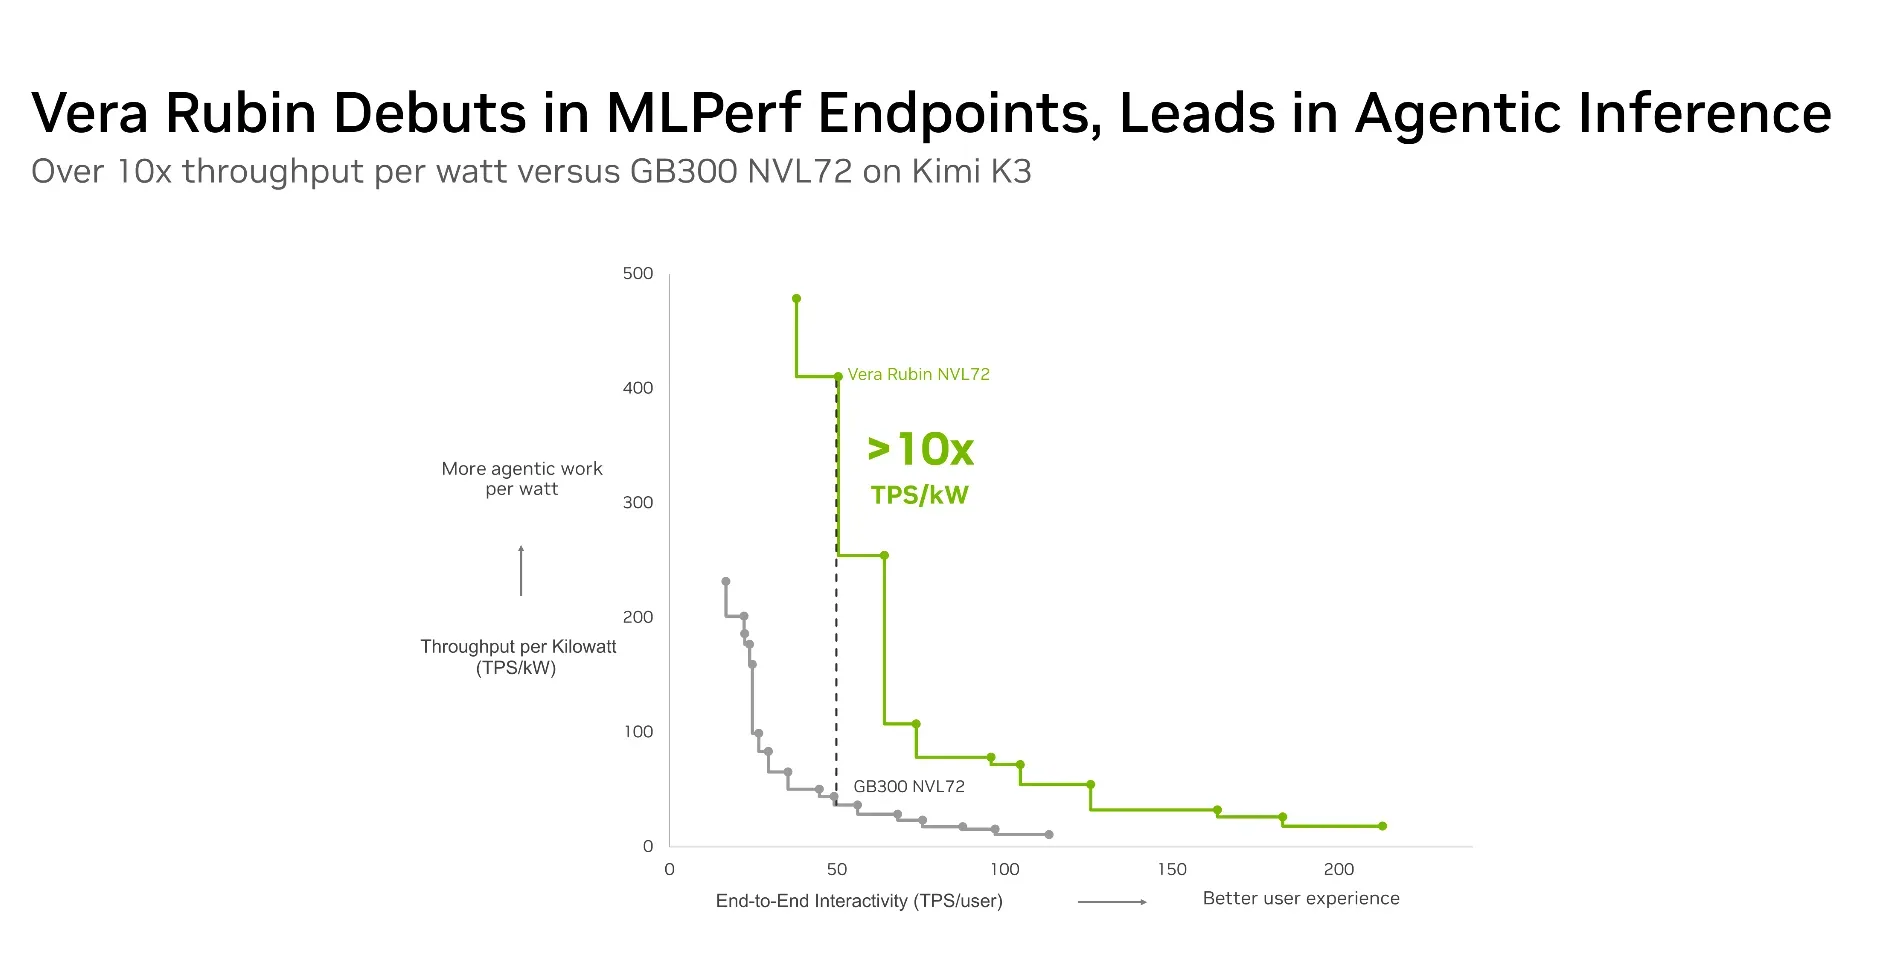
更高的每千瓦吞吐量使组织能够在相同的功率预算内同时运行更多智能体,同时满足相同的响应速度要求。在低并发情况下,更快的响应可缩短延迟敏感型代理式任务的推理等待时间。
针对代理式推理进行硬件和软件优化
NVIDIA Rubin GPU 结合了 HBM4 显存、NVIDIA Tensor Core 和第六代 NVIDIA NVLink ,可满足代理式推理的需求。HBM4 支持快速访问模型权重和对话状态,Tensor Core 加速矩阵运算,NVLink 支持跨 GPU 通信。上下文感知服务和模型特定的内核基于这些功能而构建,可重复使用之前的工作,独立优化预填充和解码,并加速 token 生成,从而将硬件的进步转化为更高的推理能力和更快的交互。
上下文感知服务和模型特定优化可提高推理性能
代理式工作负载会反复重复使用对话历史记录,同时添加新的指令和工具结果。高效服务必须保留可复用的状态,在不同工作节点之间分发请求,并适应提示处理和 token 生成的不同执行要求。前缀缓存、状态重用和 NVIDIA Dynamo 路由有助于减少冗余计算并平衡服务负载,而分离服务支持对预填充和解码进行独立优化。
图 3 总结了上下文感知服务和模型特定 GPU 执行如何支持代理式推理。
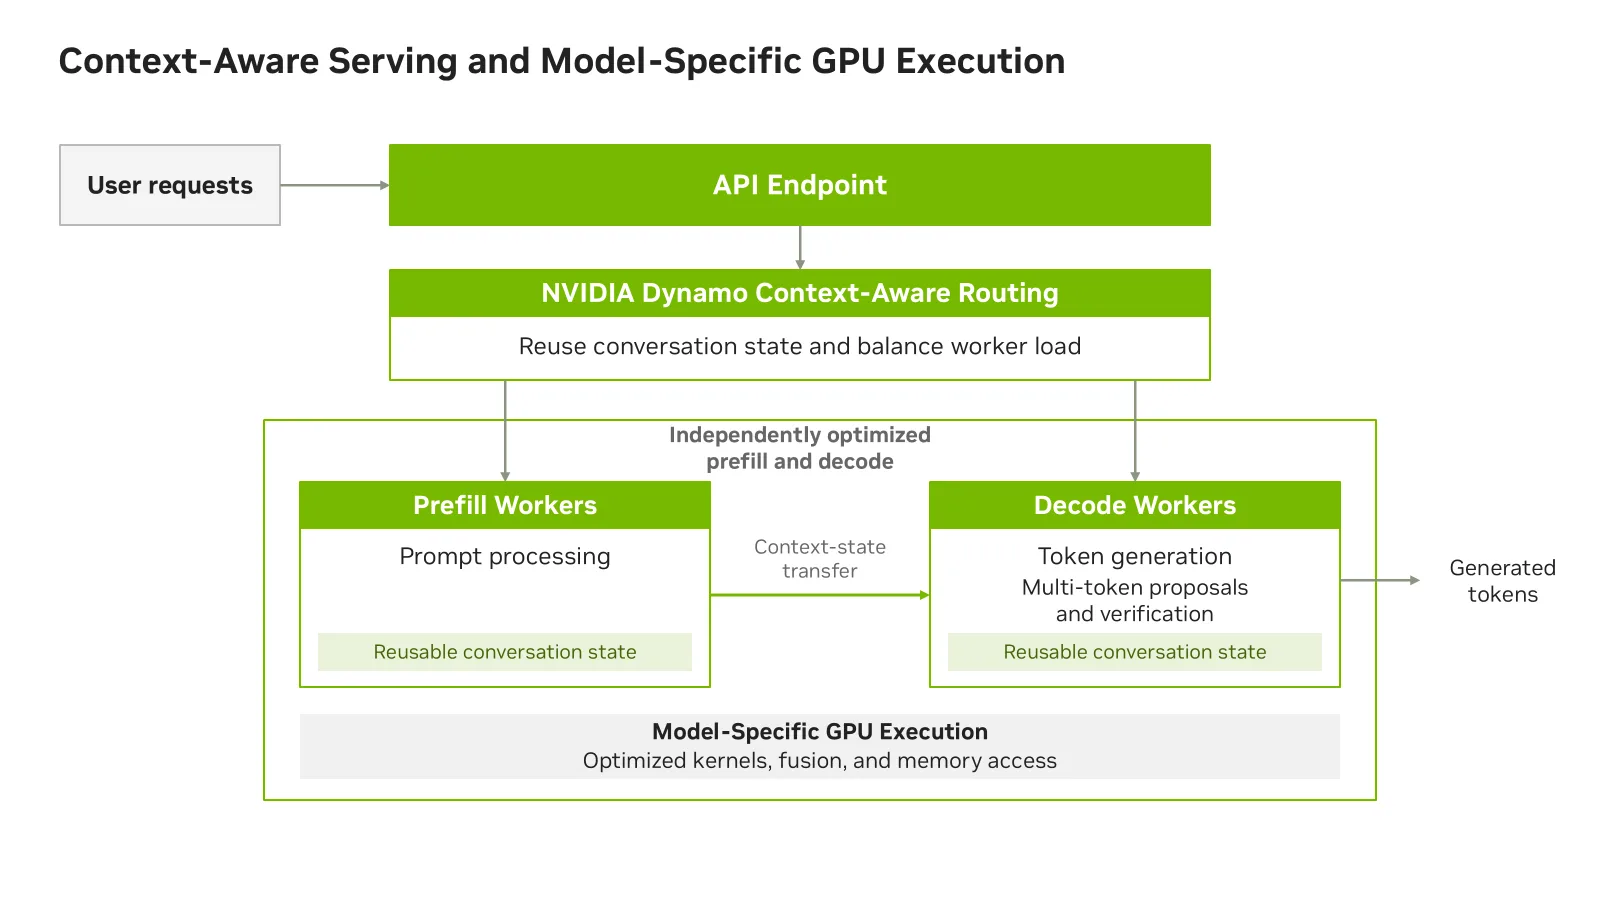
Kimi K3、DeepSeek-V4.1-Flash 和 Qwen3.6-35B-A3B 也具有独特的架构,可受益于有针对性的 GPU 执行改进。模型特定的内核、融合、优化的内存访问和预测验证可减少数据移动和执行开销。表 2 总结了这些服务和执行技术如何在三个模型中协同工作。
| 优化 | 如何提高性能 |
|---|---|
| 上下文重用和路由 | 重用之前处理的对话状态并分发请求,以减少重新计算并平衡工作负载。示例: Qwen 的细粒度前缀匹配会轮次重复使用之前处理的历史记录。 |
| 预填充和解码优化 | 通过解服务独立配置提示处理和 token 生成,从而减少争用和同步等待时间。示例: Kimi 将解服务与预填充更改相结合,可减少 GPU 同步等待时间。 |
| 特定模型的 GPU 执行 | 定制每个架构的内核、融合和内存访问,减少内核启动和数据移动。示例: DeepSeek 的 MegaMoE 内核使用 Rubin GPU 局部性和矩阵乘法指令。 |
| 预测生成和验证 | 提出多个 token 并一起验证,从而减少顺序解码步骤。示例: Qwen 的多 token 预测将 token 提案与 Tensor Core 验证配对。 |
为代理式 AI 打造更高效的基础设施
代理式推理性能取决于硬件、系统架构和服务软件的协同设计。MLPerf Endpoints v1.0 的初步结果显示了 Vera Rubin 平台如何将这些功能结合在一起,以满足代理式工作负载的需求,并创造更多能力来服务用户和扩展应用。
在配套博客文章中详细了解 NVIDIA 训练和推理性能。
致谢
Richard Cai、Viraat Chandra、Xiaoming Chen、Zhenhuan Chen、Alice Cheng、Julien Darve、Ashutosh Dhar、Kefeng Duan、Alec Flowers、Ann Guan、Jie Hao、Rashid Kaleem、Tzu-Ling Kan、Tuhin Khare、Zihao Kong、Jonas Li、Shicheng Li、Y 京 Li、Allison Lim、Yanchao Lu、Bofeng Luo、Mingyuan Ma、Matthias Maiterth、Yibai Meng、Stanley Cheong Kwan Phoong、Hanjie Qiu、Zhongdao Ren、Tong Tong、Harshil Vagadia、Li

