

联邦学习 (FL) 项目通常从简单的设置开始:一个服务器、几个客户端和每个站点的一个数据集。随着这些项目的发展,挑战从运行算法转向运行共享基础设施。必须在作业需要时分配 GPU,必须将多项研究分开,并且每个参与的组织必须保留对自己的数据、机密和计算策略的控制。
当组织依赖于不同的环境时,运营的复杂性就会增加。一个站点可能使用 Docker 主机,另一个站点可能运行 Kubernetes 集群,研究中心可能使用 Slurm 安排其 GPU 工作负载。要求每个参与者采用相同的基础架构可以将平台标准化转变为协作的先决条件。
NVIDIA FLARE 通过将持久联邦与执行每项作业的进程分开来解决这一挑战。
FLARE 的两层架构将持久性联合服务与作业执行分开,允许同一联合中的每个站点使用适合其基础设施的执行后端,例如,一个站点的 Docker、另一个站点的 Kubernetes 以及第三个站点的 Slurm。每个站点都保留对计算分配以及每个研究使用的数据集、图像、机密和调度策略的本地控制
Docker 和 Kubernetes 部署支持在 NVIDIA FLARE 2.8 中提供。FLARE 2.9 增加了对 Slurm 的支持。
将联合协调与作业执行分离
FLARE 部署有两个操作层。长期运行的服务器和客户端父进程可维护联合、验证连接并协调工作。单独的服务器和客户端作业工作者执行已提交的 FL 作业。
这种分离实现了资源感知型执行。父进程可以保持可用,而不会占用训练所需的 GPU。当数据科学家提交作业时,每位家长都会通过其配置的执行平台启动一个 worker。工作者接收作业、使用请求的资源、返回其结果,并在其工作完成后退出。
该作业将资源意图与平台详细信息分开描述。作业可以请求 GPU、完整的可调度 CPU 单元和主机内存。每个站点的启动程序都会将这些要求与本地学习配置相结合,并将其转换为 Docker 容器、Kubernetes Pod 或 Slurm 分配。
这些层共同保持联合服务的可用性,同时在每个站点按需创建在职工作者及其资源。
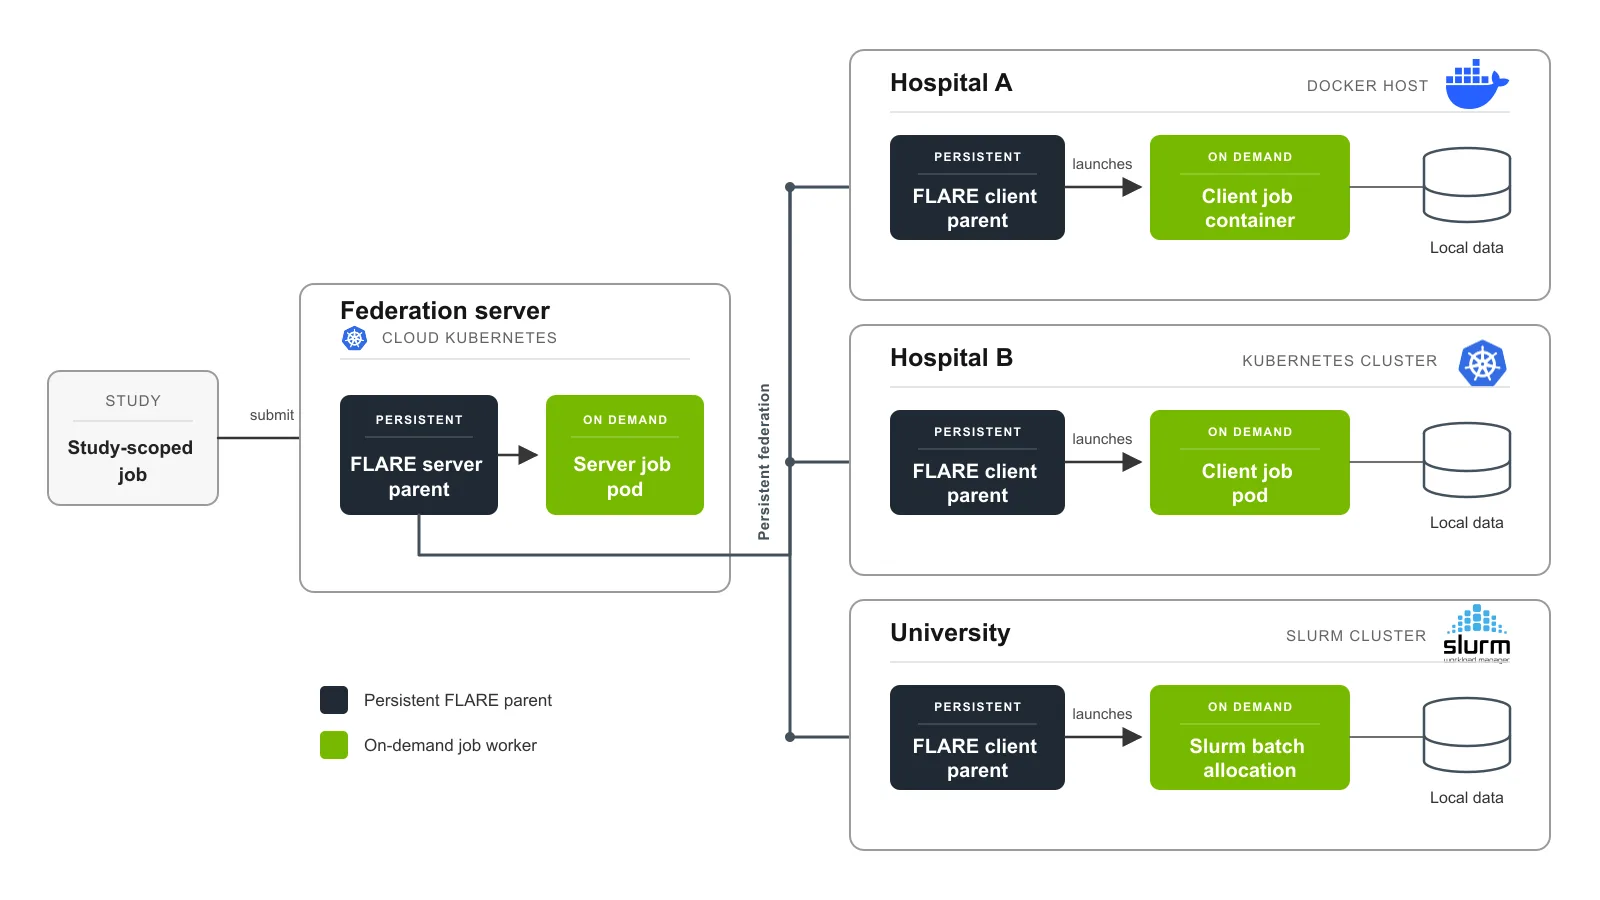
使用 Docker、Kubernetes 和 Slurm 部署作业工作者
NVIDIA FLARE 与标准部署和调度系统集成。site operator 选择与本地环境相匹配的运行时,并继续对其策略负责。
| 运行时 | 典型环境 | 动态执行单元 | 资源权限 |
|---|---|---|---|
| Docker | 工作站或单主机站点 | 工作容器 | Docker 主机 |
| Kubernetes | 云端或本地集群 | 工作 pod | Kubernetes 调度程序 |
| Slurm | HPC 或共享 GPU 集群 | 批量分配 | Slurm 调度程序 |
用于在一台主机上执行容器化操作的 Docker
Docker 是工作站、实验室服务器、边缘系统或其他单主机环境的实用选择。持久 FLARE 服务器或客户端运行在基于父镜像构建的父容器中。对于每个提交的作业,FLARE 会动态启动基于作业镜像构建的单独作业容器。
父镜像包含 FLARE 运行时和启动容器所需的组件。单独的工作镜像可包含训练框架、模型代码和应用程序依赖项。站点可以通过 NVIDIA 容器工具包将请求的 GPU 公开给作业容器,并使用 Docker 设置来满足共享内存、挂载、网络和其他特定于主机的需求。
将父图像和工作图像分开也会使更新变得更容易。基础架构所有者可以保持父环境的稳定性,而研究人员则可以根据站点的图像和代码审批政策独立更新其训练环境。
用于动态调度作业 POD 的 Kubernetes
在 Kubernetes 中,Helm 图表会将每个持久 FLARE 服务器或客户端作为父 POD 进行安装。对于每个提交的作业,父作业都会创建一个单独的服务器或客户端作业 Pod。Kubernetes 调度程序根据其 CPU、内存、GPU、存储和放置要求放置该 Pod。
此方法可将 FLARE 作业与熟悉的 Kubernetes 功能相连接。站点可以使用命名空间、服务账户、机密、持久卷、节点选择器、容限和准入策略。例如,一项研究可以使用 Pod 模板选择 H100 节点,而另一项研究则使用不同的节点池。
平台运营商为其集群配置存储类、注册表凭据、网络策略、GPU 支持和基于角色的访问控制 (RBAC) 。FLARE 使用这些服务来启动和监控作业 POD。
用于调度 GPU 和多节点分配的 Slurm
许多大学、研究中心和企业计算环境使用 Slurm 共享 GPU 集群。FLARE Slurm 启动程序将每个服务器或客户端工作者作为批量作业提交。Slurm 选择计算节点并强制执行请求的 GPU、CPU、内存、分区、账户、服务质量 (QoS) 和时间限制。
作业可以请求单个或多个节点。FLARE 会提交分配,监控其状态,传播完成或失败,并在需要时取消分配。该启动程序支持裸执行 (无沙盒) 、Pyxis/ Enroot 容器和 Apptainer 容器。
Slurm 仍然是资源的权威。其账户、关联、分区、QoS 规则、cgroups、文件系统权限和设备控制决定了分配的用途。这将保留集群管理员已用于非联邦工作负载的操作模型。
NVIDIA FLARE 提供参与者身份验证、安全通信和授权,同时每个站点的执行平台执行本地资源和工作负载策略。站点操作员配置主机和集群安全性、经批准的镜像、机密和访问控制,并验证所选运行时的工作负载隔离。
将研究与研究分离
共享基础架构带来了另一个问题:多个团队如何在不混合用户、作业或数据的情况下运行 FL 研究?
FLARE 研究可在一次部署中提供逻辑多租户边界。每个研究都定义了其参与的客户网站以及可以为该研究打开会话的管理员用户。研究感知型操作会限制作业可见性、客户状态、提交目标和当前研究的部署地图。
在每个参与站点继续研究边界。站点拥有的 local/study_runtime.yaml 文件将研究映射到可在本地使用的资源。根据运行时,此配置可以定义:
- 数据集挂载
- 环境变量
- 由机密支持的环境变量和文件挂载
- 站点批准的默认作业镜像
- Kubernetes Pod 模板
- Docker 运行时设置
- Slurm 沙盒、分区、账户和 QoS 策略
数据科学家通过打开研究范围的会议来选择研究,该会议中提交的作业将继承研究上下文。这些作业不会选择任意的本地数据集路径或提供机密值。在作业到达站点之前,FLARE 服务器会验证研究成员资格,而站点操作员则控制将该研究映射到本地资源。
以下简短的 Kubernetes 示例将病理学研究映射到站点拥有的数据量和数据库凭据。配置包含对“秘密 ( Secret) ”的引用,而非其值。
format_version: 2

studies:
  pathology:
    container:
      image: registry.example.com/pathology-trainer:1.0
    datasets:
      slides:
        source: pathology-data-pvc
        mode: ro
    secret_env:
      DB_USER: {source: pathology-db, key: username}
      DB_PASSWORD: {source: pathology-db, key: password}
当从病理范围内的会话中提交的作业到达此站点时,Kubernetes 启动程序会选择匹配的 studies.pathology 条目。启动程序将研究图像用作本地默认值,并在作业容器内的 /data/pathology/slides 处以只读方式加载病理数据 – pvc 卷。挂载路径源自研究,数据集名称为 /data/<study>/<dataset>。
在 POD 规范中,secret_env 条目将成为 Kubernetes secretKeyRef 引用。启动 Pod 时,Kubernetes 会从 pathology-db Secret 中注入 username 和 password 值。这样可将凭据值保留在站点的秘密存储区中,同时为研究人员提供所需的环境。
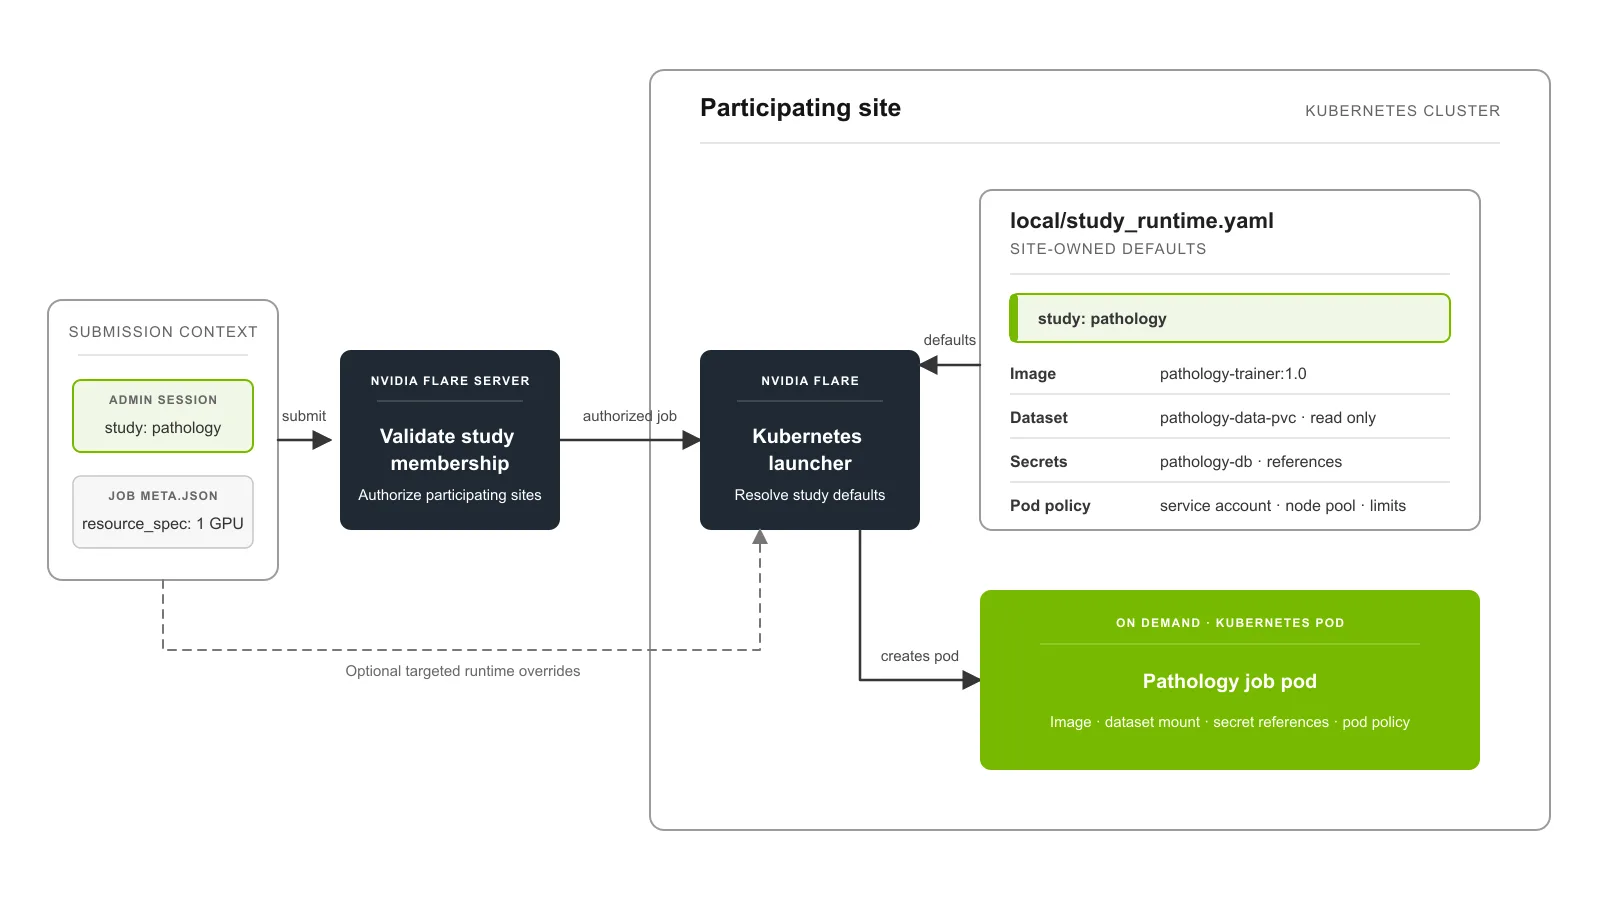
研究面向共享相同 FLARE 服务器和公钥基础设施 (PKI) 但需要在实验之间进行逻辑分离的组织。如果组织需要单独的 PKI、基础设施管理员或故障排除半径,则应使用单独的 FLARE 部署。
将异构联邦整合在一起
在上文图 1 所示的联合中,病理学研究使用 GPU 工作人员和每个站点的经批准的图像数据集,将医院和大学联系在一起。结果研究仅涵盖医院,并使用 CPU 工作人员分析结构化临床数据。
这两项研究共享联邦的持久性服务。研究成员资格决定参与的站点,而每个站点的研究配置为其工作人员提供数据集、图像、机密和调度设置。研究人员在相应的研究会话中提交作业,然后本地启动器应用这些设置。
提交作业
FLARE 2.9 在作业的 meta.json 中的 resource_spec 中支持便携式 GPU、CPU 和主机内存要求。可移植密钥为 num_of_gpus、num_of_cpus 和 memory。CPU 值表示整个可调度 CPU 单元,内存使用正整数,单位为 Mi、Gi 或 Ti。
@default 条目会对每个目标站点 (包括服务器) 应用一个资源配置文件。命名的客户端或服务器条目仅提供不同的值。在本示例中,两家医院都继承了一个 GPU、四个 CPU 单元和 64 GiB 内存。大学系统覆盖 GPU 数量,而服务器系统覆盖 GPU 数量,使其变为零。两者都继承相同的 CPU 和内存需求。
{
  "resource_spec": {
    "@default": {
      "num_of_gpus": 1,
      "num_of_cpus": 4,
      "memory": "64Gi"
    },
    "server": {"num_of_gpus": 0},
    "university": {"num_of_gpus": 8}
  }
}
每个启动程序都会将解析出的值转换为原生设置。Docker 将四个 CPU 单元转换为 nano_cpus=4000000000,将 64 GiB 转换为字节值的 mem_limit,并应用 GPU 设备请求。Kubernetes 设置匹配的 CPU 和内存请求,限制并添加 GPU 请求。Slurm 会发出 --cpus-per-task=4、--mem=65536M 以及相应的 GPU --gres 值。
数据科学家打开一个研究范围的会议,并将作业提交一次至 FLARE 服务器,然后由 FLARE 服务器将作业部署给研究的参与者。在每个站点,配置的启动程序都会应用研究的本地运行时默认值并创建工作进程。FLARE 可协调联合工作流并报告作业状态,而 Docker、Kubernetes 和 Slurm 则可管理本地资源。
将 launcher_spec 用于后端特定的拓扑和策略,例如 Slurm 节点布局或运行时特定的图像。该研究运行时配置为每个站点提供经批准的图像、数据集、机密和执行策略的本地默认值。
这能实现什么
联合学习基础设施不需要在所有参与者之间实现统一。FLARE 将持久性联合服务与动态启动的作业工作者分开,以便每个站点都可以使用 Docker、Kubernetes 或 Slurm。研究为数据、机密、图像和调度策略添加范围内成员和站点拥有的映射。
这些功能相结合,使一个联邦能够跨越本地系统和云,而无需强制每个组织使用同一平台。站点可以在作业需要时分配 GPU 和其他资源,继续使用其现有的操作控制,并对独立管理的数据进行多项研究。异构基础设施成为联盟设计的一部分,而不是扩展的障碍。
首先,请查看 NVIDIA FLARE 文档 和 NVIDIA FLARE GitHub 资源库。


