

AI 智能体正从云数据中心转向车辆、机器人和其他边缘设备。与只回答单个提示的聊天机器人不同,智能体需要执行一系列步骤。它会选择工具、评估结果,并在越来越长的对话中继续推理。
此工作流对边缘推理提出了新的要求。该模型必须快速生成 token,高效处理较长的共享历史记录,并在有限的功率和内存范围内生成有效的工具调用。
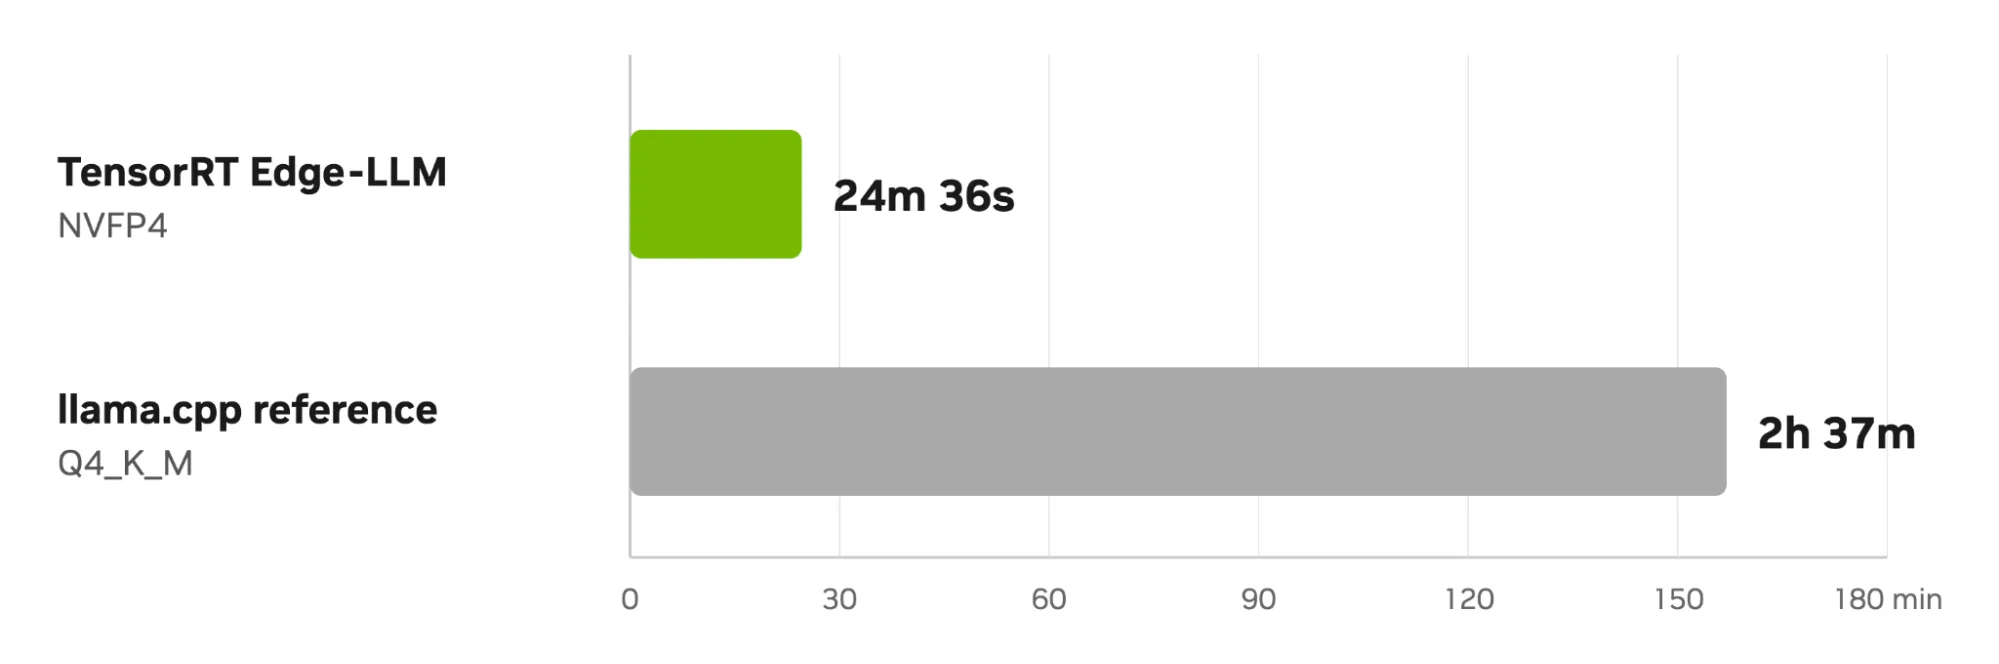
在 MLPerf Inference v6.1 Edge Agentic 基准测试中,NVIDIA TensorRT Edge-LLM 在单个 NVIDIA Jetson AGX Thor 开发者套件上运行 Qwen3.6-27B。该系统每秒可生成 52.33 个token,并在 24 分钟 36 秒内完成所有 1007 轮性能工作负载,比 llama.cpp 2 小时 37 分钟的参考提交快 6.4 倍。结果使用 NVFP4 量化、基于树的多token预测 (MTP) 和 KV 缓存重用。
MLPerf 如何衡量端到端代理式 AI 性能
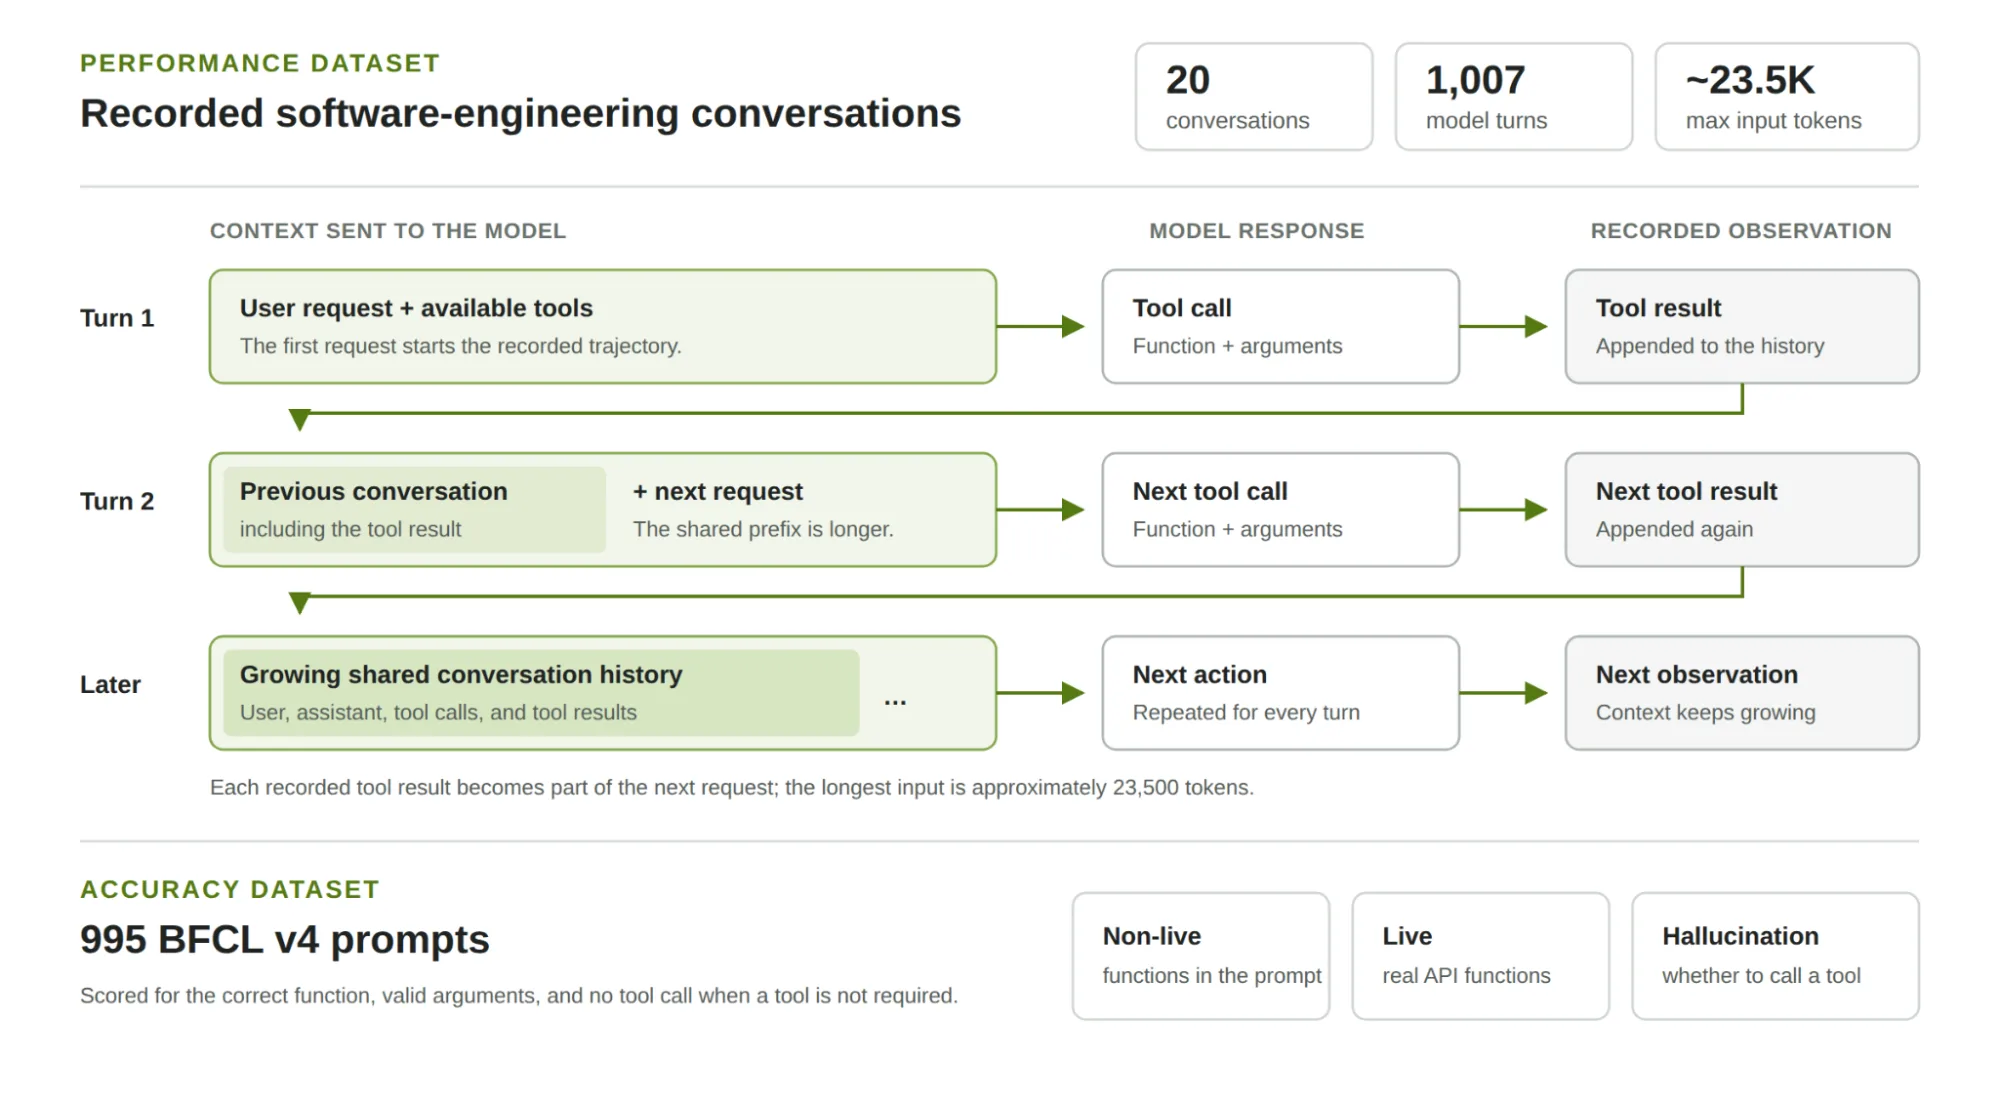
MLPerf Edge Agentic 分两个阶段来衡量兼容 OpenAI 的模型端点:性能和准确性。
性能阶段回放录制的软件工程智能体轨迹。模型会接收用户请求,生成工具调用,观察工具结果,然后继续相同的对话。工作负载包含 20 次对话和生成的 1007 个回合。输入长度会逐渐增加,达到约 23.5 K 个 token,这使得长上下文处理成为测量的重要组成部分。此外,还测量了基于交并比 (IoU) 的在线准确性,以确保在性能阶段正确运行智能体。
准确性阶段使用 Berkeley Function Calling Leaderboard (BFCL) v4 提示,仅支持单圈推理,可在边缘设备上平衡准确性和评估时间。它会评估模型是否选择正确的函数、生成有效的参数,并避免在不需要工具时调用工具。
Jetson AGX Thor 上的 MLPerf Edge Agentic 基准测试结果
TensorRT Edge-LLM 提交作品在单流模式下使用 Qwen3.6-27B,在一个 Jetson AGX Thor 开发者套件上使用,在 MAXN 电源模式下具有 128 GB 的统一内存。
| 指标 | 结果 |
|---|---|
| 输出吞吐量 | 每秒 52.33 个token |
| 第一个token的中值时间 | 247.12 毫秒 |
| 每个输出token的中位时间 | 14.68 毫秒 |
| BFCL 整体精度 | 87.94% |
表 1. MLPerf v6.1 NVIDIA Edge Agentic 提交结果摘要
MLCommons Edge Agentic 示例还发布了在 Jetson AGX Thor 上运行的 llama.cpp 参考,该参考使用 Qwen3.6-27B 和 Q4_K_M 量化,在 2 小时 37 分钟内完成。TensorRT Edge-LLM 提交可在 24 分钟 36 秒内完成工作负载,即时间缩短至原来的 6.4 倍。
使用 NVFP4 量化加速 Qwen3.6-27B 推理
众所周知,边缘平台上的低批量 LLM 解码受 DRAM 带宽的严格限制。减小权重和激活函数的大小可减少内核的内存占用,从而提高解码性能。
提交的 Qwen3.6-27B 模型使用 NVFP4 进行权重和激活,包括语言模型头,并使用 FP8 进行 KV 缓存。NVFP4 是一种 4 位浮点格式,由 Jetson AGX Thor 中的 NVIDIA Blackwell GPU 提供支持。TensorRT Edge-LLM 使用经过优化的内核来加速量化模型,同时保持 MLPerf 所需的准确性。
较小的模型表示还可以为长上下文、预测解码状态和应用程序工作负载提供更多的 128 GB 统一显存。开发者可以从已发布且经过校准的 Qwen3.6-27B NVFP4 检查点入手。部署团队可以使用已发布的量化检查点,也可以在部署模型之前在任何开发系统上执行一次后训练量化。
在代理轮次中重复使用 KV 缓存
智能体轨迹中的每个新请求都包含之前的大部分对话以及新的模型响应或工具结果。如果不重复使用,模型必须在每次回合中再次预先填充共享历史记录。成本会随着对话的增长而增加。
TensorRT Edge-LLM 可识别可重复使用的提示词前缀,并恢复其缓存的注意力 KV 页面。Qwen3.6 使用混合模型架构,因此运行时还会恢复正确继续执行所需的递归状态和部分 KV 页面状态。然后,它只预先填充对话的新后缀。
KV 缓存和循环状态重用可减少整个智能体轨迹中重复的长上下文计算。此优化是对基于树的 MTP 的补充:缓存重用可在开始生成之前降低成本,而 MTP 可在生成过程中减少目标模型步骤的数量。
在此工作负载中,约 96% 的提示token通过热缓存提供。在总计 1360 万个提示token中,运行时仅预填充约 50 万个。
使用基于树的多 token 预测加速 LLM 推理
标准自回归解码会为每个模型调用生成一个 token。多token预测使用草稿模型预测多个未来token,然后由目标模型一起验证。最新模型通常使用官方 MTP 权重进行训练,并与主模型一起提供。
除了传统的线性 MTP,TensorRT Edge-LLM 还实现了基于树的 MTP 实现。运行时不会只保留一个预测的延续,而是会将高概率候选项整理成树。目标模型在一次正向传递中验证候选项,运行时接受匹配的路径。如果接受多个候选项,系统会按多个 token 推进生成。
启动服务器时,您可以调整绘图参数。MLPerf 服务器配置使用 8 个草稿步骤、每个草稿深度的前 2 个候选项以及 16 个节点的验证树。基于树的验证对于函数调用非常有用,因为工具名称、JSON 语法和常见参数结构通常是可预测的,而多个分支可以为单个参数值保留可能的替代方案。与具有 3 个草图步骤的线性 MTP 相比,基于树的 MTP 可将此工作负载的解码性能额外提升约 40%。
如何运行 MLPerf Edge Agentic 基准测试
用于此提交的实现可在 TensorRT Edge-LLM 版本/ 0.9.1-mlpinf 分支中获取。该分支包括模型导出设置、TensorRT 引擎构建命令、服务器配置和 MLPerf 客户端配置
1. 克隆 TensorRT Edge-LLM 并初始化其子模块。
git clone --branch release/0.9.1-mlpinf \
  https://github.com/NVIDIA/TensorRT-Edge-LLM.git
cd TensorRT-Edge-LLM
git submodule update --init --recursive
2. 下载经过校准的 NVFP4 检查点。
huggingface-cli download \
  centml/Qwen3.6-27B-NVFP4-W4A4-mlpinf \
--local-dir "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf"
3. 按照 mlperf/README.md 构建 TensorRT Edge-LLM,使用树 – MTP 接口导出检查点,并构建基础和草稿 TensorRT 引擎。
$VENV/bin/python -m tensorrt_edgellm.scripts.export \
  "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf" \
  "$WORK/onnx" \
--mtp-tree-base --skip-visual
4. 启动兼容 OpenAI 的 TensorRT Edge-LLM 服务器。
export REPO="$PWD"
export VENV=/path/to/venv-edgellm-export
export WORK=/path/to/mlperf-artifacts
bash mlperf/serve_edgellm.sh
5. 克隆 MLCommons 端点工具,安装其 BFCL 依赖项,在 mlperf/config.yaml 中更新模型和分词器路径,然后运行基准测试。
git clone https://github.com/mlcommons/endpoints.git
cd endpoints
python3.12 -m venv .venv
source .venv/bin/activate
pip install -e ".[dev,bfcl]"

inference-endpoint benchmark from-config \
--config "$REPO/mlperf/config.yaml"
所提供的配置运行温度为 0、种子值为 42、推理禁用和并发值为 1 的性能和准确性阶段。使用 --accuracy-only 选项仅运行 BFCL 精度阶段。有关数据集和客户端配置的更多信息,请参阅 MLCommons Edge Agentic 示例。
有关 MLPerf Inference v6.1 在所有提交作品中的完整结果,请参阅 MLCommons 公告。有关服务器规模的 Vera Rubin 性能,请参阅 NVIDIA Vera Rubin NVL72 在 MLPerf Inference v6.1 首次亮相时提供的领先性能。
致谢
这项工作代表了 NVIDIA 的 TensorRT Edge-LLM、ModelOpt、Jetson 和 MLPerf 团队所做的贡献,尤其是孔子浩、郭祥、肖宇科、李启和 Ashwin Nanjappa。感谢 MLCommons 社区开发 Edge Agentic 基准测试和端点工具。


