

NVIDIA KGMON 团队在 KDD Cup 2026 Data Agents 比赛中获得第二名,他们所使用的系统基于一个简单的理念,即让智能体的线束更小、更清晰且更易于验证。
比赛要求智能体通过异构数据源回答自然语言问题,包括数据库、CSV 和 JSON 文件、散文文档、PDF 和简报视频。每项任务都需要的不仅仅是检索,智能体需要检查可用数据、选择合适的工具、进行跨来源推理、生成最终答案文件,以及处理分析工作流中出现的陷阱。
KDD 还要求团队使用小型固定 LLM为智能体提供动力支持,从而使其成为主要的优化平台。该团队旨在通过预处理、约束工具、持久性状态和评估,简化可用模型的任务。在围绕较小的开放模型构建可靠系统时,这些技术尤其有用。
本文将分享其结果背后的剧本。这并不是每个数据科学智能体的通用配方,但更广泛的经验适用于许多智能体系统。使模型更加开放通常会降低可靠性,而围绕该模型构建正确的工具则更多。
系统背后的两个原则
两个原则塑造了这个系统。
首先,限制动作空间。检查数据、调用工具、写入文件或从错误中恢复的方法过多都会导致失败。KGMON 统一了数据访问,提供了一个小工具集,并要求最终答案遵循单个输出路径。
其次,让每一次尝试都可被检查。运行可能会因错误的工具调用、错误的连接、未遵守的文档规则或答案格式问题而失败。执行痕迹、重复尝试和轨迹检查帮助团队识别故障并优化线束。图 1 显示了整个工作流程。
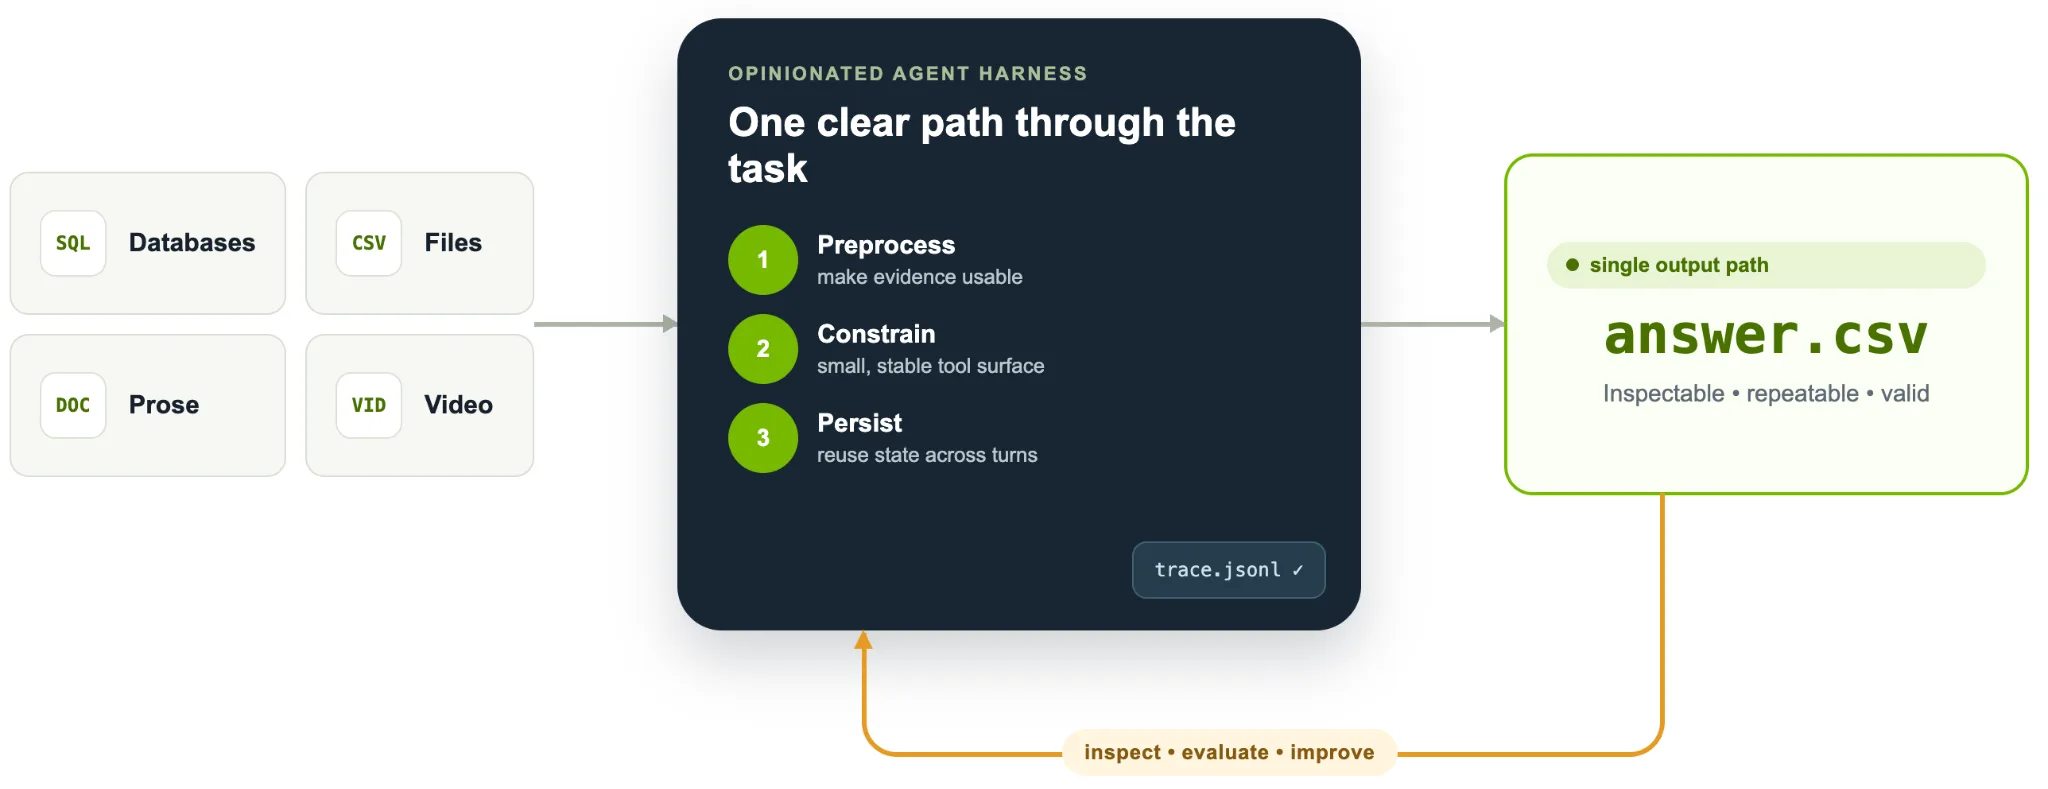
以下技术为构建可靠的数据分析智能体提供了实用指导。
1. 将结构化源转换为一个查询面
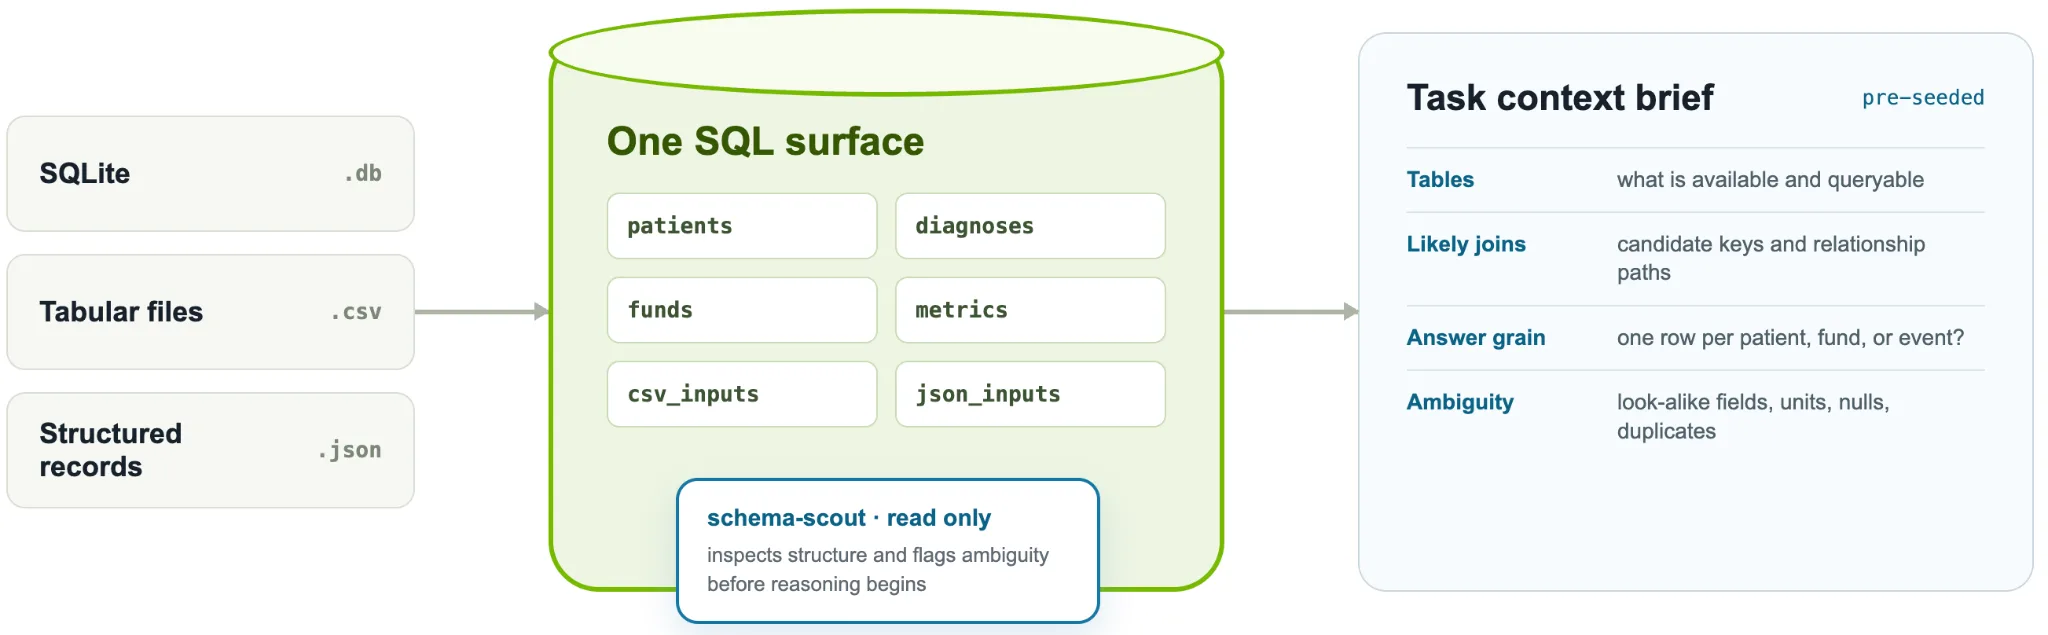
每个 KDD 任务都可以组合 SQL 数据库、CSV 和 JSON 文件、文档和视频。KGMON 将 CSV 和 JSON 文件转换为现有 SQLite 数据库中的表格,从而为智能体提供一个 SQL 接口来处理所有结构化数据。
KGMON 的自定义持久性 Python 环境提供了两个用于检查和查询统一数据表面的内置函数:
schema()
sql(query)
这些自定义函数为智能体提供了一种发现和查询结构化数据的单一方法。它们内置于 KGMON 的环境中,而不是由 Python 或 SQLite 提供。
单一 SQL 接口可减少路由失败和浪费的次数,从而为固定模型留出更多空间,以便对数据进行推理。
应用此方法:在智能体启动之前对结构化数据的访问进行规范化。临时 SQLite 数据库、虚拟化查询层或受治理的仓库接口可以提供稳定、窄且记录良好的查询面。
2. 预先为智能体输入模式上下文
KGMON 在主推理循环之前添加了模式探索步骤。系统会检查表格、列、可能的连接键、重复名称、相似性字段、单元、空模式和行纹问题。
智能体在每个任务开始时收到此模式上下文,从而节省了早期发现时间。
Schema scouting 可减少错误列、漏入连接或混淆每个答案行应代表的内容而导致的错误。图 2 显示了提供给智能体的统一 SQL 接口和模式上下文。
应用此方法:添加只读预检步骤,向智能体简要介绍可用表格、可能的连接、关键列、单元、可疑字段以及已知的模糊之处。这可能比其他检索工具更有用。
3. 构建一个小巧的工具工具
KGMON 将该智能体限制为用于模式检查、SQL 查询、文档查找、散文提取和答案写作的助手。
环境中提供了以下功能:
schema()       	# inspect tables and columns
sql(query)     	# query context.db
write_answer(df)   # write the final answer atomically
prose_helper() 	# answer from prose or extract prose into SQL
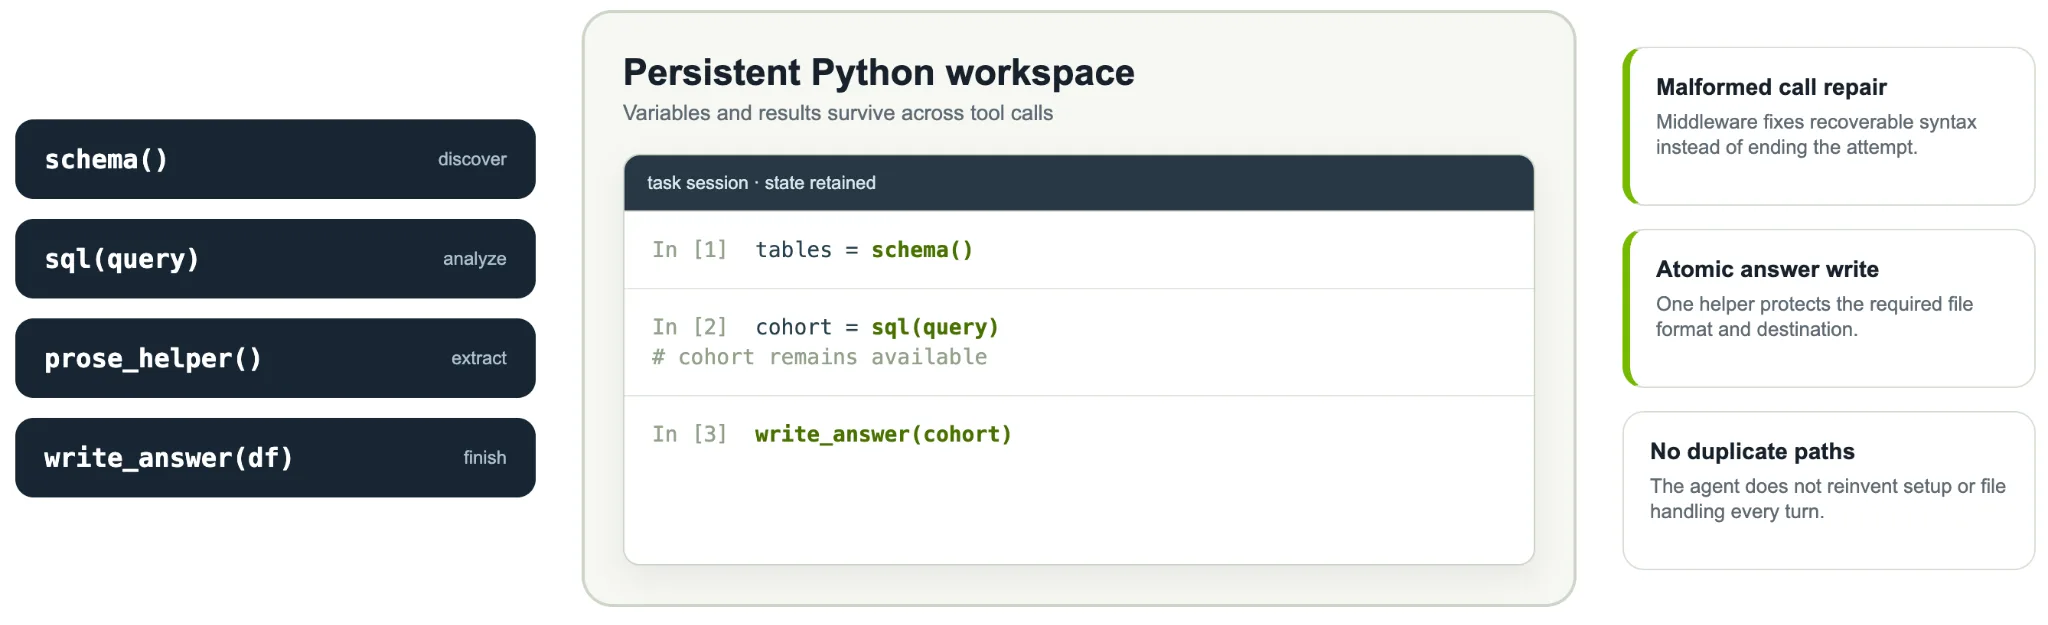
中间件修复了格式错误的工具调用,因此一次错误调用并没有结束尝试。
有状态 Python 环境会在工具调用之间保留变量,让智能体能够重复使用中间结果。schema()、sql(query) 和 write_answer(df) 等预定义函数可减少样板、语法错误和文件处理错误。这节省了轮次,并让小型 LLM 专注于分析。图 3 显示了环境的功能、持久性状态和错误处理。
简短、有效的尝试为额外的运行、评估和集成留下了更多的轮次,可组合多次尝试的结果。
应用此方法:根据工作流要求设计工具并删除重复路径。经批准的运行 SQL 或编写答案的单一方式可减少损坏状态或产生无效输出的机会。
4. 将散文视为第一类输入,但要将其与结构化数据分开
分析工作流通常包括 PDF、Markdown 文件、文档、策略文本、说明和报告。在某些 KDD 任务中,这些来源包含回答问题所需的值、规则、定义和类似表格的记录。
大型文档可能会使用 LLM 的上下文窗口。KGMON 通过 Python 的 open() 函数或 .read() 方法阻止了整个文件的直接读取,提供了通过字符数量或正则表达式 (regex) 匹配来限制预览和搜索的工具。
找到相关部分后,智能体可以调用 prose_helper,这是一种自定义工具,可将文档块传递给单独的 LLM 调用,并将温度设置为 0 并禁用推理。它返回答案或提取表格,将原始文档内容排除在主智能体的上下文之外。
Figure 4 shows the document-inspection workflow. KGMON used prose_helper in two modes:
mode="answer"  # extract a rule, threshold, or short answer
mode="table"   # extract repeating records into a SQL table
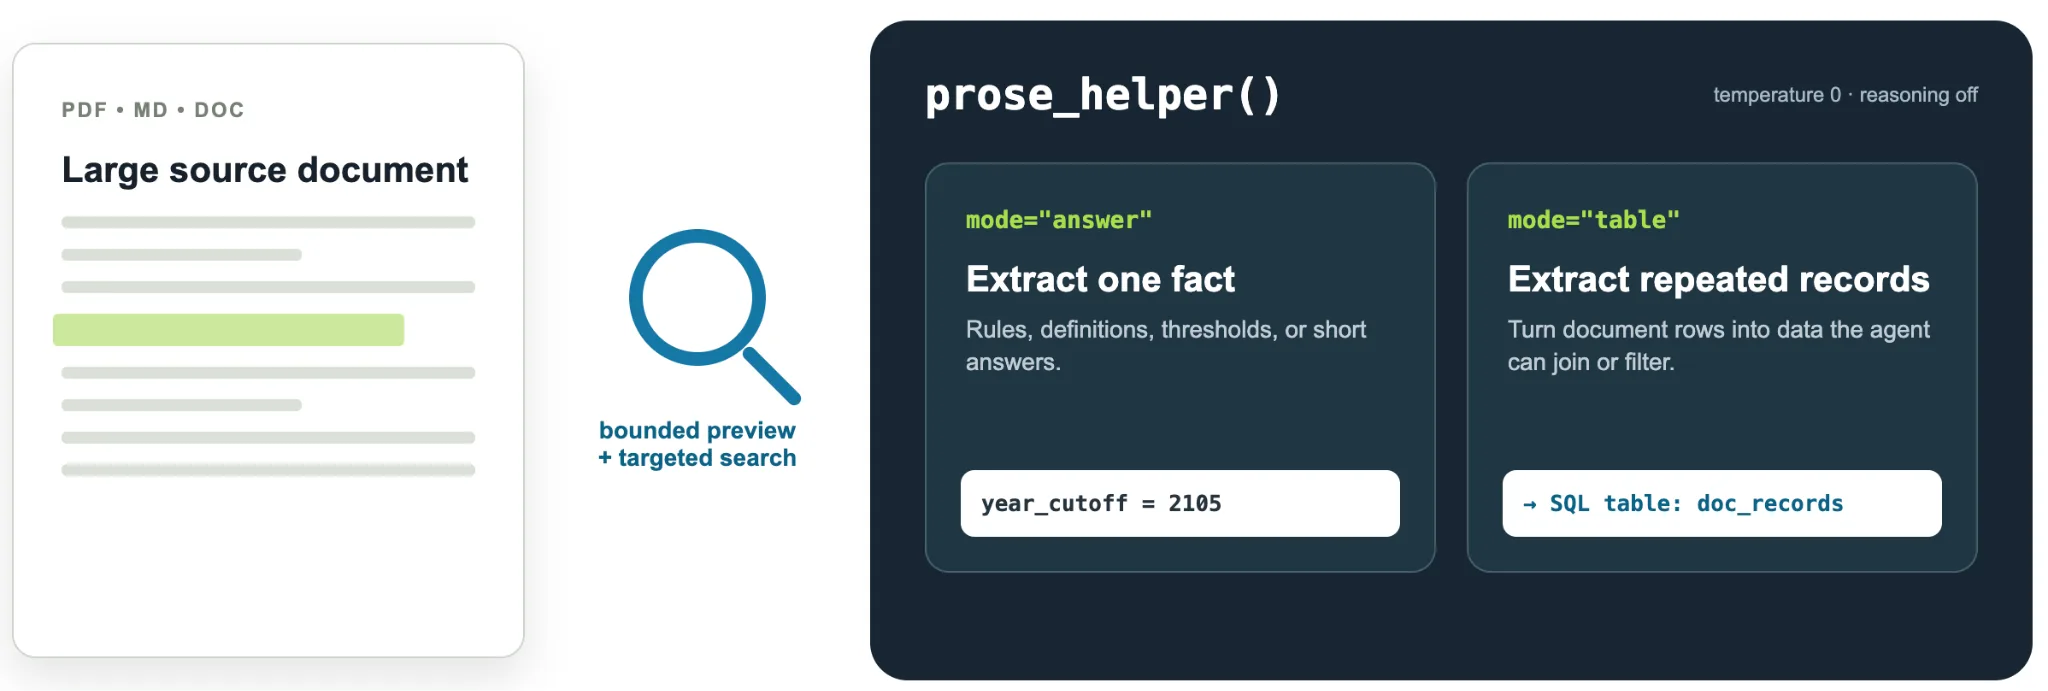
通过从散文中提取规则,智能体可以在 SQL 分析中应用这些规则,同时保持专注于其工作上下文。
重要警告:表格提取适用于在文档中嵌入结构化信息的竞争任务。生产系统可能只需要有针对性的散文查找;表格提取仍然是可选的。
应用此方法:提供文档检查工具,回答目标问题并引用来源,而无需将整个文档加载到主智能体的上下文中。当文档包含需要连接或筛选的重复记录时,添加表提取。
5. 对任务中的视频进行预处理
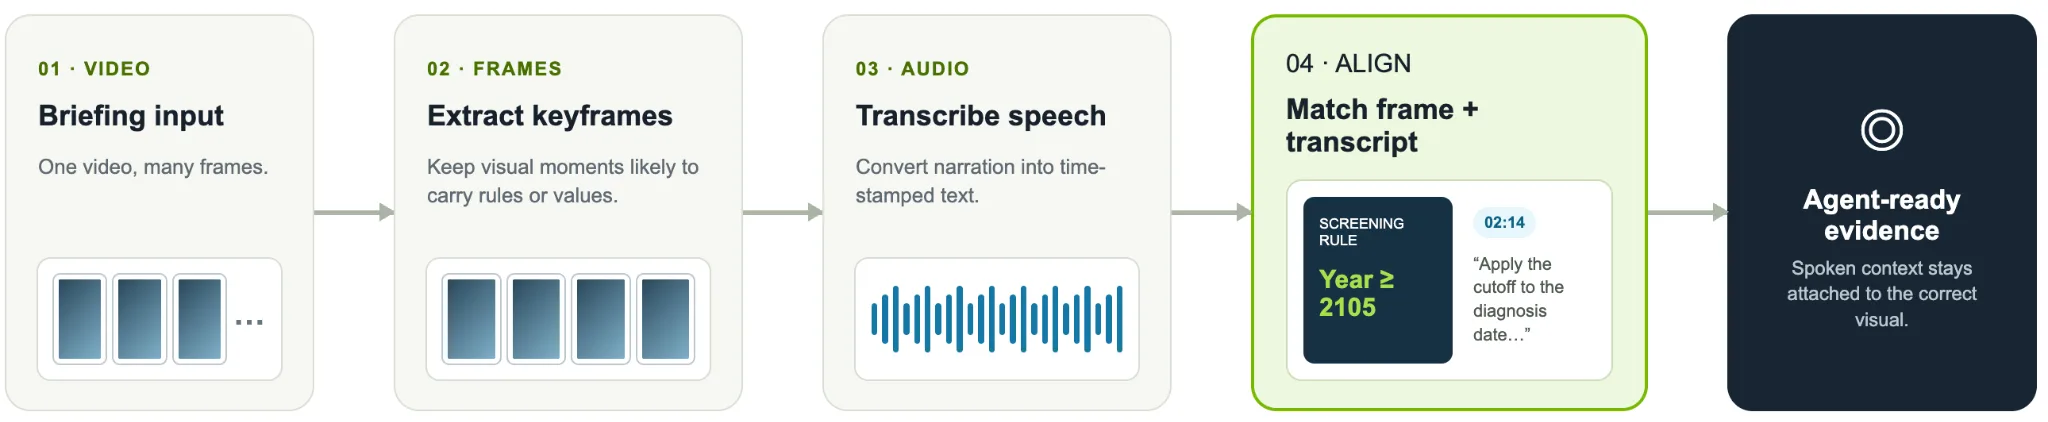
一些 KDD 任务包括简介视频。为了避免在智能体循环内处理视频所产生的计算成本,KGMON 提取了关键帧,转录了音频,将转录片段与帧对齐,并将生成的证据提供给智能体。
每个任务最多包含一个视频,通常包含基于幻灯片的约束条件或干扰值。与文稿对齐的关键帧将口语上下文与正确的视觉证据联系起来。图 5 显示了预处理步骤。
重要注意事项:预处理适合比赛设置。视频较多的应用可能会受益于类似于 prose_helper 的按需辅助工具。
应用此方法:在智能体循环之前预处理有限的一组视频。对于较大的集合,提供检索或检查工具,按需查询视频证据。
6. 记录追踪,以便其他智能体或人员检查故障
每次尝试都会记录提示、工具调用、SQL 查询、中间结果、错误、维修、文档查找和最终答案。
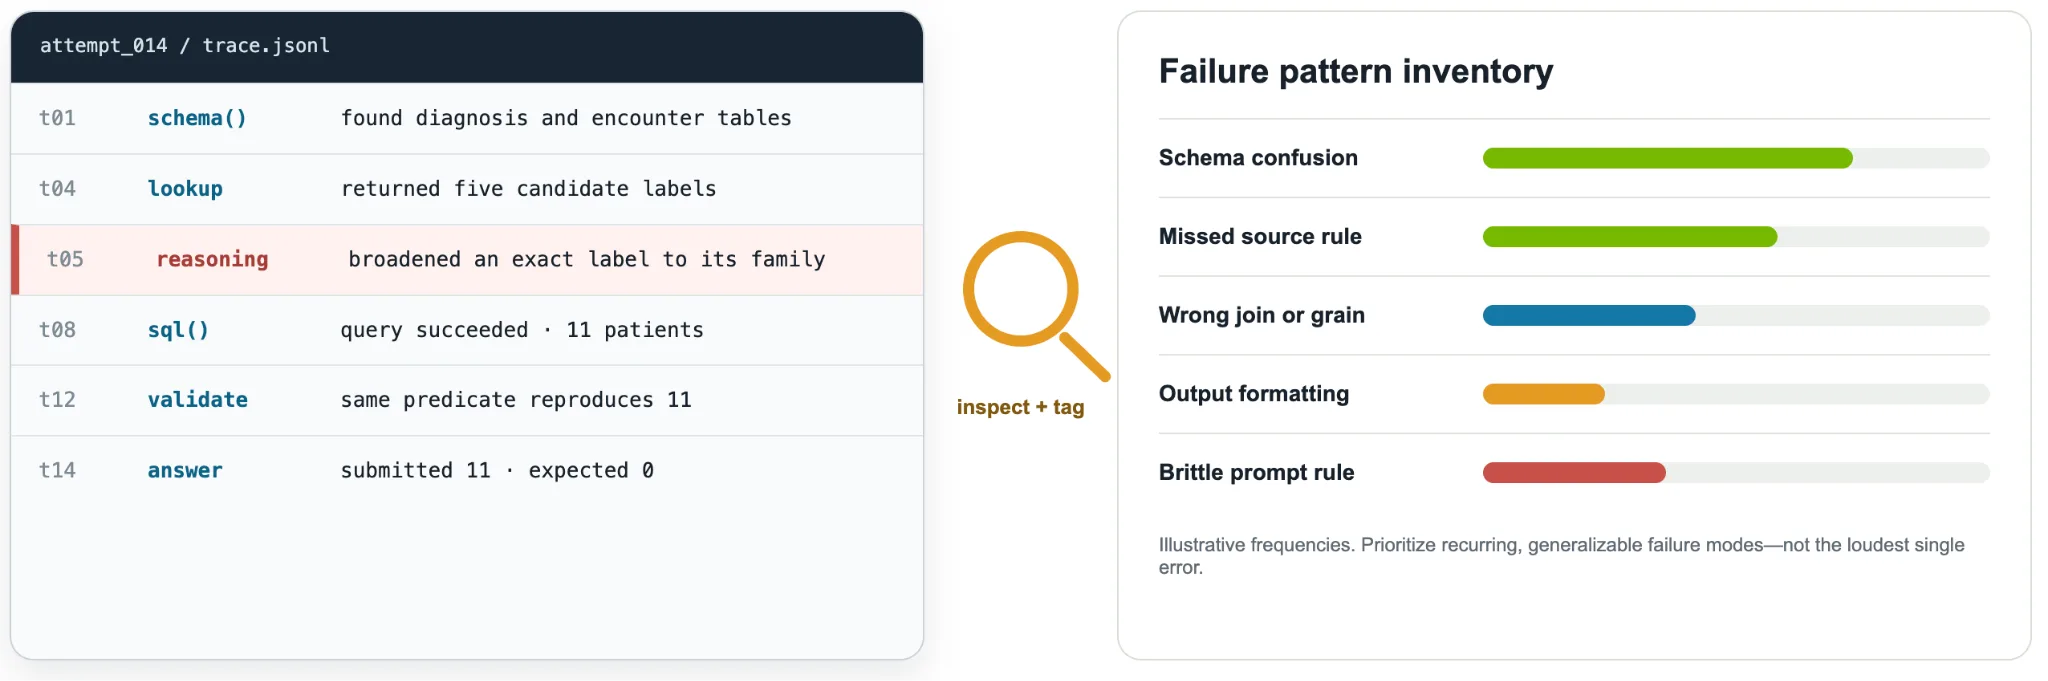
专业的 Inspector 智能体可以审查失败的轨迹、对错误进行分类并发现反复出现的故障,以帮助团队确定改进的优先级。
追踪显示了错误答案是否来自模式混淆、错误连接、缺失散文证据、输出格式或不可靠的提示规则。
应用此方法:在开发工作流程中构建追踪检查。子代理或评估脚本可以对最近运行中的故障进行分类,并推荐对线束的更改。图 6 显示了追踪如何揭示第一个错误的决策。
7. 评估多次尝试,但注意成本
KGMON 通过重复尝试和答案选择提高了覆盖率和可靠性。它按答案值 (而非列名称) 对尝试进行分组,并且可以为有争议的任务提供额外的运行。
根据排行榜的准确价值等级评分,多次尝试帮助区分了稳定答案和一次性错误。
重要警告:重复尝试会增加 token 使用率、延迟和计算成本。在生产环境中,为价值、不确定性或风险证明成本合理的任务保留集成。
应用此方法:从单次运行评估和跟踪检查开始。根据置信度、不同意见或验证失败来确定何时进行更多尝试证明其成本是合理的。
8. 谨慎使用改进循环
在自主改进循环中,智能体使用评估反馈来优化提示、工具、后处理和评估逻辑。这些更改可以提高性能,但也会过拟合基准测试。
KGMON 发现了几个风险:
- 将训练示例硬编码为提示词
- 累积相互矛盾的指令
- 添加脆弱的后处理规则
- 改进单一基准拆分,同时损害泛化
该团队需要快速改进,而无需构建能够记住基准的线束。
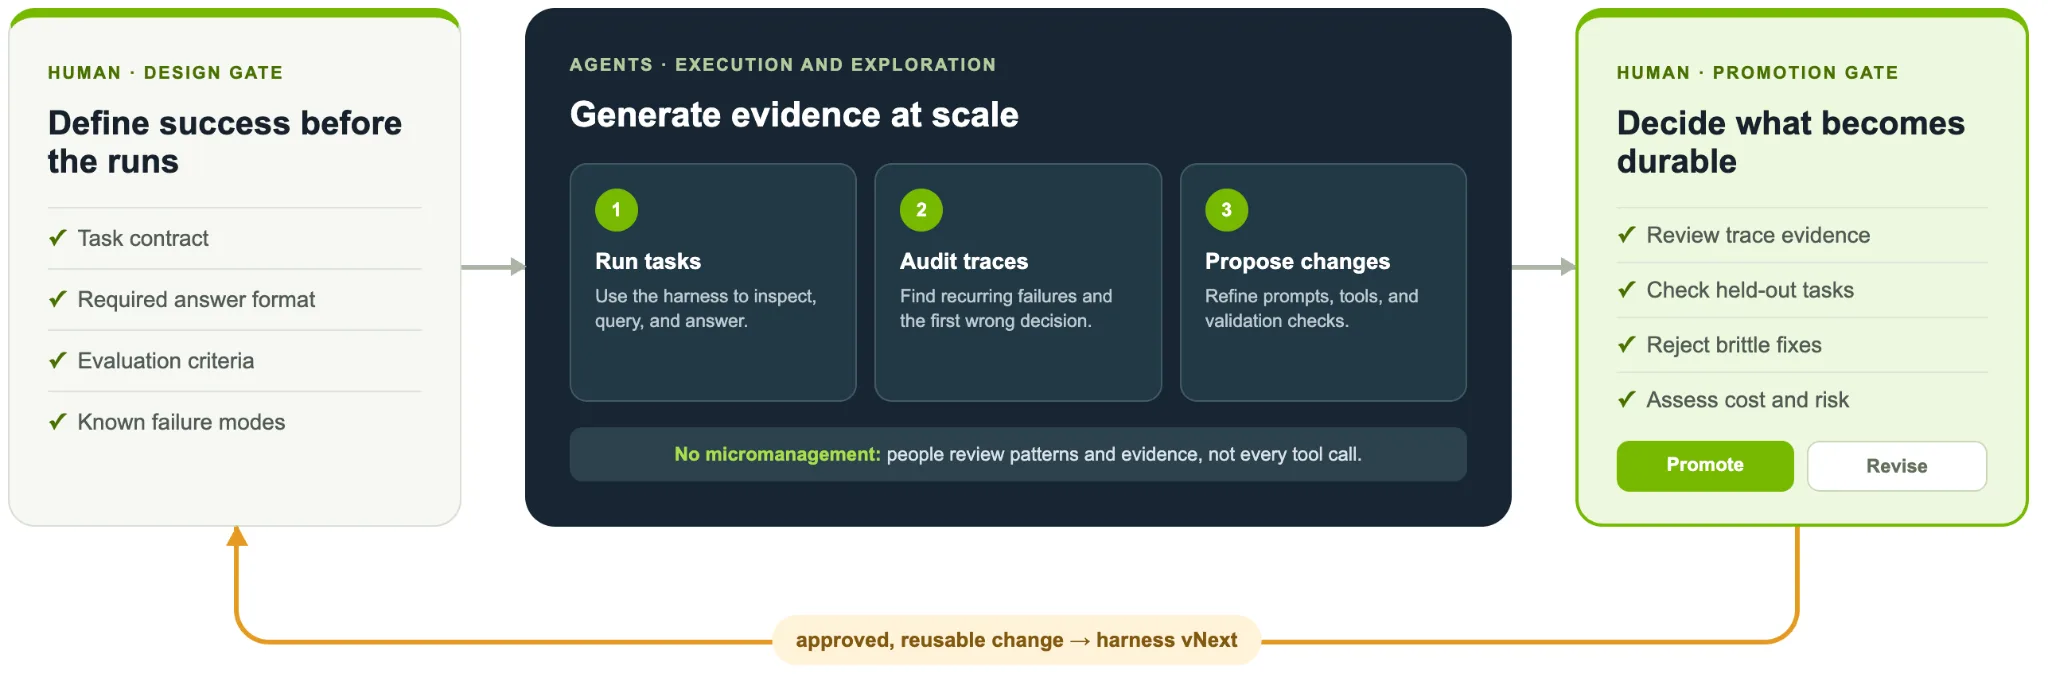
应用此方法:在推动更改之前,需要执行持久的任务、提示审核、追踪审查和人工批准。构建进入改进循环的审查门户。
9. 让人类始终处于正确的工作状态
该团队将人工指导与智能体规模的实验相结合。
人们定义了任务要求、审核了追踪、引导了早期代理行为、拒绝了脆弱的更改,并选择了一些改进以保留在工具中。
有针对性的人工干预可以改善未来的运行,而无需对每次工具调用进行监督。
应用此方法:审查任务设计、评估标准、故障分析和建议的可重复使用技能。让智能体执行和探索,而人们决定保留哪些改进。图 7 显示了人工评审在此循环中的位置。
构建数据科学智能体的主要经验
确切的 KDD 解决方案由基准决定:固定模型、无互联网访问、异构任务包、价值级别评分和长期预算。并非每个设计选择都应直接复制到生产环境中。
您可以将这些实践应用于其他智能体系统:
- 在智能体启动之前规范化数据访问。
- 为智能体提供一个小巧可靠的工具面。
- 让每一次尝试都可追踪。
- 评估答案和轨迹。
- 有选择地使用重复尝试。
- 保留可重复使用的知识。
- 仅在验证后促进改进。
这些实践有助于智能体可靠地使用数据。
开始使用
从一个可重复的分析工作流开始,构建可以完成该工作流的小型工具。请按照以下步骤操作:
- 定义问题和所需答案格式。
- 为智能体提供一系列用于检查和查询数据的工具。
- 记录每次工具调用和中间结果。
- 创建一个包含成功案例和可能的故障模式的小型评估集。
- 检查智能体的轨迹,然后优化其工具、提示和验证检查。
在基础可靠后,添加文档检查、共享知识、回顾改进以及对多次尝试的选择性评估。
如需了解其他架构示例和实施方案,请浏览 KDD Cup Data Agents 演示文稿存档,其中包括录制的演示文稿和来自八个精选团队的幻灯片。这些材质旨在作为设计参考,而非 KGMON 解决方案的分步重新实现。
智能体的可靠性取决于模型及其线束。它们必须共同支持可检查、可重复且有用的分析。


