

每一个未使用的功率都是剩余的容量。AI 工厂通常是为每个 GPU 达到峰值功率这一不太可能出现的时刻而提供,从而创建一个保护缓冲区,使宝贵的基础设施在正常运行期间不被充分利用。NVIDIA DSX MaxLPS 使用策略控制的功耗共享在参与活动的资源之间动态分配功耗,使客户能够在相同的批准功耗预算内部署多达 40% 的 GPU。
本技术演示探讨了 NVIDIA 和 Nscale 对这种方法的联合评估,该方法使用的是在 Nscale 位于冰岛凯夫拉伏克的 Verne 园区的数据中心的 NVIDIA GB300 NVL72 系统上运行的 Kimi K2.5 工作负载,该数据中心完全由可再生能源提供动力支持。它涵盖了功率和性能之间的测量权衡,解释了用于维持电气限制的控件,并提供了操作员在大规模部署之前可以使用的可重复验证方法。
静态资源调配如何使可用功率受限
AI 工厂在电气极限的层次结构中运行。公用事业服务、变电站、配电设备、机架、节点和 GPU 都存在限制。运算符必须将每个受管理边界保持在其已批准的限度内,同时满足应用程序吞吐量和延迟目标。
静态功率规划通常会为每个节点保留足够的功率,以便同时达到指定的峰值。这种保守的方法非常简单,但 AI 工作负载很少会消耗恒定的功率。训练工作负载涉及计算、通信、同步和检查点。推理工作负载在预填充、解码、受内存限制的工作、网络活动和空闲时间间隔之间交替运行。随着请求形状和并发性的变化,即使是同一模型的实例也会产生不同的功耗。
这种可变性导致保留峰值功率与实际消耗之间出现差距。对于每个节点的静态保留,一个保留中未使用的容量无法应用到另一个节点。聚合设施可以保持在其上限以下,而额外的 GPU 容量则保持离线状态。
DSX MaxLPS可监控实际功耗,并在参与活动的资源之间动态重新分配可用功率,同时保留运营商的总体预算和策略边界。
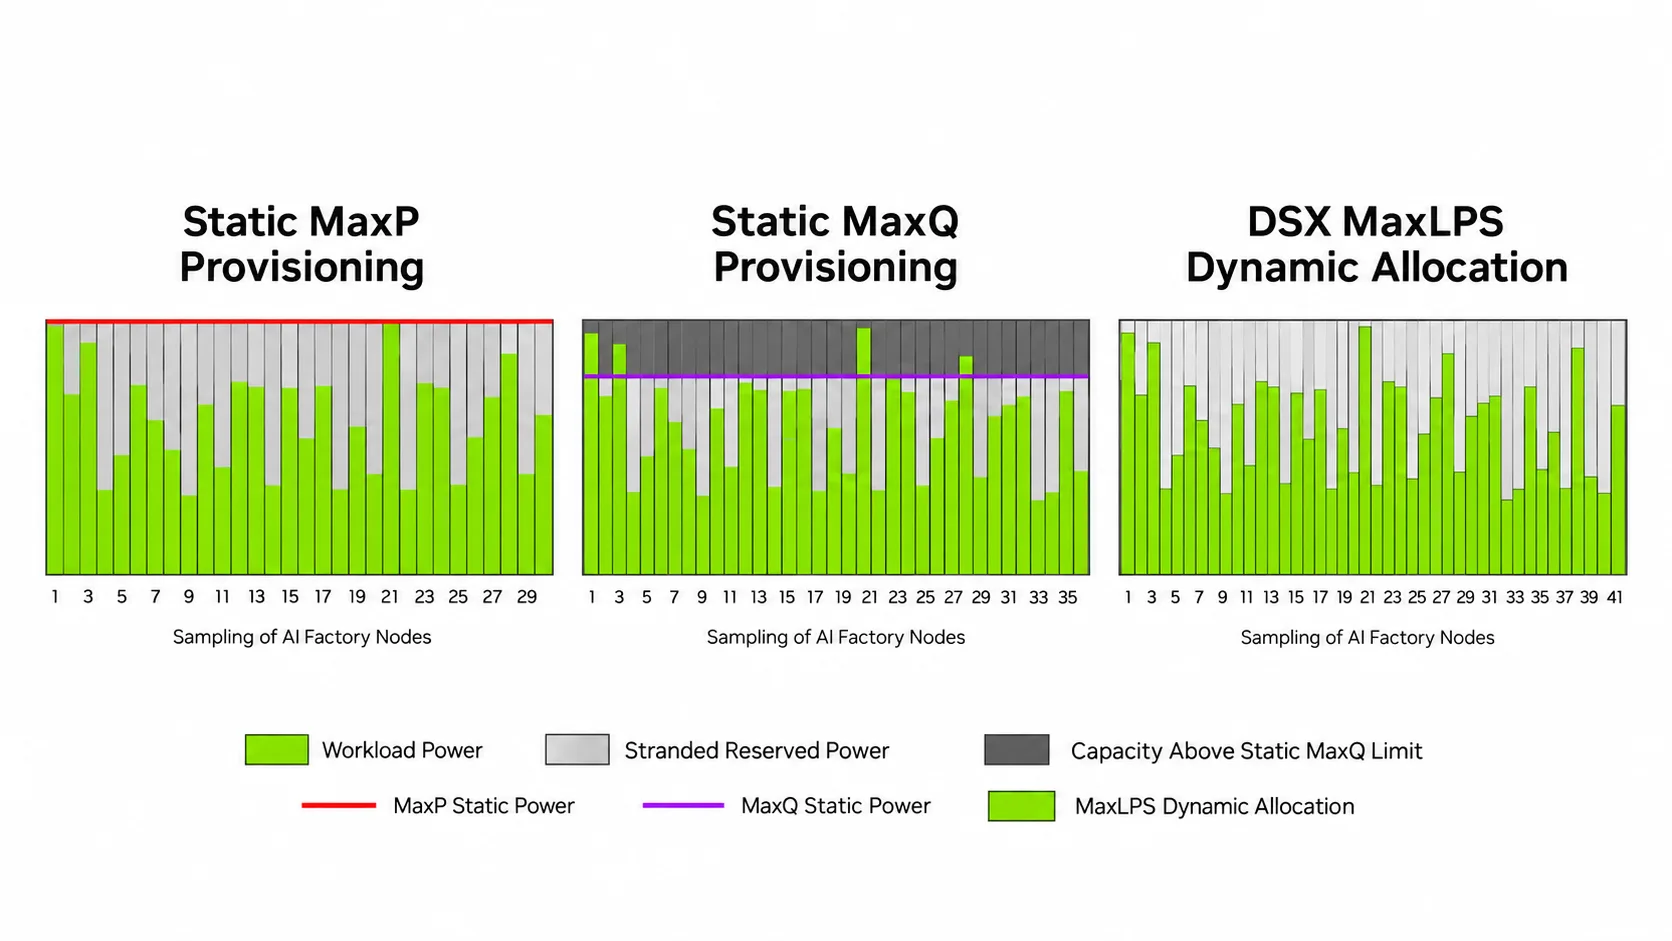
DSX MaxLPS 控制回路
DSX MaxLPS 结合了芯片、系统、散热和软件技术,可在土地、电力和外壳 (LPS) 的限制范围内更大限度地提高 AI 工厂的输出。Dynamic Power Software 为策略控制的功率分配提供控制层。
控制流程包含五个技术要素:
- 拓扑和资源组。运营商映射参与的基础设施,并将节点整理成具有总功率预算的托管组。
- 遥测。该系统以足以检测可用净空和新出现功率事件的间隔收集 GPU、节点、机架和组功率遥测数据。
- 策略。运营商定义的规则建立节点限制、组限制、分配优先级、保留要求以及对维护或紧急事件的响应。
- 分配和控制。当一些资源消耗的资源少于分配的资源时,软件会调整参与的 GPU 功率限制,以便其他资源可以使用可用容量。
- 验证和执行。该系统会将测量的功率与已批准的团队预算进行比较,并在功耗接近极限时调整分配。
这是协调分配,而不是增加现场的电力供应。控制回路可在相同的受控功率预算下提高工作效率。
如何评估方法
在评估中,Nscale 在其数据中心部署了 MaxLPS 软件,并在 NVIDIA 运行工作负载时收集遥测数据。该评估测量了控制行为和工作负载权衡。
该评估使用了 NVIDIA Blackwell Ultra GPU、FP4 中的 Kimi K2.5、NVIDIA Dynamo、NVIDIA TensorRT LLM、8K 输入序列长度和 1K 输出序列长度。工作负载组合结合了高吞吐量和低延迟推理实例,在托管组内创建了不同的功耗和服务配置文件。
静态基准使用了 35 个 4 GPU 节点或 140 个 GPU。它运行两个高吞吐量实例 (每个实例使用 52 个 GPU) 和一个低延迟实例 (使用 36 个 GPU) 。DSX MaxLPS 配置使用了 48 个 4 GPU 节点或 192 个 GPU。它添加了第三个 52-GPU 高吞吐量实例,同时保留了相同的 36-GPU 低延迟实例。
作业在四个机架中运行,在两种配置下,每个分布式工作负载都限制在一个机架中。这控制了跨机架性能差异。当测试环境已经过跨机架的同等性能验证时,无需将分布式工作负载限制在单个机架上。
该团队测量了标准化的聚合和每个实例的吞吐量、第一个 token 的时间、端到端延迟、交互性、GPU、CPU 和机架功耗遥测。比较这些指标可以防止吞吐量增加,避免隐藏延迟、稳定性或电源合规性回归。
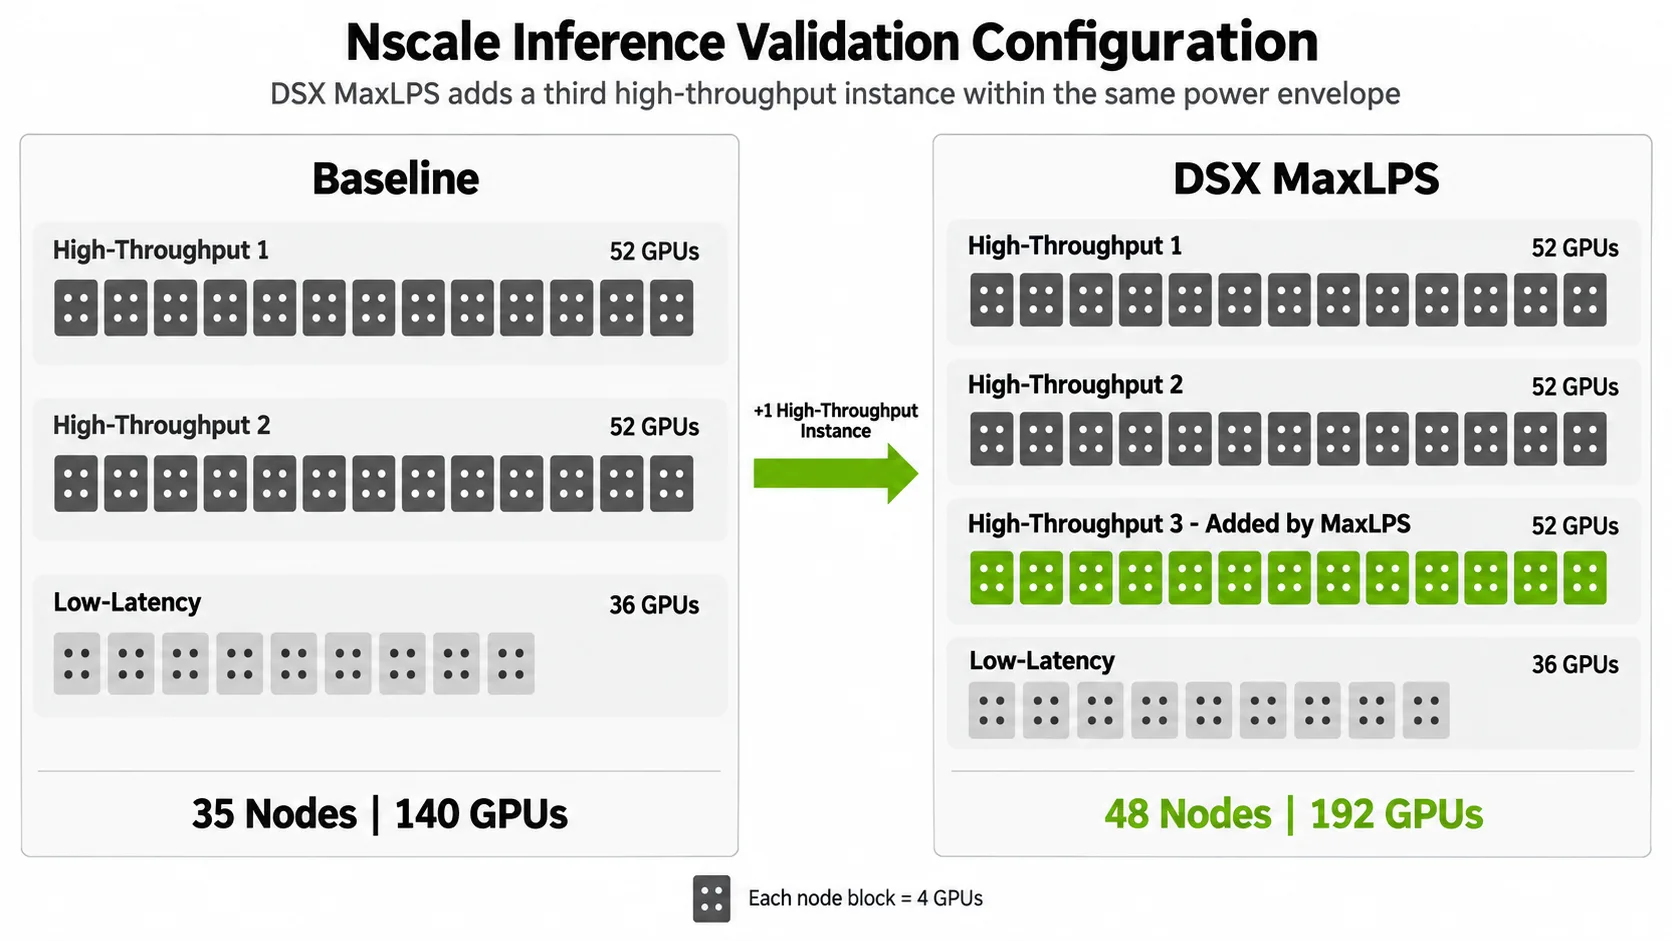
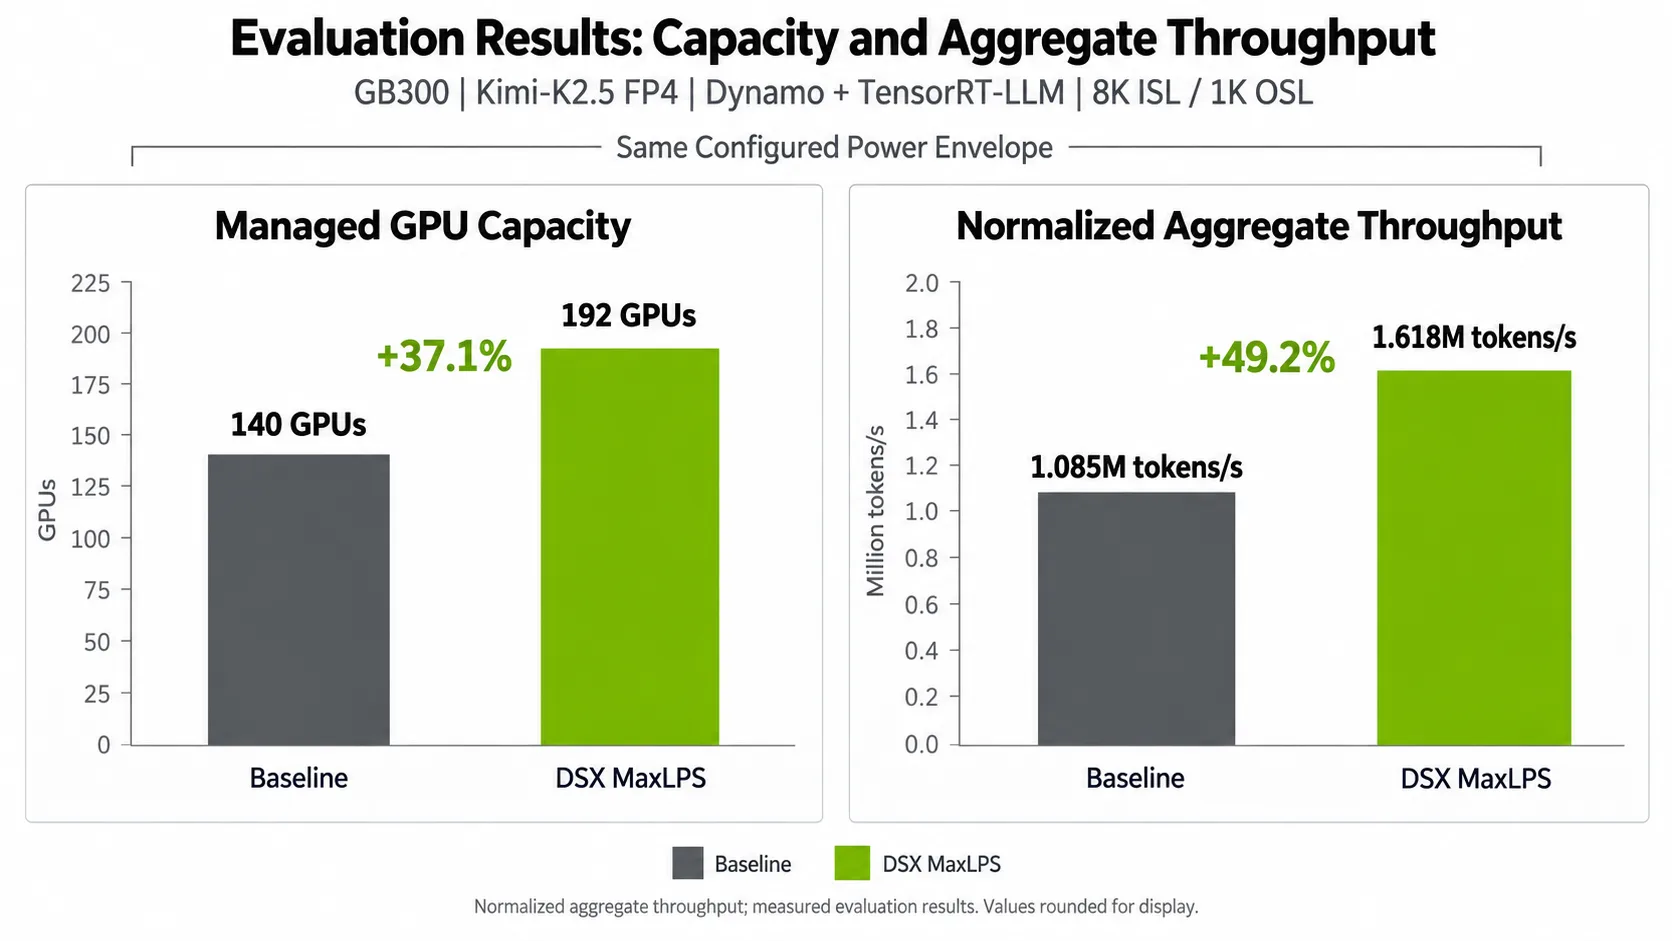
测量结果
表 1 比较了静态基准和 DSX MaxLPS 配置的容量、吞吐量和功耗。
| 指标 | 静态基准 | DSX MaxLPS | 更改 |
|---|---|---|---|
| 带管理 GPU | 140 | 192 | +37.1% |
| 聚合吞吐量 | 1084503 个token/ 秒 | 1618443 个token/ 秒 | +49.2% |
| 每个实例的高吞吐量输出 | 59153 个token/ 秒 | 59220 个token/ 秒 | +0.1% |
| 每个实例的低延迟输出 | 2265 个token/ 秒 | 2265 个token/ 秒 | 0% |
| 平均 GPU 功耗 | 97.0 kW | 131.8 kW | +35.9% |
| 总测量功率 | 166.2 kW | 199.9 kW | +19.7% |
| 功耗预算利用率 | 62.9% | 75.2% | + 12.3 个百分点 |
| 每置备瓦吞吐量 | 4.10 token/ 秒/ W | 6.12 个token/ 秒/ W | +49.2% |
两种配置均使用相同的 264.4 kW 预置功率预算。每置备瓦吞吐量将标准化聚合吞吐量除以此固定分母。基准测试提供了 4.10 个 token/s/ W,DSX MaxLPS 提供了 6.12 个 token/s/ W,增加了 49.2%。由于置备功率分母保持不变,因此此百分比与总吞吐量的增加相匹配。
在显示的精度下,每个实例的结果实际上保持不变。这表明,更大的托管集群提高了总吞吐量,而不会显著降低现有高吞吐量或低延迟实例的吞吐量。
就延迟而言,P75 是第 75 百分位的结果,这意味着 75% 的请求在该延迟下完成。P99 是第 99 个百分位的结果,代表尾部行为:99% 的请求在该延迟或以下完成,而最慢的 1% 需要更长的时间。中值延迟和 P75 延迟仍保持在基准的 5% 以内。与 15.7 秒的基准相比,P99 生成第一个 token 的时间增加了 17%,这表明评估尾部延迟以及容量和吞吐量的重要性。
评估中暴露的权衡取舍
动态功率分配使工程权衡在车队层面上变得可见和可控,但这并不会消除它们。
工作负载混合形状可用空间
DSX MaxLPS 使用之前未使用的空间,因此增加的容量仍然可以提高平均功耗。可用空间还取决于工作负载组合:互补功率配置文件比同时达到峰值的工作负载创造了更多机会。因此,操作员应根据总功率限制测试具有代表性的生产工作负载。典型的 AI 工厂运行具有不同功率配置文件的异构工作负载。因此,该研究使用了旨在反映这种可变性的工作负载组合。
尾部延迟揭示了服务权衡
稳定的中位延迟可以屏蔽尾部延迟的变化。在本次评估中,中间值和 P75 延迟仍保持在基准的 5% 以内,但 P99 达到第一个token的时间增加了 17%。应在研究中定义生产合格标准。
遥测支持可靠控制
动态分配依赖于可靠的遥测技术。缺少、延迟或映射不正确的测量结果会影响车队级别的决策。在此评估中,我们使用站点级遥测来验证机架级功耗测量值。在部署之前,运营商应确认增加的吞吐量不会影响服务质量或遵守功率限制。
这些权衡决定了哪些运算符应在部署前进行验证。
操作员如何验证 DSX MaxLPS
使用具有明确边界和接受标准的分阶段验证过程。
- 定义受管理边界。映射可用性、分布、机架、节点和 GPU 拓扑。设置资源组预算、储备要求和上报行为。确认哪个测量值代表可执行的限制。
- 建立代表性基准。使用预期部署和放置规则,在静态配置下运行具有代表性的 AI 工厂工作负载组合。测量足够长的性能和功耗,以捕获工作负载变化并确认可重复性。
- 保守地引入策略。从接近验证基准的极限值开始。在添加节点之前,确认遥测、拓扑、控制响应和预算合规性。
- 增加容量并测试每个阶段。通过比较每个步骤的聚合和每个实例的性能,逐步增加受管理的总体数量。在继续之前,请先验证需求高峰、操作过渡、遥测故障和电源可用性降低时的服务行为。
- 设置生产运营限制。仅在以下情况下批准配置:满足吞吐量和延迟目标、保持在管理预算范围内、保留所需储备,并且在故障和过渡期间行为可预测。
此评估展示了 DSX MaxLPS 如何回收功耗受限的 AI 工厂中的闲置容量。相同的策略控制方法可以提高不同环境中的有用计算能力。运营商可以根据硬件、工作负载组合、软件、冷却、网络拓扑和服务目标,针对每个部署调整最佳操作点。
为经过验证的运营目标规划站点
动态分配是一种运营能力,但站点必须能够托管其启用的容量。配电、冷却、网络结构、占地面积和机架位置应根据经过验证的生命周期目标确定大小,即使在第一天填充的机架较少。
对于未来的 NVIDIA Vera Rubin NVL72 AI 工厂,DSX MaxLPS 还将动态电源管理与每瓦性能技术和基础设施相结合,专为 45 ° C 液冷入口操作而设计。任何 Vera Rubin 容量投影都应与测量的 GB300 NVL72 评估值保持分离。
DSX MaxLPS 为运营商提供了一个框架,可将工作负载的可变性转化为受管理的容量。工程工作是定义边界、衡量代表性行为、根据服务目标调整策略,并在正常和不利条件下证明合规性。
查看 NVIDIA DSX MaxLPS 和 NVIDIA Dynamic Power 软件文档,然后使用此验证序列为您自己的 AI 工厂建立生产运营限制。
