

对于大型 AI 工厂的运营商而言,最大化连续输出对于提高生产力至关重要。在大规模 AI 训练中,集群中的每个 GPU 必须每秒同步数千次集合运算的梯度。同样,在推理期间,计划外停机会直接减少服务请求的总量,严格限制创收。
随着 AI 模型呈指数级增长,训练和服务这些模型所需的网络基础设施必须同步扩展。但是,在大规模部署中,瞬时错误、链路降级和节点中断是数学确定性。
为了保持最佳集群利用率,网络必须保证这些紧密合的工作负载不会中断。不能让丢包导致推理延迟激增或破坏训练集合。大规模而言,即使是罕见的数据包丢失也会导致有效输出严重下降。因此,真正的无损网络是生产级 AI 基础设施的先决条件。
NVIDIA Vera Rubin 是一个全栈 AI 工厂平台,可为所有 AI 和加速计算工作负载提供可替代计算。对于 AI 工作负载,它旨在使用 Vera Rubin NVL72 GPU 提供训练,并以最低的 token 成本提供最高的每瓦推理吞吐量。Vera Rubin NVL72 是该平台的核心机架级计算引擎,通过 NVIDIA NVLink 6 纵向扩展网络结构将 72 个 Rubin GPU 连接成一个纵向扩展域,使它们能够作为单个计算单元发挥作用。
NVIDIA NVLink 6 通过全面的弹性框架提供这些工作负载所需的出色可靠性。通过在本地检测、控制和恢复瞬态信号错误,NVLink 可确保持续运行并更大限度地提高集群生产力。
为什么多层弹性是唯一途径
在现代 AI 工厂的规模上,反应式协议和单点修复从根本上来说是远远不够的。作为 AI 互连领域的行业领导者,NVIDIA 将 NVLink 的弹性设计为一个精心集成的多层堆栈,涵盖硬件、系统设计和软件。
首先,在物理层和链路层,NVLink 强制采用原生无损结构。它通过结合前向纠错 (FEC) 、物理层重试 (PLR) 和通用物理层 (UPHY) 恢复来实现这一点,从而实现快速纠错和链路稳定性。此外,它还利用基于积分的流量控制 (CBFC) ,以数学方式消除丢包,并部署主动错误控制,在故障级联之前立即隔离故障。
其次,由于任何低于完全系统冗余的东西都是一种负担,因此该架构在设计时没有单点故障。冗余交换机托盘、分布式 NMX 控制器和双带外管理路径可确保域在单个组件丢失时仍可正常运行。
最后,在应用和软件层,Dynamo Shadow Engine Recovery 等功能利用预热副本进程执行近乎即时的故障转移,而应用级检查点和恢复机制可确保严格保留长时间运行的作业。这种紧密集成的多层方法是唯一经过验证的方法,可以无缝控制硬件异常,保护运行中的工作负载不中断,并提供不妥协的正常运行时间,满足大规模 AI 需求。
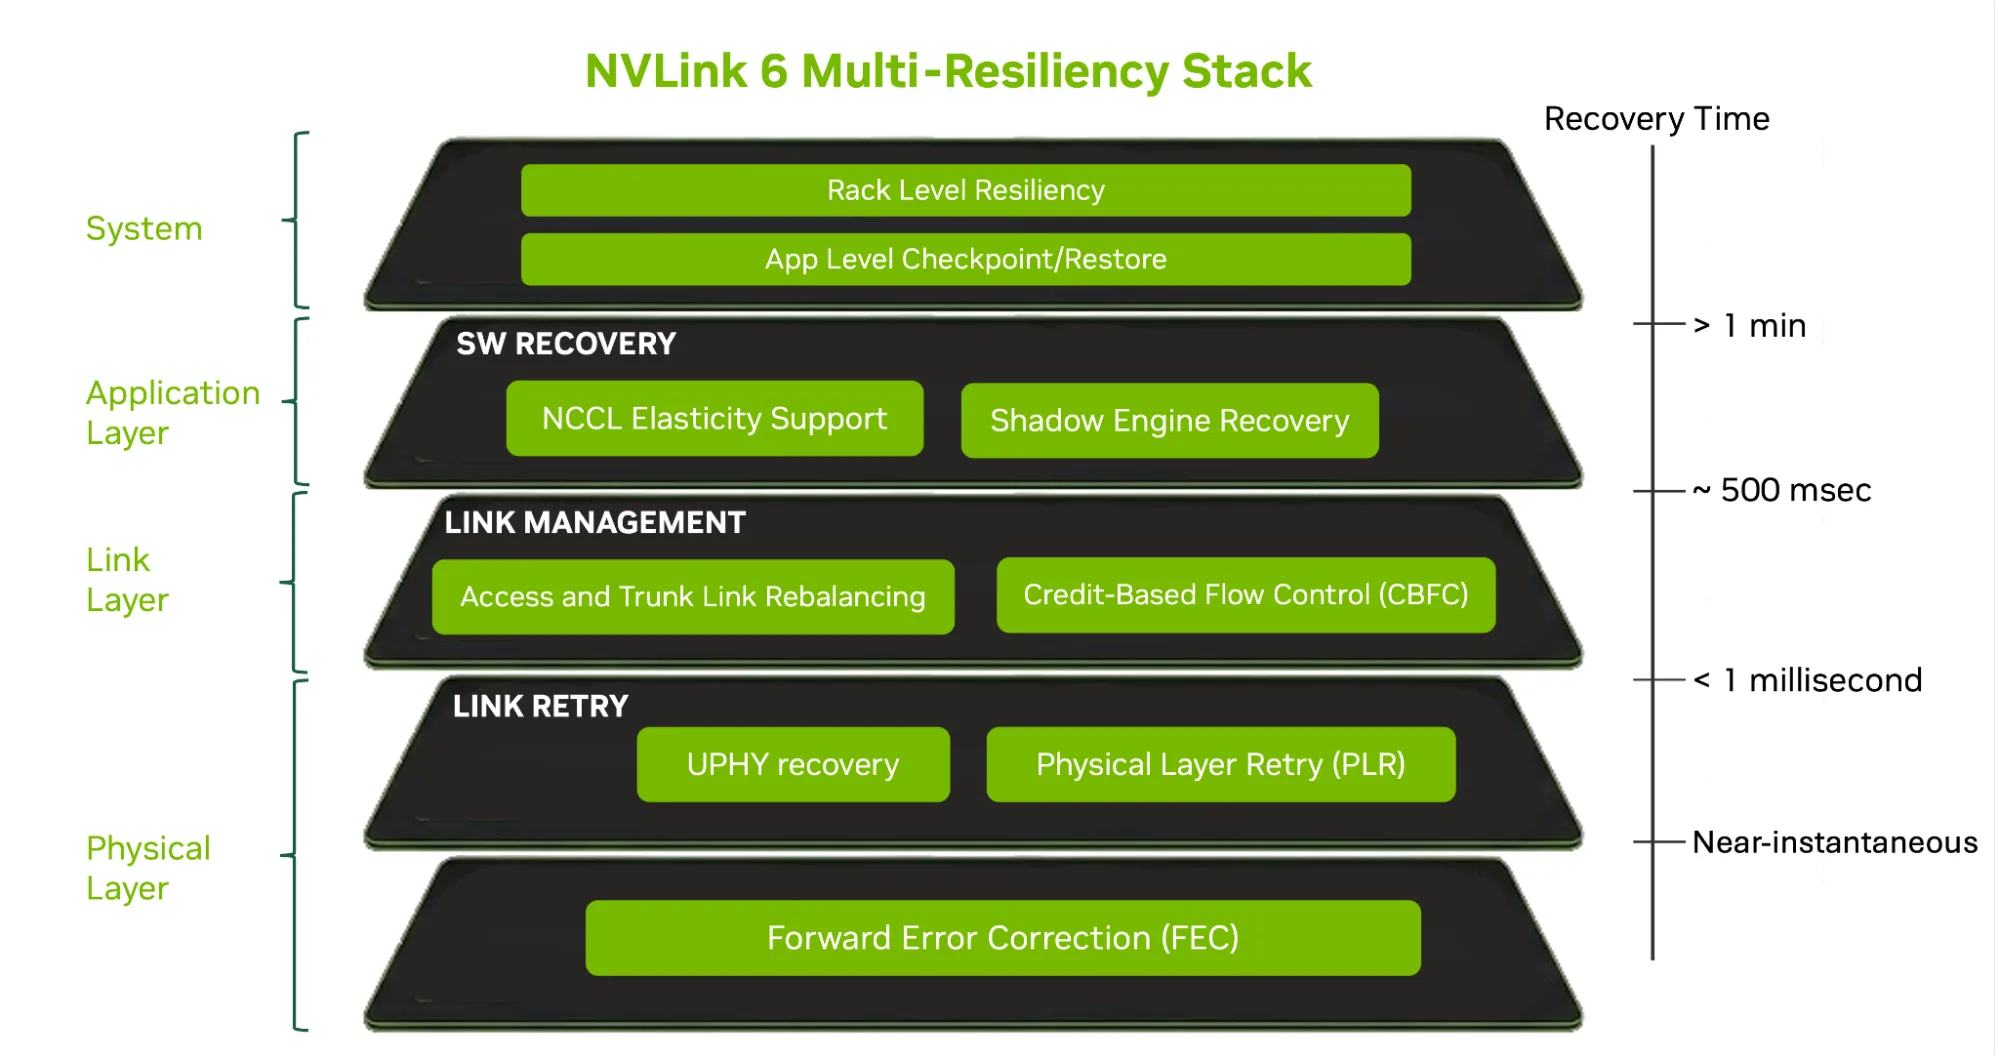
下面,我们将详细介绍这种多层架构的实际运作方式。
通过物理层减少源错误
在基础物理层,NVLink 可直接在硅级处理电气噪声和信号衰减。在极高的信号速率下,噪声引起的误码是不可避免的。现成的网络结构依赖于标准的重量级 FEC 算法,这些算法会产生巨大的处理开销和多跳延迟。相比之下,NVLink 专为紧密合的纵向扩展 AI 工作负载而设计。
NVLink 利用 PLR 作为快速的第二道防线,因此能够避免这些重量级 FEC 算法,这一点至关重要。这种架构协同作用使 NVLink 能够采用轻量级、高效率的 FEC 架构。该方法允许发送端口向数据流附加高级纠错码,而不是像基本奇偶校验那样仅检测故障。
然后,接收端使用这些代码以数学方式内联重建损坏的位,以近乎零的延迟损失纠正一位或多位错误。这种效率直接有助于 NVLink 提供比通用以太网替代方案低 3 倍的端到端延迟和高 10 倍的数据包速率。
当错误爆发超过这些轻量级 FEC 校正能力时,第二道防线立即启动。PLR 是一种成熟、成熟的物理层数据包重传机制。通过直接在物理层处理重传输,PLR 可在不涉及更高级别的软件堆栈的情况下有效地将数据包丢弃减少到零。
最后,如果严重性能下降触发物理链路关闭事件,UPHY 恢复会快速重新校准物理参数,同时数据包被安全地保存在硬件回放缓存中,以确保零数据丢失。
确保在链路层无损传输
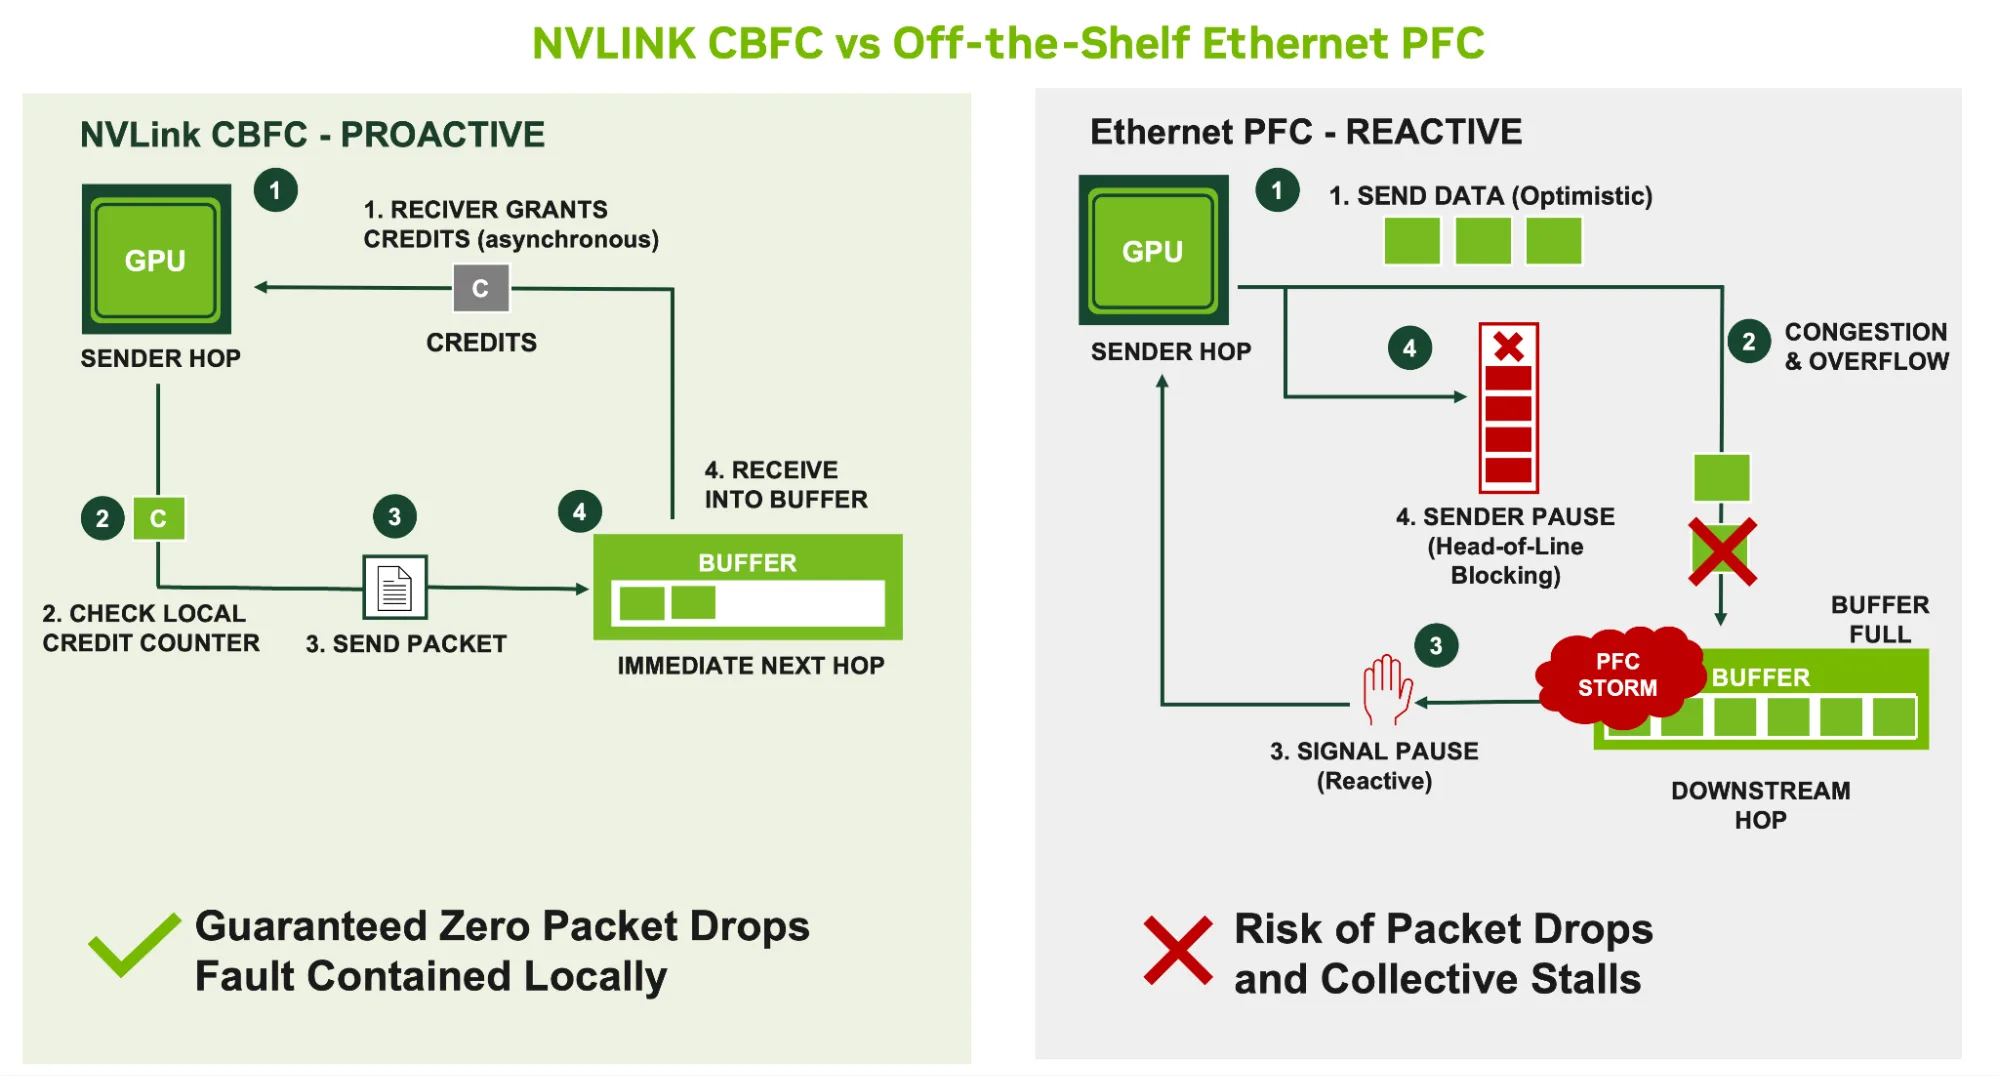
向上移动时,NVLink 依靠链路层来管理网络拥塞,而无需使用更高级别的软件。与传统协议相比,CBFC 是 NVLink 如何建立原生无损结构的关键区别。基于以太网的标准纵向扩展替代方案试图通过优先流控制 (PFC) 和显式拥塞通知 (ECN) 等螺栓固定机制来近似估计无损情况。
但是,这些被动式方法引入了自己的故障模式,例如头部阻塞、PFC 风暴和死锁。这些漏洞会将拥塞管理本身转化为弹性风险。此外,传统的基于确认的方案要求接收方事后发出成功或失败的信号,当缓冲区溢出时增加了延迟,因此必须重试。
使用 CBFC 时,发送者永远不会向网络注入数据包,除非其拥有积分,表明即时下一个 Hop 有可用的缓冲区空间来吸收数据包。这种主动式方法通过设计消除丢包,并保证在硬件级别进行无损传输,而不会出现与以太网 PFC 相关的网络暂停。
由于在传输过程中没有任何数据会被悄无声息地丢弃,因此网络行为仍然具有高度可预测性,并且具有一致的低延迟。同时,如果底层物理链路性能下降,Link Manager 会通过执行访问链路和主干链路重新平衡来自动修复 NVLink 网络。
最重要的是,它可确保硬件故障能够在发生故障的地方就地加以控制,而不会触发层叠式重传、超时或集体停顿,从而困扰基于以太网的现成 AI 集群。
通过应用层软件恢复隔离故障
应用层提供软件驱动的智能事务恢复 (SW Recovery) ,执行时间约为 1.5 秒。当链路错误发生时,NMX 控制器会直接与 GPU 驱动程序交互,将受影响的链路置于“包含和漏出”状态。这使得硬件能够自动重新训练降级链路,而不会损坏数据,同时防止整个网络的背压。
为避免控制平面单点故障,NVLink SDN 控制 (NMX-C) 利用 NMX 高可用性 (NMX-HA) 。NMX-C 托管在其中一个交换机托盘上,如果主主机出现故障,它可以在几秒钟内自动将其功能控制器迁移到备用托盘。此外,NVLink 交换机托盘数据平面与运行 NVOS 的交换机管理 CPU 完全解。即使发生计划外的 CPU 重置或操作系统故障,数据平面也会继续不间断地转发,从而使 NVOS 能够在不丢失数据包或工作负载中断的情况下进行恢复。
借助 Shadow Engine Recovery 实现 NCCL 软件级弹性
虽然 NVLink 的物理层和链路层成功包含并纠正了绝大多数信号错误,但无法纠正的链路降级偶尔会到达软件堆栈。在多 GPU 推理部署中,LLM 依靠 NVIDIA 集合通信库 (NCCL) 在 NVLink 结构中快速同步数据。如果 NVLink 连接发生严重中断,可能会导致瞬态通信故障,导致 NCCL 操作失败,并迫使活跃的 LLM 引擎中止。
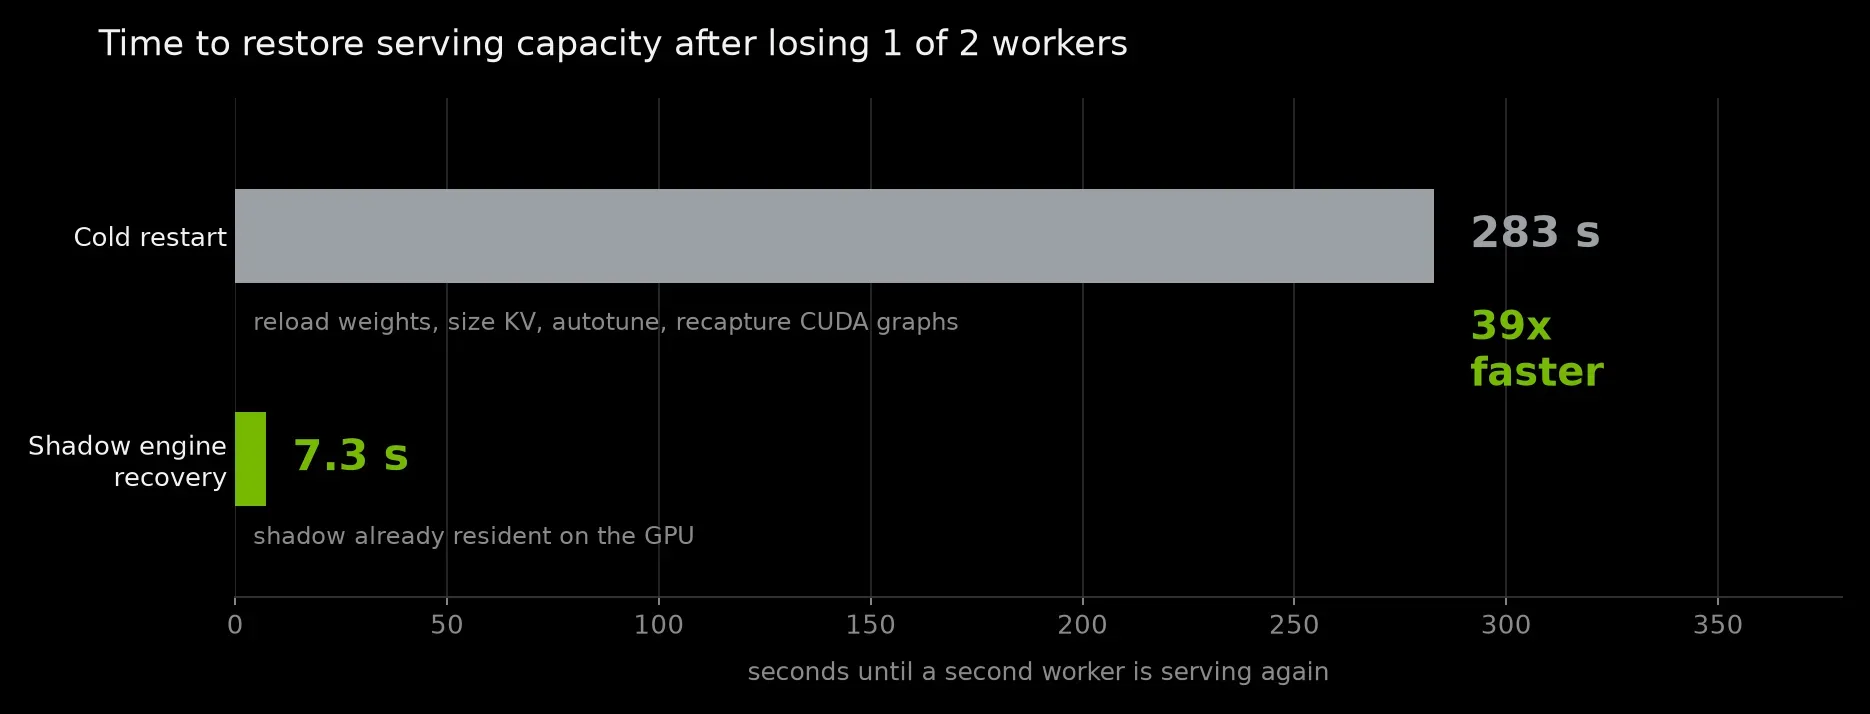
过去,这需要对推理引擎进行彻底的冷重启。此过程涉及将模型权重重新加载到 HBM 中,重新编译内核并重新捕获 CUDA 计算图,所有这些操作都可能会中断推理服务几分钟,并严重影响 token 吞吐量。为消除这一瓶颈,软件弹性堆栈利用 Shadow Engine Recovery,这是 NVIDIA Dynamo 中的一项功能,旨在绕过冷重启并在几秒钟内恢复推理能力。
由于 NCCL 通信器与创建时运行的特定活动进程集紧密绑定,因此在崩溃后无法动态地将其交给替换进程。
Shadow Engine 架构通过维护完全初始化的空闲副本进程以及主动推理引擎来解决这一问题。在启动期间,此备用引擎会预先建立自己独立的 NCCL 和 NIXL 通信器。如果硬件故障中断了主要进程的通信上下文,则影子引擎已拥有绑定到 NVLink 结构的良好的预热网络拓扑。这使其能够立即恢复分布式运算,例如张量并行 (TP) ,而无需等待重建 NCCL 通信器或重新加载模型权重。在 NVIDIA B200 GPU 上的基准测试部署中,影子引擎恢复可将推理停机时间从 8.3 秒缩短到 7.3 秒。
此外,对于需要适应硬件中断期间不断变化的节点数量的工作负载,该软件堆栈集成了 NCCL 弹性支持,以动态扩展通信器并保持作业平稳运行。
通过 CUDA 检查点实现 NCCL 软件级弹性
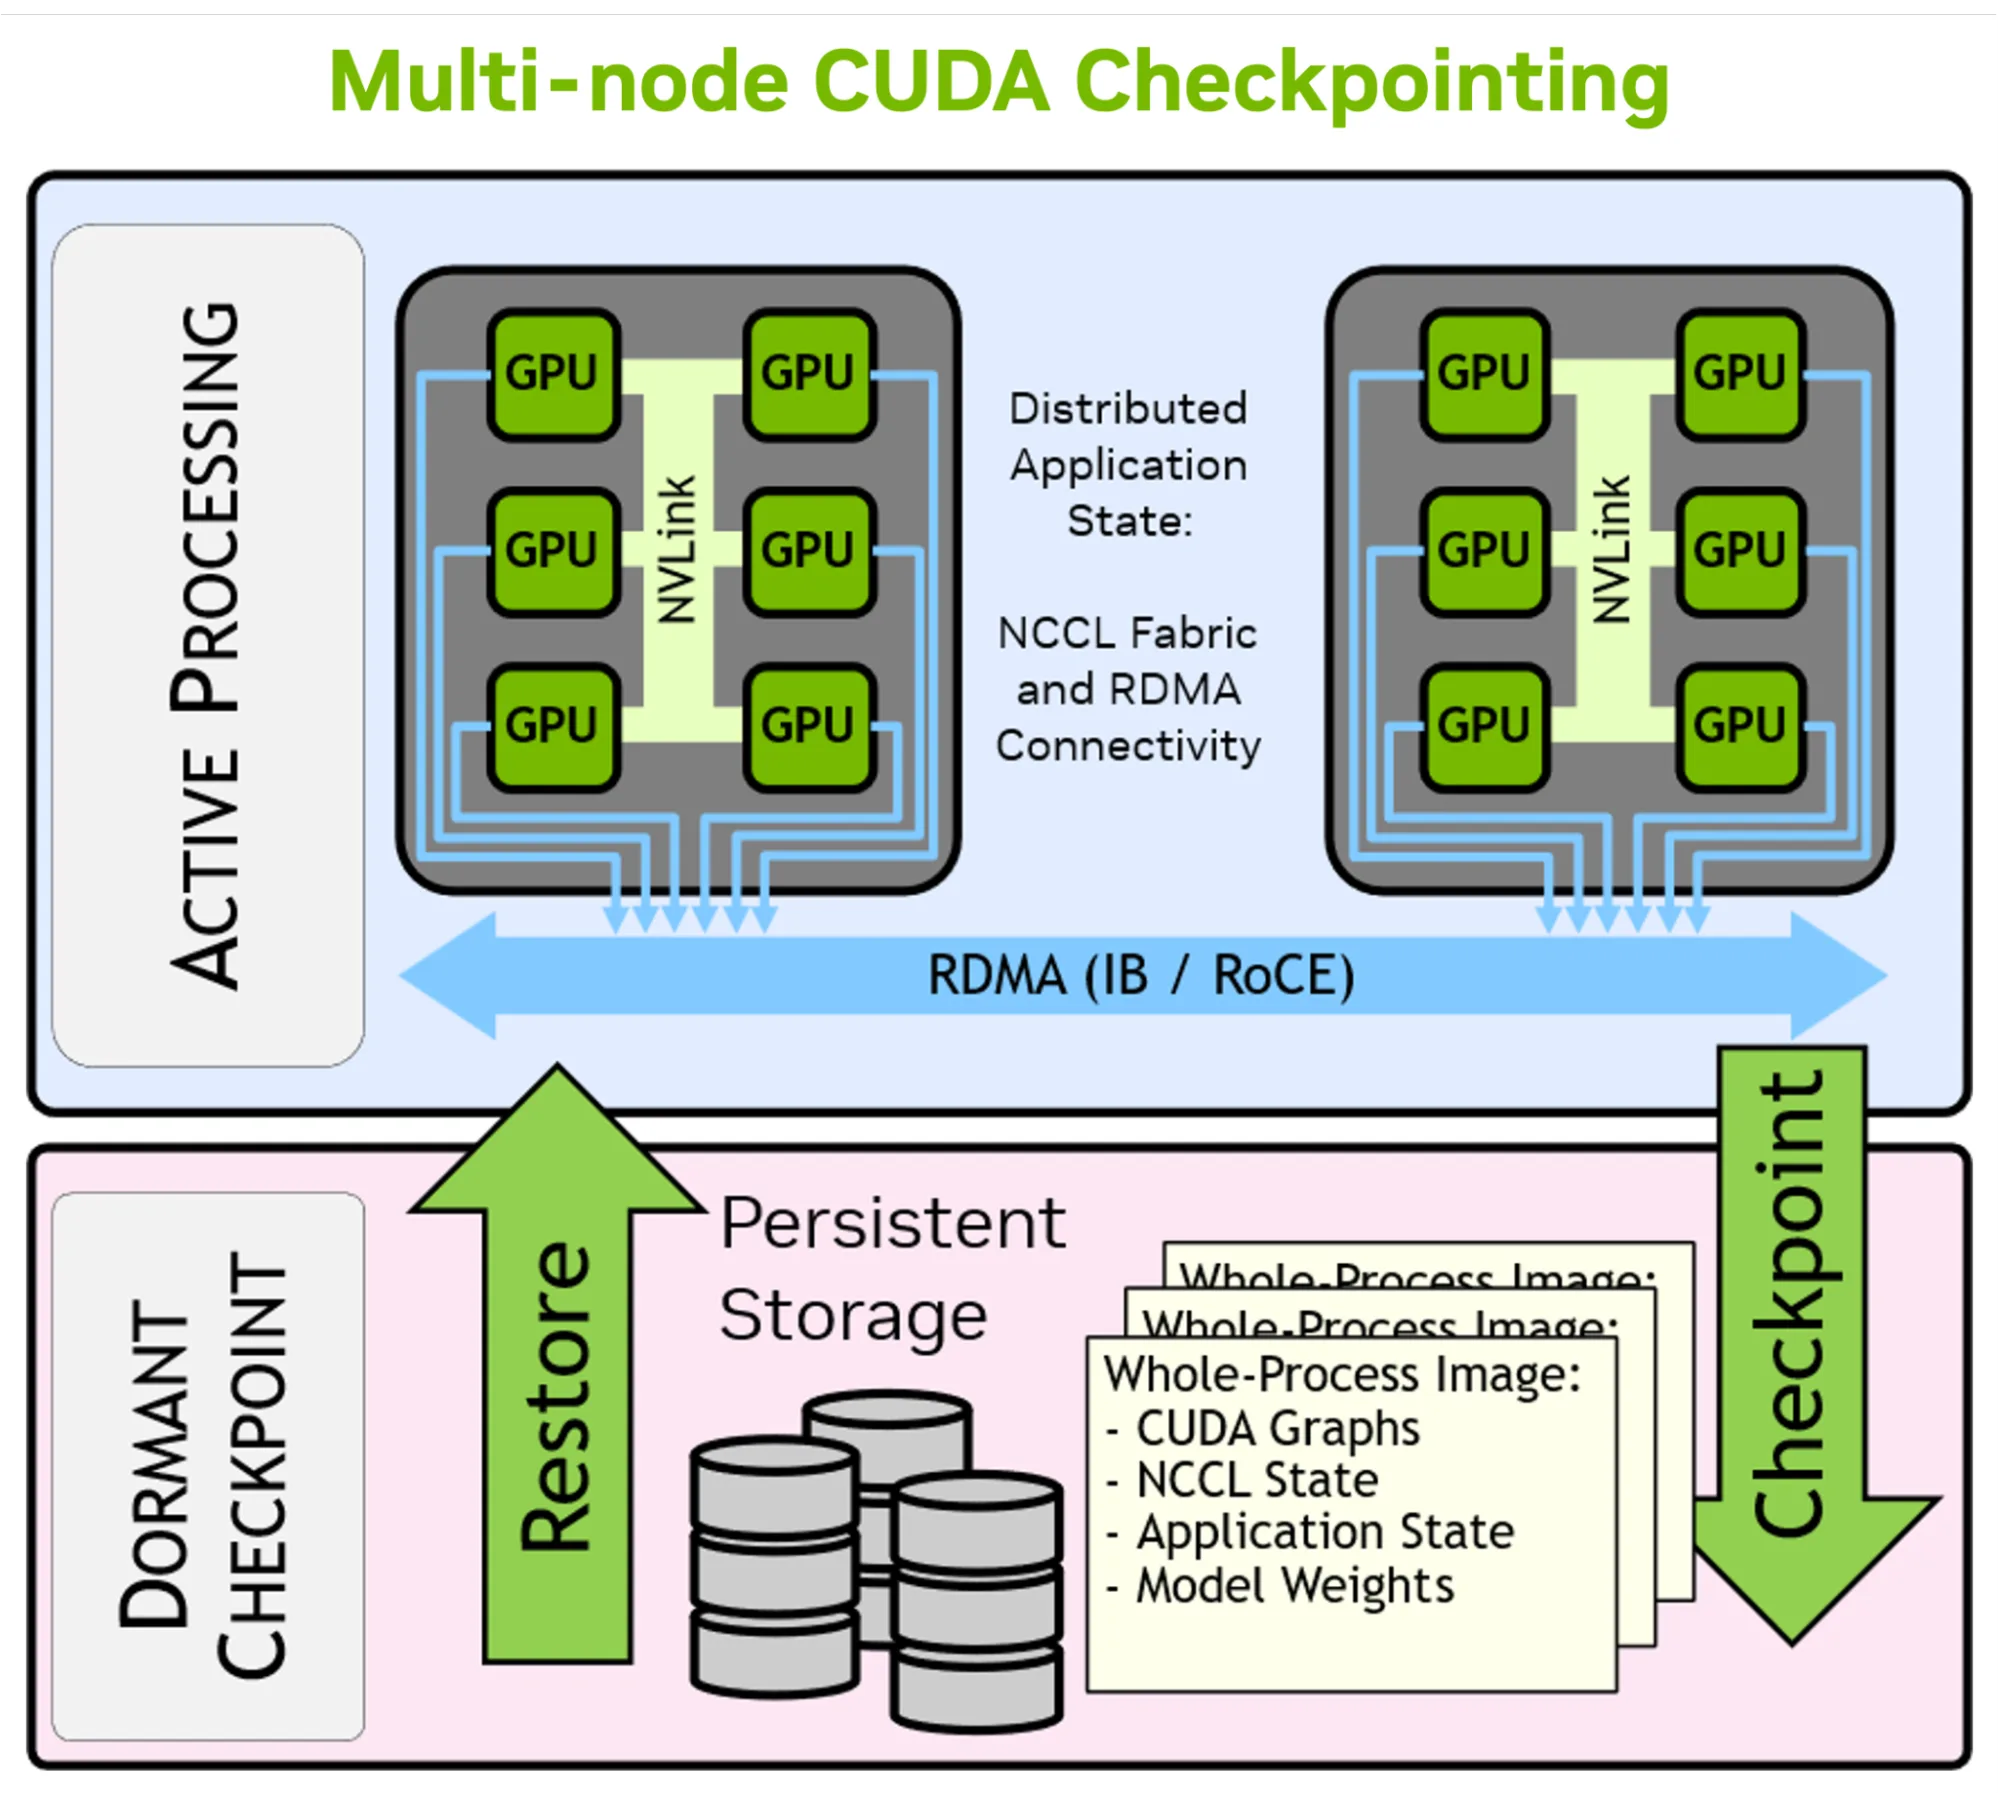
偶尔会发生中断,需要在新节点上重新启动推理引擎的部分或全部进程。为了加速这些场景,CUDA 通过 CRIU 支持进程级检查点。这使得完整的 LLM 工作进程能够在 GPU 上快速进行检查点和恢复,从而避免启动用度。Dynamo Snapshot 整合了这项工作,可将启动时间缩短一个数量级。
直到最近,这种检查点方法才包括节点本地状态,并且必须在创建任何网络连接或 CUDA 计算图之前采用。为了克服这一限制,NCCL 引入了对 cuda checkpoint 的原型支持 (预计年底全面推出) ,允许多节点 checkpoint 捕获在启动和加载 LLM 推理引擎时执行的几乎所有工作。这种方法可显著减少推理服务和智能体等延迟敏感型工作负载的启动和重启用度。
基于这种弹性软件基础,应用程序还可以通过 NVIDIA NeMo 框架 可靠地利用异步检查点,或通过 NVComp 利用检查点压缩 来保存高带宽 NVLink 结构上的状态,从而节省更多时间。对于大规模前沿模型而言,这种组合可显著减少同步阻塞时间,将检查点开销从几分钟缩短到几秒钟,并确保在发生故障时快速恢复。
通过机架可维护性维持正常运行时间
在宏观层面,系统层可管理长期状态保留以及物理机架级运行状况和可维护性,在一分钟以上的时间内处理重大恢复。这种宏观级别的弹性依赖于网络和计算堆栈之间的深度集成。NCCL 本身了解 NVLink 拓扑结构,使其能够通过重建聚合环或树来绕过故障硬件,动态适应降级链路。
通过协同工作,CUDA 可为有序的内存操作提供更丰富的错误报告和弹性模型。CUDA 通过将硬件故障清晰地显示到运行时,而不是让系统静音挂起,可确保应用始终保持感知和响应能力。
对于物理数据中心操作,交换机管理状态可将 NVSwitch 托盘维护转变为有针对性的非破坏性操作。系统管理员可以更换单个交换机托盘,而无需耗尽整个 NVLink 域或中断当前的 AI 作业。管理员状态会在非操作模式下保留已替换的链接,在显式验证和启用之前,防止链接过早包含。
此外,NVLink 原生支持部分填充的机架。NMX 控制器可自动发现可用硬件,并为存在的任何物理计算或交换机托盘配置路由,从而在分阶段部署或维护周期中实现无缝操作。
使用 NVLink Fusion 将多层弹性扩展到自定义 XPU
上述全面弹性堆栈不仅限于使用 NVIDIA GPU 的部署。随着超大规模企业和 AI 原生用户越来越多地为专用工作负载构建自定义 XPU,他们需要在大规模部署时保持同样出色的可靠性。从历史上看,将先进、容错的纵向扩展网络集成到定制芯片中一直是一个巨大的工程障碍。
NVLink Fusion 通过将 XPU 连接到 NVIDIA AI 基础设施来应对这些挑战。这种集成使第三方芯片能够无缝继承与本文中讨论的完全相同的 NVLink 纵向扩展网络结构和多层弹性堆栈。通过利用经过验证的成熟平台,NVLink Fusion 可帮助超大规模企业和 AI 原生设备提高性能、加快上市速度,并集成当今 AI 工厂所需的可靠性。
确保大规模部署的出色可靠性
随着组织评估大规模 AI 和加速计算工作负载的纵向扩展架构,比较简单的带宽指标是不够的。真正的规模需要全栈容错方法。
NVLink 6 专为通过整体、多层容错方法更大限度地提高 MTBI 而构建。从亚毫秒级物理层纠错和基于学分的原生流控制,到解管理平面和机架级可维护性,NVLink 提供了保持世界上最复杂的 AI 工厂不间断运行所需的弹性。
详细了解 NVIDIA Vera Rubin 平台、NVLink 和 NVLink Fusion。
或者了解纵向扩展网络如何决定 AI 工厂的经济性。


