

随着分布式 AI 训练的扩展,硬件和软件依赖项之间的故障会越来越多地干扰训练进程,因此快速、可靠的恢复至关重要。停止训练的秩可能会触发 NVIDIA 集合通信库 (NCCL) 超时,GPU 节点可能会停止对调度程序的响应,或者掉队者可能会减慢整个作业的速度。每次中断都是可以自行管理的,但累积影响和恢复开销决定了系统如何高效地将不间断时间转化为富有成效的训练进度或良好的输出。
当手动恢复必须全天候、大规模地覆盖集群中的每项训练任务时,就变得难以为继。每次中断都需要日志分析、故障隔离和从保存的检查点重新启动,而受影响的 GPU 在恢复期间保持空闲状态。随着训练任务的数量和规模不断增加,重叠的故障会增加工程负担并浪费 GPU 小时。如果没有持续覆盖,这些损失可能会累积,从而增加总体计算成本并延长训练时间。
NVIDIA Recovery 是 NVIDIA DSX OS 的一部分,是一项开源工作负载级服务,可在集群的训练作业中实现全天候自动恢复。它使用应用程序日志、GPU 指标和调度程序信号来检测中断,使用故障属性来识别相关资源,并协调检查点在正常容量下的隔离和重启检查点。通过跨工作负载自动执行此恢复循环,它可以处理并发中断,减少人工干预,并帮助维持训练的良好输出。本文将介绍恢复循环的工作原理、NVIDIA Recovery 如何与 Slurm 集成,以及如何在您自己的集群上进行部署。
工作负载恢复是一个独特的 AI 工厂问题
我们之前的 NVIDIA DGX 云弹性博文、GTC 演讲 和 NVIDIA Mission Control 2.5 博文 介绍了保持训练效率的分层方法。NVIDIA Recovery 以该架构为基础,将基础设施修复与工作负载恢复相连接。
Break-fix 自动化可识别故障节点,将其从服务中移除,并路由硬件进行修复。框架级库如 NVRx 可在单个训练作业中提供恢复、挂起检测和掉队缓解功能,但每位用户都必须为自己的工作负载配置和管理这些功能。Slurm 等集群工作负载管理器可管理资源分配、队列和容器执行。
工作负载恢复是一个独特的协调问题:恢复生产训练需要将故障归因于其原因,确定是否应以及应在何处重新启动受影响的作业,并在共享基础设施的工作负载之间采取一致行动。解决这一问题需要集群级控制循环,该循环集成了基础设施修复、框架级恢复和集群工作负载管理,并具有跟踪恢复延迟、恢复成功率和恢复生产训练所需时间的操作指标。
多层 NVIDIA 运行状况和恢复堆栈
如下图 1 所示,NVIDIA Recovery 在 DSX OS Stack 中提供了专用的工作负载恢复层。节点运行状况监控和隔离取决于集群的编排和工作负载管理堆栈。Kubernetes 部署使用 NVSentinel 监控 GPU 运行状况指标和 XID 事件,并自动封锁和释放故障节点。许多 Slurm 站点使用自定义的 prolog 和 epilog 脚本检查节点运行状况。在 Kubernetes 上运行 Slurm 时,Slinky 项目中的 slurm-operator 会原生支持并注入这些相同的脚本。在单个训练作业中,NVRx 提供了一个用于工作中恢复和挂起检测的库。NVIDIA Recovery 可在集群级别协调跨工作负载的恢复,并集成这些功能来管理作业的重启、放置和节点排除。
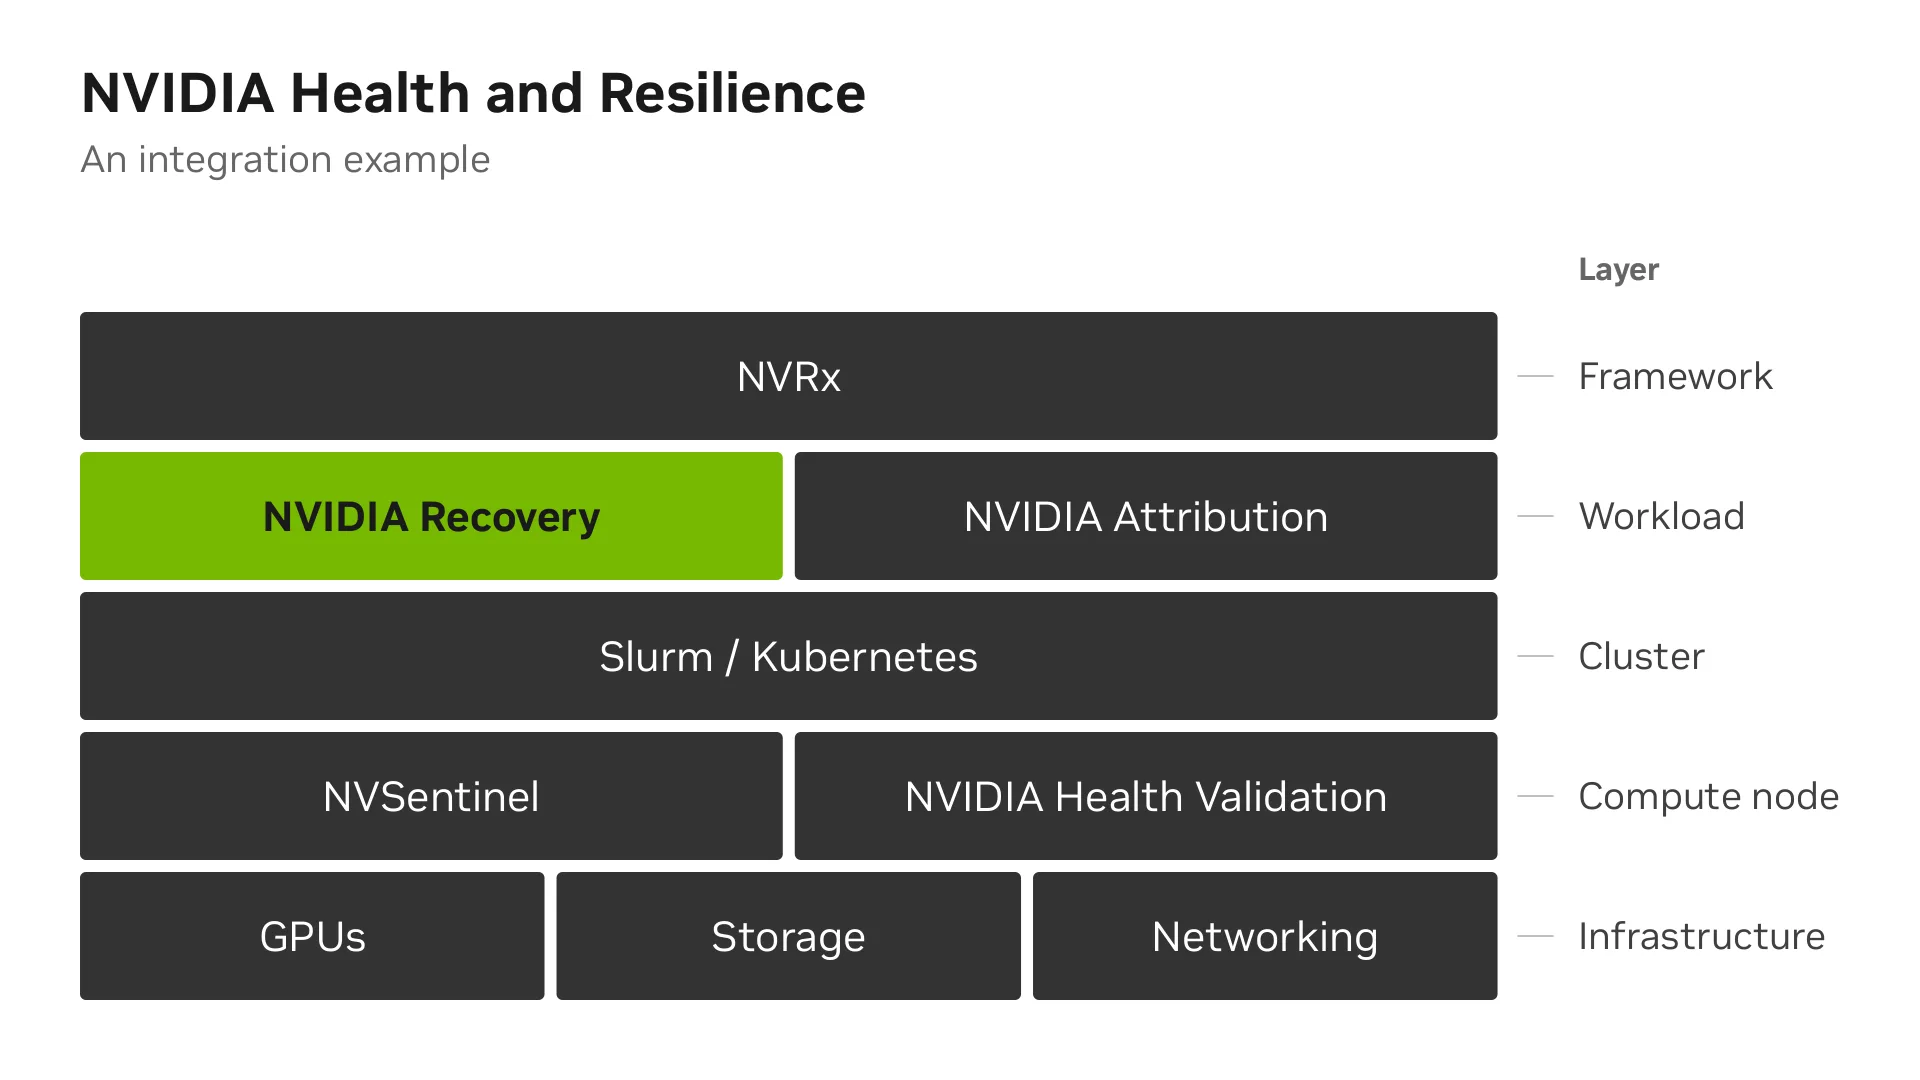
这些层独立运行,不存在硬依赖项,因此您可以采用每个模块化组件或插入自己的平台组件进行集成。例如,如果您的集群已经依赖 NVSentinel 或 NVIDIA Health Validation,则您可以集成 NVIDIA Recovery,而无需对现有的运行状况工作流进行任何更改。
对于已运行 NVRx 的环境,NVIDIA Recovery 通过管理跨工作负载生命周期和节点排除,填补了作业重启无法达到的空白。与 NVIDIA Attribution 搭配使用时,它可以获得丰富的跨层诊断结果,从而丰富持久的审计追踪。
差距成本
在集群规模上,罕见的每 GPU 故障都会增加。即使每个 GPU 在指定日期内以 99.9% 的概率无故障运行,则跨越 10000 个 GPU 的作业在该日可不间断地完成,且概率仅为 0.99910,000 ≈ 0.005%。这解释了为什么在 Meta 对 24000 个 A100 GPU 进行的为期 11 个月的研究中,硬件故障中断的作业不到 1%,而这些作业占 GPU 运行时间的 19%:最大、运行时间最长的作业暴露程度最高。
NVIDIA Recovery 可在集群的训练工作负载中自动进行恢复,适用于小型和大型分布式运行。许多较小的作业会不断发生中断,从而增加运营负担。在大型作业中,每次中断都会影响更多 GPU,从而增大恢复的计算成本。自动恢复可解决这两个挑战。
我们的生产观察结果凸显了这种跨集群工作负载的高效自动化恢复的需求:从 7 月 9 日至 10 月 9 日,一个训练集群上的 NVIDIA 恢复监控每天覆盖近 200 项作业,并记录了约 8550 次异常检测,平均检测和恢复操作延迟分别为 69 秒和 94 秒。这种无人值守的全集群响应减少了对单个工程师的依赖,并减少了中断次数不断增加时对每个用户的恢复安排。恢复操作延迟在自动操作时结束;调度和检查点恢复决定了何时恢复有效训练。
自动恢复循环
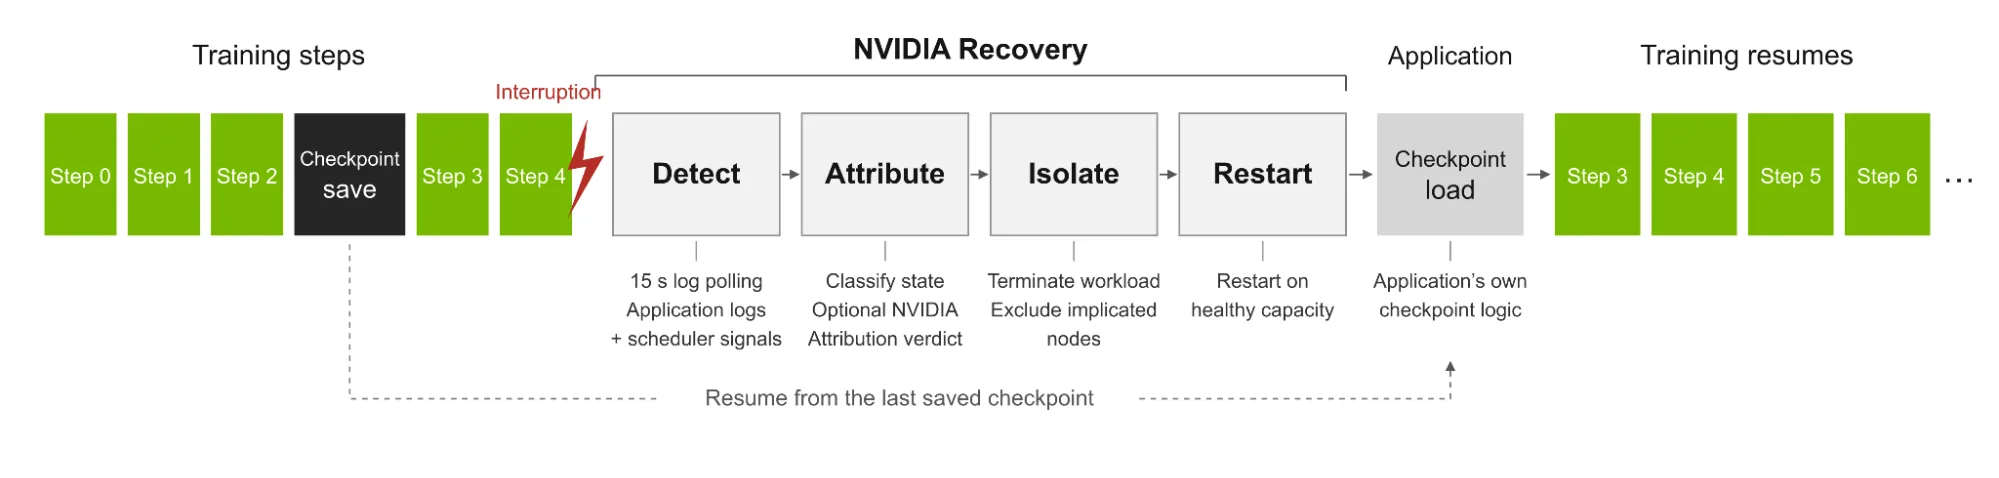
NVIDIA Recovery 可在整个集群的训练工作负载中协调恢复工作。循环分为四个阶段,动作由中断和配置策略决定:
- 检测:异常检测器将应用程序日志和调度程序信号相结合,以识别崩溃、挂起和掉队者。它可以识别 PyTorch 和 NCCL 故障、CUDA 错误和互连故障模式。缺少进度信号或已识别的通信挂起模式表示可能出现挂起;相对于最近的基准,吞吐量持续下降表示可能出现掉队现象。
- 属性:NVIDIA Recovery 使用在检测过程中收集的调度器信号和应用程序日志对中断进行分类并指导恢复操作。与 NVIDIA Attribution 的可选集成增加了更深入的诊断,以区分硬件故障、系统软件问题和应用程序错误。这一证据可告知节点排除,并丰富审计追踪。运营商还可以集成自己的追踪服务,并独立采用 NVIDIA Recovery。
- 隔离: The Anomaly Remediator 应用恢复建议,将相关节点排除在后续重启尝试之外,或者在进一步重试不起作用时停止工作负载。它会跟踪相关节点的各种尝试,以避免反复出现故障。此外,安全网络 (看门狗服务) 允许在恢复决策耗时过长或彻底失败时继续正常调度,从而防止工作负载无限期等待。
- 重启或停止:调度程序集成通过 Advisor API 根据 NVIDIA Recovery 的建议发挥作用,以重启工作负载或停止非生产性重试。重启时,应用程序使用其现有的重启逻辑从上次保存的检查点恢复。如果作业在可配置的多次尝试中未能保存新的检查点,则可以停止进一步的重试。审核追踪记录重启和停止决策,分配重启、恢复训练进度,并将训练完成追踪为不同的事件。
NVIDIA 恢复与工作负载调度程序集成
NVIDIA Recovery 作为控制平面服务运行,并通过 HTTP 或 gRPC API 与集群的调度程序集成进行通信。它支持 Slurm,并在路线图上提供 Kubernetes 支持。恢复建议遵循通用 API 合同,集群侧控制器将其转换为工作负载管理器的操作。这样可使 NVIDIA Recovery 独立于调度程序内部,并避免更改应用程序代码。
对于 Slurm,参考 Advisor 控制器可作为 Helm 图表轻松部署。它支持两种模式:1) 集群内模式,控制器在集群内运行;2) SSH 模式,控制平面远程连接到 Slurm,无需添加集群内服务。当部署新的集群组件需要更改窗口或进行安全审查时,此选项便可派上用场。
NVIDIA Recovery 会在控制器行动之前记录每个恢复建议,从而创建预期操作的审计追踪。如果控制器在恢复期间重启,它会先检查当前的调度器状态,然后再继续,这样可以防止重复操作已完成。
运行:监控模式和审核追踪
默认情况下,新部署以监控模式启动。在此模式下,NVIDIA Recovery 会发布建议并记录其完成的操作,并且不执行任何调度程序操作。查看该建议,将决策与您自己的工程师所做的工作进行比较,并在您对信噪比感到满意后切换到每个集群的操作模式。
controller:
  environment: prod
  acknowledgeSchedulerActions: false

watchdog:
  enabled: true
  mode: observe
  acknowledgeSchedulerActions: false
  environmentPattern: prod
IBM Research 在其 Slurm 集群上采用了这一方法。他们先在显示器模式下运行,将建议与自己的手动恢复决策进行比较,并在验证信号后启用自主操作。Verda 是一家新云提供商,它部署在 Victoria Logs (而不是 Loki) 上,并在存储库的一个 VictoriaLogs 连接器上进行协作,从而快速启动了 OSS 合作伙伴计划。
NVIDIA Recovery 会将每个操作写入持久、可查询的审计追踪。每个条目都会捕获匹配的检测模式、所采取的行动 (击杀、请求、释放或节点排除) 、时间、工作负载标识符,以及返回时的 NVIDIA Attribution judgement ( NVIDIA Attribution judgement) 。策略引擎操作和看门狗操作位于相同的路径中,因此记录没有差距。
“Recovery Console” (恢复控制台) 是 Operator 控制面板。它可以跨调度程序类型显示实时工作负载状态,显示异常标志,并为您提供每个检测事件和恢复操作的每个工作负载时间轴。
NVIDIA Recovery 在 Apache 2.0 许可下的 dsx-ai-factory/NVIDIA-Recovery GitHub 存储库中提供。恢复第一个工作负载需要三个步骤:
- 安装图表。NVIDIA Recovery 通过单个 Helm 总图进行部署。随附捆绑的 MySQL 子图表,因此您可以在本地运行快速入门,而无需调配数据库或物理 GPU。对于生产环境,请将图表指向托管式 MySQL 服务。资源库中的 Operator 部署指南涵盖了 Kubernetes、Helm 和 Slurm 的路径和当前版本要求。
- 验证您的信号。将图表指向您现有的 Loki 或 Victoria Logs 端点以及您的 Prometheus scrape 目标,然后在执行第一个工作负载之前运行日志摄取配置器。它会根据 NVIDIA Recovery Contract 测试您的信号,映射与默认设置不同的标签名称,并在不匹配变成无提示故障之前将其表面化。
- 选择工作负载。为 sbatch 提交脚本添加一条指令:
#SBATCH --comment='{"nvidia-recovery":{"environment":"prod","mode":"observe"}}'
之后,NVIDIA Recovery 会通过应用程序日志和调度程序信号监控工作负载。在显示器模式下,它会发布恢复建议而不采取行动。在“Recovery Console” (恢复控制台) 中验证这些建议后,请在 Helm 值中将“mode” (模式) 设置为“action” (行动) ,并将“accountSchedulerActions” (确认调度器行动) 设置为“true”,以启用自主恢复。
其他资源涵盖其余部分:
- dsx-ai-factory/nvidia-recovery GitHub 资源库,用于源和问题跟踪器。
- 快速入门指南,无需物理 GPU 即可运行。
- 适用于集群内和基于 SSH 的 Slurm 部署的 Operator 部署指南。
- 架构参考,用于了解控制平面如何组合在一起。
NVIDIA Attribution 是推荐的配套部署。它为 NVIDIA Recovery 提供了更深入的诊断结果和更丰富的审计追踪;它是可选的,并且与 NVIDIA Recovery 一起提供。
未来趋势
此版本通过 slurm-operator 恢复 Slurm 作业,包括 Kubernetes 上的 Slurm 作业。接下来是两项功能。Slurm 作业数组的恢复功能为以数组形式运行的多个团队提供超参数扫描保护:每个失败的任务都会自行恢复,当故障看起来是系统性的时,恢复功能就会停止。原生 Kubernetes 恢复从 JobSet 和 Kubeflow PyTorchJob 开始,使用开源Workload Map项目来支持每种工作负载类型。
除此之外,路线图还包括更清晰的故障分类、在控制面板和 API 中更清晰地记录每个恢复决策,以便您可以将其输入到自己的可观察性工具中,以及面向稳定版本的工作。对路线图问题进行投票和评论,以确定优先事项。
IBM Research 已部署 NVIDIA Recovery 用于训练工作负载,并正在与团队合作,从中改进故障模式。Verda 是首个部署该平台的 NVIDIA 云合作伙伴,该平台使用的是 NVIDIA Recovery with VictoryLogs,并已提交了首批 Pull Request。随着越来越多的采用者做出贡献,他们的更改也会像 NVIDIA 一样接受审查。
NVIDIA Recovery 是 DSX OS 的一部分,DSX OS 是 NVIDIA 用于 AI 工厂运营的开源软件层。它在 Apache 2.0 下获得许可。
开始使用
NVIDIA Recovery 可自动完成恢复周期,该周期在凌晨 3 点由工程师手动处理。克隆存储库,在遥测堆栈上运行配置器,然后选择其中的工作负载。第一个中断将显示循环的端到端情况。
- Thedsx-ai-factory/nvidia-recovery GitHub 存储库,用于源和问题跟踪器
- 快速入门指南,无需物理 GPU 即可运行
- 适用于集群内和基于 SSH 的 Slurm 部署的 Operator 部署指南
- 架构参考,用于了解如何将控制平面组合在一起
致谢
Abhishek Jha、Alex Kondratenko、Amy You、Andrew McHarg、Ashwin Poojary、Ashwini Awatiger、Benjamin Schmaus, Bob Schatz、Collin Neale、Dave Yao、Deepak Narayanan、Dilpreet Singh、Divyansh Jain、Dong H. Ahn、Torrin Poorkay、Evan Briodes、Gargi Prasad、Haim Elisha、Hamzeh Doostie、Harmandeep Singh、Harri Lin、Himanshu Soni、Ian Gibbs、Jason Sewall、Kumar Anik、Maer Rodrigues de Melo、Megan Chao、Mike


