

构建 AI 应用的团队需要从模型配置到工作推理端点的可重复路径。NVIDIA Dynamo 是一个分布式推理框架,可协调 GPU 工作者之间的模型服务。在 Kubernetes 上部署它只是第一步。成功部署模型需要更多:GPU 驱动程序、资源分配、调度、网络和监控必须协同工作。解决这些依赖项需要耗费大量时间来测试模型行为、提供性能和应用集成。
NVIDIA DSX AI 工厂平台整合了多种技术,可帮助生态系统设计、构建和运营更高效的 AI 工厂,Dynamo 就是其中之一。为了更轻松地管理这些基础设施依赖项,该平台包含 NVIDIA AI 集群运行时 (AICR)。它将 NVIDIA Dynamo 及其支持基础架构打包到经过验证的方案中。每个 recipe 都为特定环境和工作负载定义了配置,包括固定组件版本、兼容性限制和验证检查。AICR 为平台团队提供了一种可重复的方式来部署和检查运行时,为开发者提供服务模型和测试应用的一致基础。
此演练介绍了在 Kubernetes 上支持 Dynamo 的基础设施,比较了两个路由选项,并展示了如何使用 AICR 部署和验证运行时。
为什么底层运行时对 Dynamo 很重要
在 Kubernetes 上使用 Dynamo 运行模型的第一步是使用 DynamoGraphDeployment,其中指定了 vLLM、SGLang 或 NVIDIA TensorRT LLM 应如何在集群上的 Pod 中运行。但图形只是堆栈的顶部。生产推理集群还需要其下方的运行时层。它必须回答以下问题:
- NVIDIA GPU Operator 是否安装了与节点相匹配的驱动程序堆栈?
- GPU 节点是否已标记且可被发现?
- 集群是否通过预期的动态资源分配 (DRA) 驱动程序公开 GPU?
- 调度程序能否使用所需的拓扑结构和帮组调度语义放置 GPU worker?
- 在工作负载登陆降级节点之前,节点运行状况信号是否可用?
- Prometheus 是否适用于 Dynamo 和加速器指标?
- 当入口处的部署应为 Kubernetes 原生时,网关 API/端点选择器 (EPP) 路径是否已配置?
AICR 在 recipe 中捕获这些运行时要求。
AICR 为 Dynamo 提供的产品
AICR Dynamo recipe 会将 Dynamo 及其所依赖的集群运行时组件打包在一起。
AICR 提供了 dynamo-platform 图表的 1.4.2 版本,其中包括 Dynamo 运算符、Dynamo 运行时镜像以及 nvidia.com/v1beta1 DynamoGraphDeployment CustomResourceDefinition (CRD) 等资源。v1beta1 将取代之前的 v1alpha1 API 版本。
表 1 列出了 recipe 中包含的支持基础架构组件。
| 预备知识 | 要求 | AICR recipe 中的组件 |
|---|---|---|
| GPU 驱动程序堆栈 | 与节点相匹配的驱动程序和 GPU 软件堆栈 | NVIDIA GPU Operator |
| GPU 发现 | 标记 GPU 节点并可将其发现以供放置 | 节点功能发现 |
| GPU 分配 | 通过 Kubernetes 原生动态资源分配 (DRA) 公开的 GPU | 适用于 NVIDIA GPU 的 DRA 驱动程序 |
| 调度 | 为 GPU 工作者安排所需的拓扑和分组调度 | KAI 调度程序 |
| 推理工作负载编排 | 多组件服务图以协调组的形式启动、放置和扩展 | Grove |
| 节点运行状况 | 在工作负载登陆降级节点之前提供运行状况信号 | 所选 recipe 支持的 NVSentinel 和 Nodewright |
| 指标 | 收集的集群、加速器和 Dynamo 服务指标 | Prometheus 堆栈 |
| Ingress | 入口为 Kubernetes 原生时配置的网关/ EPP 路径 | 代理网关 和网关 API 资源,如路由部分所述 |
此外,recipe 还固定组件版本并记录配置值、节点选择器、容差、checksum 和验证期望,以实现可重现的部署。
借助 Dynamo 1.4、前端、worker、可选的 网关 API 推理扩展 (GAIE) / 端点选择器插件 (EPP) 组件 以及其他 Dynamo 服务,可以通过 Kubernetes 资源相互探索。因此,AICR 的默认路径不再使用 NATS,并且 dynamo-platform chart 也不再默认安装该路径。对于需要 NATS 的部署,NATS 仍然可以选择使用。
代理式工作负载反复扩展长token前缀,包括系统提示、工具定义、对话历史记录和工具结果。如果轮到 GPU 显存中没有该前缀的工作者,则系统会重新处理中间token,而不是重复使用缓存的结果。Dynamo 通过其前端路由器或网关 API 层的 GAIE/ EPP 集成,将请求路由到已持有相关 KV 块的工作者。
Dynamo 还可以将提示处理 (预填充) 与token生成 (解码) (一种称为解服务的架构) 分开。在 KV 缓存未命中的情况下,必须由预填充池对全部或部分提示词进行重新处理。然后,解码工作者接管逐个token生成,这具有不同的 GPU、内存、延迟和批处理特征。缓存漏报率取决于工作负载。长时间运行的代理式会话的行为方式与一次性聊天请求不同。分解服务使操作员能够针对给定的请求组合单独扩展和调整预填充和解码容量。
请求平面和 KV-cache 事件平面是分开的。在 Dynamo 1.4.2 中,默认的 AICR Kubernetes 路径使用 TCP 处理请求,并使用 ZMQ 处理 KV 缓存事件。每个 vLLM 工作引擎都会通过本地 ZMQ 发行商发送原始 KV 缓存事件,例如,使用以下 vLLM 配置:
--enable-prefix-caching --kv-transfer-config \
  {"enable_kv_cache_events": true, "publisher": "zmq", "endpoint": "tcp://*:5557"}
然后,Dynamo 的 worker runtime 会订阅该本地 vLLM 事件源,对事件进行归一化,并将其重新发布到 Dynamo 事件平面上。原生 Dynamo 前端路由器和 GAIE/ EPP 路径都使用此 Dynamo 管理的 KV 缓存状态来做出路由决策。
Kubernetes 上的 Dynamo 路由路径是什么?
Dynamo 在 Kubernetes 上支持两种路由路径。第一种是使用 Dynamo 前端路由器进行工作者选择。第二种是使用 Kubernetes 网关 API 实现来实现入口,使用 Dynamo EPP 来选择端点。AICR 为任一拓扑发布并验证 Dynamo 运行时。
路径 1:Dynamo 前端路由器
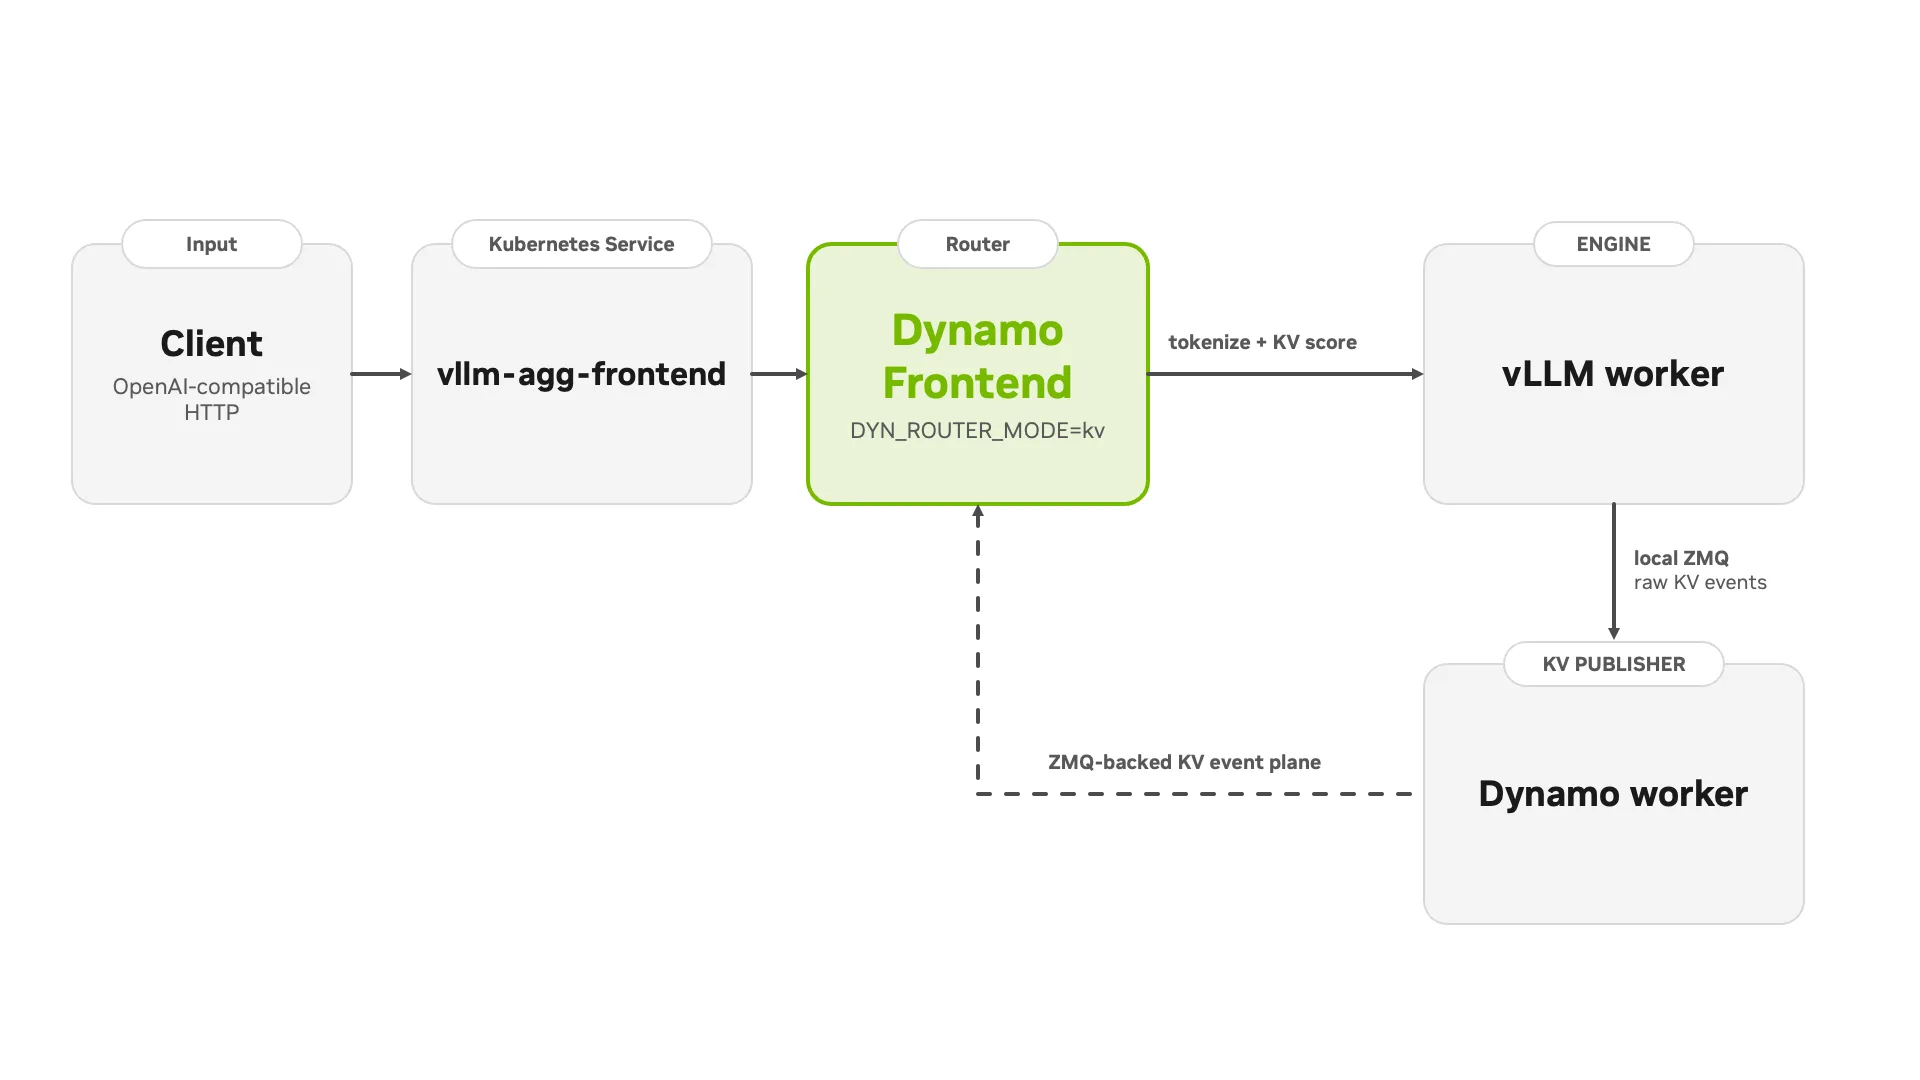
默认路径显示 Kubernetes Service 后面的 Dynamo 前端。在使用 DYN_ROUTER_MODE=kv 运行时,前端会标记每个请求,使用前缀重叠和当前加载对符合条件的 worker 进行评分,选择 worker,然后通过 Dynamo 请求平面 (默认使用 TCP) 分发请求。
当应用程序团队拥有模型特定的端点,或者现有的边缘代理只需要将流量转发到 Dynamo 前端服务时,此路径是合适的。它是用于部署和验证 Dynamo 图形的最小拓扑,也是经过生产验证的服务选项。它不需要路径 2 中使用的其他网关和 EPP 组件。
路径 2:网关 API 推理扩展程序和 Dynamo EPP
此路径将 Dynamo 与网关 API 和网关 API 推理扩展程序 (GAIE) 集成。在 AICR 示例中,代理网关将 HTTPRoute 解析为 InferencePool。Dynamo Operator 从 DynamoGraphDeployment 创建 InferencePool:其选择器识别符合条件的工作 pod,而 endpointPickerRef 识别 Dynamo EPP 服务。
网关通过 GAIE 的端点选择接口调用 Dynamo EPP。EPP 会对请求进行标记化,并使用 Dynamo 的 KV 路由器选择端点。它将选择和路由元数据返回到网关实现,即实际的 HTTP 代理。在此模式下,每个可路由的 worker pod 都包含一个 Dynamo Frontend sidecar,它接收来自网关的请求并将其转发到本地 worker 容器。前端使用 --router-mode direct 运行,因此它会应用 EPP 选择,而无需重新路由。
此路径适用于平台团队管理共享 Kubernetes 入口,并且需要通过网关 API 机制配置模型端点工作进程选择、超时、重试和回退的情况。请注意,这两种路由方法都适用于网关 API HTTPRoute。区别在于哪一个组件管理着向 worker 的传输:Dynamo 前端或网关本身。
注意:本文将介绍 Dynamo 与 GAIE 的 Operator-managed DynamoGraphDeployment 集成;实验性独立 vLLM on-ramp 是一个单独的集成。在 Dynamo 1.4 中,此路径使用 GAIE 的 Go EPP 框架,Dynamo 的 Rust KV 路由器通过 CGO 嵌入,并通过 eppConfig 进行配置。
展望:从 Dynamo 1.5 开始,原生的 Rust EPP 将取代 Go/CGO 桥接器。它直接实现 GAIE 的 Lightweight Endpoint Picker (ext_proc) 接口,在进程中运行完整的 Dynamo 路由器,并使用 DYN_* 环境变量代替 eppConfig 插件和调度配置文件。聚合和分解路由直接通过通过 Dynamo 发现注册的工作者角色进行处理。周围的 Kubernetes 拓扑结构保持不变。移除 Go 插件框架和 CGO 边界还可减少每个请求的 EPP 用度。
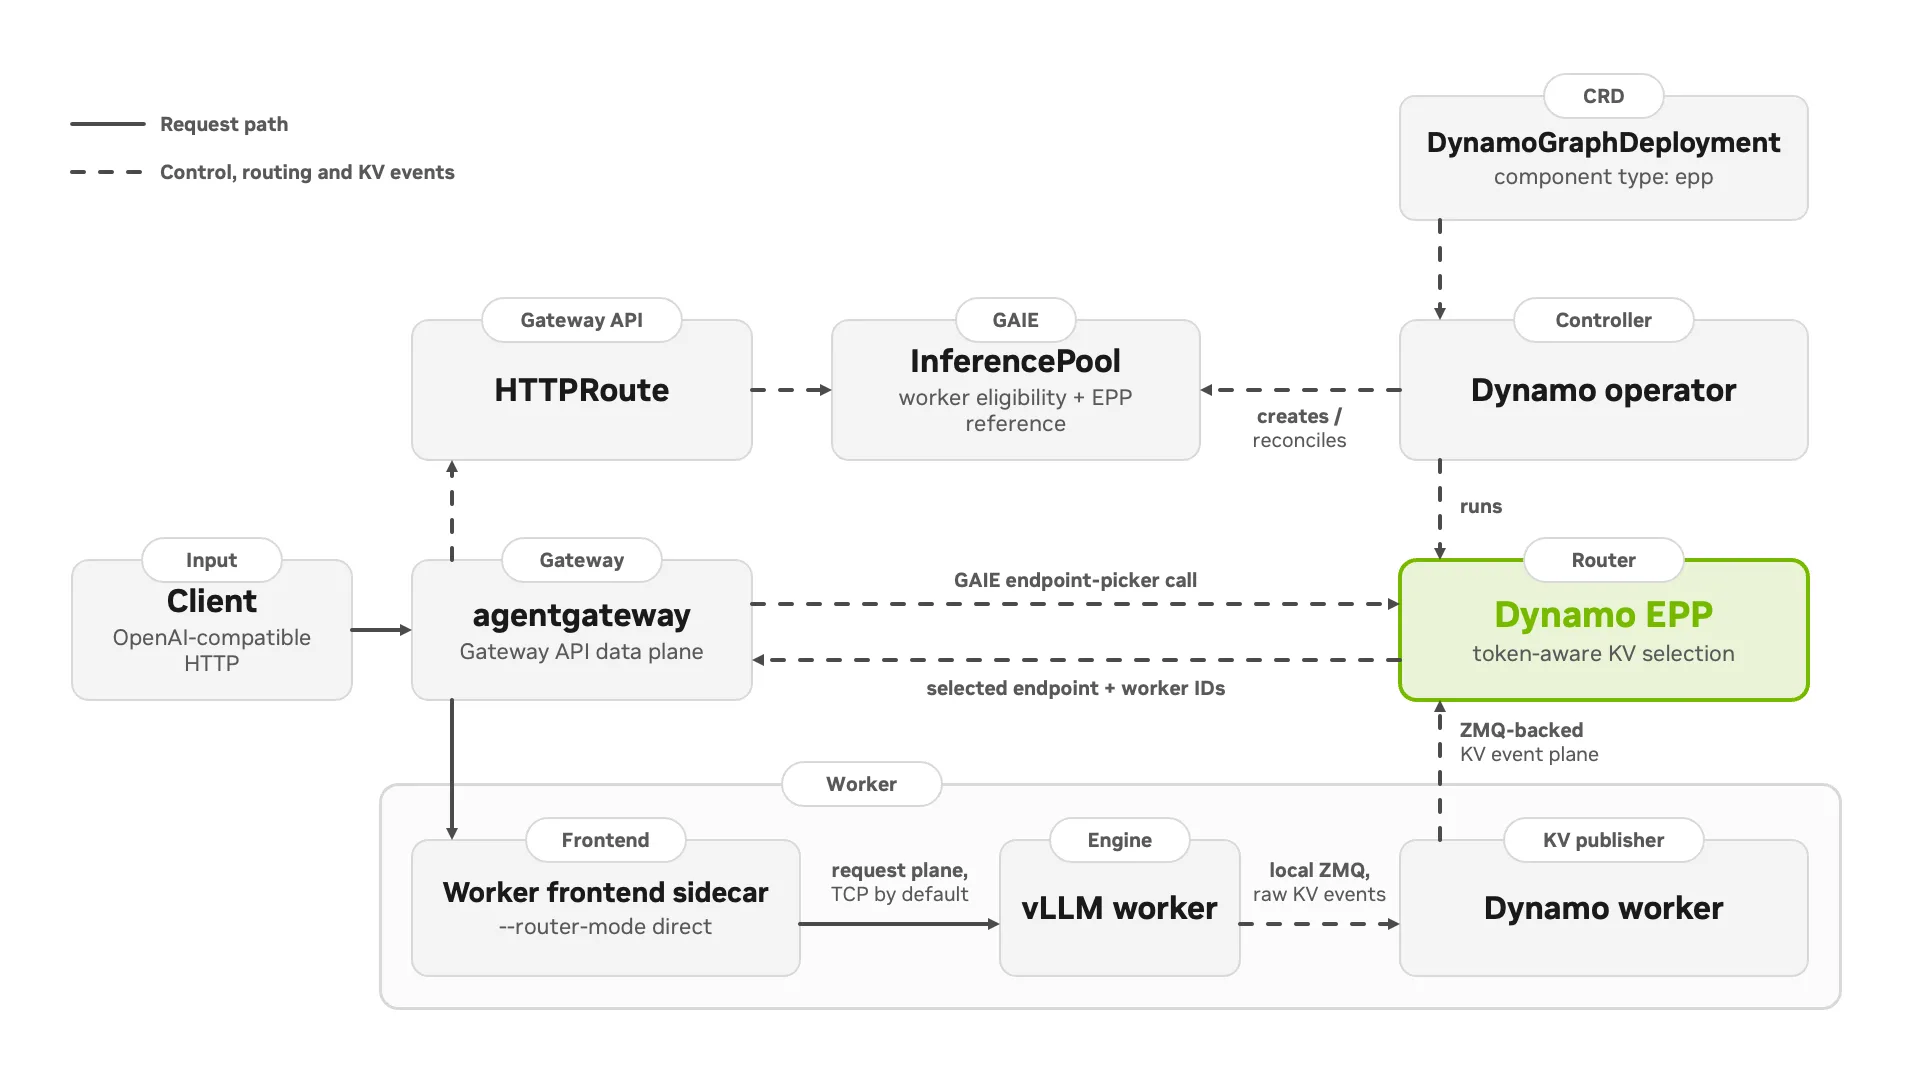
客户端请求通过网关 (例如 agentgateway) 进入,并匹配由 InferencePool 支持的 HTTPRoute。网关调用 Dynamo EPP,后者仅执行token感知 KV 选择,并返回选定的端点和路由元数据。然后,网关会在直接模式下将请求转发给所选择的 worker 的前端 sidecar,然后通过 Dynamo 请求平面将请求发送给 vLLM worker。工作者 KV 缓存状态通过 Dynamo 事件平面到达 EPP,而 Dynamo Operator 则从 DynamoGraphDeployment 创建 EPP 和 InferencePool。
选择路径
路由路径取决于网关或 Dynamo 前端是否应处理向 worker 转发的请求,包括超时、重试和回退管理。表 2 比较了 Dynamo 前端和网关 API/ EPP 路径。
| 决策 | Dynamo 路由器 | GAIE/ EPP |
|---|---|---|
| Ingress 所有者 | Dynamo 前端服务 | 网关和 HTTPRoute |
| 员工选择 | 前端选择并派遣工作人员 | EPP 选择端点;网关转发请求 |
| 请求路径 | 客户端前端 worker | 客户端+ 网关+ worker 前端 sidecar+ worker |
| 最适合 | 模型特定的 Dynamo 端点,具有最小的服务拓扑 | 通过网关 API 资源进行管理的共享 Kubernetes 入口 |
| 其他基础设施 | 除了 Dynamo 前端和 worker 之外 | 兼容 GAIE 的网关、推理池、EPP 和 worker 前端 sidecar |
| KV 缓存行为 | 基于工作者发布的缓存和负载状态的 Dynamo KV 感知路由 | 在网关层使用相同的 Dynamo KV 感知路由 |
这两种路径都使用工作者发布的 KV-cache 事件来实现精确的缓存感知放置。可以将 Dynamo 配置为预测其从何处发送每个请求的 KV 缓存状态。预测无法看到驱逐,因此路由器的视图可能会偏离每个工作人员的实际视图,并且路由质量会降低,尤其是在内存压力下。本文中的 AICR 配置启用了实时事件,因此这两种路径都使用工作节点报告的 KV 缓存状态进行路由。
AICR recipe 流的工作原理
AICR 将运行时设置与应用程序部署分开。首先,它捕获现有的 Kubernetes 集群,并生成匹配的 Dynamo recipe。然后,在安装应用程序的 DynamoGraphDeployment 并测试其推理端点之前,渲染、部署和验证运行时包。
第 1 步:对集群进行快照
该快照捕捉了 AICR 用于选择和验证配方的集群状态:
aicr snapshot \
  --namespace aicr-validation \
  --output snapshot.yaml
如果未指定放置标志,AICR 会自动以标记为 nvidia.com/gpu.present=true 的节点为目标,并允许 GPU 节点污点。当集群需要时,--node-selector 和 --toleration 标志可提供更具体的放置。
第 2 步:生成 Dynamo 推理方案
AICR 使用快照识别 Kubernetes 分布、GPU 加速器和 GPU 节点操作系统。该命令可指定工作负载意图和平台:
aicr recipe \
  --snapshot snapshot.yaml \
  --intent inference \
  --platform dynamo \
  --output recipe.yaml
生成的 recipe 会记录固定组件版本、特定于环境的配置、兼容性限制和验证检查。对于适用于 NVIDIA GB200 NVL72 和 NVIDIA GB300 NVL72 系统的 Amazon EKS Dynamo 推理 recipe,AICR v1.0.0 选择以下 Helm 图表版本:
Component |
Version |
|---|---|
NVIDIA GPU Operator |
v26.7.1 |
Node Feature Discovery |
0.19.0 |
cert-manager |
v1.20.2 |
AWS EBS CSI Driver |
2.59.0 |
AWS EFA |
v0.5.29 |
NVSentinel |
v1.25.0 |
NodeWright Operator |
v0.19.0 |
NVIDIA DRA GPU Driver |
0.5.0 |
KAI Scheduler |
v0.16.9 |
Grove |
v0.1.0-alpha.13 |
Dynamo Platform |
1.4.2 |
Agent Gateway |
v1.5.0 |
Agent Gateway CRDs |
v1.5.0 |
Kube Prometheus Stack |
84.4.0 |
Prometheus Operator CRDs |
28.0.1 |
Prometheus Adapter |
5.3.0 |
Kubernetes Ephemeral Storage Metrics |
1.19.2 |
AICR 团队在指定的平台和硬件上同时测试了这些组件版本。以下验证步骤可验证集群是否满足所选 recipe 的要求。
可选的离线检查
“Recipe selection” (菜谱选择) 已使用 snapshot.yaml 中的集群事实,因此根据相同的快照验证生成的菜谱几乎没有用。在不联系 Kubernetes 的情况下,离线验证在使用不同捕获的集群快照测试配方时非常有用。它评估声明性约束,而行为检查则报告为跳过。
aicr validate \
  --recipe recipe.yaml \
  --snapshot candidate-snapshot.yaml \
  --no-cluster \
  --output dry-run.json
第 3 步:渲染运行时捆绑包
AICR 会将 recipe 渲染为可部署的 Helm 值并加以体现:
aicr bundle \
  --recipe recipe.yaml \
  --accelerated-node-selector nodeGroup=gpu-worker \
  --accelerated-node-toleration dedicated=worker-workload:NoSchedule \
  --accelerated-node-toleration dedicated=worker-workload:NoExecute \
  --system-node-selector nodeGroup=system-worker \
  --system-node-toleration dedicated=system-workload:NoSchedule \
  --system-node-toleration dedicated=system-workload:NoExecute \
  --set-json agentgateway:allowedSourceRanges='["<your-cidr>"]' \
  --deployer helmfile \
  --output bundle
这些放置标记反映了用于此演示的测试集群。对于具有不同标签和污点的集群,可以调整或省略这些标志。如果集群没有默认的 StorageClass,命令还需要 --storage-class。
第 4 步:部署运行时
对于没有集群内 GitOps 控制器的本地部署,Helmfile 提供了一个部署选项。使用本地可用的 Helm 和 helm-diff 插件 时,以下命令会在应用之前检查 AICR 生成的版本图:
helmfile -f bundle/helmfile.yaml diff
helmfile -f bundle/helmfile.yaml apply
AICR 在生成的 Helmfile 包中对组件依赖项进行编码。Helmfile 按顺序处理这些依赖关系层,并同时在层中应用独立组件。重新运行应用可将已安装的 Helm 版本与生成的配置保持一致。
如果 Helmfile 不可用,可以使用 AICR 的默认 Helm 部署器重新生成该捆绑包。其生成的 deploy.sh 脚本是交互式测试驱动的轻量级备用脚本:
aicr bundle \
  --recipe recipe.yaml \
  [... all the flags setting node selectors and tolerations ...] \
  --set-json agentgateway:allowedSourceRanges='["<your-cidr>"]' \
  --deployer helm \
  --output bundle-helm

chmod +x bundle-helm/deploy.sh
 ./bundle-helm/deploy.sh
对于生产环境,AICR 还会使用 --deployer argocd、 --deployer argocd-helm 和 --deployer flux 渲染 GitOps 捆绑包。
第 5 步:验证已安装的运行时
完成安装、部署和一致性验证后,请先检查实时集群,然后再安装应用程序工作负载。由于此处未提供快照,因此 AICR 会在运行验证器作业之前捕获当前集群状态。
aicr validate \
  --recipe recipe.yaml \
  --node-selector nodeGroup=gpu-worker \
  --toleration dedicated=worker-workload:NoSchedule \
  --toleration dedicated=worker-workload:NoExecute \
  --phase deployment \
  --phase conformance \
  --output report.json
只有在这些检查通过后,才会安装应用程序 DynamoGraphDeployment。性能验证单独运行,因为它会部署临时服务工作负载并使用受测 GPU。
AICR 验证检查什么内容?
AICR 根据所选 recipe 中编码的检查和约束来验证已安装的运行时。检查因食谱而异。对于 Dynamo 推理方案,部署和一致性验证通常包括以下内容:
| 面积 | 勾选了什么 |
|---|---|
| 集群基准 | 预期的集群资源、GPU 可分配容量以及加速器节点上正常运行的 nvidia-smi |
| 平台运行状况 | GPU Operator 运行状况和版本,以及 Dynamo 平台和 Operator 运行状况 |
| 加速器访问 | DRA 支持和安全加速器访问 |
| 调度和扩展 | 分组调度、Pod 自动扩展、集群自动扩展和强大的控制器行为 |
| 可观测性 | Prometheus 支持的加速器和 AI 服务指标 |
| Ingress | 适用于 Kubernetes 原生入口的网关 API 和代理网关就绪情况 |
在部署应用程序之前,这些检查会验证安装的运行时是否满足所选 recipe 的要求。
AICR 将版本控制的运行时配置与验证集群是否满足所选 recipe 要求的检查相结合。
开始使用
NVIDIA AI 集群运行时 (AICR) 和 NVIDIA Dynamo 是 NVIDIA DSX AI 工厂平台的开源组件。在 Kubernetes 上部署 Dynamo 的团队可以使用 AICR 的方法和部署示例来配置、部署和验证支持其推理工作负载的基础设施。
- 您可以通过 NVIDIA DSX AI Factory GitHub 获取其他项目和社区资源。
- 您可以在 NVIDIA DSX AI Factory Slack 社区中进行讨论。在 KubeCon+ CloudNativeCon North America 期间,NVIDIA DSX OS AI 推理和贡献者研讨会提供了 AICR 实操体验。由于席位有限,需要注册。
- KubeCon 期间,NVIDIA 在 170 号展位上展示了 Kubernetes 的深入探讨和现场演示。


