视觉语言模型使构建能够理解生产级视频的视觉 AI 智能体成为可能。更棘手的问题是将这种能力转变为可维护的系统,将提取、流处理、事件检测、检索、总结和报告结合起来。
用于视频搜索和总结 (VSS) 的 NVIDIA Metropolis Blueprint 及其智能体技能可帮助开发者更快地构建视觉 AI 智能体。VSS 可连接NVIDIA Cosmos 等视觉语言模型 (VLM) 、NVIDIA Nemotron 等 LLM、检索增强生成 (RAG) 和模型上下文协议 (MCP) 工具,将实时和录制的视频转化为自然语言搜索、视觉问答、验证警报和自动报告。
VSS Blueprint 3.3 还可同时降低成本:借助新的 Build Vision Agent 技能 (vss-build-vision-ai) 加快应用程序合成速度,并借助自适应高效视频采样 (EVS) 在运行时降低 VLM 处理成本。
本文将介绍成本降低的两个方面。在开发方面,只需一个提示,即可在 30 分钟内构建和部署生产线溢出代理,只需使用几美元的编码代理。在运行时方面,自适应 EVS 在 60 分钟的总结中提供的 VLM 输入token减少了 80%,在同一 GPU 上并发流的数量增加了 46%。
要了解更多信息,请参加我们于 10 月 1 日上午 9 点 (太平洋时间) 举办的直播活动,届时我们将根据单个提示构建视觉 AI 智能体。
为什么视觉 AI 智能体价格昂贵
生产级视觉 AI 智能体 通常涵盖多个工作流。智慧城市应用可能需要车辆检测、碰撞警报、可搜索的事件片段、每小时摘要和操作员报告。仓库应用程序可能需要人员和叉车跟踪、差强人意警报、SOP 检查以及后续问答。每个工作流本身都很有用,但当这些工作流协同工作时,真正的部署就变得很有价值。
这就产生了 3 个递归成本驱动因素:
- 开发成本:团队必须选择并连接微服务、共享服务 (如 Kafka、Redis、Elasticsearch 和 Video IO and Storage (VIOS)) 、模型端点、环境变量和 API,而无需复制基础设施。
- 运营成本:视觉 AI 工作负载可能会导致大量 token 使用,每增加一个流、帧窗口、提示和视觉 token,都会增加 GPU 使用率、排队延迟和端到端摘要延迟。
- 更改成本:团队必须从概念验证转向生产,添加功能,并保持配置、文档和操作的一致性。
VSS 3.3 更新,用于构建和运行视频分析 AI 智能体
VSS 智能体技能可让编程智能体 (如克劳德 Code、Codex) 或任何与 agentskills.io 兼容的智能体根据自然语言请求部署和操作 VSS。VSS 3.3 增加了两项更新,可降低部署双方的成本:
- 构建视觉代理技能 (vss-build-vision-ai):将警报、搜索和摘要等 VSS 工作流整合到一个应用中,用于 SOP 合规性或流量管理等用例,并扩展正在运行的部署,而无需重建整个堆栈。
- 自适应 EVS:这项新功能通过为帧中与前一帧相比没有变化的部分裁剪视觉标记,并在发生事情的时刻批处理 VLM 工作,从而减少冗余 VLM 处理。EVS 已经以固定的剪枝率在 vLLM 和 Cosmos NIM 微服务中推出。VSS 3.3 中的自适应版本集成到实时 VLM 微服务中,并决定每个补丁和每帧要保留哪些 token。
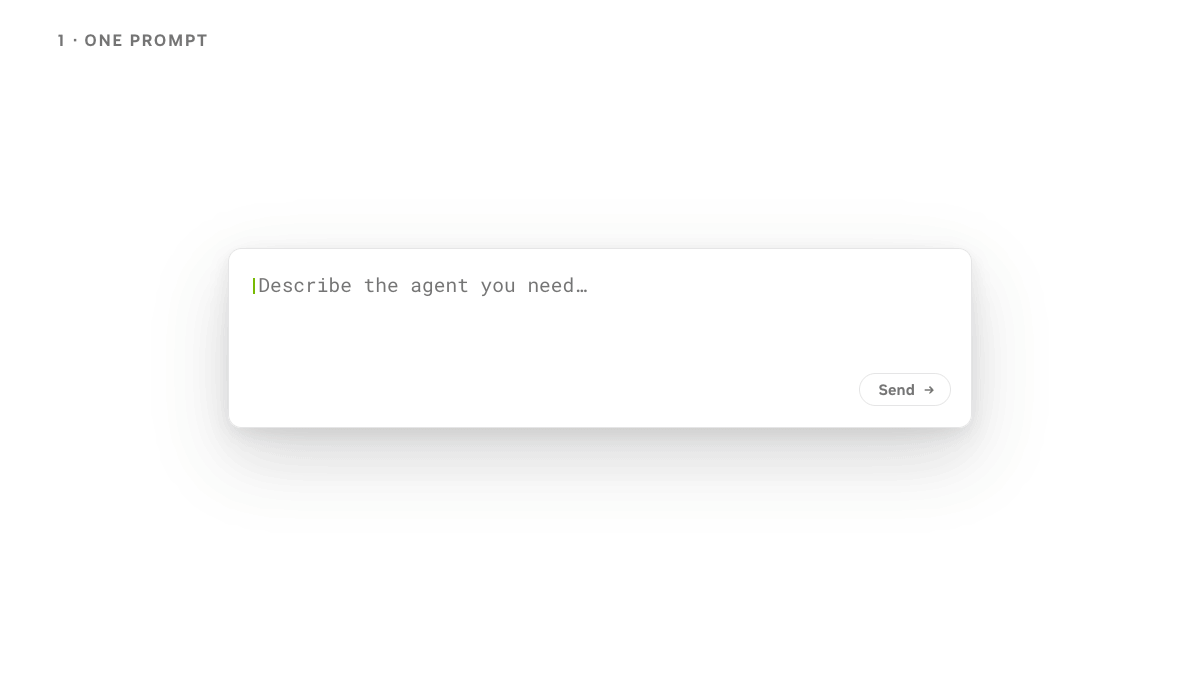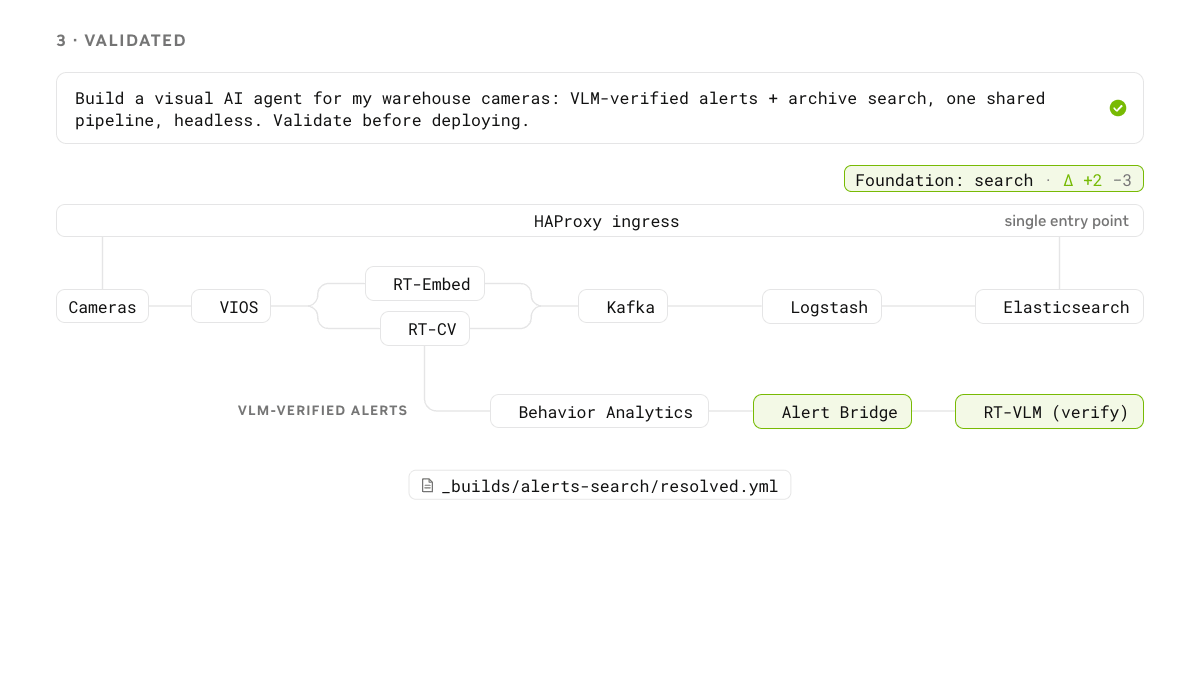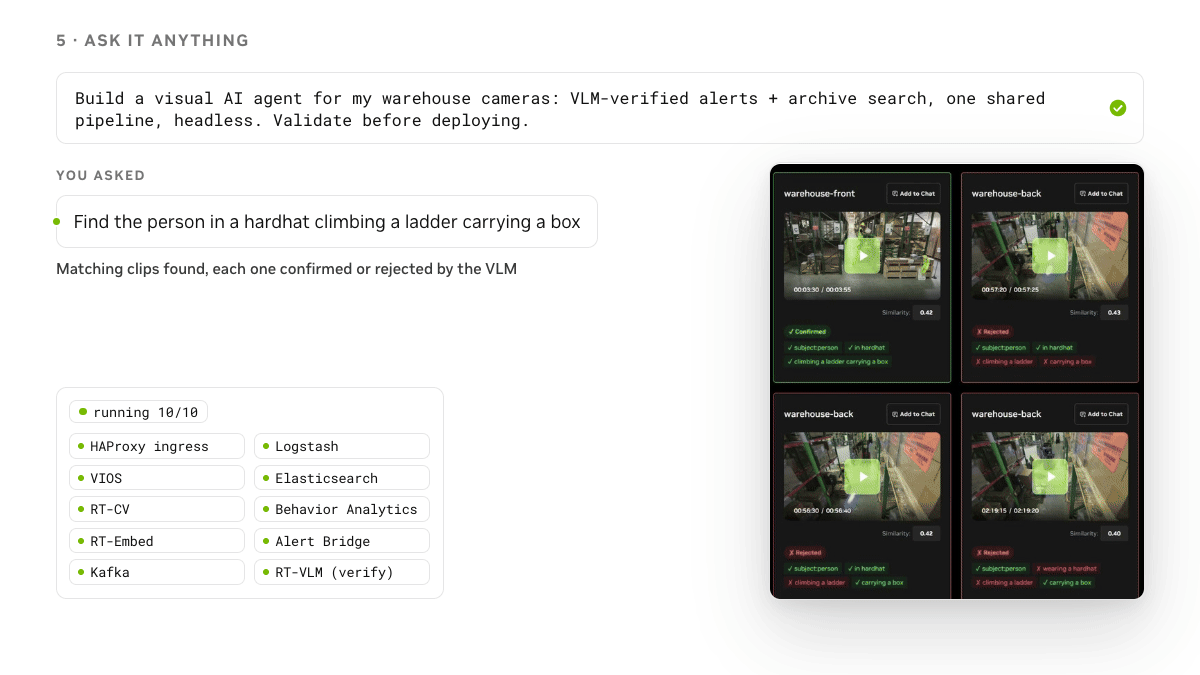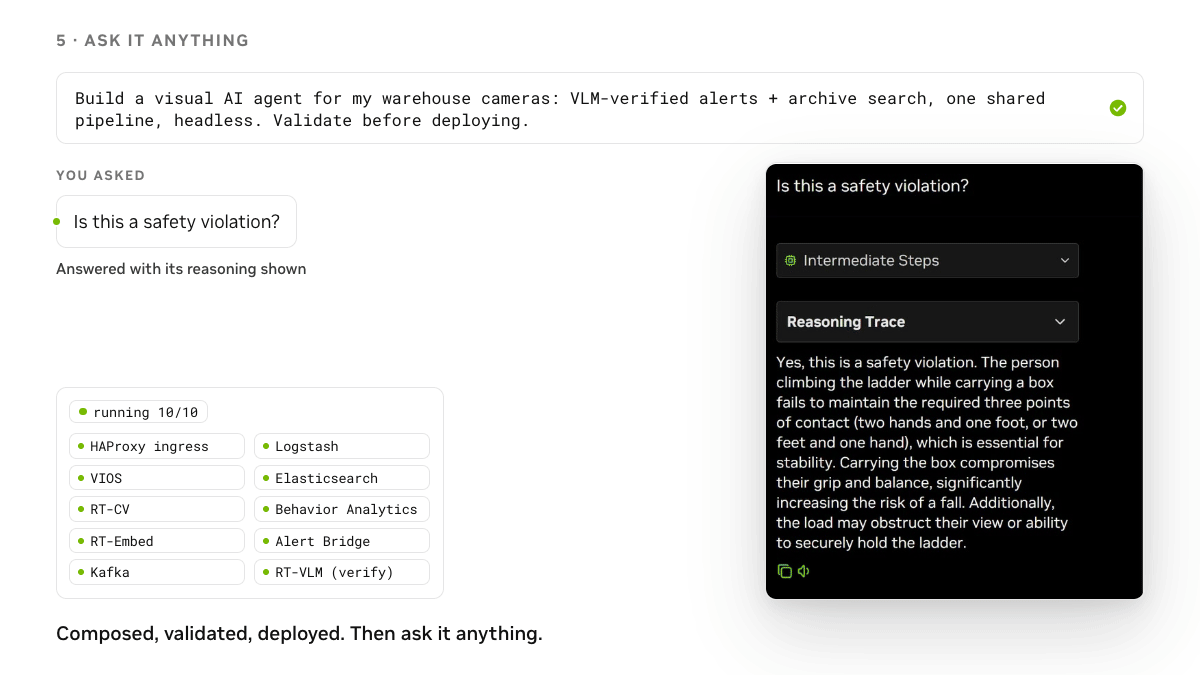
Build Vision Agent 技能通过编写和扩展部署来降低开发和变更成本。自适应 EVS 通过减少 VLM token 和在不变视频上花费的 GPU 时间来降低运营成本。
借助 Build Vision Agent 技能降低开发成本
早期的 VSS 技能可处理单个操作,例如部署、摄像头设置、摘要、搜索、警报和分析。VSS 3.3 将其整理为部署技能、操作技能、工具和基准,其余部分由 vss-build-vision-ai 组成。
开发者会描述他们想要的应用,而 Build Vision Agent 技能会将该意图转化为涵盖配置文件、微服务、配置和运行时操作的部署计划。
该技能并非从头开始生成部署,而是从最接近的四个经过验证的开发者配置文件开始,每个配置文件都是针对一个工作流的完整、经过测试的堆栈 (请参阅下表 1) 。该技能称为“新手分析基础”,仅更改请求所需的内容。
| 配置文件 | 能力 |
base |
VLM 密集字幕和剪辑问答 |
alerts |
实时 VLM 警报,或带有行为分析和 VLM 警报验证的 RT-CV 检测 |
lvs |
长视频摘要 |
search |
借助代理式搜索实现物体和视频嵌入 |
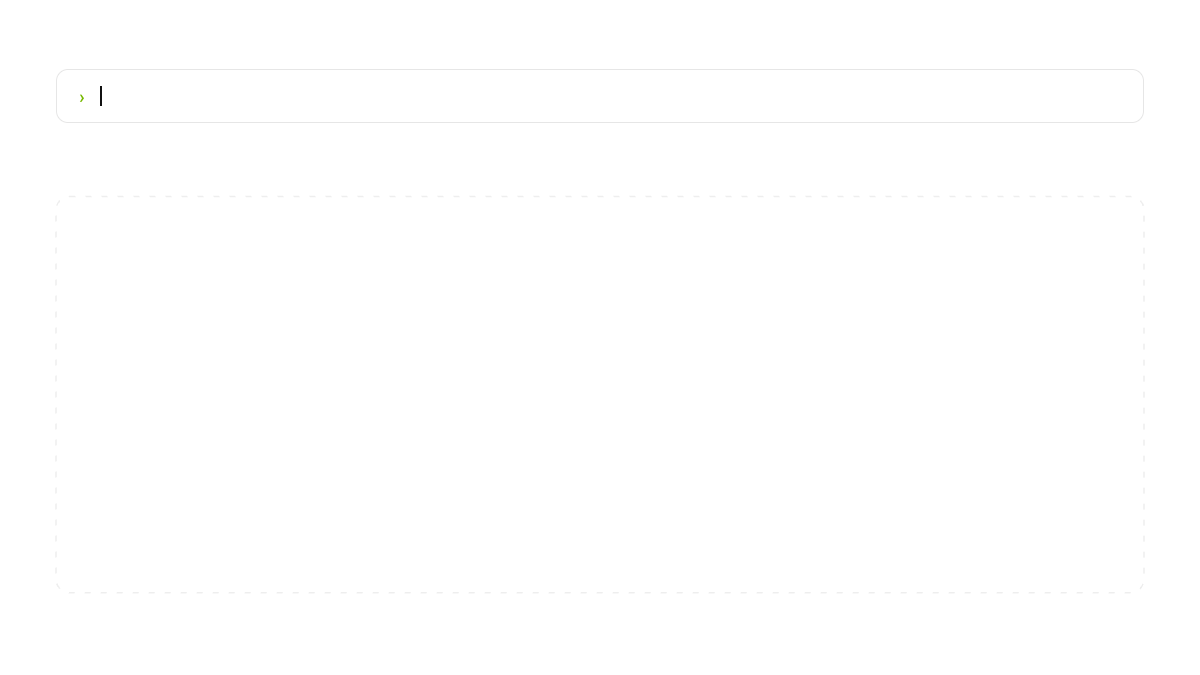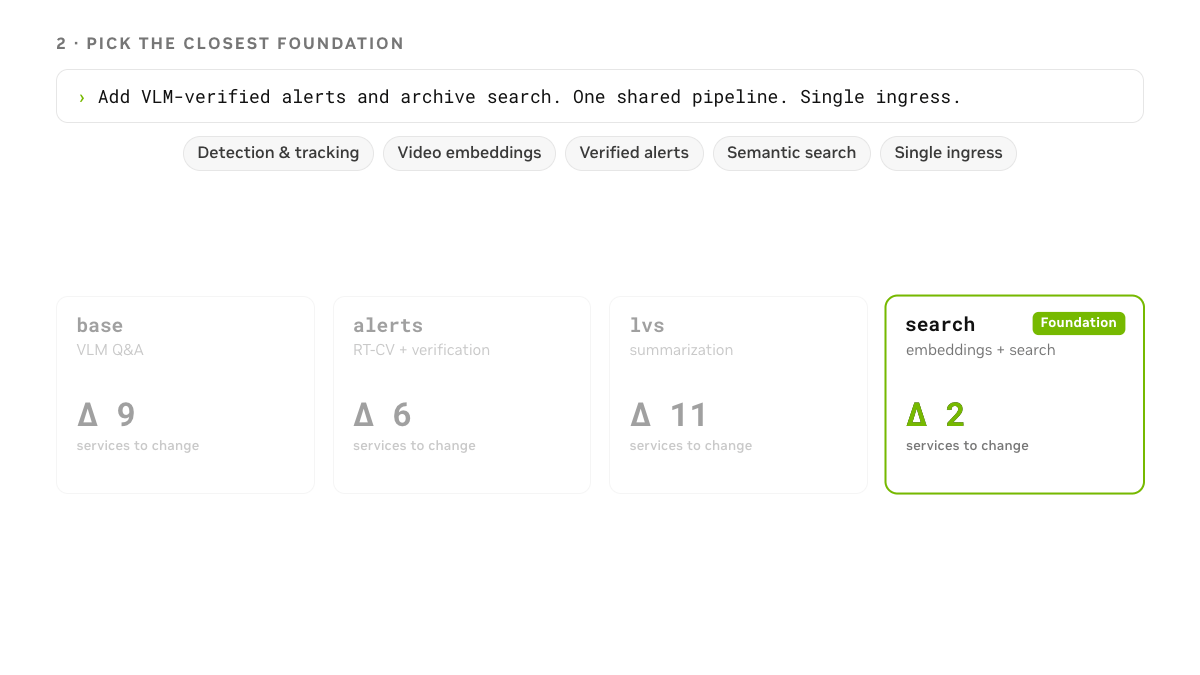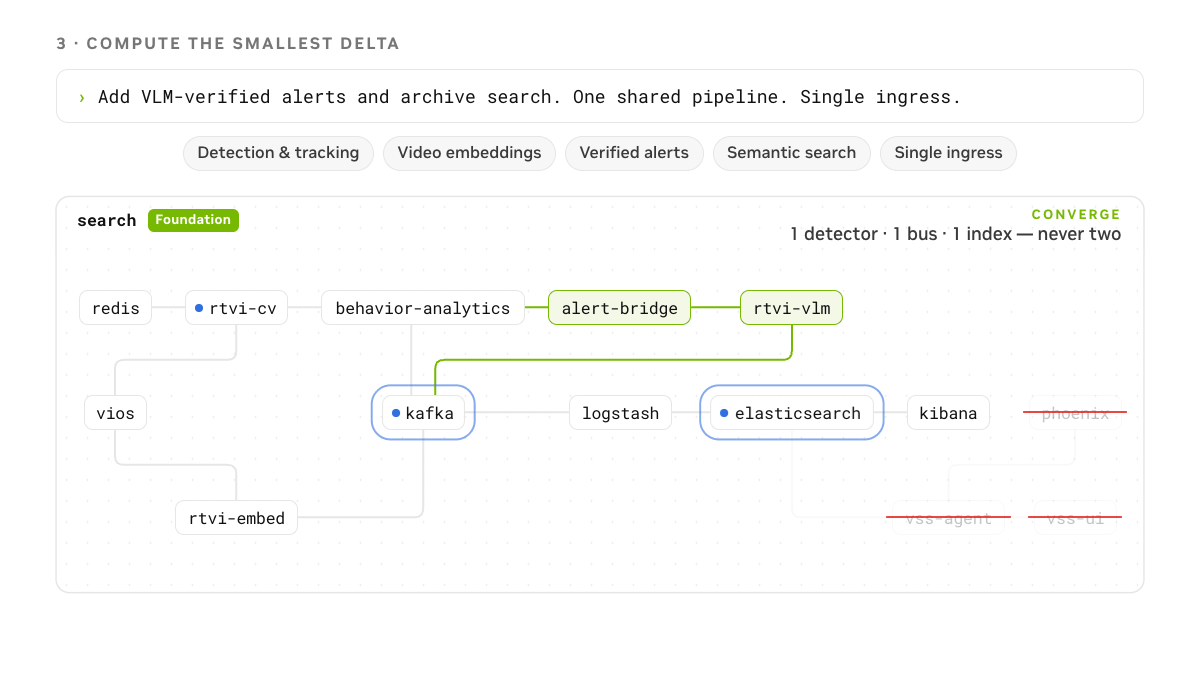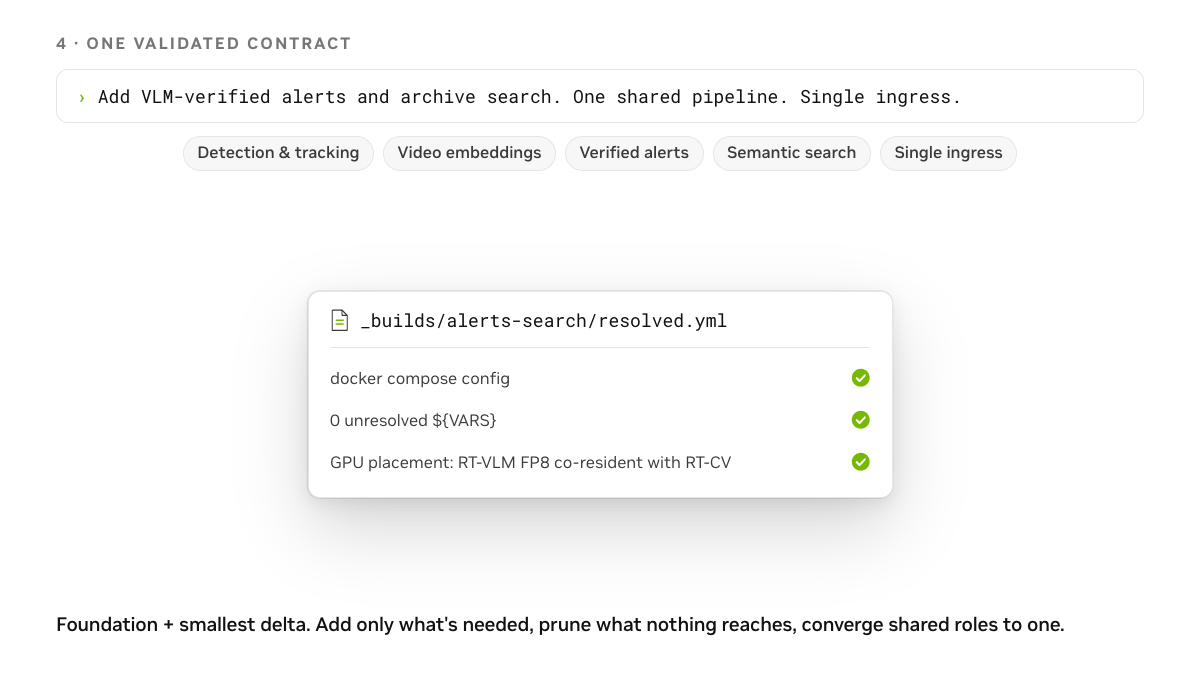
然后,该技能计算最小的增量:仅添加或删除精确的服务密钥,仅保留所请求功能实际到达的服务,并将共享角色聚合到一个实例上。
两种功能都需要检测器,一种是检测器。两个都需要 Kafka 和 Elasticsearch 的应用程序共享一个消息总线和一个 Elasticsearch 部署,每个都编写自己的索引。当规则无法解决某个选择时,技能会提出一个结构化问题,而不是猜测。
技能的自动化程度
- 将应用目标映射到所需的 VSS 工作流和微服务。
- 将警报、搜索和摘要等工作流整合到一个部署计划中。
- 重用共享基础设施,包括 VIOS、Kafka、Redis、Elasticsearch、HAProxy ingress 和 MCP 服务。
- 将部署生成为自包含的构建:_builds/ <name>/override.env (基础、有效的 Compose 配置文件以及仅您更改的设置) 、compose.yml 和 resolved.yml,这是一个使用 docker compose 配置文件生成的扁平化 Compose 文件,可自行部署。永远不会修改存储库的 deploy/docker/tree。
- 在编写或部署任何内容之前显示架构图以供审核,然后运行验证、部署和就绪性检查,以便开发者在构建应用程序逻辑之前验证堆栈。
- 询问是否部署智能体工具。默认为 NemoClaw,这是一个安装了 VSS 技能的主机侧沙盒;回答“否”会产生由 VSS CLI 驱动的无外设堆栈。
- 通过重复使用现有服务的较小增量扩展正在运行的部署。
这可缩短发现时间,使合成具有可重复性,并避免跨工作流重复提取、存储、消息传递和分析基础架构。
使用 VSS 构建生产线视觉 AI 智能体
对于橘汁装瓶生产线,该团队需要一个智能体来观察灌装机和封盖机的摄像头,对溢出或溢出发出警报,搜索过去的事件,并生成轮班报告。
手动开发将连接事件检测、警报验证、存储、搜索提取、摘要和报告。借助 Build Vision Agent 技能,开发始于预期结果。
示例提示
Build a VSS vision agent for an orange juice bottling line. Use two RTSP cameras on the filler and capper. Detect bottle overflows and juice spills, verify each alert with the VLM, make alert clips searchable, and generate a shift report for the line supervisor.
智能体组装的内容
- 由 VIOS 支持的 RTSP 摄像头和录制片段的摄取。
- 实时检测、跟踪、字幕或基于 VLM 的警报,具体取决于基金会配置文件。
- 针对溢出、溢出和线路中断事件的行为分析或规则。
- VLM 验证,用于确认警报并解释其推理。
- 在经过验证的片段和编入索引的视频中进行自然语言搜索。
- 为操作员交接和事故审查提供总结和报告。
- 共享消息传递、存储、API 和可观察性。
在双 GPU RTX PRO Blackwell 主机上,该技能通过重复使用现有服务并仅添加警报桥接器和实时 VLM,将搜索和警报相结合。FP8 Cosmos 3 Nano 共享探测器的 GPU,可避免重复工作。录制的警报构建在 30 分钟内就完成了可预览的实时部署。
其结果是一种可重复使用的模式:只提取一次视频,跨工作流共享证据,并为操作员提供自然语言搜索、提醒、摘要和报告。
自适应 EVS 如何降低运营成本
上述示例中的生产线智能体运行后,其摄像头会全天候制作视频,而且每个帧中的大部分内容都不会改变:填充物、防护罩和地板。只有瓶子在其中移动,而且溢出现象很少见。
每个帧窗口仍然会成为 VLM 的视觉环境,因此模型的大部分计算都会重新读取看起来与之前的帧完全一样的区域。这种 VLM 处理是已部署的视觉 AI 智能体的主要运行时成本驱动因素之一,也是 Adaptive EVS 所追求的成本。
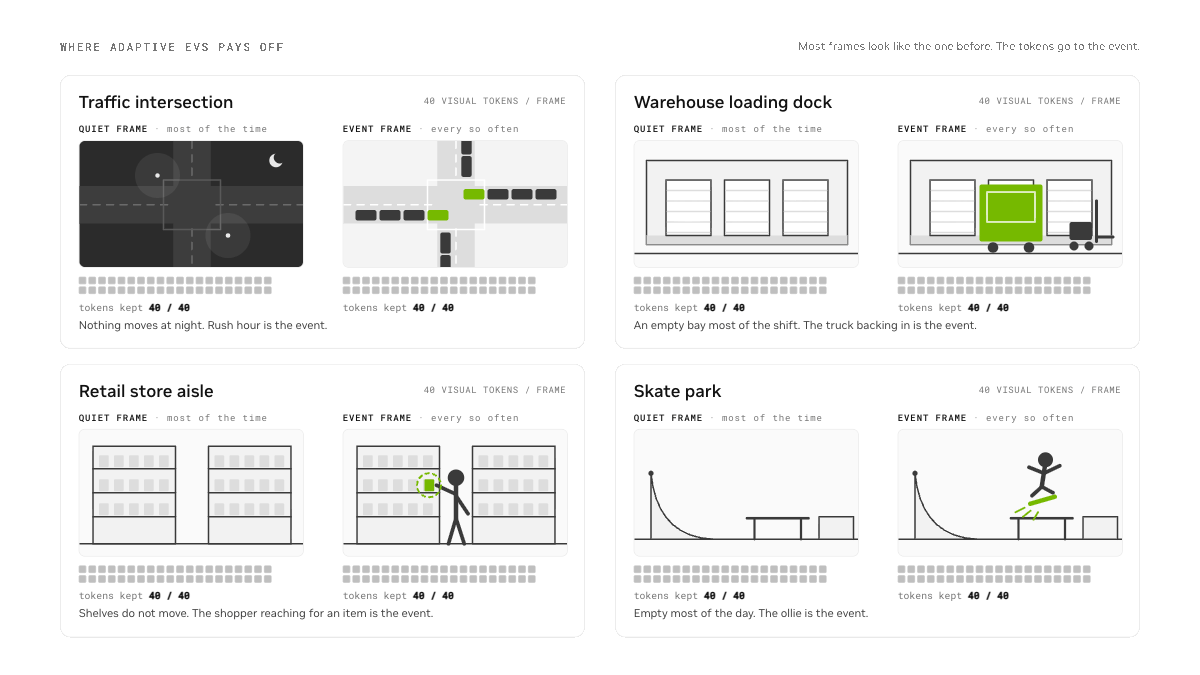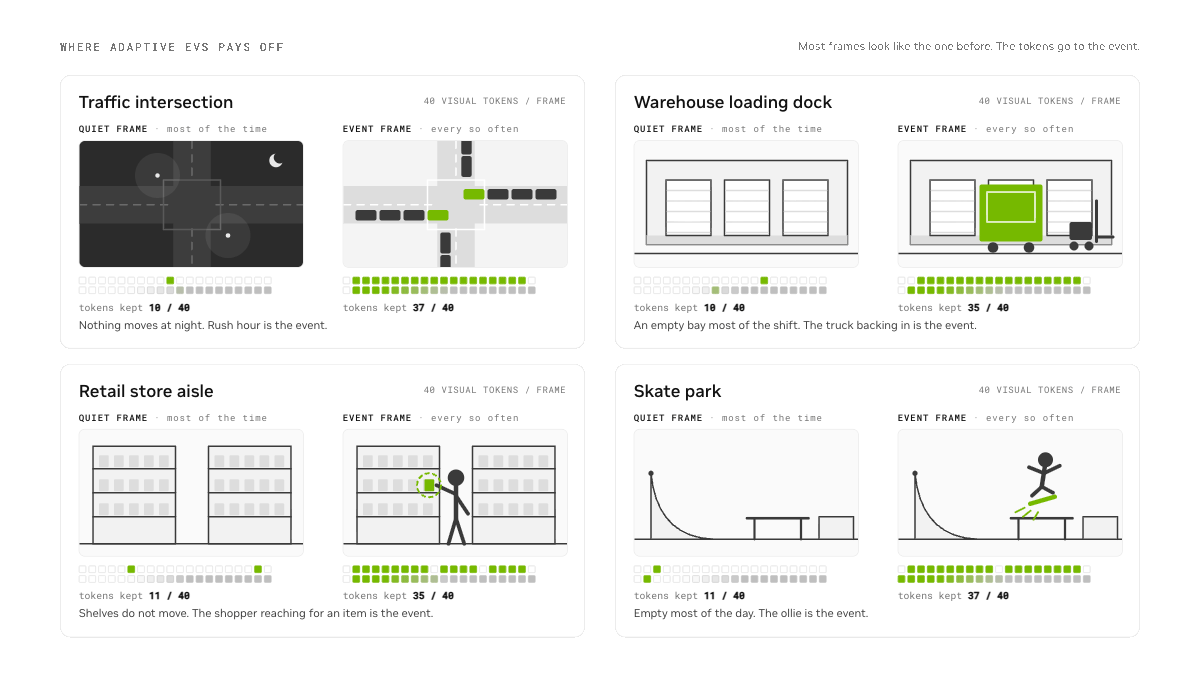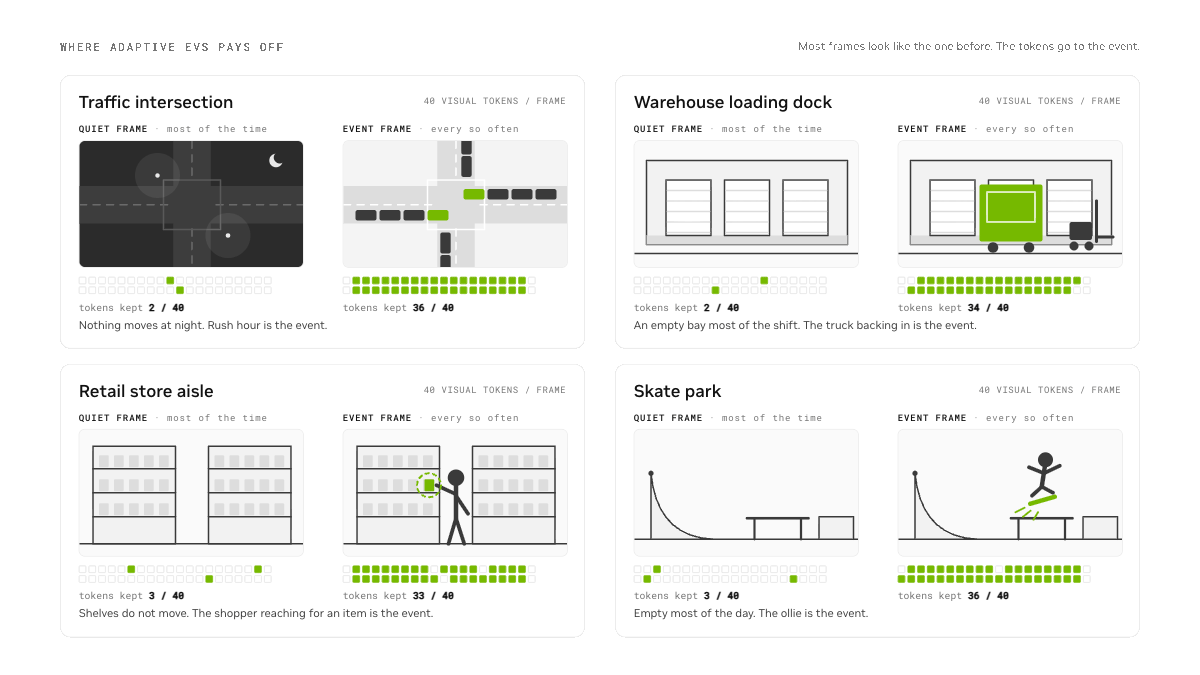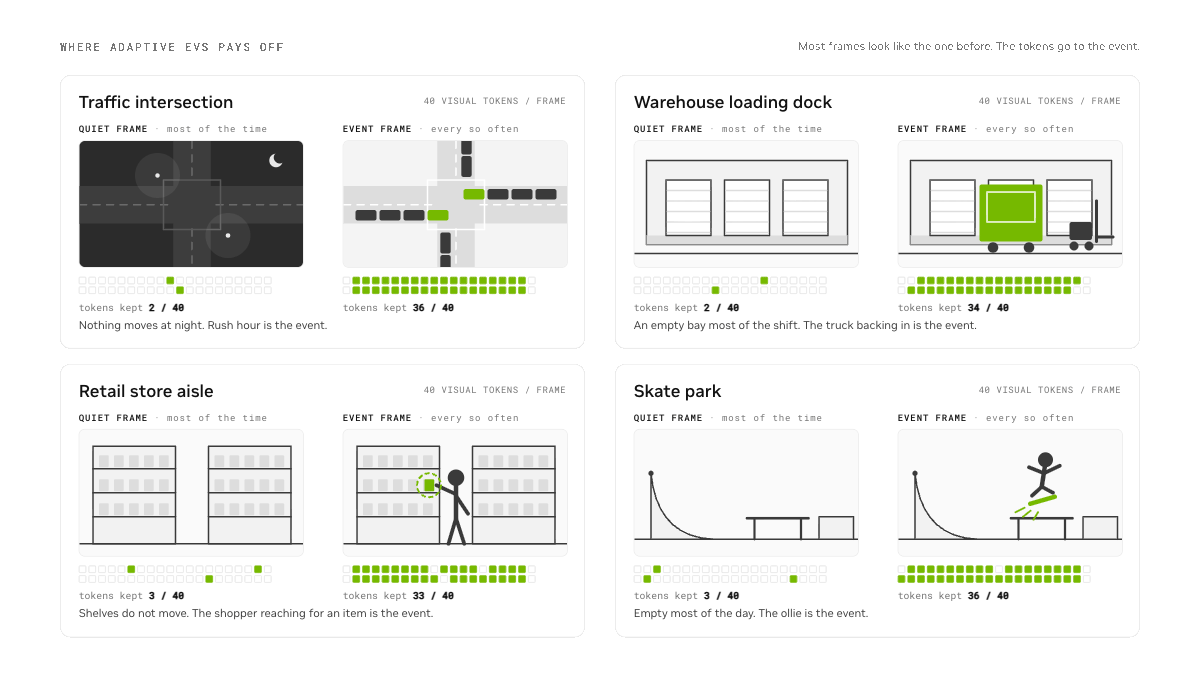
自适应电动汽车在工作流中的变化
- 动态剪枝。使用余弦相似性将每个分块与上一帧进行比较;在到达语言模型之前,会丢弃未改变的分块。
- 事件感知批处理。Token 保留表示活动:超过 70% 的片段会被批处理为事件,低于 30% 的片段会被丢弃或刷新,其余片段会正常运行。
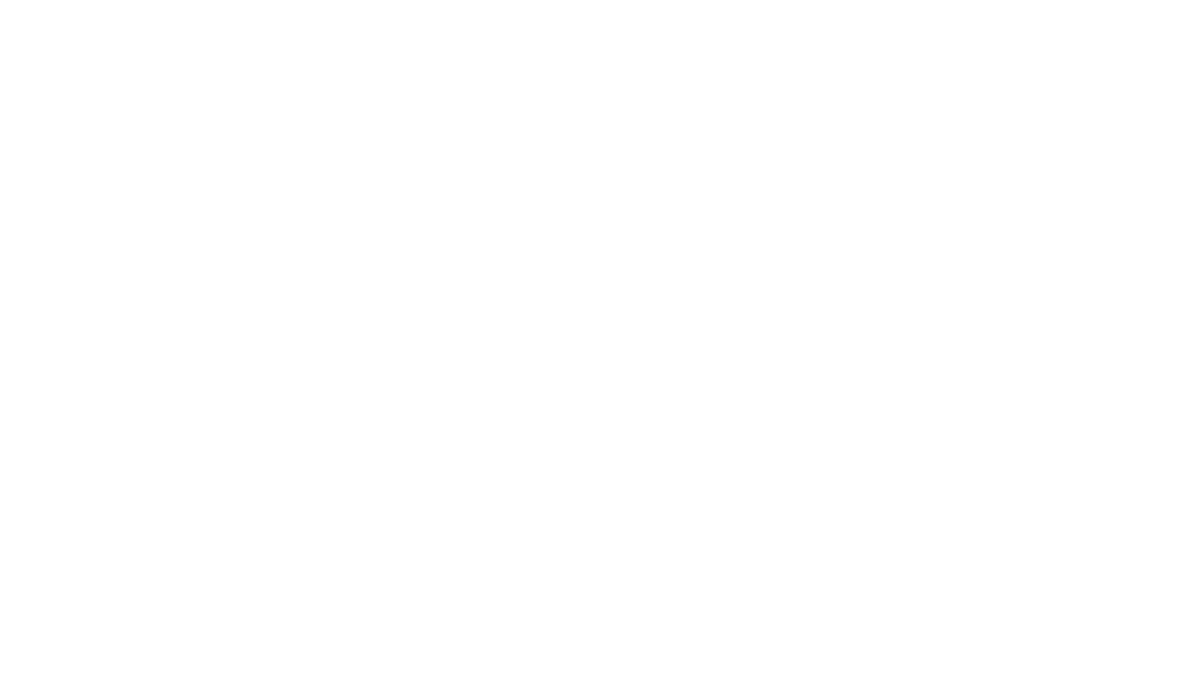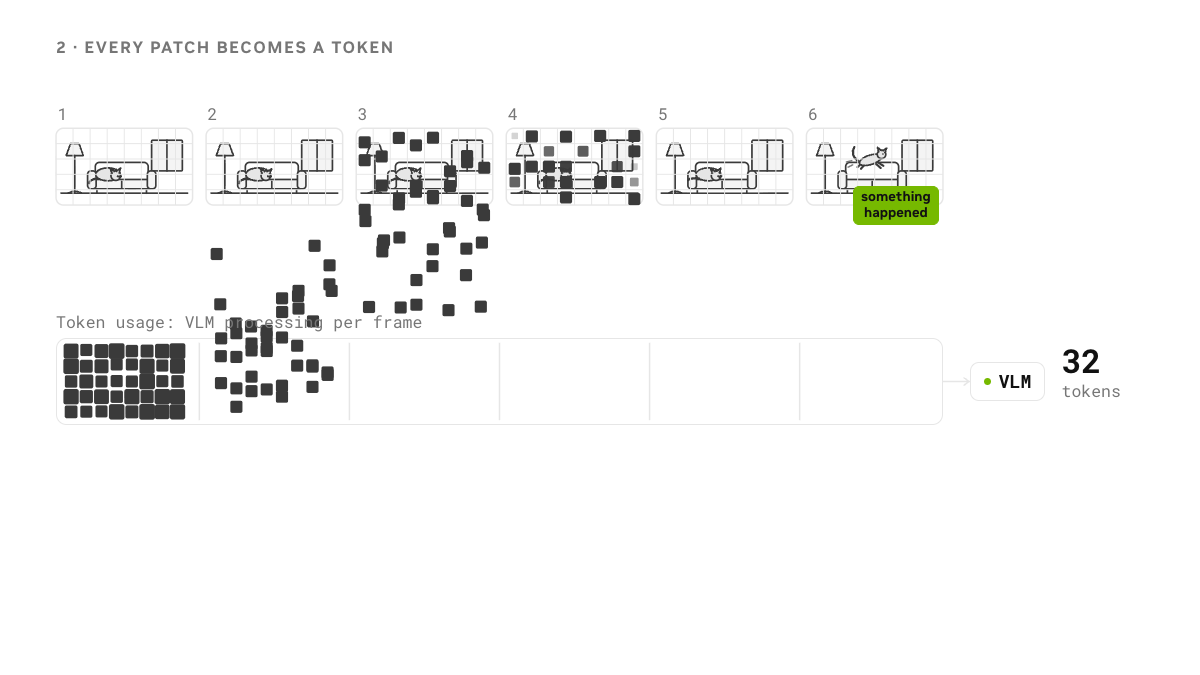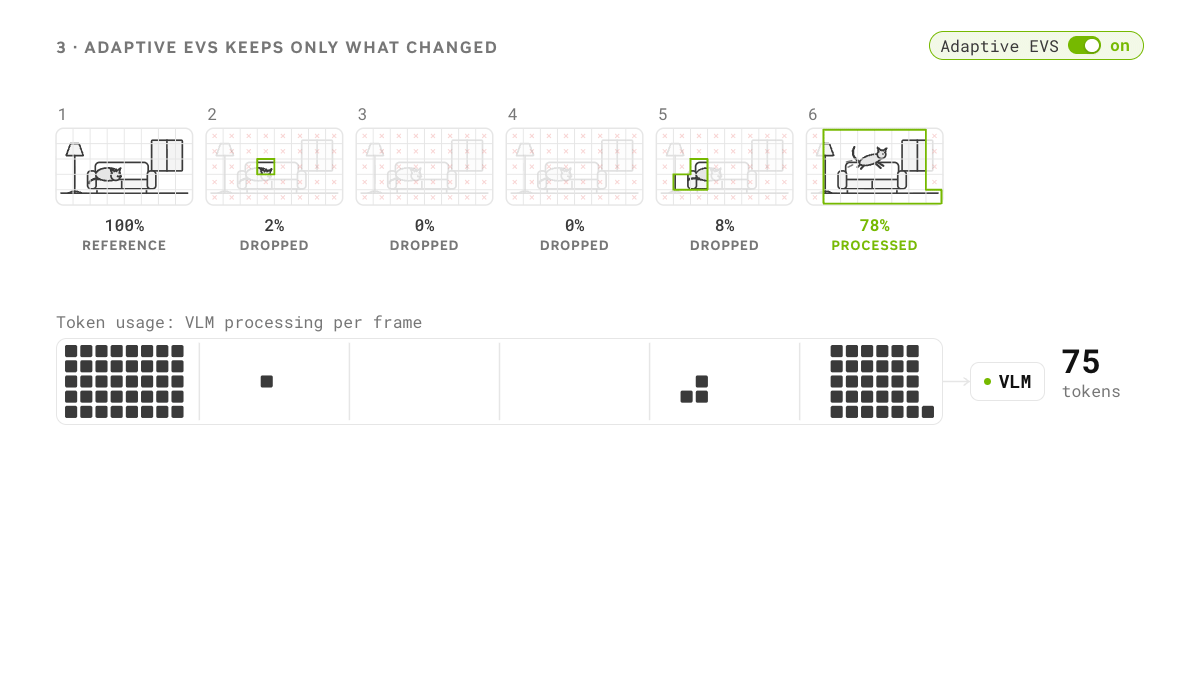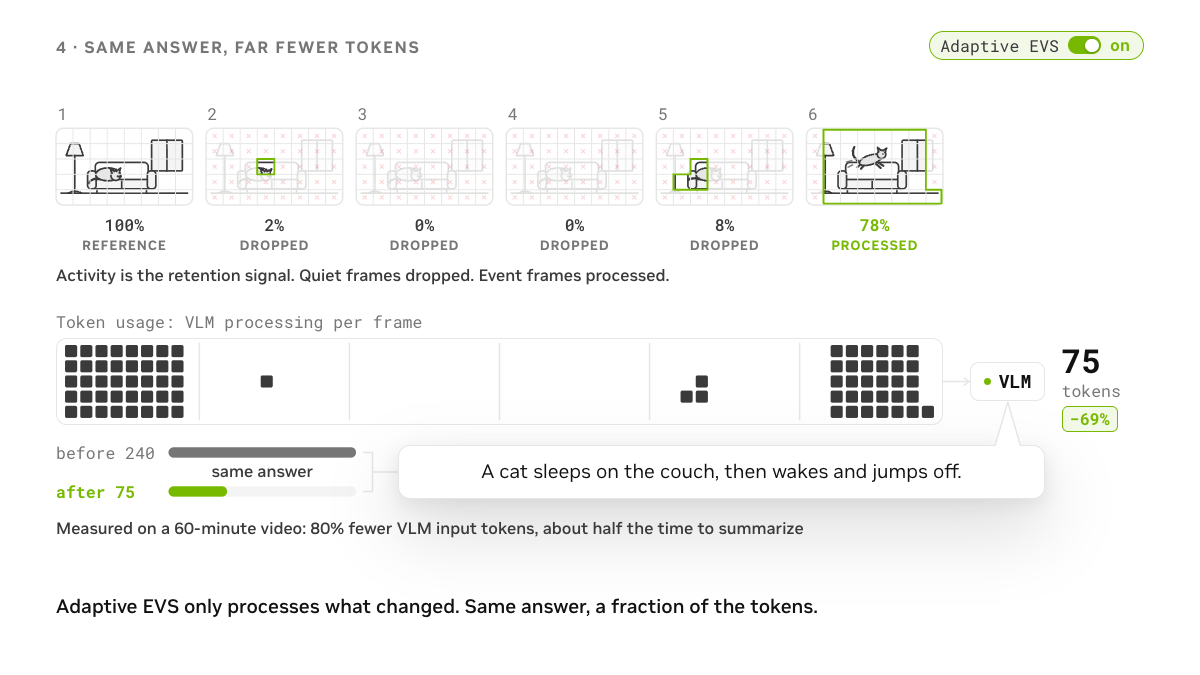
性能影响
在运行 Cosmos 3 Super FP8 的 NVIDIA RTX PRO 6000 Blackwell 上,自适应 EVS:
- 将警报上下文化延迟从 1021 毫秒降低到 844 毫秒,同时同样减少 token 使用量。
- 并发实时 VLM 流数量增加 46%,从 13% 增加到 19%。
- 对 60 分钟视频进行总结的时间大约缩短了一半,VLM 输入token减少了 80%。
结果因场景运动、数据块长度和相似性值而异;在选择生产默认设置之前,对具有代表性的素材进行基准测试。
当 VLM 读取多帧并产生简短响应时,自适应 EVS 非常有用,例如密集字幕、长视频摘要和警报验证。它对于几帧的长输出优势较小,在 RT-VLM 容器内运行,而不是针对远程端点运行,并且是可选的。在 override.env 中启用该功能,然后对具有代表性的视频片段的准确性、吞吐量和延迟进行基准测试:
VIA_EVS_SESSION=true
VLM_VIDEO_PRUNING_RATE=0.5             # 0.0 to 1.0; higher prunes more
VLLM_EVS_SIMILARITY_THRESHOLD=0.2
成本影响:为团队带来哪些变化
- 通过多工作流应用的自然语言合成减少集成工作量。
- 减少警报、搜索、总结、报告和问答等基础设施的重复性。
- 通过修剪不变的视觉区域来提高 GPU 效率。
- 跳过平淡无奇的视频,从而降低总结和事件审查延迟。
- 通过增量增量进行更轻松的扩展,重复使用正在运行的部署。
这些变化共同减少了前期开发工作,以及在各种环境和应用中使用 VLM 处理视频所需的 GPU 工作。
VSS 3.3 入门
- 克隆 VSS Blueprint 资源库,并查看包含 3.3 技能的分支。
- 在编码智能体的标准技能目录中安装 VSS 技能。
- 描述所需的智能体,包括视频源、工作流和部署限制,或者说“构建视觉智能体”以获取指导。
- 查看架构图和_builds/ <name>/override.env,尤其是 GPU 布局、模型端点、端口、存储和安全边界。
- 对于 RT-VLM 工作负载,启用自适应 EVS,调整剪枝率,并对代表性视频的准确性、吞吐量和延迟进行基准测试。
- 在具有身份验证、TLS、速率限制和外部控制的可信隔离网络上进行部署。
设置命令示例
git clone https://github.com/NVIDIA-AI-Blueprints/video-search-and-summarization.git
cd video-search-and-summarization
请您的编码智能体安装以下技能:
Read skills/README.md and every SKILL.md under skills/. Install each skill for this host
using the standard skills directory, symlinking rather than copying so a git pull keeps
them current.
安装技能后,您可以从以下提示开始:
Build a VSS vision agent that combines alert verification, natural-language video search,
and hourly summarization for my warehouse cameras. Reuse existing Kafka and Elasticsearch
services where possible, and produce a deployment plan before running Docker Compose.
深入了解
- 克隆 VSS Blueprint 资源库
- 安装VSS 智能体技能
- 使用上面的示例提示,在您自己的摄像头上试用 Build Vision Agent 技能