

强化学习 (RL) 使用奖励来训练模型来解决问题并更成功地完成任务。
推理推动了这一过程。工作者生成的数据发布:模型输出、动作和环境交互的序列。RL 框架对结果进行评分,更新模型权重,并将这些权重发送回工作节点,以供下一轮处理。
随着 RL 训练规模的扩大,冗余的计算工作、缓慢的部署、权重更新和工人故障可能会浪费 GPU 容量并延迟训练。
NVIDIA Dynamo 提供服务层来解决这些限制,帮助团队生成更多可接受的训练样本,并更快地完成训练迭代。
本博文介绍了拖慢 RL 训练的推出瓶颈,以及 Dynamo 如何通过路由、ModelExpress 权重更新和恢复来解决这些瓶颈。
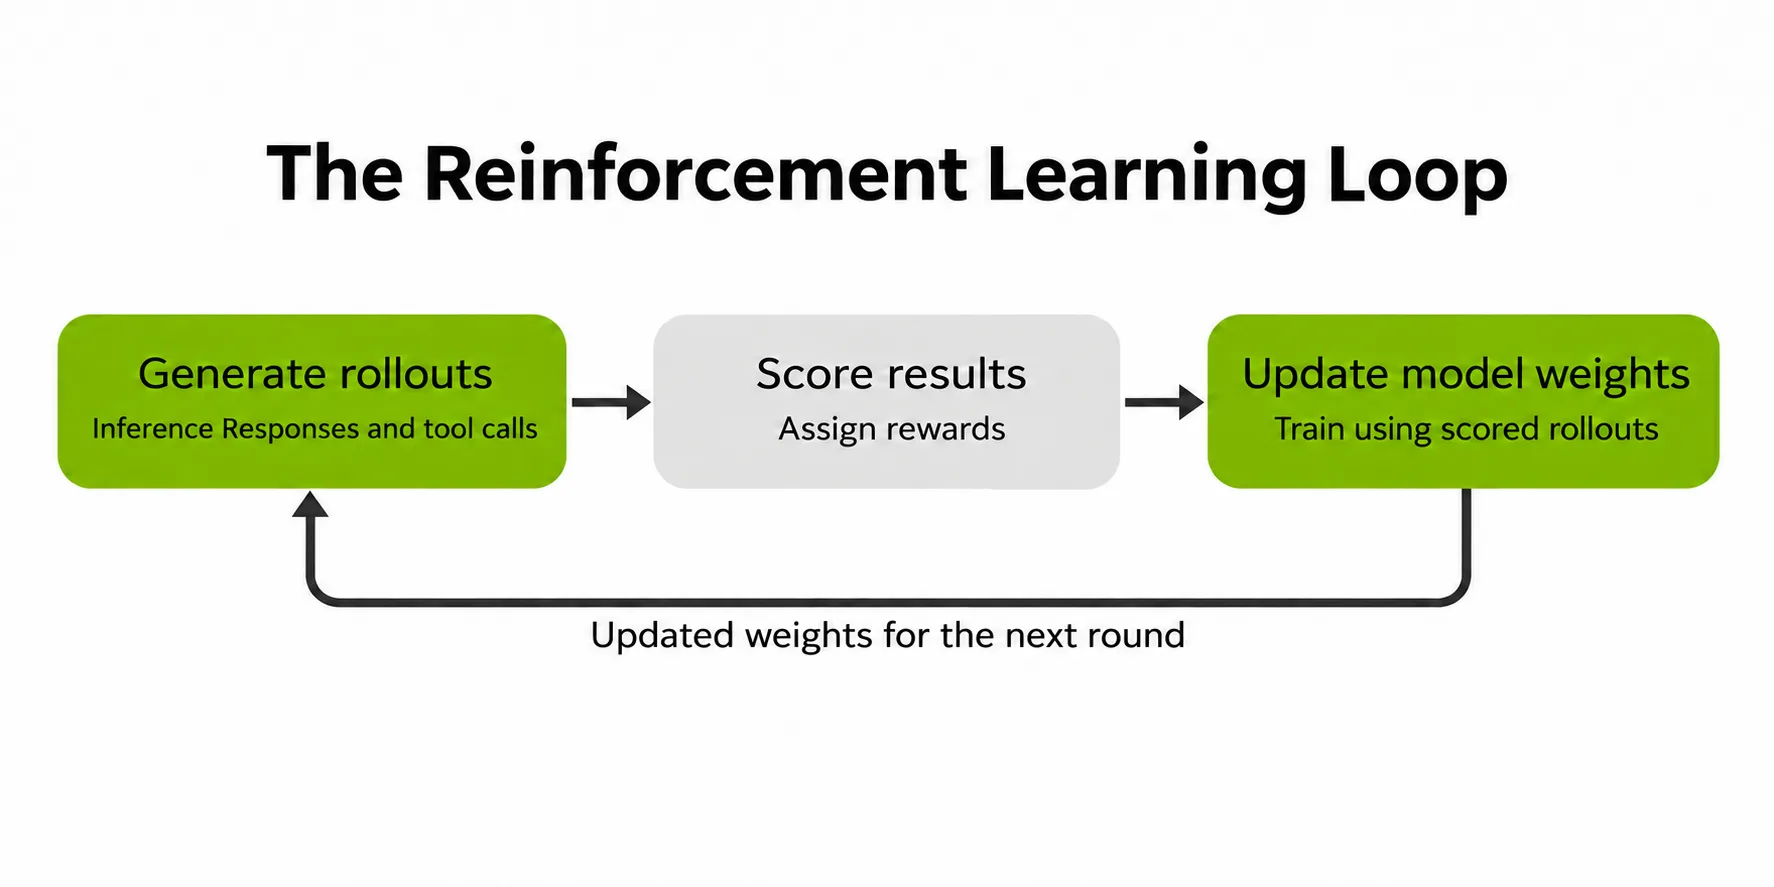
1. 为什么 RL 需要分布式部署基础架构
推理发布可能包含一个响应。编码智能体的推出可能涉及资源库探索、编辑、工具调用和测试。这些差异会导致推理工作者的工作负载不均衡。
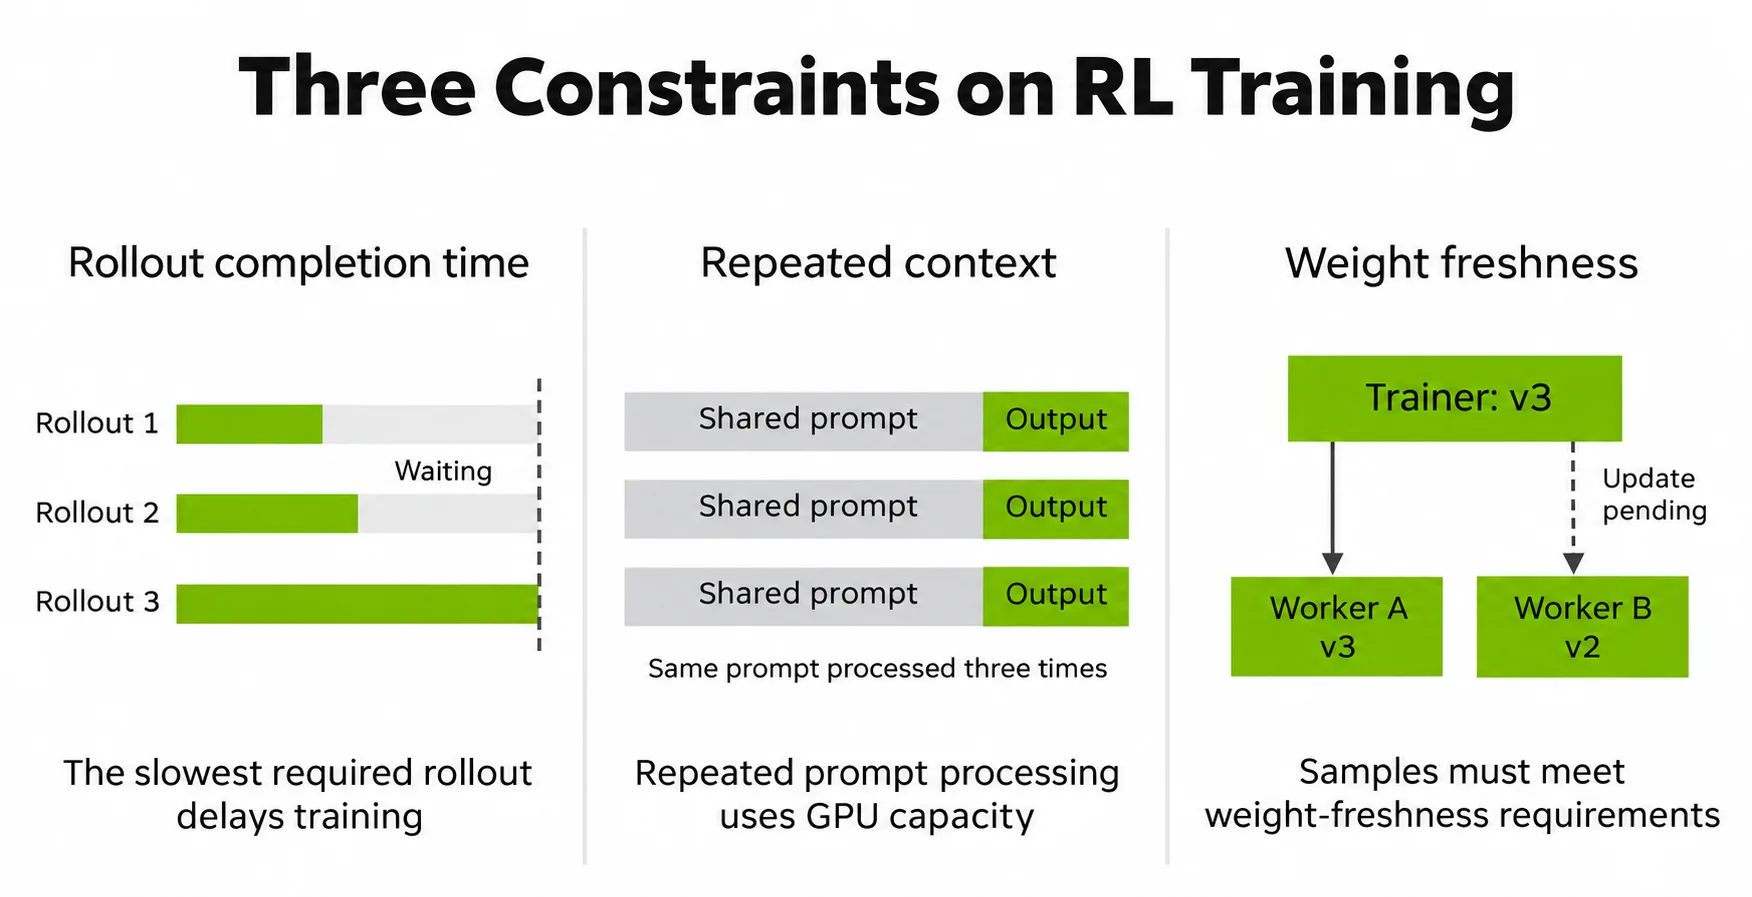
三个限制因素决定了该工作负载支持训练的效果。
发布完成时间。当训练需要一组样本时,所需速度最慢的部署可能会延迟下一步。在 GPU 上均匀地分配请求数量并不一定会均匀地分配工作。
重复的上下文。多次尝试通常始于相同的指令、任务说明或编码库上下文。重新计算这些前缀会在生成新输出之前消耗 GPU 容量。
重量新鲜度。训练会在整个运行过程中生成新的模型权重。工作者必须根据算法的采样要求和可接受的迟滞度来接收这些数据。
解决这些限制条件可以让团队在固定的计算预算内完成更多的迭代。正确的优化取决于限制工作负载的约束条件。
2. 适用于 RL 的 Dynamo 架构
Dynamo 介于部署编排和推理工作者之间。RL 框架提交生成请求;Dynamo 将其路由到符合条件的容量;推理引擎执行模型。
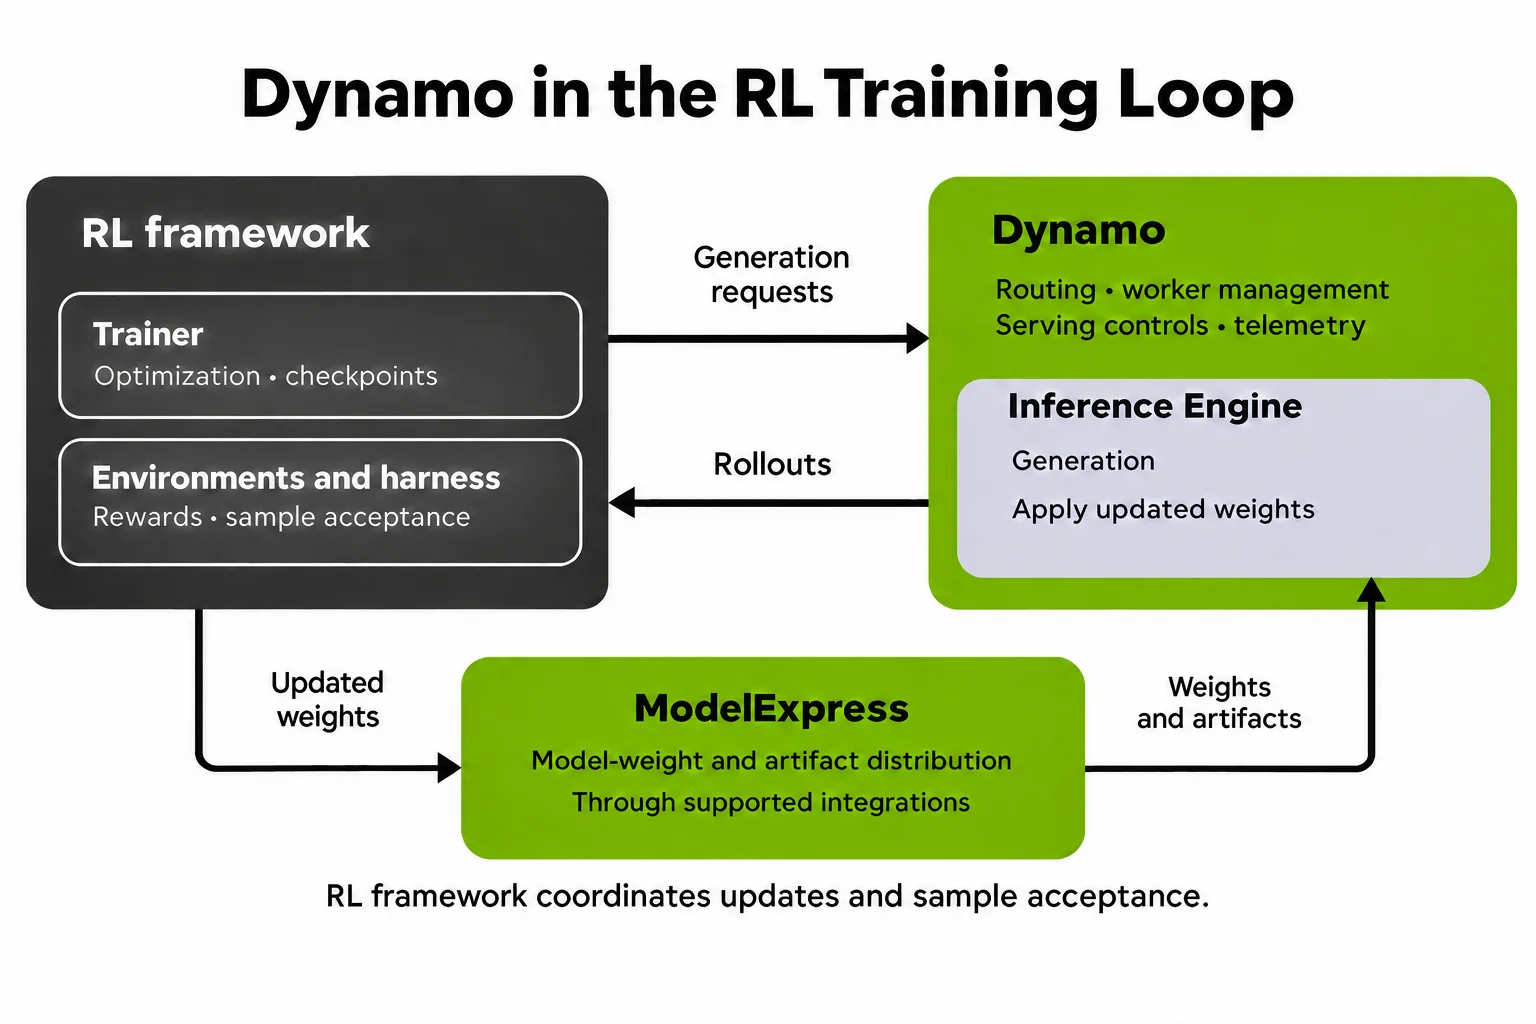
每个组件的职责保持明确:
| 组件 | 角色 |
|---|---|
| RL 框架 | 优化、奖励、环境、检查点和样本验收 |
| 发电机 | 路线规划、员工管理、服务控制和遥测 |
| 推理引擎 | 生成和应用更新的权重 |
| ModelExpress | 通过支持的集成实现模型权重和构件分布 |
生成和权重管理遵循不同的路径。请求使用共享服务前端,而刷新操作则针对框架控制下的选定工作者。这使框架能够确定工作者何时可以生成样本,以及哪些结果符合训练条件。
这种分离允许团队在不转移学习过程所有权的情况下改进服务。路由决策可确定生成的运行位置;框架可确定生成的样本是否满足其训练要求。请参阅 RL 集成参考。
3. Dynamo 如何加速路线规划、重量分配和恢复
KV 感知路由:减少重复提示计算
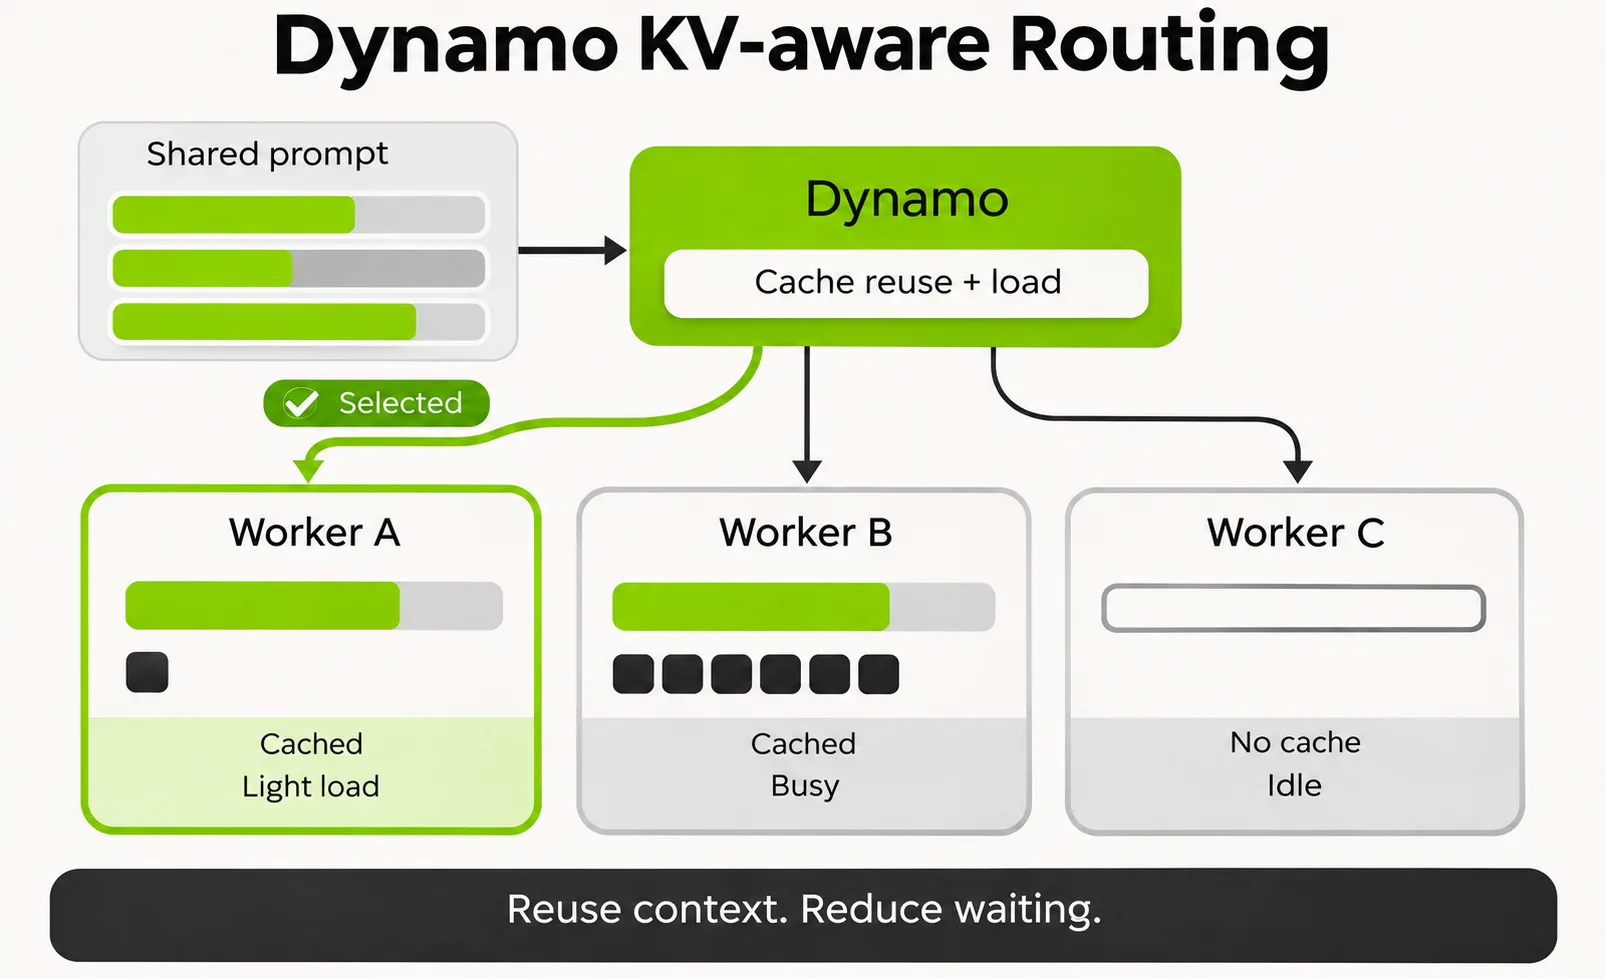
RL 通常使用共享提示为同一任务生成多个解决方案。将这些请求发送给已缓存提示的工作者可避免重复处理,从而节省 GPU 计算。但是,向该工作者发送每个请求都会创建一个队列,从而延迟发布和下一个训练步骤。
Dynamo 的路由器可平衡 KV 缓存重用和工作负载,以减少冗余计算和等待。目标是更早完成训练所需的样本。
ModelExpress:减少重复性权重分布用度
RL 训练会反复更新模型。向每个发布工作者发送完整的检查点需要时间,并且可能会中断生成。
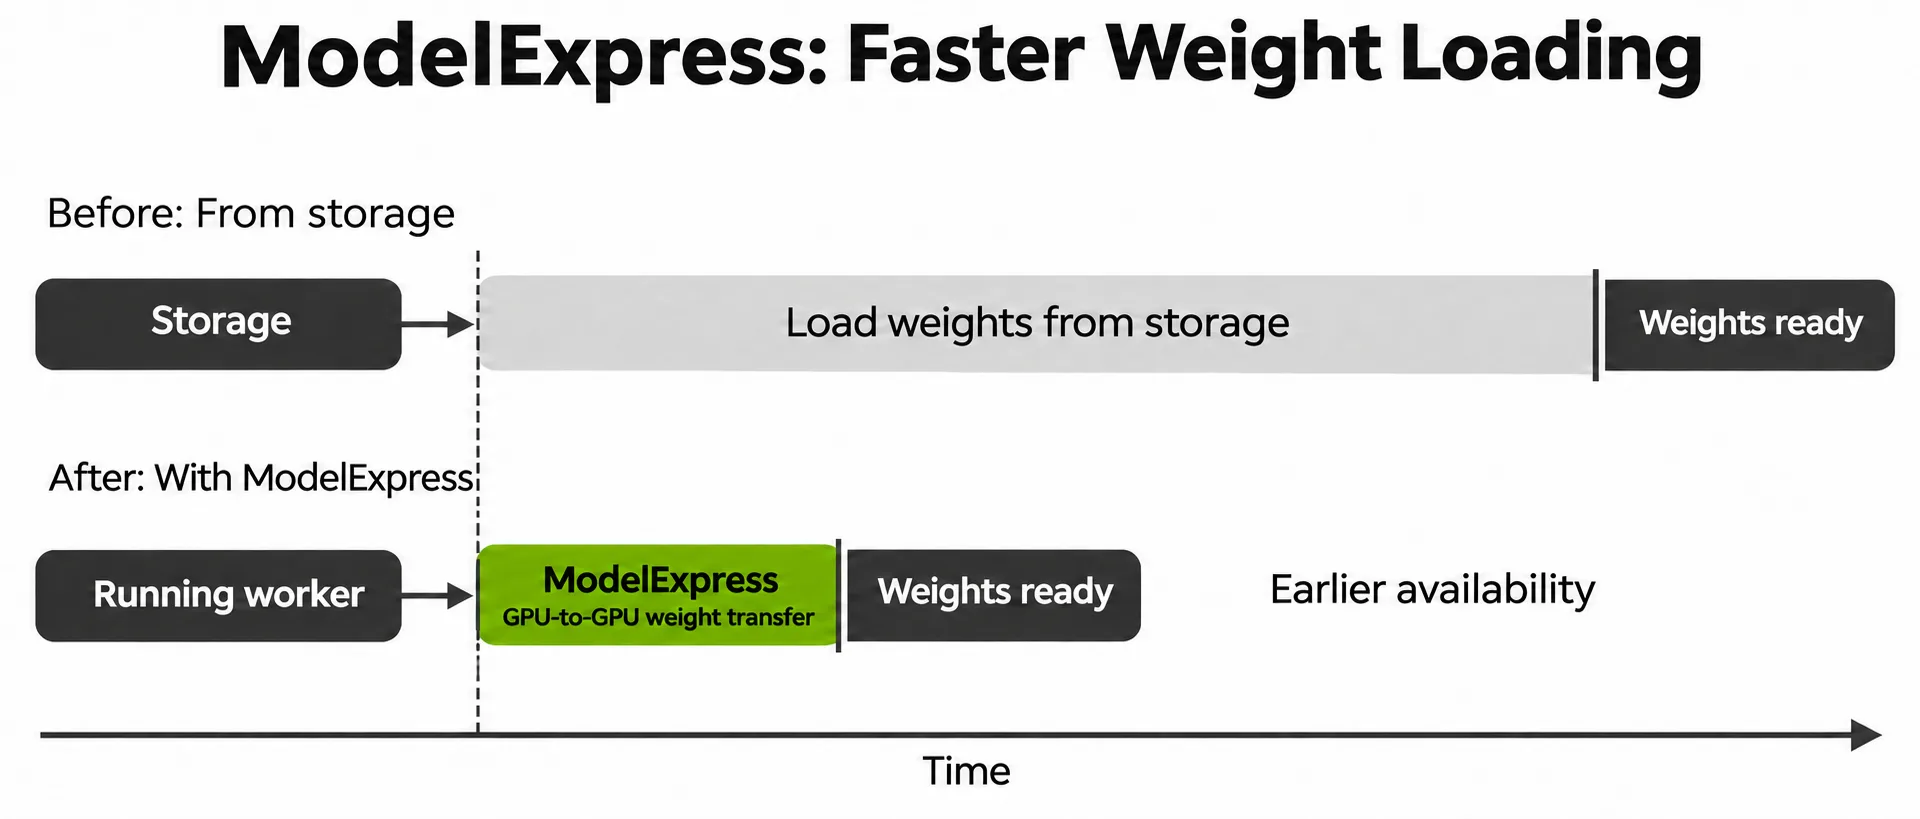
ModelExpress 通过重复使用集群中已有的权重 (而非从远程存储加载) 来减少这种开销。兼容的工作者可以通过 NIXL 直接从另一个 GPU 复制权重。
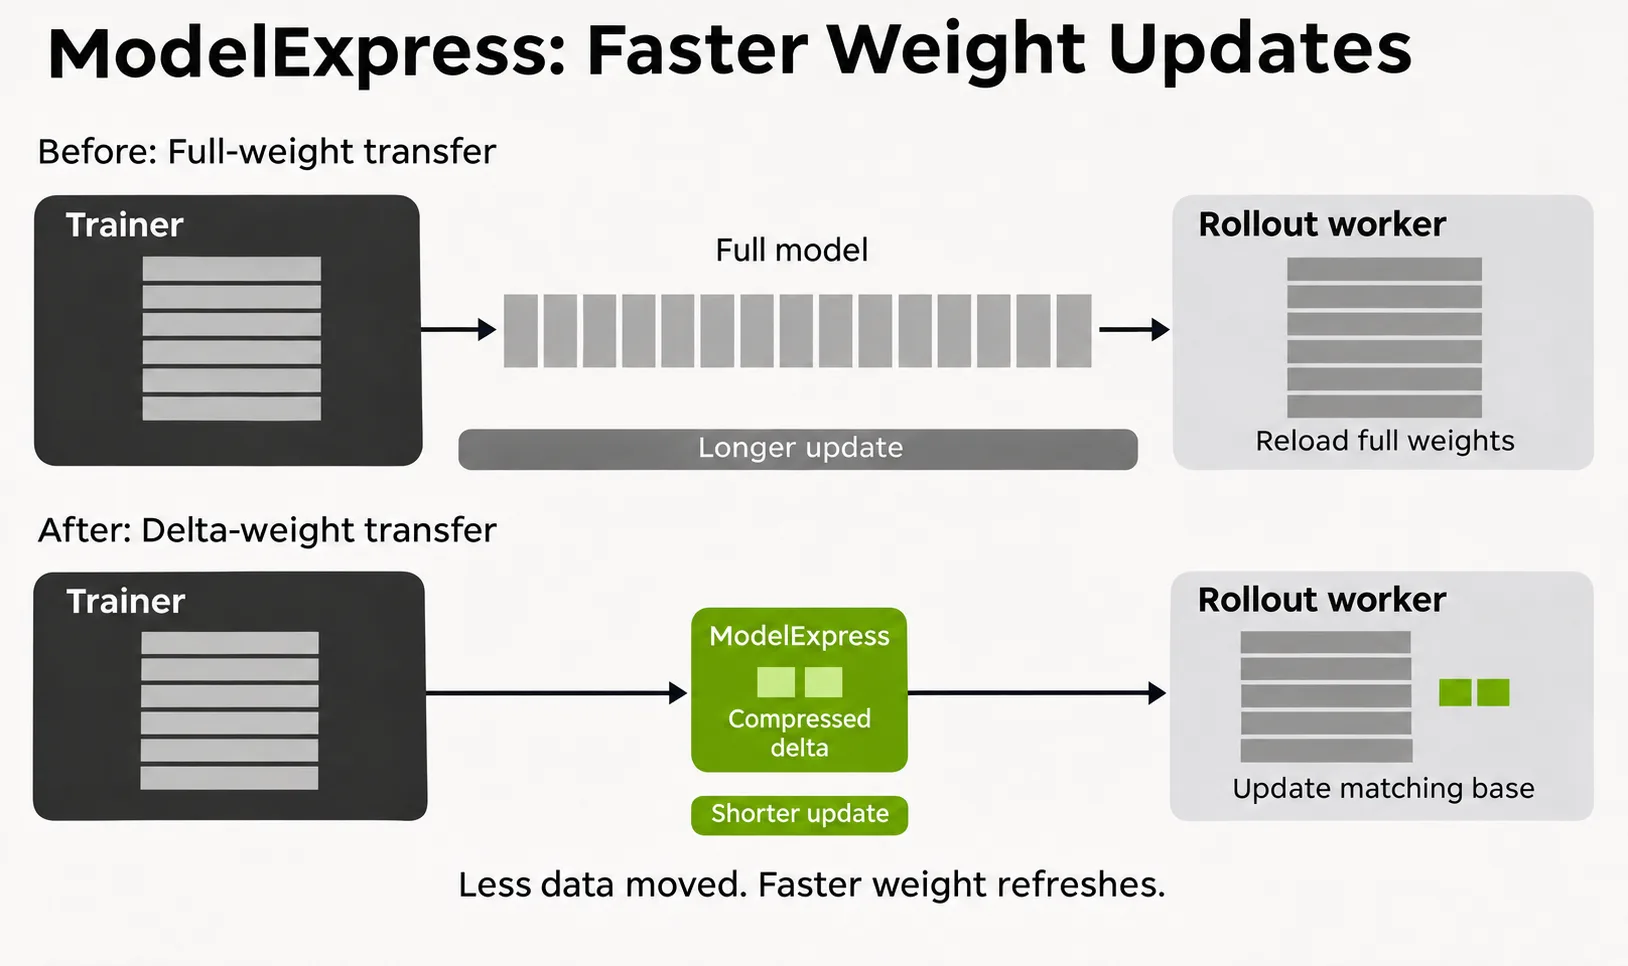
增量权重转移可减少在两次更新之间发送的数据。它不会移动完整的模型,而是会发送更改内容的压缩表示。工作者根据匹配的基本版本重建新的权重,从而减少传输时间和网络流量。
这也有助于恢复。替代工作者可以加载检查点,并应用后续增量来跟上训练运行。健康的工作者可以在恢复容量的同时继续生成产品。
RL 框架会在工作者应用更新时进行协调,处理缓存状态,并在接受新样本之前检查准备情况。
恢复:限制工人故障的影响
长时间的训练必须能适应工人的故障,而不会不必要地中断正常的工作负载。
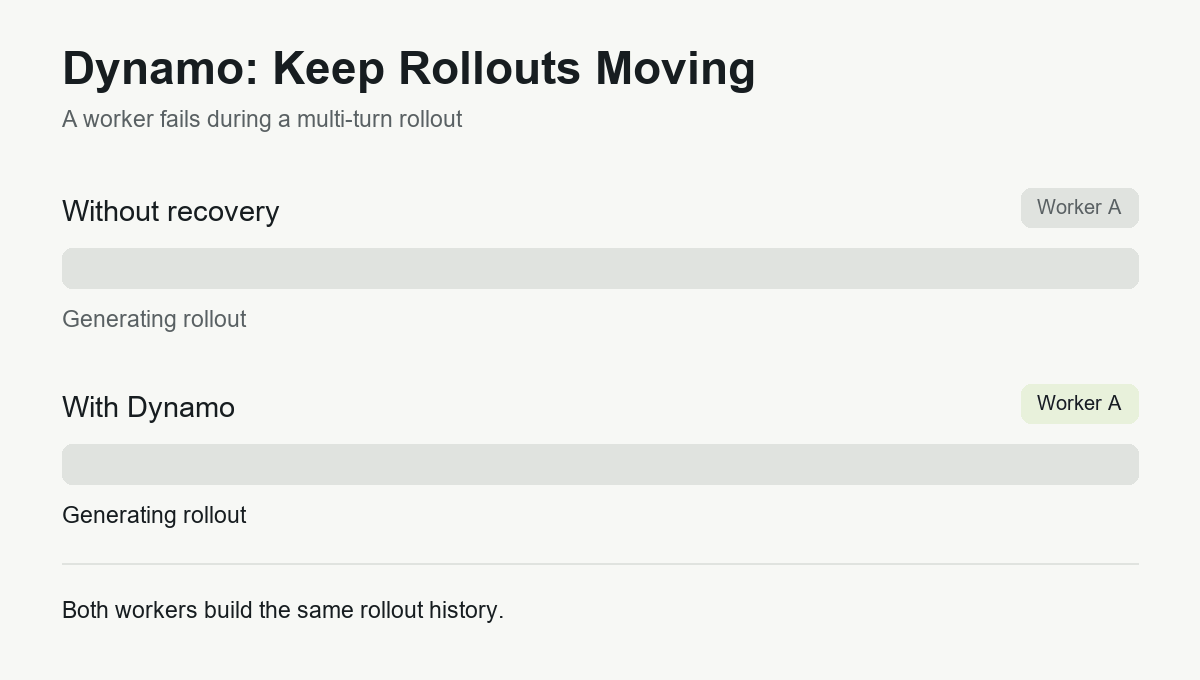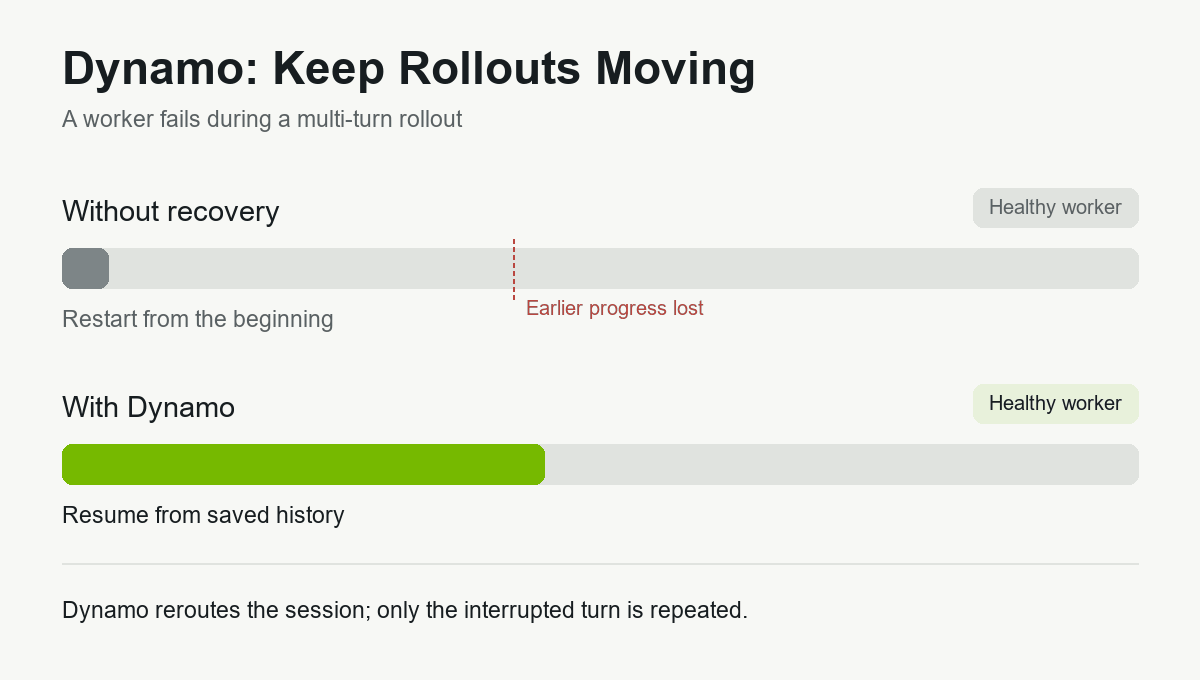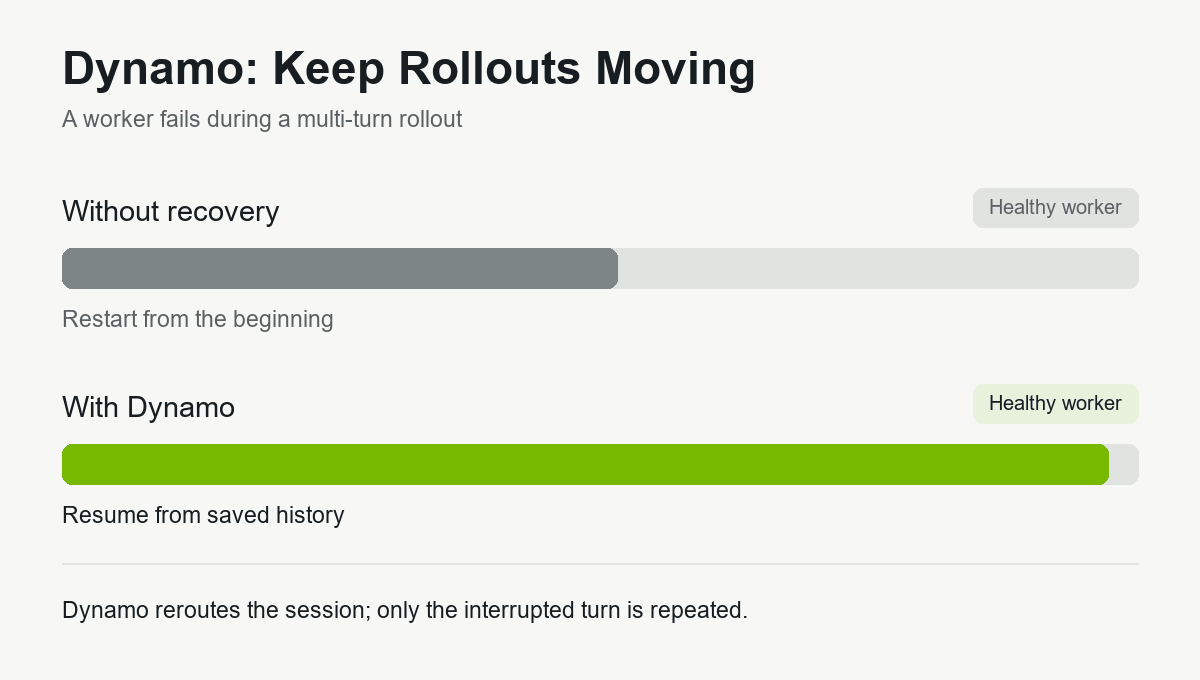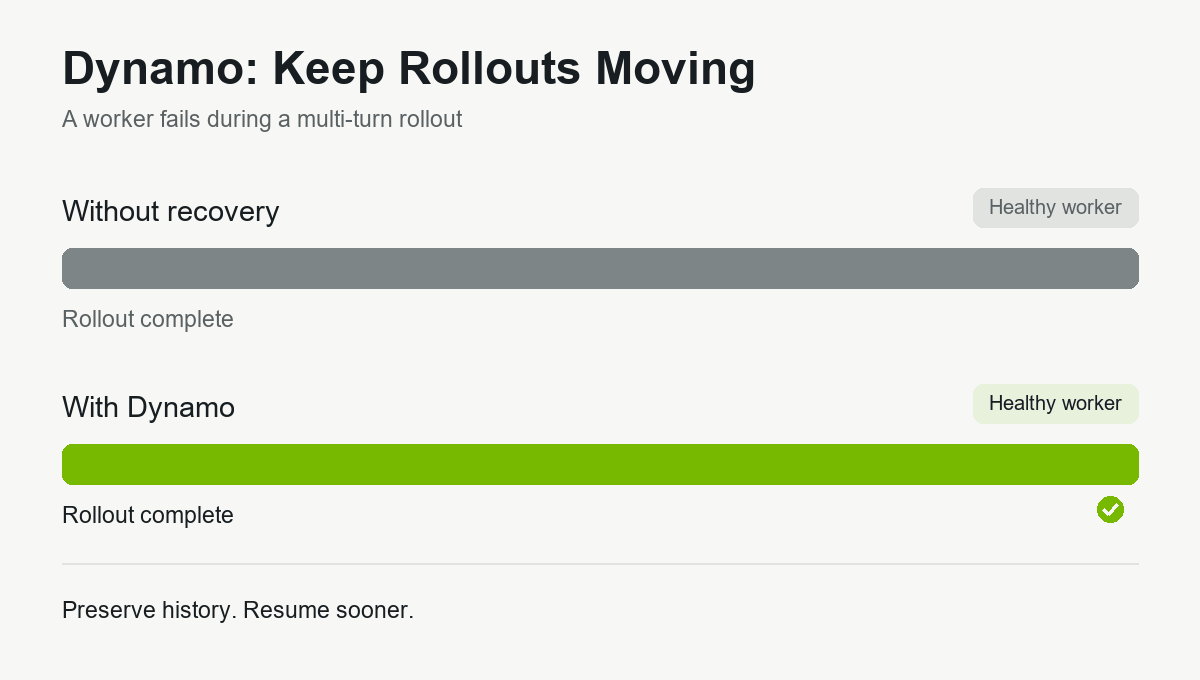
Dynamo 可检测员工流失情况,将新请求引导给符合条件的员工,并在准备就绪后将替换员工添加到路由中,从而在员工失败时保持部署生成。
支持的配置还支持迁移符合条件的在线请求和顺畅的排水。
RL 框架会处理中断的样本,并确保替换使用所需的权重。
RL 工作流中的动态效果
在 RL 中采用 Dynamo 涵盖前沿模型开发、托管基础设施和开源框架:
- 在后训练期间,Microsoft AI 使用 NVIDIA Dynamo 支持 RL 部署推理。
- CoreWeave 使用 Dynamo 和 ModelExpress 将模型权重更新速度提升高达 15%。
- 在 SWE-1.7 的后训练过程中,Cognition 使用 Dynamo 管理推理工作者并规划部署路线。
- Prime Intellect 使用 Dynamo 进行分布式推理编排。
- H Company 使用 Dynamo 和 ModelExpress 将平均训练步长时间缩短高达 20%,GPU 小时数缩短高达 5%。
- 开源集成将 Dynamo 连接到现有的 RL 堆栈,包括 verl、NeMo RL、Slime 和 prime-rl。
开始使用 Dynamo for RL
高效的 RL 基础设施可同时推动产品发布、重量分布和员工恢复。Dynamo 将这些服务功能引入训练循环,帮助团队将分布式 GPU 容量转化为可接受的训练样本,并加快迭代速度。
探索 Dynamo RL 文档,并开始为您的下一个模型扩展推理。
致谢
Aichen Feng、Biswa Ranjan Panda、Elaine Hou、Hyunjae Woo、Jinyan Chen、John Thomson、Sean Choi、Sophia Yang、William Arnold 和戴中东明为这篇文章做出了贡献。


