

生成式推荐 (GR) 系统正在成为实现大规模个性化的强大新方法。GR 没有将推荐视为一组孤立的检索、排序和预测阶段,而是将推荐重新表述为对用户行为的序列建模。用户的交互、上下文、候选项和操作会成为高基数事件流中的 token,模型会学习根据该序列生成下一个相关项或对其进行评分。
这种方法对于现代推荐工作负载尤其有吸引力,因为在这些工作负载中,用户历史记录很长,商品目录不断变化,个性化质量取决于对丰富的顺序行为进行建模。但这也带来了一项服务挑战:GR 模型需要低延迟推理,尽管历史很长,嵌入表很大,并且模型架构序列较多。
NVIDIA Dynamo-Triton (以前称为 NVIDIA Triton 推理服务器) 现在通过 NVIDIA recsys-examples 存储库支持端到端分层顺序转换单元 (HSTU) GR 推理工作流。该工作流结合了 HTSU、PyTorch Ahead-of-Time Inductor 编译、由 FlexKV 支持的 KV 缓存、原生 C++ 验证、NV 嵌入缓存 和 Dynamo-Triton 部署。
其结果是为具有强大延迟性能的 HSTU 排名模型提供了一条切实可行的路径。在 NVIDIA RTX PRO Blackwell 工作站版 GPU 上的动态批量大小为 8 时,采用 PyTorch AOTI 的 Dynamo-Triton 在最佳情况下实现了高达 4.47 倍的速度提升 (三层 HSTU 模型) 和 5.93 倍的速度提升 (八层模型) 。
本文将介绍如何使用 NVIDIA Dynamo-Triton、PyTorch AOTI 和 FlexKV 将 HSTU 生成式推荐系统从 PyTorch 开发阶段迁移到生产推理阶段。您将学习如何导出和提前编译模型,在 Python 和原生 C++ 中验证生成的部署构件,并通过 Dynamo-Triton 提供服务,而无需为单独的运行时重写模型。
它还研究了 GPU 支持的 KV 缓存如何减少重复计算,并提供了证明延迟降低高达 5.93 倍的基准,强调了此部署工作流程的实际性能优势。
为什么使用 HSTU 进行生成式推荐?
HSTU 用于在高基数非静态事件流上运行的 GR 工作负载。在传统的推荐系统中,检索和排序通常基于一系列专用模型和特征管线构建而成。GR 取代了模型推荐作为顺序预测问题,允许模型在一个序列感知架构中根据用户上下文、物品历史记录、操作历史记录和候选物品进行推理。
在 NVIDIA HSTU 排名示例中,模型输入基于分类token构建。上下文token代表用户端信息,物品token代表物品,可选动作token代表用户与这些物品的交互。
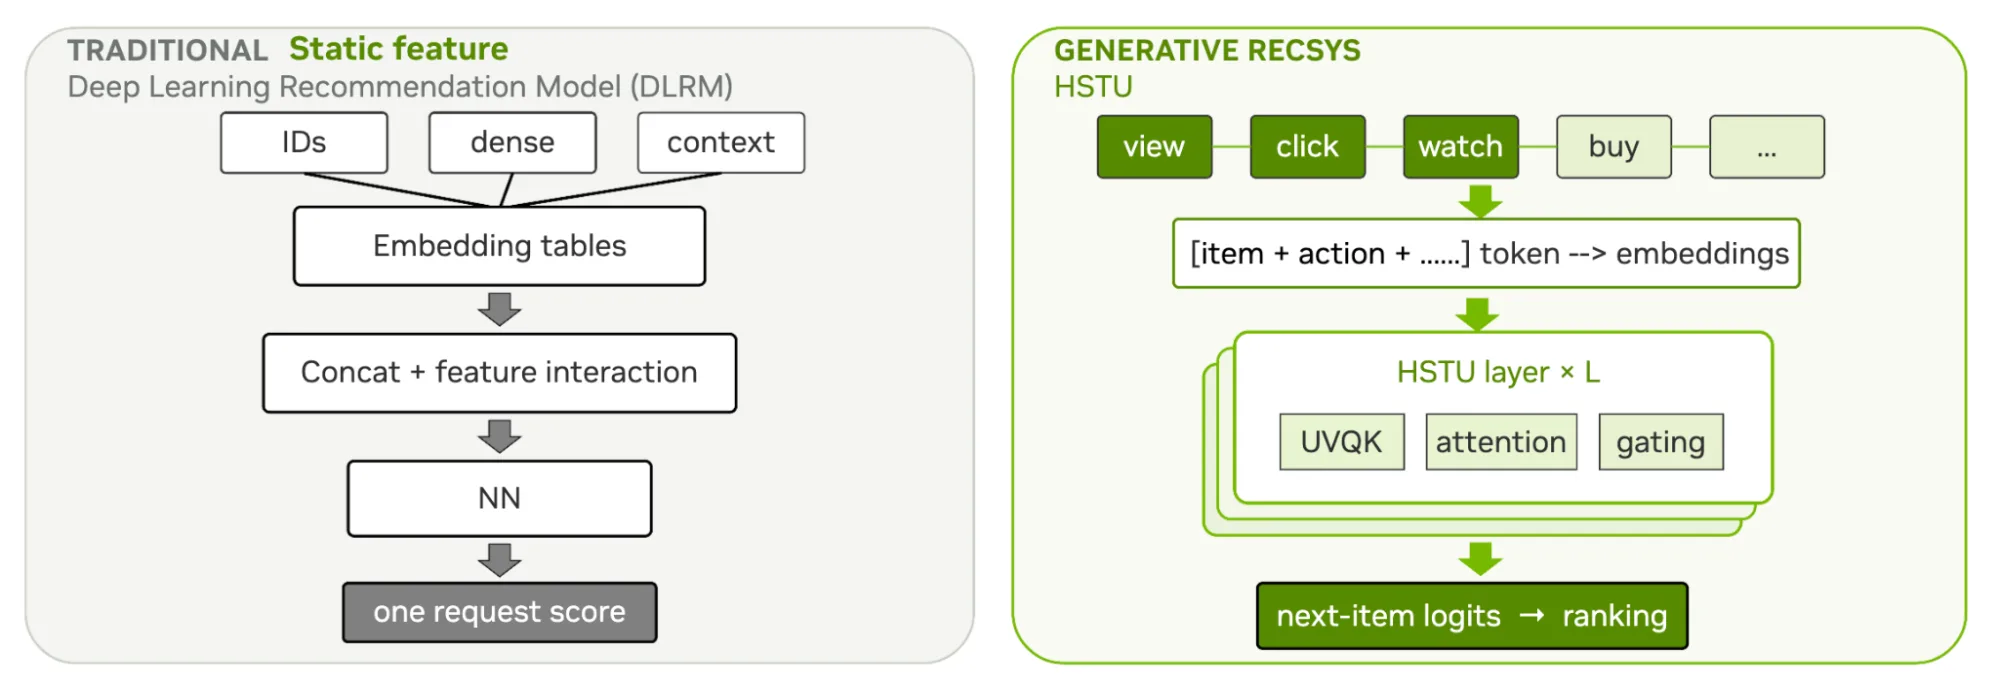
HSTU 预处理路径可检索嵌入,在存在动作token时交错项目和动作嵌入,附加上下文信息,并应用位置编码。然后,HSTU 块处理序列,预测头生成多任务排名输出。
这种结构非常适合推荐系统,在这些系统中,最新性、顺序和重复交互模式非常重要。但是,这也意味着,当每个请求重复处理较长的历史序列时,推理成本会变得很高。生产系统需要保留 HSTU 建模的优势,同时减少服务期间的冗余计算。
为大型顺序推荐系统提供服务为何具有挑战性?
为大型顺序推荐系统提供服务不同于为小型密集排名模型提供服务。服务堆栈必须处理锯齿状的序列输入、大型分类嵌入状态、长历史记录和请求模式,其中同一用户可能仅在少量新信息的情况下重复返回。重新计算每个请求的用户历史记录的完整键值状态不仅会浪费工作,还会增加延迟。
这正是 KV 缓存的重要性所在。KV 缓存可存储先前序列计算中可重复使用的键值数据,使模型能够避免重新计算用户历史记录的缓存部分。对于推荐系统推理,当用户的长期历史记录在新的候选项或最近的操作出现时基本保持稳定时,这一点尤其有用。
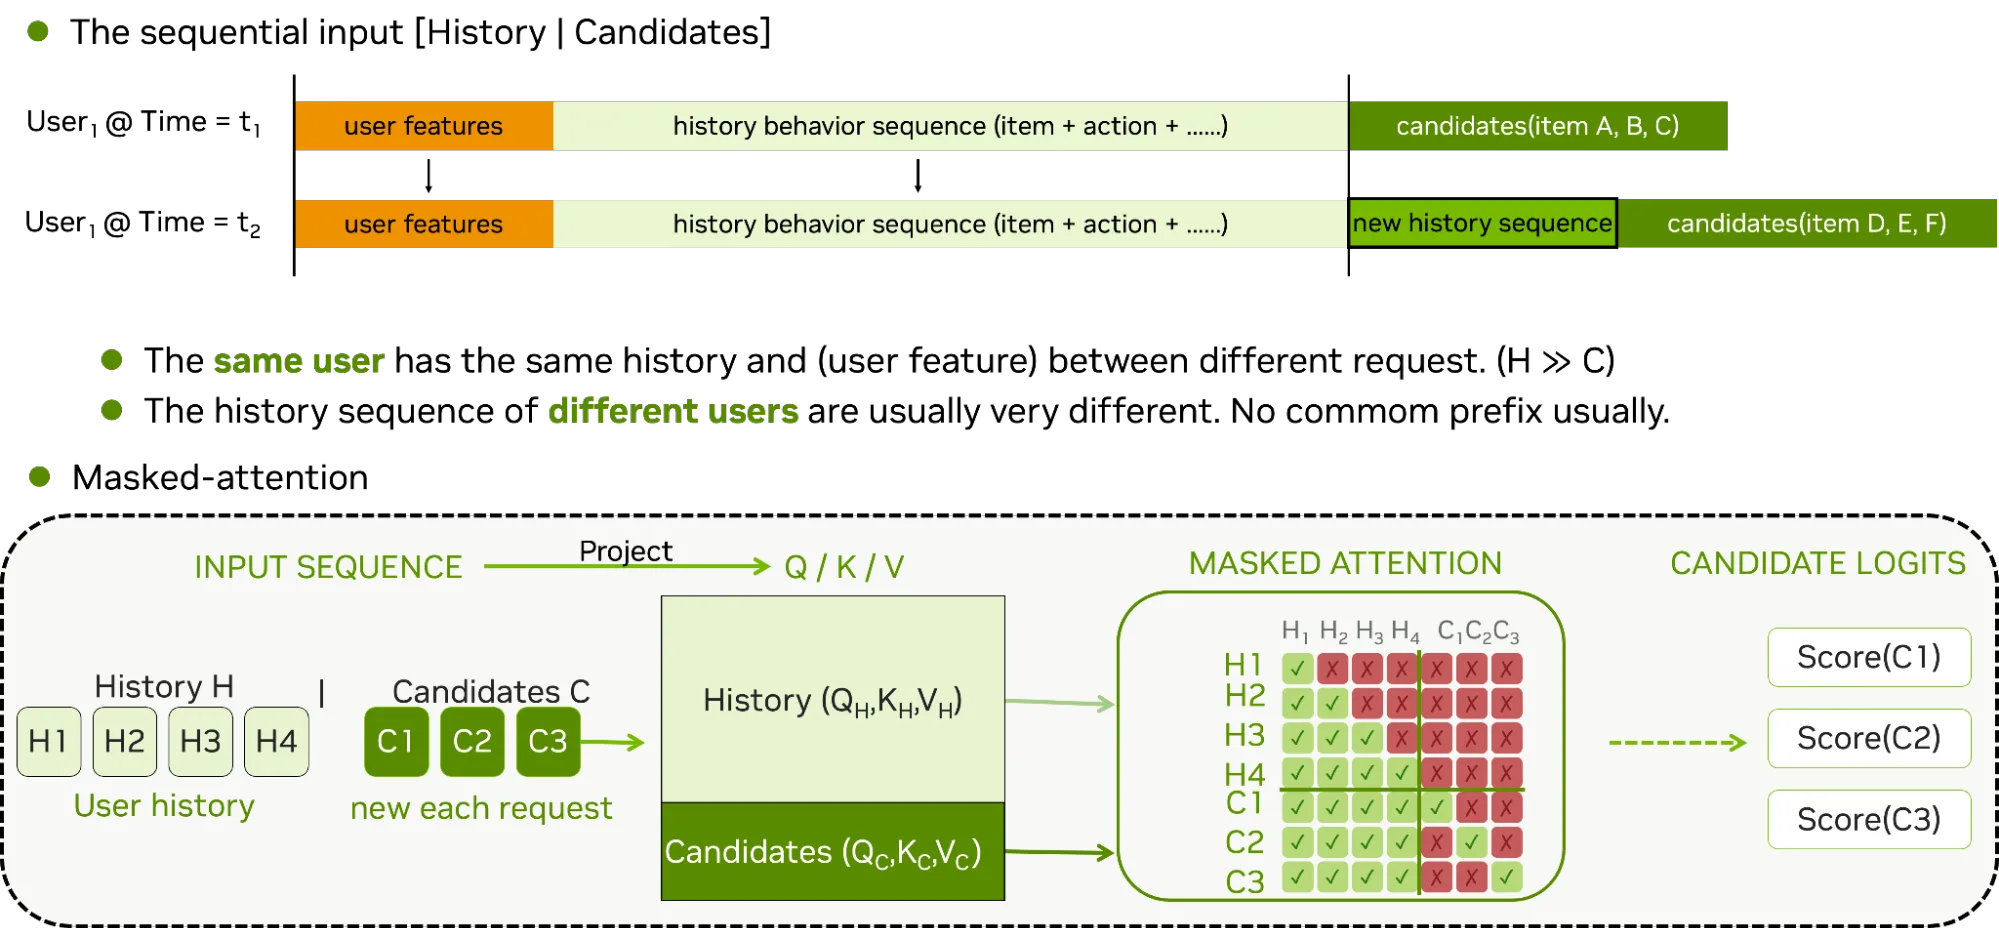
NVIDIA HSTU 推理工作流包括使用 GPU 显存和主机存储进行 KV 数据缓存的 KVCacheManager。GPU 缓存以分页 KV 数据表的形式组织,支持查找、分配、附加和移除。当 GPU 缓存空间受限时,可以根据 LRU 式策略驱逐年龄较大的用户。主机侧存储为缓存的 KV 数据提供了另一层,工作流包括一个由 FlexKV 支持的后端,用于 KV 缓存运行时。
HSTU 注意力内核可以使用分页缓存中的 KV 数据,而导出的推理路径包括用于查找、分配、载入、附加和卸载的缓存感知自定义操作。这允许服务路径保留模型的序列语义,同时减少冗余计算。
用于原生推理的 PyTorch AOTI
Pytorch AOTI ( Ahead-of-Time Inductor) 工作流从 PyTorch 模型开始,并使用 torch.export 和 PyTorch AOTI 进行导出。AOTI 会提前将模型编译成可由原生 C++ 运行时加载的软件包。这可降低 Python 运行时开销,并为 Dynamo-Triton PyTorch AOTI 后端提供便于部署的构件。
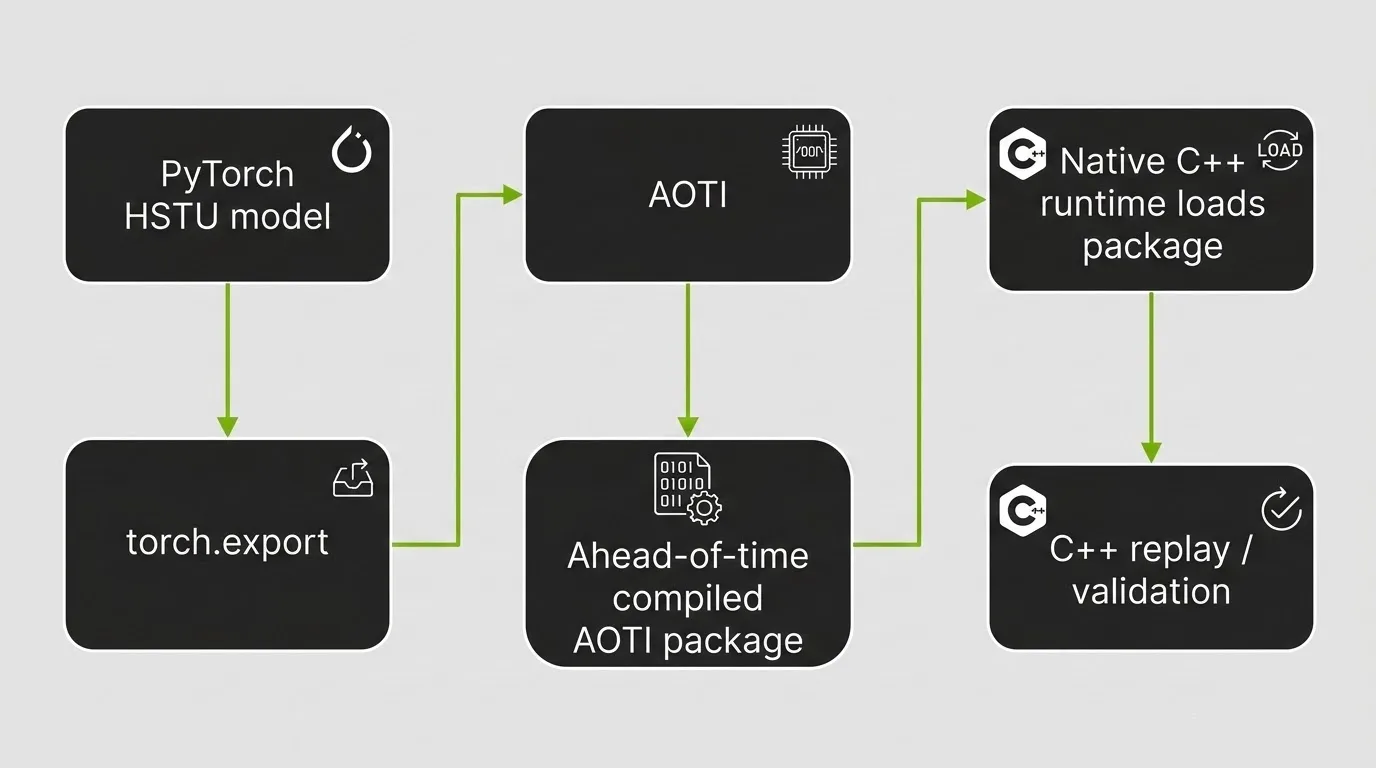
导出的模型包包含 AOTI 模型存档以及元数据和嵌入表文件。在 NVIDIA 示例中,嵌入实现结合了 DynamicEmb 推理嵌入表和 NV Embedding Cache,通过仅在 GPU 显存中存储热门嵌入,同时将整个表保留在 CPU 显存中,从而减少 GPU 显存占用。导出路径会写入层元数据,并将嵌入表数据与编译后的 .pt2 存档文件一起嵌入,因此可以加载模型,而无需重复嵌入表副本。
该工作流可通过多种方式验证相同的导出伪影。Python 导出脚本会生成软件包并回放张量。原生 C++ 可执行文件加载并回放导出的模型,以进行正确性和性能验证。然后,Dynamo-Triton 部署使用相同的 AOTI 软件包和回放路径,这有助于保持开发验证和生产服务保持一致。
Dynamo-Triton 部署路径
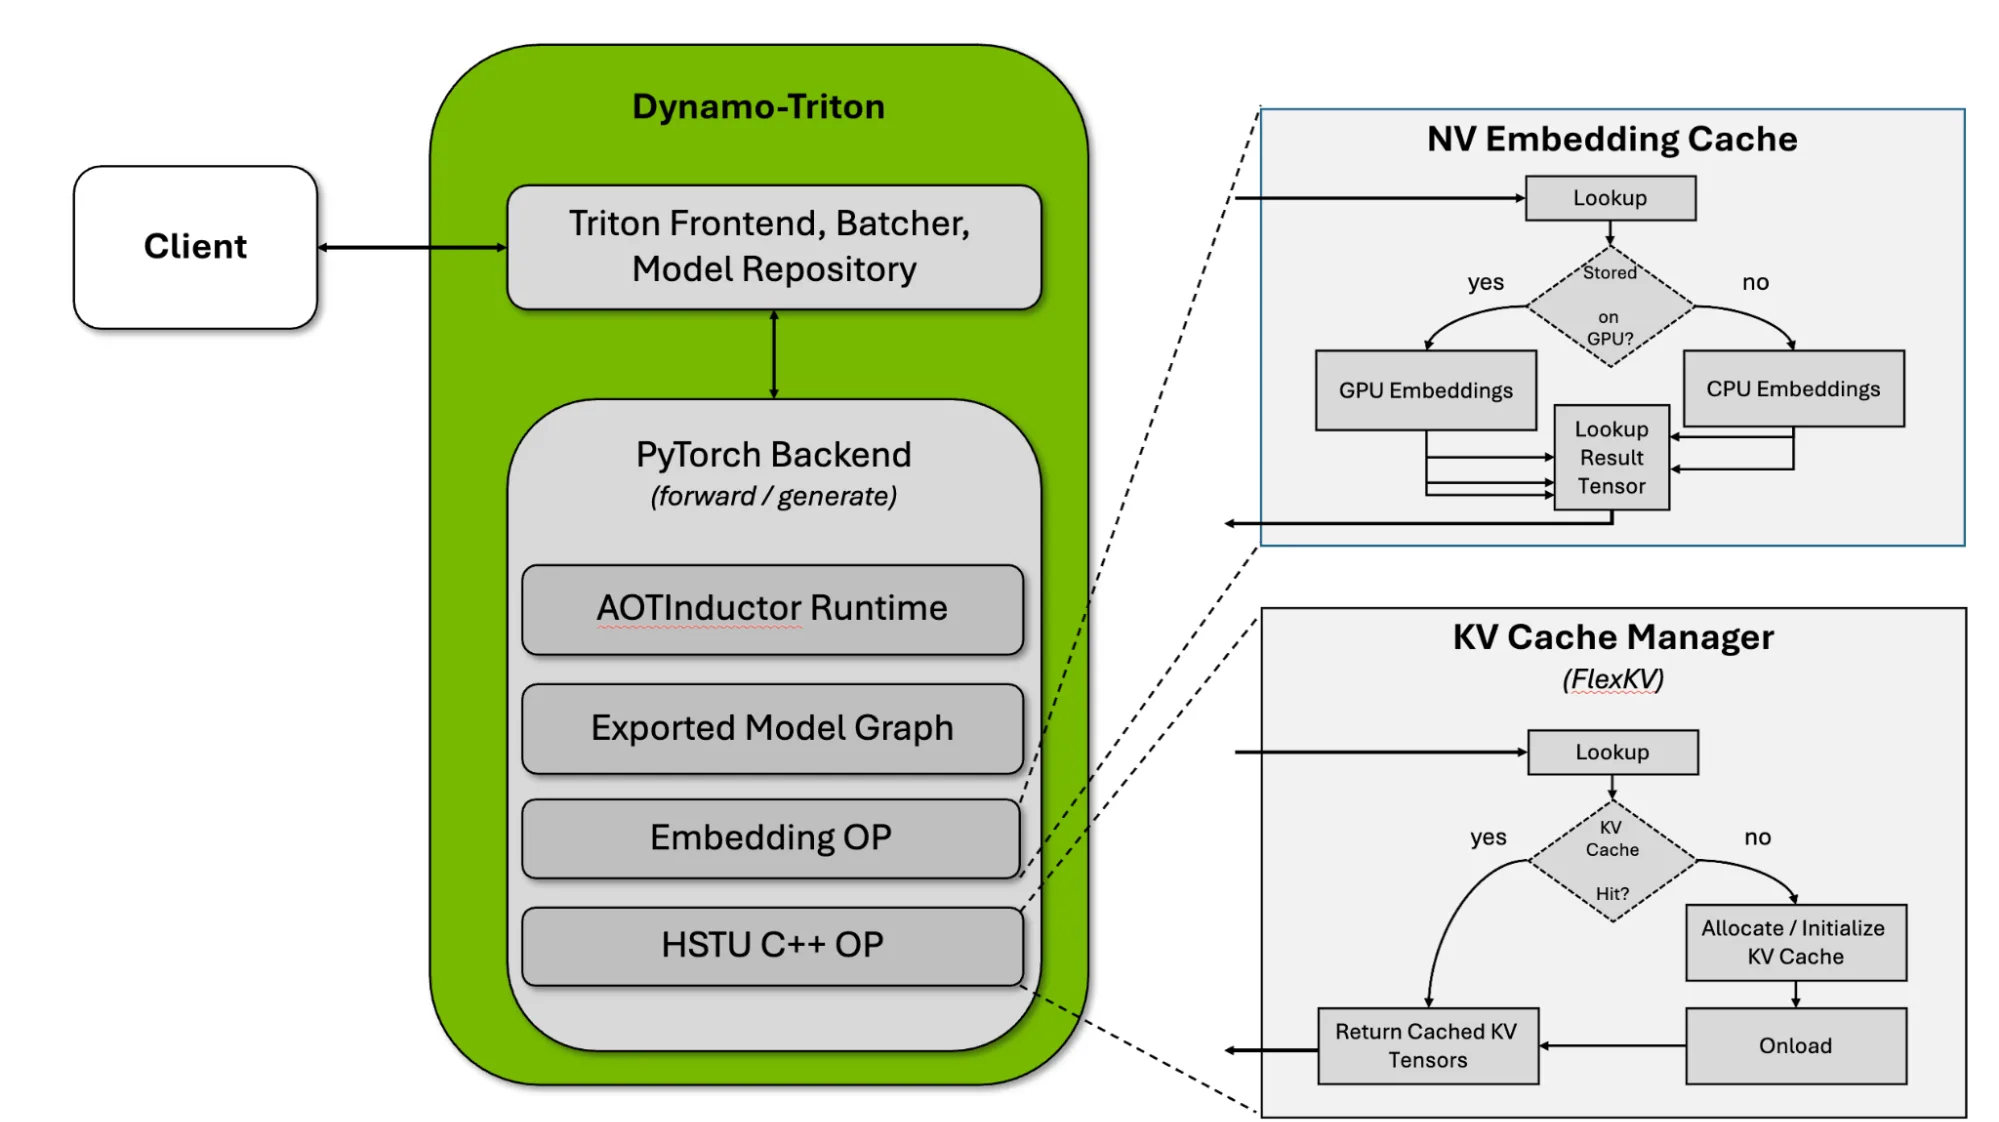
Dynamo-Triton 为导出的 HSTU 模型提供生产服务层。AOTI 部署使用带有 platform: "torch_aoti" 的 Dynamo-Triton PyTorch 后端。这使得 Dynamo-Triton 能够加载和提供提前编译的 PyTorch 模型包。
完整的工作流程包括以下五个阶段:
- 构建所需的自定义运算符和运行时库
- 使用 PyTorch AOTI 导出 HSTU Ranking 模型
- 启动由 FlexKV 支持的 KV-cache 服务
- 使用原生 C++ 回放验证导出的伪影
- 使用 Dynamo-Triton 为导出的 KV-cache AOTI 模型提供服务
这种方法很重要,因为推荐系统服务需要的不仅仅是一个快速的模型内核。NV Embedding 缓存通过仅在 GPU 显存中保留嵌入表的热部分来降低 GPU 显存需求。FlexKV通过缓存注意力块来减少长用户历史记录的重新计算。Dynamo-Triton 提供模型库管理、请求处理、后端集成、指标和部署结构。AOTI 带来了开销较低的编译模型构件。它们共同构成了一个服务堆栈,旨在实现逼真的生成式推荐系统推理。
基准测试 HSTU 服务延迟
此基准测试比较了 HSTU 在 Dynamo-Triton 后端、模型大小、批量大小和 KV 缓存状态下的服务延迟。
其目标是量化生产级 HSTU 服务堆栈的性能优势。它将 Dynamo-Triton PyTorch AOTI 后端与 Python 后端进行比较,测量 GPU KV 缓存带来的额外延迟降低,并评估这些优势如何跨模型深度和批量大小扩展。最终,它向开发者展示了他们在从基于 Python 的非缓存推理转向使用 Dynamo-Triton 的编译、缓存感知型 HSTU 部署时所能期望的性能。
benchmark results in recsys-examples 中的基准测试结果使用单个 GPU 上的 KuaiRand-1K 排名配置。模型结构包括三层和八层 HSTU 变体、隐藏大小 512、四个注意力头、BF16 模型权重、BF16 KV 缓存、历史流中最大历史序列长度为 8192 ( 4096 个项目加动作对) 、最大候选序列长度为 100 以及六个上下文特征。比对前的有效序列长度为 8298 个 token,导出时的最大比对序列长度为 8320。
基准协议会报告每个逻辑请求的延迟。对于 Dynamo-Triton AOTI 基准测试,每次 Dynamo-Triton 调用都包含一个逻辑批量,每个逻辑请求的延迟是通过端到端通过时间除以 Dynamo-Triton 调用次数乘逻辑批量大小来计算的。数据集加载、验证、重新批处理、用户 ID 生成、服务器启动、预热和预热后休眠均排除在测量时间之外。
用于 Dynamo-Triton 后端比较和批量大小结果的硬件是 NVIDIA RTX PRO 6000 Blackwell 工作站版 GPU。
Dynamo-Triton 后端对比
在 Dynamo-Triton batch size 2 下,即使未命中 KV 缓存,PyTorch AOTI 也比 Dynamo-Triton Python 后端降低了延迟。由于 GPU KV 缓存的内存容量为 20 GB,因此延迟显著降低。
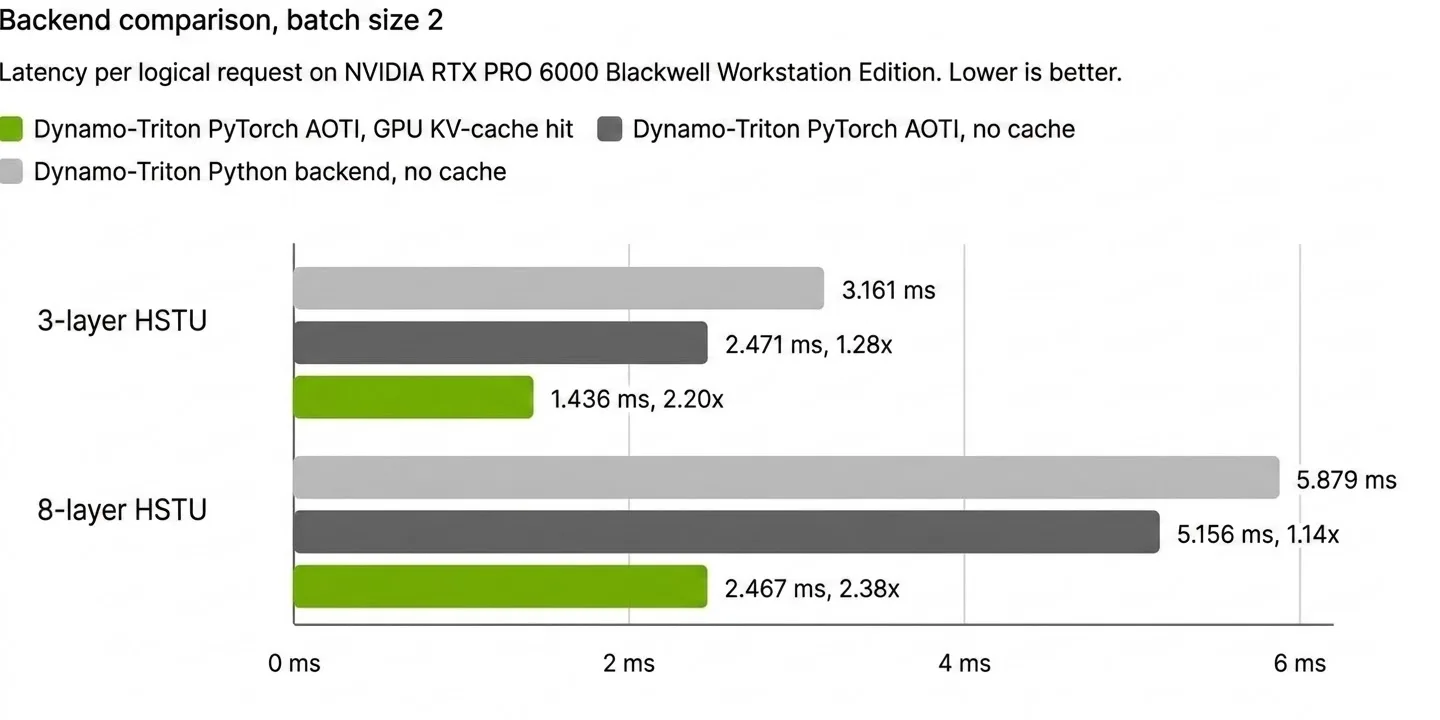
这些结果显示了两种不同的收益。首先,与 Python 后端相比,AOTI 减少了服务开销。其次,KV 缓存命中通过重复使用缓存序列状态来减少模型工作量。缓存的优势在更深的 8 层模型上尤为明显,在这种模型中,避免重新计算会产生更大的影响。
使用 AOTI 和 KV 缓存进行批量大小扩展
按批量大小划分的 PyTorch AOTI 后端结果显示,随着逻辑批量大小的增加,KV 缓存变得越来越有效。
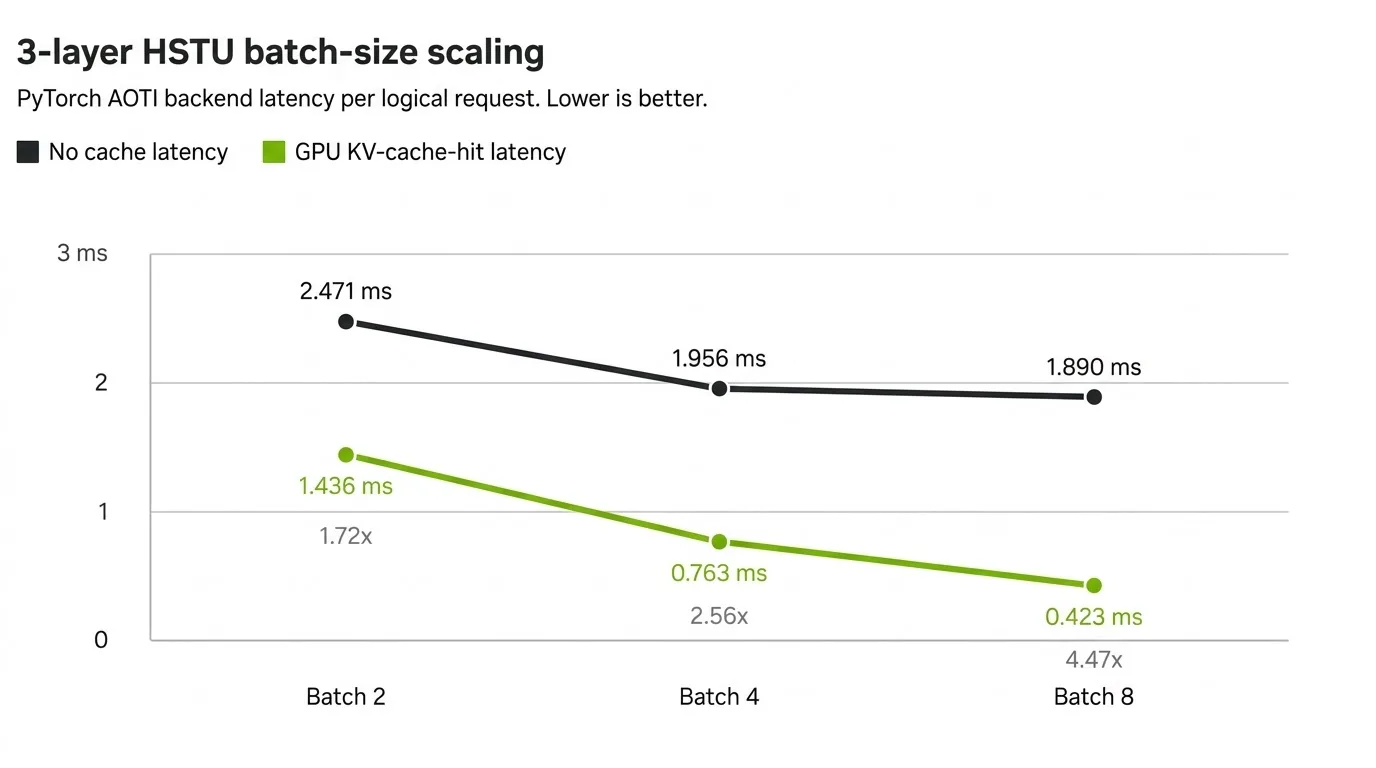
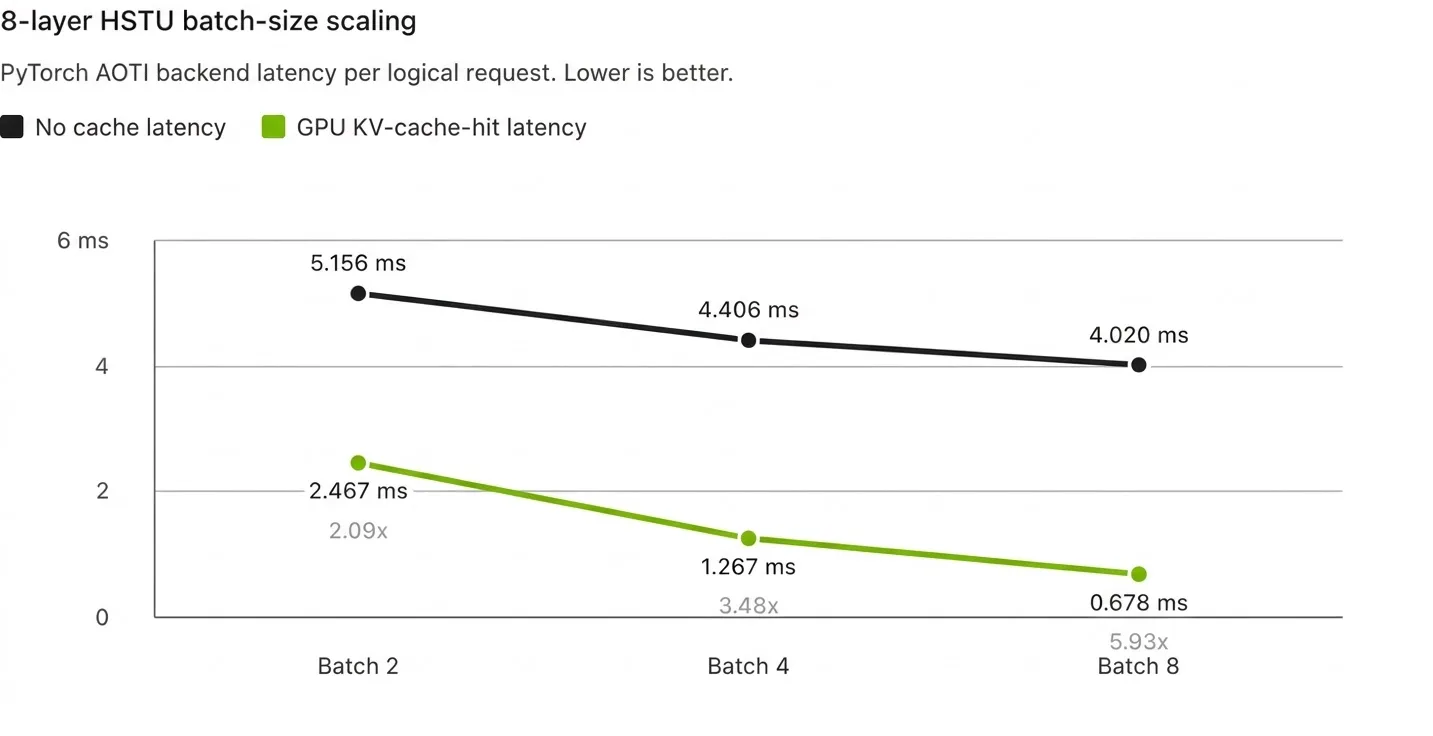
在批量大小为 8 时,三层 HSTU 模型在 GPU KV 缓存命中的情况下,每个逻辑请求的延迟为 0.423 毫秒。八层 HSTU 模型可达到 0.678 毫秒。这些是长序列排名推理的出色结果,展示了将编译模型执行与缓存感知服务相结合的价值。
加速 HSTU GR 推理有哪些好处?
推荐系统在严格的延迟预算下运行。额外的排名延迟会影响页面加载时间、订阅源响应速度和广告投放截止日期。与此同时,序列感知和个性化模型的日益增强可能需要更多的推理计算,尤其是随着用户历史记录的增长。
HSTU 的服务工作流结合了互补技术来应对这一挑战。HSTU 提供生成式推荐架构,PyTorch AOTInductor 生成提前编译的部署构件,FlexKV 支持的 KV 缓存支持重复使用先前计算的注意力状态,NVIDIA Dynamo-Triton 提供生产服务环境。
当连续请求共享用户交互历史的不变前缀时,这种方法尤其有用。模型无需重新计算序列中该部分的注意力,而是可以重用其缓存的键值状态,仅计算新附加token的所需内容。序列更长、模型更深,否则跨多个 HSTU 层重复计算会显著增加延迟,因此潜在的节省量也会增加。
开始加速 HSTU GR 推理
您可以从 NVIDIA/recsys-examples GitHub 存储库中复制和扩展此工作流。HSTU 概述介绍了 GR 模型结构,包括上下文标记、物品标记、动作标记、嵌入表、HSTU 块和预测头。
AOTI 推理指南介绍了构建所需的图像和库、准备 KuaiRand-1K 数据、训练检查点、导出 KV 缓存 AOTI 模型、使用 C++ 回放对其进行验证、打包 Dynamo-Triton 运行时图像,以及通过 Dynamo-Triton 服务器回放请求。
如需了解详情,请查看以下相关资源:
致谢
本文是 NVIDIA 多个团队跨职能部门撰写的博文。我们在此感谢 J、Runchu Zhao、Yulu Liu、Lin Hu、Zhuofan Li、Jacob Subag 和 Tomer Bar-On 所做的贡献。


