

在分布式 AI 工作负载中,一个错误就会产生一系列症状。GPU 或网络事件可能会随着其他 rank 上的 NCCL 错误、调度器状态变化以及数千条下游消息而出现。报告的异常显示了工作负载停止的位置,而非故障开始的位置。
在本文中,您将学习如何根据示例工作负载证据运行 NVIDIA Attribution,检查诊断结果,并探索归因规则如何识别故障模式。
NVIDIA Attribution 会关联工作负载范围内的日志、指标、遥测和调度器状态,并返回结构化诊断:结果、根本原因、受影响节点、支持症状和证据追踪。以工作负载为中心是指在工作负载的上下文中分析故障,而不是将故障视为孤立的节点事件。确定性规则使结果具有可再现性和可定制性,而结构化输出则支持与现有的健康和恢复系统集成。
NVIDIA 运行状况和恢复软件可帮助团队保持 AI 工作负载正常运行。NVIDIA Attribution 解释了工作负载失败的原因,并提供了指导下一步行动的证据。此外,它还能进行就绪检查、持续运行状况监控,以及修复基础设施和重启工作负载的系统。
NVIDIA Attribution 在整个 NVIDIA AI 基础架构的生产环境中使用多年,每周可分析数十万个 GPU 上的数百万个工作负载。在一个由 RDMA 支持的大型集群中,它将端口错误、连接重置和调度器事件关联起来,以识别特定主机和交换机端口周围的模式,帮助团队针对网络进行修复和拥塞调整。
它包含两个可部署的组件:NVIDIA Attribution Service 和 NVIDIA Attribution Blueprint;这两个组件均利用核心追踪引擎。该服务通过 RESTAPI 提供属性;Blueprint 将集群调度程序和遥测源连接到该服务,并写入结果。
将工作负载证据转化为单一诊断
NVIDIA Attribution Service 一次可分析一次工作负载尝试。Blueprint 收集工作负载上下文和证据,服务提取并关联事件,Blueprint 返回结构化结果。
该路径包含四个阶段:
- 确定工作负载范围。Blueprint 可通过调度程序标识符或显式执行窗口和节点分配识别工作负载尝试。
- 收集观察结果。日志和指标连接器可根据应用日志、系统日志、GPU 驱动程序和 Fabric Manager 消息、调度程序历史记录、节点和网络指标生成工作负载范围的
Observation记录。 - 提取和关联事件。该服务会调用属性引擎来识别 GPU XID、NCCL 故障、调度器转换和指标条件等重大事件。确定性规则可评估其时间和交互作用,将下游症状与导致故障的事件区分开来,并找出根本原因。
- 返回结构化结果。该 Blueprint 将结果与工作负载结果 (
terminal_state)、归属域 (sub_domain)、症状、受影响节点以及收集器覆盖率和错误记录相结合。
从应用到识别
下面是提取证据、解释事件和保留解释分布式工作负载故障的症状的示例。
考虑一下多秩训练工作负载,其中一个 GPU 遇到硬故障,例如:XID 149 和 NCCL 错误在其他秩中发生。NVIDIA Attribution 可关联节点之间的事件,将 XID 识别为根本原因,在症状链中保留 NCCL 故障,并命名负责节点。工作负载报告为硬件故障,而非一组独立的通信错误。
失败集合可能会在多个节点上留下错误报告。这些报告告诉我们工作负载在哪里发现了问题。为了解释失败的原因,NVIDIA Attribution 将其与其他来源的证据相结合,并一起评估症状。
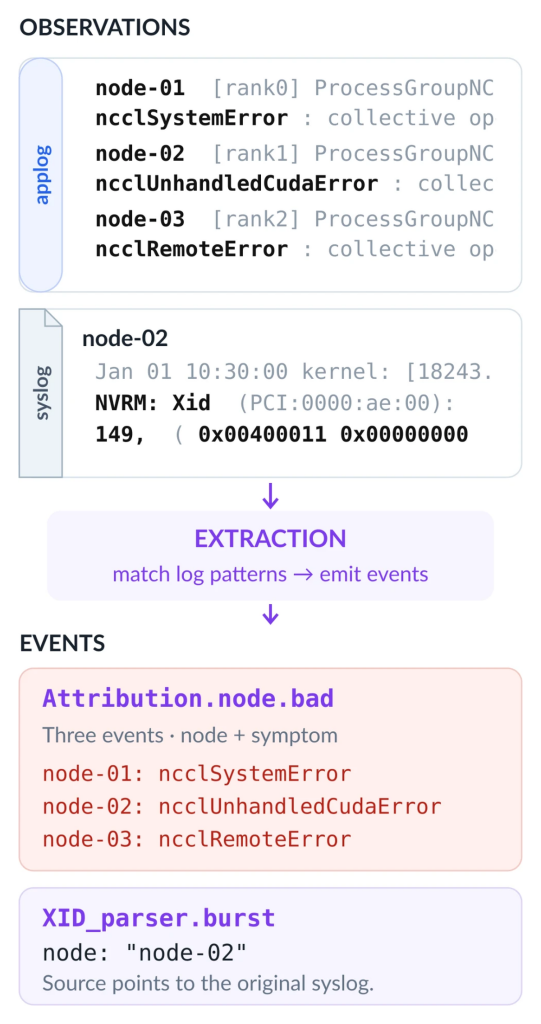
在此合成工作负载中,应用程序日志包含三个不同的 NCCL 错误。node-02 上的系统日志包含 XID 149,其中包含解码为 NVLink 信号完整性问题的错误词。我们将通过规则管道遵循这一证据。
使用提取解释日志
提取阶段是第一个运行阶段;它在原始输入日志上运行,并生成结构化事件,以供后续阶段处理。
在过滤过程中解码 NVLink 证据
过滤规则读取和写入事件流。早期 HandleXidBurstEvents 规则读取 XID 突发证据,解码错误词,并在 node-02 上发出信号完整性问题的归属事件。在此步骤中,三个 NCCL 事件保持不变。
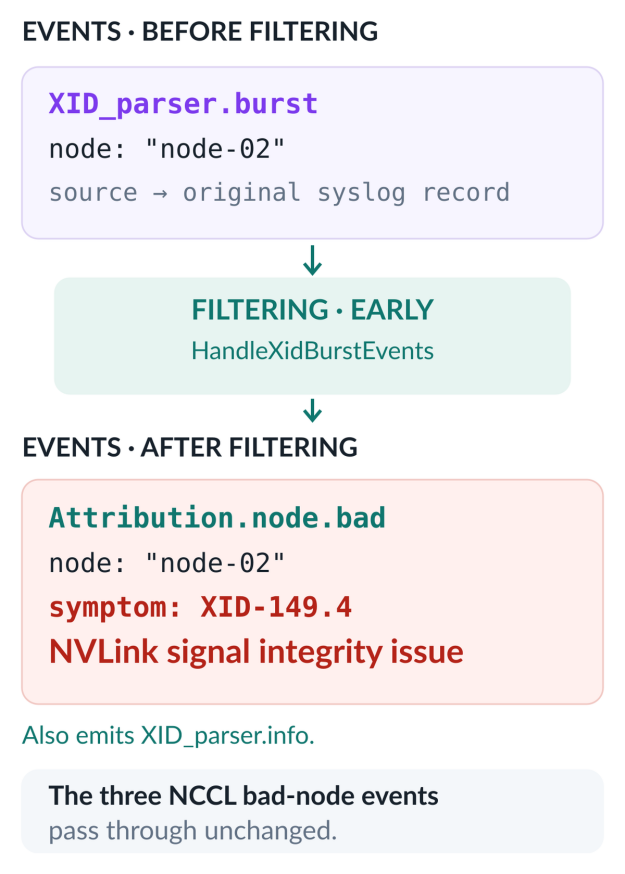
上图 2 中,该图将解码症状缩写为 XID-149.4 信号完整性问题。过滤器还会发送解析器信息以供检查。
将症状细化为一个属性
该框架可将事件物化为每个节点的症状,运行每个节点的清理程序,并将存活的症状汇总到整个作业中。在本示例中,所有四个候选项都达到了最终优化。
Xid149AndNvlinkFiltering 会保留信号完整性症状,并将其他节点症状降级。Gb200PriorityRootCause 可减少整个作业范围内的活跃症状集。然后,结果映射会生成硬件故障属性。
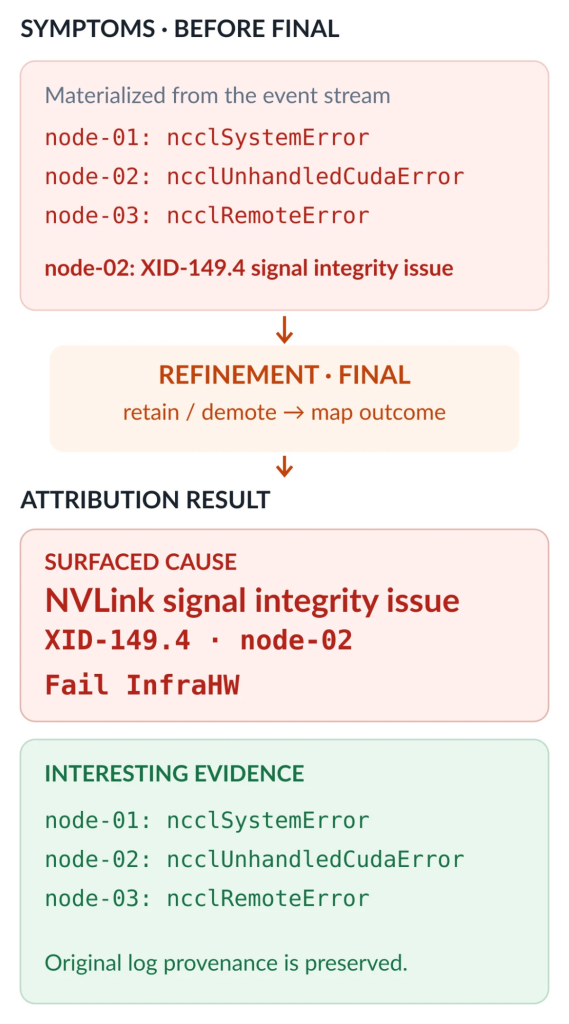
该属性会出现 node-02 和信号完整性问题。NCCL 报告仍然是有用的证据:降级保留了原始来源的“有趣性”,因此仍然可以检查它们。
当多种原因符合证据时,sub_domain 就会变得模糊不清。属性识别的质量取决于基础遥测的质量和完整性。诊断记录这种区别,正确反映不确定性,而不是将不完整的证据转化为最终诊断。
服务和 Blueprint 架构
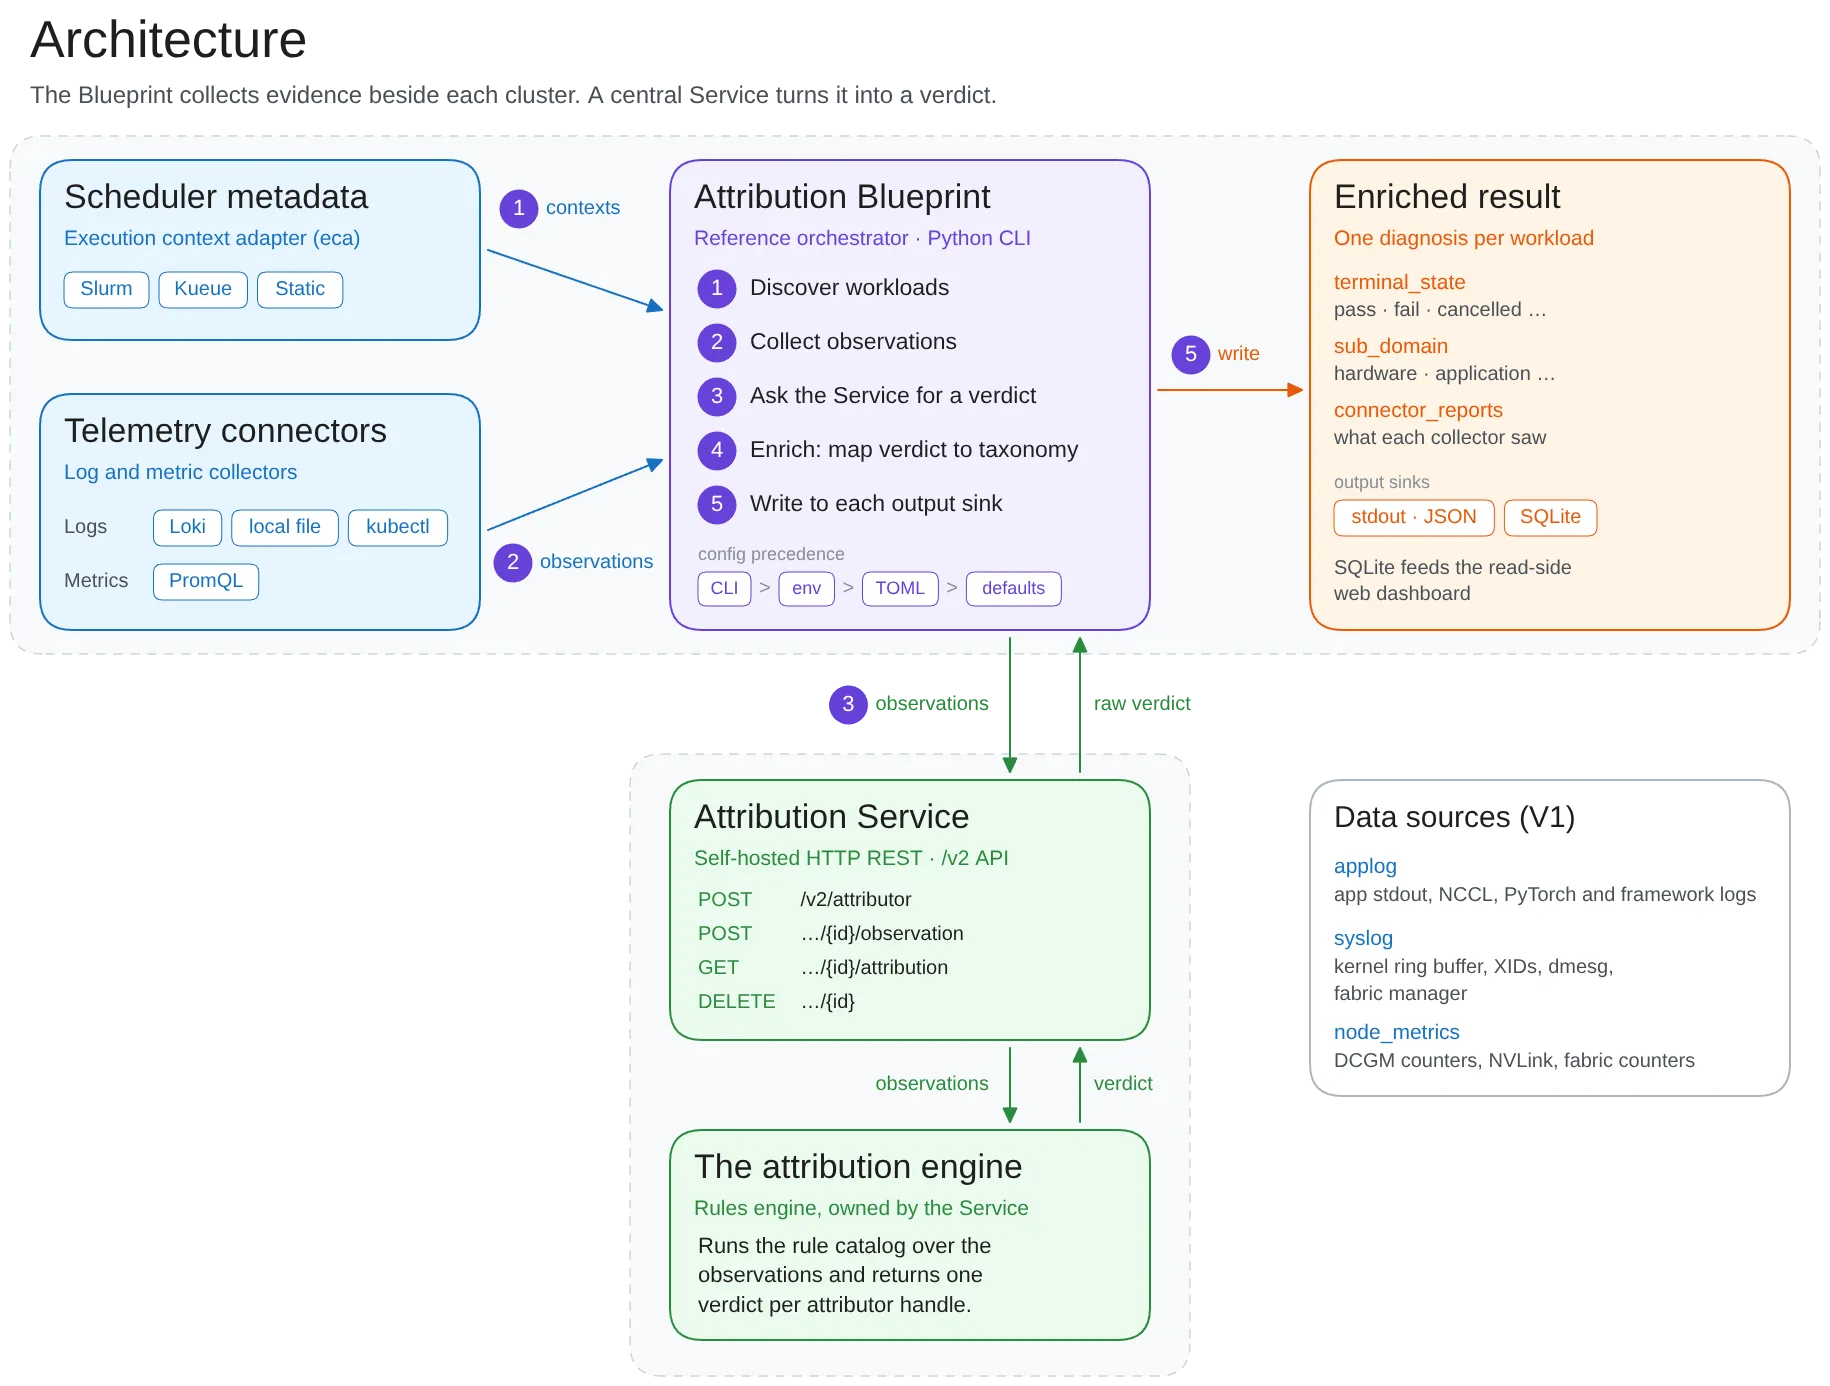
追踪引擎包含规则引擎和核心追踪逻辑。Attribution Service 通过 HTTP API 公开该逻辑,而 Blueprint 则负责处理集群特定的集成。这种分离使团队能够在集群中应用相同的归属逻辑,同时将调度程序、遥测和输出连接器调整到每个环境。
Attribution Service (追踪服务):围绕核心追踪引擎的自托管 HTTP 包装器,可接收标准化观察结果,并为每个工作负载返回一个结果。
Attribution Blueprint:一个 Python 参考编排器,用于发现工作负载、解析 ExecutionContext、运行收集器、调用服务、丰富判断内容、编写 AttributionBlueprintResult,并提供只读控制面板。这是一个参考实现,供从业者根据自身环境定制解决方案。
Blueprint 随附:
- 用于 Slurm、Kueue 和静态输入的执行上下文连接器
- 用于 Loki、本地文件、Kubernetes Pod 日志和 PromQL 指标的日志和指标连接器
- 适用于标准输出和 SQLite 的输出连接器
Blueprint 可以在每个集群的数据源附近运行,为每个 Blueprint 提供专用的归因服务,或为多个 Blueprint 提供共享服务。您可以灵活选择自定义部署的方式,例如:一对一或一对一。下游系统使用 terminal_state 和 sub_domain,而非解析特定于产品的日志。
将归属扩展到您的基础架构
开源 NVIDIA Attribution 使基础设施团队能够对故障模式进行一次编码,并将其应用于工作负载和集群。开发者可以为新的故障模式添加规则,为其调度程序和遥测后端实现连接器,并将 AttributionBlueprintResult 记录路由到事件、恢复和车队管理系统。由于扩展程序使用相同的 ExecutionContext、Observation 和结果合同,因此新的集成会馈送相同的诊断流程。
演练
先前的示例说明了 GPU 故障如何导致跨 rank 的 NCCL 错误。在此演示中,您将使用 NVIDIA Attribution 分析记录的训练工作负载中的 NVLink 错误证据。您将运行随附的样本,检查诊断和源证据,并检查缩小报告症状范围的规则。然后,您将根据 NVIDIA 恢复指南确定受影响节点的下一个操作。
演示包含两个组件:
- Attribution Service 运行分析规则。
- Attribution Blueprint 会读取工作负载上下文和日志,调用服务,并将检查结果存储在本地控制面板中。
样本证据随存储库一起提供,因此您可以在连接实时集群之前进行分析。
运行示例工作流程
NVIDIA Attribution quickstart 在 Docker 中构建 Attribution Service 和 dashboard,然后使用 Blueprint 处理提交到存储库的示例工作负载证据。您需要 Docker 和 uv 包管理器。
克隆资源库并运行示例工作流程:
git clone https://github.com/dsx-ai-factory/attribution.git nvidia-attribution
cd nvidia-attribution


docker build \
  -f blueprint/docker/Dockerfile \
  -t attribution-blueprint-web:quickstart \
  "$PWD"


mkdir -p .attribution-sample


docker run -d --rm \
  --name attribution-blueprint-web-local \
  -e ATTRIBUTION_DB=/data/attributions.db \
  -p "127.0.0.1:8000:8000" \
  -p "127.0.0.1:8080:8080" \
  -v "$PWD/.attribution-sample:/data" \
  attribution-blueprint-web:quickstart


uv run --project blueprint --frozen nvidia-attribution-blueprint \
  --configs blueprint/examples/static/configs \
  --connector attribution service_url http://127.0.0.1:8000 \
  --connector output db sqlite path .attribution-sample/attributions.db
打开 http://127.0.0.1:8080 以检查每个工作负载的诊断、受影响节点、辅助症状和证据追踪。
规则引擎使用签入声明性规则和 Python 规则。此生产规则可识别应用程序日志中无效的 Pyxis 参数,并包含一个托管测试用例:
[[extractor]]
name     = "SrunInvalidPyxisArgument"
match_re = "srun: error: Invalid --(?:no-)?container-\\S+ argument:"
emit     = { type = "bad_node", symptom = "srun: invalid pyxis argument" }


[[extractor.cases]]
expect  = "bad"
line    = "srun: error: Invalid --container-mounts argument: /nonexistent"
symptom = "srun: invalid pyxis argument"
启动时,服务加载捆绑的规则目录并评估内联用例。提交规则更改并随服务一起提供;规则不会通过 HTTP API 动态上传。资源库的规则创作指南介绍了如何选择合适的规则形式、记录新症状、添加测试以及验证完整目录。
开始使用
克隆 NVIDIA Attribution 存储库,然后按照快速入门指南运行示例并检查其诊断。要在您自己的基础架构中使用“Attribution” (属性) ,请参阅 Blueprint 配置参考中关于调度器和遥测连接器的内容,并了解如何为新的证据模式添加提取器规则。
致谢
Aaron Blakeman、Ajay Hotchandani、Alex Shaposhnikov、Ashwin Poojary、Ben Gueret、Chunyang Sheng、Torrin Poorkay、Gargi Prasad、Felix Abecassis、Grace Tan、Jason Sewall、Mayuri Gupta、Pasha Shamis、Pavan Kumar Gondhi、Piero Orderique、Rahul Kandu、Rakesh Konda 和 Sirshak Das 为 NVIDIA Attribution 和这篇博文做出了贡献。


