

GPU 应用程序越来越需要网络和数据移动,以实现由 GPU 控制的一流操作,而非主机驱动的服务。当 CPU 位于每个网络事务的中间位置时,它会成为关键路径的瓶颈,增加延迟,并限制分布式应用程序实时响应的效率。
NVIDIA DOCA GPUNetIO 是以 GPU 为中心的网络 SDK 层,用于实时数据包处理和数据移动,可直接解决这一问题。它整合了 GPUDirect RDMA、GPUDirect Async Kernel-Initiated (GDA-KI) 和 GDRCopy 等技术,因此 CUDA 内核可以直接驱动以太网、RDMA、Verbs 和 DMA 操作,同时使 CPU 远离应用程序关键路径。
具体而言,DOCA GPUNetIO 提供:
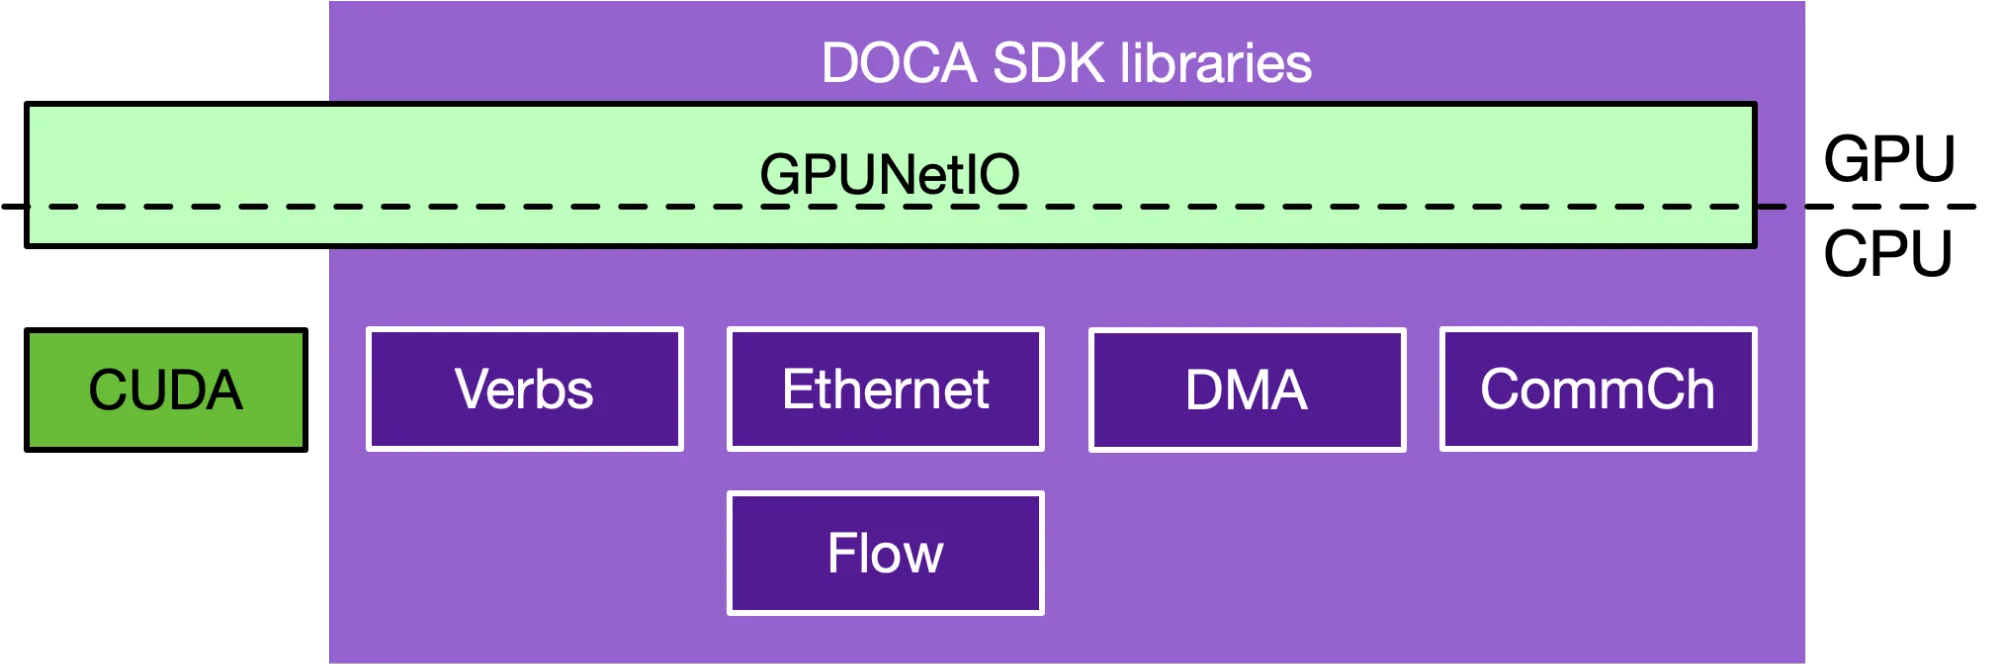
- 通过 DOCA Ethernet、DOCA Verbs、DOCA DMA、DOCA CommChannel 创建的 GPU 内存传输对象的控制路径上的 CPU 功能
- 数据路径上的 GPU CUDA 函数允许创建 CUDA 核函数,以操作导出的传输对象
自 NVIDIA 首次通过 DOCA GPUNetIO 引入以 GPU 为中心的数据包处理以来,该框架已显著成熟,从从关键路径中移除 CPU 的强大方式发展为跨 NVSHMEM、NCCL、Aerial 5G SDK、UCX/NIXL、NVQLink with Holoscan Sensor Bridge Operator、DeepEP/ HybridEP 等集成的统一 GDA-KI 基础。
本文将介绍新功能:开源库、统一架构以及这些集成的实际运作方式。
为什么统一的 GPUNetIO 保护套很重要
在 GPUNetIO 成为共享基础之前,每个通信库都构建了自己的 GDA-KI 式 GPU 初始化 RDMA 的单独实现。每个模型都独立工作,有自己的假设、自己的代码和自己的维护负担。他们之中没有一个人与其他人分享任何东西。
将不同的 GDA-KI 风格的实现引入 GPUNetIO 提供了一个很大的优势:它们可以收在每个人都可以在一个地方使用、改进和扩展的单个 GPUNetIO GDA-KI 实现上,而不是构建每个库并维护自己基于 GDA-KI 的 RDMA 通信路径。
这将为功能、优化和错误修复创建一个共享的投资点,减少跨 SDK 的重复工程,并允许为一个框架开发的创新更快地提供给其他框架。
换句话说,GPUNetIO 成为多个通信库可以构建的通用 GDA-KI 基础,而不是部分重叠的并行实现的集合。这种统一的方法对于 NIXL/ UCX、NCCL 和 NVSHMEM 等更高级别的库尤为重要。他们正在合作丰富 GPUNetIO,所有人都在利用整个堆栈的改进并从中受益。从生态系统的角度来看,这意味着代码的重复性更少,行为的碎片化程度更低,以及更强大的长期演变路径。
GPUNetIO:开源与 SDK
NVIDIA 以两种密切相关的形式提供 GPUNetIO,因为生态系统需要广度和开放性。完整的 DOCA SDK 版本是超集:它是 DOCA 编程指南 中记录的 GPUNetIO 实现,它涵盖了更广泛的 DOCA 堆栈,包括 (但不限于) Verbs、以太网、DMA 和 Comm 通道集成,同时保留了核心 GPUNetIO 模型,即将控制路径移动到更靠近 GPU 的位置,并将 CPU 从应用程序关键路径中移除。
与此同时,NVIDIA 还发布了一个开源 GPUNetIO 项目,作为一种轻量级、以 RDMA-Verbs 为中心的实现,专为希望在集成网络传输方面保持完全开放的框架而设计。如今,开放版本是更小的面向 Verbs 的子集,而 DOCA SDK 版本是超集,增加了更广泛的功能,例如更丰富的 RDMA 支持、以太网和 DMA。
这种分割并不是要创建两个不同的软件堆栈。它为 GPU 发起的 RDMA 通信提供了一个通用的开源基础,同时在 DOCA SDK 存在时仍然可以使用更高级的功能。事实上,开源实现可以在运行时检测 DOCA SDK 的存在,并在可用时通过 dlopen 调用选定的闭源 DOCA SDK 函数;如果 SDK 不存在,它将继续使用开源实现运行。
这是关键的架构优势:与构建和维护自己的 GDAKI 式 RDMA 管道的每个通信库不同,GPUNetIO 成为多个框架和库可以共同采用、强化和改进的共享实现点。
在 CUDA 设备端,对于 Verbs 路径而言,差距有意缩小:开放和 SDK 变体都公开了面向设备的 API,即使主机端实现从轻量级开源路径扩展到更广泛的 DOCA SDK 功能集,它也能保持 GPU 编程模型在很大程度上保持一致。
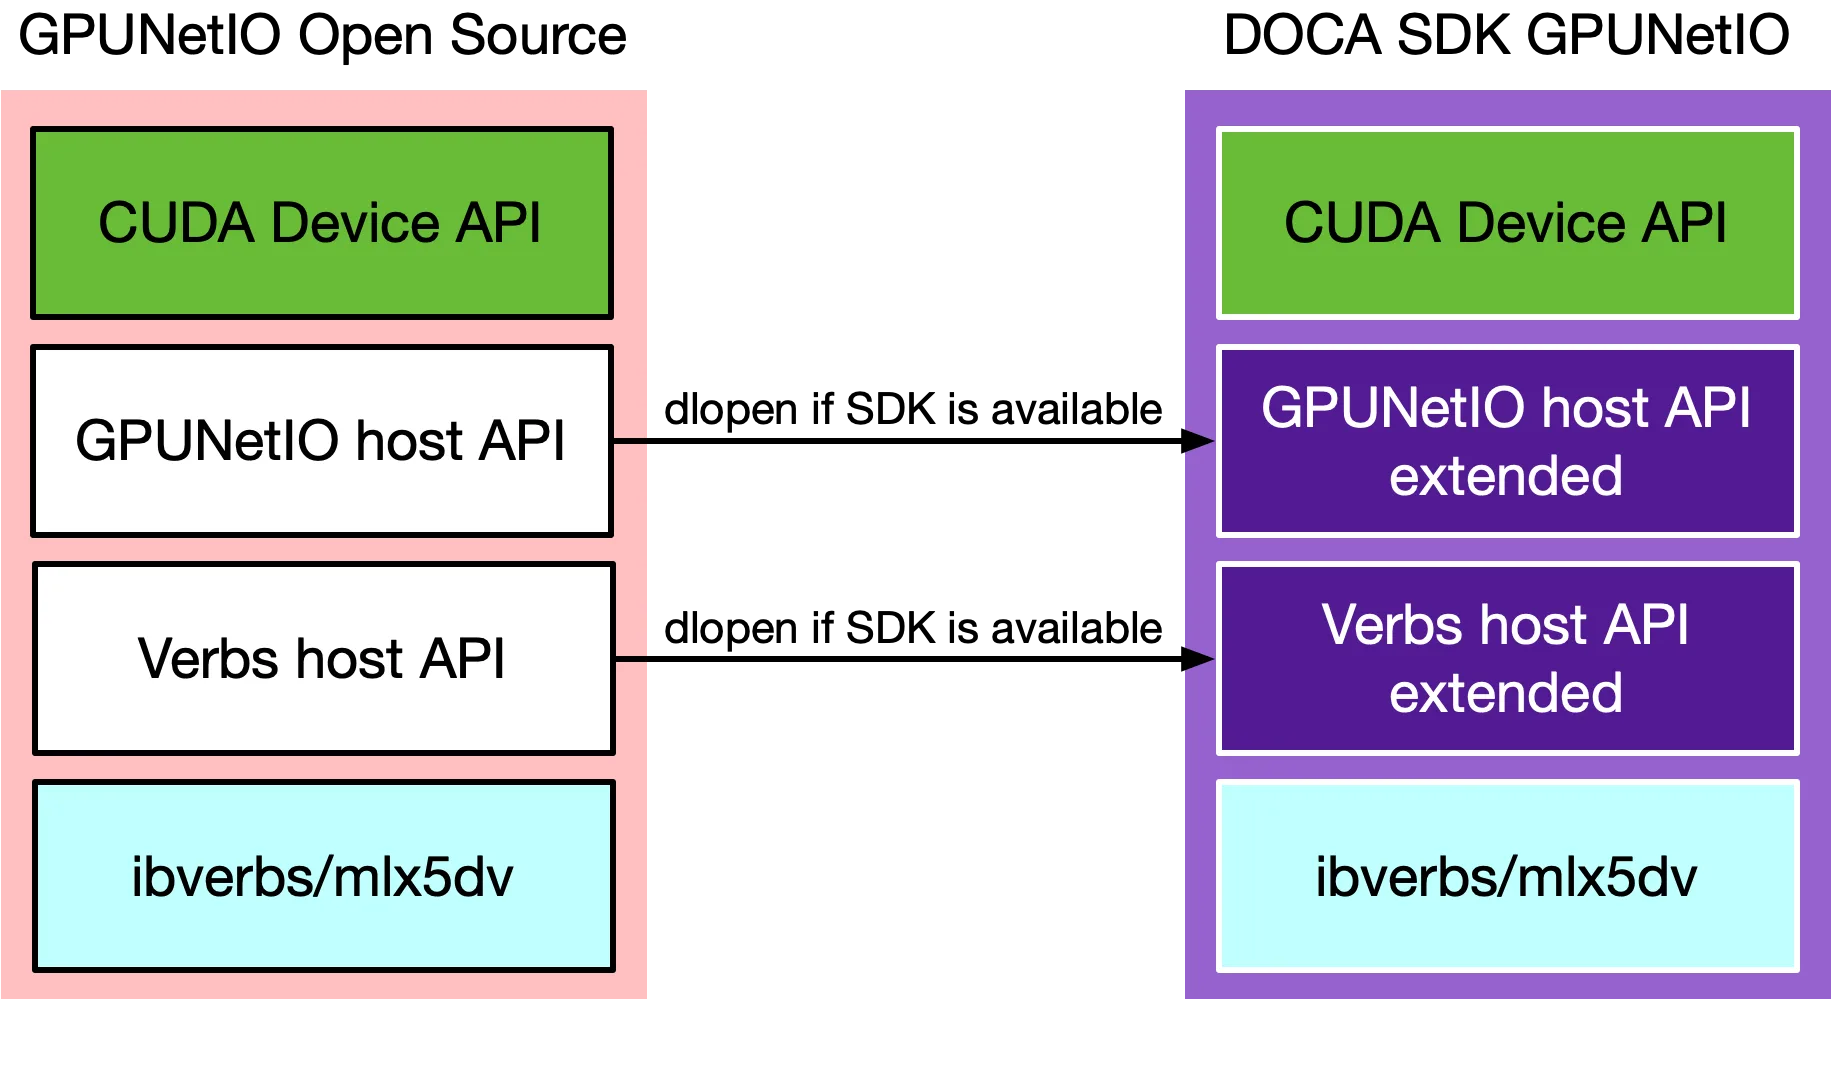
dlopen 调用 SDK 函数;否则它将独立运行编程模型
本节涵盖适用于任何 GPUNetIO 应用的关键概念和编程模型元素。
CPU 控制路径
在使用 DOCA GPUNetIO 的应用程序中,需要在主机侧 CPU 初始配置阶段执行控制路径,然后是数据路径通过 CUDA 内核在 GPU 上运行的第二阶段。
控制路径工作流程通常遵循以下顺序:
- 初始化和配置 GPU 和网络设备,并分配所需的内存。
- 创建网络传输对象。例如,DOCA Verbs 或 DOCA 以太网通过
mlx5dv在 CPU 上创建一个网络队列对象。 - GPUNetIO CPU 函数将网络队列对象的相关元素导出到存储在 GPU 显存中的描述符中,并为其提供 GPU 地址。
- 应用程序启动 CUDA 核函数,并将网络队列的 GPU 描述符作为输入参数之一进行传递。
为了简化 DOCA Verbs 的部分操作,我们引入了一组 GPUNetIO 高级函数 (例如 doca_gpu_verbs_create_qp_hl) ,以压缩创建和连接 RDMA QP 所需的步骤。这些功能提供 SDK 和开源版本。
控制路径完成后,数据路径可以在 GPU 上启动,其中一个或多个 CUDA 核函数使用 GPUNetIO CUDA 函数来操作导出到 GPU 显存中的传输对象,以发送或接收流量。
GPU 数据路径
用于 GPU 通信的 CUDA 内核的通用结构通常包括以下步骤:
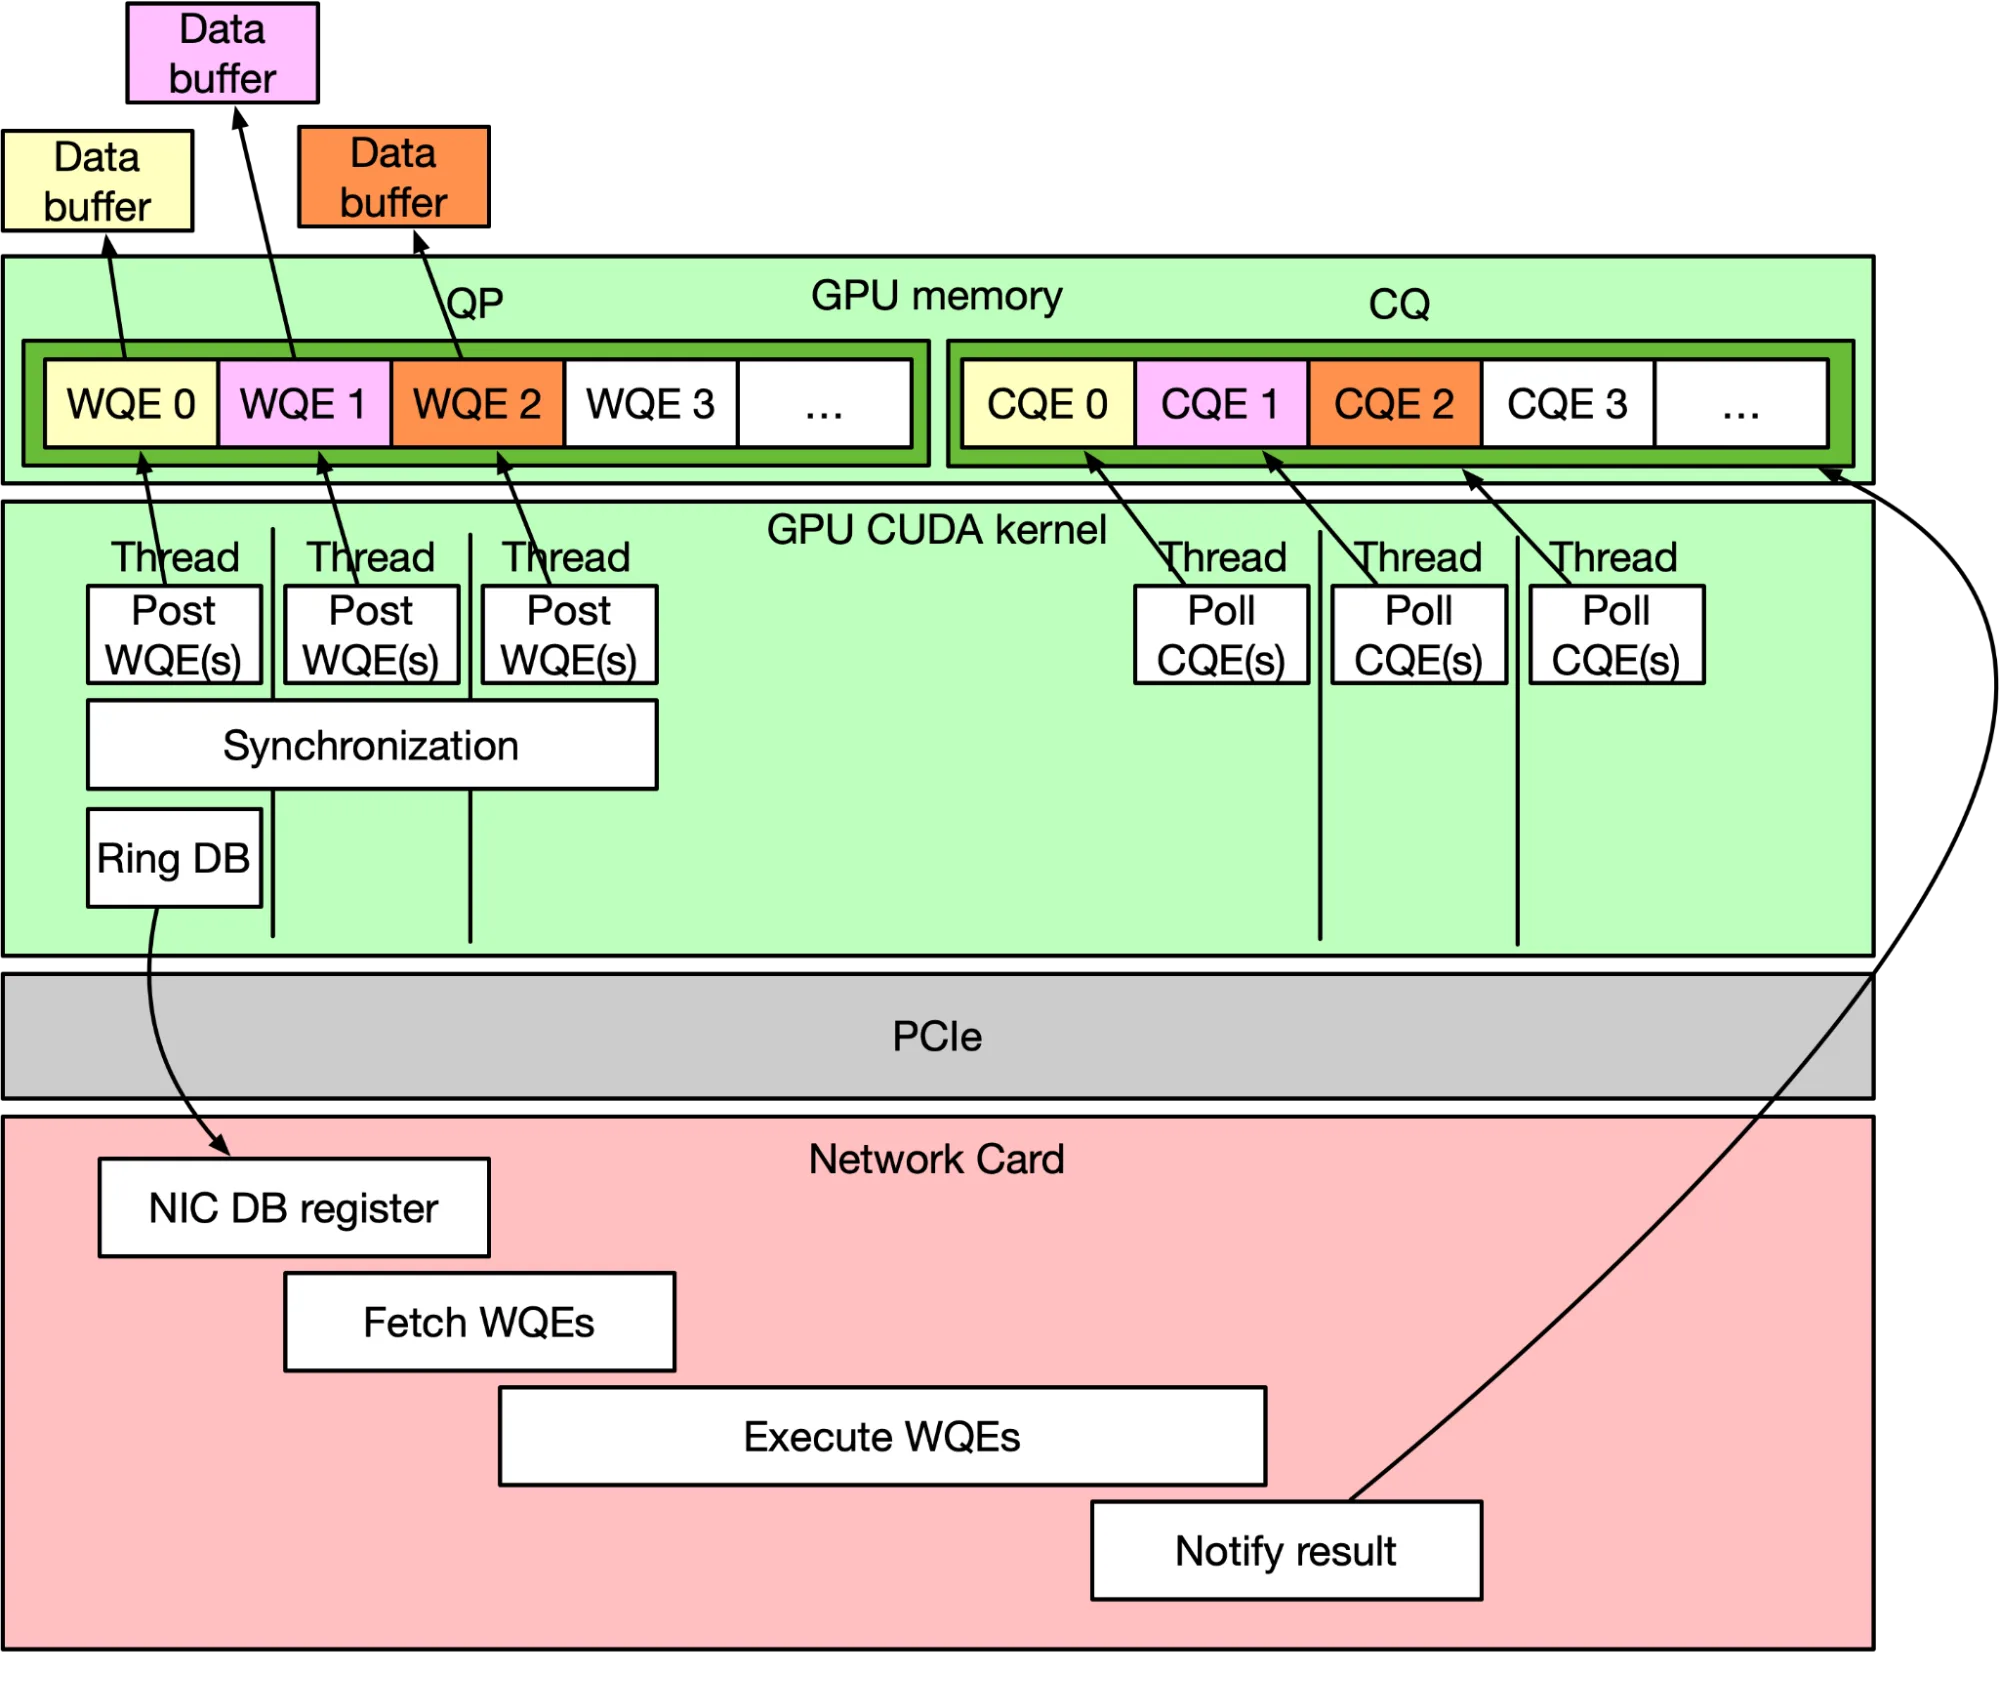
- 发布 WQE:一个或多个 CUDA 线程将工作队列条目 (WQE) (例如 RDMA 写入、RDMA 读取或以太网发送/ Recv) 发布到网络队列对象。
- 按门铃:一个或多个 CUDA 线程通过写入网卡寄存器 (即“按门铃”) 来通知网卡新 WQE 已准备就绪。
- 轮询 CQE (可选) :一个或多个 CUDA 线程等待完成队列条目 (CQE) ,以确认 WQE 已成功完成。
API:高级与低级
对于以太网和 RDMA Verbs 传输,DOCA GPUNetIO 提供了两个不同级别的 API:高级和低级。
高级 API 可实现复杂的复合操作。例如,在 Verbs 方面,doca_gpu_dev_verbs_put_signal() 提供了一个预实现的线程安全组合,将 RDMA Write Work Queue 条目 (WQE) 与 RDMA Atomic Fetch& Add WQE 执行的每线程范围或每线程束范围相结合 (线程束中的所有线程都配合发布 WARP_SIZE RDMA Write 的操作,并且最后只有一个 RDMA Atomic) 。该函数负责处理来自同一网络队列中其他 CUDA 线程的 WQE 并发提交,并按响网卡门铃以避免竞争条件。
同样,在以太网方面,另一个示例是 doca_gpu_dev_eth_txq_send(),它提供了一种线程安全的组合,即在网络队列中发布以太网发送 WQE,然后在线程、线程束或线程块范围内按门铃。这同样适用于接收端。
相比之下,底层 API 提供了基本的构建块,应用程序可以使用它们来创建自己的自定义复合操作,例如发布具有不同操作代码的 WQE、按网卡门铃、轮询完成队列等待完成队列条目 (CQE) 。这些 API 不是线程安全的,因此应用有责任将并发访问 (如果存在) 正确同步到同一网络队列对象。
按门铃
将 WQE 发布到网络队列后,必须通知网卡以便其执行这些 WQE。此步骤称为“按门铃”。在 GPUNetIO 中,此步骤是指 CUDA 内核通知网卡新工作已准备就绪,可供执行。
DOCA GPUNetIO 提供了几种按门铃的方法:
- 常规门铃:这是规范模式,在此模式下,网卡寄存器被 MMIO 映射到 CUDA 内存空间,从而允许 CUDA 线程直接向其写入内容。
- BlueFlame:它遵循与常规门铃相同的通用模型,但在这种情况下,整个 WQE (而不仅仅是通知) 被写入 NIC 寄存器中。BlueFlame 通常用于具有少量网络队列的延迟敏感型应用程序。
- CPU 辅助门铃:在此模式下,NIC 寄存器映射到 CPU 显存而非 GPU 显存。GPU 会将通知写入由 CPU 线程轮询的共享内存区域。一旦 CPU 线程检测到 GPU 更新,它会按响网卡的门铃。此模式主要适用于在没有 GPU 到网卡直接连接的系统 (例如 DGX Spark) 中启用 GDA-KI。
示例
为促进 API 探索和性能基准测试,GPUNetIO 提供了各种参考实现。开发者可以直接在项目库中访问开源示例,而更全面的SDK 示例和基于以太网的专用应用程序则作为完整的 DOCA SDK 的一部分分发。此外,这些示例已集成到GitHub中,以便在近期发布的版本中更轻松地访问。
以下各节将重点介绍特定的代码片段,以说明如何利用高级和低级基元来使用不同的编程语义实现类似逻辑。
以太网示例
GPU 启动的以太网数据包生成器可使用高级 API (如以下代码段所示) 实现。具体而言,高级函数 doca_gpu_dev_eth_txq_send 有助于将跨多个 CUDA 块的 WQE 并发提交至共享的“发送队列”,从而在内部处理必要的同步,确保线程安全运行,而无需自定义应用级锁。此外,它还抽象化了队列结构的精细管理,例如跟踪 WQE 和 CQE 的特定指数。
__global__ void send_packets(struct doca_gpu_eth_txq *txq, uint8_t *addr, const uint32_t mkey, const size_t size, uint32_t *exit_cond)
{
	enum doca_gpu_eth_send_flags flags = DOCA_GPUNETIO_ETH_SEND_FLAG_NONE;
	doca_gpu_dev_eth_ticket_t out_ticket;
	uint32_t num_completed = 0;

	/* Only the last thread in the block requests a CQE. */
	if (threadIdx.x == (blockDim.x - 1))
		flags = DOCA_GPUNETIO_ETH_SEND_FLAG_NOTIFY;

	while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
		doca_gpu_dev_eth_txq_send<DOCA_GPUNETIO_ETH_RESOURCE_SHARING_MODE_GPU,
				  DOCA_GPUNETIO_ETH_SYNC_SCOPE_GPU,
				  DOCA_GPUNETIO_ETH_NIC_HANDLER_AUTO,
				  DOCA_GPUNETIO_ETH_EXEC_SCOPE_BLOCK>(txq, addr, mkey, size, flags, &out_ticket);

		/* __syncthreads already present in send with BLOCK scope */

		if (threadIdx.x == 0)
			doca_gpu_dev_eth_txq_poll_completion<DOCA_GPUNETIO_ETH_CQ_POLL_LAST>(txq, 1, DOCA_GPUNETIO_ETH_WAIT_FLAG_B, &num_completed);

		__syncthreads();
	}
}
应用还可以利用低级基元来实现对其实现的精确控制。例如,如果数据包生成器恰好为每个 CUDA 块分配一个“发送队列”,则高级 doca_gpu_dev_eth_txq_send 的内部同步用度将不再需要。在这种情况下,可以使用以下模式简化逻辑:
__global__ void send_packets(struct doca_gpu_eth_txq *txq, uint8_t *start_addr, const uint32_t mkey, const size_t size, uint32_t *exit_cond)
{
	uint64_t wqe_idx = threadIdx.x, cqe_idx = 0;
	enum doca_gpu_eth_send_flags flags = DOCA_GPUNETIO_ETH_SEND_FLAG_NONE;
	struct doca_gpu_dev_eth_txq_wqe *wqe_ptr;
	/* For simplicity, every thread always sends the same buffer */
	uint64_t addr = ((uint64_t)start_addr) + (uint64_t)(size * threadIdx.x);

	if (threadIdx.x == (blockDim.x - 1))
		flags = DOCA_GPUNETIO_ETH_SEND_FLAG_NOTIFY;

	while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
		wqe_ptr = doca_gpu_dev_eth_txq_get_wqe_ptr(txq, wqe_idx);
		doca_gpu_dev_eth_txq_wqe_prepare_send(txq, wqe_ptr, wqe_idx, addr, mkey, size, flags);
		__syncthreads();

		if (threadIdx.x == (blockDim.x - 1)) {
			/* Ring network card doorbell */
			doca_gpu_dev_eth_txq_submit(txq, wqe_idx + 1);

			/* Poll for last send completion */
doca_gpu_dev_eth_txq_poll_completion_at<DOCA_GPUNETIO_ETH_RESOURCE_SHARING_MODE_GPU, DOCA_GPUNETIO_ETH_SYNC_SCOPE_CTA>(txq, cqe_idx, DOCA_GPUNETIO_ETH_WAIT_FLAG_B);
			cqe_idx++;
		}

		__syncthreads();
		wqe_idx += blockDim.x;
	}
动词示例
GPUNetIO Verbs API 遵循类似的范式。例如,开发者可以利用高级基元来实现面向性能的应用程序,该应用程序使用 GPU 驱动的通信,通过以下 put 功能复制 ib_write_bw 的逻辑:
template <enum doca_gpu_dev_verbs_exec_scope scope>
__global__ void put_bw(struct doca_gpu_dev_verbs_qp *qp, uint32_t num_iters, uint32_t data_size, uint8_t *src_buf, uint32_t src_buf_mkey, uint8_t *dst_buf, uint32_t dst_buf_mkey) {
	doca_gpu_dev_verbs_ticket_t out_ticket;
	uint32_t lane_idx = doca_gpu_dev_verbs_get_lane_id();
	uint32_t tidx = threadIdx.x + (blockIdx.x * blockDim.x);

	for (uint32_t idx = blockIdx.x * blockDim.x + threadIdx.x; idx < num_iters; idx += (blockDim.x * gridDim.x)) {
		doca_gpu_dev_verbs_put<DOCA_GPUNETIO_VERBS_RESOURCE_SHARING_MODE_GPU, DOCA_GPUNETIO_VERBS_NIC_HANDLER_AUTO, scope>(qp,
doca_gpu_dev_verbs_addr{.addr = (uint64_t)(dst_buf + (data_size * tidx)), .key = (uint32_t)dst_buf_mkey},
doca_gpu_dev_verbs_addr{.addr = (uint64_t)(src_buf + (data_size * tidx)), .key = (uint32_t)src_buf_mkey},
data_size, &out_ticket);

		__syncthreads();
	}
}
应用还可以利用低级基元来实现对其实现的精确控制,例如创建 CUDA 特定块的带宽测试,手动管理每个单独的操作:
global void write_bw(struct doca_gpu_dev_verbs_qp *qp, uint32_t num_iters, uint32_t size, uint8_t *src_buf, uint32_t src_buf_mkey, uint8_t *dst_buf, uint32_t dst_buf_mkey) {
	uint64_t wqe_idx;
	struct doca_gpu_dev_verbs_wqe *wqe_ptr;

	for (uint32_t idx = threadIdx.x; idx < num_iters; idx += blockDim.x) {
		wqe_idx = doca_gpu_dev_verbs_reserve_wq_slots(qp, 1);
		wqe_ptr = doca_gpu_dev_verbs_get_wqe_ptr(qp, wqe_idx);

		doca_gpu_dev_verbs_wqe_prepare_write(qp, wqe_ptr, wqe_idx, MLX5_OPCODE_RDMA_WRITE, DOCA_GPUNETIO_MLX5_WQE_CTRL_CQ_UPDATE, 0,
			(uint64_t)(dst_buf + (size * threadIdx.x)), dst_buf_mkey,
			(uint64_t)(src_buf + (size * threadIdx.x)), src_buf_mkey, size);
		__syncthreads();

		if (threadIdx.x == (blockDim.x - 1))
			doca_gpu_dev_verbs_submit<DOCA_GPUNETIO_VERBS_RESOURCE_SHARING_MODE_EXCLUSIVE>(qp, (wqe_idx + 1));
		__syncthreads();

		wqe_idx += blockDim.x;
	}

	if (threadIdx.x == (blockDim.x - 1))
		doca_gpu_dev_verbs_poll_cq_at(doca_gpu_dev_verbs_qp_get_cq_sq(qp), (wqe_idx - blockDim.x));

	__syncthreads();
}
适用于 GIN 的 NCCL 设备 API
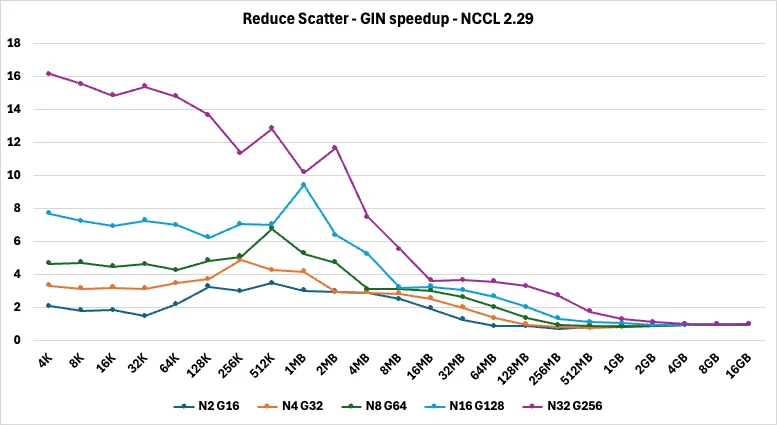
NCCL GIN (GPU-Initiated Networking) 为 CUDA 核函数提供设备端通信抽象层,可公开 put、get、signal、wait 和 flush 等基元。自 NCCL 2.27 起,GIN 已将 GDA-KI 集成为利用开源 GPUNetIO Verbs 路径的后端。该架构使 NCCL 算法和设备 API 应用能够直接从 GPU 驱动 RDMA 操作,同时抽象出 GIN 接口下的低级队列管理和工作提交复杂性。
该工作流始于 CPU 在通信器初始化期间执行控制路径,在此过程中,CPU 会处理 RDMA 队列对创建、内存注册以及将传输描述符导出到 GPU 内存的操作。配置完成后,数据路径将完全转移到 GPU。GIN 运算被映射到 GPUNetIO Verbs 调用中,用于管理 WQE 准备、门铃铃声和完成轮询。此模型成功地将 CPU 从每个网络事务的应用程序关键路径中移除。
通过将通信语义与传输实现解,NCCL 专注于集合算法,而 GPUNetIO 则提供强化的 GDA-KI 管道。NCCL 利用 GIN 级控制来管理线程、CTA 或 GPU 范围内的资源共享,从而实现请求聚合和优化的队列管理。这些功能符合 GPUNetIO 的优势,可促进低延迟和高吞吐量路径,而不会分散 RDMA 实施。最终,GPUNetIO 可作为共享基础,您只需开发一次性能增强功能和 NIC 支持,即可在整个 GPU 通信生态系统中加以利用。
要探索 NCCL 测试 GitHub 资源库 以获取参考代码。
NVSHMEM
NVSHMEM 是一种基于 PGAS 的编程模型,可在 GPU 集群中提供可扩展的点对点和集合通信基元,例如推算、获取、原子、屏障和归约。它使多 GPU 应用程序能够在 CUDA 内核中实现细粒度的 GPU 到 GPU 数据移动和同步,从而在应用程序工作负载的强扩展方面获得显著收益。
对于网络通信,NVSHMEM 根据可用的网络能力和应用要求提供多种传输。NVSHMEM 提供 IBGDA 传输,使用 MLX5 直接动词实现 GDA-KI。
随着开源 GPUNetIO 库的发布,NVSHMEM 3.7 引入了基于 GPUNetIO 的新传输。通过在此通用实现层上构建,NVSHMEM 受益于 DOCA SDK 提供的 GPUNetIO 优化和高级 NIC 功能。新的 GPUNetIO 传输通过 RDMA 支持 GDA-KI 通信和主机发起通信 (即 CPU 通信) (在第二种情况下,GPUNetIO 仅在控制路径上用于配置网络元素,而数据路径通过 NVSHMEM 原生函数在 CPU 上执行) 。用户可以通过设置 NVSHMEM_REMOTE_TRANSPORT=gpunetio 并使用 NVSHMEM_GPUNETIO_ENABLE_GDAKI=1 启用 GDA-KI 来选择 GPUNetIO 传输。
NVSHMEM 中 GPUNetIO 传输的 GDA-KI 部分遵循 IBGDA 传输的结构,但会用对 GPUNetIO 库的调用替换较大的低级代码部分。例如,如上面的“按门铃”部分所述,门铃结构和按铃代码已完全外部化到 GPUNetIO 库中。GPUNetIO 传输虽然实现了与 IBGDA 相同的功能和性能,但显著降低了传输实现的复杂性,展示了整合 GDA-KI 实现的通用功能的价值。
根据通信模式,启用 GDA-KI 可以显著提高小消息的可实现带宽。以下实验使用 NVSHMEM 性能测试套件的 shmem_put_bw 基准测试,使用具有不同消息大小的 nvshmem_double_put_nbi。该实验每个 CTA (协作线程阵列) 使用 1 个线程和 1 个 QP,同时 CTA 数量也在不断增加。以下两幅图显示了 GPUNetIO 传输实现的带宽,第一幅图显示了禁用 GDA-KI (即使用 CPU 通信) 时的结果,而第二幅图显示了使用 GDA-KI 时的结果。
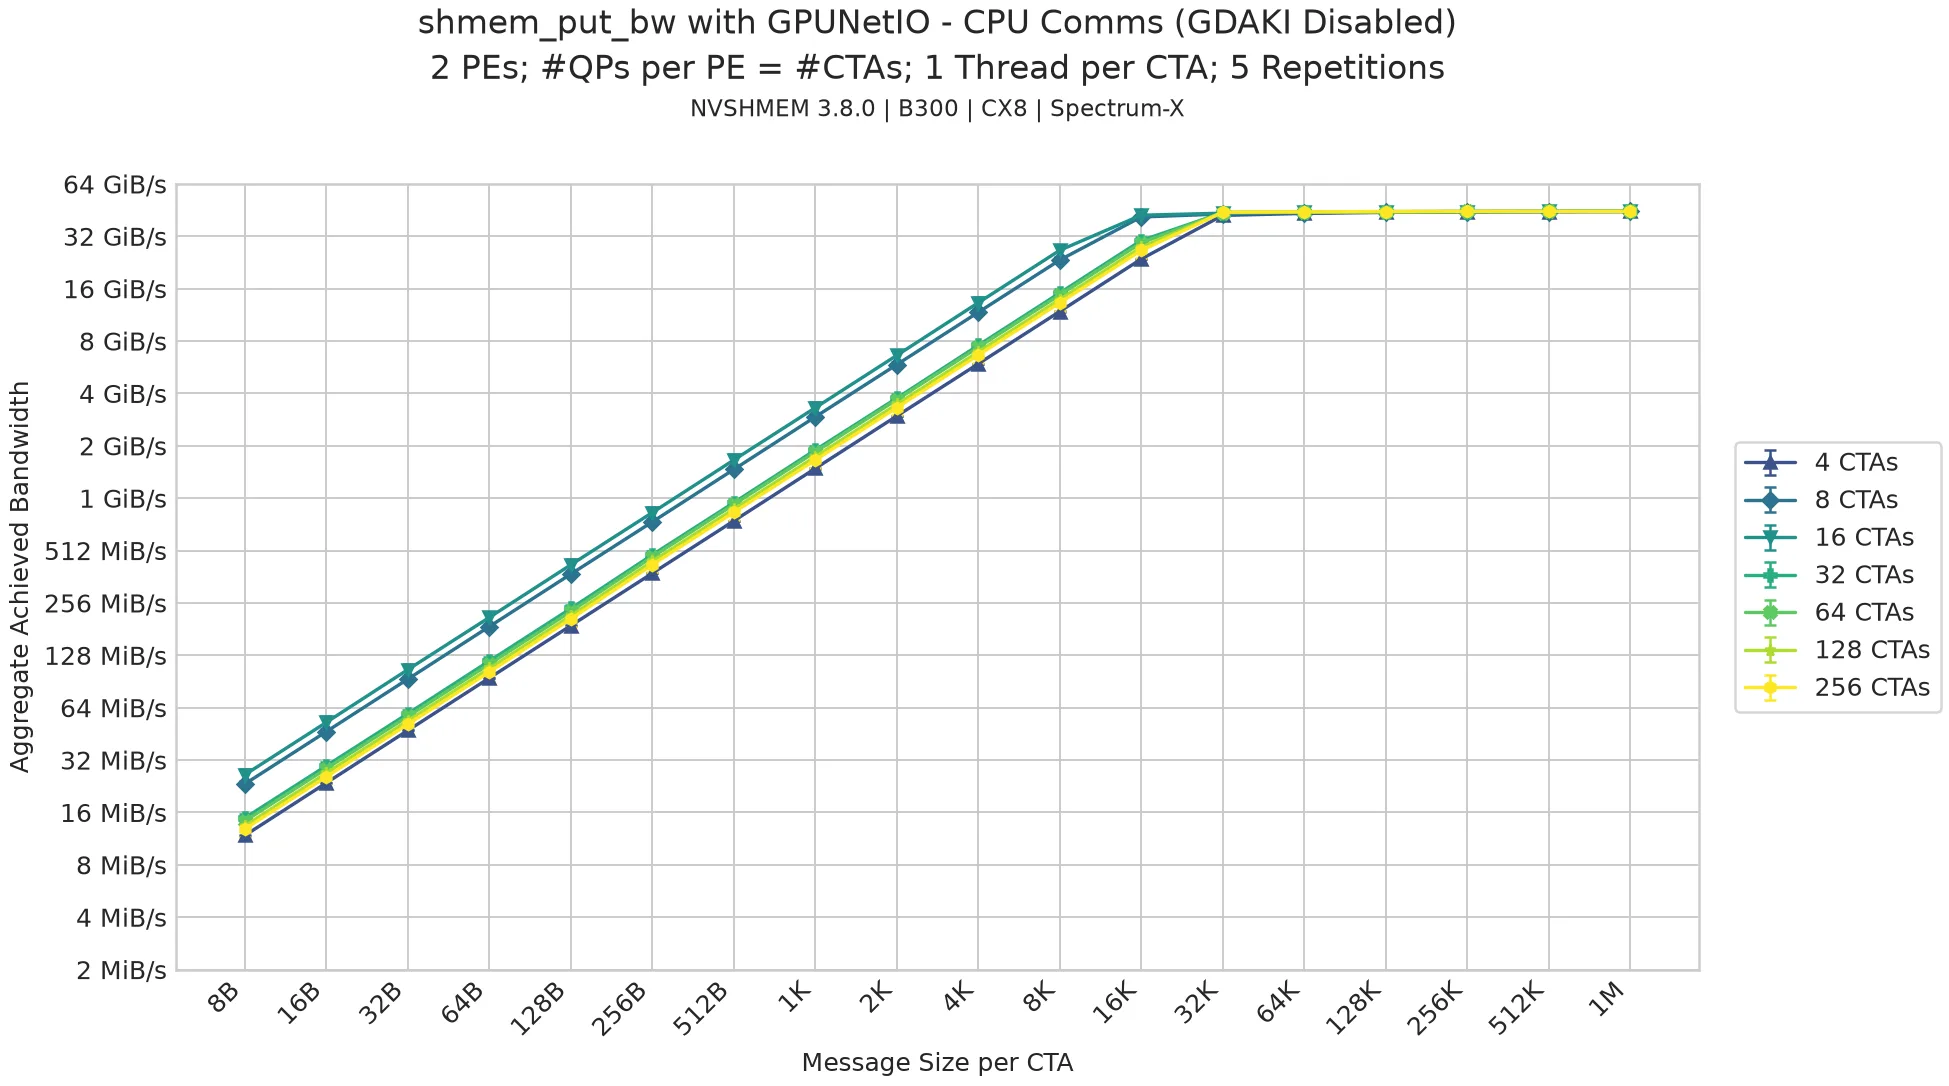
如图 5 所示,当 NVSHMEM 使用 CPU 通信时 (控制 CPU 路径配置了 GPUNetIO 功能,而 CPU 数据路径是 NVSHMEM 原生的) ,由于 CPU 代理瓶颈,在扩展到更多 CTA 和 QP 时,针对较小的消息大小限制带宽。在图 6 中,启用 GDA-KI 功能 ( GPU 使用 GPUNetIO CUDA 函数执行的数据路径) 的 GPUNetIO 后端执行相同的基准测试。
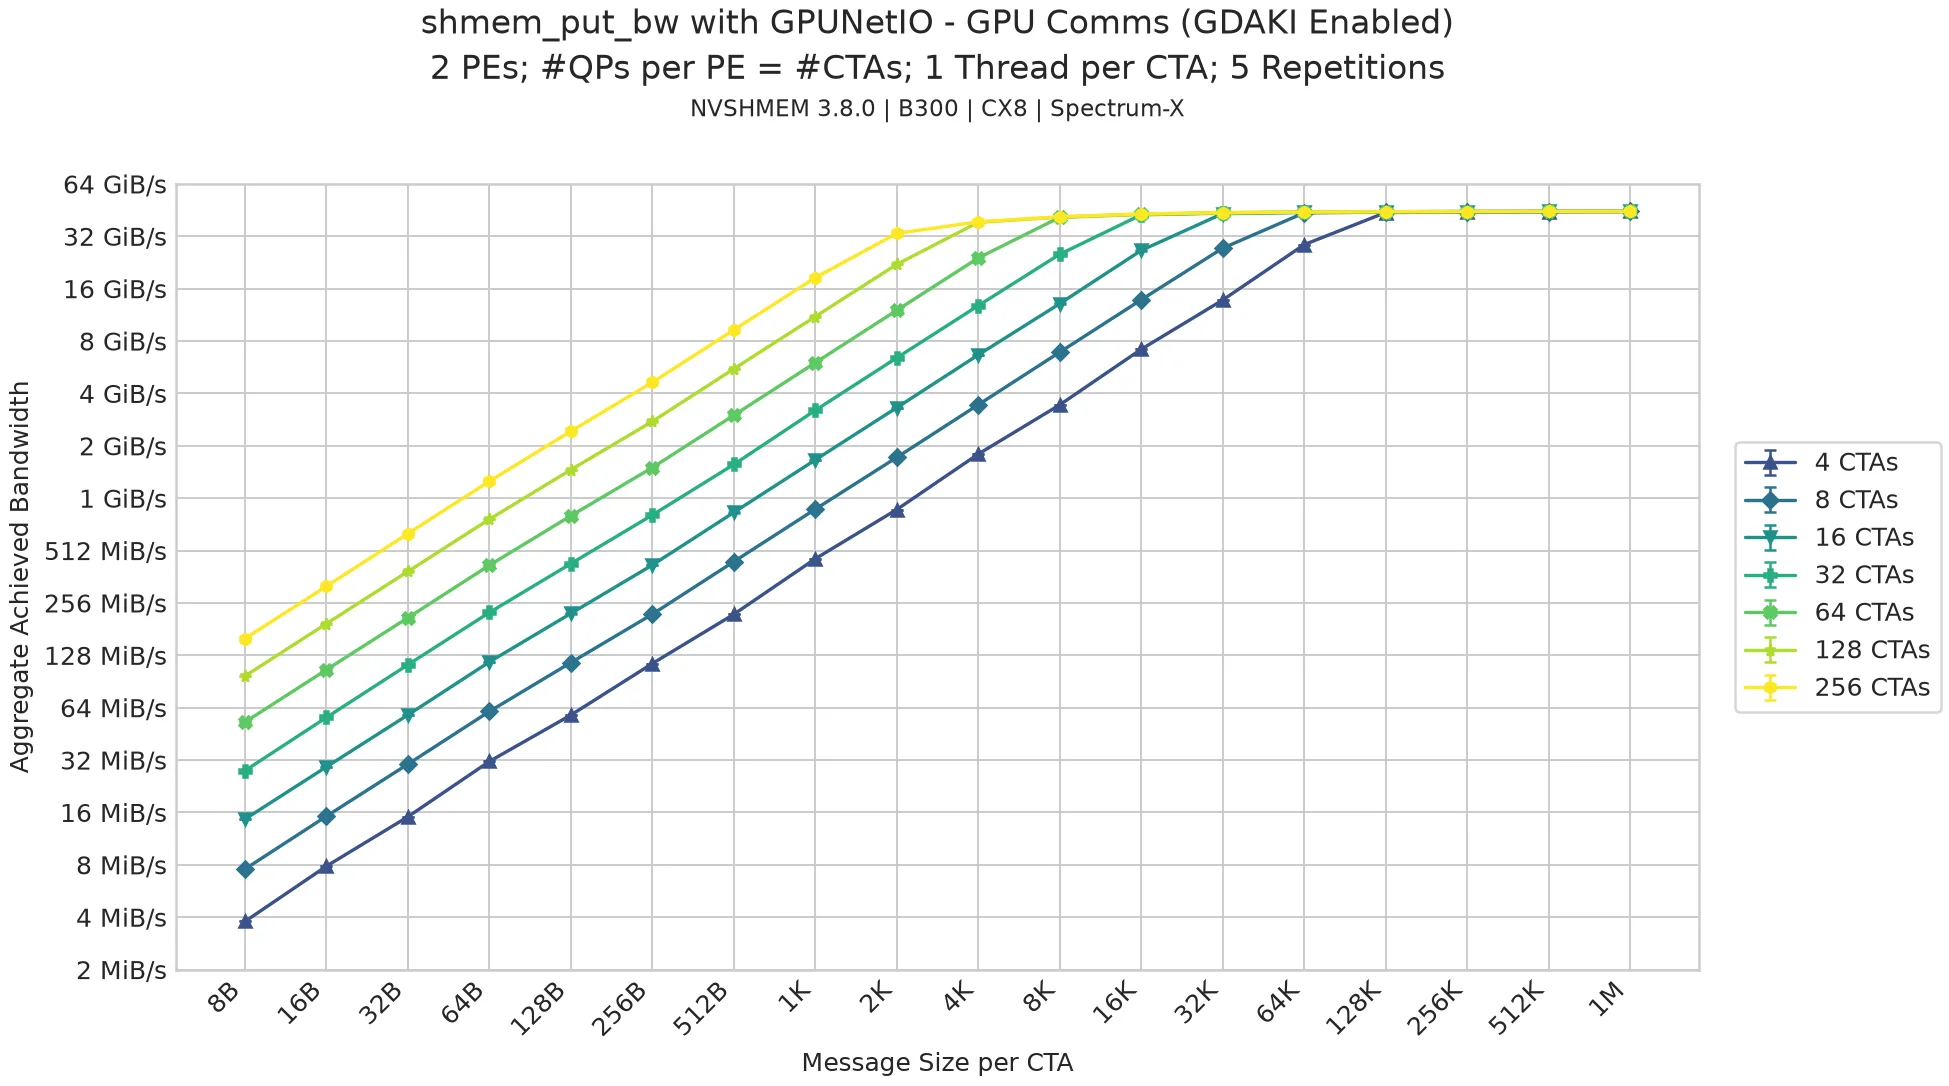
实验确认,使用 GDA-KI 时,消除了代理瓶颈后,CTA 和 QP 扩展行为会更好。与非 GDA-KI 版本相比,GDA-KI 版本可以在消息大小较小的情况下达到更高的峰值带宽,并且在消息大小方面更早实现峰值带宽。之前的实验比较了 IBRC 和 IBGDA 的带宽性能,也得出了类似的结果。
总体而言,GPUNetIO 保留了 IBGDA 和 IBDEVX 的功能和性能,同时大幅降低了 NVSHMEM 的实现复杂性和维护成本。
NVQLink
NVIDIA NVQLink 是 NVIDIA 的低延迟参考架构,用于将量子处理器控制系统连接到 GPU 计算,通过与 NVIDIA CUDA-Q 紧密集成,实现量子纠错 (QEC) 、前馈和自适应校准等实时量子经典工作流程。Holoscan Sensor Bridge (HSB) 通过使用 RoCE 和轻量级 FPGA IP 以及主机侧控制软件,为这种方法提供网络基础,而 NVQLink 则将基于 HSB 的模型推向更低延迟的状态,适合实时 QPU 控制,而不是传统的传感器摄取工作流。
NVQLink 使用的 HSB 网络运算符称为 GPU RoCE Transceiver。它基于 DOCA GPUNetIO 和 DOCA Verbs 库构建,旨在尽可能降低流量转发延迟。在 Standalone 模式下,Operator 为网络完整性检查和性能分析提供了流量转发执行路径。
Operator 启动一个持久的 CUDA 内核,该内核使用 DOCA GPUNetIO CUDA 函数持续接收来自远程对端的数据包,并将其发送回来,而无需任何 CPU 干预。在此设置中,远程对等端是一个 FPGA,用于测量数据包被传输到被接收回之间的耗时。
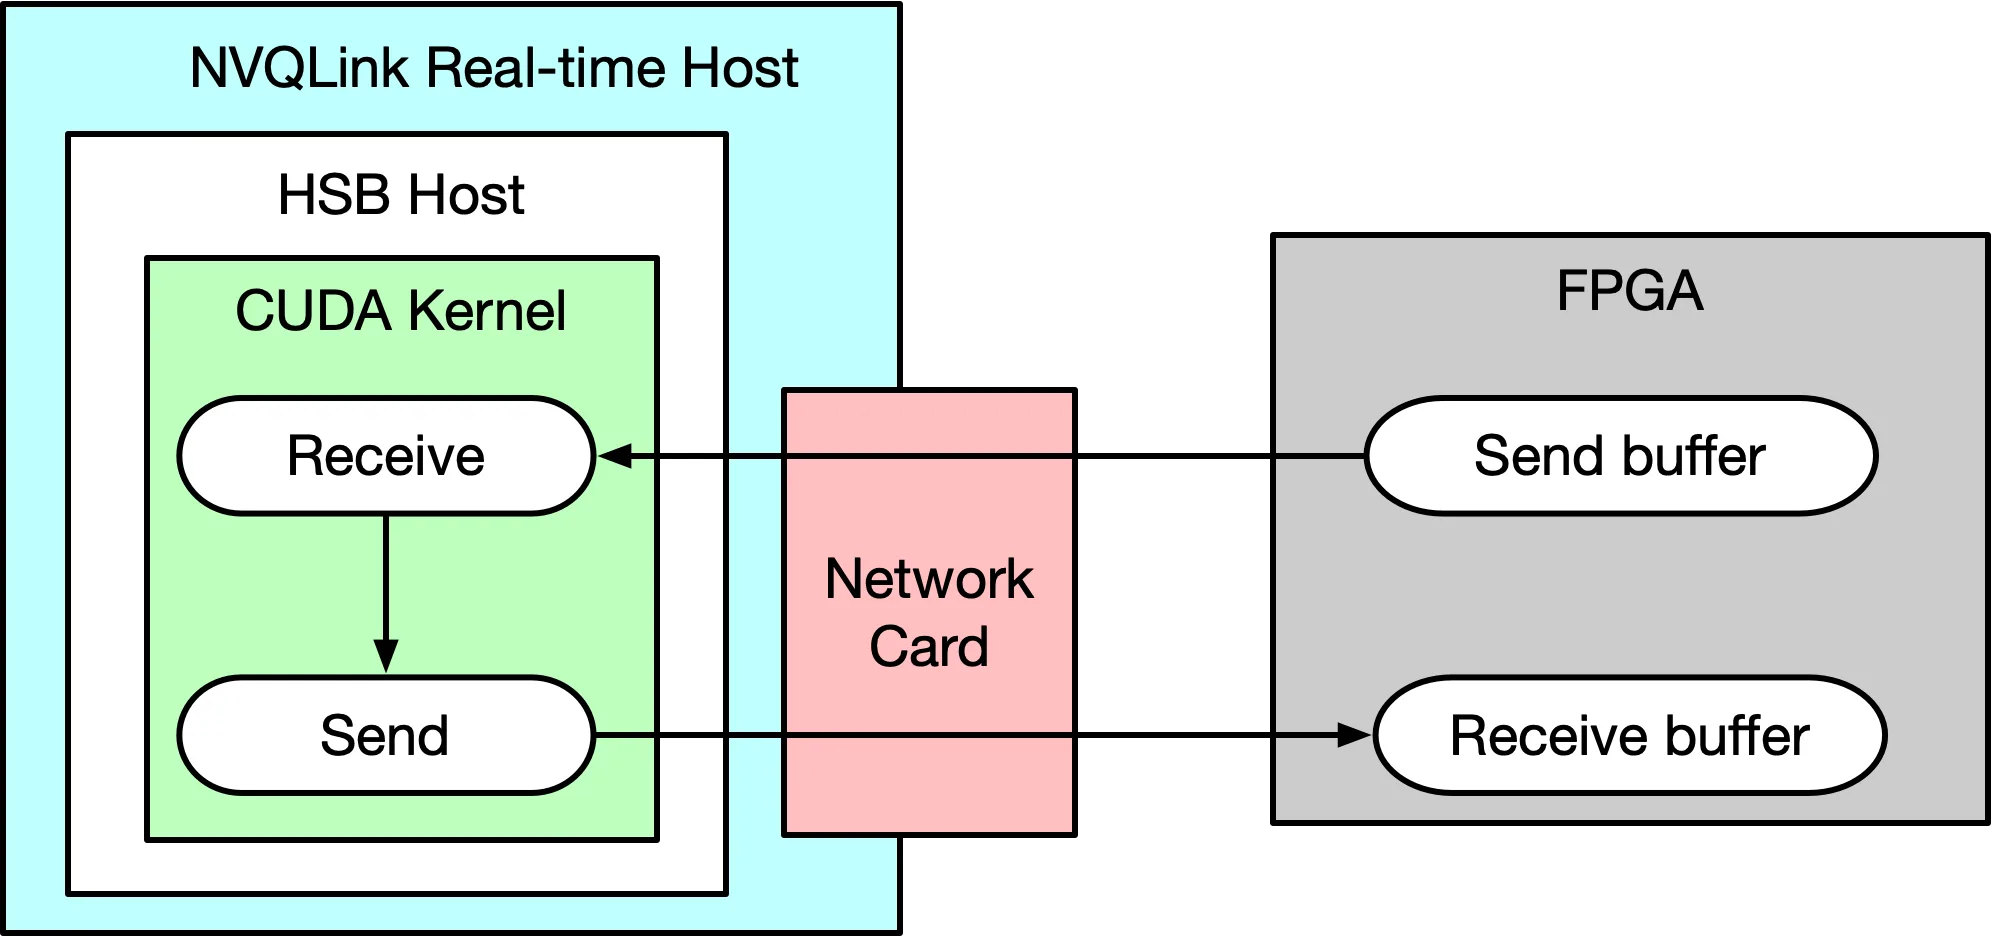
为了测量 HSB 2.7.0 GPU RoCE Transceiver Operator 的网络转发延迟,我们使用了一个配备 Blackwell GPU 和 ConnectX-7 网卡的 NVIDIA IGX Thor 平台。
另一方面,通过 OSFP 线缆背对背连接,我们使用 Xilinx RFSoC 4 × 2 板上的 FPGA 来发送、接收和测量往返延迟。
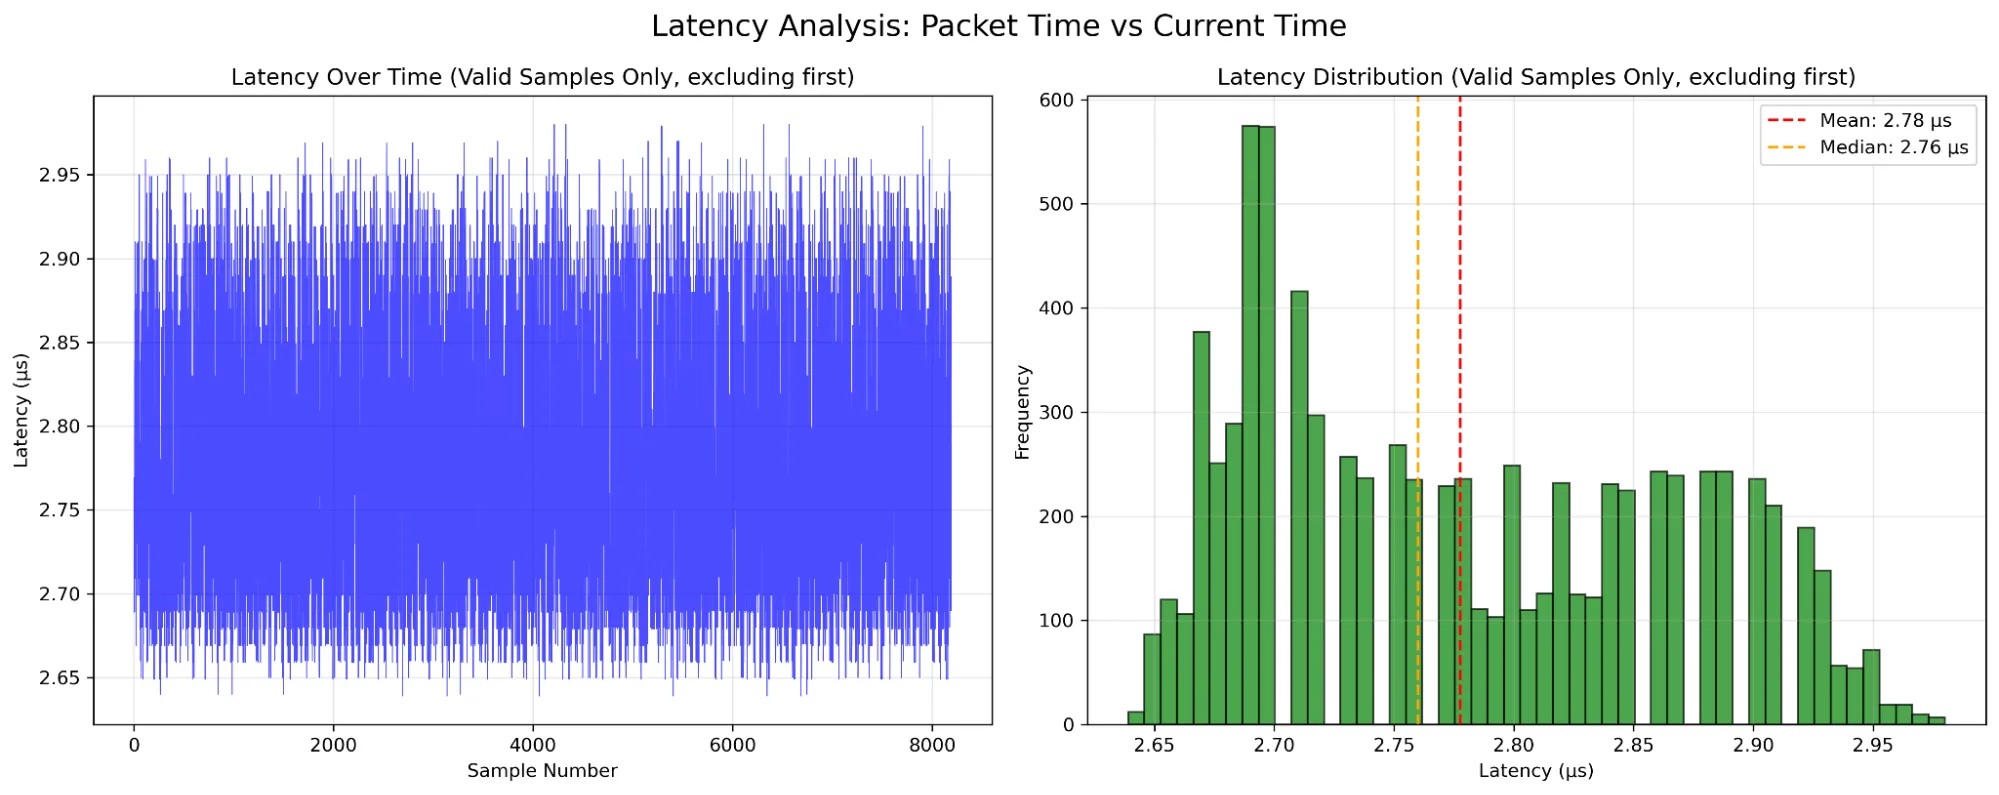
报告的最低延迟 (以 FPGA 的数据包传输和接收之间的时间测量) 约为 2.6 微秒,而中间延迟为 2.7 微秒。
开始使用 DOCA GPUNetIO
- DOCA SDK GPUNetIO 编程指南 – 完整的 SDK 文档
- 开源 GPUNetIO 资源库 – 示例和开源实现
- GitHub 上的 DOCA SDK 示例 — 参考实现
- NCCL 测试 – GIN 设备 API – GIN 参考代码
- Holoscan Sensor Bridge GPU RoCE 收发器 – NVQLink Operator


