
原子模拟可帮助研究人员了解分子和材料的行为方式,包括化学反应、相变和机械故障。这些模拟需要在成本准确性方面进行权衡。密度泛函理论 (DFT) 等量子力学方法可以提供准确的能量和作用力,但其计算成本往往会限制其在大型系统或长时间模拟中的应用。经典原子间相互作用势的速度要快得多,但其固定的泛函形式限制了在不同原子环境中的准确性和通用性。机器学习原子间相互作用势 (MLIP) 有助于弥合这一差距。他们使用神经网络来预测潜在能量和原子间相互作用,而成本仅为后者的一小部分,使研究人员能够研究更大的系统和更长的时间尺度,同时保持大部分所需的准确性。
然而,高效运行 MLIP 本身也存在挑战。原子模拟对可能随时间累积的小误差很敏感,在计算力时最明显,而计算力是通过差分预测能量获得的。在分子动力学模拟期间,这些作用力会引导多个时间步长中的原子速度和位置更新,这使得数值精度不仅对物理精度很重要,而且对最终轨迹的稳定性也很重要。
因此,许多 MLIP 继续在 FP32 中运行推理,尽管现代 NVIDIA GPU 通过低精度 Tensor Core 运算提供了更高的矩阵乘法吞吐量。用于 FP32 矩阵乘法的 Tensor Core 方法提供了一种缩小这一差距的方法。它们会将每个 FP32 操作数分解为精度较低的组件,在 Tensor Core 上评估其交积,并在 FP32 中重新组合结果。这种方法可以提高矩阵乘法吞吐量,同时保持接近原生 FP32 的准确性,而无需重新训练或改变模型的权重或架构。
在本文中,我们将评估 Tensor Core FP32 方法在 Point Edge Transformer (PET) (由 EPFL 的 Lab COSMO 开发的基于 Transformer 的 MLIP) 上的实际表现。PET 将大部分运行时间用于高度优化的通用矩阵乘法 (GEMM) ,为进一步优化留下的空间有限,这使得 PET 成为了一个要求苛刻的测试用例,用于判断这些方法能否带来额外的性能提升。
我们对 NVIDIA Blackwell GPU 上的 BF16x9 和 NVIDIA Ampere GPU 上的 TF32x3 进行了评估,比较了内核和端到端分子动力学性能以及轨迹级行为。我们进一步测试了 TF32x3 方法的势能平滑度、节能和结构松。我们展示了这些方法如何在保持接近 FP32 基准的行为的同时加速 MLIP 推理,并概述了如何在其他精度敏感型科学机器学习工作负载上评估这些方法。
Tensor Core FP32 如何缩小硬件差距
现代 NVIDIA GPU 可为 BF16 和 TF32 提供远高于 FP32 矩阵乘法的 Tensor Core 吞吐量,从而在较低精度下的可用吞吐量与许多科学工作负载的精度要求之间造成差距。Tensor Core FP32 方法通过将 FP32 操作数分解为较低精度的组件、在 Tensor Core 上评估选定的乘积,并将其与 FP32 累加重新组合,有助于缩小这一差距。根据方法和工作负载的不同,这可以提供达到或接近原生 FP32 的准确性,同时利用更高的 Tensor Core 吞吐量。
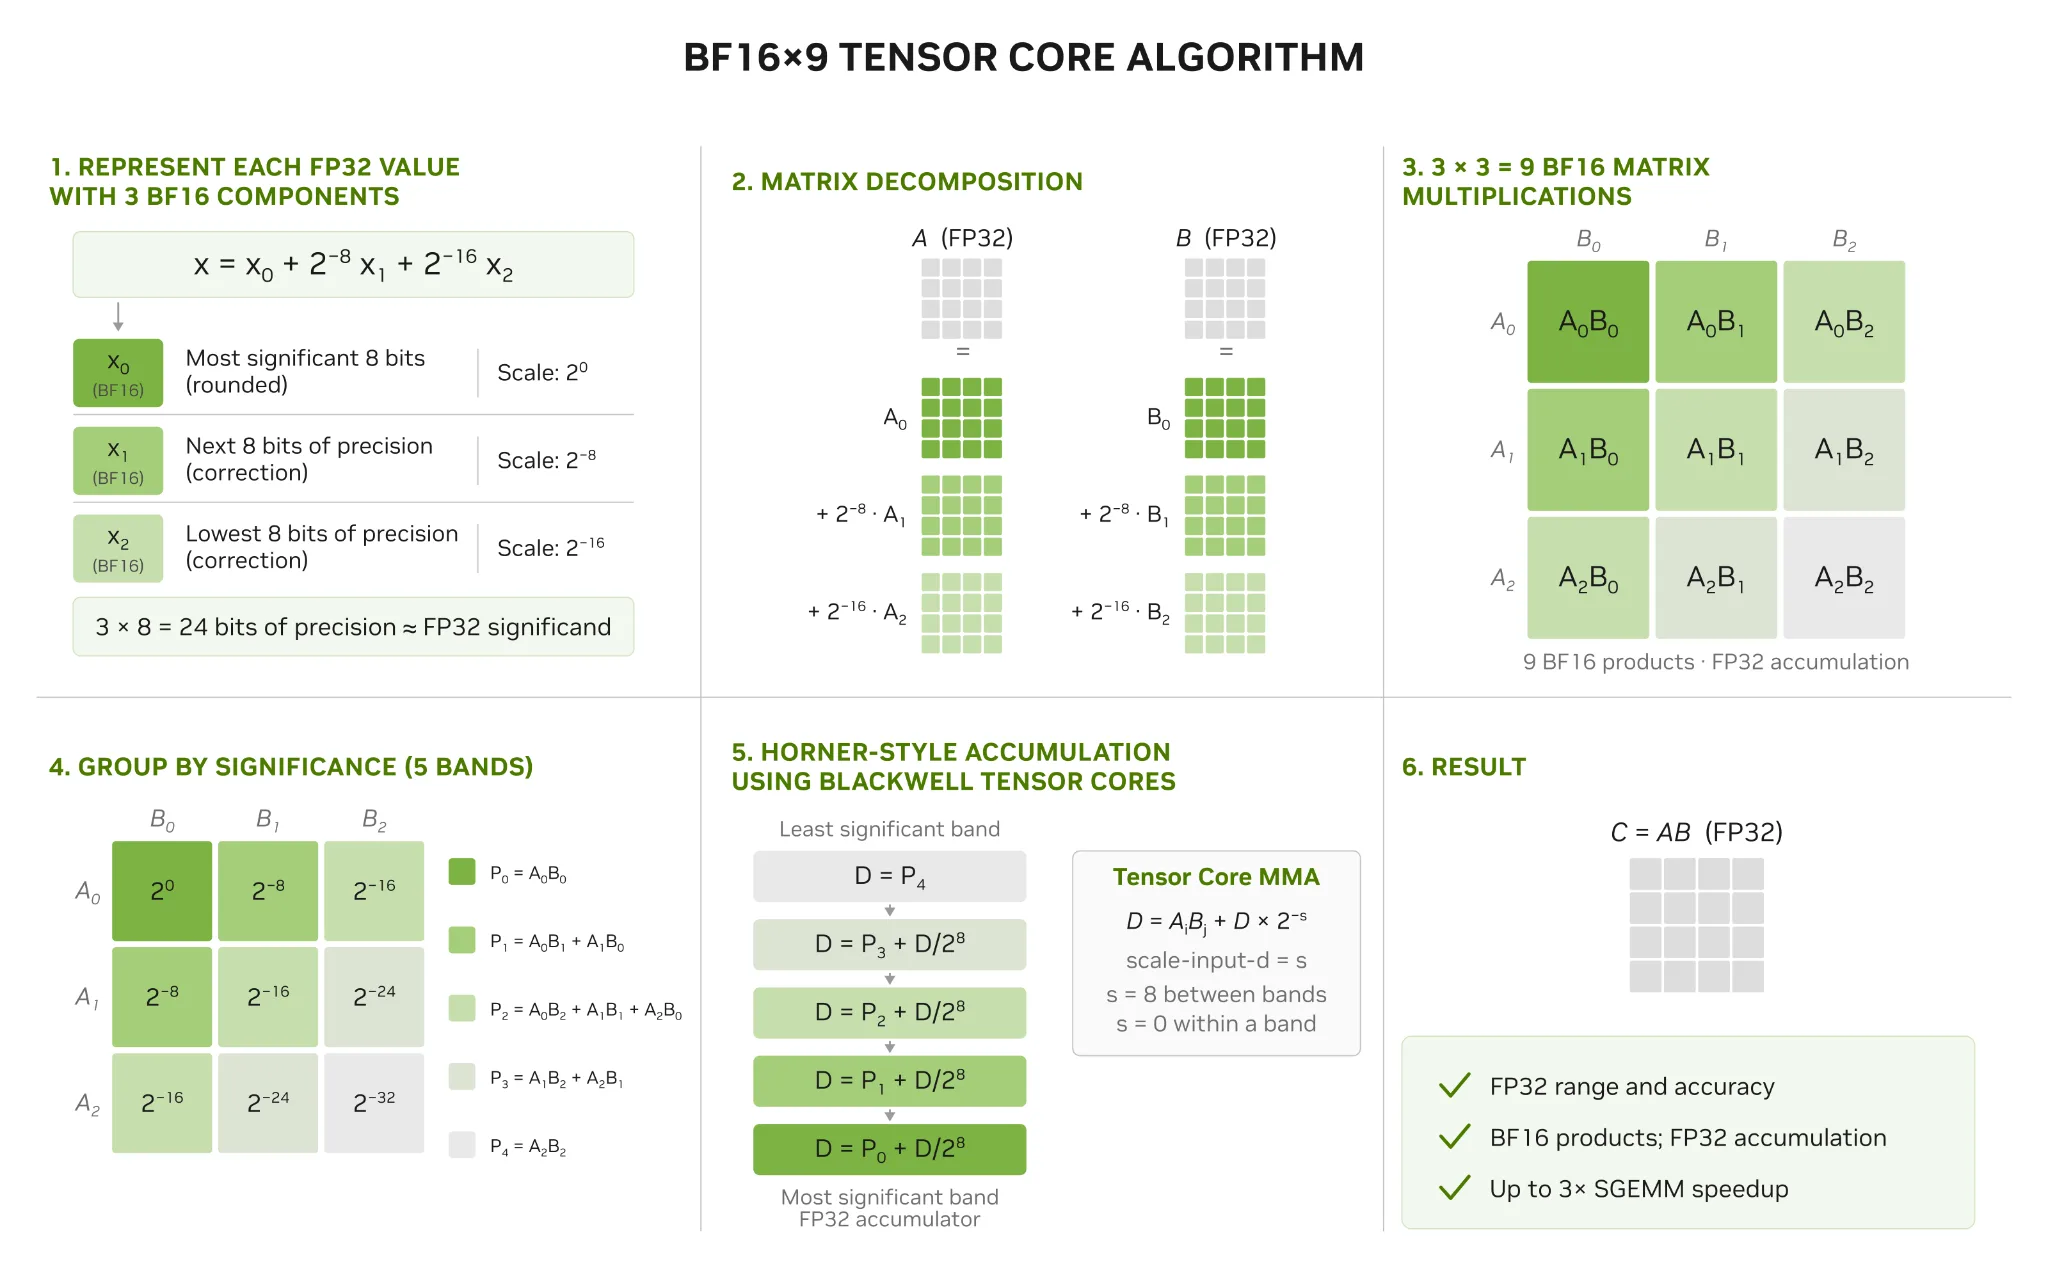
在 Blackwell GPU 上,NVIDIA cuBLAS 提供了 BF16x9 Tensor Core 路径 (图 1) 。每个 FP32 操作数被分解成三个 BF16 分量,并通过所需的缩放重新组合九个成对积。cuBLAS 可以通过 CUBLAS_EMULATE_SINGLE_PRECISION=1 环境变量启用此路径,因此兼容的 PyTorch GEMM 可以使用它,而无需更改模型架构或实现自定义 GEMM。
由于这种方法改变了评估 GEMM 的方式,因此在与优化的图形构建、融合运算、自定义内核和 NVIDIA CUDA 图形相结合时,可能会带来额外的收益。在此评估中,我们没有衡量综合收益;应为每个工作负载建立端到端收益。
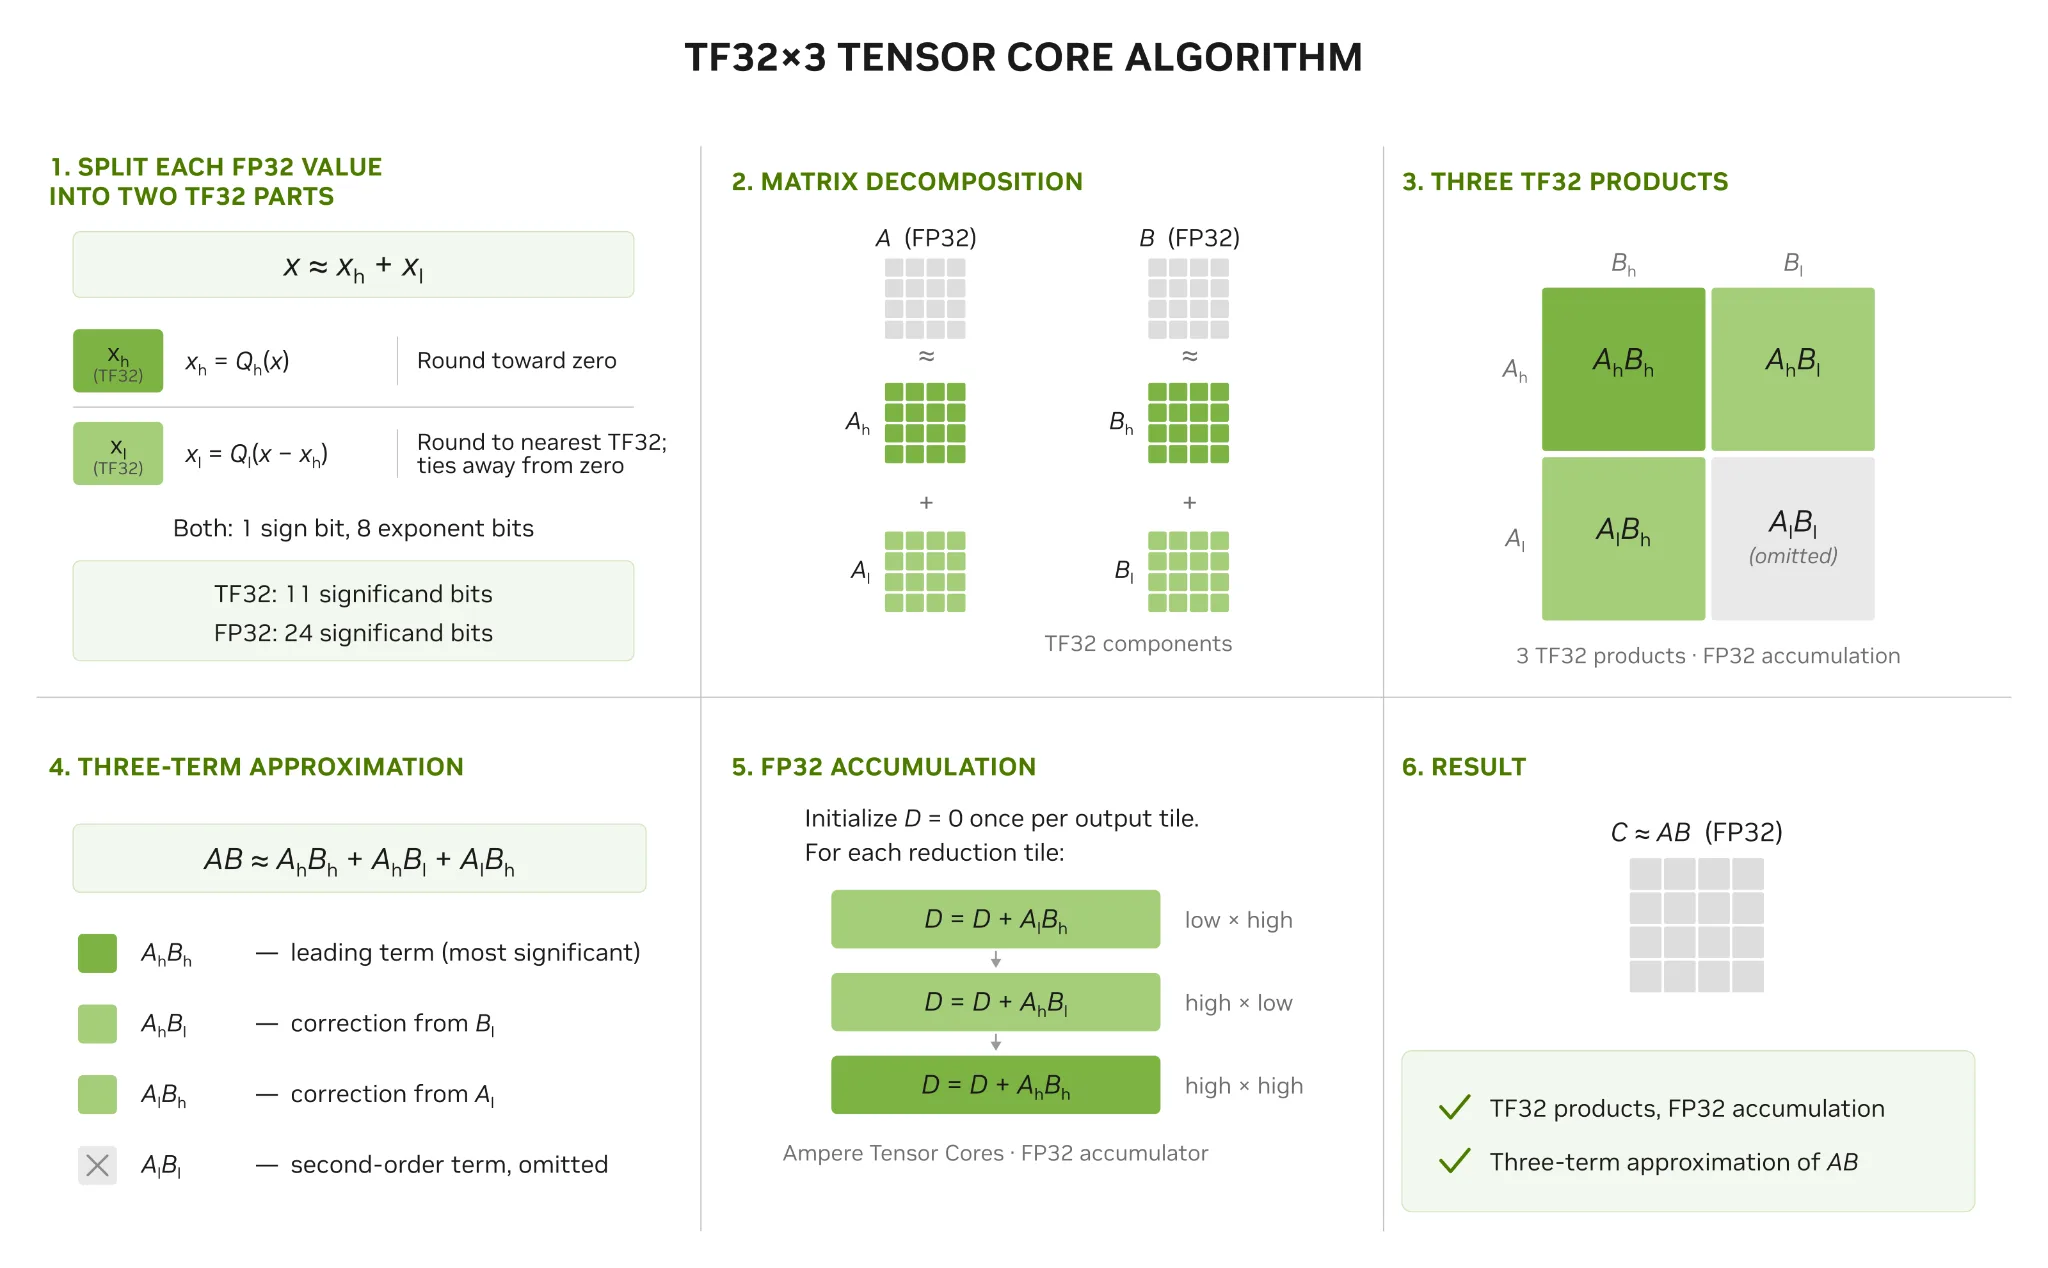
TF32x3 方法在 Ampere GPU 上应用了相同的原理 (图 2) 。TF32x3 使用前导 TF32 组件和残差 TF32 组件表示每个 FP32 操作数。与 BF16x9 不同,我们的 TF32x3 实现不使用缩放系数。该方法会计算三个交叉乘积,并省略残差 – 残差项,如下方程所示
NVIDIA CUTLASS 通过 OpMultiplyAddFastF32 运算符提供这种方法。输入和输出仍采用 FP32。Tensor Core 执行三个 TF32 乘积,并以 FP32 进行累加。
在 PET 上对 Tensor Core FP32 矩阵数学运算进行基准测试
我们在一个 192 原子水盒和一个 17280 原子超级单元上评估了 26M 参数的 PET-MAD 小型检查点 (pet-mad-s-v1.6.0-nn-32) 。我们还在 192 原子系统上评估了 2.55 亿参数的大型检查点 (pet-mad-m-v1.6.0) 。我们将预测的能量、作用力和应力与原生 FP32 路径中的预测能量、作用力和应力进行了比较。
NVIDIA Blackwell GPU 上的 BF16x9 方法
在计算能力为 10.0 或 10.3 的 NVIDIA Blackwell GPU 上,cuBLAS 支持通过环境变量、数学模式或计算类型 (通过 CUBLAS_COMPUTE_32F_EMULATED_16BFX9、CUBLAS_FP32_EMULATED_BF16X9_MATH 或 CUBLAS_EMULATE_SINGLE_PRECISION=1 请求) 启用 BF16x9。使用此路径进行单精度通用矩阵乘法 (SGEMM) 时,无需更改模型代码。
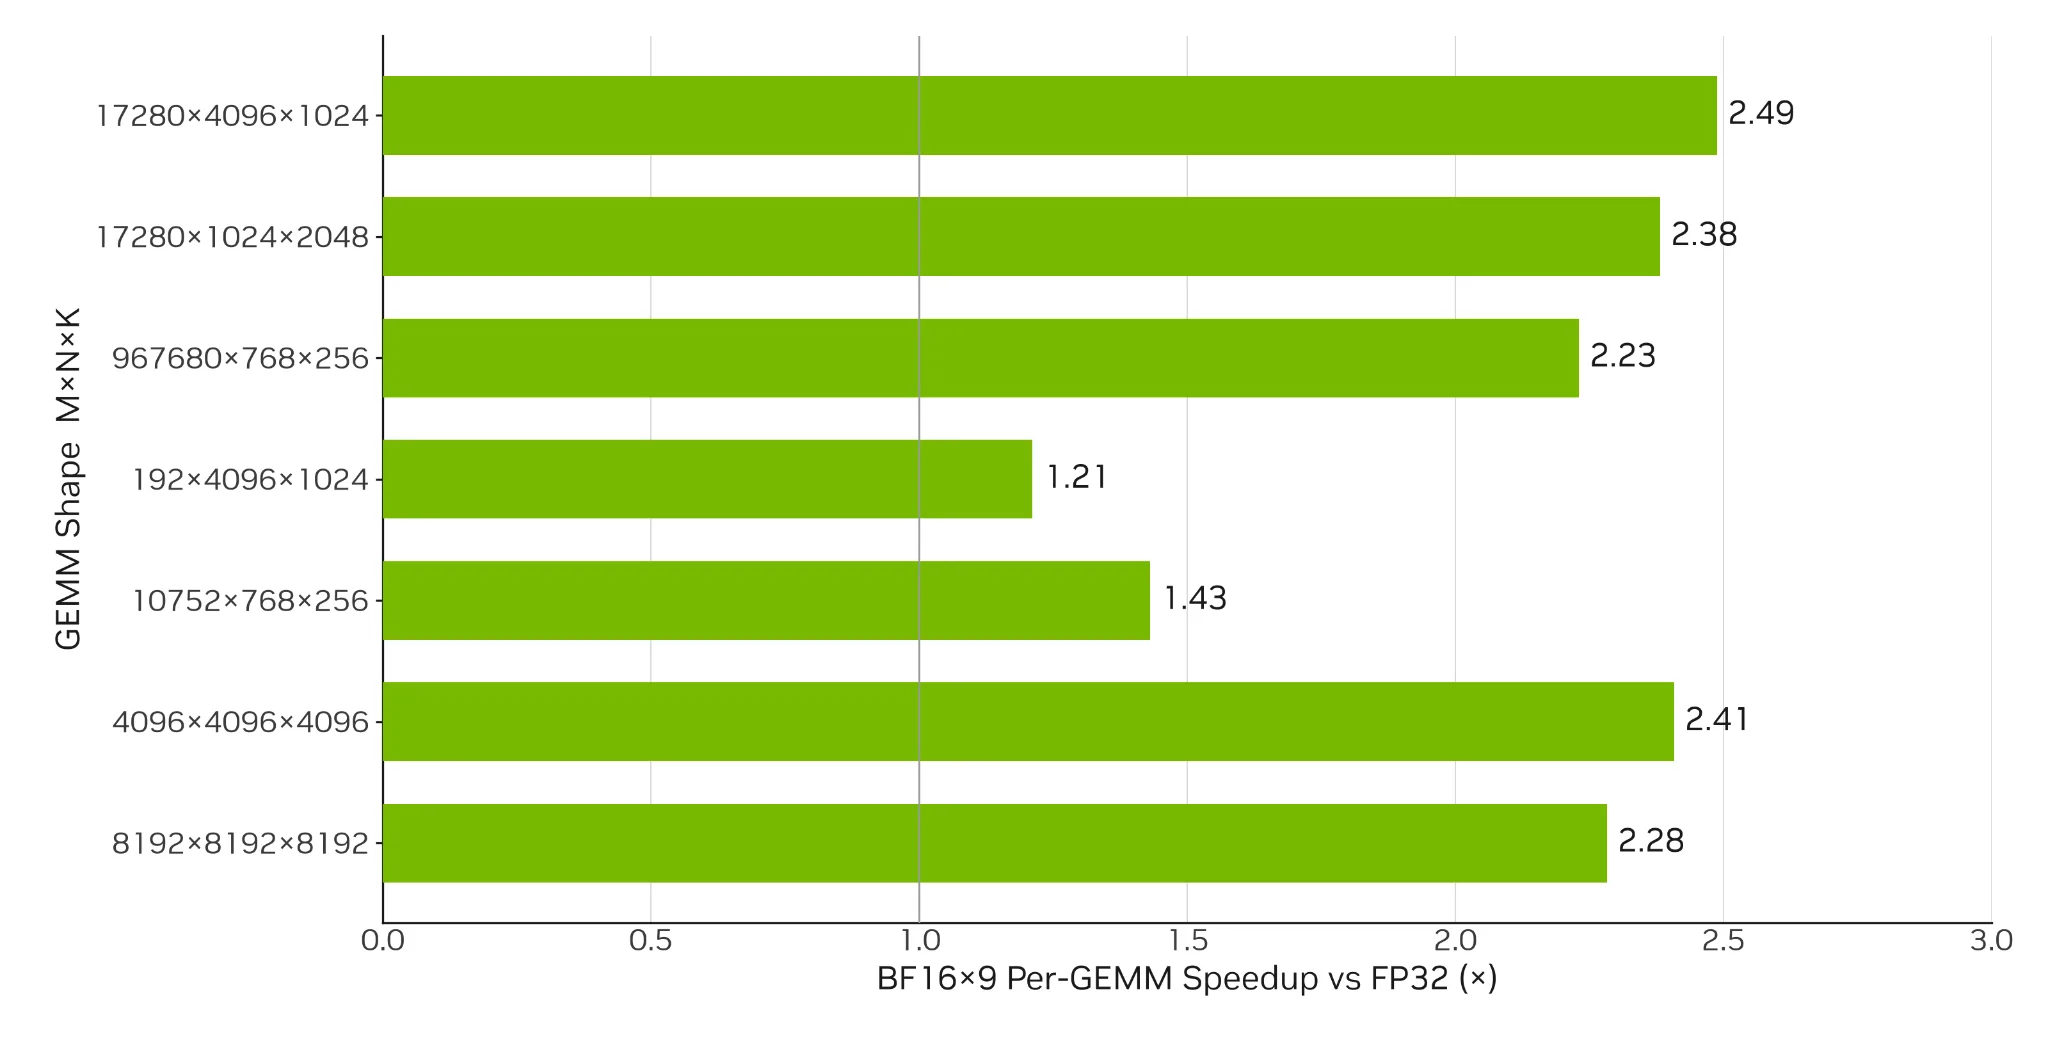
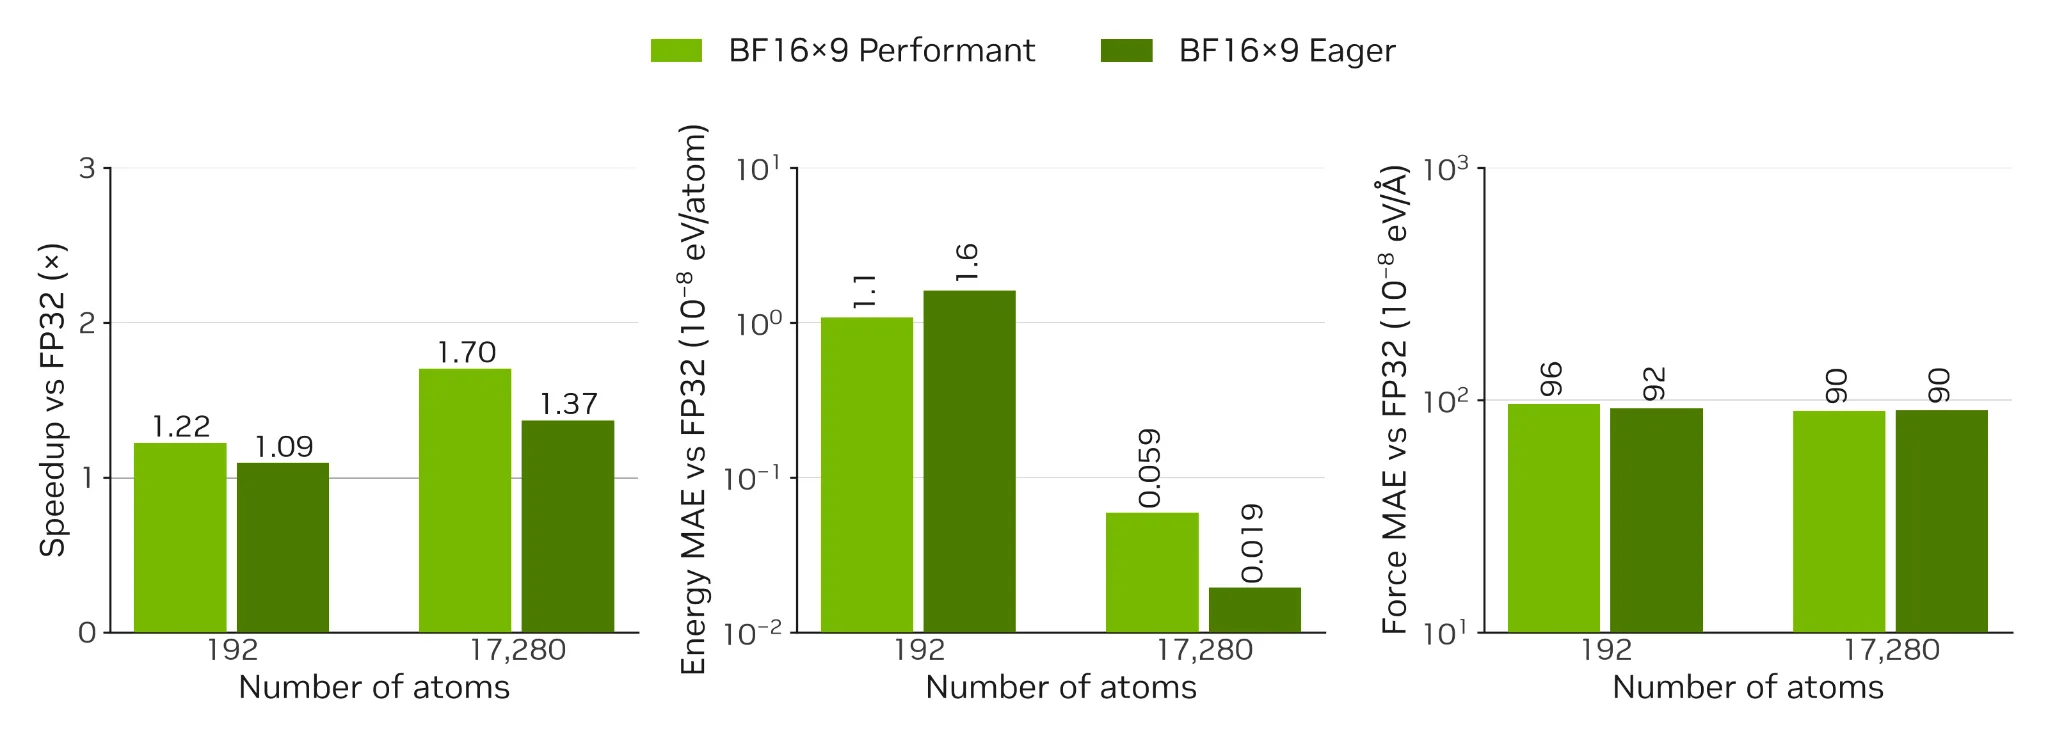
借助 Blackwell 上的 BF16x9,在处理 17280 原子工作负载时,PET 中的大型 GEMM 可获得 2.2 – 2.5 倍的加速 (图 3) 。图 4 比较了 cuBLAS 与编译后的 FP32 之间 MD-step 加速以及单点能量和力精度的性能和迫切策略。
- 192 原子系统:性能策略将 MD 步长提高了 1.2 倍,而“急速策略”实现了 1.1 倍。
- 17280 – Atom 系统:性能策略实现了 1.7 倍的加速,而渴望策略实现了 1.4 倍的加速。
当 cuBLAS 期望 BF16x9 更快时,性能策略使用 BF16x9;每当操作支持 BF16x9 时,主动策略使用 BF16x9。重要的是,BF16x9 Tensor Core 方法导致的误差低于模型自身的非确定性水平。这一结果意义重大,因为 PET 已将其大部分运行时表示为经过优化的 GEMM 工作,但 BF16x9 路径在不重新训练模型、改变其 Transformer 架构或编写自定义内核的情况下,却暴露了性能空间。
Ampere GPU 上的 TF32x3 方法
在 Ampere GPU 上,我们通过将 PET 的标准 nn.Linear 层替换为自定义 TF32Linear 层 (称为 CUTLASS C++ TF32x3 内核) 来实现 TF32x3。
CUTLASS C++ 在示例 27 中提供了此方法的参考实现。PET 实施中的关键设置为:
C++
cutlass::arch::OpMultiplyAddFastF32
选择 CUTLASS 快速、准确的 FP32 乘法模式。内核将每个 FP32 操作数表示为 TF32 前导组件和残差组件。然后,Tensor Core 会评估三种产品 (领先的产品和两种领先的残差产品) ,并将其累加到 FP32 中。忽略最小的残差乘积。CUTLASS C++ 运算符通过 float 输入和输出进行声明。因此,PET 继续提供普通的 FP32 激活函数和权重,并接收 FP32 结果;从模型的其他角度来看,该层的行为类似于标准 nn.Linear。只有底层矩阵乘法的实现发生变化。C++ 示例是为 sm80 (Ampere) 编写的,也可以为 sm90 (Hopper) 编译。
自定义 TF32Linear 模块可替换兼容的 PyTorch 线性层,并使用 CUTLASS C++ TF32x3 内核执行矩阵乘法运算,同时保留经过训练的权重、偏差和输入形状。
由于 PET 通过差分预测能量来计算力,因此 TF32x3 还可用于将梯度传播至层输入。这可确保能量和力计算均使用 TF32x3 Tensor Core 算法。权重梯度使用标准 PyTorch 路径,但在固定权重推理期间不需要。
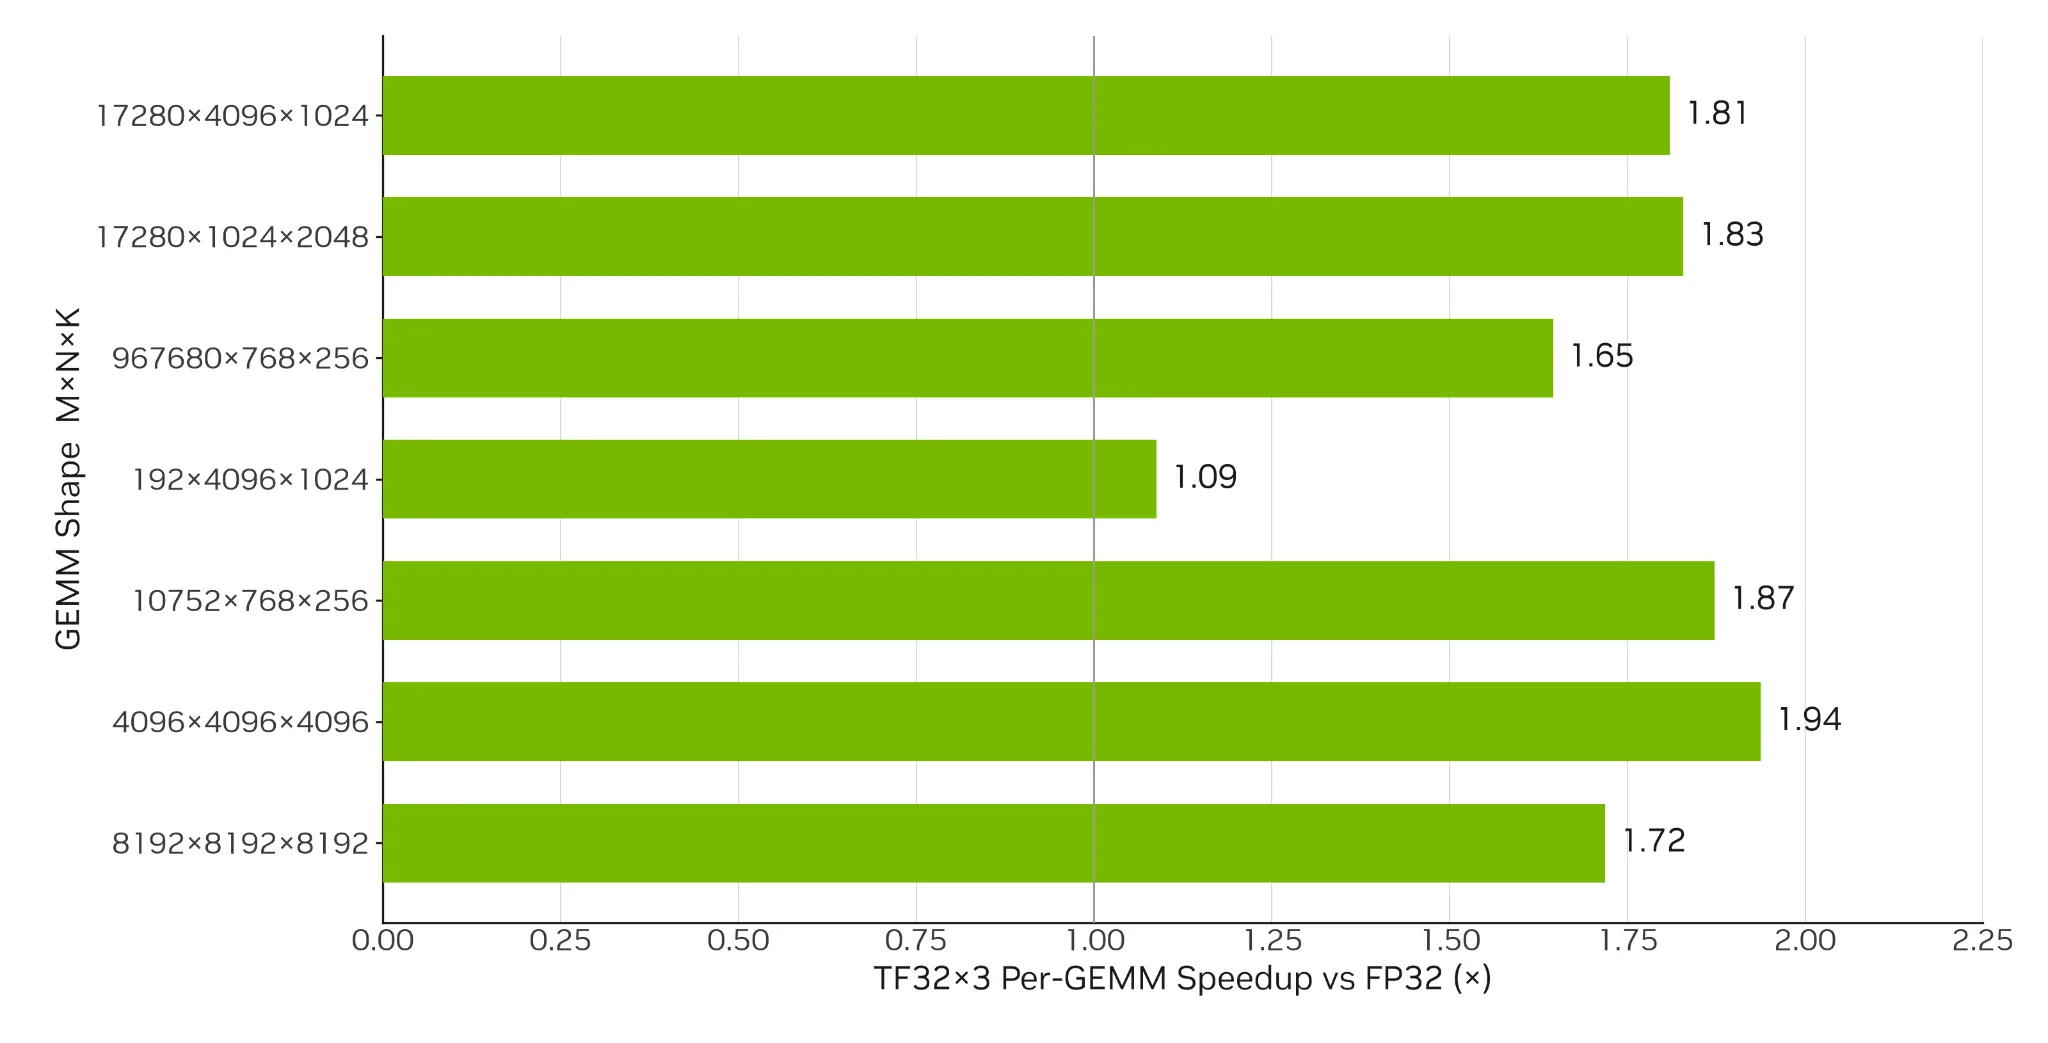
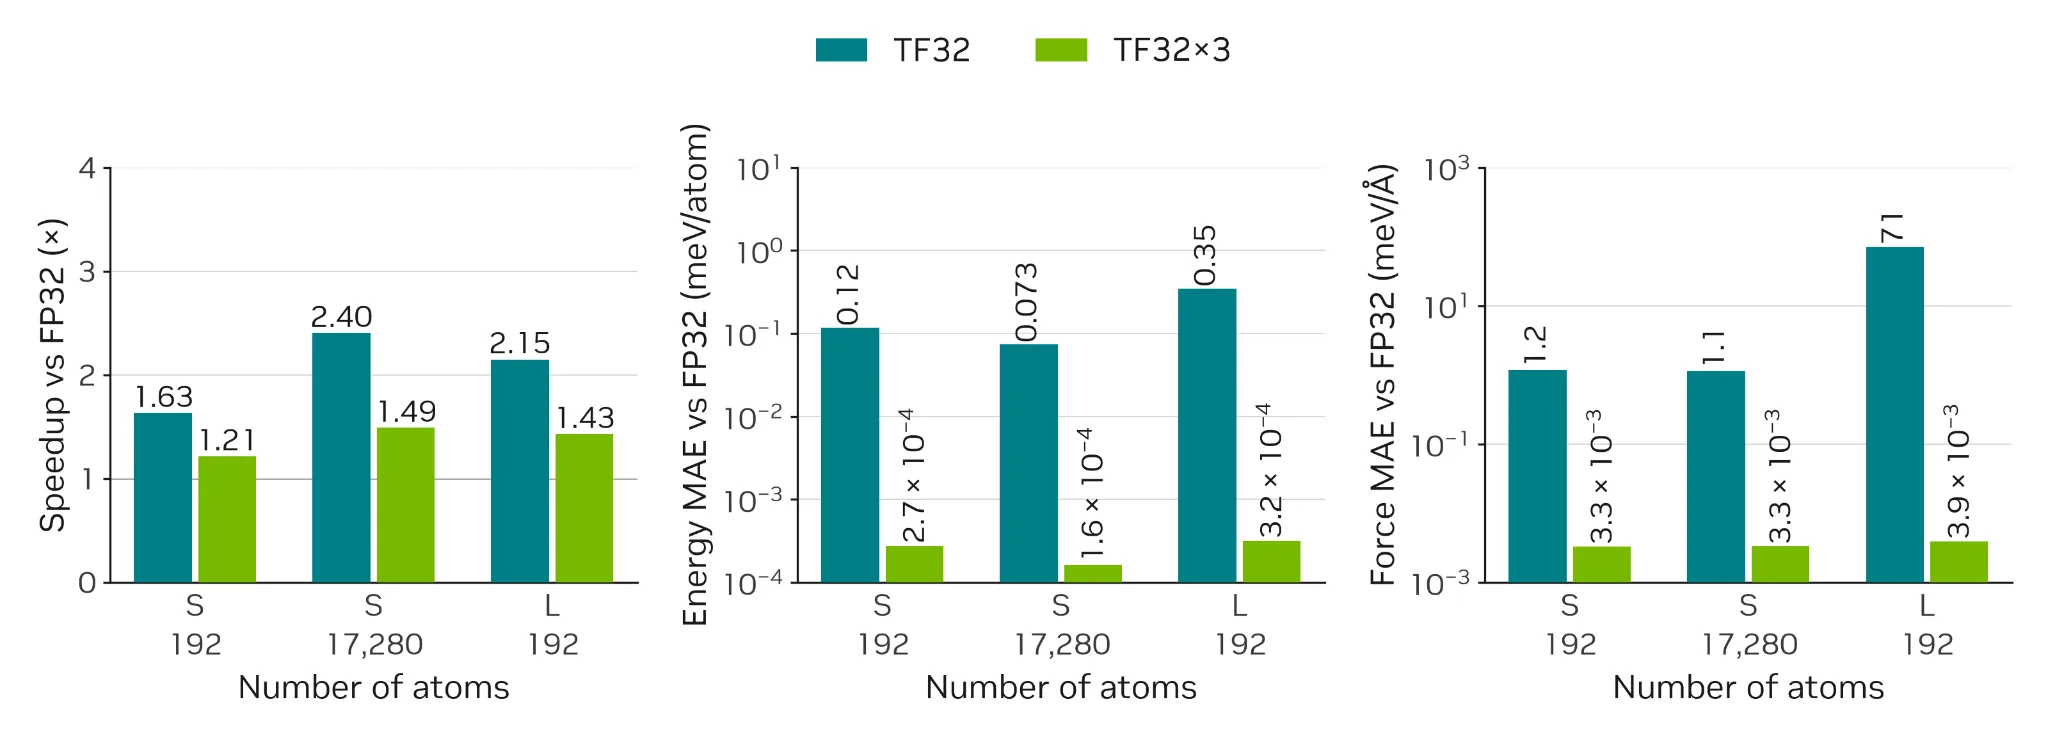
在 A100 上的 PET 主要线性层形状中,TF32x3 将 GEMM 加速了约 1.7 – 1.9 倍 (图 5) 。图 6 比较了单遍 TF32 和 TF32x3 的 MD-step 加速和单点精度,每个精度都根据其对应的 FP32 基准进行测量。单遍 TF32 实现了更高的加速,但对准确性和轨迹稳定性的影响更大 (图 6 – 7) 。
- 小型检查点 ( 2600 万个参数) :显示了 192 个原子水盒及其 17280 个原子超级单元的结果。在重新编译后,TF32x3 将力误差保持在 FP32 运行差值的大约三倍,并在更大的系统上将 MD 步长加快了 1.5 倍。
- 大型检查点 ( 2.55 亿个参数) :在 192 原子系统上,TF32x3 实现了 1.4 倍的加速,而小型检查点则是 1.2 倍。其力误差为 3.9 × 10⁻⁶ eV/Å,与小检查点基本不变。
验证物理一致性
在分子模拟中,匹配孤立的能量和力预测只是对数值保真度的第一个测试。力是已学习势能表面的梯度,并在许多时间步长中积分,因此即使是微小的数值不规则性也会使表面变得粗糙、破坏轨迹稳定或产生非物理能量漂移。因此,Tensor Core FP32 方法的前景特别引人注目:它可以释放 Tensor Core 的矩阵乘法性能,同时保留 FP32 所期望的平滑和稳定行为。
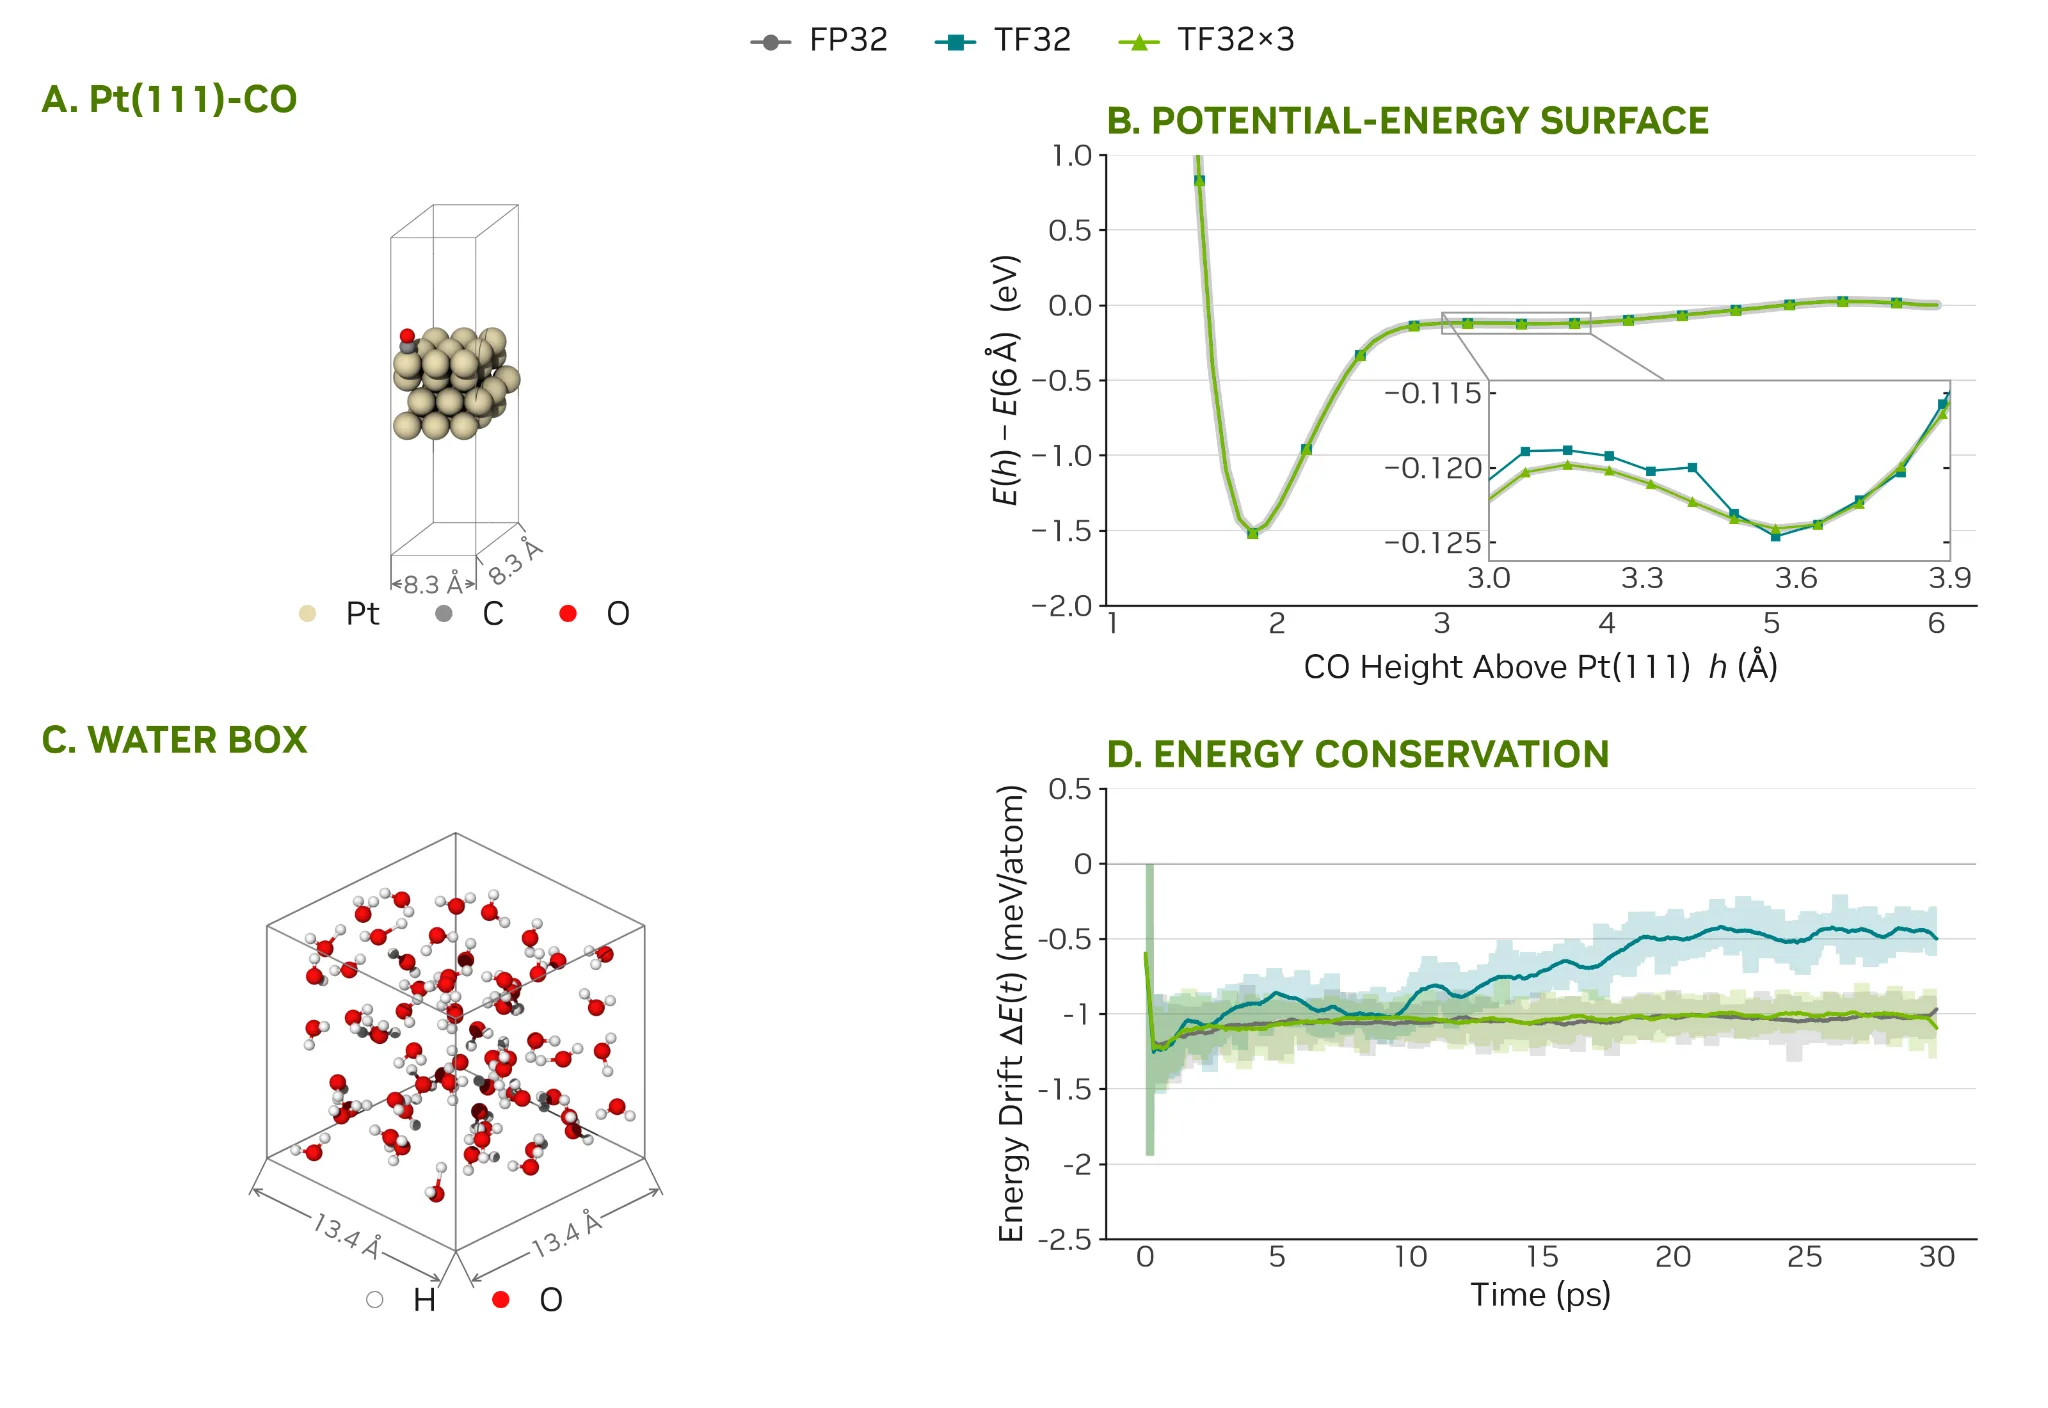
我们使用两个单独的测试 (图 7) 测试了势能平滑度和节能性。为了测试能量的平滑度,我们将单个一氧化碳分子从 Pt (111) 板的顶部站点刚性地拖走,并在 60 碳高度下以 8.1 × 10⁻² Å 的步骤从 1.2 到 6.0 Å 评估总能量。TF32x3 遵循平滑的 FP32 CO/ Pt (111) 能量曲线,而单遍 TF32 引入了可见的点对点变化。
在对一个 192 原子水盒的单独 NVE 模拟中,FP32 和 TF32x3 显示了类似的边界能量波动,而单次 TF32 显示了更大的系统漂移。这些结果表明,TF32x3 在测试系统中保留了势能平滑度并保持了节能,而不仅仅是单点精度。
测试结构松
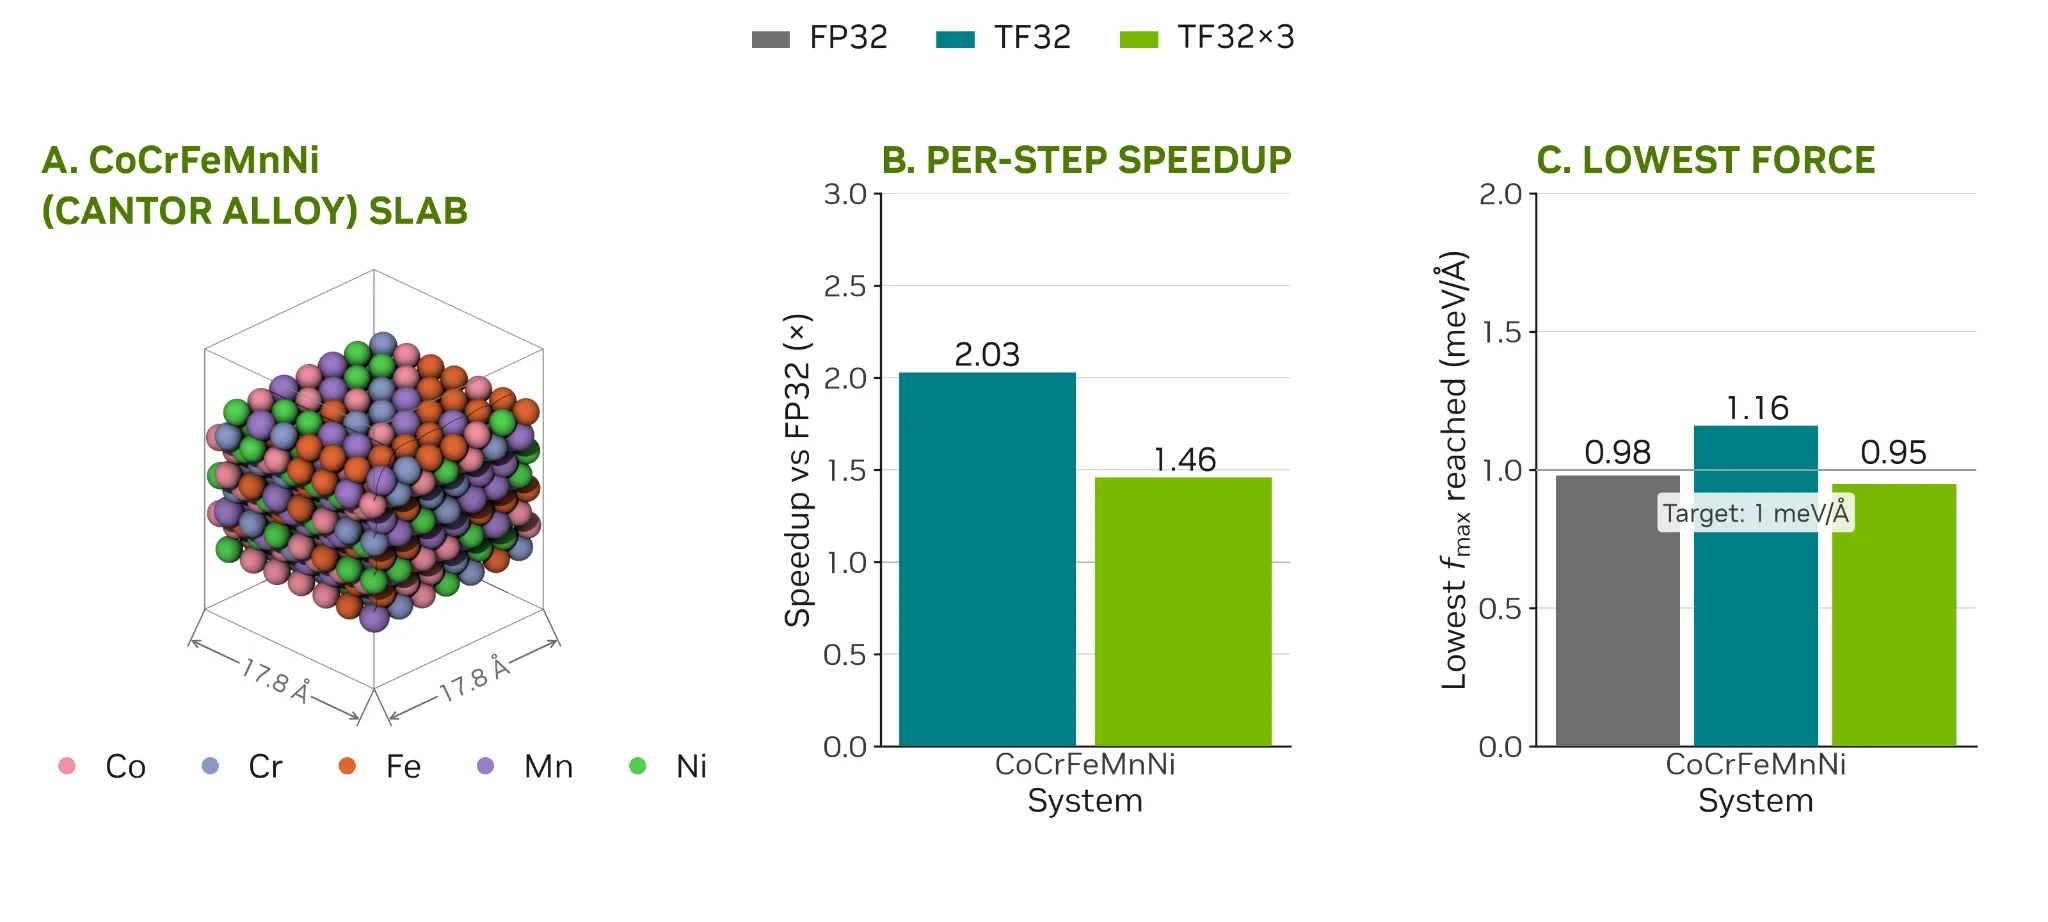
结构松还会测试数值保真度,因为优化器会反复使用预测力来更新原子几何图形。小的力不一致性会改变优化路径,增加所需的步骤数,或阻止系统达到所需的力容差。我们使用 PET 和 NVIDIA ALCHEMI 工具包的 FIRE2 优化器放松了 539 原子的 Cantor 合金板。在三次重复中,FP32 以 218 个步骤收,TF32x3 以 218 – 2022 个步骤收;每次运行均达到 1.0 × 10⁻³ eV/Å 力容差。使用单遍 TF32 时,所有三个重复都无法在 500 步限制内收,并迫使其稳定在 1.2 × 10⁻³ eV/Å 左右。
TF32x3 在匹配 FP32 收率和标准的同时,将每个优化步骤的速度提高了 1.5 倍 (图 8) 。单遍 TF32 实现了 2.0 倍的每步加速,但即使将优化步长限制翻倍至 1000 步,也无法收。
这些结果凸显了 Tensor Core 路径的实用价值:在不牺牲 FP32 工作流程收行为的情况下实现大幅加速。
限制和决策标准
端到端收益取决于系统大小和在 GEMM 中花费的运行时间比例。由于启动用度、近邻处理、图形操作和其他非 GEMM 工作在运行时中占较大比例,因此小型系统的优势通常较小。当 GEMM 承担更多工作时,更大的系统会受益更多。TF32x3 的性能还取决于模型矩阵形状和硬件的内核调优。
数值行为取决于所用的 Tensor Core 策略。在矩阵乘法测试中,BF16x9 与 FP64 参考相比,达到或超过了原生 FP32 精度,支持将其用作受支持硬件上 FP32 GEMM 的直接替代品。TF32x3 的准确性配置文件略有不同,应根据模型的准确性和物理稳定性要求进行验证。
总结
Tensor Core FP32 方法可在不重新训练或改变模型架构的情况下提高 PET 性能。TF32x3 将 A100 上的主要 GEMM 加速了 1.9 倍,将完整的分子动力学步骤加速了 1.5 倍。在 NVIDIA B300 Tensor Core GPU 上,BF16x9 可将主要 GEMM 的速度提升高达 2.5 倍,将整个步骤提升高达 1.7 倍。如 TF32x3 所示,Tensor Core 方法可在经过测试的节能和结构松工作流程中保留接近 FP32 的行为。
这些结果支持评估其他 MLIP 和精度敏感型科学机器学习模型中的方法,这些模型的运行时间主要由大型 FP32 GEMM 决定。这两种 Tensor Core FP32 策略都不需要重新训练或重新设计架构。因此,每个层都可以作为独立的性能层进行评估,并在工作负载支持的情况下与其他软件优化相结合。
立即针对您的模型试用 TF32x3 或 BF16x9 Tensor Core 方法,无需重新训练或更改架构。如需了解详情,请参阅 cuBLAS 文档 和 NVIDIA ALCHEMI 工具包文档。在 UPET 资源库 中探索 PET 模型。
致谢
感谢 Nikita Fedik、Harun Bayraktar、Gregory Thomsen 和 Vamsi Sripathi 对此博文的贡献。


