

始终在线的智能体正在承担更长、更复杂的企业工作流程。单个请求可能涉及阅读文档、检查跨来源的信息、遵循公司政策以及调用多个工具。
NVIDIA Nemotron 3.5 Super VL 是一个开放、可定制的多模态模型,适用于这些专业工作流程。其 120B 参数混合专家模型 (MoE)架构可为每个 token 激活 120B 个参数,从而在模型容量和推理效率之间取得平衡。
与同类别的其他开放模型相比,该模型在单个 GPU 上可提供高达 5 倍的代理式任务吞吐量。
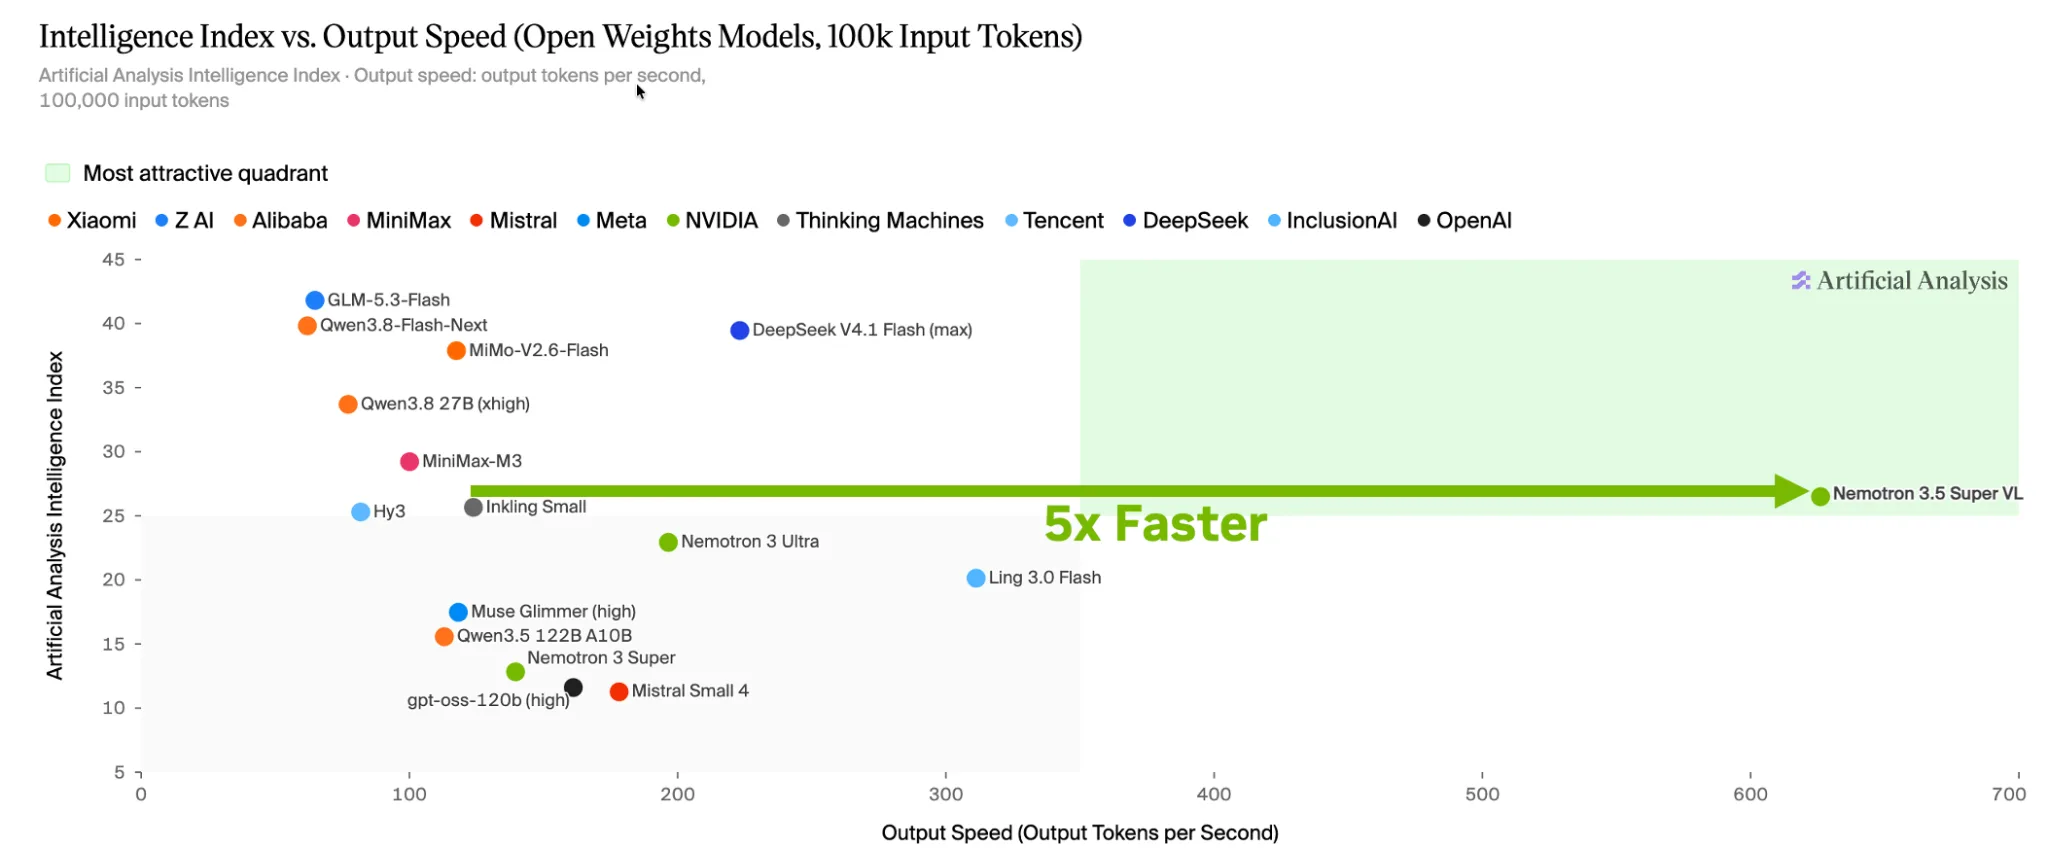
该模型将推理、指令遵循和工具使用与文本、图像、文档和视频理解相结合。通过将这些功能整合到一个模型中,团队可以处理文本和视觉任务,而无需部署单独的文本和视觉语言模型,也无需在它们之间传递任务上下文。
开发者可以使用自己的数据、工具、策略和工作流,使用 NVIDIA NeMo 对 Nemotron 3.5 Super VL 进行后训练。本文将介绍如何利用该基础构建专用的企业智能体,并介绍为其提供支持的训练和推理技术。
为何选择适用于专用智能体的 Nemotron 3.5 Super VL?
智能体需要了解其任务和操作环境。客服人员必须遵守公司的退货政策。研究智能体将跨来源的证据连接起来,而文档智能体则解释表格、图表和页面布局。
Nemotron 3.5 Super VL 结合了一系列智能体工作流的推理和视觉理解,包括:
- 编码:测试和验证代码、分析错误并提出修复建议。
- 网络研究:跨网站搜索、关联信息并验证答案。
- 文档智能:从表格、图表和页面布局中提取信息,以生成摘要和报告。
- 网络安全:识别安全漏洞并对威胁进行分类,以便优先采取补救措施。
- 视频理解:提取信息用于搜索、内容审查和事件分析。
在模型系统中,NVIDIA Nemotron 3.5 Lightning 可处理大量文本任务,而前沿模型 (如 NVIDIA Nemotron 3 Ultra) 则可处理复杂的规划和编排。
为域数据、工具和策略自定义 Nemotron 3.5 Super VL
专业智能体必须了解组织的运作方式。域术语、工具界面、操作程序和策略要求决定了智能体成功完成任务的方式。
从网络安全和金融到医疗健康等行业的组织正在对 Nemotron 3.5 Super VL 进行后训练,以在其生产工作流的准确性和效率方面优于前沿模型。例如:
- 扩展 AI,这是一家 AI 数据和技术提供商,由 Skydance Corporation (一家媒体和娱乐公司) 提供经过后训练的 Nemotron 3.5 Super VL,用于自动化供应商信用处理。此工作负载的推理成本将降低 40 倍,延迟将降低 5 倍。
- 金融运营平台提供商 Ramp 正在将收据图像转换为结构化 JSON,其中包含商家信息、日期和支付数据。Ramp 期望吞吐量提高 50%,延迟降低 10 倍。
- AI21 和 Alice 经过后训练的 Nemotron 3.5 Super VL 可用于威胁情报和漏洞分析,准确率提高 41%。
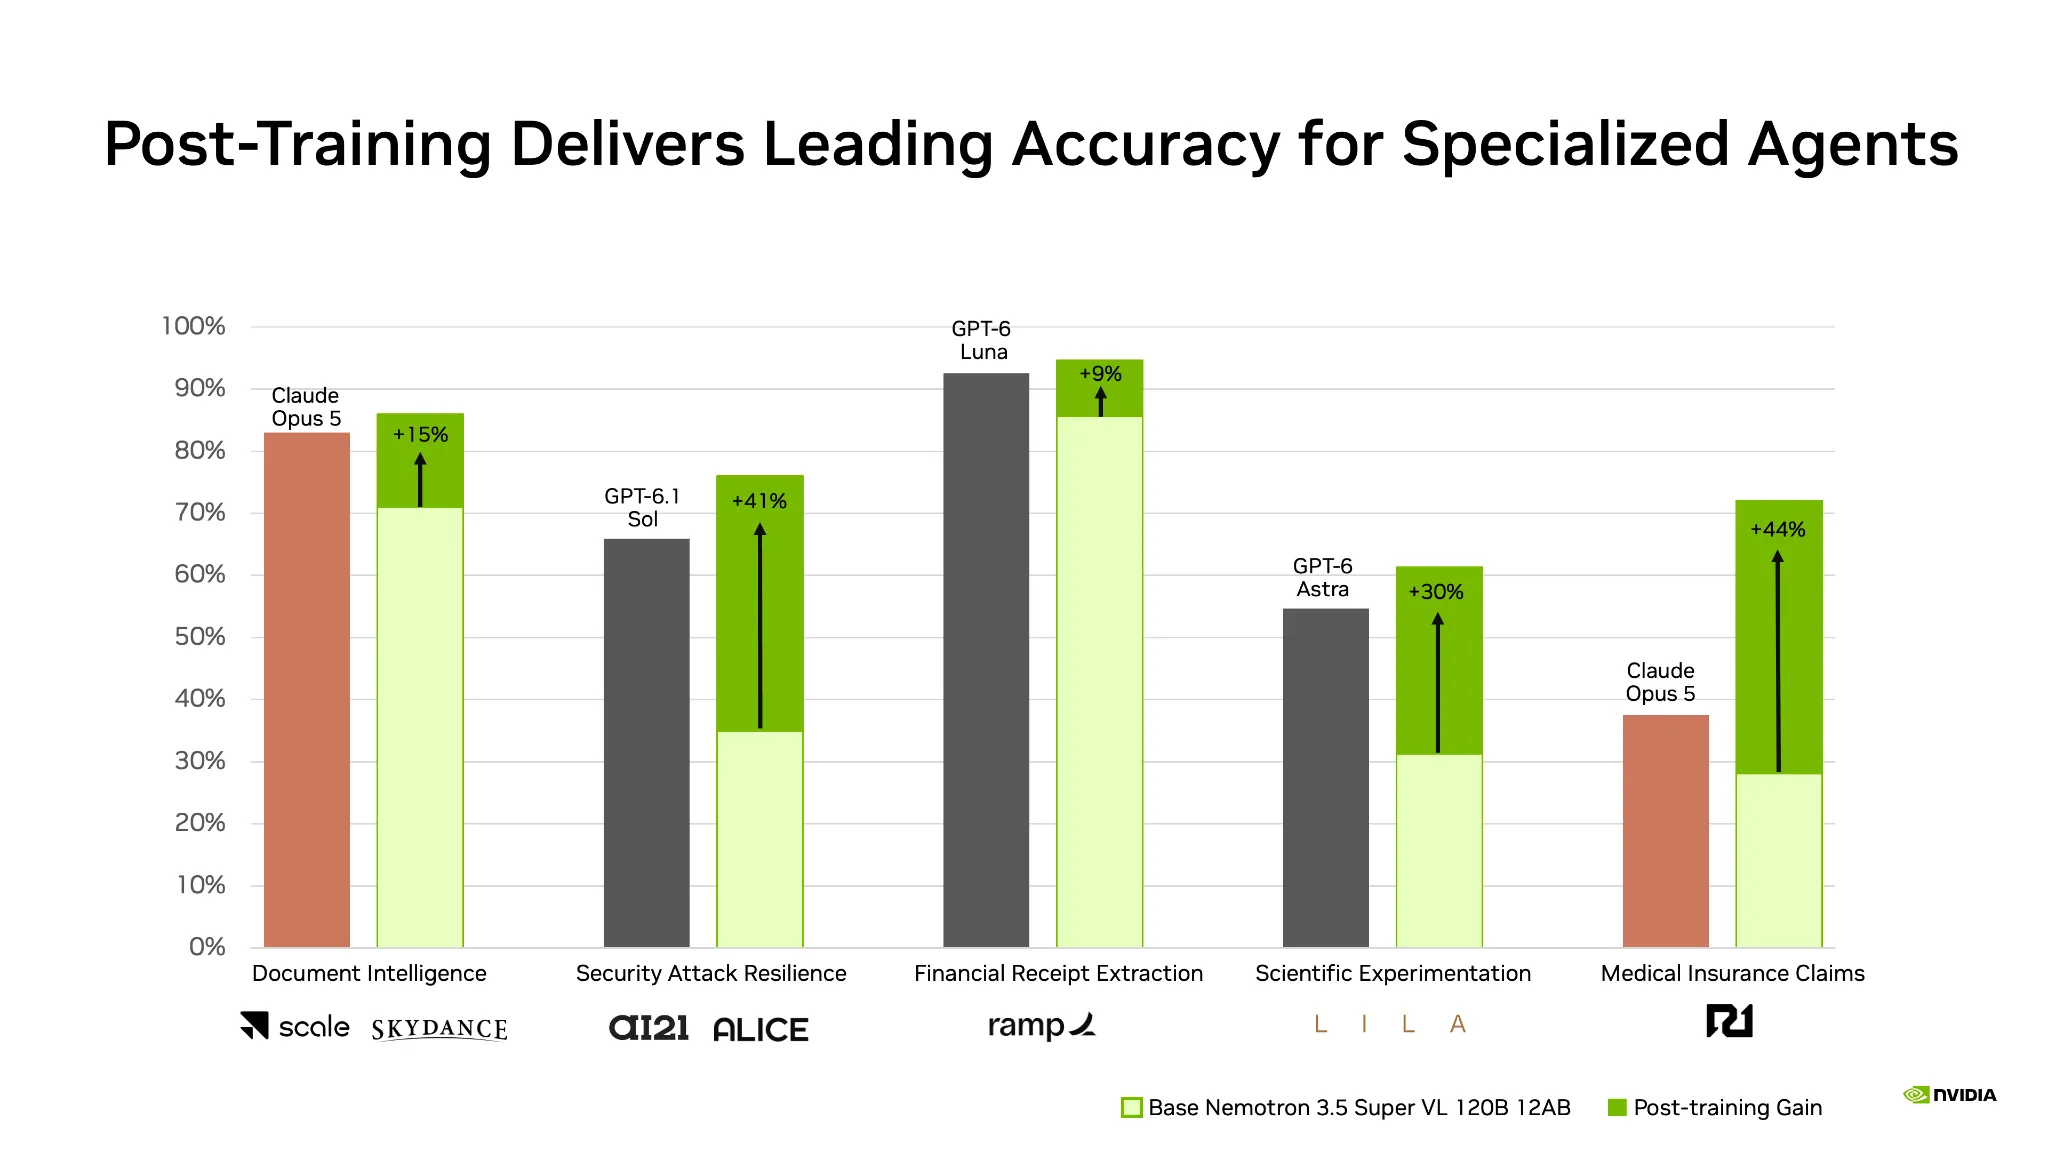
团队可以使用 NVIDIA NeMo AutoModel 进行监督式微调 (SFT) 和低秩自适应 (LoRA) ,以教授特定领域的行为。强化学习 (RL) 可提高反映组织工作流的代理式环境的性能。
除 Nemotron 3.5 Super VL 外,NVIDIA 还将在 Hugging Face 上发布开放数据集。其中包括代理式工具使用和对话式数据、金融推理和工具调用数据集、指令遵循和聊天数据、长上下文转导和翻译数据、公平性数据以及 40 个视觉语言数据集。这些数据集可以补充用于 SFT 和 RL 的专有数据。
对于多模态数据,可以从 NeMo Data Designer 资源入手,用于 图表问答 和 长文档理解。探索 NVIDIA NeMo RL 和 NVIDIA NeMo Gym,了解 RL 和基于环境的评估。
组织可以在受支持的本地、数据中心或云环境中调整和部署模型的开放权重,以满足其基础设施和数据要求。有关定制资源,请参阅 GitHub 上的 Nemotron 3.5 Super VL 使用规范。
在一个工作流中结合文本和视觉理解
Nemotron 3.5 Super VL 将文本、图像、文档和视频理解与推理和指令遵循相结合,回答这些输入中的问题。
其视觉训练包括图表、表格、光学字符识别 (OCR) 、多页文档和视频理解。双阶段 SFT 工作流将视觉证据与推理、聊天、安全、长上下文数据和智能体轨迹相结合,训练语言和视觉组件。
对于文档智能,同一模型可以解释图表,将其与文档中其他位置的表格连接,并对两者进行总结。开发者可以根据自己的文档和评估标准定制工作流程。
NeMo Data Designer 生成的多样化训练数据有助于模型更好地理解复杂的图表。在图表推理基准测试 CharXiv 上,该模型的得分为 80.8%,而 Nemotron 3 Nano Omni 的得分为 63%。借助 Python 代码解释,这一比例达到了 84%。有关方法和经验教训,请阅读 图表理解深入探讨 和 开源图表问答流程。
该模型由 Nemotron 联盟组织提供支持和专业知识。例如,Perplexity 的高质量数据集有助于改进和简化模型的中期训练。Prime Intellect 的环境有助于构建更好的教师模型。
Nemotron 3.5 Super VL 也是 OCRBench v2 排行榜上的顶级开放模型之一。
跨智能体任务的准确性和效率
对 Nemotron 3.5 Super VL 的评估涵盖了 Hermes、LangChain、OpenClaw、OpenCode、Pi、Codex 和 Claude。除了编码任务外,智能体利用提供商还使用自己的评估来测试各种智能体任务。在 Hermes Bench 和 LangChain 行为评估中,Nemotron 3.5 Super VL 得分高于 Nemotron 3 Ultra。
| 模型 | Hermes Bench | LangChain Evals |
|---|---|---|
| Nemotron 3 Ultra | 56.33% | 84.3% |
| Nemotron 3.5 Super VL | 63.44% | 87.05% |
对于始终开启的智能体而言,效率决定了部署可以完成的工作量。吞吐量、token 使用率、工具调用以及达到正确结果所需的步骤都会影响任务完成时间。
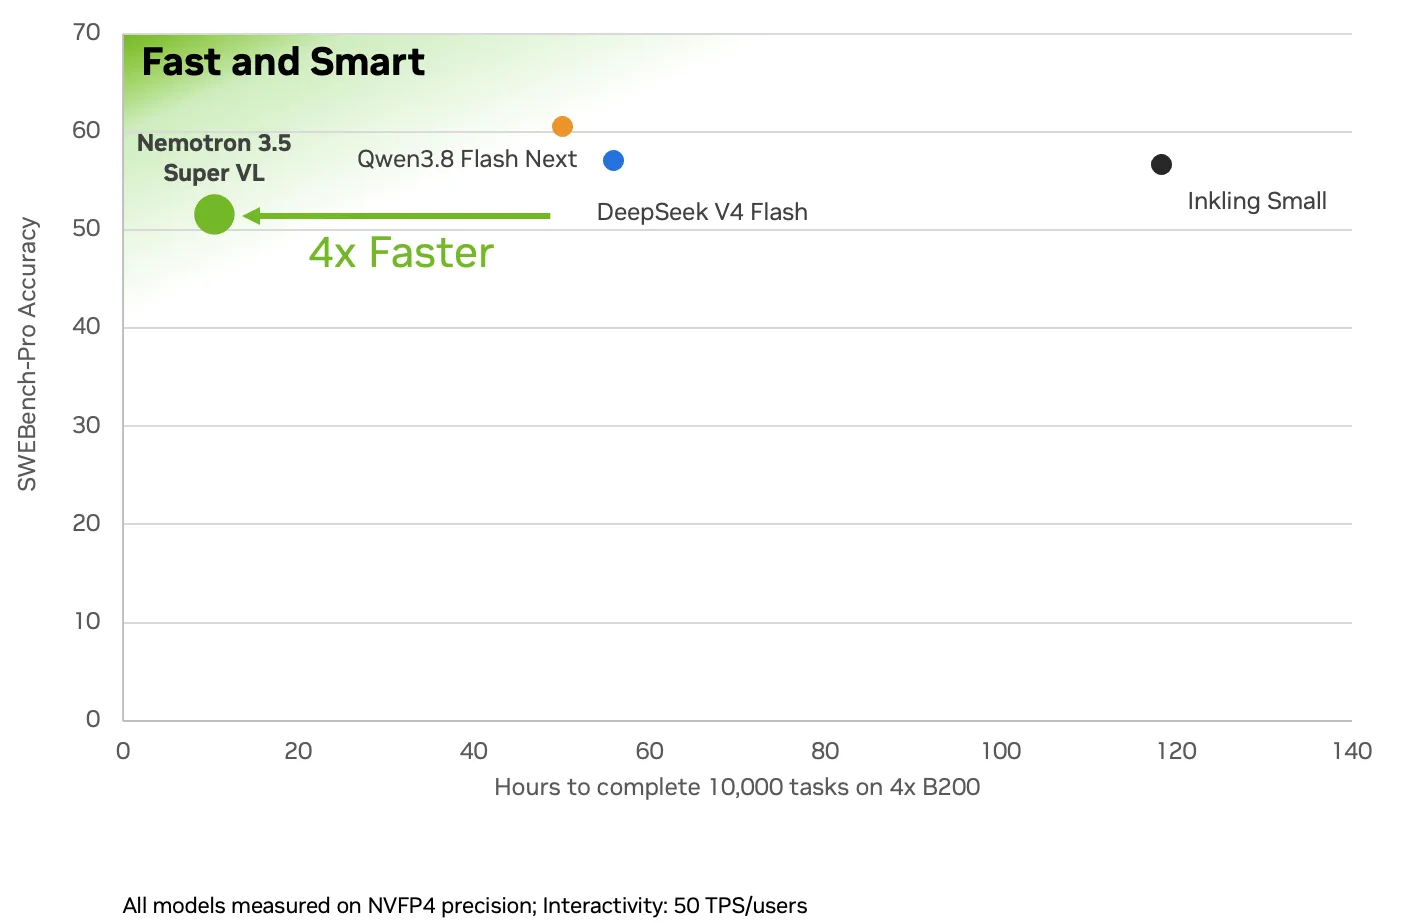
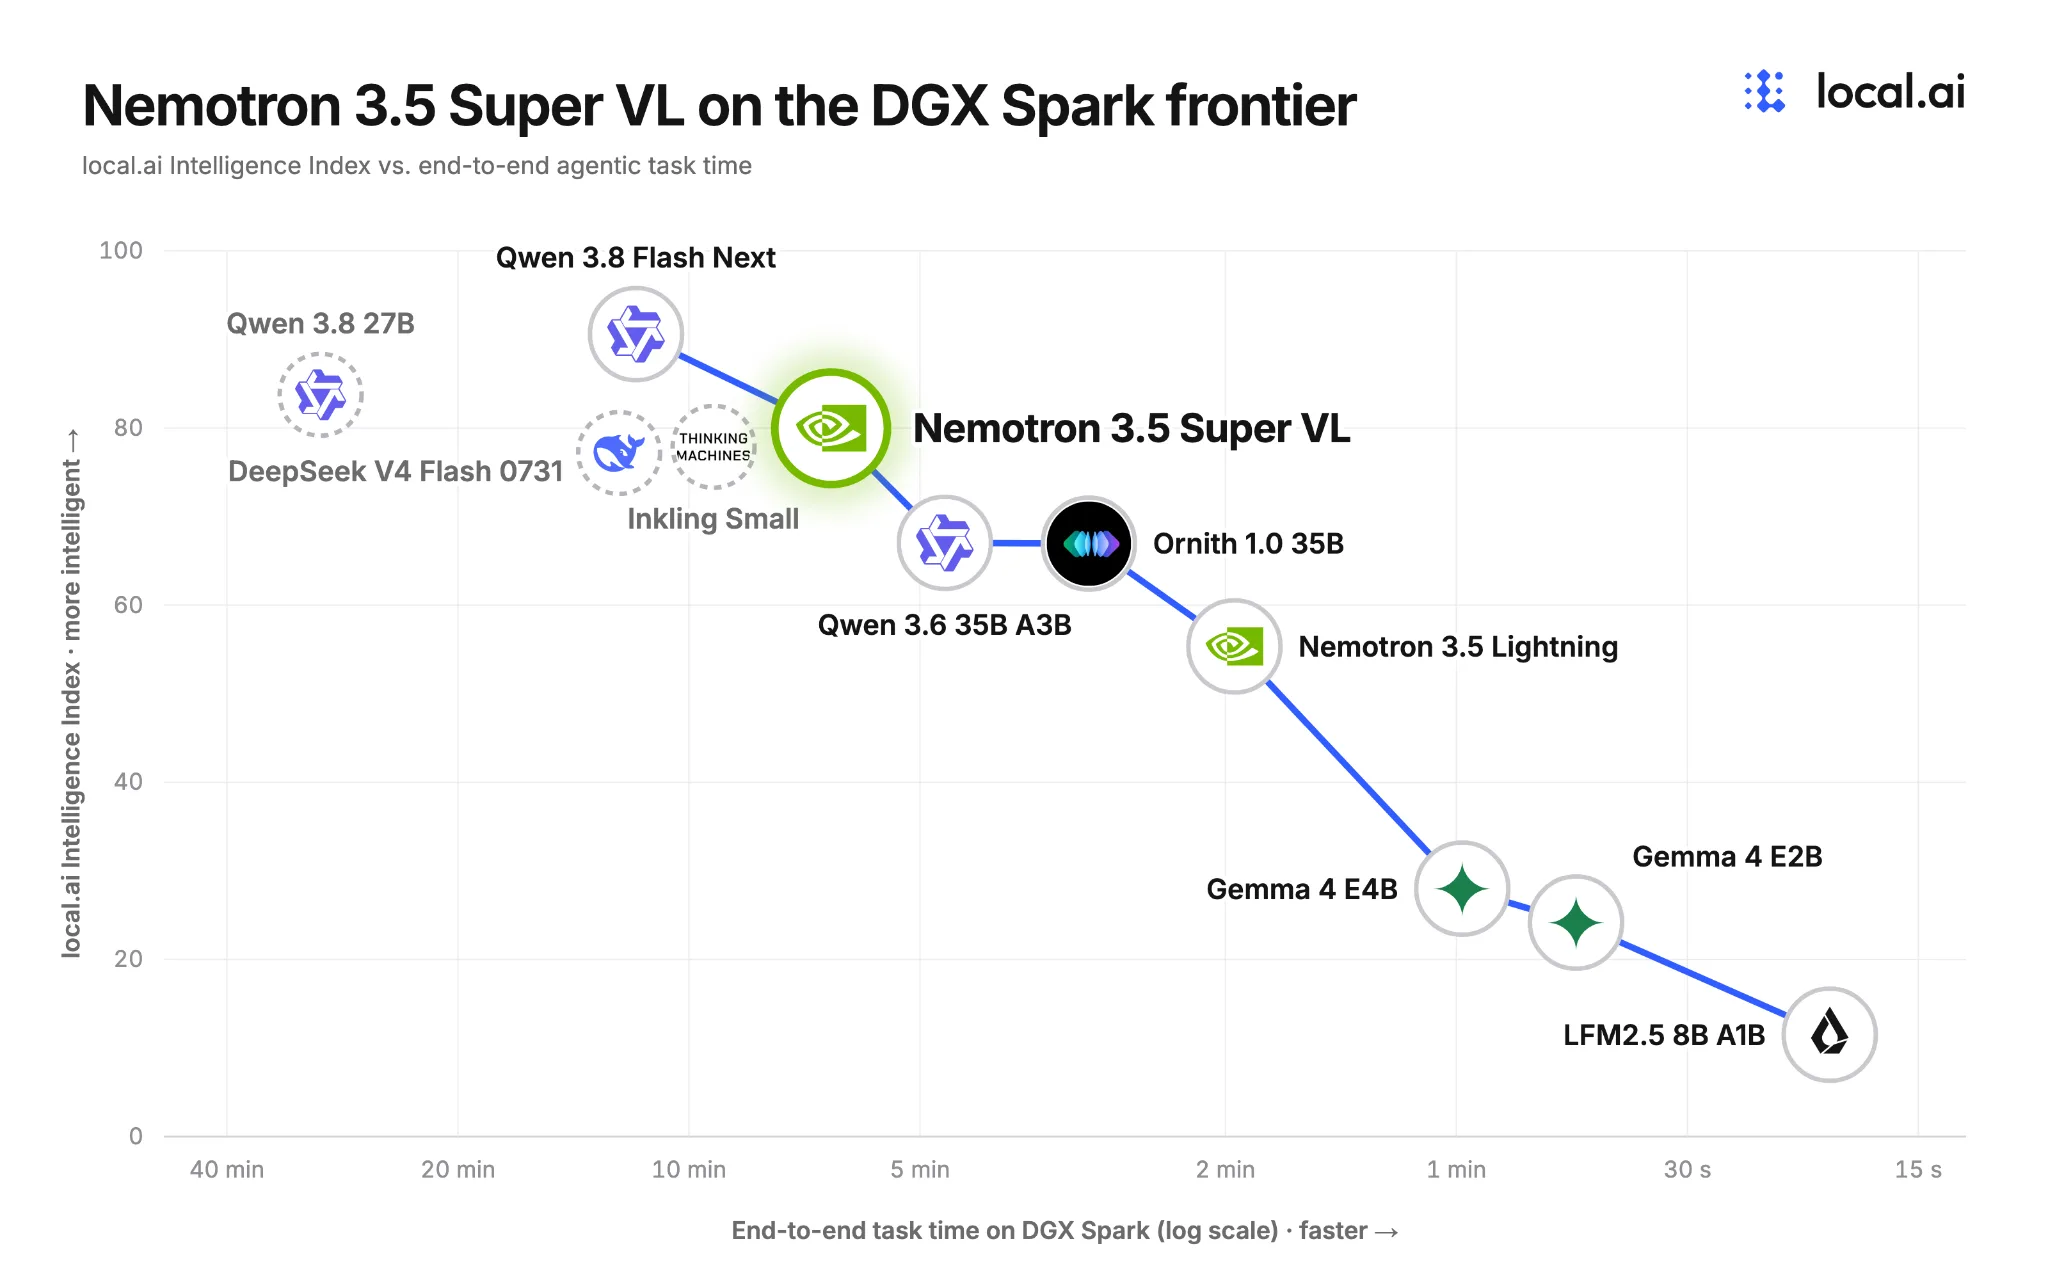
此模型还经过优化,可在 NVIDIA DGX Spark 上本地运行。EXO Labs 的一项独立评估将 Nemotron 3.5 Super VL 置于 Pareto 前沿,以确保准确性和任务完成时间。
Nemotron 3.5 Super VL
该模型建立在坚实的基础之上,并使用混合架构、推理解码、上下文重用和混合精度来减少重复智能体调用中的推理工作。
构建强大的基础模型
Nemotron 3.5 Super VL 采用 Nemotron 3 Ultra 蒸而成。Ultra 的编码功能与蒸馏中使用的 SkewReverse 损失函数相结合,有助于提高编码准确性。
在后培训期间,多教师策略指导蒸馏 (MOPD) 结合了专业教师对文本和视觉的指导。该模型会生成回复,而教师则会在视频推理和跟踪、视觉工具使用和对齐方面对其进行评分。
针对智能体动作、代码库和软件工程任务示例进行的额外训练提高了模型在智能体任务上的性能。在多个评估设置中,Nemotron 3.5 Super VL 在 SWE 工作台和终端工作台上的表现优于 Nemotron 3 Super。
使用高质量自然和合成数据进行的持续预训练提高了印度语能力,并有助于提高后训练后的总体分数。本阶段添加了 100 亿个印度语 token,这些 token 来自 Nemotron-pretraining-Indic-v1 的 12 种语言子集和自然印度语文本。
NVIDIA 将发布完整的数据集,该数据集包含涉及 22 种印度语言的约 2.8 T token,由 IIT Madras 及其 AI4Bharat 实验室开发。以下结果基于经过后训练的 Nemotron 3.5 Super VL。
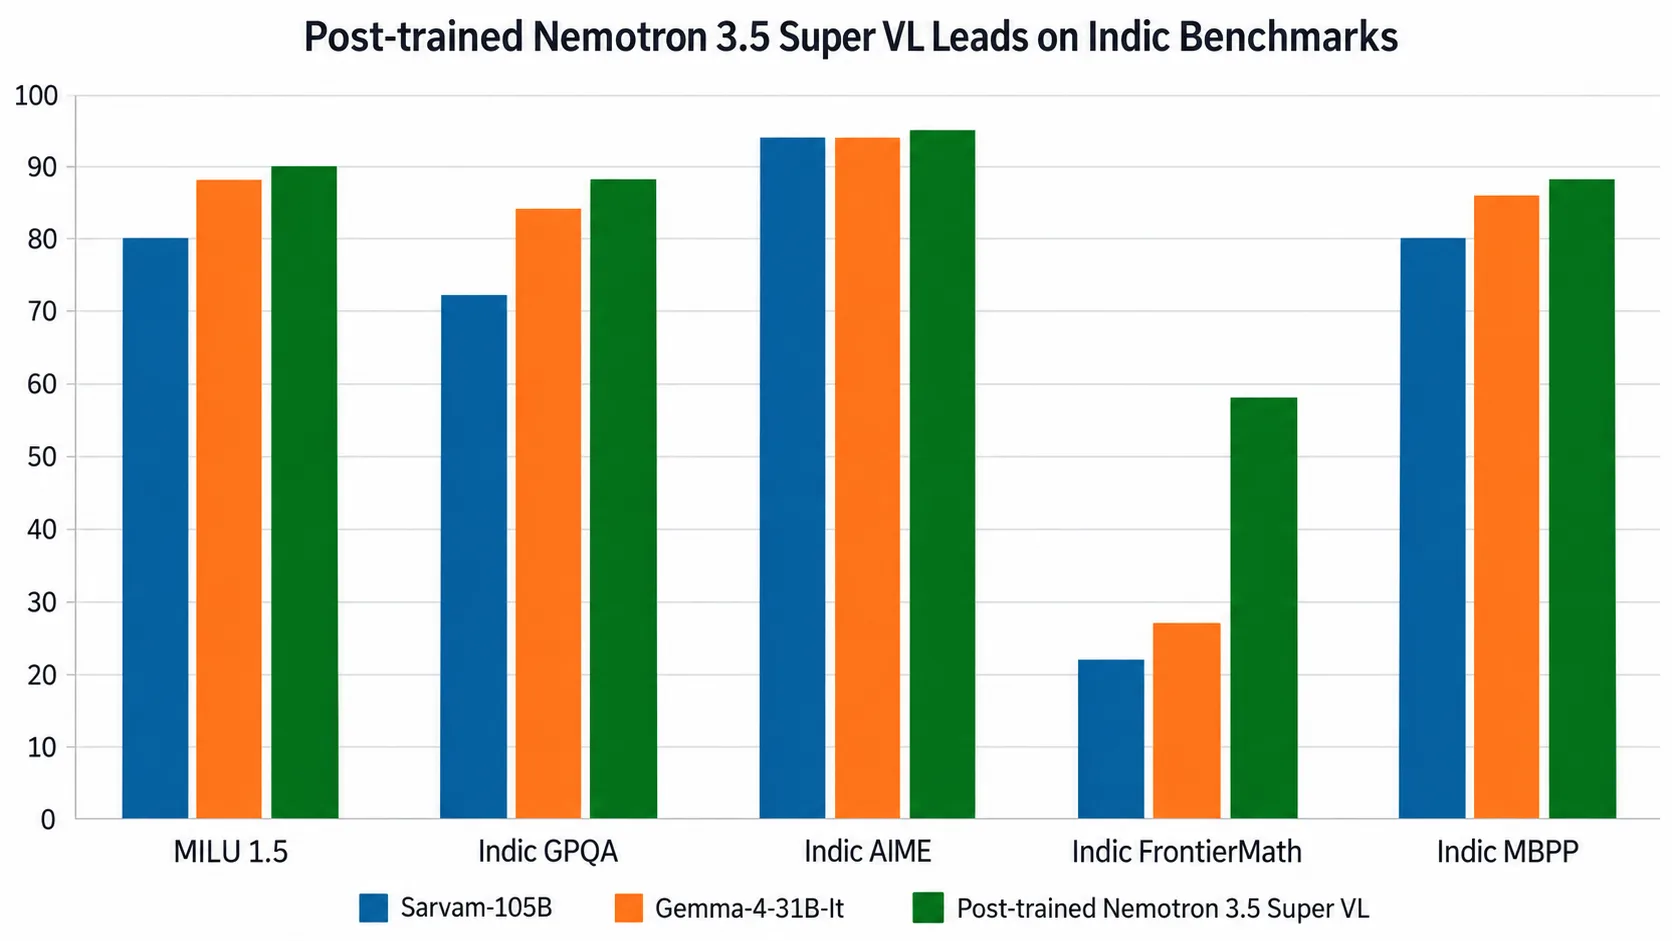
开发者可以使用 NeMo 在此基础上进行构建,并为其应用自定义 Nemotron 3.5 Super VL,使其推理和智能体功能适应其数据、工具和工作流。
LiLiCorr:一种开放的推理解码技术
LiLiCorr 通过联合评估整个草稿中的 token 候选项,捕获独立 token 预测遗漏的依赖项,从而改进并行预测解码。轻量级网络在单次传递中计算兼容性分数,以生成更连贯的草稿,只留下低成本、顺序的最终选择步骤。
在 DGX Spark 上,使用 Nemotron 3.5 Super VL 进行低延迟推理时,推荐使用 LiLiCorr。与无需猜测的解码相比,它的 token 生成速度最高可提升至原来的 2.3 倍。
NVFP4 和混合精度
该模型使用 NVIDIA Model Optimizer 进行后训练量化和量化感知蒸馏 (QAD) 。NVFP4 recipe 在 NVIDIA Blackwell 架构上使用 4 位权重和激活函数。相同的检查点在具有 4 位权重和 16 位激活函数的非 Blackwell 平台上运行。对于敏感元件,系统会单独选择精度。
NVFP4 使模型变得更小,而 QAD 帮助其在较低精度下保持准确性。在 QAD 期间,量化模型会学习匹配原始 BF16 模型的输出,从而缩小量化带来的准确性差距。QAD 还支持在 NVFP4 (而非 FP8) 中存储键值 (KV) 缓存,同时仍能达到准确性目标。由于 QAD 是在训练期间进行的,因此不会增加推理开销。
多token预测
多token预测 (MTP) 为 Nemotron 3.5 Super VL 提供了一个内部绘图器,该绘图器为主模型提出了多个token,以便在一次前向传递中进行验证。同时接受多个 token 可减少生成响应所需的计算密集型验证步骤的数量。
专门的 MTP 加速训练阶段进一步调整了起草者与最终模型的一致性。
跨智能体轮次的上下文重用
智能体反复将系统指令、工具定义和对话历史记录传递回模型。前缀缓存会重用这些共享输入的计算。
该模型的服务优化可同时保留注意力缓存和 Mamba 递归状态。额外的 Mamba 检查点可减少恢复预测解码所需的输入所需的回放,而内部检查点可避免在提示处理过程中进行额外的模型传递。
借助 NVIDIA NIM 和 NVIDIA Dynamo 简化生产部署
NVIDIA NIM 为云和数据中心部署提供经过优化的推理引擎、经过验证的配置和标准 API。NIM 会收到持续的安全性、功能和性能更新。企业支持通过 NVIDIA AI Enterprise 提供。开始使用 NIM。
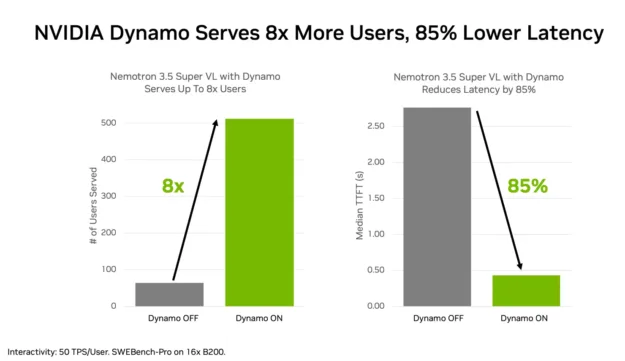
NVIDIA Dynamo 支持分布式推理优化,可提高吞吐量并降低延迟,包括 KV-cache 感知路由、KV 缓存管理 和 解服务。
在 16 个 NVIDIA B200 GPU 上,以每位用户每秒 50 个token的速度,具有会话关联性和 KV 缓存卸载的 KV 感知路由可为多达 8 倍的用户提供服务,同时将首个token延迟降低 85%。开始使用 Dynamo 部署方案。
开始使用 Nemotron 3.5 Super VL
利用多模态推理和工具构建专用智能体。针对专用工作流程自定义模型,然后将其部署到受支持的环境中。
该版本包括基础、后训练和 NVFP4 量化检查点,以及训练方法、数据和强化学习环境。
请参阅 Nemotron 3.5 技术报告了解模型详情,并参阅 Hugging Face 或 ModelScope 了解部署说明。有关托管模型访问,请参阅 OpenRouter。
合作伙伴生态系统
合作伙伴支持针对特定领域工作流定制和部署 Nemotron 3.5 Super VL。
View partners:
- AfterQuery
- AgileRL
- AI21
- Alice
- 应用计算
- Baseten
- 定制实验室
- Databricks
- 蒸实验室
- Fastino Labs
- Fireworks AI
- 握手
- Mercor
- Mindbeam
- ms-swift
- 多元宇宙计算
- Prime Intellect
- Reasonable
- 河流 AI
- 扩展 AI
- 思考机器实验室 (Tinker)
- TNG
- 轨迹
- Aible
- 克莱因 (Cline)
- Hermes 智能体
- 千克码
- LangChain
- LM Studio 仿生
- OpenClaw
- OpenCode
- 开放之手 ( OpenHands)
- 圆周率
- Amazon SageMaker JumpStart
- Google Cloud Gemini Enterprise Agent Platform
- MSFT Foundry
- OCI 企业 AI
- HCLTech
- Infosys
- Tata 咨询服务
- 艺术作品

