

随着大语言模型 (LLM) 推理越来越多地在个人、企业和受监管环境中处理敏感信息和专有模型上下文,数据必须在可信环境中处理。NVIDIA 机密计算 (CC) 为使用内存加密的机密虚拟机 (CVM) 、机密 GPU 和加密的 NVIDIA NVLink 安全运行这些工作负载提供了途径。这使得在可信硬件上运行生产级 AI 推理成为可能。
NVIDIA TensorRT LLM 等推理框架通过将框架级优化与 NVIDIA 加速计算相结合,提供出色的 AI 推理。但是,当这些框架在支持 CC 的环境中运行时,安全执行会改变内存移动、定时、调度和多 GPU 通信背后的假设。如果运行时无法适应,这些更改会产生性能开销。因此,保持高性能需要同时优化推理框架和机密计算环境。
对于在 NVIDIA Blackwell GPU 上评估机密推理的 AI 平台工程师,本文将探讨 AI 推理框架 (如 TensorRT LLM) 如何在有助于保持推理性能的同时实现安全执行。它提供了一种受控方法,团队可以应用该方法来量化其工作负载的 CC 开销。
选择工作负载以公开 CC 开销
工作负载特性决定了 CC 开销的可见程度。高请求量可以通过将停顿与其他工作重叠来分摊固定的加密成本,从而使直接效果更难以观察。
要展示这些效果,请选择具有长输入上下文、扩展输出生成和低并发的工作负载。长上下文会在预填充期间强调数据移动,扩展生成会在解码期间放大较小的每 token CC 开销,而低并发限制了在并发请求中隐藏这些成本的机会。
NVIDIA 性能工程团队将这些特征用于此处评估的工作负载。
| 参数 | 配置 |
|---|---|
| 模型 | NVIDIA/ DeepSeek-R1-0528-NVFP4 |
| 推理框架 | TensorRT LLM、PyTorch 后端 |
| I/ O 序列长度 | 32K 输入/ 1K 输出 |
| 并发请求 | 1, 2, 4, 8, 和 16 |
| 并行性 | TP = 8,EP = 1,PP = 1 |
| KV 缓存 | FP8 |
通过受控 CC-on 和 CC-off 比较测量 CC 开销
为了隔离 CC 对性能的影响,请在两种条件下运行相同的工作负载:机密计算禁用 (CC 关闭) 和机密计算启用 (CC 开启) ,以保持模型、硬件、框架版本、序列长度、并行性和并发常数,使 CC 状态成为唯一变化的变量。
在每个并发级别:
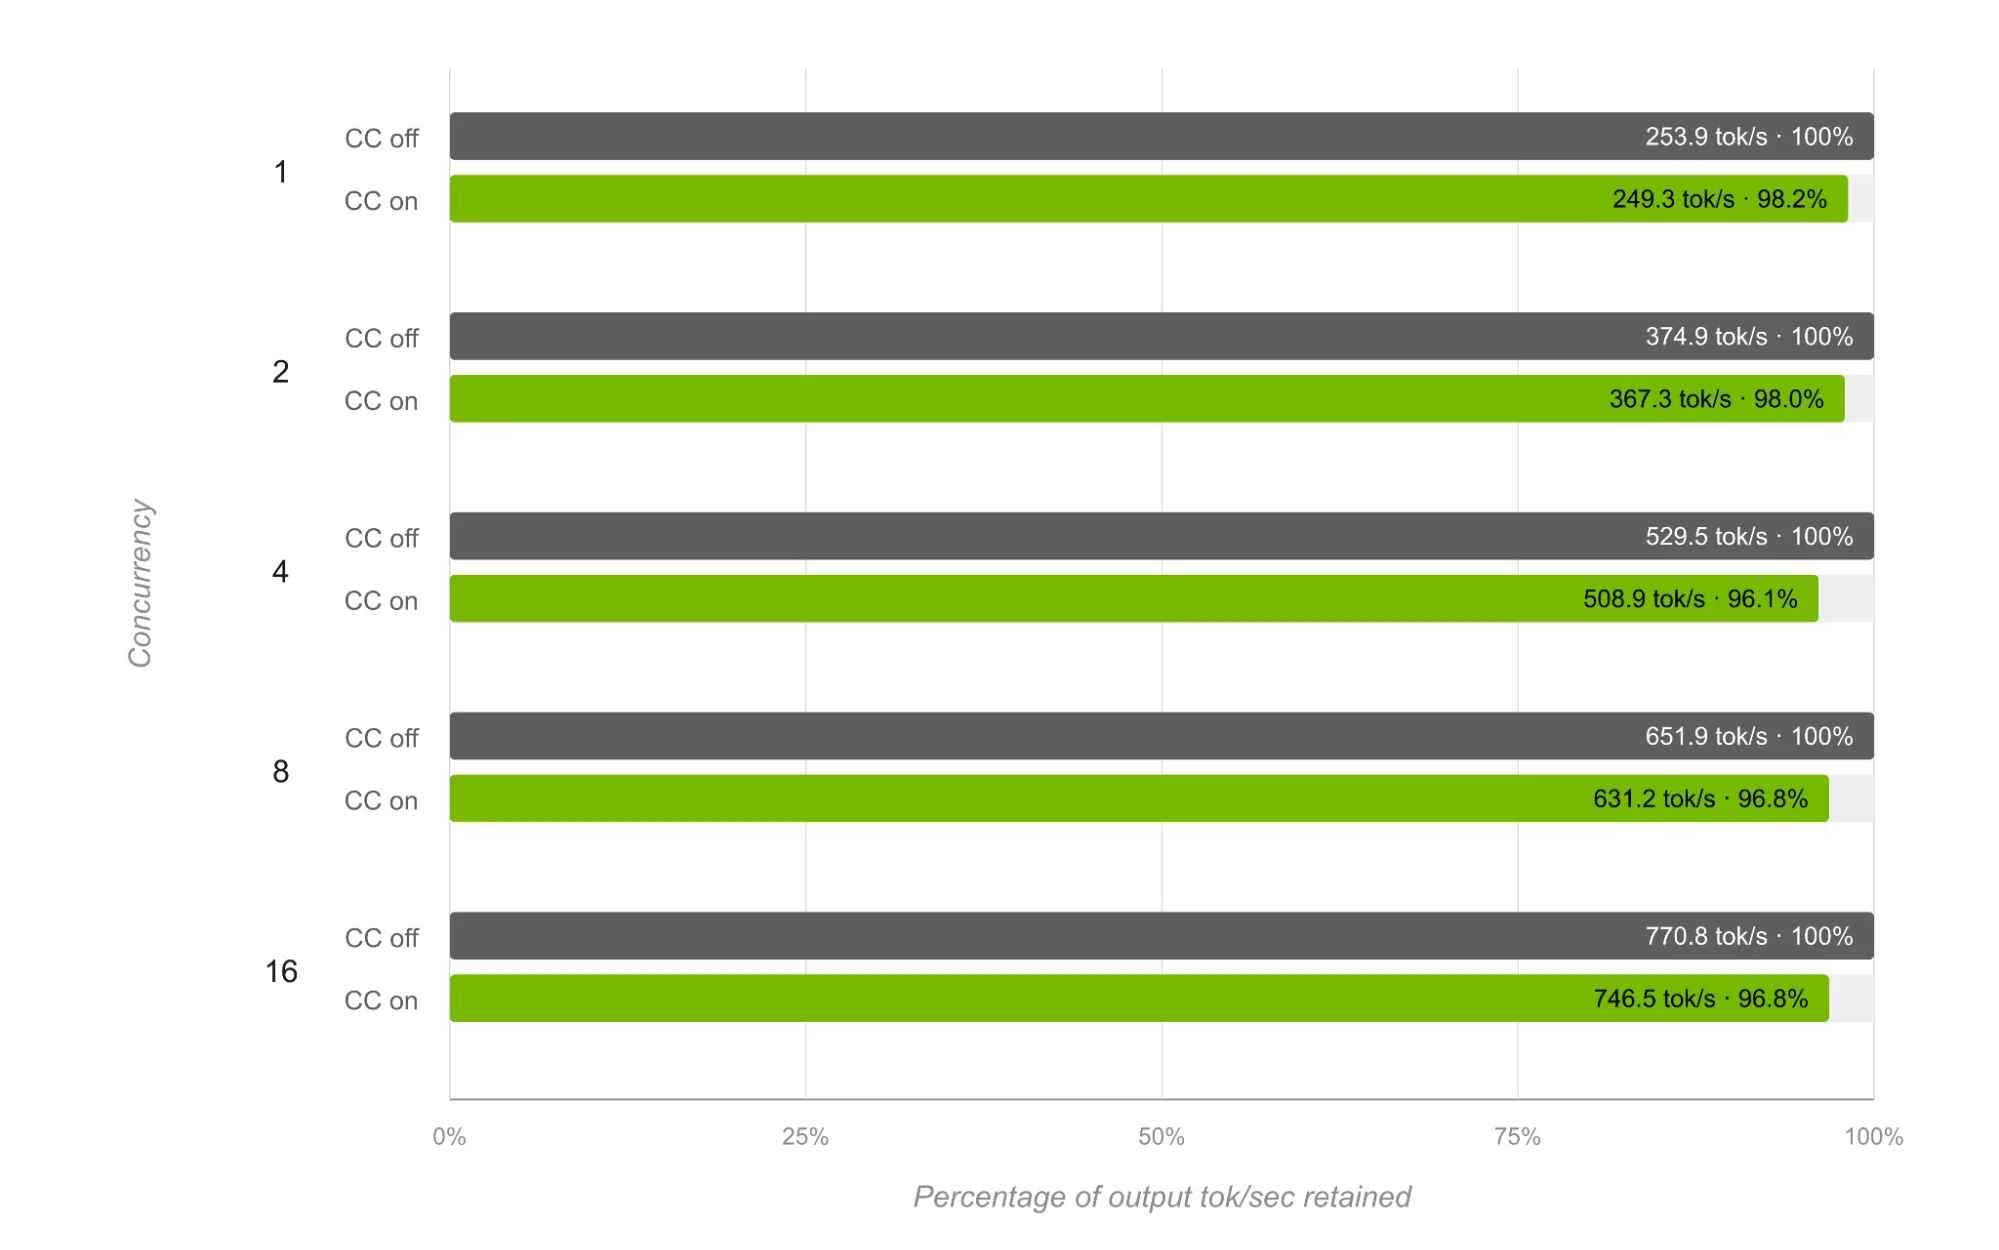
- 保留的输出吞吐量:100 x (CC on output tokens/s ÷ CC off output tokens/s)
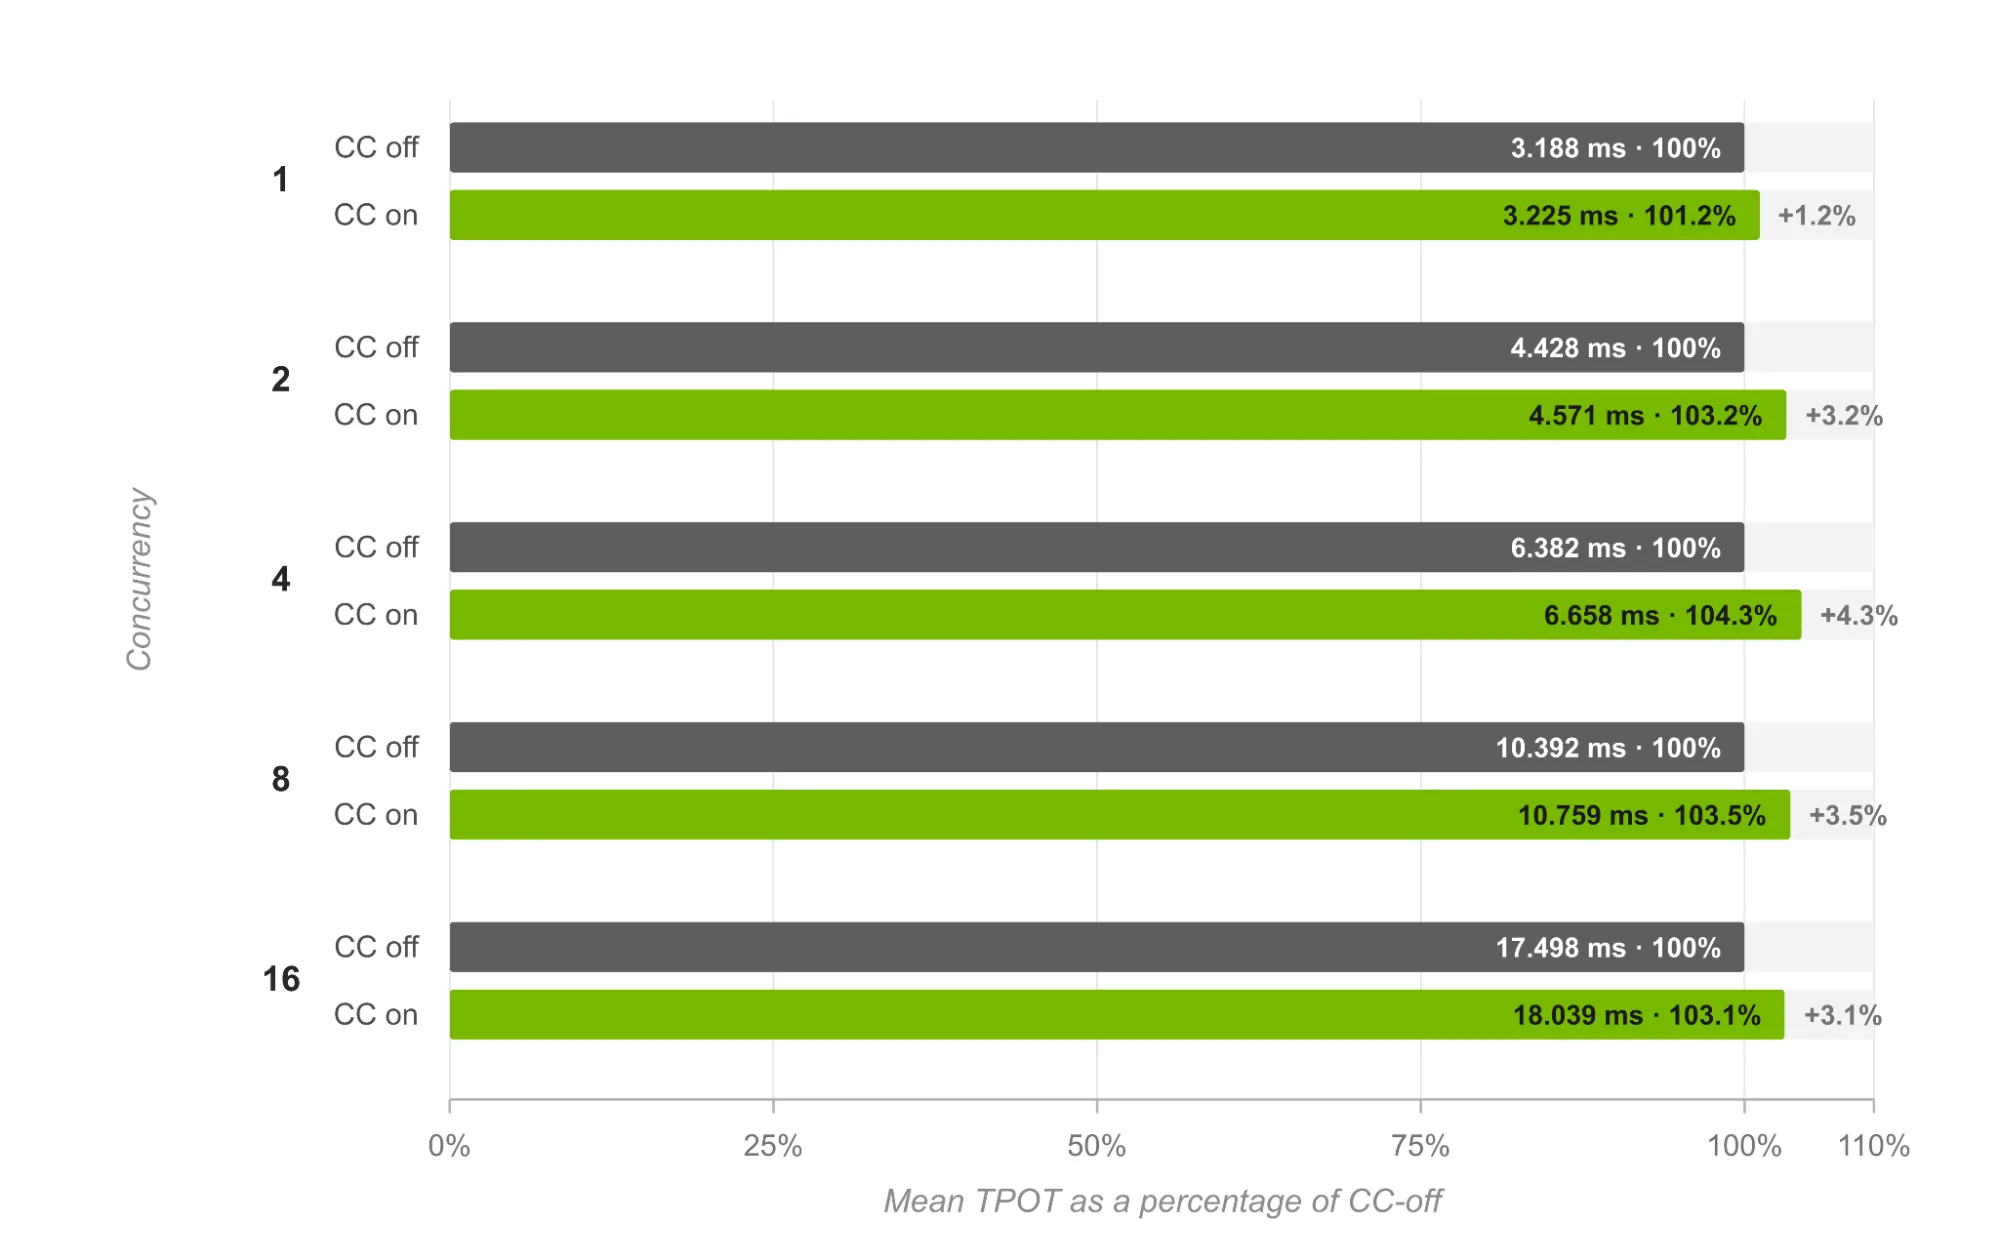
- 每个输出token的延迟开销时间 (TPOT) :100 x (CC on TPOT ÷ CC off TPOT − 1)
性能团队可以使用这些测量结果来量化在为目标工作负载启用 CC 时,CC off 基准得到保留的比例。NVIDIA 性能工程团队使用表 2 中总结的硬件和软件配置进行了比较。
| 组件 | 版本/ 详情 |
|---|---|
| 硬件 | 1 个 NVIDIA DGX B200 系统 ( 8 个 NVIDIA B200 GPU) |
| 平台 | 英特尔 TDX |
| 主机操作系统 | Ubuntu 25.10 |
| 主机内核 | 6.17.0-20 通用 |
| 客户机操作系统 | Ubuntu 24.04.4 LTS |
| 客户机内核 | 6.8.0-124 通用 |
| 客户机 vCPU | 256 |
| 用户 NUMA | 2 个节点 |
| NVIDIA 驱动 | 595.71.05 |
| VBIOS | FW 1.4.x[97.10.64.00.0C] |
| GPU 功率限制 | 1000 瓦 |
| CUDA | 13.2 |
| TensorRT LLM | nvcr.io/nvidia/tensorrt-llm/release:1.3.0rc22 |
| NCCL | v2.30 |
| OpenSSL | 3.6.0 |
| 编排 | Docker 容器 NVIDIA 容器工具包 |
性能结果
如图 1 和 2 所示,在并发 1 – 16 之间,CC-on 保留了 96.1 – 98.2% 的 CC-off 输出 token 吞吐量,而平均 TPOT 仍保持在基准的 1.2% 至 4.3% 范围内。
识别并减少 CC 开销
NVIDIA Blackwell 机密计算架构引入了硬件增强的安全路径,用于保护使用中的数据和工作负载。有关该架构的详细概述,请参阅不会拖慢您速度的基于硬件的 AI 安全性。
对于 TensorRT LLM 用户和框架开发者,以下详细信息展示了这些安全路径如何改变常见的运行时假设,以及 TensorRT LLM 如何进行调整以减少由此产生的性能开销。
调整主机到设备的数据移动
在 B200 CC 中,由于 GPU 无法直接访问受保护的 CVM 内存,主机到设备的传输会通过软件加密的反弹缓冲区。这改变了推理框架的预期行为:固定内存不再提供其通常的异步传输优势,并且一些副本会阻止调用线程。
- 主机到设备缓解措施:TensorRT LLM 使用 CC-aware 显存选择,为受影响的路径选择可分页显存,而不是无条件地使用固定显存。
- 设备到主机的缓解措施:TensorRT LLM 将重复 token 和采样数据读回移动到异步工作进程,防止受保护的副本在解码期间阻塞主调度程序。有关详细信息,请参阅 TensorRT LLMPR# 11573。
稳定内核自动调整程序定时
内核自动调整程序通常使用 CUDA 事件来比较候选战术。在测试的 CC 配置中,CUDA 事件时间产生了不稳定的定时信号,这可能会导致自动调整器选择较慢的策略。
- 缓解:TensorRT LLM 使用 GPU
%globaltimer在 CC 下进行战术测量,同时在 CC 外部保留 CUDA 事件。有关详细信息,请参阅 TensorRT LLMPR# 11657。
选择 CC 感知型多 GPU 通信
NVLS (NVLink SHARP) 组播在 B200 CC 配置中不可用。如果没有 NVLS,NCCL_SYMMETRIC 无法提供预期的组播优势,但在使用非组播集合路径之前,仍可能会产生内存注册和交叉秩同步成本。
- 缓解:针对 CC 的框架应检测 NVLS 的可用性,并选择能够针对给定的消息大小、拓扑和工作负载特征更大限度地减少延迟的通信算法。
开始使用 NVIDIA 机密计算
NVIDIA 机密计算将硬件强制保护扩展到机密 VM、NVIDIA Blackwell GPU 和加密 NVLink,在处理过程中保护专有模型、企业环境和敏感提示。
机密计算并没有消除对性能工程的需求,而是使框架感知变得更加重要。借助 TensorRT LLM CC-aware 自适应功能来确保数据传输、自动调整和多 GPU 通信的就位,机密 DeepSeek-R1 推理可在 8 个 NVIDIA B200 GPU 上保留超过 96% 的 CC off 输出 token 吞吐量,同时将每个token的延迟开销保持在 5% 以下。
随着组织将私有推理转移到生产环境中,安全配置和推理优化应作为单一部署问题来处理。启用机密计算、验证环境,并使用您要服务的确切工作负载对 CC 开启和关闭进行基准测试。对于 AI 平台工程师和 TensorRT LLM 用户将私有推理迁移到生产环境中时,应将安全配置和推理优化视为全栈工程工作。
要开始规划机密推理部署,请使用 NVIDIA 可信计算文档 并探索新的 TensorRT LLM 功能和版本说明。如需及时了解最新进展,请关注 NVIDIA 机密计算新闻。
致谢
我要感谢 Dan Hansen、Sheel Pethe、Samuel Mendoza-Jonas、Moein Ghaniyoun、Vidhya Krishnan、Avinash Ahuja、Laikh Tewari、Laura Martinez 和 Matheen Rza 在整个工作过程中所做的工程贡献、技术指导、分析和周到的审查。
