

从分子化学到材料科学,许多科学模拟的大部分执行时间都在计算高精度密集通用矩阵乘法 (GEMM) 。这些运算称为 DGEMM (用于真实的 64 位浮点数) 和 ZGEMM (用于复杂的 64 位浮点数) 。cuBLAS 广泛用于 HPC 和 AI 应用,以加速 NVIDIA GPU 上的 GEMM 和其他基本线性代数子程序 (BLAS) 。低精度硬件的快速发展推动了对新型算法的探索,这些算法可在更快的整数 Tensor Core 上提供完整的双精度结果。
借助 CUDA 工具包 13.4.2,cuBLAS 无需再在准确性和速度之间做出选择。cuBLAS 将每个双精度数字分解为整数块,在 GPU 的 Tensor Core 上对其进行乘积,然后重新组合确切的结果。答案保持完全的双精度精度,但工作在速度更快的硬件上运行。
两种新算法使这种方法更加高效: Ozaki-II 需要的整数乘法更少,与早期的 Ozaki-I 方法相比,而 2M 方法 将复杂矩阵乘法从四个实数乘法减少到两个。这基于在 cuBLAS 中通过浮点仿真解锁 Tensor Core 性能 中引入的自动动态精度 (ADP) 框架,该框架通过将 FP64 算法映射到整数 Tensor Core 上,同时保留原生 FP64 精度,从而提供更高的双精度 (FP64) 矩阵乘法性能。
cuBLAS 可自动加速 DGEMM 和 ZGEMM,且无需更改应用程序代码。只有在不影响准确性的情况下,速度才至关重要,因此我们在现实世界的应用中验证了这两种情况:量子化学中的合单倍和双倍集群 (CCSD) 和材料科学中的 BerkeleyGW。本文将介绍算法的工作原理、基准测试和应用程序结果,并介绍如何开始。
性能亮点
CUDA 工具包 13.4.2 中的 cuBLAS 可带来以下性能提升:
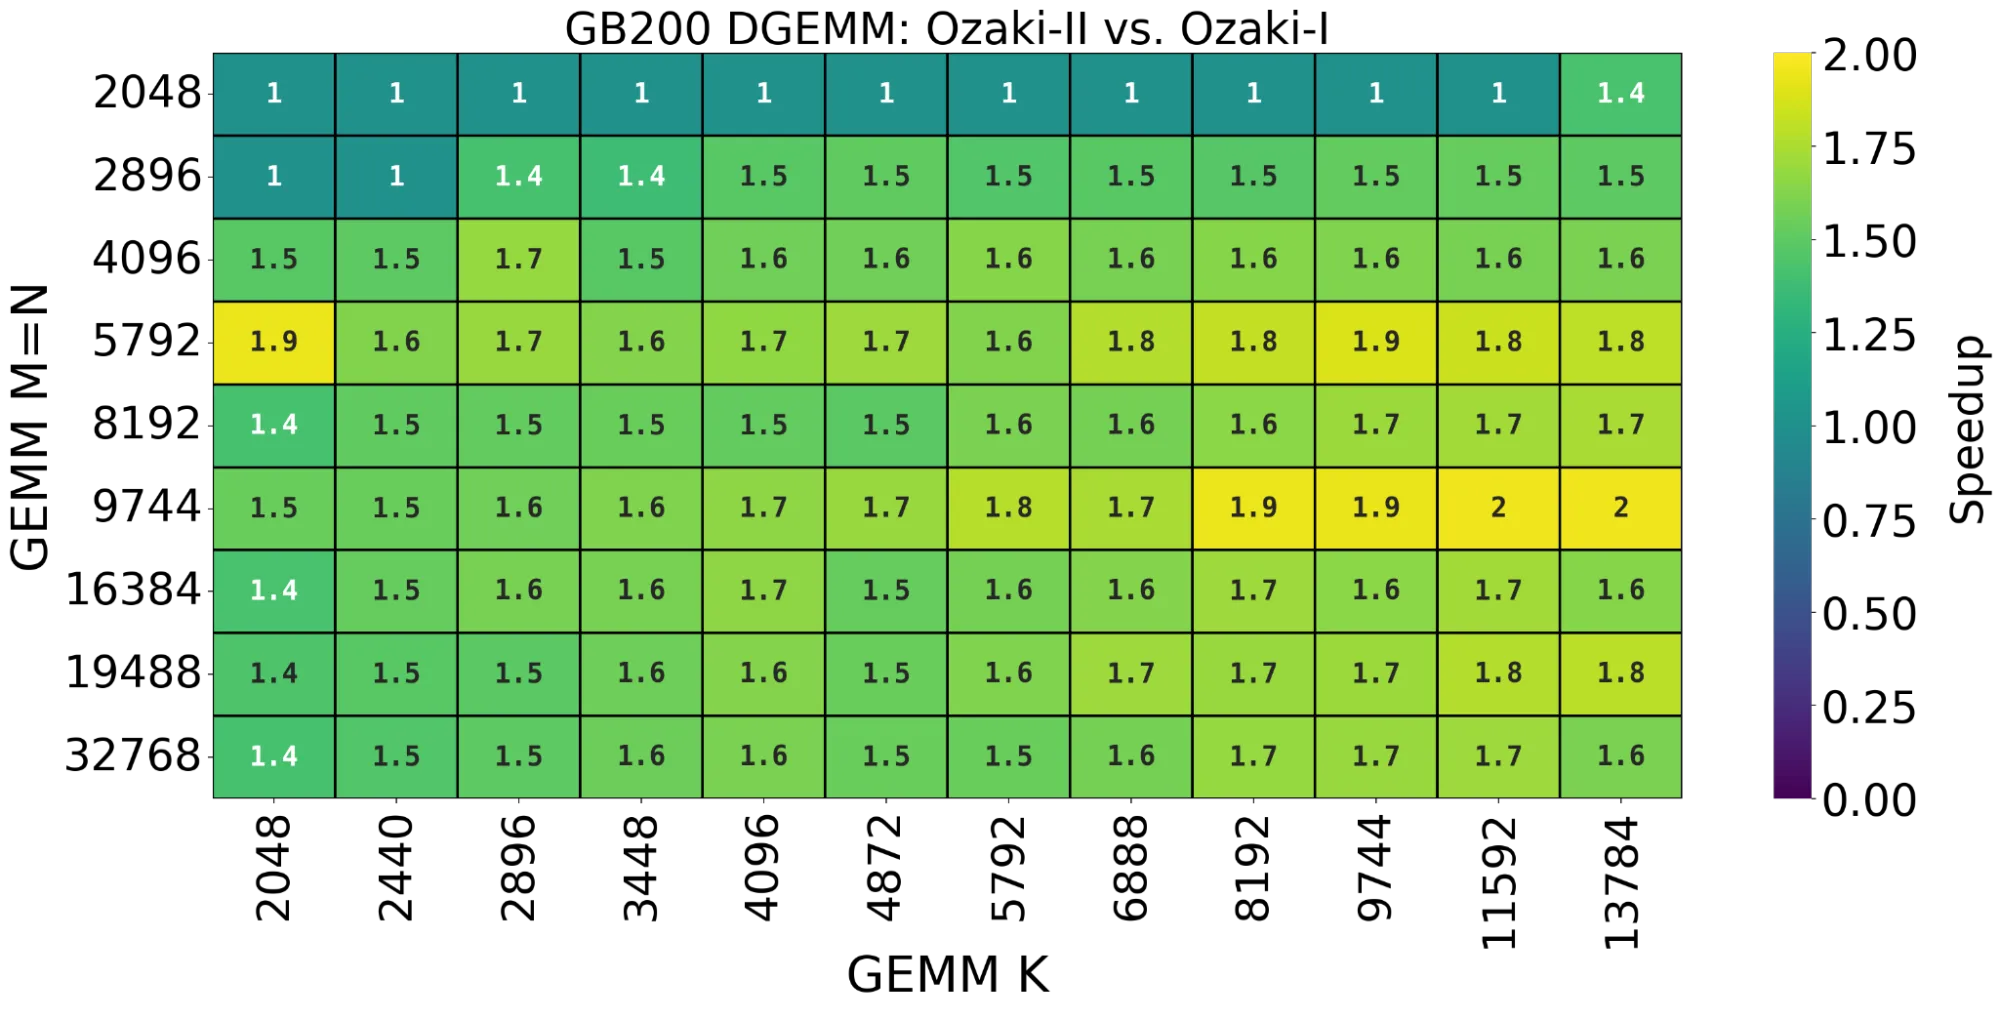
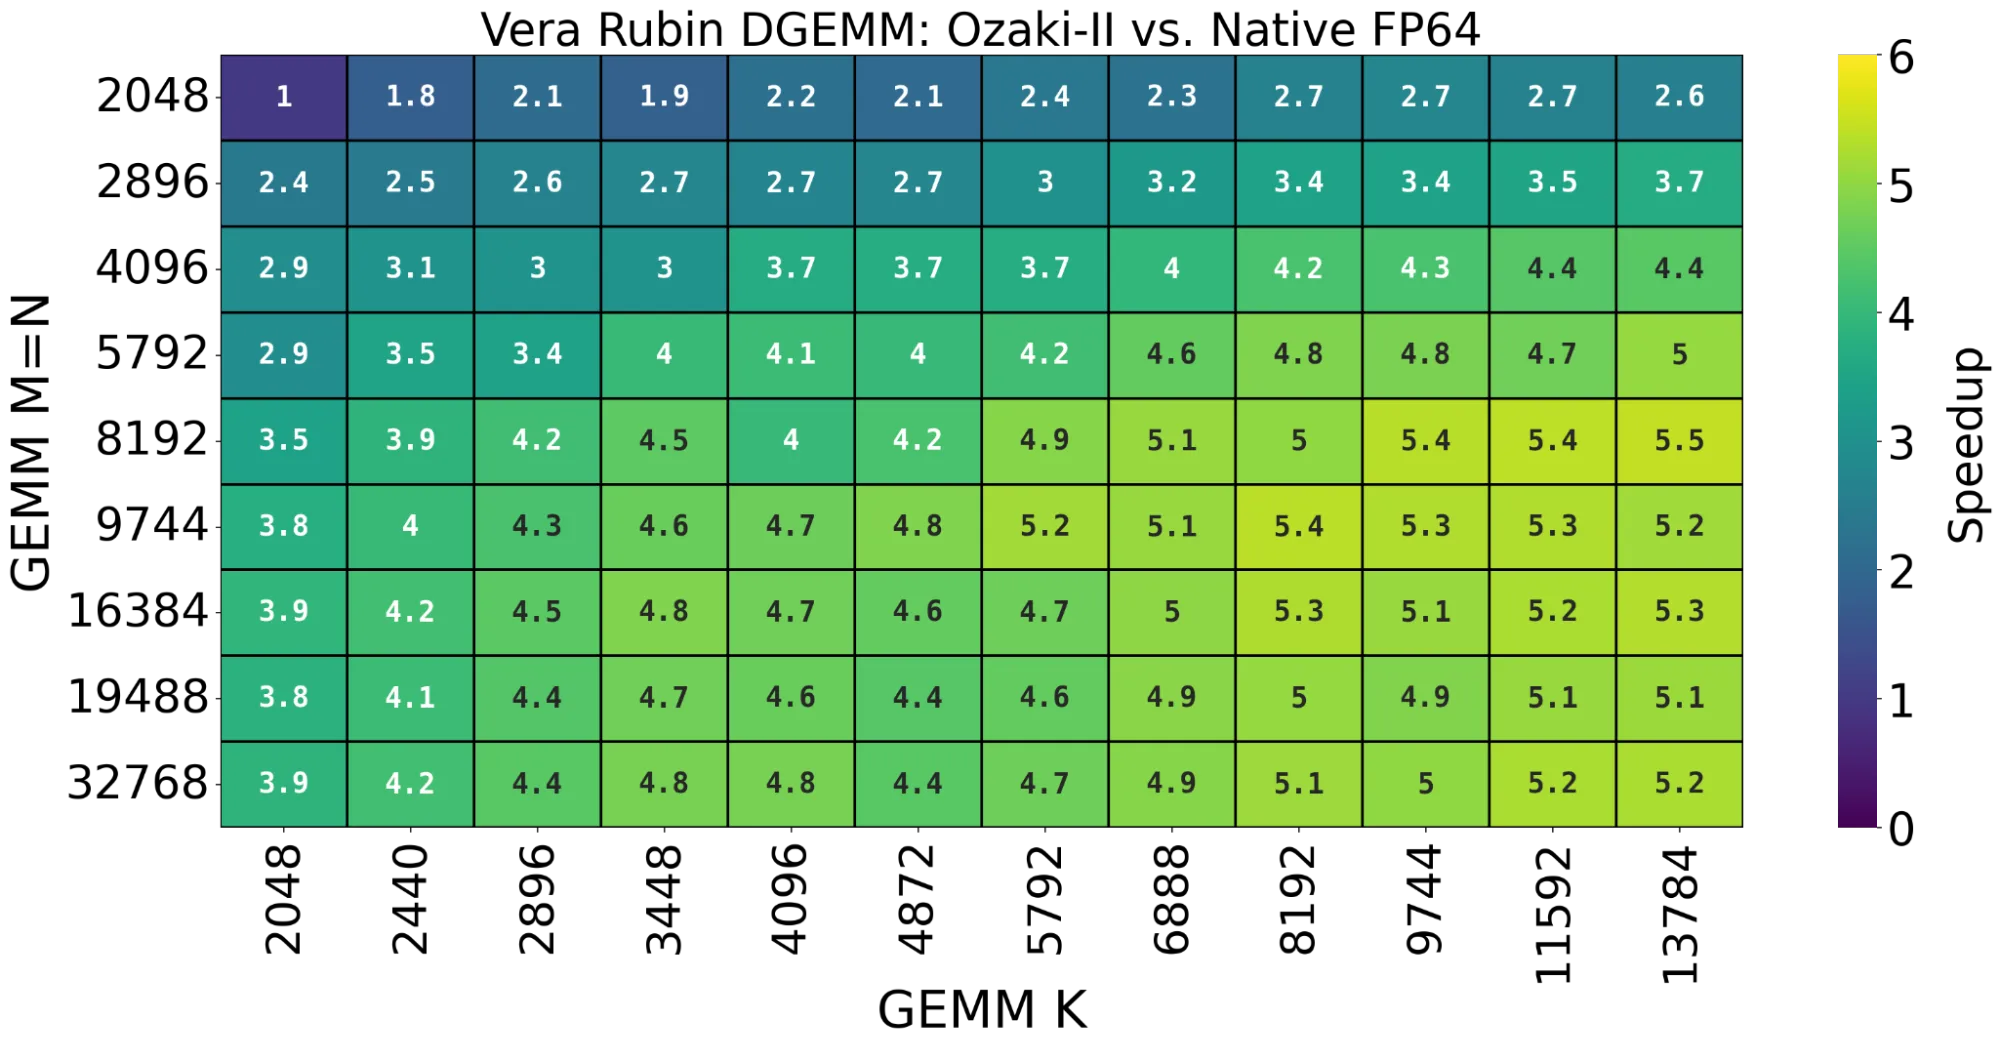
- 在 NVIDIA VR NVL72 和 NVIDIA GB200 上,搭载 Ozaki-II 的 cuBLAS DGEMM 的运行速度分别比原生 FP64 快 5.5 倍和 3.9 倍。在 NVIDIA GB200 上,它的速度比 Ozaki-I 快 2 倍。
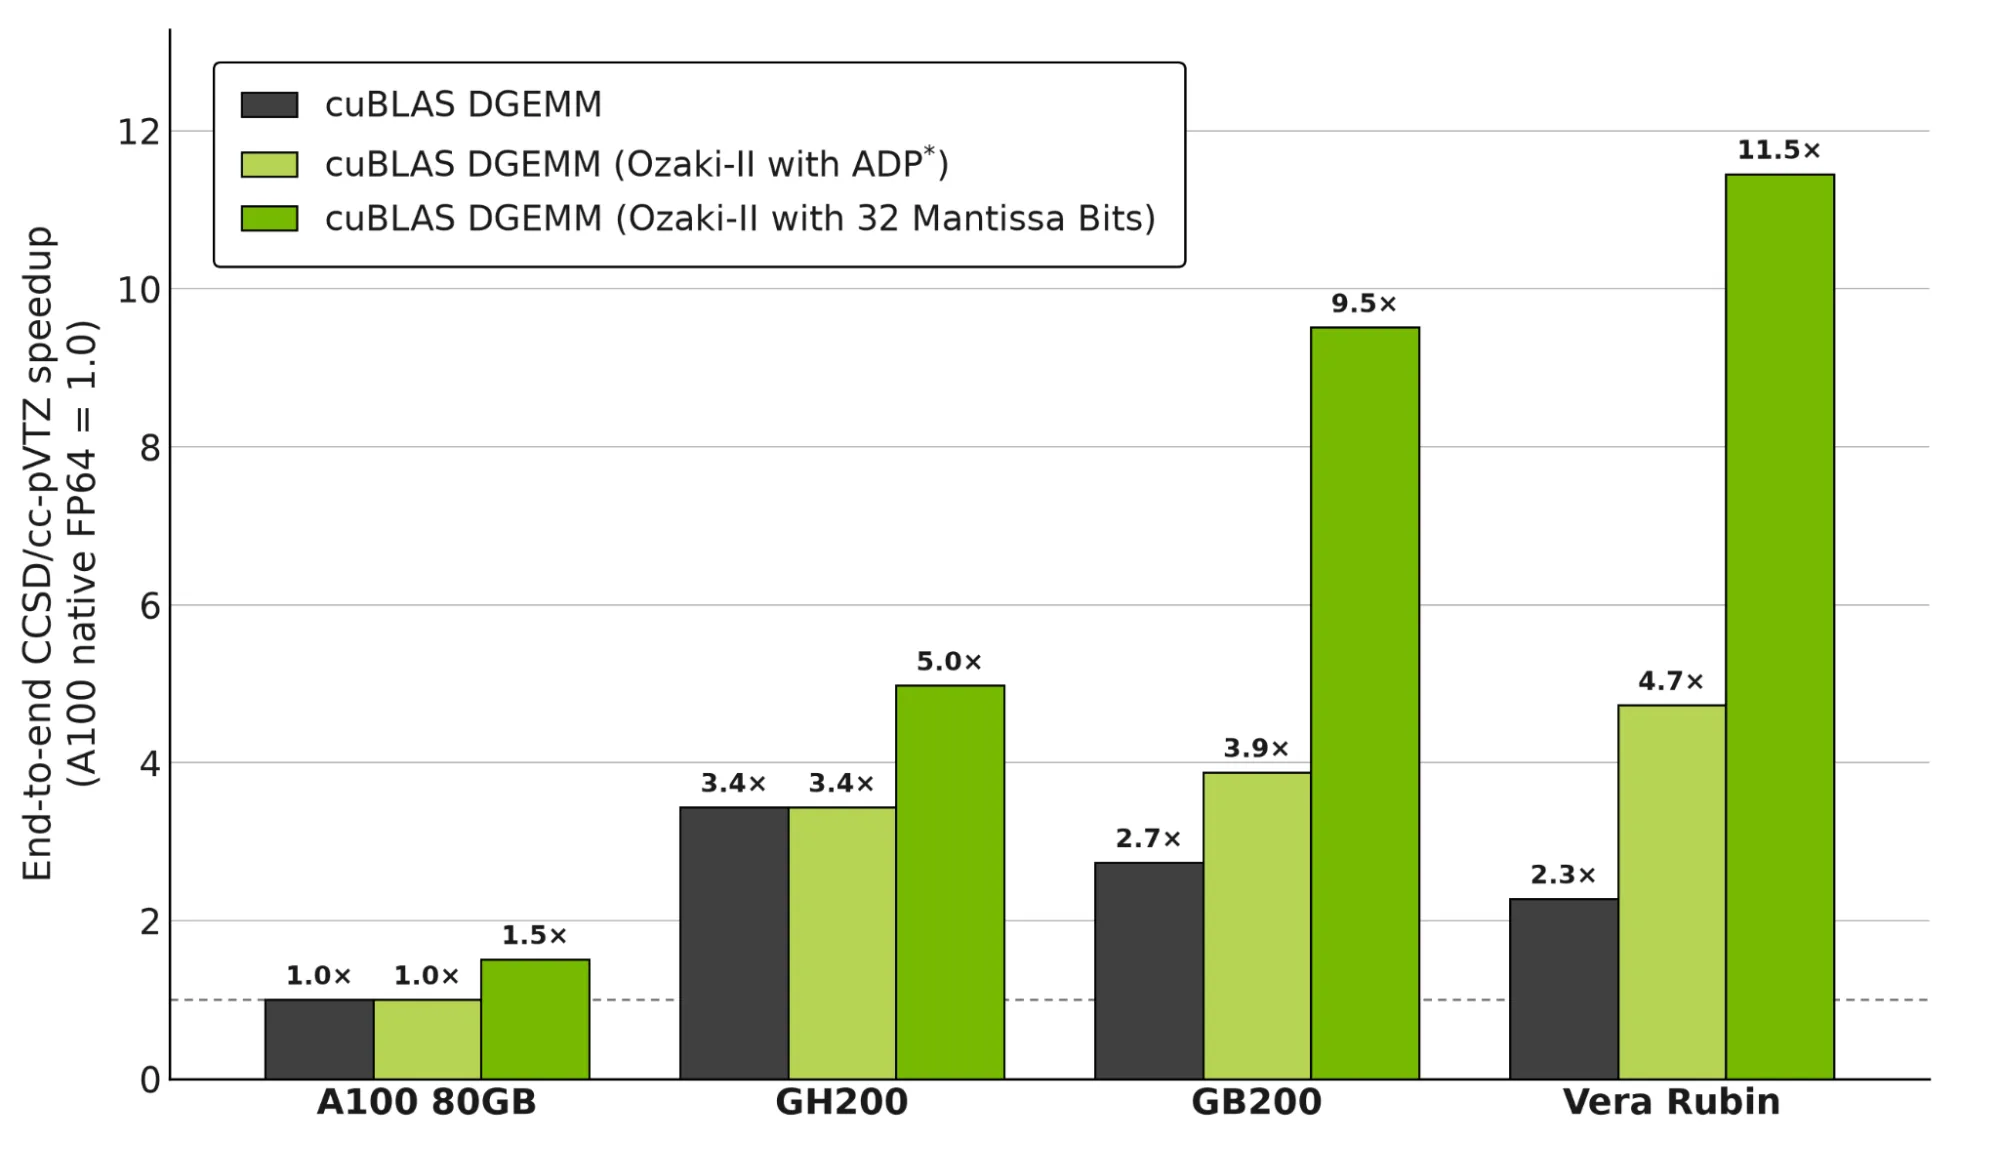
- CCSD 案例研究使用 cuBLAS DGEMM 和 Ozaki-II,在 NVIDIA VR NVL72 和 FP64 中的 NVIDIA GB200 上实现了 2 倍和 1.4 倍的原生 FP64 端到端加速。在特定领域的混合精度模式下,在 NVIDIA VR NVL72 和 NVIDIA GB200 上,端到端加速分别比原生 FP64 快 5 倍和 3.5 倍。
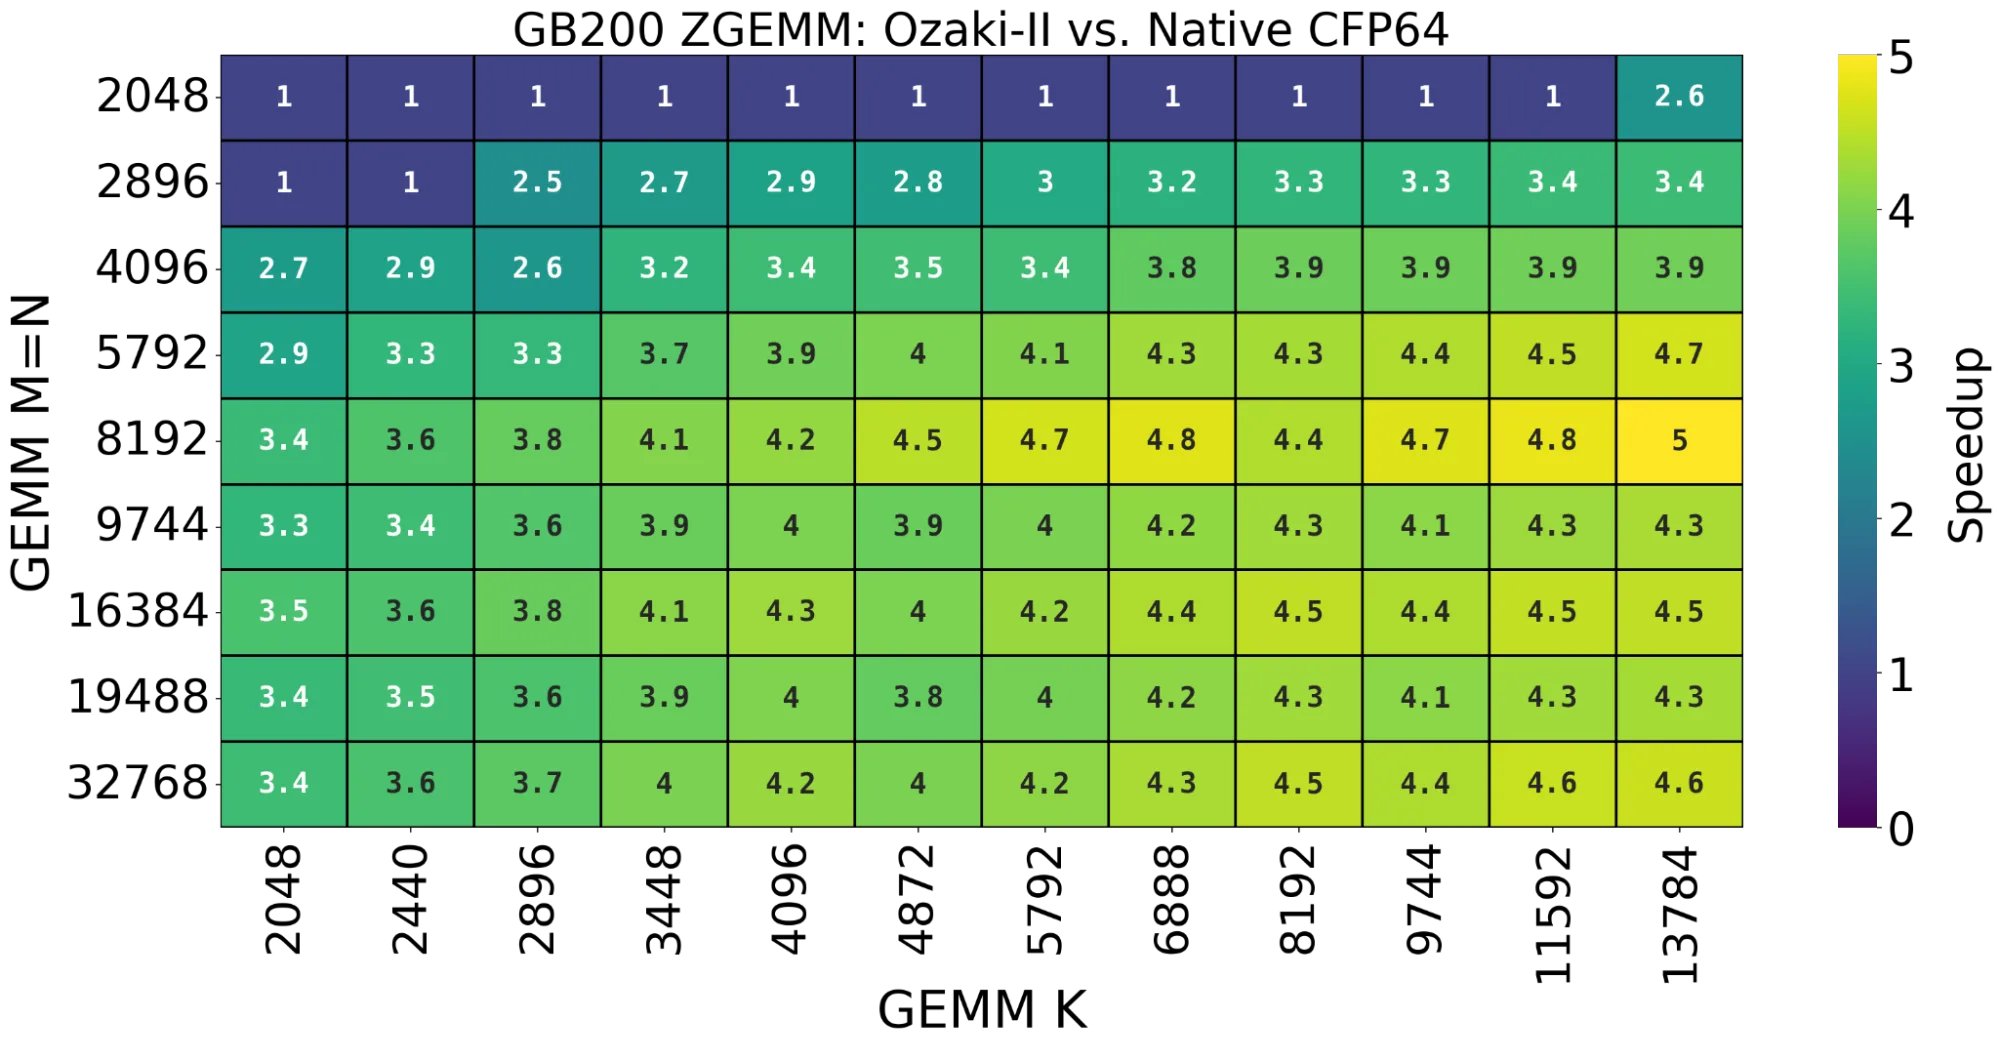
- 采用 2M 算法的 cuBLAS ZGEMM 在 NVIDIA GB200 上实现了比原生 Complex FP64 (CFP64) 快 5 倍的速度。
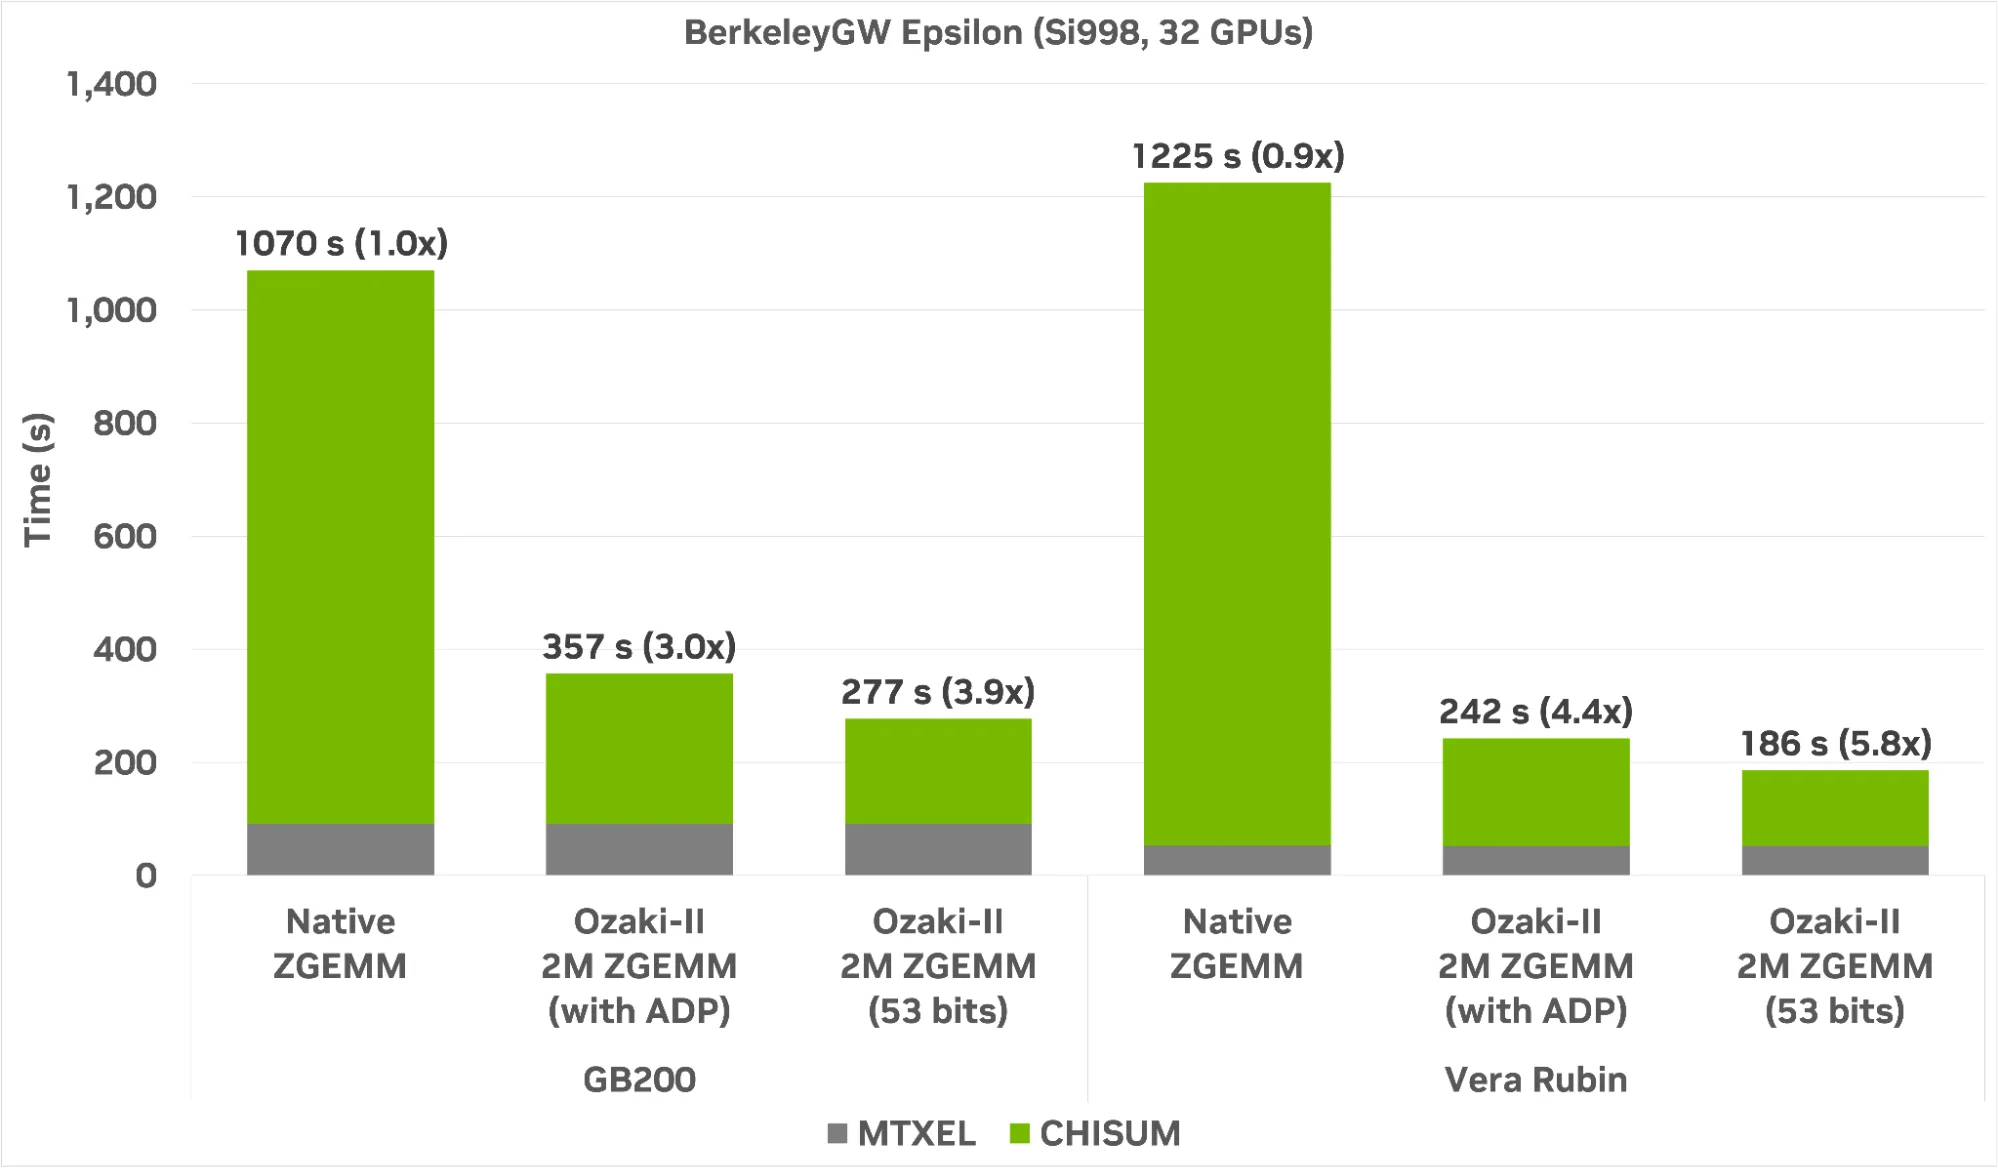
- BerkeleyGW 案例研究使用 cuBLAS ZGEMM 和 2M 算法,在 NVIDIA VR NVL72 和 NVIDIA GB200 上的速度分别比原生 ZGEMM 快 6.6 倍和 3.9 倍。
- 搭载 Ozaki-II 的 cuBLAS DGEMM 在 NVIDIA VR NVL72、NVIDIA GB200 和 NVIDIA RTX PRO 6000 上分别可实现高达 175、147 和 37 TFLOPS 的浮点运算能力。
从Ozaki-I 到 Ozaki-II
Ozaki-I 和 Ozaki-II 方案具有共同的第一步,但执行大整数乘法的方式有所不同。两种方案都会对齐输入矩阵的指数,并将其转换为共享指数、可变长度的整数表示,以便乘积精确地在整数 Tensor Core 上累加。cuBLAS 使用启发式算法自动在 Ozaki-I 和 Ozaki-II 之间进行选择,以获得最佳性能。整数宽度由 ADP 在运行时选择,也可以由用户显式设置。
Ozaki-I 将每个大的整数分解为 8 位切片,并以三角形模式将 A 的切片与 B 的切片相乘,因此 Tensor Core GEMM 的数量会随着切片数量的平方而增长。
Ozaki-II 使用一种基于中国剩余定理 (CRT) 的更快的大整数乘法算法。它将每个量化的操作数归约为一组小的成对互质整数,为每个模精确执行一个整数 GEMM ,并从残差中重建确切的乘积。对于 Ozaki-II,GEMM 计数在模数上是线性的,而 Ozaki-I 则随着切片数量的平方而增长,因此优势会随着精度目标的提高而扩大。在匹配 FP64 所需的准确性方面, Ozaki-I 需要的 Tensor Core GEMM 数量大约是 Ozaki-II 的两倍。
由于 Ozaki-II 可实现每个模量一个残基对,因此简单实现会比 Ozaki-I 占用更大的工作空间。但是,cuBLAS 已经将在 CTK 13.3 中为 Ozaki-I 引入的内存稀疏平铺技术应用到 Ozaki-II 方案中,在 GEMM 之后立即丢弃每个残基对。这样可以实现更易于管理的工作空间大小。
cuBLAS ADP 框架旨在提供与标准浮点 GEMM 算法相当或更好的准确性保证。有关定点方法准确性的更多信息,请参阅参考资料。如果在运行时,保持 FP64 等效精度所需的尾数位数量超过了库默认值或用户提供的最大值,cuBLAS 会回退到使用原生 FP64 MMA 指令的代码路径。因此,应用程序可以在其生产部署中安全地使用 cuBLAS,而无需担心数值准确性。下面的图 1 显示了在 GB200 上使用 Ozaki-II 的 cuBLAS DGEMM 相较于 Ozaki-I 的加速情况。
DGEMM 性能
NVIDIA Rubin
Rubin 引入了一种新的数字格式 TI16 ( 12 位整数,符号量级格式,范围为[-2047,+ 2047]) ,非常适合加速 Ozaki 方案计算。cuBLAS 13.4 使用 TI16 类型,通过 NVIDIA Rubin GPU 上的 tcgen05.mma 指令加速 Ozaki-I 和 Ozaki-II 计算 (计算能力 10.7) 。下图 2 显示了在 VR NVL72 上使用 Ozaki-II 的 cuBLAS DGEMM 相较于原生 FP64 的加速情况。
DGEMM 应用性能 – 量子化学中的 CCSD
为了展示 Ozaki-II DGEMM 的潜在应用性能,我们考虑了合单集群和双集群 (CCSD) 的用例。CCSD 是电子结构中的一种基础性后 DFT 方法,与 (T) 微扰校正 (此处未考虑) 共同构成了量子化学的“黄金标准”。
此外,CCSD 对各种微扰的响应产生了电子激发态的 EOM-CCSD 处理和属性计算的 CCSD lambda 处理。CCSD 值得注意的是,密集 FP64 张量收缩的成本极高,而 cuBLAS 中的 Ozaki-II 方案可以显著加速这一过程。
在 CTK 13.4.2 中使用 cuBLAS 对主要张量收缩进行了小型 CCSD 演示,并使用 cuEST v0.2.2 加速了合集群问题设置。在密度拟合表示中构建了标准的 FP64 单 GPU T1 转换受限 CCSD 方法。下图 3 显示了 S22 数据库中五个中型成员的冻结核心 CCSD/ CC – pVTZ 性能数据,这些系统包含 24 – 28 个原子和大约 590 – 630 个原子轨道。
配备 ESC 的 Ozaki-II DGEMM 可保证完整的 FP64 精度,从而使性能随着时间的推移而单调地提升,与 A100 相比,Rubin 的总速度提高了 4.7 倍。另一个引人注目的可能性是使用特定于应用程序的混合精度模式,具有固定的 Ozaki-II 尾数位预算,此处选择了 32 尾数位。这也带来了单调的性能提升,目前总加速为原生 FP64 A100 的 11.5 倍。使用全 FP64 质量的 ESC 时,结果与原生 FP64 精度无异,CCSD 相关能的误差为<10-14 Eh。
Ozaki-II 模拟提供了使用 32 个尾数位的较低固定精度的机会,同时仍然为绝大多数实际应用提供足够的准确性;能量误差 <10-10 Eh ,幅度方程可以收到残差 10-9 或更高。
在 Rubin for uracil dimer frozen-core CCSD/cc-pVTZ上,32 个尾数位的固定精度可实现 173 TFLOPS 的端到端吞吐量;单个 GEMM 的吞吐量高达 368 TFLOPS,平均 GEMM 吞吐量为 200 TFLOPS。在求解分子属性计算所需的 CCSD lambda 响应方程期间,也可获得类似的吞吐量 (图中未显示) 。
复杂的 GEMM:从 4M 到 3M 再到 2M
通常,我们会将复杂的 GEMM 计算为四个相同大小的真实 GEMM (4M) :
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
众所周知的 3M 算法将其简化为三个真实的 GEMM,加上二次时间预处理和后处理。在浮点运算中,3M 的使用非常谨慎,因为在重建过程中形成 Ar = Ai 和 Br = Bi 的总和并减去中间乘积会降低数值稳定性。
在 Ozaki-II 方案中,加法、减法和乘积都是精确的整数运算,因此复杂乘法的选择不再影响结果的准确性。两个复数的乘积不能少于三次实数乘法,但此精确整数设置中的矩阵乘积不受该结果的约束:2M 算法仅计算具有两个真实 GEMM (而非四个) 的复杂乘积。最终结果是,现在 ZGEMM 的成本大约是相同大小的实际 GEMM 的两倍,而不是原来的四倍。完整的推导结果可在 2M 论文中找到。
从 CUDA 工具包 13.4 开始,cuBLAS 使用 2M 算法来加速 ZGEMM,图 4 显示了在 GB200 上,2M + Ozaki-II方案比传统 4M 方法实现的加速。
ZGEMM 应用程序性能 – BerkeleyGW
研究人员使用 BerkeleyGW 代码来研究因电子如何改变能量状态而产生的材料的物理性质。这是一种大规模并行代码,已在领先的超级计算机上得到全面使用。与仅使用 CPU 的实现相比,将 GPU 与 BerkeleyGW 结合使用可将性能提升 86 倍,并且可以通过 ZGEMM 的最新 cuBLAS 增强功能进一步加速。
默认情况下,cuBLAS 使用其 ADP 框架来确定参数,以提供与 BerkeleyGW Epsilon 模块的 CHISUM 例程中的标准复杂浮点 (CFP64) GEMM 算法相当或更好的准确性保证。系统会自动为用户完成此操作,而无需更改任何应用程序代码。我们在以下配置中评估了准确性和性能:Native ZGEMM、采用 ADP 的 Ozaki-II 2M 和采用 53 位的 Ozaki-II 2M,这些配置均可生成 NERSC-10 线束中指定的相同的 Epsilon 矩阵元素,使其达到小数点后 10 位。
在 GB200 上,从原生 ZGEMM 迁移到 53 位的 Ozaki-II 2M 可实现 3.9 倍的端到端加速。同样,我们观察到 VR NVL72 的速度提升了 6.6 倍。总体而言,我们观察到,从 Blackwell 上的原生 ZGEMM 到使用 VR NVL72 上 53 位的 Ozaki-II 2M 的 ZGEMM,速度提高了 5.8 倍。图 5 显示了在 32 个 Blackwell 和 Rubin GPU ( 2 个 Grace CPU = 每节点 4 个 B200 GPU,2 个 Vera CPU = 每节点 4 个 R100 GPU) 上以参考问题大小 (Si998) 运行 BerkeleyGW 的 Epsilon 模块时的端到端性能加速。
DGEMM 在 GB200、RTX PRO 6000 上的性能
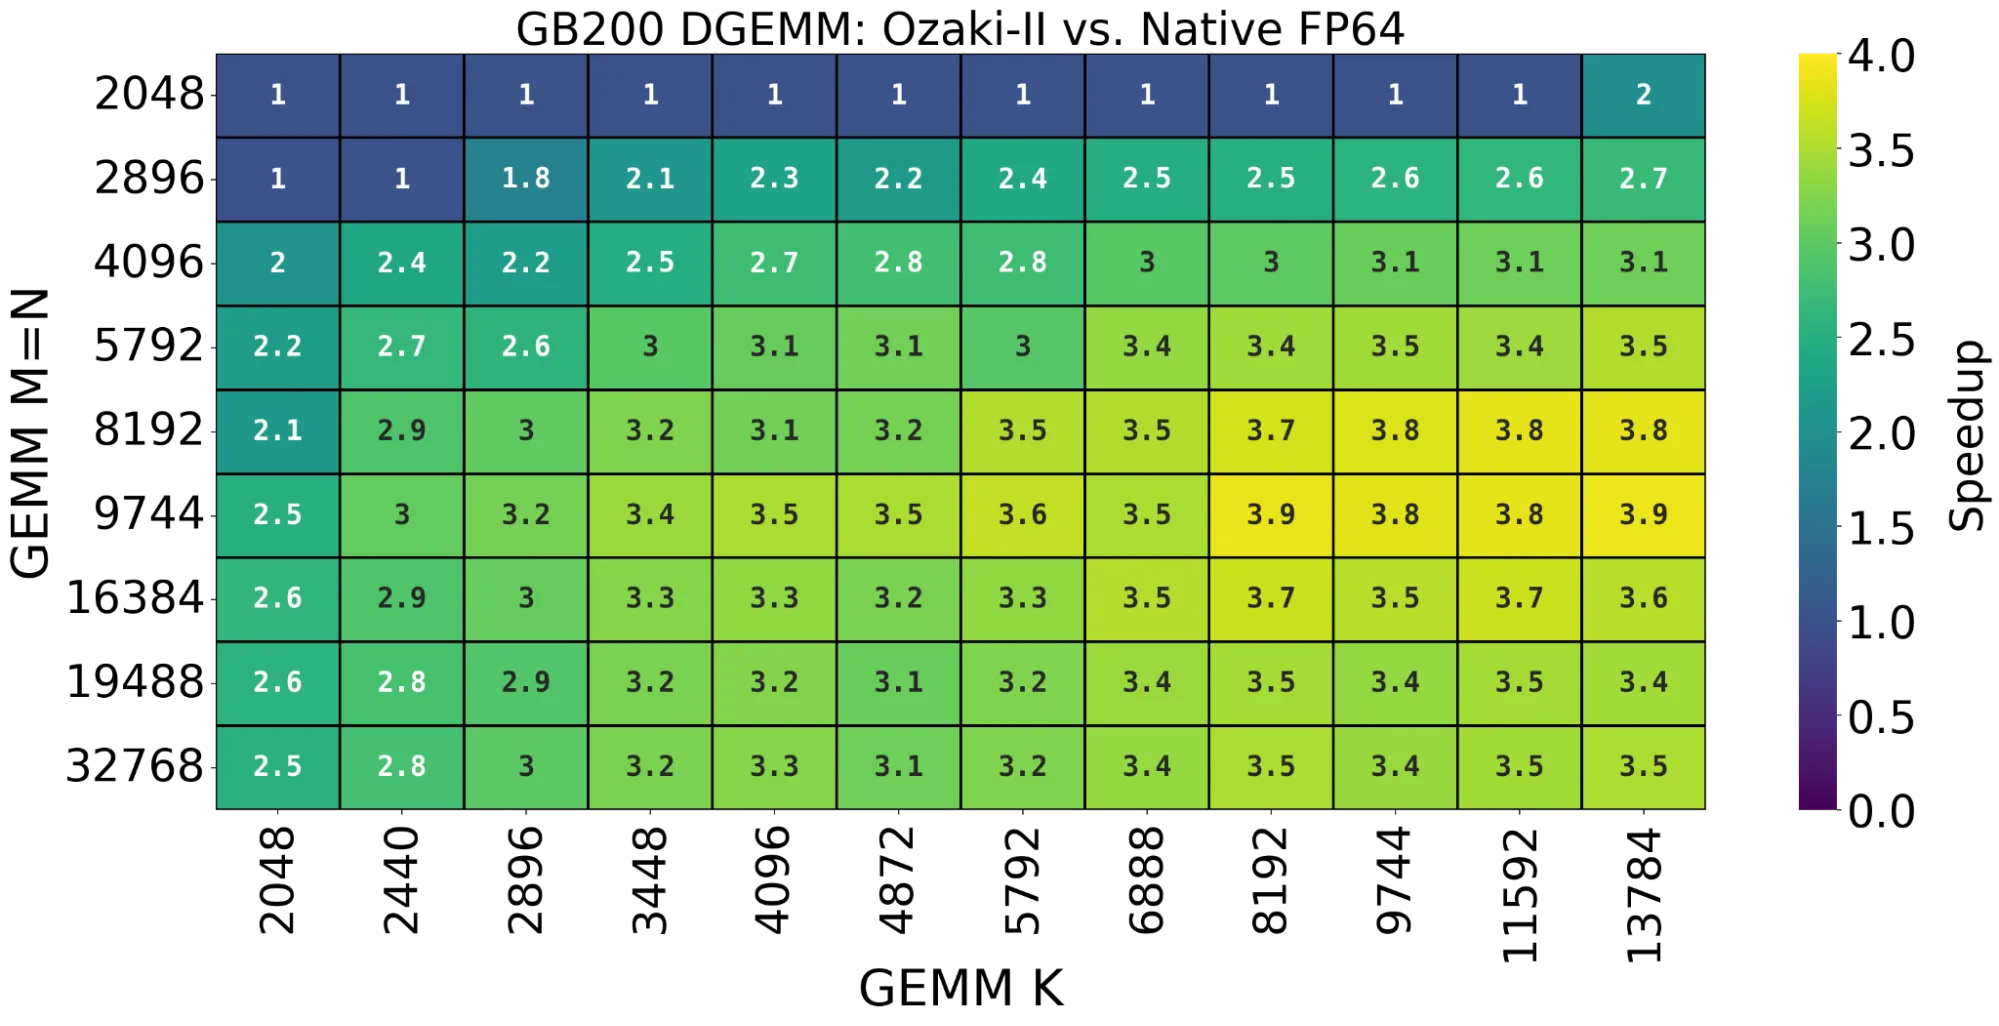
下面的图 6 显示了在 GB200 上,使用 Ozaki-II 的 DGEMM 相较于原生 FP64 的加速情况。对于最小的形状,ADP 已确定 Ozaki-II 路径没有优势,并将其发送到原生 FP64,但性能稳步提升,在测量最大的形状时,M、N 和 K 值达到 3.9 倍。
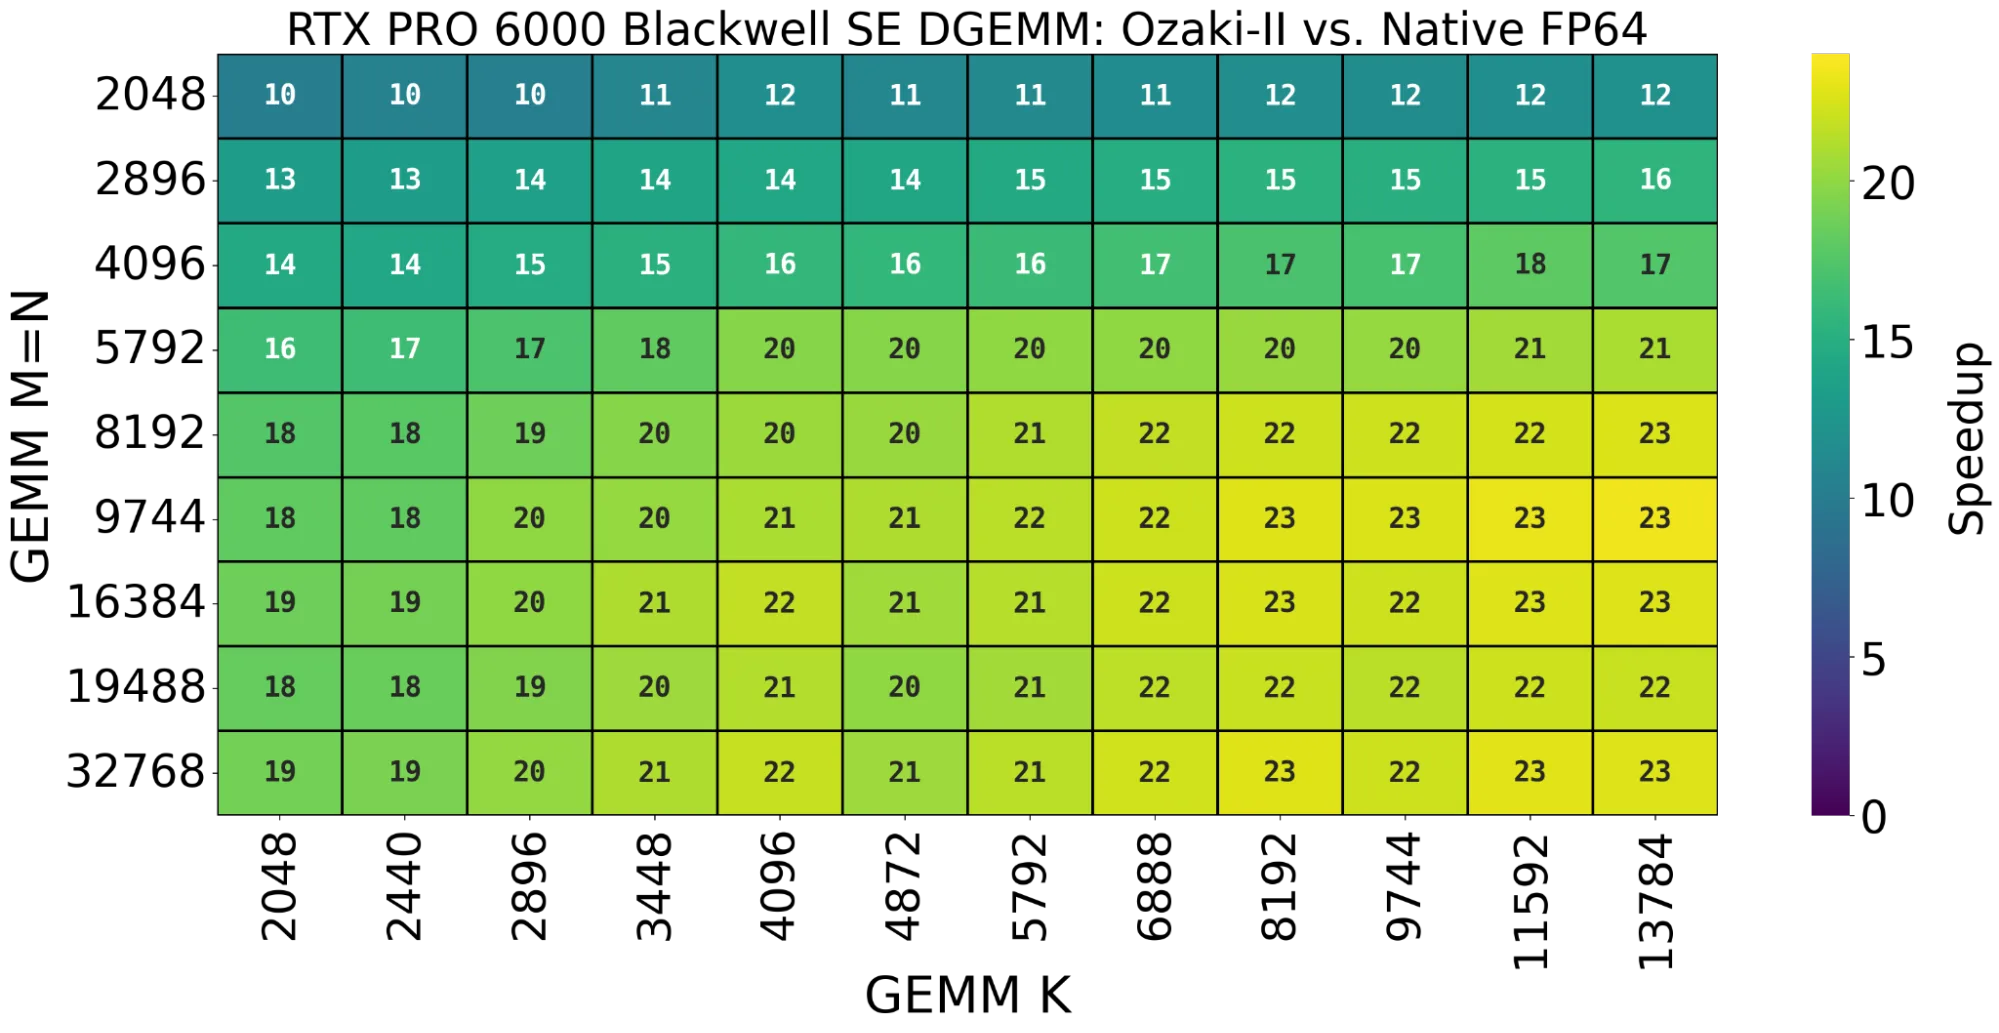
性能提升的上限取决于 GPU 相对于其原生 FP64 单元的整数 Tensor Core 吞吐量,并且该比率在产品线上有很大差异,而 NVIDIA RTX PRO Blackwell 服务器版本处于该范围的远端。下面的图 7 显示了在 RTX PRO 6000 Blackwell SE 上,搭载 Ozaki-II 的 DGEMM 与原生 FP64 相比的加速情况。从图中可以看出,Ozaki-II 受益于测试的所有矩阵大小,即使是最小的矩阵也比原生 FP64 增加了 10 倍,最大的矩阵也达到了 23 倍。
开始使用
- 下载并安装最新的 NVIDIA CUDA 工具包
- 阅读 cuBLAS 文档的浮点仿真部分,了解完整的 API 详细信息,包括
cublasSetEmulationStrategy()和手动尾数位控制。 - 在 GitHub 上探索 cuBLAS 仿真示例
- 评估您自己工作负载的收益并告诉我们您的发现,我们希望获得有关 API 设计和精度/ 性能权衡的反馈。您可以在 NVIDIA 加速计算开发者论坛上联系我们。
致谢
Jiqun Tu 对此博文做出了贡献。


