

生物分子结构预测现在通常以蛋白质组规模运行,其目标是高效地将整个工作列表移动到工作流中。
NVIDIA BioNeMo 推理运行时 (BioIR) 有助于加速 NVIDIA GPU 上受支持的生物分子结构预测模型,同时保持熟悉的 PyTorch 工作流。它使用经过优化的内核,并在适用的情况下使用 CUDA 计算图 来加速模型执行。对于大量独立输入,Ray 可以在单个节点中的每个 GPU 上运行完整的模型副本,以提高整体吞吐量。
BioIR 还被用于实际蛋白质组规模的研究,包括最近扩展的 AlphaFold 数据库 (AFDB) ,加速了 4777 个蛋白质组的蛋白质复合体结构的生成,总计约 3100 万个候选复合体,其中 81 万个作为高置信度预测发布。
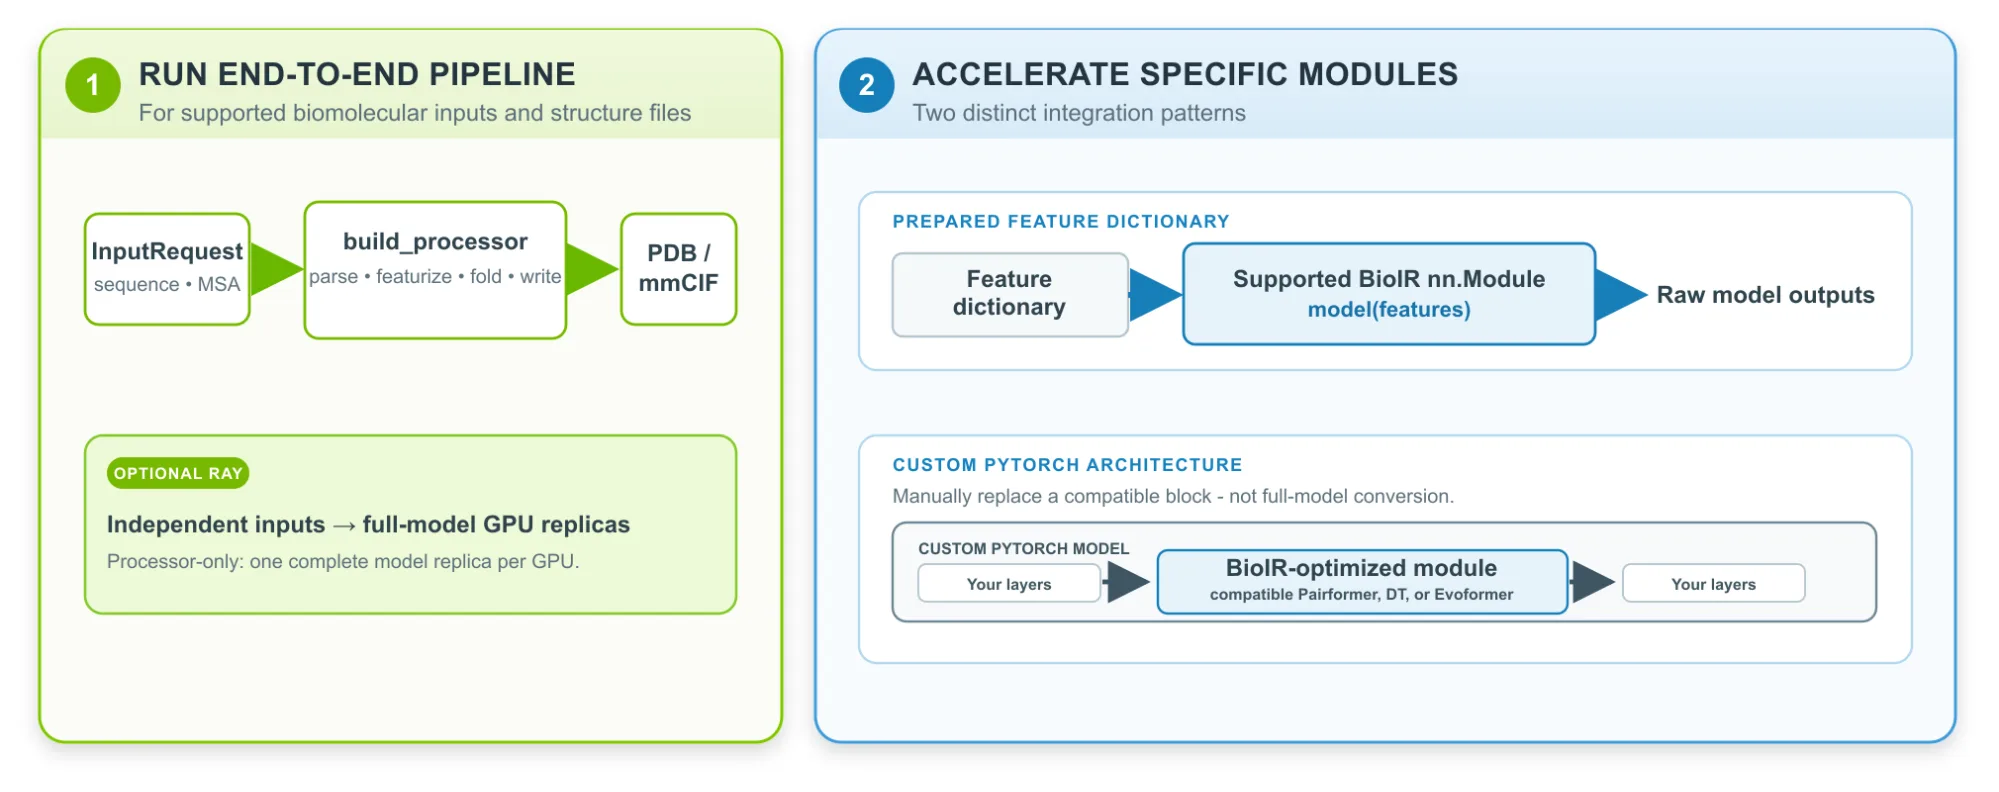
您可以通过两种方式使用它 (请参阅下面的图 1) :
- 端到端处理器通过解析、分词、特征生成、GPU 推理以及 PDB 或 mmCIF 写入来移动 InputRequest。
- 通过直接集成 PyTorch,您可以构建受支持的模型 (torch.nn.Module) ,或在自定义代码中重复使用选定的模块。
本教程将介绍 BioIR 的端到端处理器,从输入准备到 GPU 推理以及 PDB 或 mmCIF 输出,并展示如何跟踪每小时结构和资源效率。
预备知识
- Python 3.12 或更高版本
- 兼容的 NVIDIA GPU 和驱动,以及 BioIR Wheel 或支持的开发环境
- 一个分阶段模型检查点 (以下示例中的玻尔兹 – 2) 和所需的化学元数据
- 每个蛋白质链都需要 A3M MSA。对于包含多个不相同蛋白质链的输入,接受配对或未配对的 MSA
- 对于光线吞吐量缩放,请在同一节点上使用多个可见 GPU,并使用比副本更独立的记录
wheel 包含预编译的 CUBIN,因此运行时使用不需要 nvcc、CUDA 源、CMake 或 CUDA 工具包。
第 1 步:选择支持的结构预测工作流
在下文中,我们演示了 BioIR 中的 Boltz2 的端到端工作流程。使用 model_source="boltz-2"。蛋白质链需要 MSA;对于包含多个不同蛋白质链的输入,可以接受配对或未配对的 MSA。您可以选择自行提供模板,因为 BioIR 不运行 HHsearch 或 HMMsearch。端到端处理器支持配体结构预测,但不支持配体亲和力预测。
from bionemo_ir.data.schemas import InputRequest, MSARecord, Polymer

request = InputRequest(
    input_id="demo",
	polymers=[
    	Polymer(
            polymer_type="protein",
            chain_id=["A"],
            sequence="GSHMSL...",
            msas=[MSARecord(path="msa.a3m", format="a3m")],
            paired_msas=[],
            templates=None,
    	)
	],
)

rows = [{"record": request, "__record_id": request["input_id"]}]
将截断的序列和 MSA 路径替换为有效值。对于光线测试,从真实的工作列表中构建行,其记录比副本多;不要重复一行,以证明缩放是有用的。
第 2 步:使用串行处理器验证一次预测
BioIR 有两个执行程序后端,用于端到端处理器工作流程:serial 和 Ray。串行后端针对一个输入依次运行每个阶段,在进入下一个输入之前完成整个工作流程。这有助于在使用光线后端同时处理第 3 步中的独立输入之前检查您的设置。
import json

from bionemo_ir.pipeline.processor.engine_proc import (
    EngineProcessorConfig,
    build_processor,
)
from bionemo_ir.pipeline.stages.configs import (
    FeatureGeneratorStageConfig,
	WriterStageConfig,
)

serial_config = EngineProcessorConfig(
    model_source="boltz-2",
	executor_backend=None,  # None mean the serial processor
	runtime_args={
        "recycling_steps": 3,
        "num_sampling_steps": 50,
        "diffusion_samples": 1,
	},
    feature_generator_stage=FeatureGeneratorStageConfig(
        init_context={"random_seed": 42},
	),
    writer_stage=WriterStageConfig(
        output_path="output/serial",
        format="cif",
	),
    engine_kwargs={"profile_inference": True},
)

serial_processor = build_processor(serial_config)
serial_outputs = serial_processor(rows)

for row in serial_outputs:
	scores = json.loads(row["scores"])
    print(row["output_path"])
    print(row["model_inference_time"])
    print(scores.get("confidence_score"))
model_inference_time 是 BioIR 的 CUDA 同步折叠模型前向测量。它不包括解析、分词、特征生成、后处理和写入。通过特征生成器的 init_context 设置种子。scores 字段必须解码,因为它是 JSON 字符串。
第 3 步:使用光线副本扩展独立输入
对于默认副本布局,可按以下方式选择光线后端:
from bionemo_ir.pipeline.processor.engine_proc import EngineProcessorConfig

ray_config = EngineProcessorConfig.create_default_replica_mode_config(
    model_source="boltz-2",
    output_dir="output/ray",
    output_format="cif",
)
此配置会在当前节点上的每个可见 GPU 上放置一个完整的模型副本,并将 CPU 级大小设置为 torch.cuda.device_count()。以下替代配置可明确控制四个 GPU:
import ray

from bionemo_ir.pipeline.processor.engine_proc import (
	EngineProcessorConfig,
	build_processor,
)
from bionemo_ir.pipeline.stages.configs import (
	EngineStageConfig,
    FeatureGeneratorStageConfig,
	ParallelismMode,
	ParserStageConfig,
	TokenizerStageConfig,
	WriterStageConfig,
)

ray_config = EngineProcessorConfig(
    model_source="boltz-2",
    executor_backend="ray",  # selects the ray backend
    parser_stage=ParserStageConfig(compute=4),
    tokenizer_stage=TokenizerStageConfig(compute=4, num_cpus=2),
    feature_generator_stage=FeatureGeneratorStageConfig(
    	compute=8,
    	num_cpus=4,
        init_context={"random_seed": 42},
	),
    engine_stage=EngineStageConfig(
        parallelism_mode=ParallelismMode.REPLICA,
    	compute=4,
    	num_gpus=1.0,
    	num_cpus=4,
	),
    writer_stage=WriterStageConfig(
    	compute=4,
        output_path="output/ray",
        format="cif",
	),
)

ray_processor = build_processor(ray_config)
dataset = ray.data.from_items(rows)
ray_outputs = list(ray_processor(dataset).materialize().iter_rows())
容量规则为 engine_stage.compute × engine_stage.num_gpus ≤ visible GPUs。此四副本示例是假设有四个可见 GPU 的单节点配置。本教程不涵盖多节点部署。在这里,Ray 会创建四个引擎角色,并为每个角色保留一个 GPU。每个角色都会加载完整模型。build_processor 可根据需要初始化光线。实际吞吐量取决于输入分布、阶段平衡、存储、调度和故障,因此请进行测量。
第 4 步:平衡五个处理器阶段
在光线端到端处理器中,五个处理器阶段按依赖项顺序消耗输入:Parser = 分词器+ 特征生成器+ 折叠引擎+ Writer。使用匹配的 StageConfig 配置每个阶段;步骤 3 示例显示了相关字段。enabled 字段不是公共的“Skip Control” (跳过控制) 字段。每个阶段都会显示 compute;相关阶段还会显示 num_cpus、memory 和 batch_size。光线引擎会添加 max_concurrent_batches、accelerator_type 和 num_gpus。
要调整光线工作流,请从 EngineProcessorConfig.create_default_replica_mode_config(...) 开始。增加场景的 compute 以添加 worker;使用 num_cpus、memory 以及引擎 Actor 的 num_gpus 设置资源保留。如果引擎等待输入,请添加解析器、分词器或特征处理器。当 GPU 或对象存储内存导致故障时,减少并发或分离大型输入。
Ray 旨在将 CPU 阶段与推理重叠在一起,但这能否改善目标工作负载取决于给定硬件配置上给定输入的解析、特征生成和输出写入阶段的运行时间成本。请参阅图 4 的 ScaleFold,了解 OpenFold 的预处理时间差异。
第 5 步:将每个副本的加速与工作流扩展分开
BioIR 可在三个不同的层上提供优化:
- 内核选择:支持的操作基于模型配置、GPU、数据类型和张量形状,选择兼容的 BioIR 自定义、cuEquivariance 或 PyTorch 后备实现。
- 模块优化:在支持的情况下,单独的
optimize()机制可为兼容的模块启用 CUDA 图形截取。 - 工作流扩展:光线执行程序在 GPU 上放置完整的模型副本,并在 GPU 之间分配独立的输入。
这些层针对不同的瓶颈。内核和模块优化可缩短副本中的模型转发时间。Ray 可以通过将 CPU 阶段与 GPU 折叠重叠,并在单独的 GPU 上运行全模型副本以进行独立的输入,从而提高工作列表的吞吐量。Ray 不会跨 GPU 分割单个模型的前向传递。上图 1 区分了处理器路径和直接集成路径;光线缩放仅适用于处理器路径。
我们早期使用 BioNeMo 推理运行时进行的基准测试估计了以下模型前向加速:
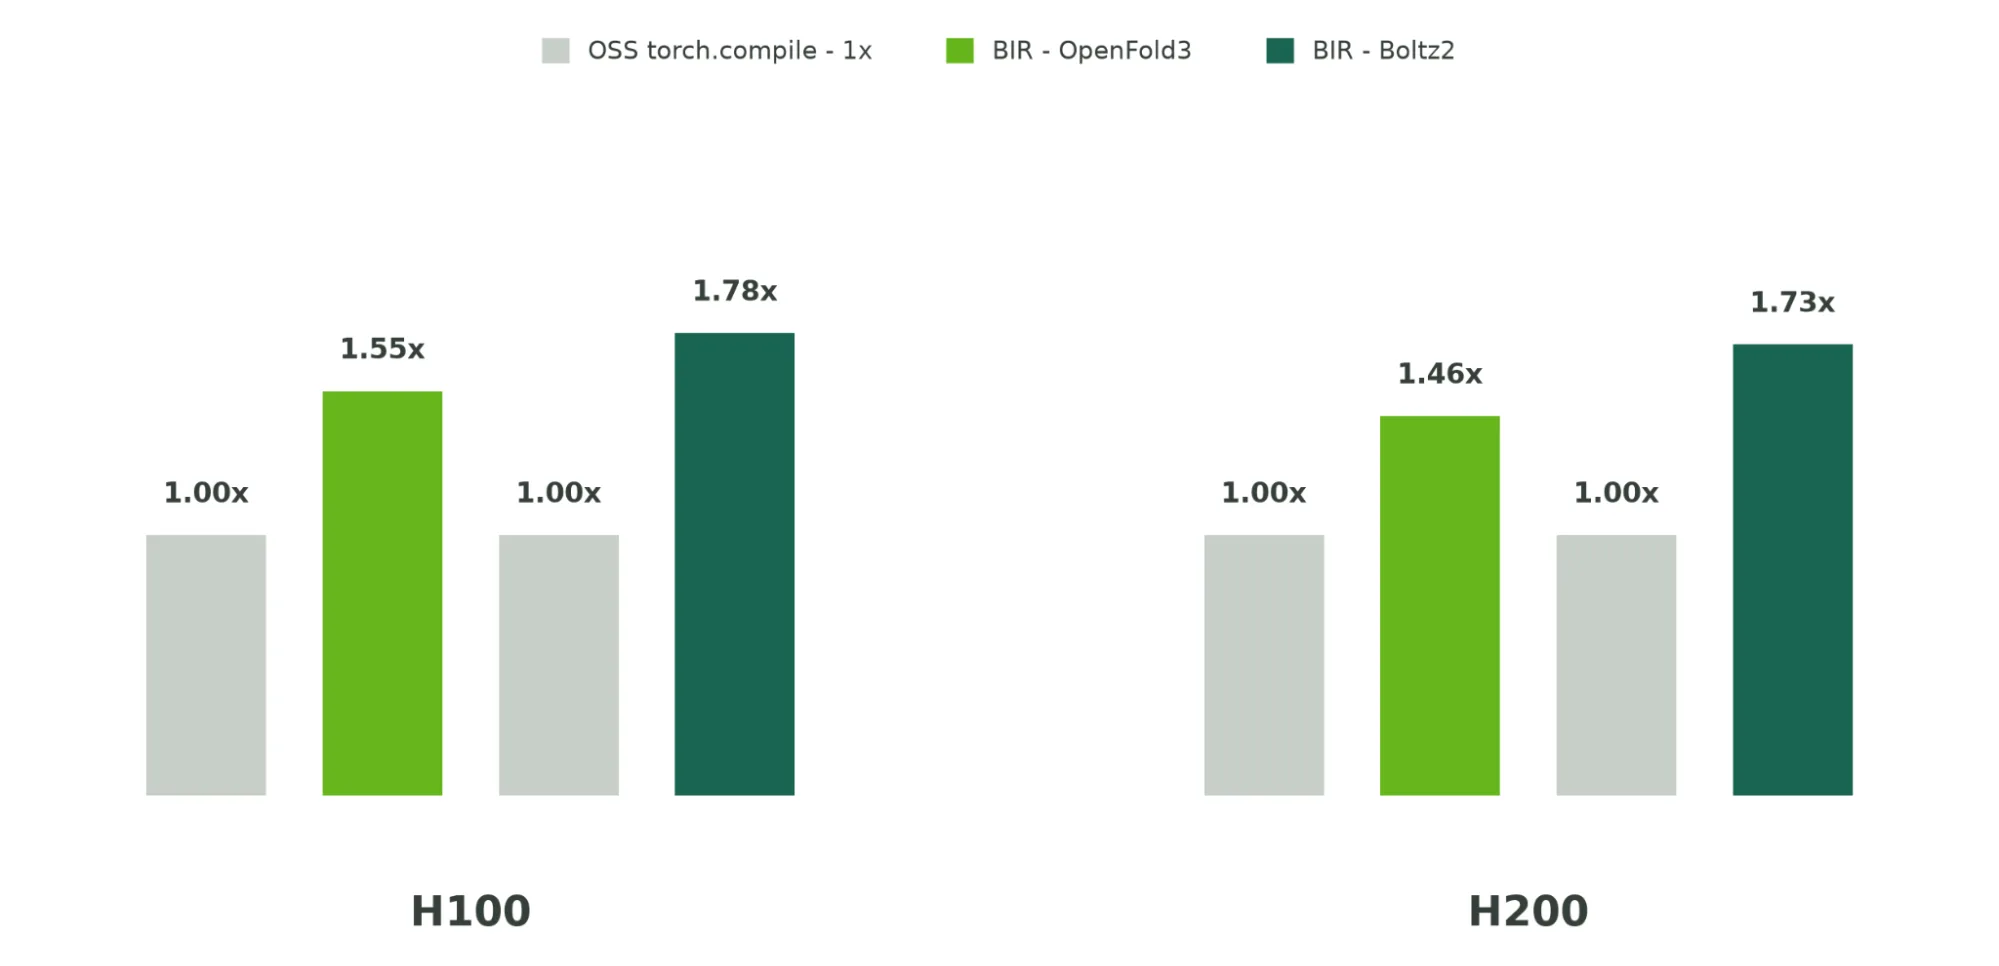
在跨越 29 – 1734 个残基的 17 个输入中,使用 1 次热身 (已弃用) 和 1 次测量调用测量出的加速效果。OpenFold3 和 Boltz2 OSS 基准使用 torch.compile 和 dynamic=None、fullgraph=False、recompile_limit=128、accumulated_recompile_limit=256、fail_on_recompile_limit_hit=True。Boltz2 OSS 使用 cuEq;OpenFold3 OSS 使用 use_cuequivariance=True 和 use_deepspeed=True。
这些结果量化了一个模型副本中的加速。它们不会测量解析、特征生成、输出写入、光线调度、多 GPU 吞吐量或完整工作列表挂壁时间。下图 3 显示了模型前向和端到端测量必须保持独立的原因。
要确定在实际部署中可解锁的额外 GPU 数量,请在单个节点上使用 1 个、2 个和 4 个光线副本来测量相同的代表性工作列表。第 6 步定义所需的指标和比较方法。
第 6 步:基准测试折叠阶段效率和端到端交付:AFDB – 案例研究
为了使这些测量结果具体化,我们对 1000 个人类二聚体标 (组合序列长度低于 2800 个残基) 运行了匹配的基准测试,这代表了大量独立生物分子结构预测任务,类似于 AlphaFold 数据库中最近添加的数据集。
这个具有代表性的折叠阶段基准测试将 BioIR 加速的 Boltz-2 与 Torch 编译的开源 Boltz-2 在 8 个 H100 GPU 上的实现进行了比较。这两种实现都使用相同的目标、暂存 MSA、推理配方和 GPU 配置;吞吐量指标和其他结果是此配置所特有的,不应泛化到所有 BioIR 支持的模型、数据集或硬件。
该工作流程使用三个回收步骤、200 个采样步骤,以及每个标的五个扩散样本。与公开实现的 20.2 K 相比,BioIR 完成了所有 1000 个目标,并在每分配的 GPU 小时内成功提供了 58.5 K 个折叠残基,残基标准化吞吐量提高了 2.90%;开源实现在 29 个目标上耗尽了内存。
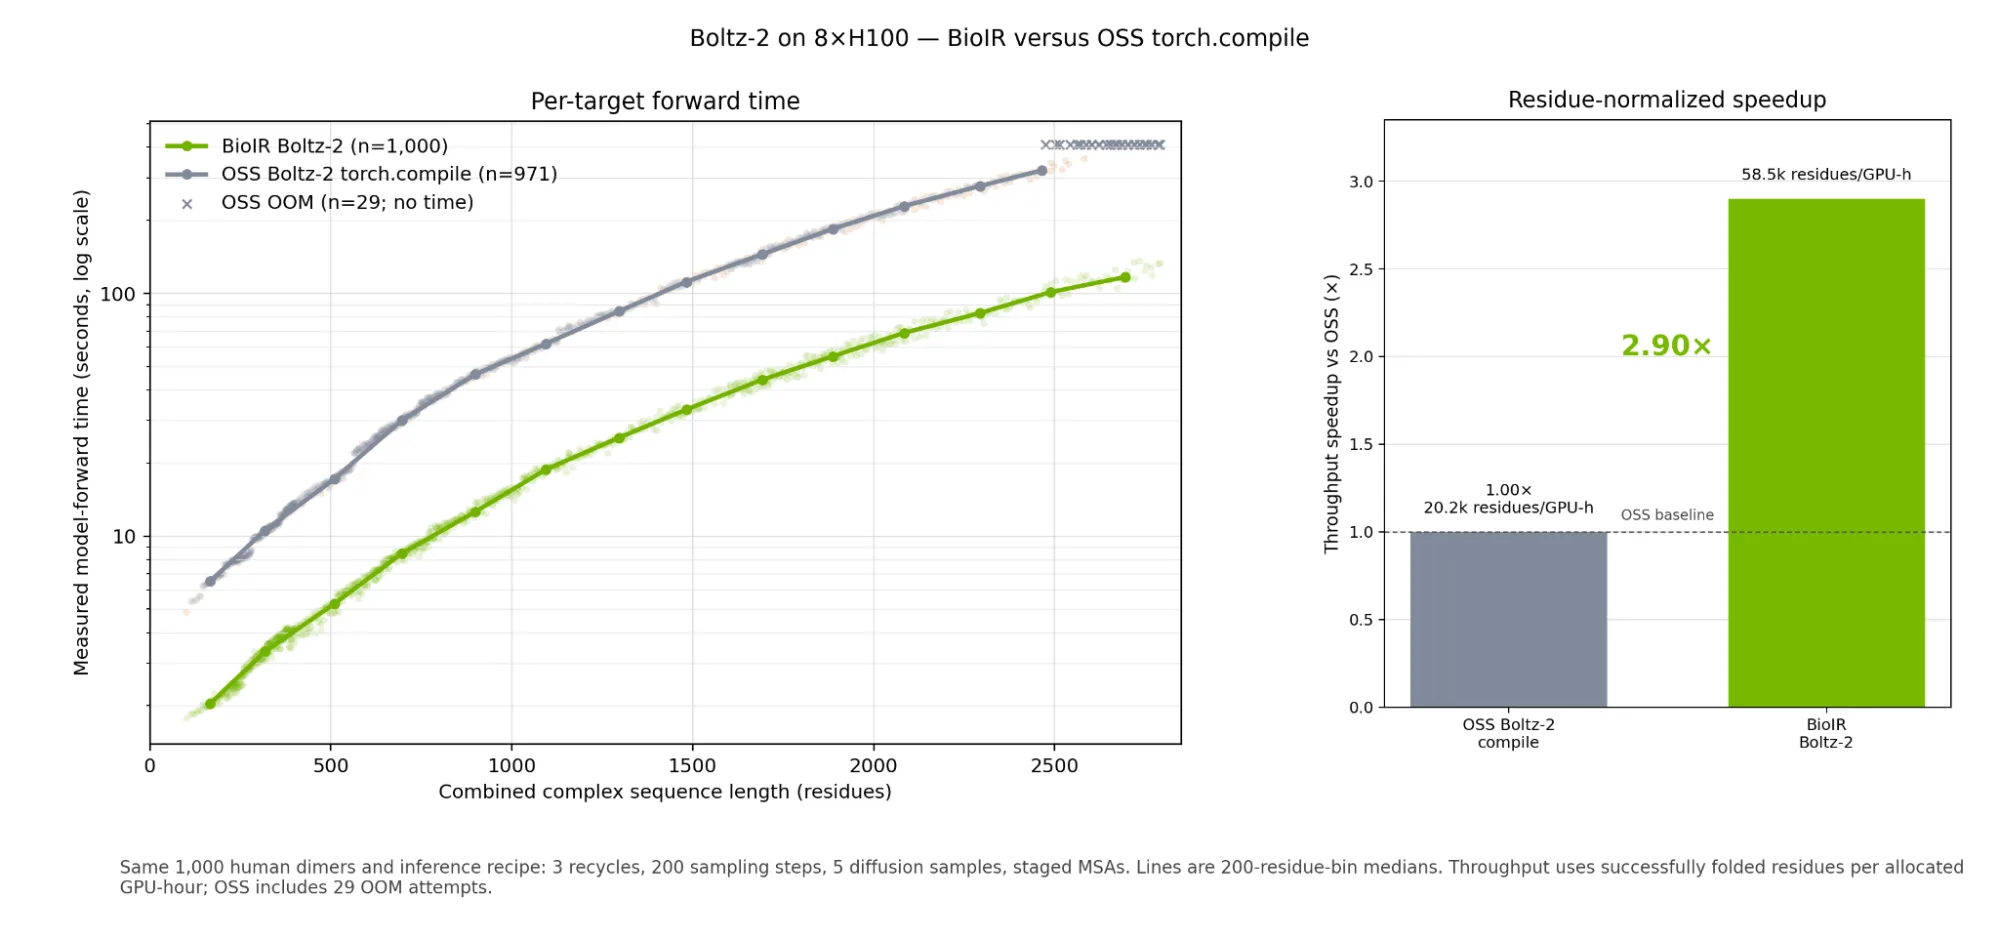
图 3 的左侧面板比较了 BioIR 和 Torch 编译开源实现的模型前向时间,并直接显示了 BioIR 提供的较低模型前向时间。图 3 右侧面板将 BioIR 提供的吞吐量与开源实现进行了比较,其中吞吐量是预测结构中通过分配的 GPU 小时数进行标准化的残基总数。图 3 的右侧面板显示了 BioIR 中内核级、模块级和工作流级优化带来的加速效果。图 3 的左侧面板显示了内核级和模块级实现带来的加速效果。
与玻尔兹 2 加速类似,BIR 还可加快其他生物分子协同折叠模型 (例如 OpenFold2 和 OpenFold3) 的推理速度。BIR 的早期版本为 NVIDIA 内部版本的 OpenFold2-MM 提供了加速模块,使 AFDB 能够大规模预测包含 3100 万个蛋白质复合体结构的蛋白质结构。
我们使用 8 个 H100 80GB HBM3 节点的等效额定功率,将图 3 中 1000 个目标匹配的基准测试线性外推到 100 万个可比目标 (参见下面的图 4) 。
据估计,在使用 8-GPU TDP (热设计功耗) 同等性能的情况下,公开实施 BioIR 需要 11 MWh,而在使用全节点最大功耗等效性能的情况下,公开实施 BioIR 需要 35 MWh,而在使用全节点最大功耗等效性能的情况下,公开实施 BioIR 需要 21 MWh,而在使用全节点最大功耗时则需要 64 MWh这些是 IT 设备的折叠式估算值,而非计量能耗测量值,并且不包括数据中心开销,例如功耗效率 (PUE) 。
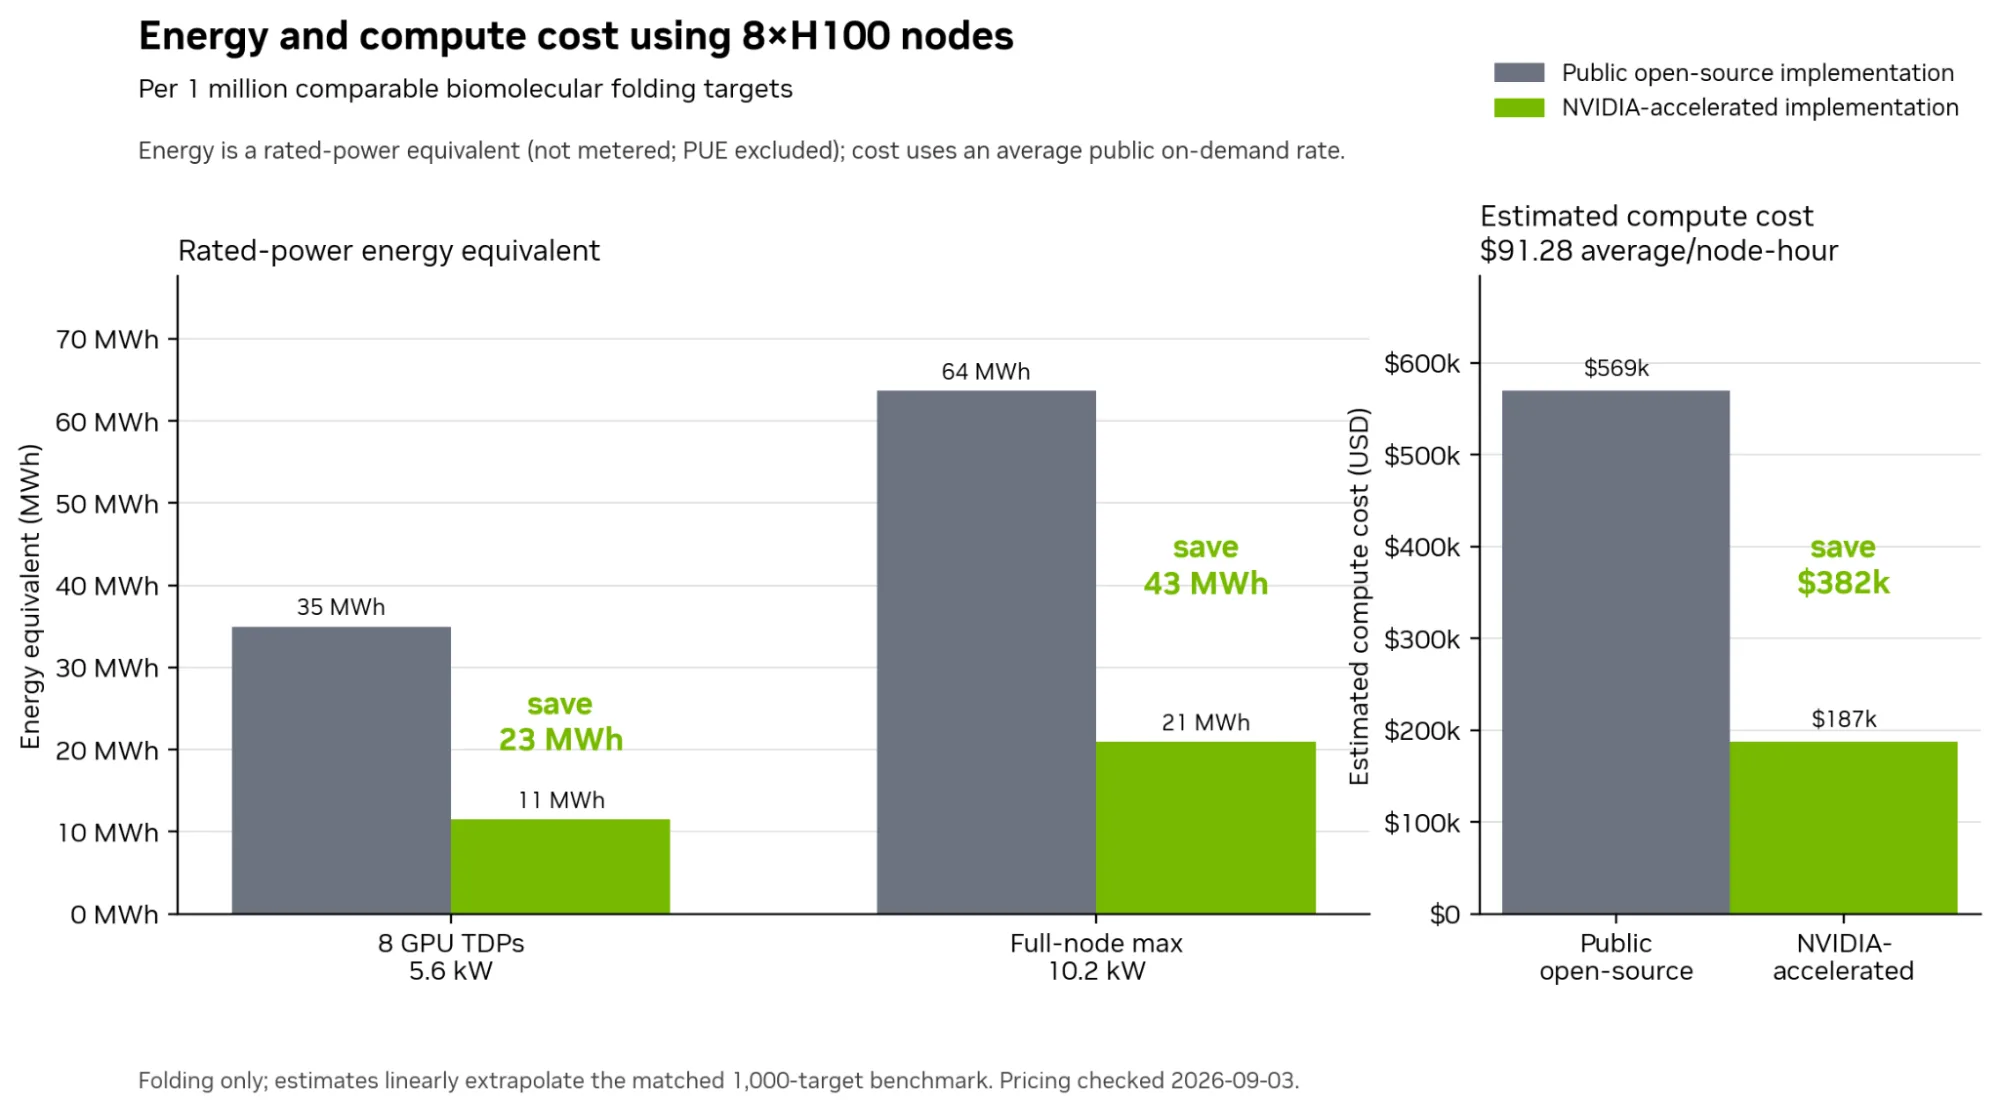
受控比较用于测量每个实现中具有相同输入和 MSA 的折叠吞吐量;它排除了 MSA 生成、预处理 CPU 分配、存储、数据传输、重试和工程用度。报告有别于模型前向指标的端到端工作流性能指标,包括每小时完成的结构、GPU 和 CPU 利用率、GPU 显存峰值、完成率、故障和重试。
故障排除
- 只有一个 GPU 处于活动状态:确认 Ray、
REPLICA、多个副本、多个可见 GPU 以及足够的独立记录。 - 处理器结构提高了`ValueError`:检查
compute * num_gpus是否超过可见 GPU。 - 蛋白质输入失败:检查所需的未配对 A3M 和工人可见路径。
- GPU 等待:在添加副本之前,检查 CPU 阶段、CPU 保留、队列和光线对象存储容量。
- 行等待推理:检查写入器并发性和目标吞吐量。
- 光线无法放置行为者:检查 CPU、GPU、内存和
accelerator_type标签。 - 一条记录会停止作业:快速失败的默认设置会提高
FoldingPredictionError。仅将should_continue_on_error=True设置为预期的行级延续,然后设置inspect __inference_error__。
开始使用
探索 BioNeMo 推理运行时 (BioIR) ,并将其大规模集成到您的结构预测工作流中: http://github.com/NVIDIA-BioNeMo/BioNeMo-Inference-Runtime
要通过智能体编排进一步加速药物研发工作流程,请查看 NVIDIA BioNeMo 智能体工具包 (BAT) 。


