

蛋白质设计是一个搜索问题。为 8 个残基的蛋白质序列选择氨基酸,可以实现超过 250 亿种组合。为 100 个残基的蛋白质序列选择氨基酸,可能性的数量超过了可观测宇宙中的原子数量。该空间中的某个地方存在一种蛋白质,它为新疗法开辟了道路。需要进行全面搜索的组合太多,因此要找到它取决于知道从何处查找。
RFD4-Proteina 是 NVIDIA 与华盛顿大学医学院蛋白质设计研究所共同开发的 NVIDIA BioNeMo 开放模型,利用从自然界中汲取的模式在该领域中导航。它共同设计蛋白质序列和全原子结构,并使用奖励引导的推理时间搜索来集中计算最有前景的候选项。
本教程向计算生物学家、机器学习工程师和药物研发研究人员展示了如何使用奖励引导的推理时间搜索,针对肿瘤标 PD-L1 设计蛋白质结合剂候选化合物,并介绍了跨设计任务的实验验证结果。
您可以通过两种方式访问 RFD4-Proteina:
- 选择用于训练、推理、方法开发和直接控制采样代码或
- 选择 NIM 微服务,通过 HTTP 接口实现快速推理部署
RFD4-Proteina 基于 Proteina-Complexa 的半隐方法构建而成,将显式主干坐标与隐表示、学习序列和原子变量相结合。其自编码器解码器可同时生成序列和全原子结构,从而消除 ProteinMPNN 等模型的单独反向折叠切换。
预备知识
- 开放模型
- 受支持的 Linux GPU 主机和 Python 3.12;遵循存储库设置指南并使用受支持的 NVIDIA GPU。
- 模型缓存:安装程序会自动下载 Hugging Face 包;仅当您想要其他缓存目录时,才会设置 HF_ 主页。
- NIM
- 自行托管:满足 NIM 前提条件 的 x86_64 或 Arm64 Linux、Docker、NVIDIA 驱动程序、NVIDIA 容器工具包和 NGC API 密钥。
- NIM API 端点 (不推荐用于生产运行) :通过 NVIDIA build.nvidia.com 通过 Shell 和 Python 脚本进行 HTTP 访问,无需安装本地 GPU 或模型。
关于 RFD4-Proteina
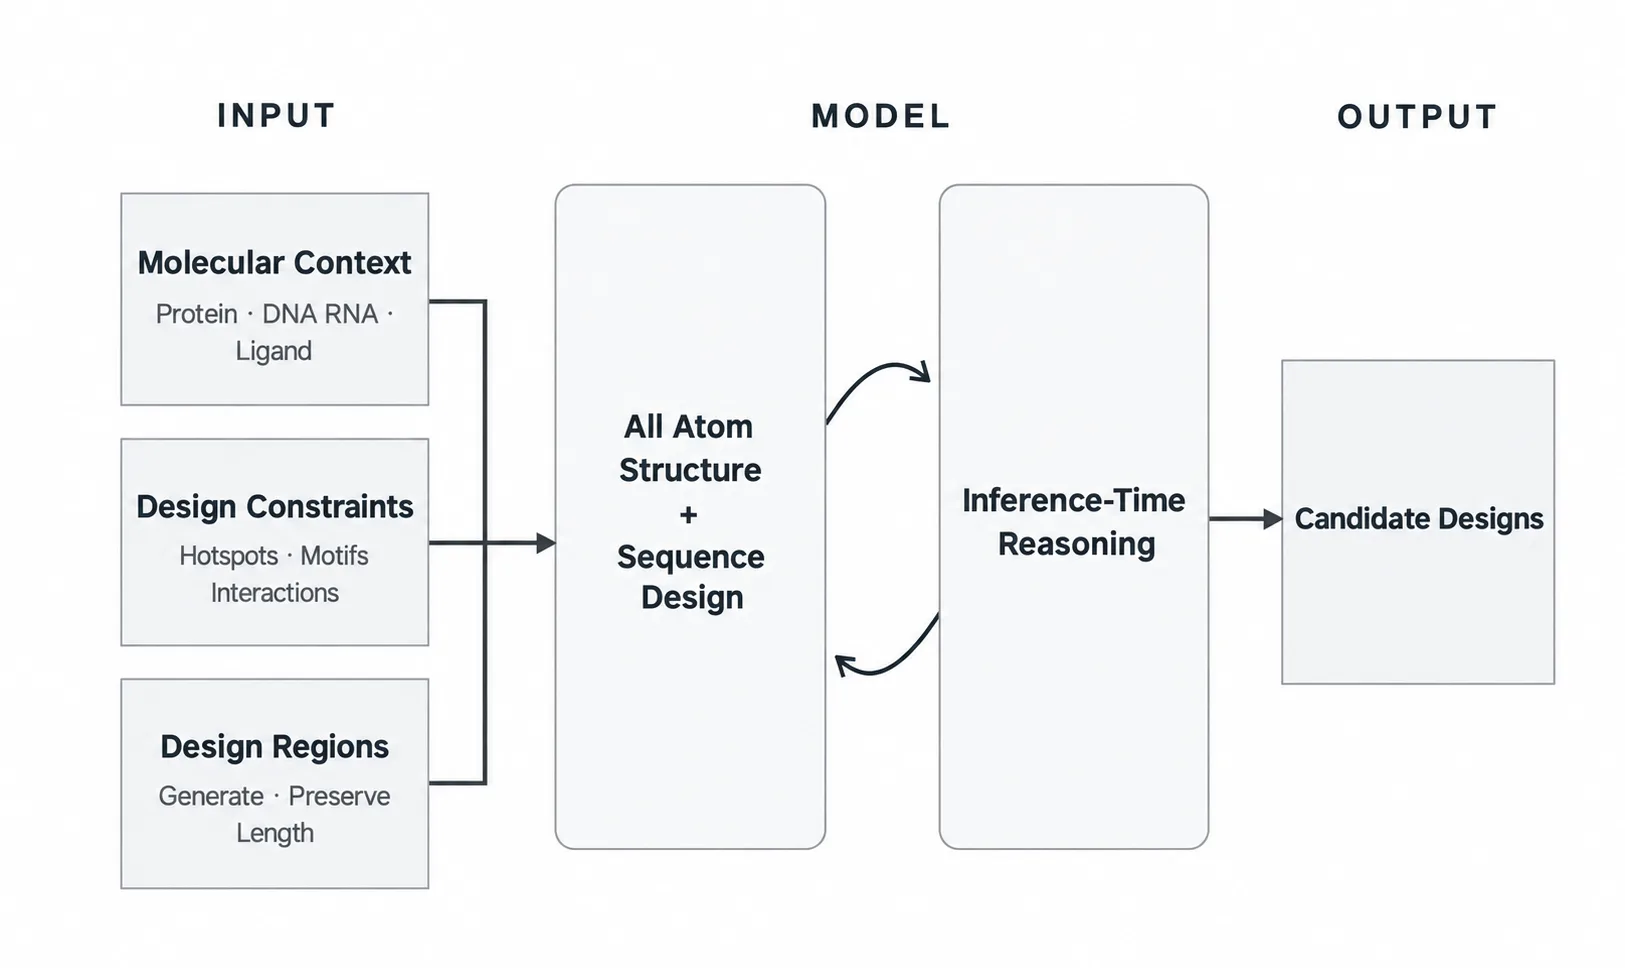
如图 1 所示的搜索循环是 RFD4-Proteina 计算的重点。
在推理时推理搜索期间,该模型会对生成轨迹进行降噪以获取结构,对这些设计进行评分,保留并分支承诺部分状态,并一直持续到达到生成标准。
奖励可以衡量几何图形、交互或独立预测的置信度。这种额外的搜索针对指定目标优化设计,以生成得分较高的设计。在本教程后面,您将了解用户如何通过开放模型和 NIM 启用此功能。
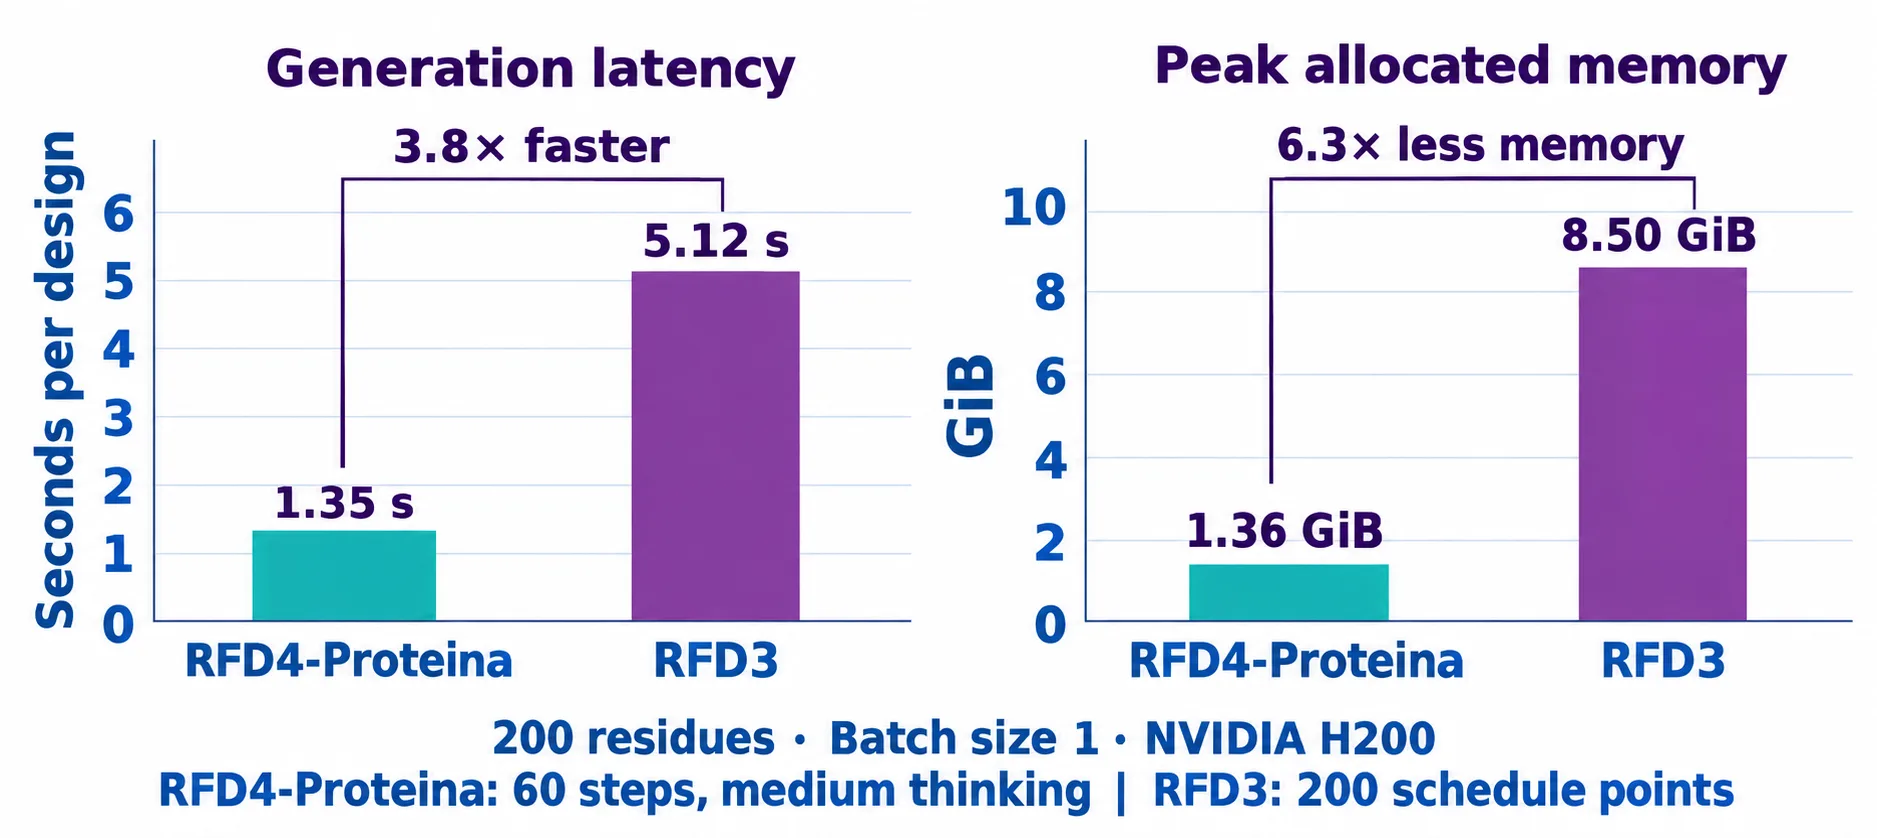
与 RFD3 相比,RFD4-Proteina 速度更快,显存占用更少,原因如下:
- 它适用于残差级隐表示,而非原子级表示,从而避免占用内存。
- 扩散过程工程将 Proteina-Complexa 中的采样步长从大约 400 步减少到 60 步,并且由于模型中的推理能力,计算集中在过程中最重要的部分。
- 推理时搜索速度也更快,因为预言机 ( OF3 和物理方法,如 tmol) 是 CUDA 加速的。
- 该模型和内核由与 cuEquivariance 和 BioNeMo 推理运行时 (BIR) 团队共同设计,可实现速度和可扩展性。
从分子设计理念到候选设计
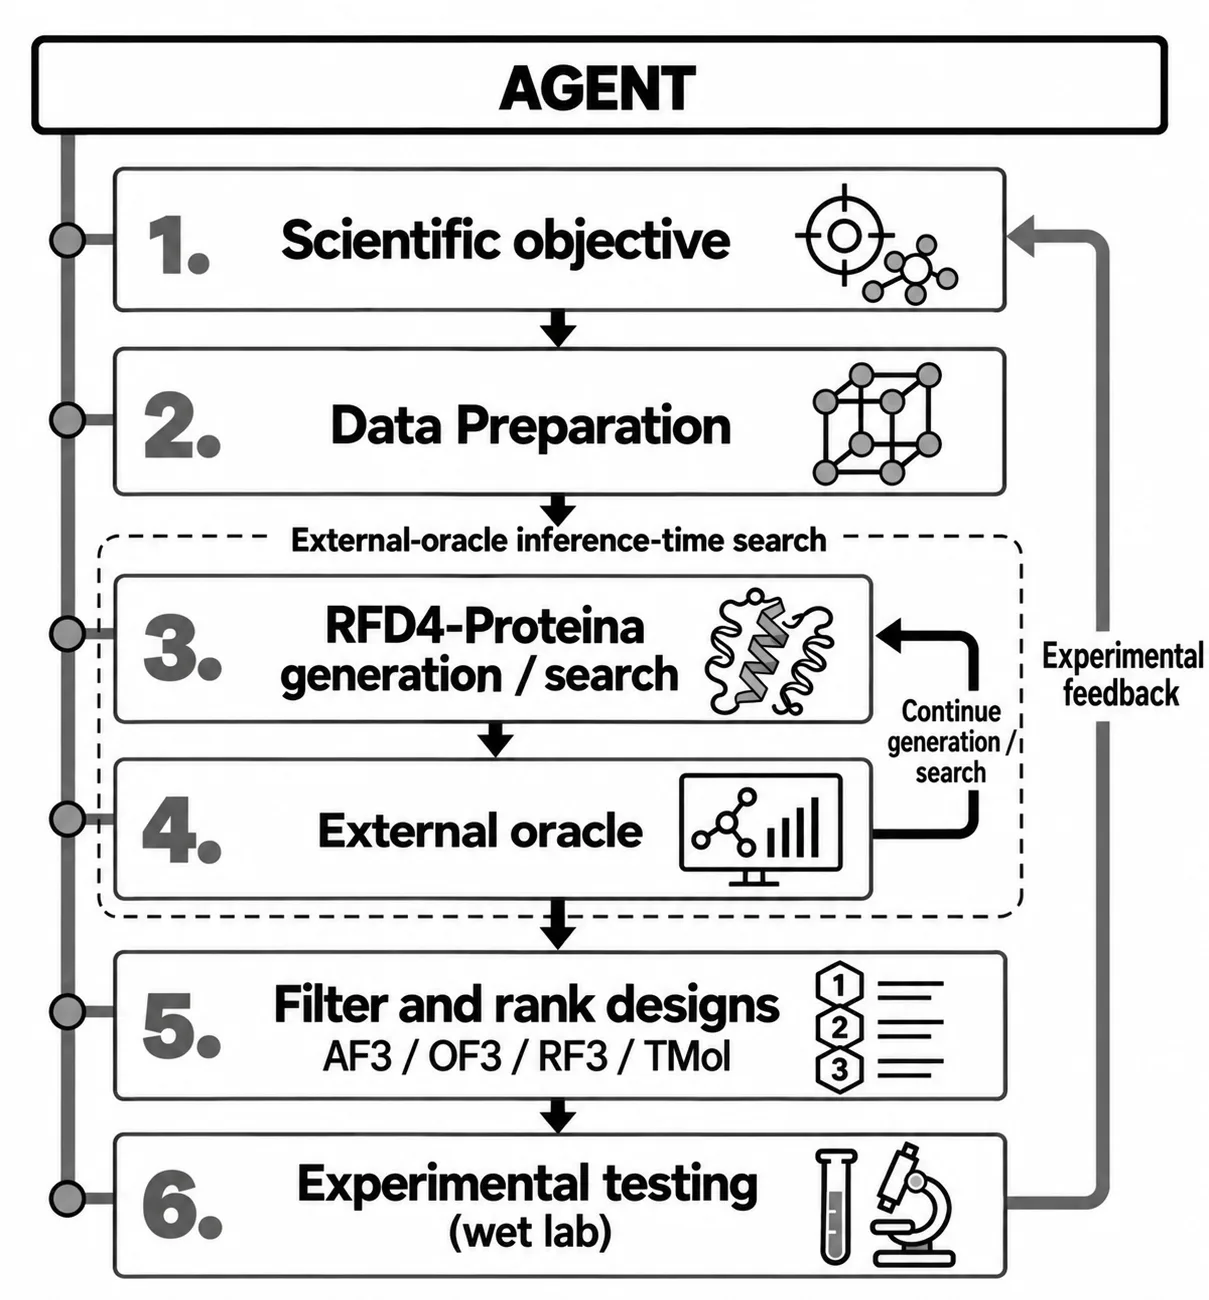
以上图 3 中的工作流程演示了如何使用 RFD4-Proteina 从科学目标变为实验测试候选目标。Anagent 可以协调这些工具并跟踪结果,而科学家则可以定义目标并使用实验证据来指导下一轮测试。
准备分子输入和环境
首先定义生成标准和要求。例如,RFD4-Proteina 希望用户定义可能发生的变化、必须保持不变的内容,以及计算和实验的成功标准。
使用 AtomWorks 生成/ 操作输入数据。AtomWorks 是用于为 RFD4-Proteina 准备结构和设计注释的分子数据层。其 Python 和 PyMOL 工作流可准备固定原子、可设计残基、热点和分子上下文。在设计周围蛋白质时保留所提供的配体或基序化学特性。
开放模型和 NIM 都接受带标注的 CIF 或条件规范及其源结构。以下规格可修复目标并定义新的活页夹。
以从PDB 5O45中裁剪出的存储库PD-L1结构作为目标。修复目标的序列和主干坐标,允许其侧链重新包装,并在Tyr56、Met115和Tyr123上直接生成热点原子的结合剂。新的活页夹具有100-150个残基,具有自由序列和坐标。
克隆存储库,然后从其根目录运行示例。这将写入 pdl1.json;这两条路径都使用相同的目标 CIF 和条件。
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina

cat > pdl1.json <<'JSON'
{
  "pdl1_binder": {
    "input": "docs/examples/inputs/5o45_cropped.cif",
    "contig": "100-150, /0, A17-131",
    "conditions": {
      "C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
      "C_SEQ": {"true": [{"select": "sel('A')"}]},
      "C_HOT": {"true": [
        {"select": "sel('A/*/56/[CG,OH]')"},
        {"select": "sel('A/*/115/[CG,SD]')"},
        {"select": "sel('A/*/123/[CD2,OH]')"}
      ]}
    }
  }
}
JSON
开放模型设置
在受支持的 Linux/ CUDA 系统上,安装具有当前 uv 版本 (验证版本为 0.12.24) 的存储库环境。如果 uv 已安装,请先更新,以便识别 CUDA 13.2。设置可缓存 Hugging Face 模型包,包括配对的自动编码器。当模型库处于私有状态时,请使用具有访问权限的账户以 hf 身份验证登录名进行身份验证。
bash setup.sh --native
source .venv/bin/activate
NIM 环境设置
要托管 NIM,请在已安装 Docker 和 NVIDIA Container Toolkit 的受支持 GPU 主机上的 Bash 中运行此块。
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
  -u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
  --format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
  --runtime=nvidia --gpus 'device=0' -p 8000:8000 \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
  --shm-size=16g "$RFD4_NIM_IMAGE"
生成序列和结构
开放模型生成
在存储库根目录中将以下内容另存为 design.py。相同的脚本支持生成和搜索。Proteina.from_pretrained("nvidia/RFD4-Proteina") 加载当前 Hugging Face 模型和配对的自编码器检查点。
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation


@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)


if __name__ == "__main__":
    main()
从资源库根目录生成一个候选项:
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null
输出保存在 runs/pdl1-open/inference_samples/ 下。为 10 个候选项添加 num_replicates = 10,并为每次运行选择一个新的 out_dir。Hugging Face 可缓存下载;在 from_pretrained 中添加修订 “<commit>”,以重现特定模型版本。
NIM 生成
将其另存为 nim_client.py。它会将 PD-L1 条件规格和目标 CIF 发送到 NIM,然后保存生成的结构和响应指标。
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec, "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post("http://localhost:8000/biology/ipd/rfd4-proteina/generative",
                             json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
安装请求并从资源库根目录运行客户端。将 pdl1.json 保留在目标 CIF 旁边。
python -m pip install requests
python nim_client.py
跨开放模型和 NIM 的性能优化
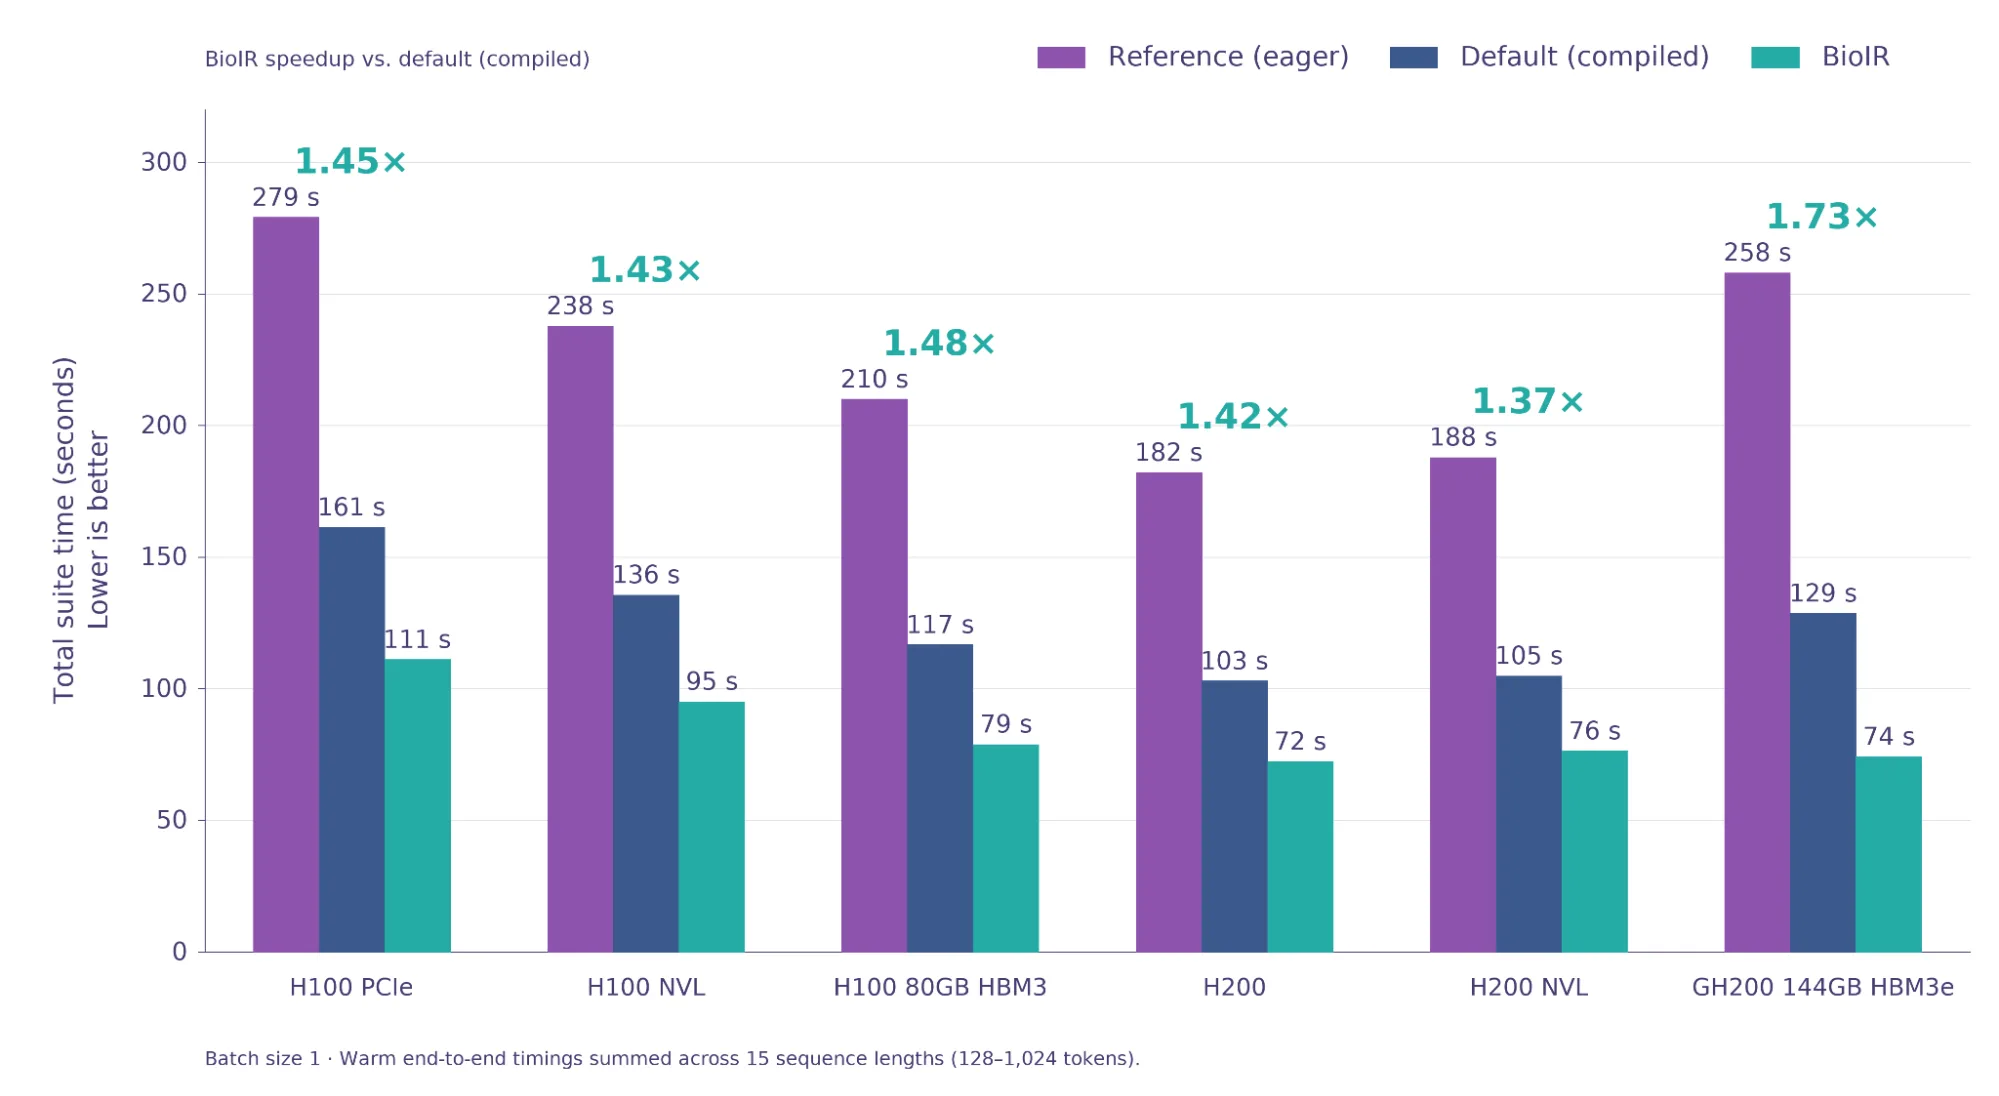
为加快设计迭代速度,BioIR 后端在经过测试的六种 Hopper GPU 配置下,将 RFD4-Proteina 的速度比默认编译后端提高了 1.37 – 1.73% (参见下图 4) 。在 H100 PCIe 上,总套件时间从 A1 秒缩短到 111 秒,运行时间减少了约 31%。该基准测试使用批量大小 1,并对 15 个序列长度 ( 128 – 1024 个token) 的热端到端计时求和。
使用外部预言机进行推理时搜索
使用 OpenFold3 进行开放模型搜索
使用 ./scripts/download_example_data.sh ./data_path 安装可选的 OpenFold3 运行时和权重。将 OF3_IMAGE、OF3_MODEL_DIR 和 OF3_JAX_CACHE_DIR 设置为其打印的路径,然后运行 mkdir -p "$OF3_JAX_CACHE_DIR"。Apptainer 必须在 GPU 主机上可用。
此示例使用在AlphaFold3 代码库,以及同样在OpenFold3 模型权重。
使用搜索预设重用 design.py:
python design.py inference_experiment=inference_beam_example \
  metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
  num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
预设使用两个分支 (光束宽度为 3) ,并在步骤 20、40、50 和 60 中评分。它为设计链的 OpenFold3 pLDDT (oracle.plddt_coi) 提供 50 层奖励,并以 80 的奖励保存资格赛。此选项用于测量活页夹的置信度,而非绑定证据;可分别检查界面和重新折叠指标。输出位于 runs/pdl1-open-search/ 下。
使用 OpenFold3 进行 NIM 搜索
将其另存为 nim_search_request.py。它重复使用 PD-L1 输入,并提交奖励引导的 OpenFold3 搜索。
from pathlib import Path
from nim_client import payload, submit

key = "oracle_of3_nvcf.overall_plddt"
payload["sampling"]["num_steps"] = 60
payload["search"] = {
    "step_checkpoints": [0, 20, 40, 50, 60],
    "n_branch": 2, "beam_width": 3,
    "reward_metrics_tags": ["unconditional_refolding"],
    "weights": {key: 1.0}, "clip_values": {key: {"min": 50.0}},
    "intermediate_save_min_reward": 80.0,
}
payload["metrics"] = {"tags": ["design", "unconditional_refolding"]}
submit(payload, Path("runs/pdl1-nim-search"))
启用 NIM 预言机
按照 Oracle 指南中所述加载 OpenFold3 reward.py 回调函数。它会报告整个复合体的 oracle_of3_nvcf.overall_plddt,并单独评估 Binder 接口。
将 Oracle 指南中的 OpenFold3 NVCF 回调另存为 reward.py,并使用 NVCF 调用凭据导出 OF3_NIM_API_KEY。使用以下回调函数重新启动服务:
docker stop rfd4-proteina
docker run -d --rm --name rfd4-proteina \
  --gpus 'device=0' -p 8000:8000 --shm-size=16g \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
  -v "$PWD/reward.py:/opt/nim/reward.py:ro" \
  -e NIM_ALLOW_ORACLE_PLUGIN=true -e OF3_NIM_API_KEY \
  "$RFD4_NIM_IMAGE"
运行搜索脚本。它将设计和响应指标保存在 runs/pdl1-nim-search/ 下。
python nim_search_request.py
此请求使用两个分支,Checkpoint[0、20、40、50、60],光束宽度为三个。它将奖励下限设置为 50,并保存分数至少为 80 的中间设计。这些是 OpenFold3 整体 pLDDT 的示例值,是整个复合体的预测置信度指标。搜索时奖励标签和最终报告标签是分开的。
搜索结果数量各不相同。在选择候选项之前,请检查生成的 CIF 和保留的指标。在计算比较中包括重新折叠和评分。
对候选项进行筛选和排序
检查约束条件、基序保留、冲突、界面、重新折叠一致性和结构多样性指标。OpenFold3 和 RoseTTAFold3 提供预测选项;TMol 提供受 Roseta 启发的全原子评分和优化。
常见指标包括蛋白质结构预测模型 (如 OpenFold 3) 的 ipTM (界面预测模板建模) 、ipSAE (交互预测对齐误差评分) 和 RMSD (均方根偏差) 评分,以及基于物理的模型 (如 TMol) 的交互能量。
实验测试并优化
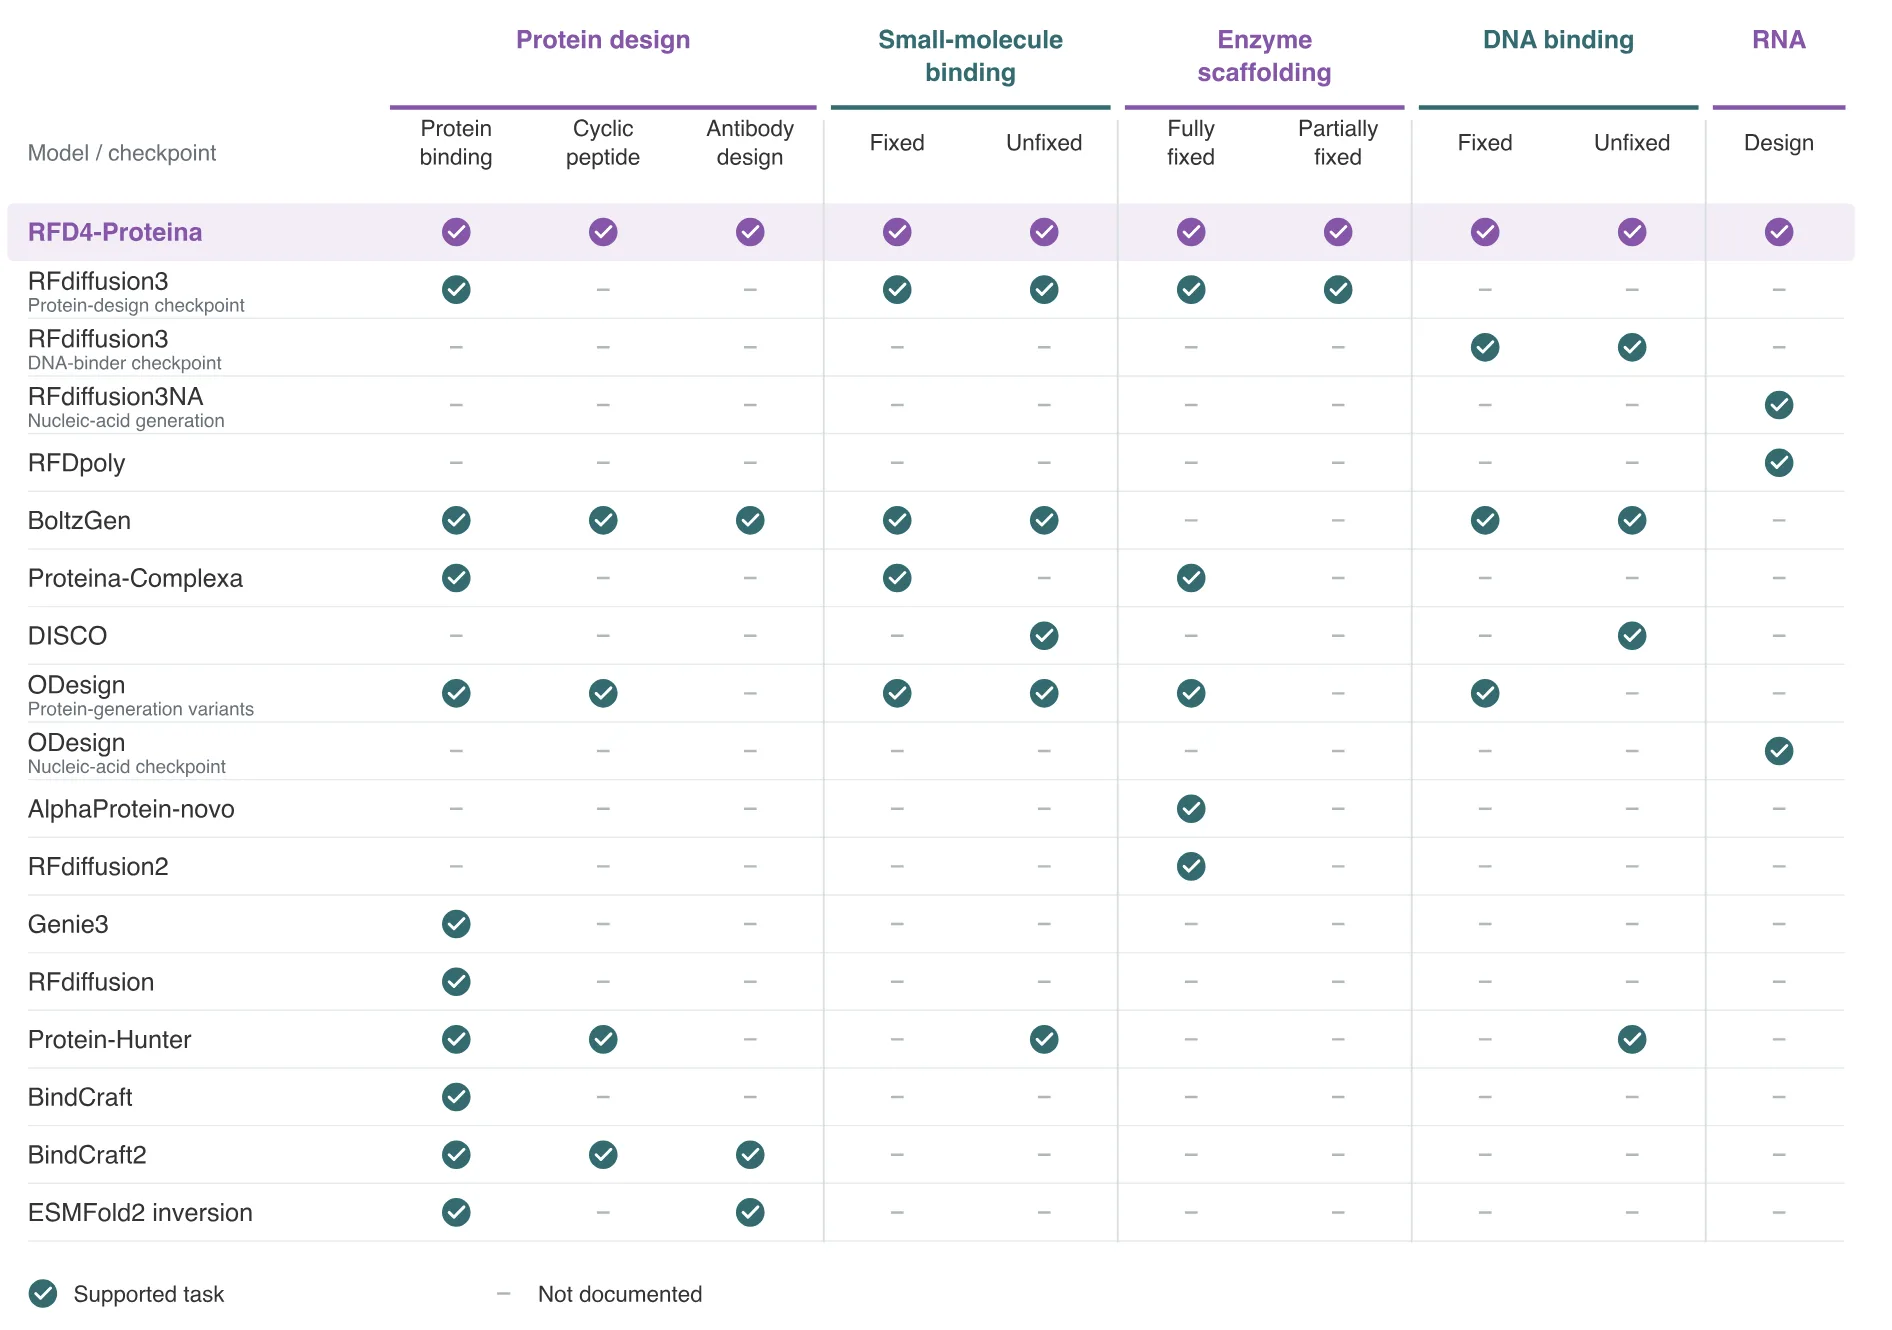
上表 1 重点介绍了 RFD4-Proteina 在分子任务方面的广泛功能。它不仅支持各种任务,随附的文稿表明,该模型在输出质量和吞吐量方面也是此类分子任务的先进模型。
通过选择不同的候选药物进行合成、表达和特定任务的分析,将这种吞吐量转化为科学进步。将实验结果反馈到下一轮的目标、约束条件和排名标准中。
使用 AI 智能体开展活动
使用 rfd4-proteina-campaign 技能,通过输入、模型版本和计算使用记录来协调生成、搜索和评估。rfd4-proteina-package 技能可生成包含结构、指标和过滤报告的结果存档。
Use rfd4-proteina-campaign to design 100–150-residue PD-L1 binders from pdl1.json, preserving its target and hotspot constraints. Use the Hugging Face model via from_pretrained and OpenFold3. Agree on criteria and a compute budget, then compare generation with reward-guided search and run a campaign via rfd4-proteina-campaign. Return up to ten diverse candidates with scores and compute usage; package the results with rfd4-proteina-package.
将工作流程应用于您的设计问题
RFD4-Proteina 将快速生成、智能搜索和智能体可编程性整合到一个工作流中。联合序列和全原子结构生成可简化候选项的创建,而奖励引导搜索则将计算重点放在特定任务的目标上。共享条件规范将这两种外形规格连接到通用评估工具,而 NIM 的 HTTP API 允许代理提交请求并检查结果。
使用开放模型进行方法开发,使用 NIM 与可选的 BioIR 加速进行应用集成,将计算探索和实验反馈引入迭代设计活动中。
开始使用 RFD4-Proteina NIM 微服务,在 GitHub 上探索开放模型,或向您的智能体介绍 BioNeMo Agent Toolkit 技能。


