随着语言模型的发展,扩展密集架构的成本变得越来越高。在密集 Transformer 中,每个 token 都会穿过每一层,因此添加功能可以提高训练和推理的计算能力。
多专家模型 (MoE) 架构采用不同的扩展方法,使用多个子网络或专家模型,同时仅为每个 token 激活一小部分子集。
这种权衡使得 MoE 架构对大语言模型 (LLM) 社区的吸引力与日俱增。它们可以更高效地扩展模型容量,但其优势很大程度上取决于实施情况。分散的专家计算可以降低 GPU 利用率。路由会增加通信开销,而更大的参数占用空间会带来内存和分布式训练挑战。NVIDIA Transformer 引擎 (TE) 通过用于分组专家计算、内核融合和低精度训练的优化基元,帮助解决这些瓶颈。随着参数数量和序列长度的增加,这些基元可以提高 GPU 效率,同时扩展模型容量。
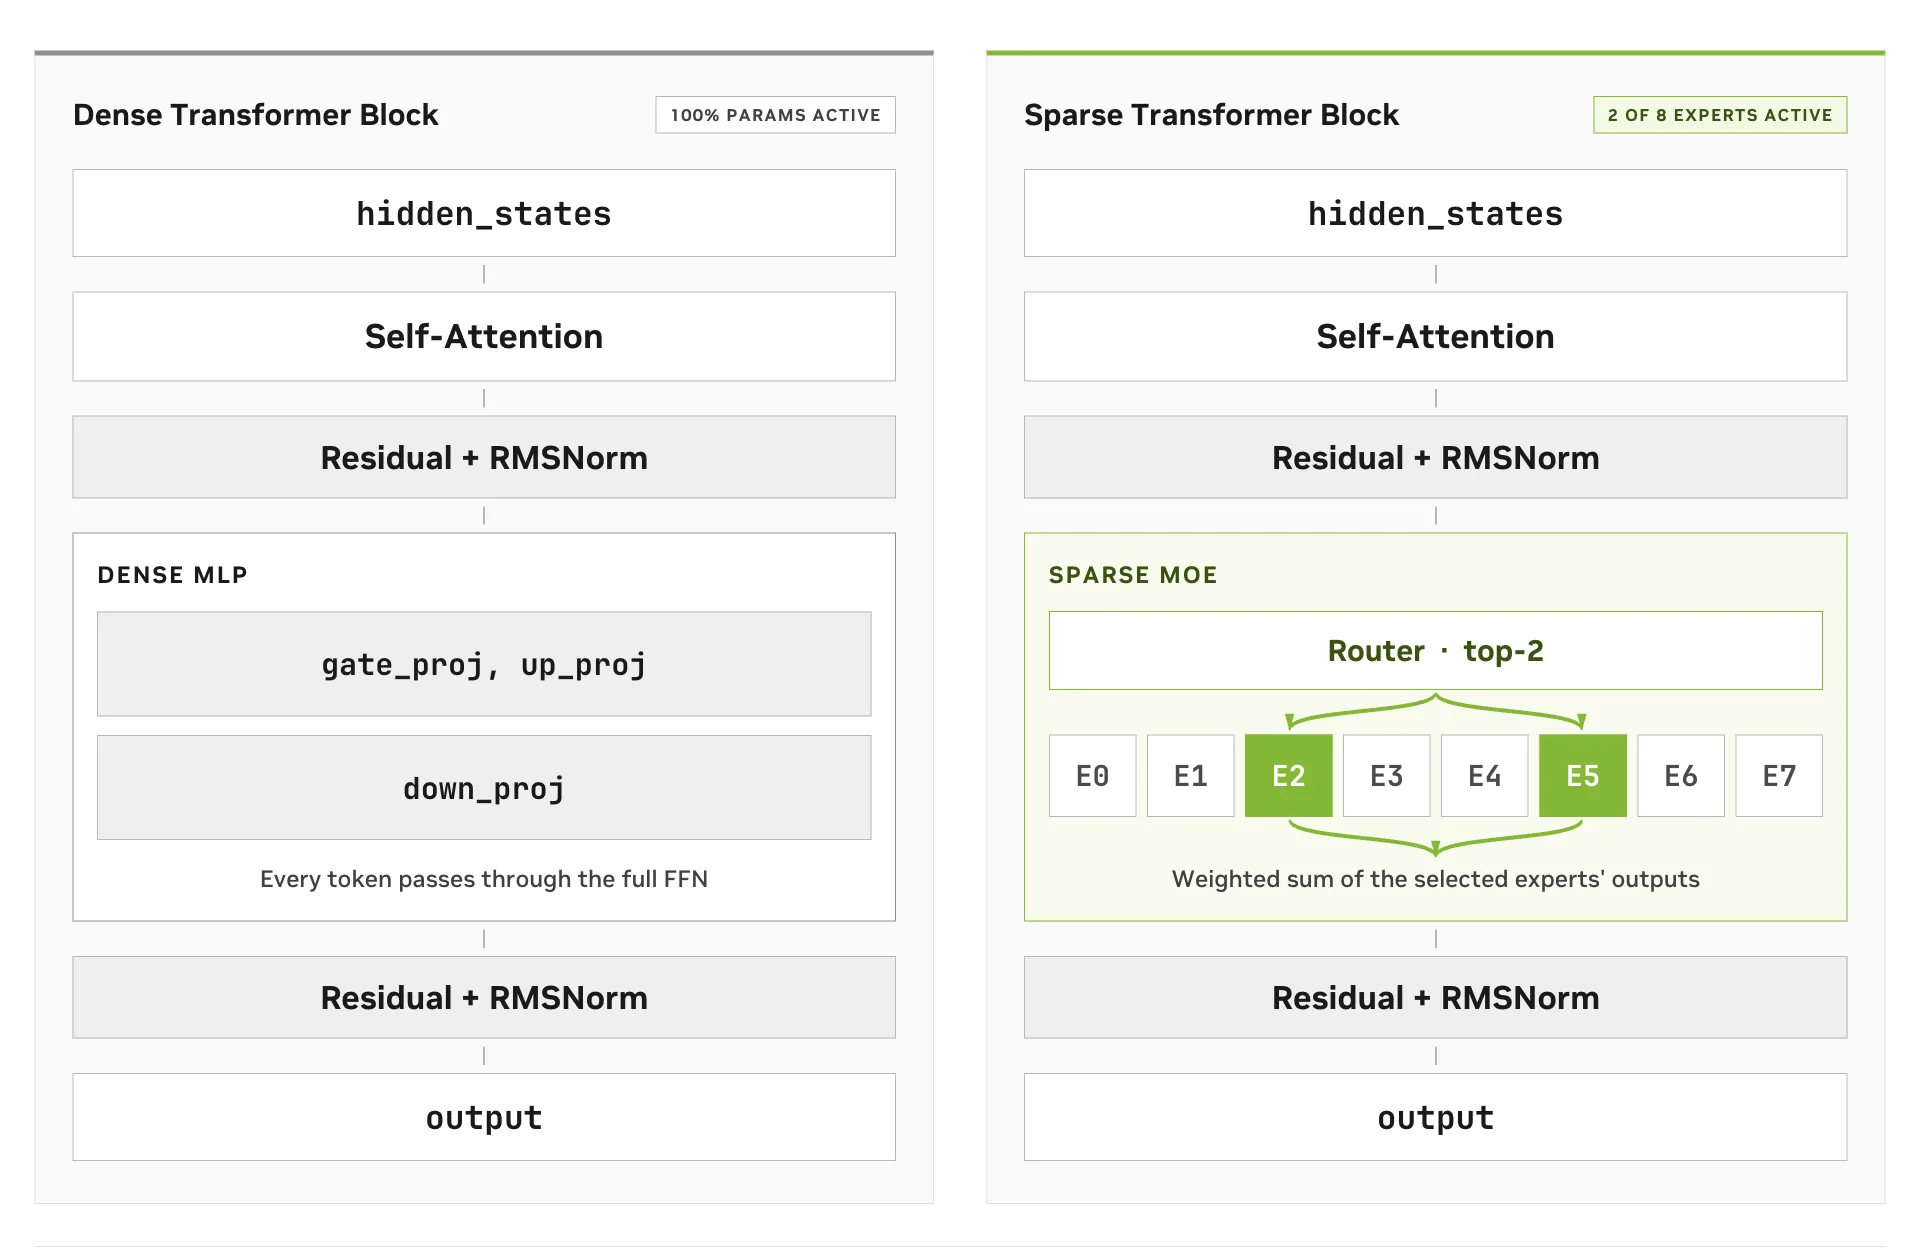
本教程展示了如何通过 NVIDIA BioNeMo MoE recipe 和 TE 将这些技术付诸实践。您将了解 GroupedLinear 如何改进专家计算,MXFP8 如何减少内存使用,以及 GroupedMLP 内核如何融合量化、SwiGLU 和路由权重缩放。这些功能共同为高效训练基于 MoE 的生物基础模型提供了实用参考。
预备知识
开始之前,您需要:
- 熟悉 Python、PyTorch 和分布式训练概念
- 支持 NVIDIA CUDA 的环境 – 您可以使用链接的 Dockerfile 或安装 recipe 要求
- 至少两个 GPU 用于专家并行;需要 NVIDIA Blackwell GPU 才能使用融合的 MXFP8 GroupedMLP 内核
挑战 1:分散的专家内核
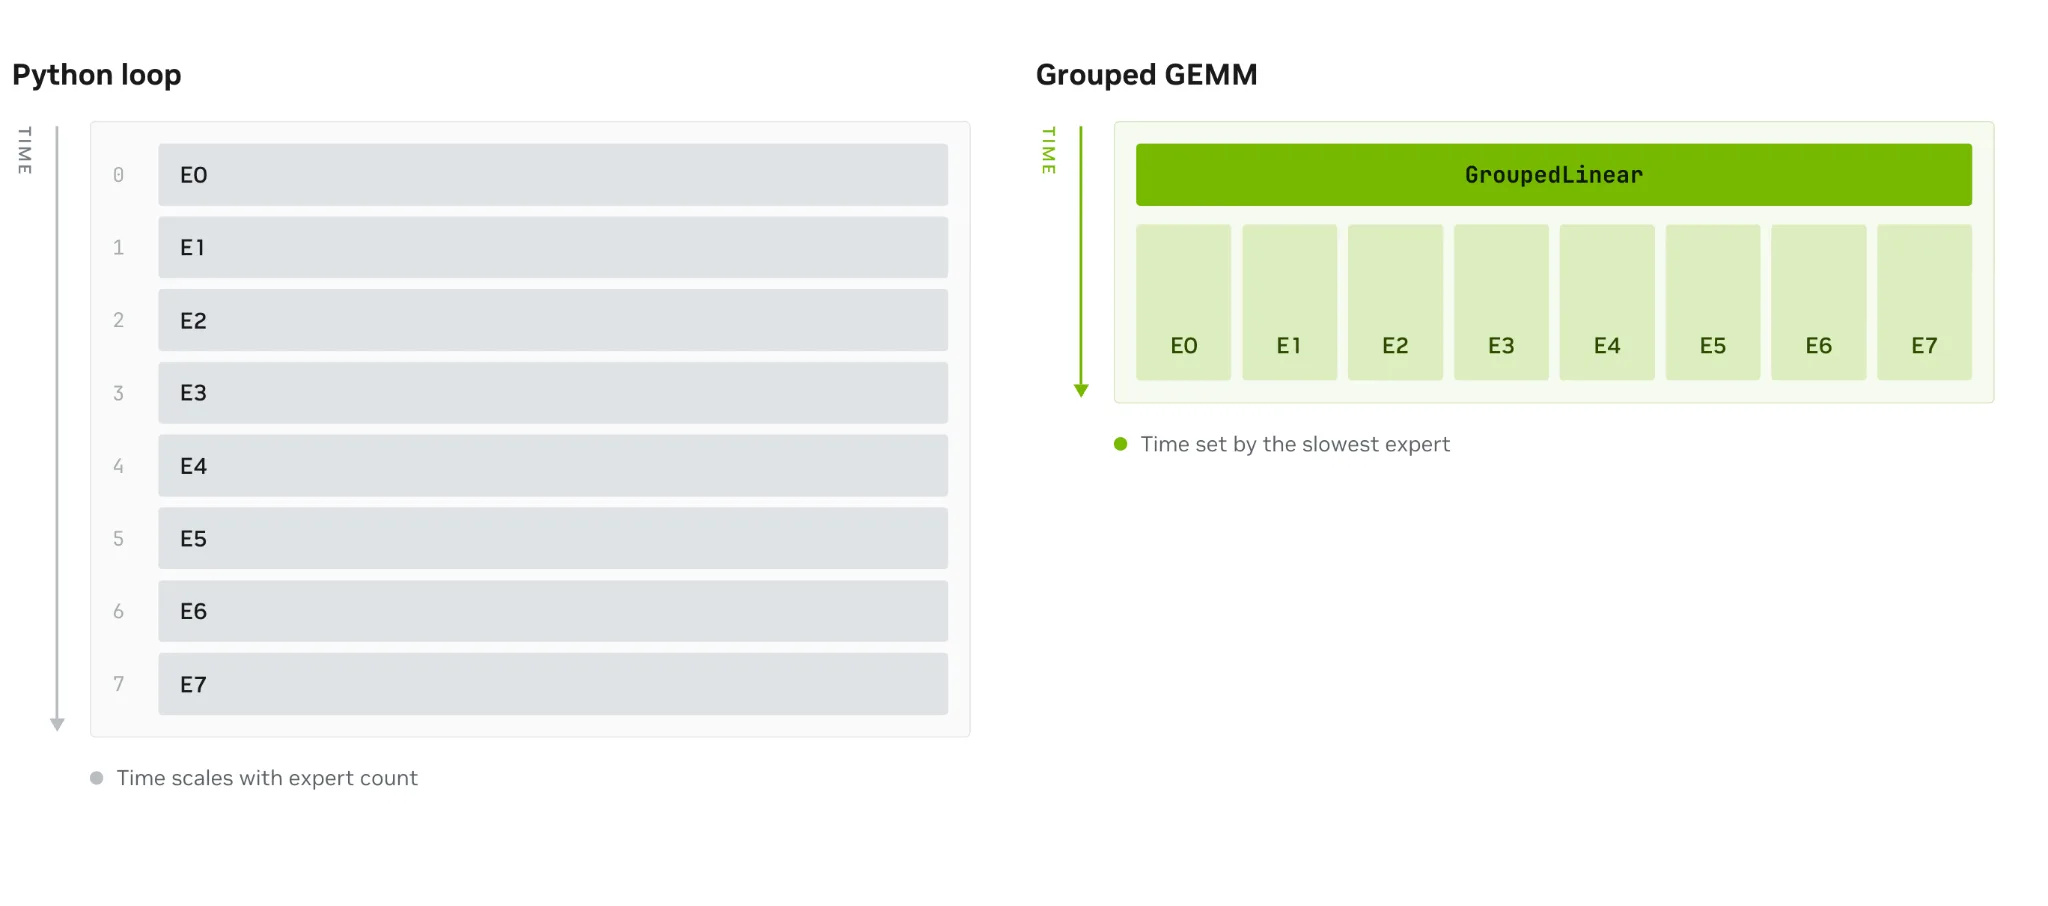
MoE 模型使用多个专家网络取代了单个密集前馈模块。然而,原生实现可能会触发过多的核函数启动。例如,Hugging Face 基准实现在 Python 循环中对所有专家进行迭代,每个专家都会触发单独的核函数启动。
for expert_idx, expert_layer in enumerate(self.experts):
    idx, top_x = torch.where(expert_mask[expert_idx])
    current_state = hidden_states[None, top_x].reshape(-1, hidden_dim)
    current_hidden = expert_layer(current_state) * routing_weights[top_x, idx, None]
    final_hidden_states.index_add_(0, top_x, current_hidden)
分组执行会保留单个专家矩阵,但同时提交其工作。TE 的 GroupedLinear 通过收集专家权重和输入token,在一次调用中应用多个线性变换。由于每个专家可以接收不同数量的token,GroupedLinear 接受每个专家的token数量 (split_sizes) 。它通过 TE 分组的 GEMM 路径提交本地专家,而不是每位专家启动一次 PyTorch Linear 操作,从而减少启动和调度用度。
使用 GroupedLinear,如下所示。每个专家都会保留自己的权重张量 ( weight0、weight1 等) ,并且调用会将每个专家的token计数作为额外的位置参数:
from transformer_engine.pytorch.ops import GroupedLinear

experts_gate_up = GroupedLinear(
    num_groups=num_local_experts,
    in_features=hidden_size,
    out_features=2 * intermediate_size,
    bias=False,
    dtype=torch.bfloat16,
    device="cuda",
)

gate_up_output = experts_gate_up(tokens, split_sizes)
与 Python 循环相比,这种方法将门控投影作为一个分组操作提交,而不是多次单独的调用。
Hugging Face Transformer 还提供 grouped_mm。但是,TE 可以将 GroupedLinear 与 MXFP8 量化、激活、路由权重缩放和中间数据移动融合到 GroupedMLP 内核中,如后面部分所示。
挑战 2:大模型大小和激活内存
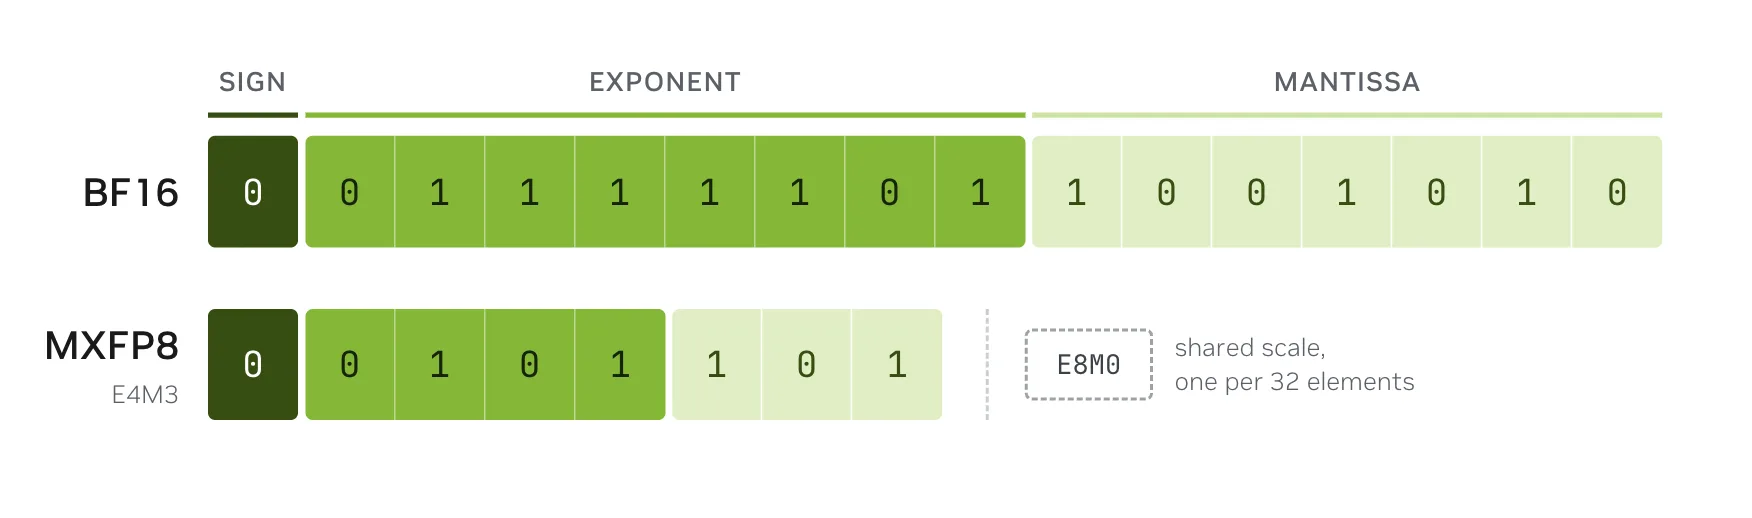
MoE 架构增加了总参数容量,而基因组学工作负载通常使用长序列,这给训练期间的激活记忆带来了压力。BF16 使用 16 位来表示每个模型的权重和激活值。
BioNeMo recipe 使用 TE 支持 FP8 和 MXFP8 训练,从而减少内存使用量。这两种格式均以 8 位 (而非 16 位) 表示权重和激活值。FP8 和 MXFP8 的主要区别在于缩放粒度:MXFP8 为每个包含 32 个连续值的块分配缩放系数,有助于保持数值范围和准确性。在 NVIDIA Blackwell GPU 上,MXFP8 经过硬件加速,使 MXFP8 GEMM 能够使用专用的 Tensor Core 指令。有关 MXFP8 和块缩放的详细信息,请参阅 Transformer 引擎 FP8 入门。
挑战 3:低精度训练中的量化用度
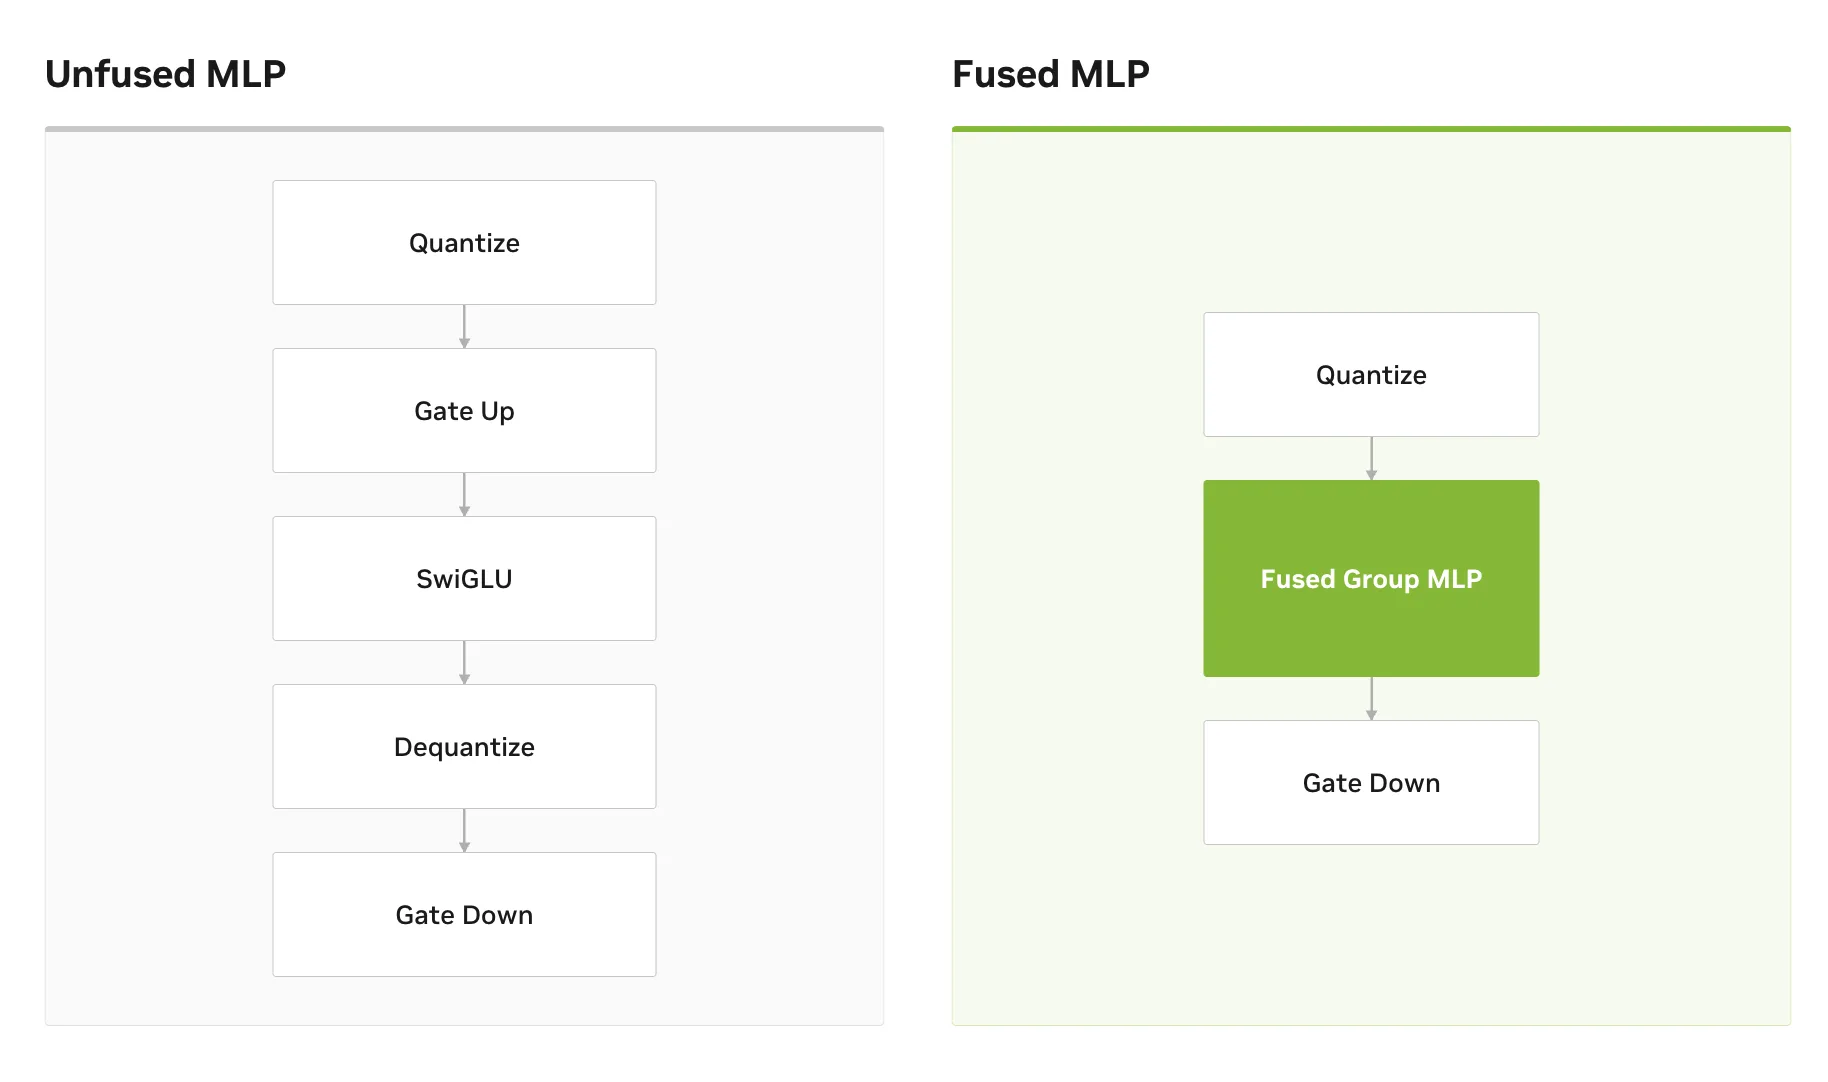
虽然大多数训练计算使用 8 位精度,但模型仍保留 16 位的主权重。因此,训练框架增加了量化和去量化步骤,以在不同格式之间进行转换。量化将 BF16 权重和激活函数转换为 MXFP8,然后再转换为低精度 GEMM;去量化则将结果转换回更高精度的格式。原生路径将这些步骤作为单独的运算来执行,从而推动下文所述的融合 MLP 路径。
fp8_recipe = te_recipe.MXFP8BlockScaling()
model = TEMixtralMXFP8ForCausalLM(config, fp8_recipe=fp8_recipe, dispatcher=dispatcher)
TE 自动投射 API 可为模型的向前和向后传递实现 MXFP8 精度:
with te.autocast(enabled=True, recipe=self._fp8_recipe):
    for decoder_layer in self.layers:
        hidden_states = decoder_layer(hidden_states)
请参阅 BioNeMo recipe 以获取完整代码。
要使用融合的 MLP,请导入 Transformer Engine Sequential API,将 gate_up、ScaledSwiGLU 和 down 链接在一起。API 还会将去量化折叠到融合路径中。ScaledSwiGLU 将路由概率 (“扩展”) 与专家前馈网络计算相结合。
from transformer_engine.pytorch.ops import GroupedLinear, ScaledSwiGLU, Sequential

experts_ffn = Sequential(GroupedLinear(gate_up), ScaledSwiGLU(), GroupedLinear(down))
TE Sequential API 会扫描运算,并在模式匹配时,将 GroupedLinear* ScaledSwiGLU* GroupedLinear 序列替换为融合运算对象:ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8 用于前向传递和匹配的融合后向后运算。这减少了框架开销,将 SwiGLU 和概率缩放工作融合到分组的 MLP 路径中,并避免实现一些中间结果。
结果
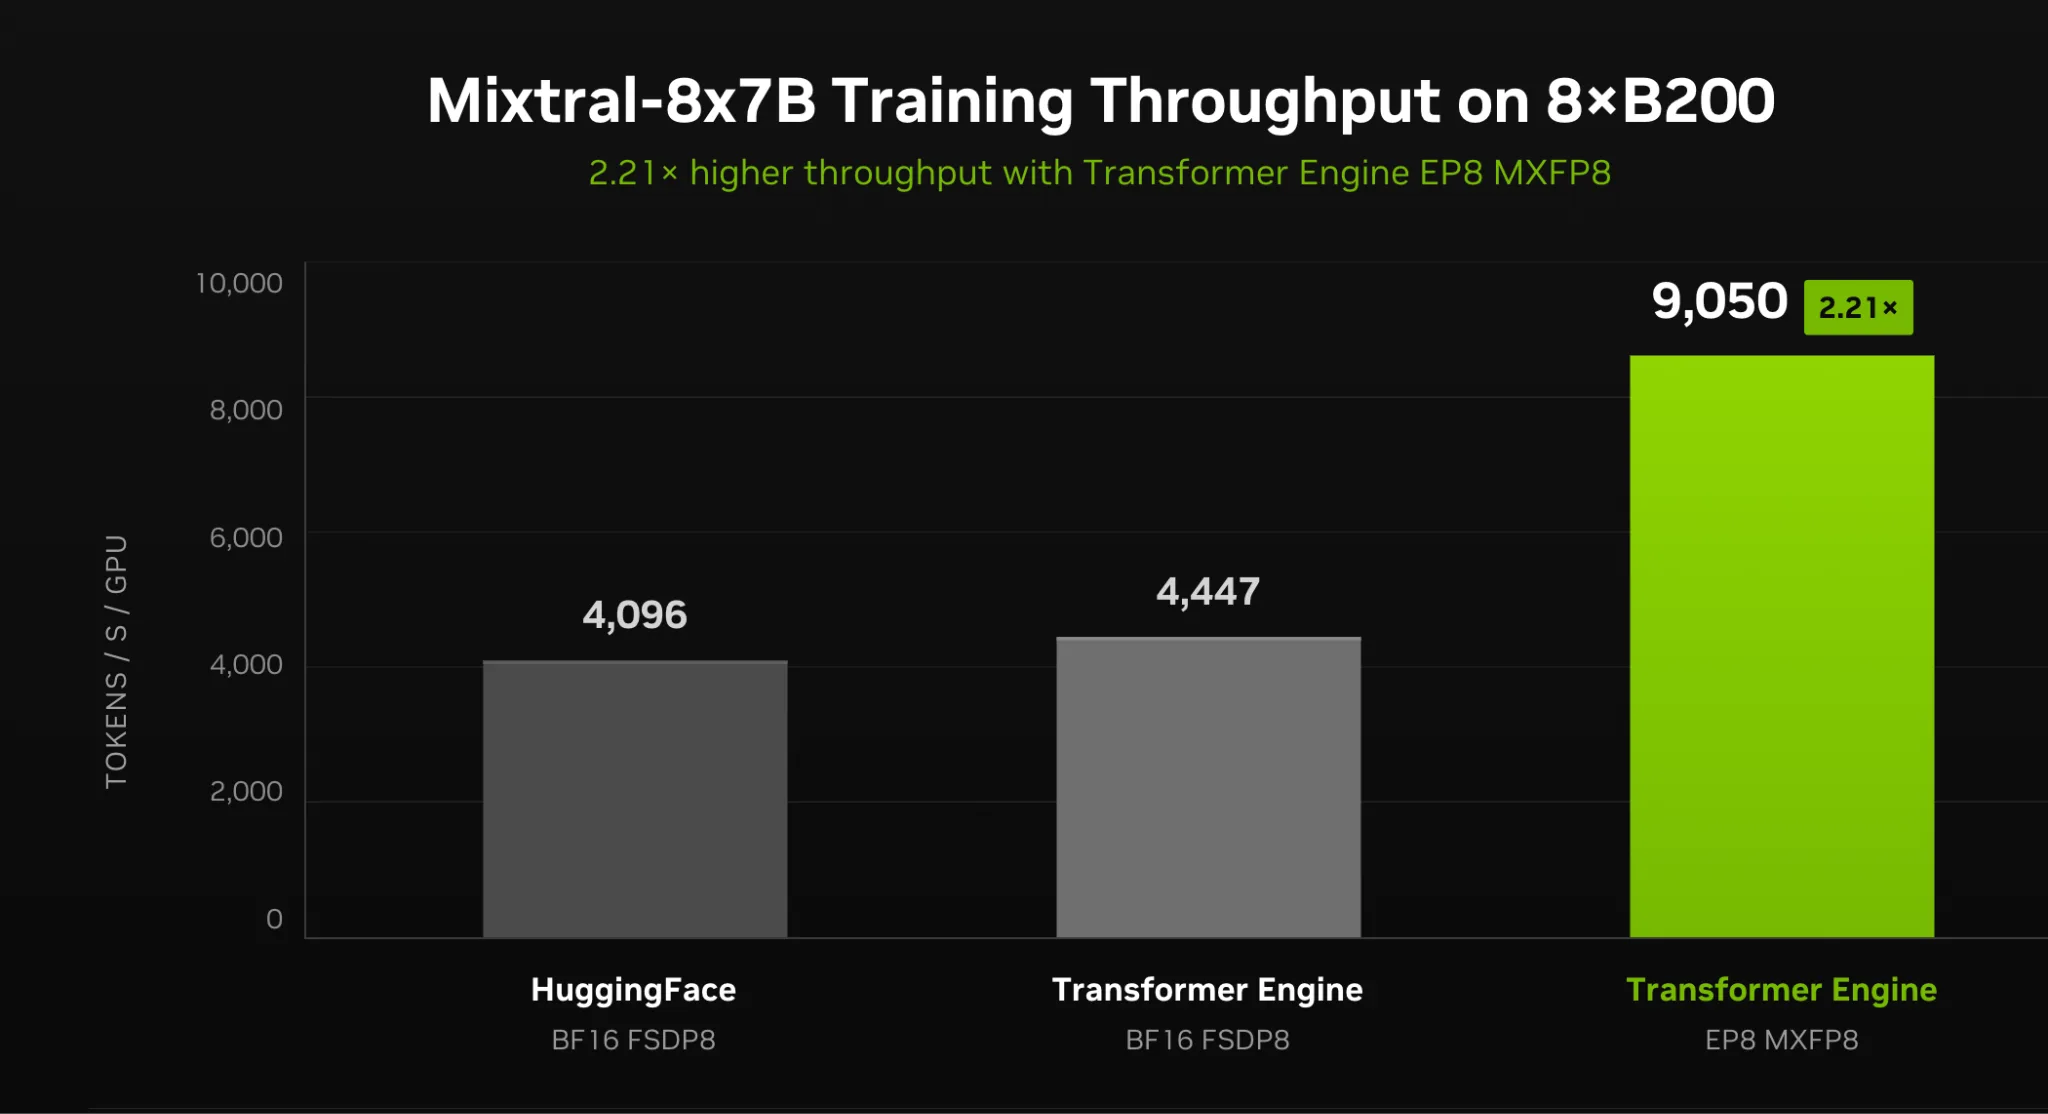
这些是 BioNeMo recipe 中的几项优化。在我们基于 8 个 NVIDIA B200 Tensor Core GPU 进行的训练基准测试中,该方法提供的吞吐量高达 Hugging Face 基准的 2.21 倍。
运行 recipe
从双 GPU L0_sanity 配置开始,确认专家并行和训练环境是否正常工作:
torchrun --nproc_per_node=2 train_fsdp2_ep.py --config-name L0_sanity
验证后,跨 8 个 GPU 扩展到具有专家并行性 (EP = 8) 和 MXFP8 精度的 Mixtral-8x7B 配置:
torchrun --nproc_per_node=8 train_fsdp2_ep.py --config-name L1_8x7B_ep checkpoint.ckpt_dir=/path/to/ckpt
根据您的 GPU 和显存需求选择 BF16 或 MXFP8,并设置数据并行和专家并行大小,使其产品等于 GPU 总数。recipe README 包括启动、检查点和基准测试命令。
试用 BioNeMo Recipes 中的 Mixtral Native Transformer Engine recipe,并在 NVIDIA Transformer Engine 文档中详细了解经过优化的 MoE 内核。
致谢
Sudhakar Singh、Varun Thumbe、Santosh Santosh、Timur Rvachov 和 Chris Hoge。