

企业应用的要求越来越高。代理式 AI 通过对日益庞大的数据集进行频繁而复杂的查询,增加了对大量企业数据的需求。
满足这一需求需要更高的数据吞吐量,而成本不会按比例增加。NVIDIA cuDF 通过利用 GPU 的大规模并行性和高带宽显存进行数据分析来应对这一挑战。特别是,适用于 Apache Spark 的 NVIDIA cuDF 插件为业界领先的大数据处理和分析平台Apache Spark带来了这种加速,从而在主要工作负载中实现更好的TCO 性能。
用户定义函数 (UDF) 长期以来一直是加速查询引擎的问题,由于其不透明性质,会产生运行时开销。虽然 UDF 通常可以替换为性能更高的代码,但重写 UDF 长期以来一直是一个需要仔细验证的费力过程。
本文将介绍如何使用智能体在几分钟内将 UDF 重写为 GPU 加速的同等性能,从而在 Apache Spark 作业中实现 22 倍以上的加速。我们将介绍适用于 Apache Spark 的 cuDF 技能,这是一套快速突破端到端开发 UDF 瓶颈的技能,涵盖测试、基准测试和集成。
UDF 挑战
cuDF 能够实现无缝的 GPU 加速,部分原因在于 Apache Spark 的声明式编程接口。SQL / Dataframe 抽象非常强大,因为它们将查询应生成的内容与系统应如何执行查询分开。这使 cuDF 插件能够使用 GPU 的强大SIMD功能透明地并行化行运算,而无需更改用户代码。
但是,Apache Spark 也支持 UDF:用于扩展内置功能的自定义例程。虽然 UDF 对于实现定制业务逻辑很有用,但它打破了声明性抽象 — — 它们包含系统无法在任何一般意义上进行推理或并行化的任意用户代码。在执行期间,GPU 加速器必须将数据从列式转换为逐行格式,然后回退到 CPU 以逐行执行 UDF:
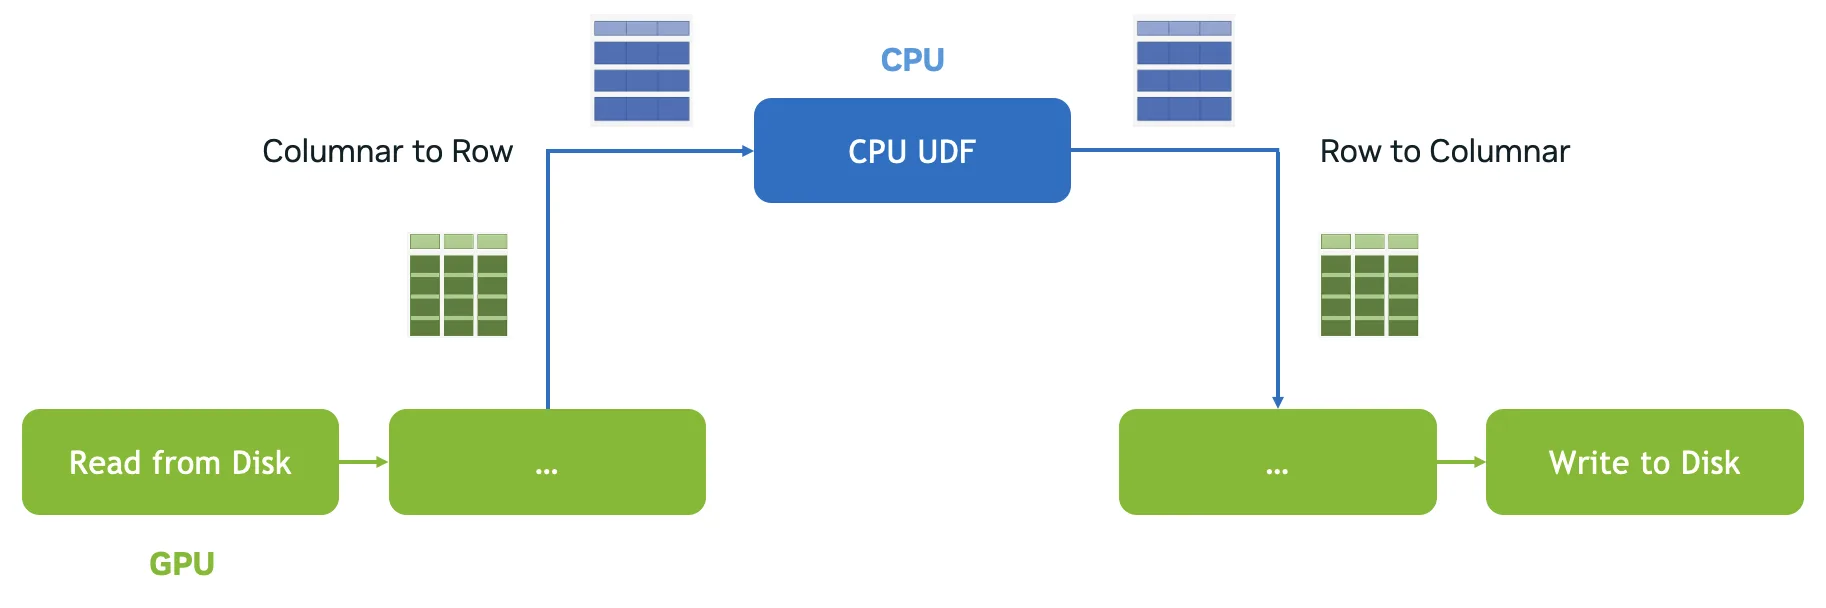
因此,在以其他方式加速的查询中,UDF 存在以下缺点:
- 由于回退,UDF 会产生往返数据传输用度。
- 如果使用 GPU 加速的基元编写,UDF 将放弃潜在的计算加速。
加速 UDF
只需进行少量定向代码更改,即可使用正确的基元将许多 UDF 重写为 GPU 加速的形式。重写 UDF 可消除与加速器回退相关的开销,并可将速度提高 20 倍以上。
我们概述了三种重写 UDF 的方法:
| 方法 | 复杂性 | 最适合 |
|---|---|---|
| SQL | 低、最高级别的抽象 | 简单的关系逻辑,例如。小型或内联函数 |
| cuDF | 中等水平,更高的灵活性和对执行的控制 | 大多数情况下,例如。中度复杂的逻辑,如字符串解析、嵌套类型 |
| CUDA | 高度灵活性和内核级控制 | 最复杂或性能关键型逻辑 |
为了使这些方法具体化,请考虑使用一个简单的 Scala UDF,将温度从摄氏度转换为华氏度:
final class ToFahrenheit
    extends Function1[java.lang.Double, java.lang.Double]
    with Serializable {

  override def apply(celsius: java.lang.Double): java.lang.Double = {
    if (celsius == null) null
    else celsius * 9.0 / 5.0 + 32.0
  }
}

spark.udf.register("to_fahrenheit", new ToFahrenheit)
spark.sql("""
  SELECT
    *,
    to_fahrenheit(celsius) AS fahrenheit
  FROM temperatures
""")
使用 SQL 重写 UDF
对于简单的 UDF,最直接的解决方案是将 UDF 替换为等效的 Spark SQL 表达式:
spark.sql("""
  SELECT
    *,
    celsius * 9.0 / 5.0 + 32.0 AS fahrenheit
  FROM temperatures
""")
这使得该函数在 Spark 的表达式树中可见。在查询规划期间,cuDF 插件会将这些表达式替换为相应的 GPU 实现,从而将数据和执行完全保留在 GPU 上。
使用 cuDF 重写 UDF
当 SQL 基元不足或不可取时,UDF 可以改为使用 RapidsUDF 接口 ( cuDF 插件提供的合同) 直接在 GPU 列上运行。合约需要一种方法,即 evaluateColumnar:
import ai.rapids.cudf.{ColumnVector, Scalar}
import com.nvidia.spark.RapidsUDF
import scala.util.Using

final class ToFahrenheit
    extends Function1[java.lang.Double, java.lang.Double]
    with Serializable
    with RapidsUDF {

  override def apply(celsius: java.lang.Double): java.lang.Double = {
    if (celsius == null) null
    else celsius * 9.0 / 5.0 + 32.0
  }

  override def evaluateColumnar(
      numRows: Int,
      args: ColumnVector*): ColumnVector = {
    Using.Manager { use =>
      val scale = use(Scalar.fromDouble(9.0 / 5.0))
      val offset = use(Scalar.fromDouble(32.0))
      val scaled = use(args.head.mul(scale))
      scaled.add(offset)
    }.get
  }
}
cuDF 插件可识别 Java API 的 RapidsUDF 接口实例,并将 GPU 驻留 ColumnVector 传递给 evaluateColumnar 函数。然后,该函数组合来自 Java API 的运算,以进行 cuDF 运算,从而并行处理列。这种方法为更复杂的处理提供了更丰富的 API。
使用 CUDA 重写 UDF
对于无法通过现有 cuDF 操作高效组合的高度复杂逻辑,RapidsUDF 可以通过 Java 原生接口 (JNI) 调用自定义 CUDA 内核。为简洁起见,我们已略过代码,但可以在 Spark UDF 的 cuDF 示例 中找到 CUDA 转换示例。
使用 AI 智能体进行高效重写
尽管具有性能优势,但 UDF 重写可能需要大量的工程工作。它们需要谨慎的 API 选择、语义验证和性能衡量,而对于在矢量化编程方面经验较少的从业者来说,列式 API 可能并不熟悉。
幸运的是,这项工作大部分非常适合编码智能体。借助适当的护栏,智能体可以搜索不熟悉的 API、实施候选重写并快速迭代,而可执行测试和性能测量则可确定每个更改是否可接受。
可用技能
Apache Spark 的 cuDF 技能将重写分解为四个重点反馈循环。每种技能都定义了要执行的工作和进入下一阶段所需的证据:
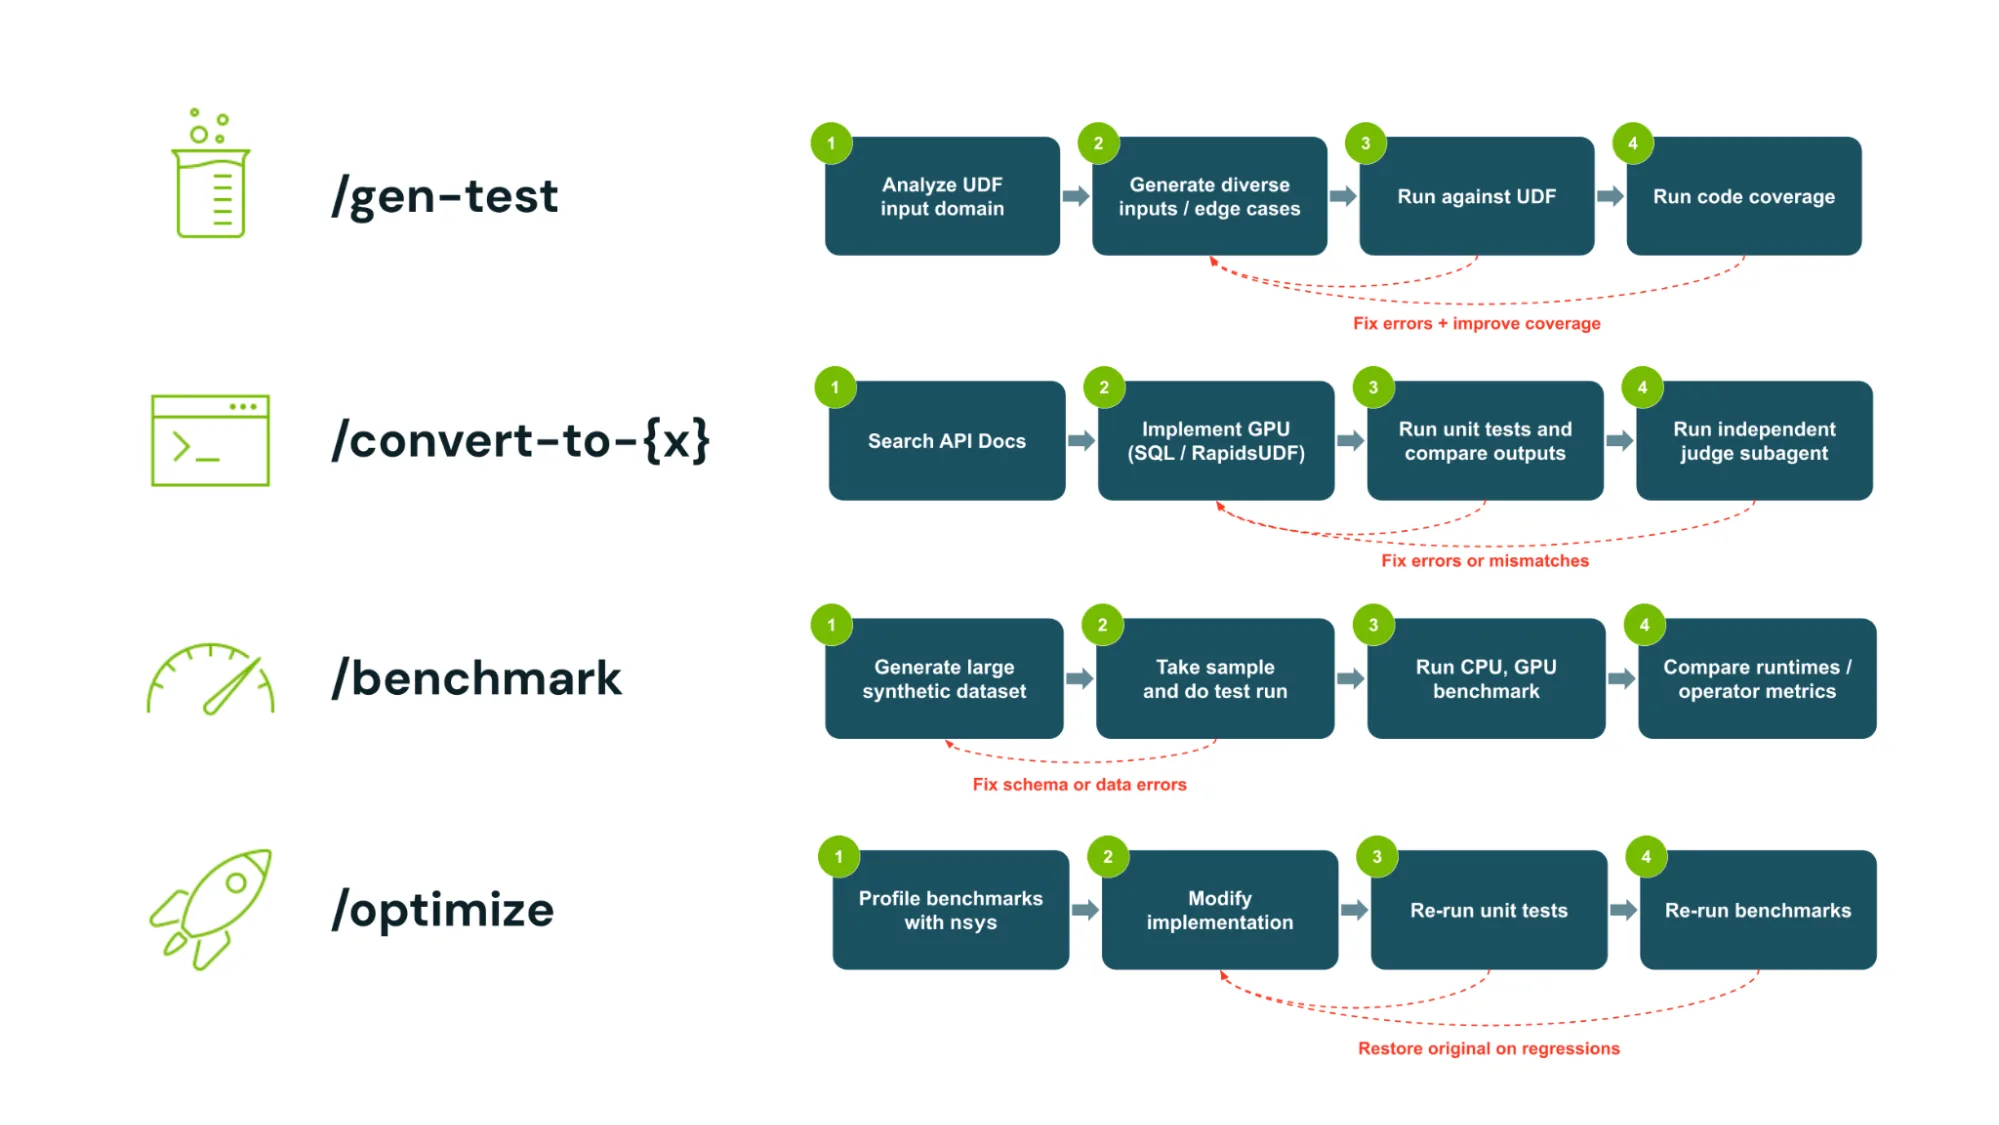
图 2. 四种技能通过测试、转换、基准测试和优化指导智能体,并在每个阶段提供验证驱动反馈回路
支架和设计
可靠的智能体执行始于可靠的开发环境。这些技能提供了一个完整的项目模板,其中包含端到端开发所需的 cuDF 和 Spark 特定的支架。这包括测试和基准测试工具、用于输出验证的编码例程以及构建配置。通过将这些知识编码到代码中,智能体可以专注于 UDF,而不是重复地重建专用基础设施。
这些技能还提供了使用 cuDF 进行 GPU 编程的最佳实践,包括内存管理和配置。这可作为咨询提示和技巧参考。为了充分利用前沿模型的强大功能,智能体可以根据周围环境自由探索不同的实现,并根据测量的正确性和性能选择一种方法。
性能结果
一家大型消费科技公司使用此工作流将生产数据工作流中使用的 30 多个 UDF 转换为 GPU 加速的实现。重写保留了原始 CPU UDF 的行为,同时消除了 GPU 加速工作负载中代价高昂的回退。例如,以下基准测试显示了此类工作负载中 UDF 产生的前后性能:
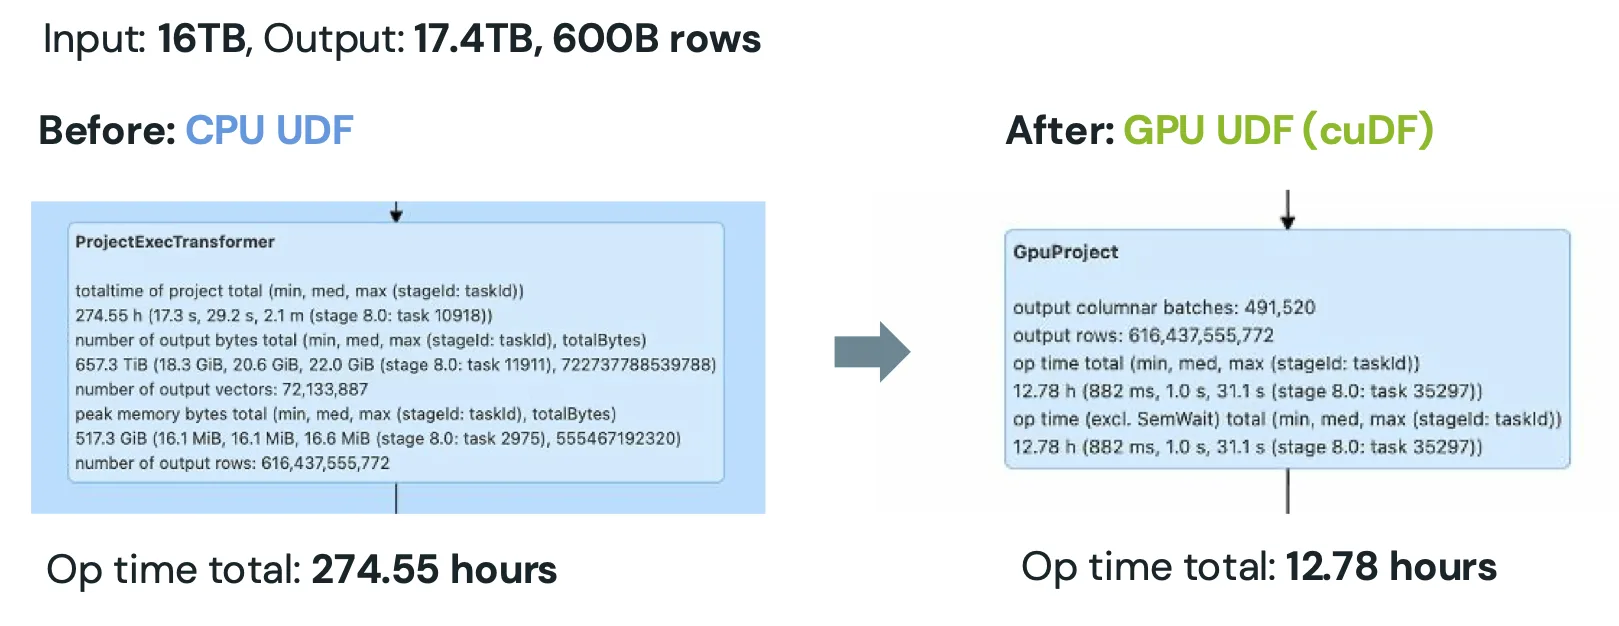
这种特定的 UDF 对 3000 多个作业 产生了影响,在此作业中,作为支持 cuDF 的 RapidsUDF 实施时,速度提高了 22 倍。在智能体的帮助下,这些性能提升更容易实现,使从业者能够在不影响正确性的情况下,以数小时 (而不是数天或数周) 为单位迭代重写内容。
开始使用
将 UDF 转换为 GPU 实施可以大大加快速度,并有助于节省 GPU 加速工作流的总体成本。借助智能体技能,重写过程变得既简单又可靠。
要开始使用,请直接或使用 npx 技能安装程序在 GitHub 上安装 Apache Spark 的 cuDF 技能:
npx skills add NVIDIA/cudf-spark --skill ‘*’
有关工作流的更深入演练和构建工作流的实践经验,请参阅 Data+ AI Summit 会议使用 AI 智能体进行编码,利用 GPU 加速为 Spark UDF 提供强力支持。
如需详细了解适用于 Apache Spark 的 GPU 加速,请遵循适用于 Apache Spark 的 cuDF 插件入门指南,在 Spark 工作流中解锁更好的性能和 TCO。访问我们的网页,详细了解NVIDIA cuDF:GPU 加速的结构化数据处理;您也可以阅读文档,了解有关适用于 Apache Spark 的 NVIDIA cuDF 插件的更多信息。

