

黑洞的成像极具挑战性,因为它们很遥远,在天空中看起来很小,例如,M87+ 的观测环只跨越 42 微角秒。黑洞本身不会发出任何光线,因此望远镜可以捕获到超热气体在活动范围外旋转产生的无线电波辐射。黑洞的强烈引力会弯曲这种光的路径,形成形成中心阴影的明亮环。
事件地平线望远镜 (EHT) 通过甚长基线干涉测量 (VLBI) 将夏威夷、智利、西班牙、墨西哥和北极等地的 13 个无线电天文台台站连接起来,解决了这一挑战。这些站点以高速电压流的形式记录毫米和亚毫米无线电信号,这些信号经过同步和组合以重建详细的图像。新一代 EHT (ngEht) 旨在增加观测点,以提高图像质量并追踪黑洞周围一段时间的变化。
本文将介绍如何使用 cuPhoton.xBeam 进行基于 GPU 的干涉测量,从读取望远镜记录到生成可见光和跨多个 GPU 进行扩展。这些测量结果可用作下游校准和图像重建的输入,而这不在本教程的讨论范围内。
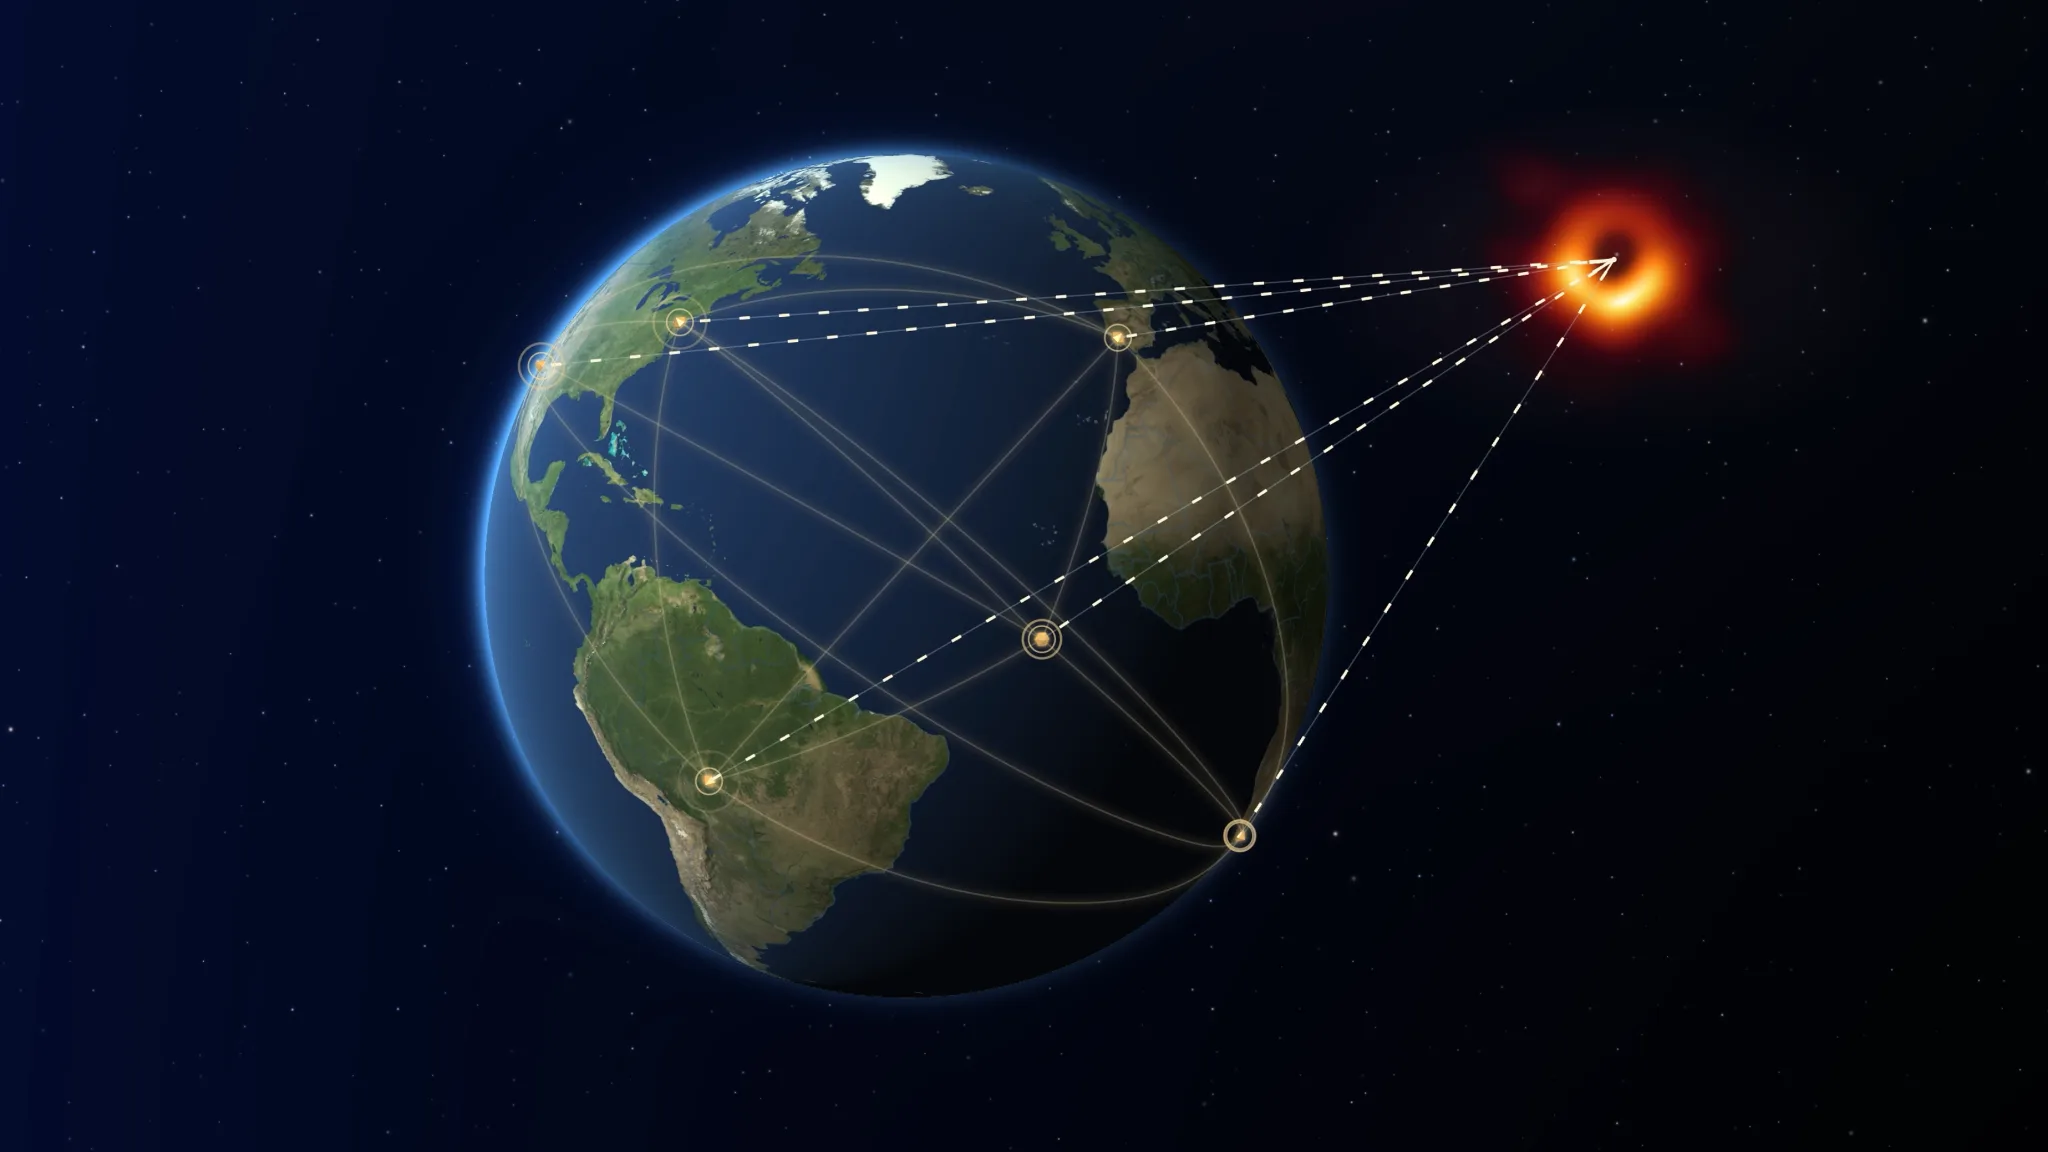
NVIDIA cuPhoton.xBeam 为干涉测量法执行基于 GPU 的相关性,并整理记录的数据以进行并行读取。它将来自成对望远镜的信号关联起来,为每对站点、每个频率通道和每个较短的时间间隔生成一个复杂的可见度。下一步可能涉及通过独特的下游过程 (例如 Gaussian splatting) 根据这些可见光构建 3D 气体模型。这种方法将排放的气体模拟为在旋转黑洞附近沿着轨道移动的众多致密发光的斑点,并经过优化以匹配所观察到的可见光。cuPhoton 目前尚未加入第二个组件。
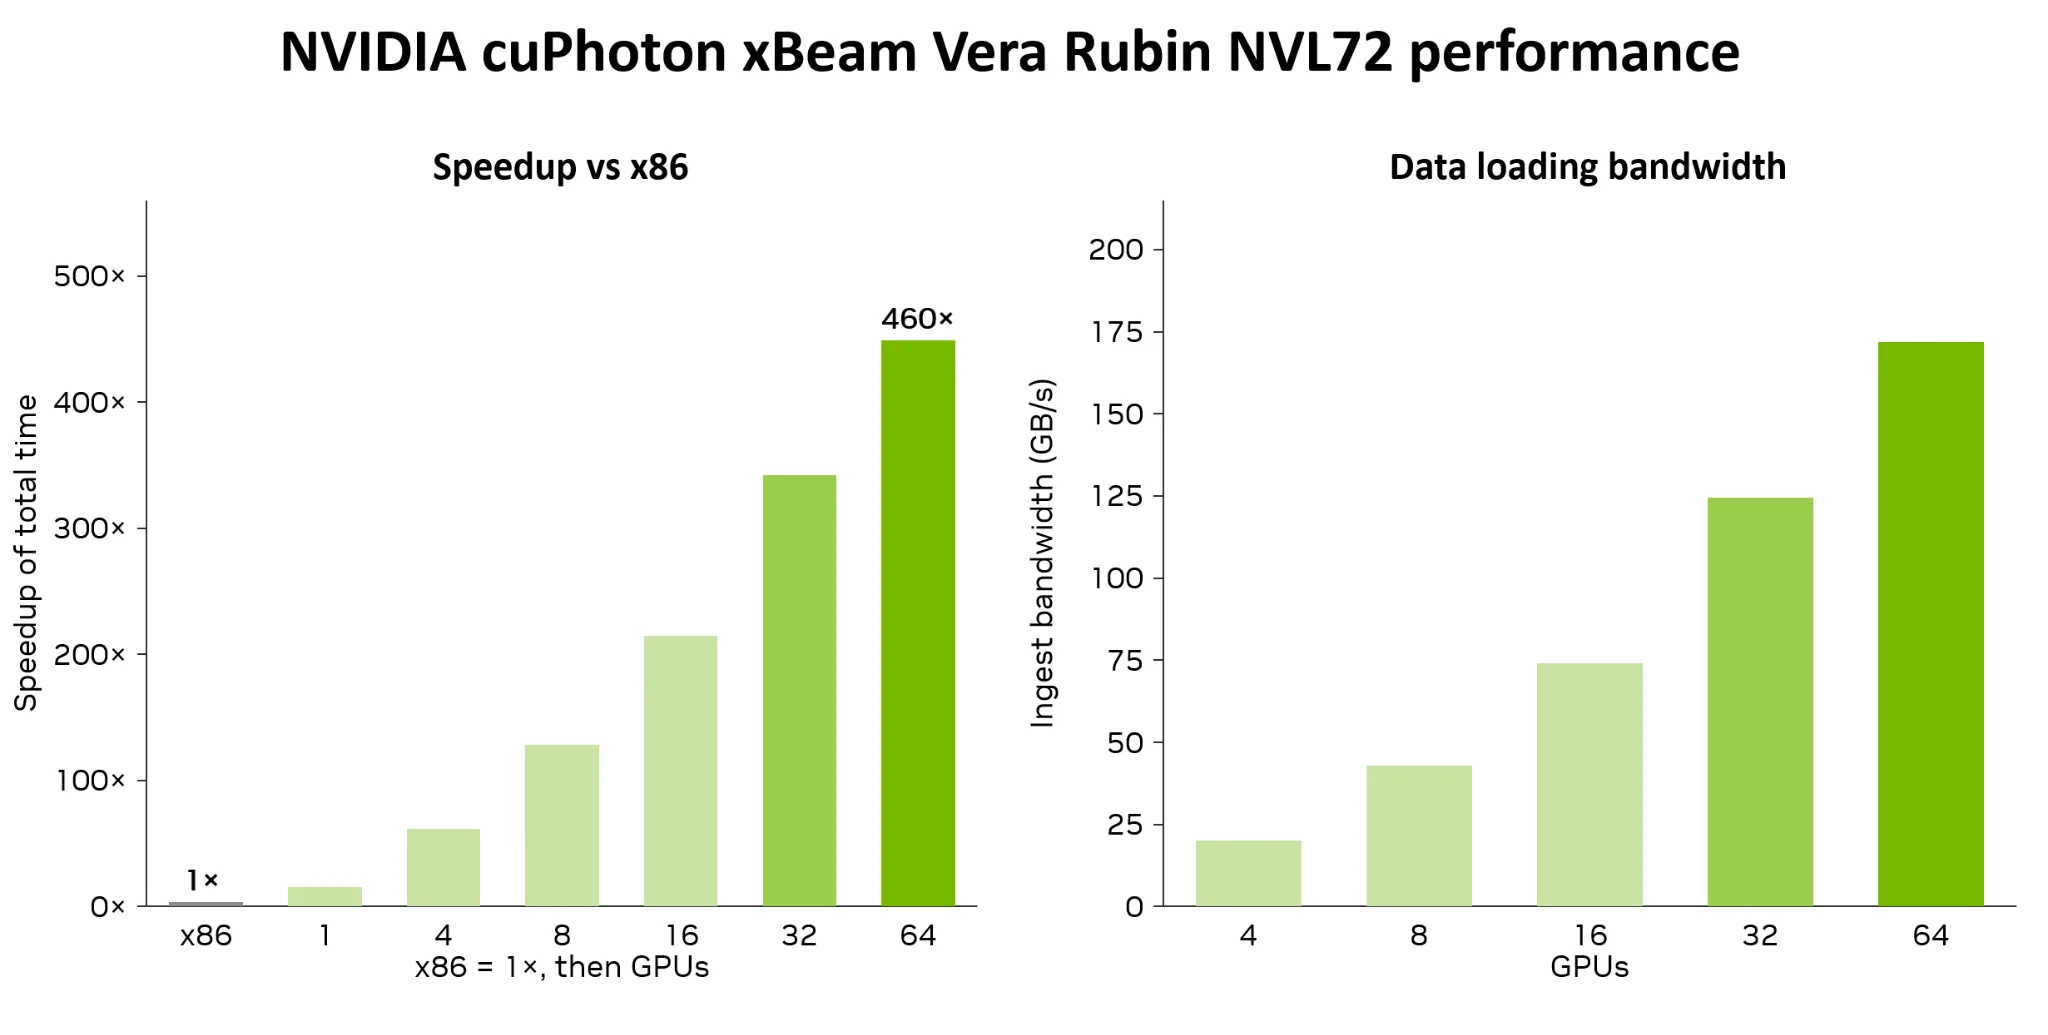
NVIDIA cuPhoton 团队与哈佛 – 史密森天体物理学中心和麻省理工学院海斯特克天文台合作,使用 xBeam 加速数据提取和关联。在兼容模式下,xBeam 在搭载 64 个 GPU 和 GPUDirect Storage (GDS) 的 NVIDIA Vera Rubin NVL72 系统上运行,在 70 秒内处理了 10 TB 的数据集,比 x86 CPU 基准 31992 秒 ( 8.89 小时) 快 460 倍。
天空是一个相反的问题
EHD 以高达 64Gbs 的速度记录两次极化的无线电信号,产生 PB 级的数据。望远镜对之间的相关信号会产生可见度,对天空亮度的里叶分量进行采样。地球自转会追踪稀疏的测量轨迹,而重建算法会将这些样本合并为图像。Sgr A+ 等光源的快速变化使这一过程变得复杂,因为观测结果捕获的光源会随着时间的推移不断变化。
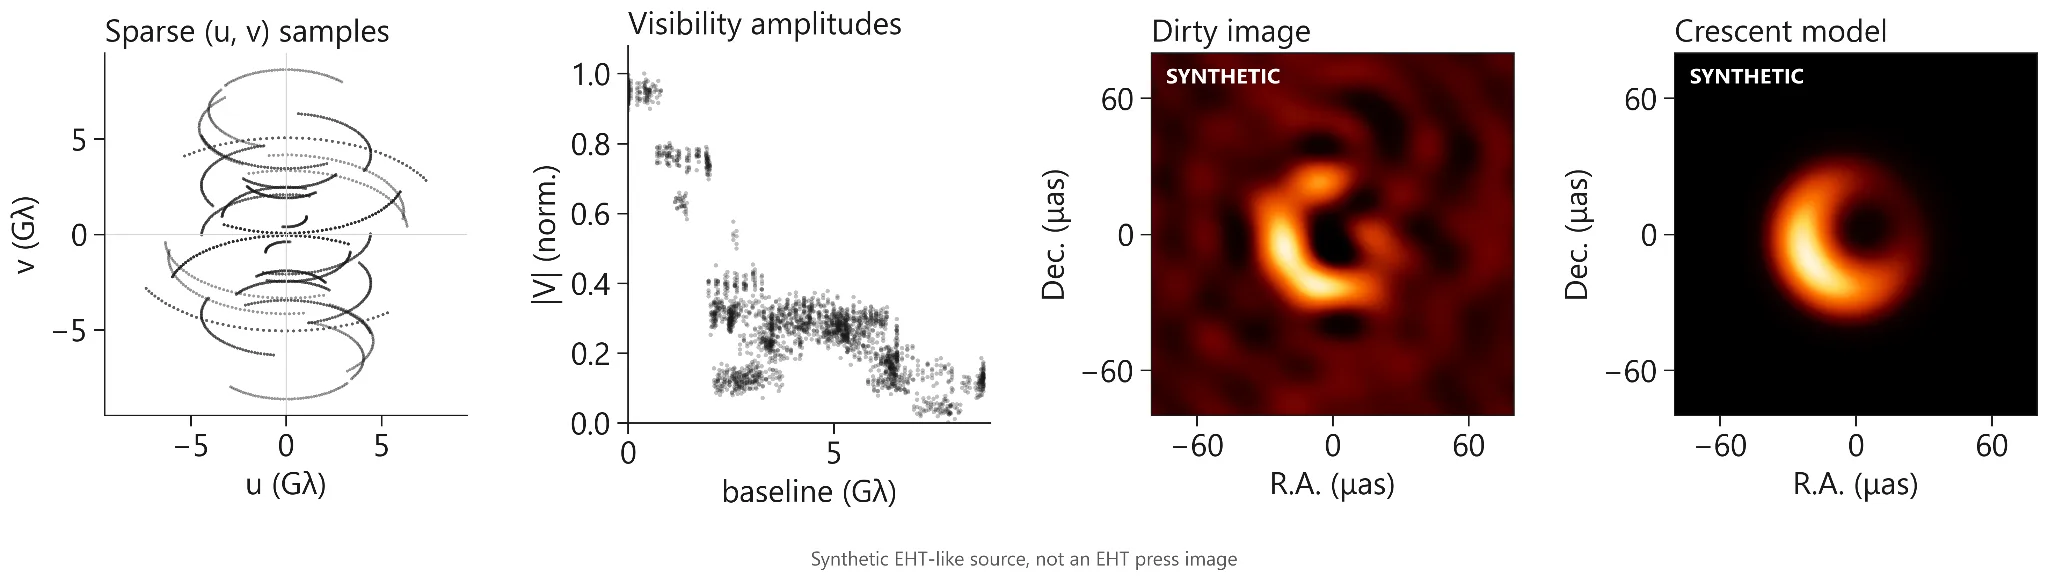
在 1.3 毫米处观察到的地球大小的阵列仅收集沿地球自转绘制的椭圆轨道的 (u,v) 测量值。由于没有物理透镜直接形成图像,因此重建算法必须解决反向问题,才能从稀疏样本中合成图像。对于 Sgr A* 等目标,源会在观察会话期间发生变化,导致假设静态源的重建方法变得复杂 (聚焦于 First Sgr A* 结果) 。
图 2 显示了使用合成光源的成像工作流程。左侧面板显示的是 (u,v) 轨道,该轨道是在地球自转的某一晚上按 2017 年 EHT 样本的形式排列的数组。下一个面板显示可见度振幅, | V ( u,v) | 根据基准长度绘制,然后是由稀疏样本形成的模糊图像。右侧面板显示的是一个月牙形模型,这是一个研究人员可以适应这些振幅的简单环形图像。
穿过黑洞附近的光线可以先绕其运行再逃离,从而在阴影边缘附近形成一个薄薄的光子环。其大小和形状有助于限制黑洞的质量、旋转和视角,而其干涉测量信号会产生特征振荡。拟议中的黑洞探测器 (BHEX) 旨在测量这个环,而未来在 345 GHz 下进行的 ngEHD 观测可以通过极化测量来检测其特征。
cuPhoton.xBeam 计算的内容
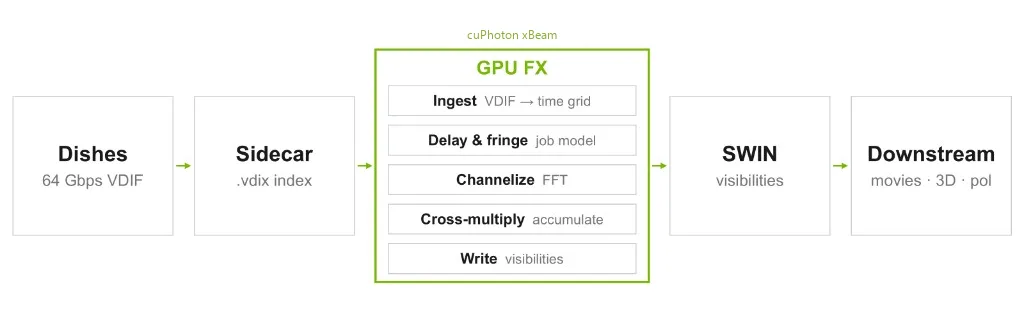
cuPhoton.xBeam 是 cuPhoton 工具包中的 FX 相关器。它会调整录制内容的结构,使其能够并行读取,构建 .vdix 索引,以便后续读取内容直接跳转到每一帧,并将电压加载到 GPU 显存中。然后,它执行 FX 工作,如 DiFX (基于 CPU 的开源软件相关器) :它通过里叶变换器将每个工作站的电压转换为频率通道 (F) ,并在作业请求的每个频率通道上交叉乘以工作站和极化对 (X) 。这些步骤在 GPU 上运行。xBeam 依次执行以下五项操作:
1. 摄取。读取 VDIF 帧,并在正确的时间放置每个帧。xBeam 构建了一个名为 .vdix sidecar 的小型索引文件,该文件可记录每一帧的位置,而无需复制数据,因此后续读取会跳转到正确的位置。
xBeam 按时间、线程和物理位置对 VDIF 帧进行索引。其 .vdix sidecar 可让后续读取找到所需数据,而无需重写录制内容。缺失或无效的数据将保持显式追踪。
2. 延迟和边缘。通过作业模型中的延迟来移动每个站点的样本,因此相同的波前在每个站点排队,并消除由地球运动引起的相位漂移。延迟校正涵盖快速里叶变换 (FFT) 的两侧。整数-样本比对和条纹旋转发生在通道化之前;依赖频率的相位校正可在之后处理剩余的分数-样本延迟。
3. 渠道化。在每个工作站的电压流上运行 FFT,将其拆分成多个频率通道。
4. 交叉乘法和累加。对于每两个站点,将一个站点的每个通道的频谱乘以另一个站点的相应频谱的复共,并将积分时间内的乘积求和。对无效的输入进行遮罩,并使用有效性衍生的曝光权重对累积的乘积进行归一化。所选处理配置文件控制其他准入和报告的权重约定。
5. 写入可见性。以 DiFX 的 SWIN 格式或 xBeam 自己的 xbeam-v1 格式保存结果,无论作业要求何种格式。
xBeam 应用的延迟来自工作文件。它是不同延迟的总和:几何延迟,参数化为围绕参考时间 t0 的时间多项式,加上由每个站点的时钟偏移和线性漂移产生的延迟,以及每个频段的固定时钟偏移量:
在一个 FFT 中,xBeam 要么保持延迟常数,要么使用直线或抛物线近似表示该常数,在 fringe_approximation_order 设置中,其数量为 0、1 或 2。应用于样本的相位校正
其中,νref 是频段的参考频率,νLO 是局部振荡器频率项。对于频率ν处的站点 a 和 b ,求和的乘积是站点频谱 a 乘以站点频谱 b 的复共的乘积:
xBeam 不会计算站点位置的延迟。它使用作业中给出的延迟。它也不会追踪黑洞周围的光线路径。DiFX 是 CPU 相关器,用作验证 xBeam 结果的参考。HOPS、rPICARD 和 eht-imaging 等工具可借此获取校正和成像的可见性。
数据以两种方式之一从磁盘移动到 GPU 显存:标准 POSIX 读取固定主机显存,或通过 cuFile ( GPUDirect Storage API) 读取。cuFile 是否使用直接存储到 GPU 的路径取决于配置和运行时条件。相位校正、FFT 和交叉乘法均在 GPU 上运行。使用多个 GPU 的作业会及时分割扫描结果 ( --shard-count、--shard-index ) ,而 merge-shards 会加入部分 SWIN 输出。
运行一项作业
xBeam ( cuPhoton v0.1.3 的一部分) 可获取标准化的 JSON 作业、架构版本 1 或受支持的 DiFX.input 文件。您可以在 NVIDIA/cuPhoton 资源库中找到记录和匹配的工作文件示例。工作名称包括站点、时钟、频率、VDIF 数据流、基准和扫描。请使用 JOB.json 查看录制内容。输出目录必须为新目录。运行以作业的输出格式 ( swin 或 xbeam-v1) 写入可见性。读者可以通过检查输出是否与预期的 SWIN 可见性记录匹配并验证完成头来验证是否成功运行。
请先查看录像。inspect-vdif 仅读取报文头:
cuphoton xbeam inspect-vdif RECORDING.vdif --json
VDIF 文件可能包含交错线程、缺失帧或按时间顺序存储的帧。在相关性之前构建 .vdix sidecar,以便 xBeam 可以找到请求的时间范围,而无需重写录制内容。在源文件保持不变的情况下重复使用它们。之后每次读取都会直接跳转到正确的帧。默认情况下,构建器使用 cuFile;如果机器没有 GPUDirect Storage,则传递 --backend posix:
cuphoton xbeam build-vdif-sidecar RECORDING-*.vdif \
  --index-dir SIDECARS \
  --backend cufile \
  --devices 0,1,2,3
在 GPU 上运行相关性。- backend cupy 选择 GPU 路径。默认情况下,xBeam 通过固定主机内存 (POSIX) 读取数据。- vdif-io cufile 通过 GPUDirect Storage 选择 cuFile I/ O 路径。这是 Vera Rubin 运行时使用的模式,不需要其他标志。
cuphoton xbeam correlate JOB.json \
  --output RUN \
  --backend cupy \
  --vdif-io cufile \
  --scan SCAN_ID \
  --first-integration 0 \
  --integration-count N \
  --index-dir SIDECARS
同样的作业也可以从 Python 运行。 load_job 返回与命令行使用相同的作业对象。 correlate 每次返回一个可见性记录;编写 SWIN 文件的工作由命令行工具完成。
from cuphoton.xbeam import CorrelationWindow, correlate, load_job

job = load_job("JOB.json")
window = CorrelationWindow("SCAN_ID", first_integration=0, integration_count=8)
for record in correlate(
	job,
	backend="cupy",
	window=window,
	index_dir="SIDECARS",
	vdif_io="cufile",
):
	spectrum = record.spectrum  # complex visibilities for one baseline product
记录中的空隙会影响相关因子向后续样本分配时间和权重的方式。xBeam 通过 --profile interop-real-usb-buffered-window-replay-v1 提供显式缓冲读取器策略。
在保留的读取器缓冲区内,此策略继续使用缓冲区的现有时间参考消耗记录的样本,直到下一次分配建立新的锚点。它还能确定哪些 FFT 块发挥作用及其报告的可见性权重。
它不会恢复丢失的样本,完整报告的权重并不意味着记录了每个时间。在不进行回放的情况下,xBeam 会根据帧头时间对后续帧进行对齐,并标记缺失的槽无效,这可能会产生不同的可见度和权重。
跨 GPU 和节点扩展
cuPhoton.xBeam 通过在 GPU 上及时分割扫描结果来进行扩展。每个 GPU 都关联自己的时间。在一个节点上,xBeam 可以同时启动多个 GPU。在许多节点上,每个 GPU 运行一个片段 (称为分片) , merge-shards 连接 SWIN 输出。
在一个节点上, --devices 会启动每个 GPU 的一个相关子进程,给出每个 GPU 各自的集成比例,在 RUN/shards/ 下写入结果,然后进行合并:
cuphoton xbeam correlate JOB.json \
  --output RUN \
  --backend cupy \
  --vdif-io cufile \
  --scan SCAN_ID \
  --first-integration 0 \
  --integration-count N \
  --devices 0,1,2,3 \
  --index-dir SIDECARS
跨节点,每个进程运行一次分片。将 --shard-count 和 --shard-index 设置在一起,为每个分片使用相同的扫描 ID、首次集成和集成数量。对于 64 个 GPU,使用索引 0 至 63 的 --shard-count 64 。在以下命令中,设置 SHARDS=64 并将 SHARD 设置为每个进程的唯一索引:
cuphoton xbeam correlate JOB.json \
  --output RUN/shard-$SHARD \
  --backend cupy \
  --vdif-io cufile \
  --scan SCAN_ID \
  --first-integration 0 \
  --integration-count N \
  --shard-count $SHARDS \
  --shard-index $SHARD \
  --index-dir SIDECARS
当每个分片完成后,将它们合并到一组可见性中。在复制任何内容之前,合并会检查所有分片是否来自同一作业、它们共同覆盖了整个时间范围,以及它们的 SWIN 报文头是否一致:
cuphoton xbeam merge-shards JOB.json RUN/shard-* \
  --output RUN/complete
--devices 是一个节点的快捷方式。带有 merge-shards 的 --shard-count 和 --shard-index 是跨节点的路径。两者都在 GPU 上运行延迟和相位校正、FFT 和交叉乘法。
图 4 显示了在多节点 GPU 上扩展 xBeam 的结果。在 Vera Rubin NVL72 上,一个 10 TB 的记录被分割到多个节点上的 1 到 64 个 GPU 上,并将分片合并到一组可见性中。报告的加速在测试范围内继续增加。其衡量标准是总处理时间:读取、准备数据,然后端到端关联数据。在 64 个 GPU 上,总速度为 70 秒,而 x86 CPU 基准的速度约为 32000 秒,因此速度大约提高了 460 倍。
借助 GPUDirect Storage,相同的 10 TB 记录的读取带宽会随着 GPU 数量的增加而增加,从 4 个 GPU 上的 20 GB/s 增加到 64 个 GPU 上的 170 GB/s。读取带宽随着 GPU 数量超过测试范围而增加。
AI 智能体和工具包的其余部分
AI 智能体作为自动化助手,编排数据提取、作业配置、并行执行和可见性提取,为自主科学提供了强大的框架。在此工作流中,智能体可以自主解析传入的 VDIF 元数据,生成标准化的 JSON 作业规格 (架构版本 1) ,在 GPU 集群中调用 cuphoton xbeam correlate ,并监控执行。虽然当前的基准测试侧重于 GPU 加速,而不是完全的代理控制,但将 AI 智能体与 xBeam 集成可提供极具吸引力的潜在应用,实现复杂的多望远镜数据流水线的端到端自动化。
cuPhoton 工具包的其余部分在不同领域数据中应用相同的 GPU 优先模式。对于光学成像, xDataReader 会加载图像数据集,而 xScan、xPois 和 xFit 会对其进行分析。 xRay 直接在 GPU 显存中处理用于 X 射线激光实验的检测器帧。研究材料、量子光学和聚变的研究人员可以在多节点、多 GPU 系统上应用类似的 cuPhoton 处理流程进行数据分析和模拟。
开始使用
公共 cuPhoton 资源库提供成像模块和 xBeam。有关可用工具和示例,请参阅公共资源库和相关帖子。

