

逐位确定性使大规模预训练更易于调试、验证和以可重现的方式恢复。在跨数千个 GPU 训练具有数万亿个参数的模型时,这些优势变得尤为重要,因为多个并行维度、低精度计算和分布式检查点会使故障再现和修复验证变得更加复杂。
制作和英雄训练成本高昂,并且需要强有力的成功保证。逐位确定性可实现可靠的故障回放、损失峰值调试、系统更改验证以及从中断的训练运行中恢复。就万亿参数规模而言,即使是微小的性能下降也会耗费数千 GPU 天,因此确定性训练必须保持高效。一项包含万亿参数的 Nemotron 案例研究展示了 NVIDIA 如何在 NVIDIA Megatron Core 中减少逐位确定性预训练的用度。
什么是逐位确定性?
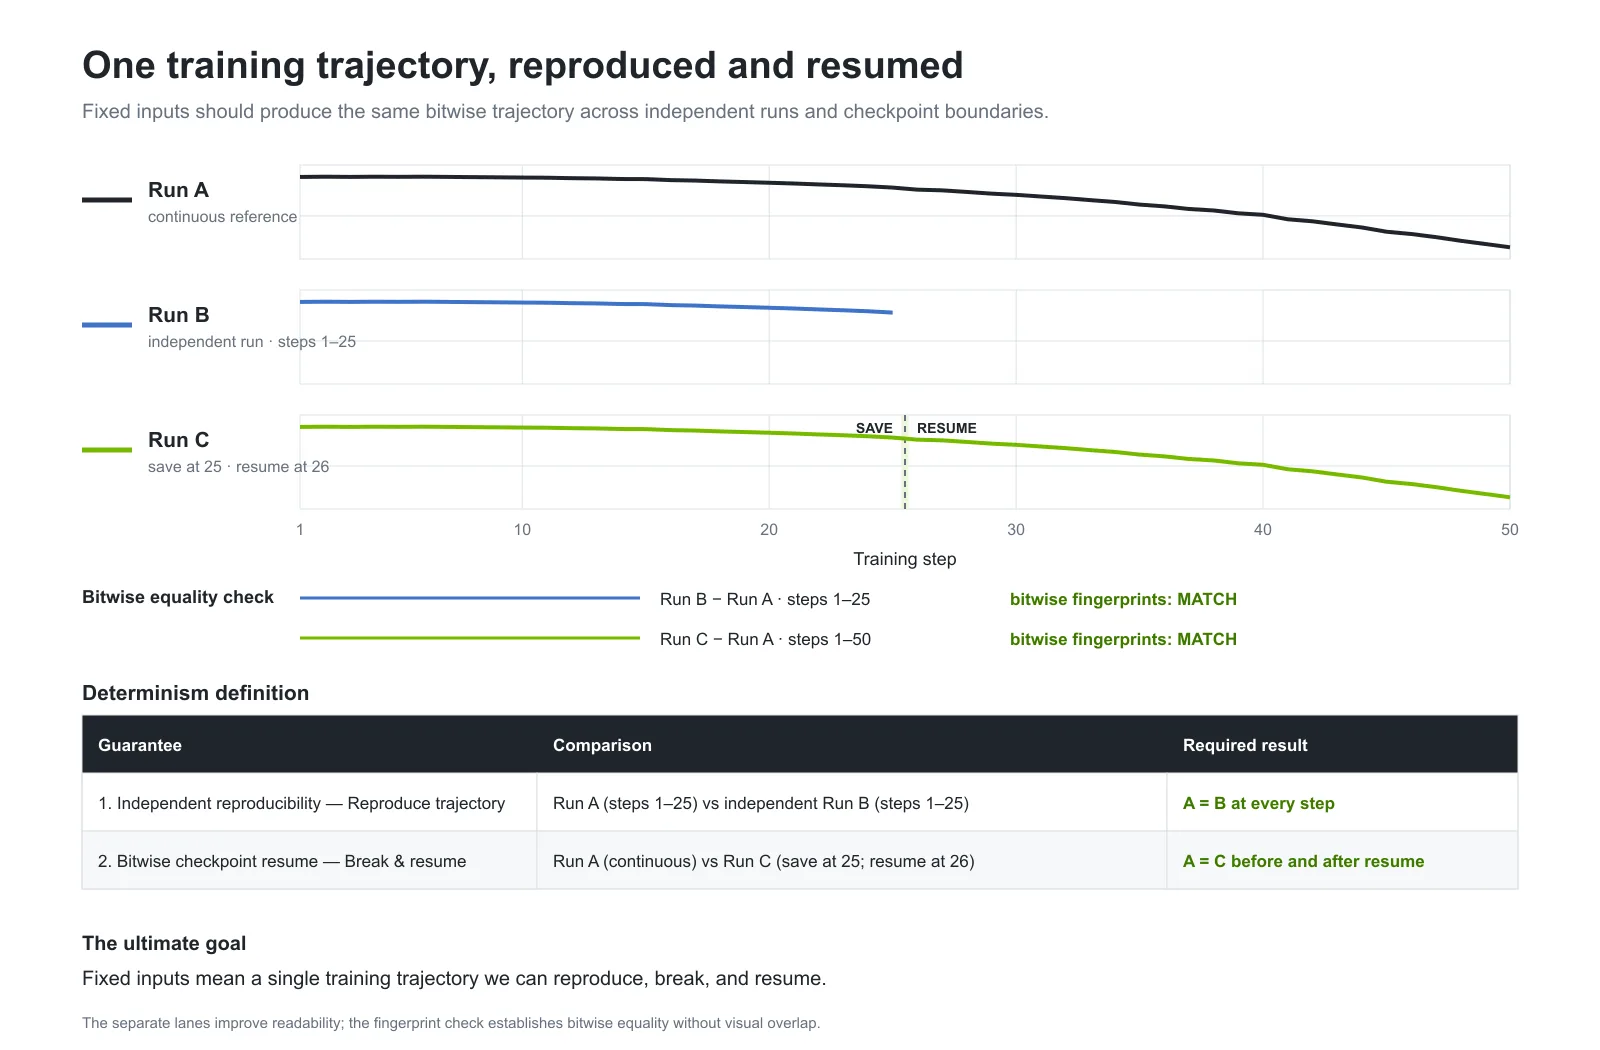
当数据顺序、架构、配方、并行性、软件、运行时设置和硬件固定不变时,逐位确定性需要独立运行和检查点恢复运行,以遵循相同的数值轨迹。Megatron Core 有两项保证。
独立再现性:在相同初始状态下启动的两次运行必须在每个训练步骤中保持逐位相同。
逐位检查点恢复:保存和恢复一个或多个检查点的运行必须保持与不间断运行相同。
为什么预训练应该是确定性的?
位向确定性为大规模预训练提供了四个优势。
- 回放失败:在同一步骤中重现损失峰值,然后一次更改一个组件以找出原因。
- 保持检查点的连续性:在不改变数值轨迹的情况下继续中断的训练。
- 检测意外差异:使用原本相同的运行之间的不匹配来调查检查点损坏或软件和硬件问题。
- 比较更改:将预期更改的数值效果与运行到运行的变化区分开来。
如何验证确定性
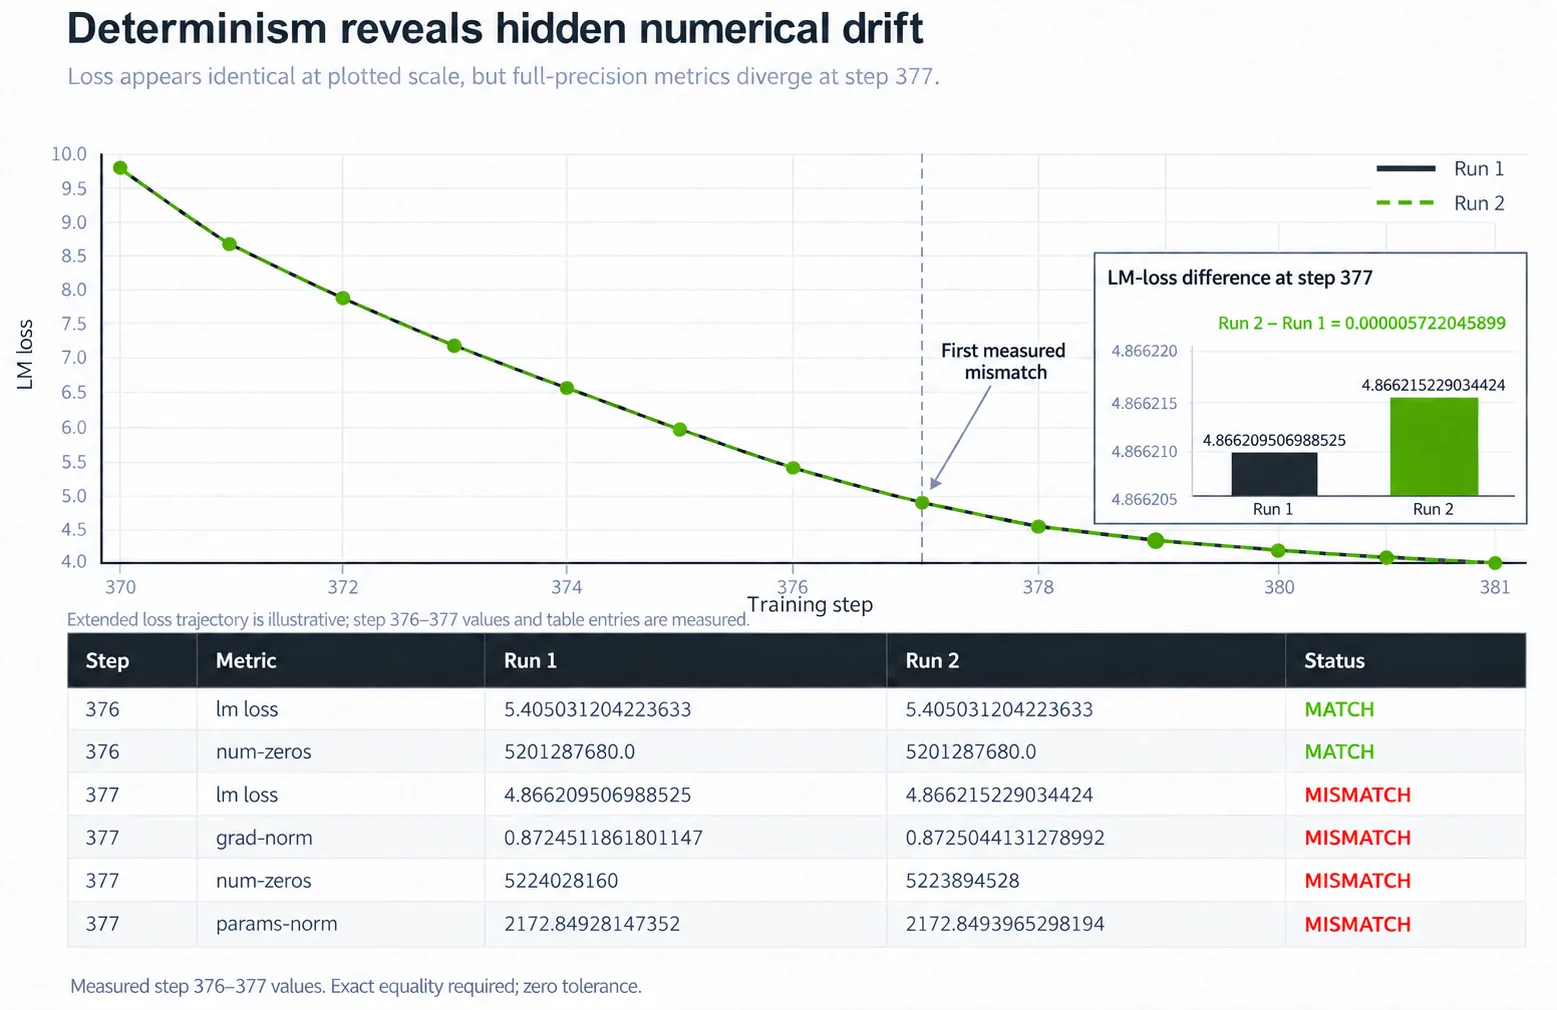
打印的损失值不够敏感,无法建立逐位相同的数字。两次运行可以打印相同的四舍五入损失,但梯度或参数的低阶位存在差异。
更强大的验证程序会在每个步骤中指纹识别选定的数值指标。其中可能包括训练损失、语言建模损失、负载平衡损失、多标记预测 (MTP) 损失和梯度范数。运行两次相同的配置,并逐步比较这些指纹。第一个不匹配步骤有助于缩小调查范围。
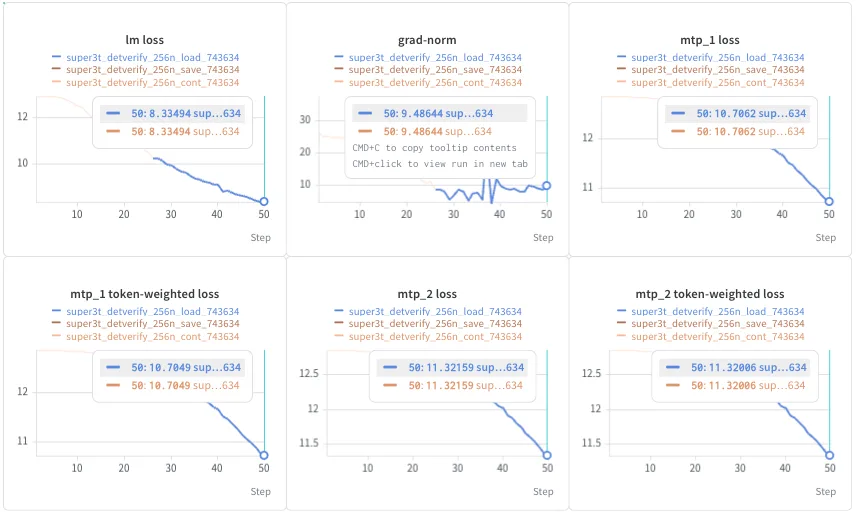
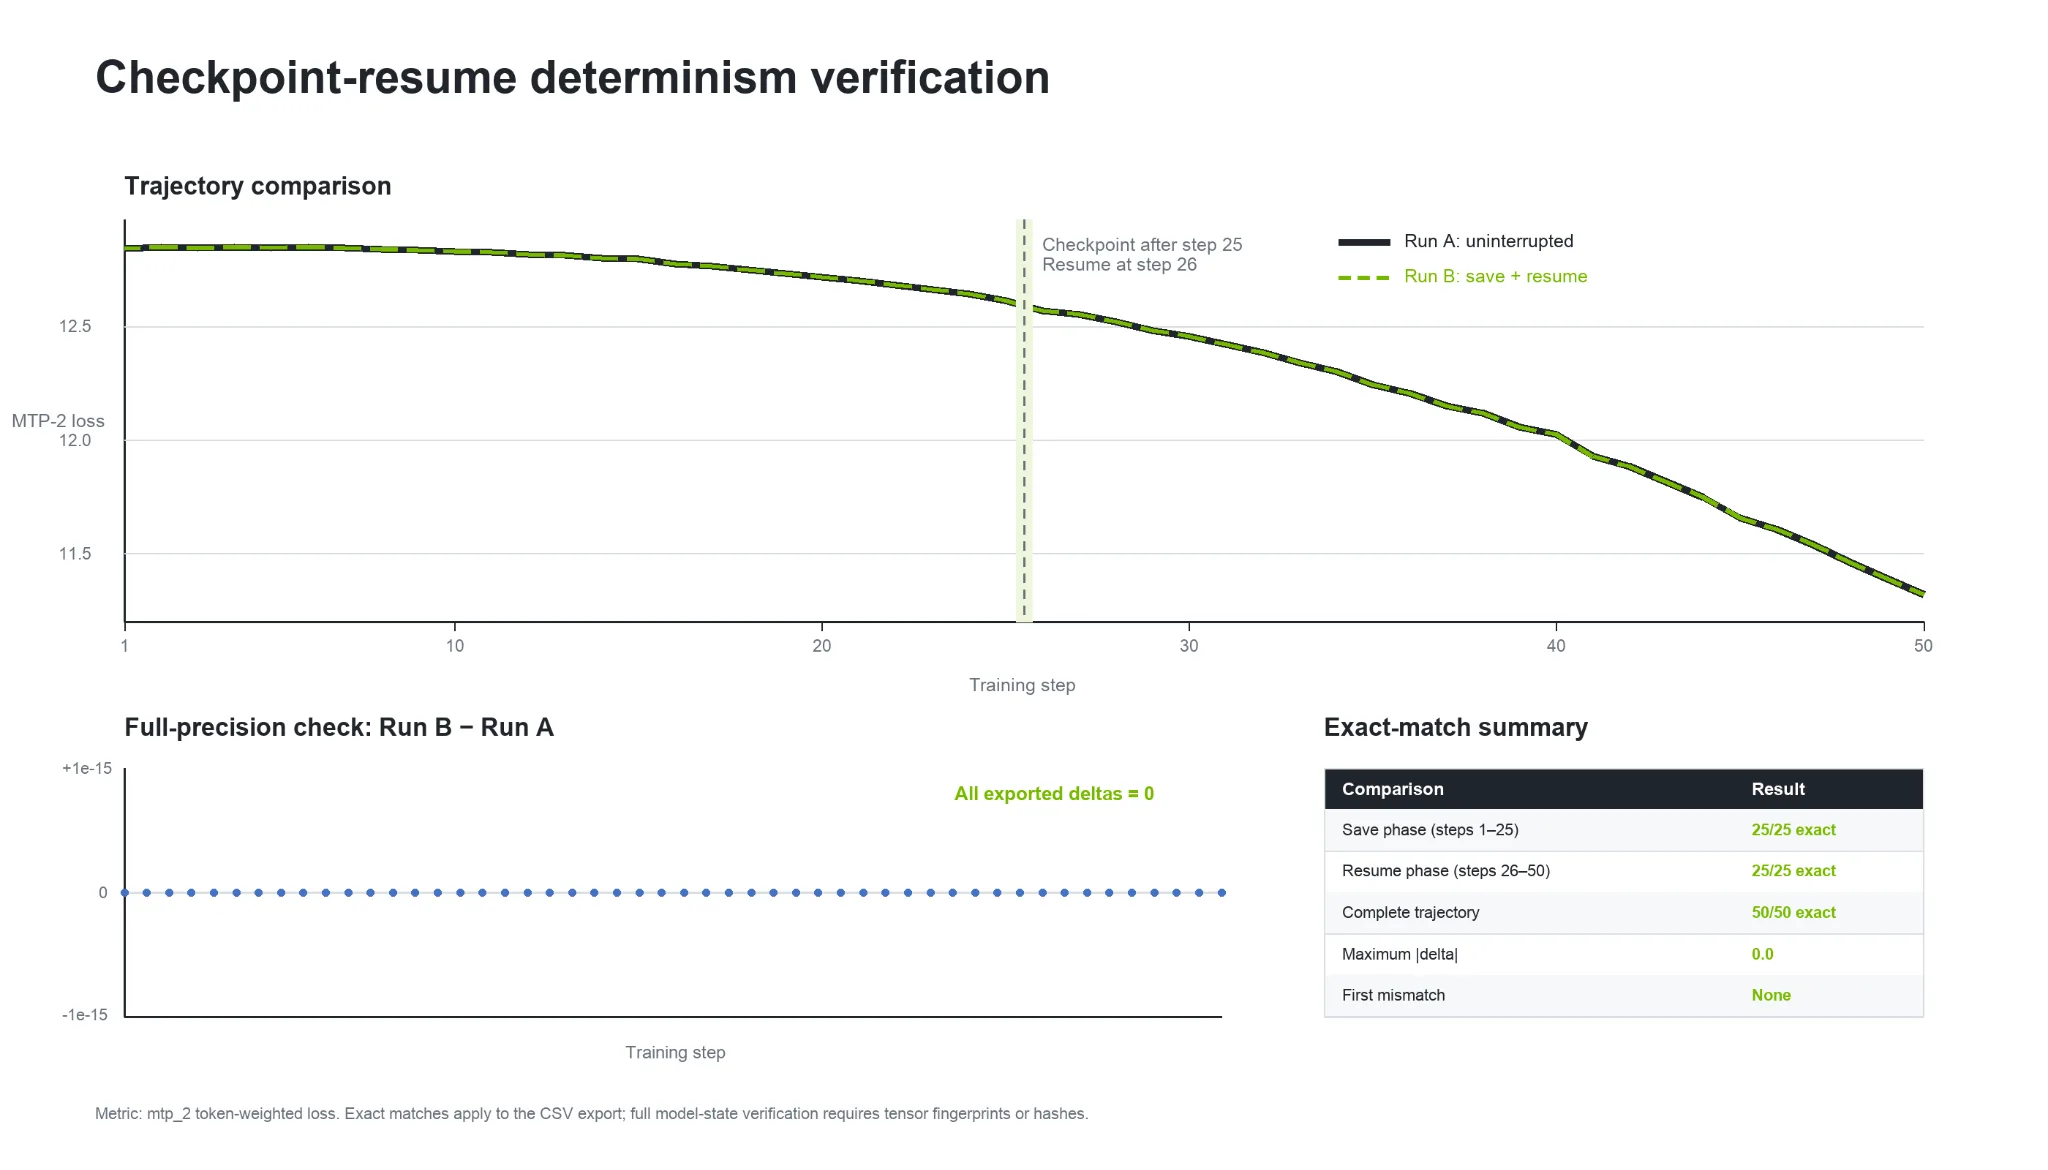
要验证逐位检查点恢复,请将不间断的参考运行与检查点恢复运行进行比较。每次恢复后,验证参数、优化器状态、RNG 状态、数据位置和后续输出在逐位上是否与引用相同。
万亿参数 Nemotron 模型检查点路径可保留全精度的事实来源,并通过训练期间使用的相同转换路径重建运行时表示。
当确定性被打破时,如何解决这个问题
在规模上,非确定性可能是间歇性的或与拓扑相关的,并且可见损失差异可能发生在第一个不同位之后很久。Megatron-LM PR# 7262 中提出的工作流记录了按秩排序的张量指纹,以便进行离线比较。首先,确认相同的种子、数据顺序、批量大小、并行性、容器和软件堆栈。
通过精细追踪定位差异
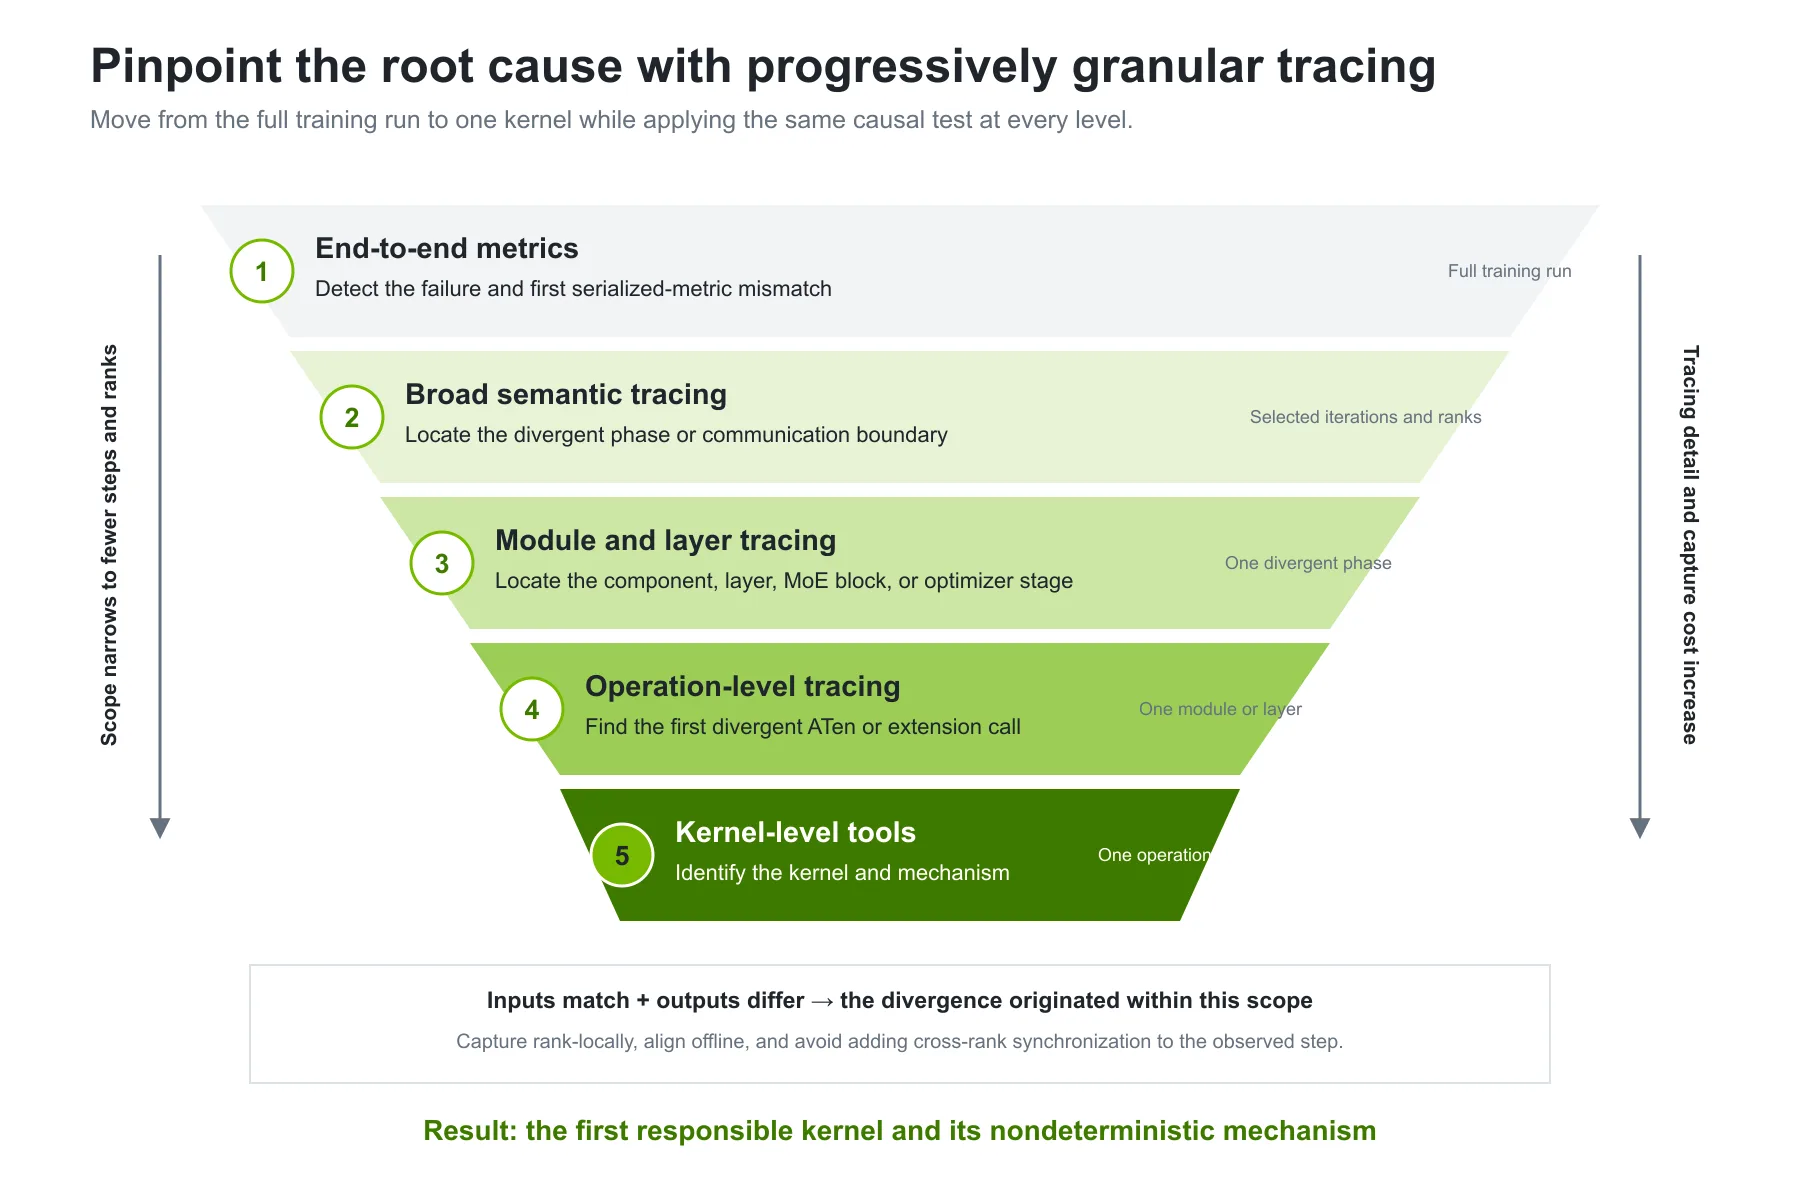
从端到端比较开始,然后将捕获范围从训练迭代缩小到阶段、模块、操作和内核。如果两次运行进入输入位相同的范围,但输出不同,则差异源于该范围。
- 端到端指标检测故障,并识别序列化指标不同的第一次迭代。
- 广义语义追踪涵盖集合、工作流通信、重新计算、优化器运算和梯度归约,以识别离散训练阶段。
- 模块和层追踪可将差异缩小到特定的模型组件、转换器层、混合专家 (MoE) 块或优化器阶段。
- 操作级追踪指纹 ATEN 操作和有针对性的扩展程序调用,以识别具有匹配输入和不同输出的第一个操作。
- 内核级工具可识别负责任的内核、算法配置和非确定性机制。
不要只追踪损失明显分离的迭代;第一个不同的位可能出现得更早。使用广义追踪来定位最早的离散迭代和 rank,然后仅在缩小的范围内启用详细运算和核函数追踪。
离线比较痕迹
每个选定的秩会将其追踪写入文件,而无需添加集合或交叉秩排序。这降低了被调查竞赛遮挡的风险。通过与运行无关的标识 (例如操作名称、发生次数和模块范围) 来对齐事件。
寻找匹配的输入指纹和不同的输出指纹。
hash(input_run_A) == hash(input_run_B)
hash(output_run_A) != hash(output_run_B)
“首次不匹配”是指每个秩;序列号无法跨秩建立顺序。按因果关系对每个秩的第一个不匹配项进行分类。
| 秩上的首次不匹配 | 说明 | 下一个动作 |
|---|---|---|
| 输入匹配;输出不同 | 候选来源 | 调查此操作或其隐藏的生产者 |
| 输入和输出不同 | 下游接收机 | 继续追踪上游 |
| 追踪秩上无起源 | Origin 位于 Capture 之外 | 拓宽迭代窗口或秩集 |
如果多个秩识别相同的原始运算,则该运算本身可能是非确定性的。如果只有子集执行此操作,则研究拓扑、秩放置、输入分布和归约排序。
GPU 上的指纹张量
提议的工作流程使用 torch.hash_tensor 处理 GPU 驻留指纹。记录每个张量的形状、类型和元素数量及其摘要。对于 MXFP8 或 NVFP4 张量,为编码值及其比例缓冲区提供指纹。
全张量异或指纹无法检测排列组合。对于路由贴图和 MoE 调度输出等顺序敏感型数据,使用 dim 参数按行或数据块为这些张量提供指纹识别。指纹是一种有效的检查,但匹配并不能保证张量在位元上完全相同。使用字节级比较来确认位元相等。
排除误报
在确定原因之前,请检查追踪盲点和无效读数。
- 调度员盲点。
TorchDispatchMode观察通过 PyTorch Dispatcher 路由的ATen操作。自定义内核可以逃离此追踪范围。如果第一个不匹配出现在简单的视图、切片或加法中,请探测生成其输入的自定义内核。 - 探针伪影。未初始化的张量、不完整的异步群集和非阻塞副本可能会在其内容有效之前被读取。在宣布生产商不确定之前排除这些情况。
验证修复
使用配对运行检查验证补丁。
- 原始对应再现差异。
- 补丁后的数据对应保持逐位相同。
- 确定修复程序是否纠正了非确定性实现,或围绕其路由执行。
- 测量新的性能成本。
请注意,逐位确定性在相同的硬件和软件环境中得到验证。跨 GPU 代、网络配置或库版本的比较超出了此验证范围,可能会产生不同的结果。
优化万亿参数 Nemotron 模型的确定性训练
具有大量开销的确定性配方可能支持调试,但对于生产训练而言,成本过高。应该从一开始就共同优化确定性和非确定性执行。这项工作使用万亿参数的 Nemotron 模型,该模型结合了 Mamba 式状态空间模型 (SSM) 层和 Transformer 注意力层。确定性训练必须涵盖 SSM 和注意力内核、低精度计算、分布式通信以及层类型之间的转换。
建立受控基准
使用相同的模型、硬件、批量大小、并行策略、精度格式、软件环境和测量窗口,将确定性执行与支持的最快非确定性配方进行比较。
衡量标准:
- 吞吐量和步骤时间
- 显存和 GPU 利用率峰值
- 通信时间
- 在主要内核组中花费的时间
计算确定性税:
仅在训练性能稳定后收集数据。
优化之旅
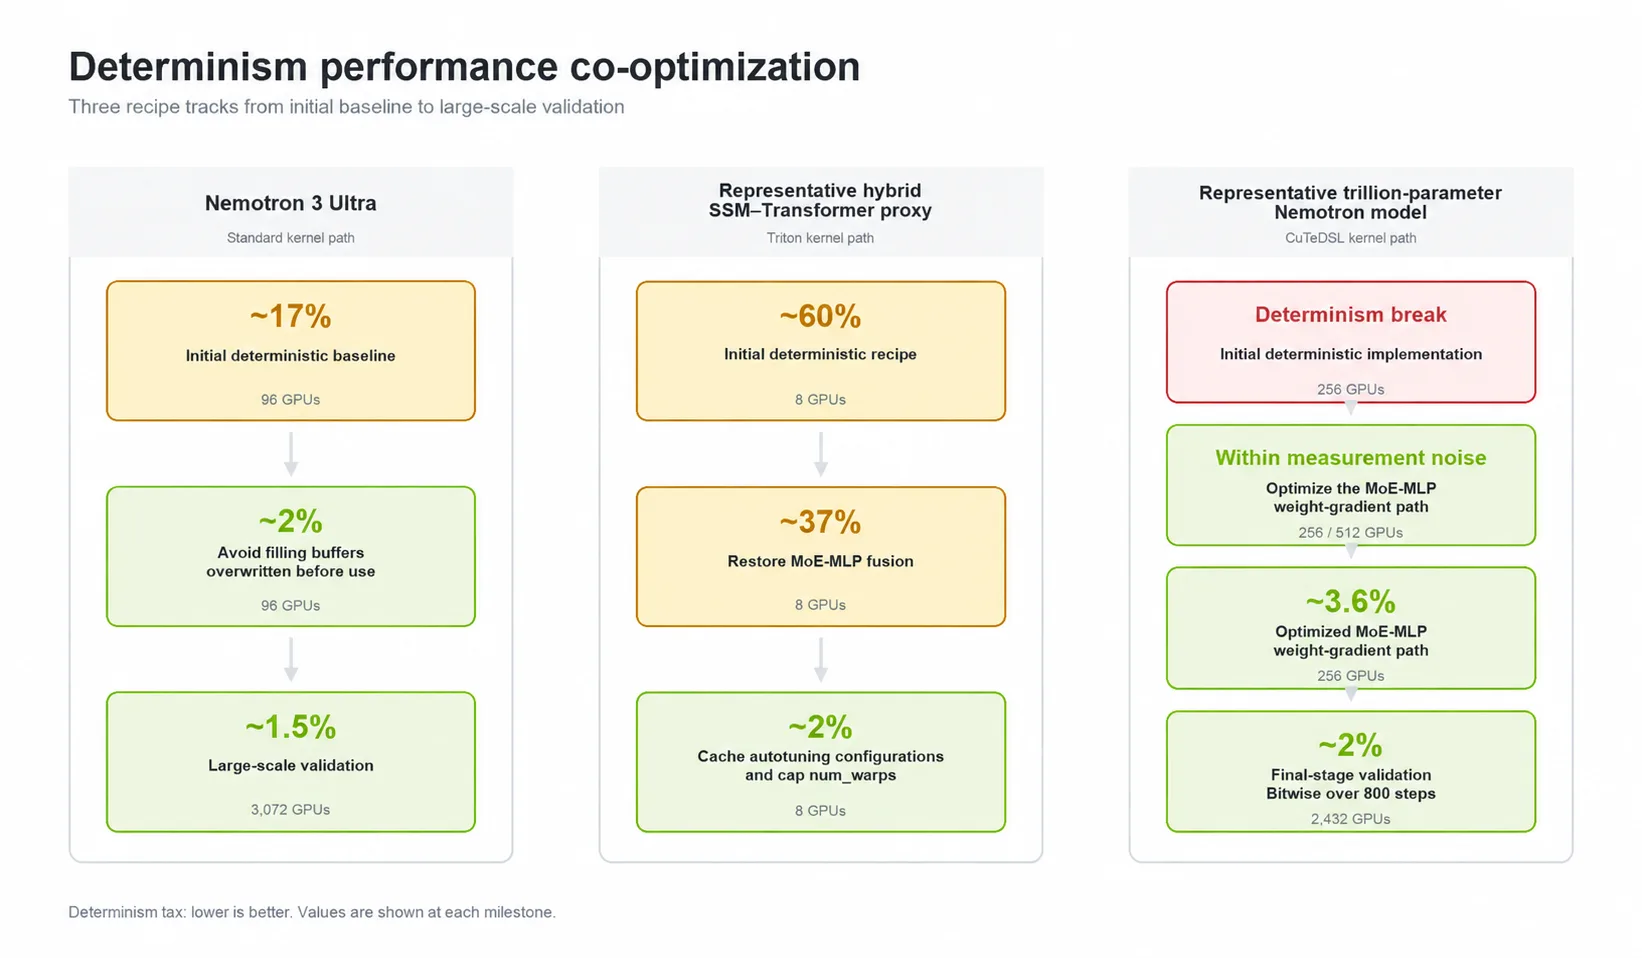
跨三个工作负载进行优化,可减少从两位数基准到低个位数的阶段性确定性开销。在缓冲区填充优化后,Nemotron 3 Ultra 从大约 17% 提升至 2%,然后在 3072 个 GPU 上提升至 1.5%。在恢复 MoE-MLP 融合后,混合 Triton 代理从大约 60% 提高到 37%,然后提高到 2%。CuTeDSL 优化的权重梯度路径在 256 个 GPU 上测得的开销约为 3.6%。在 2432 个 GPU 上,大规模 Nemotron recipe 测量了大约 2% 的稳态确定性开销,按位确定性超过 800 步。
内核级优化示例
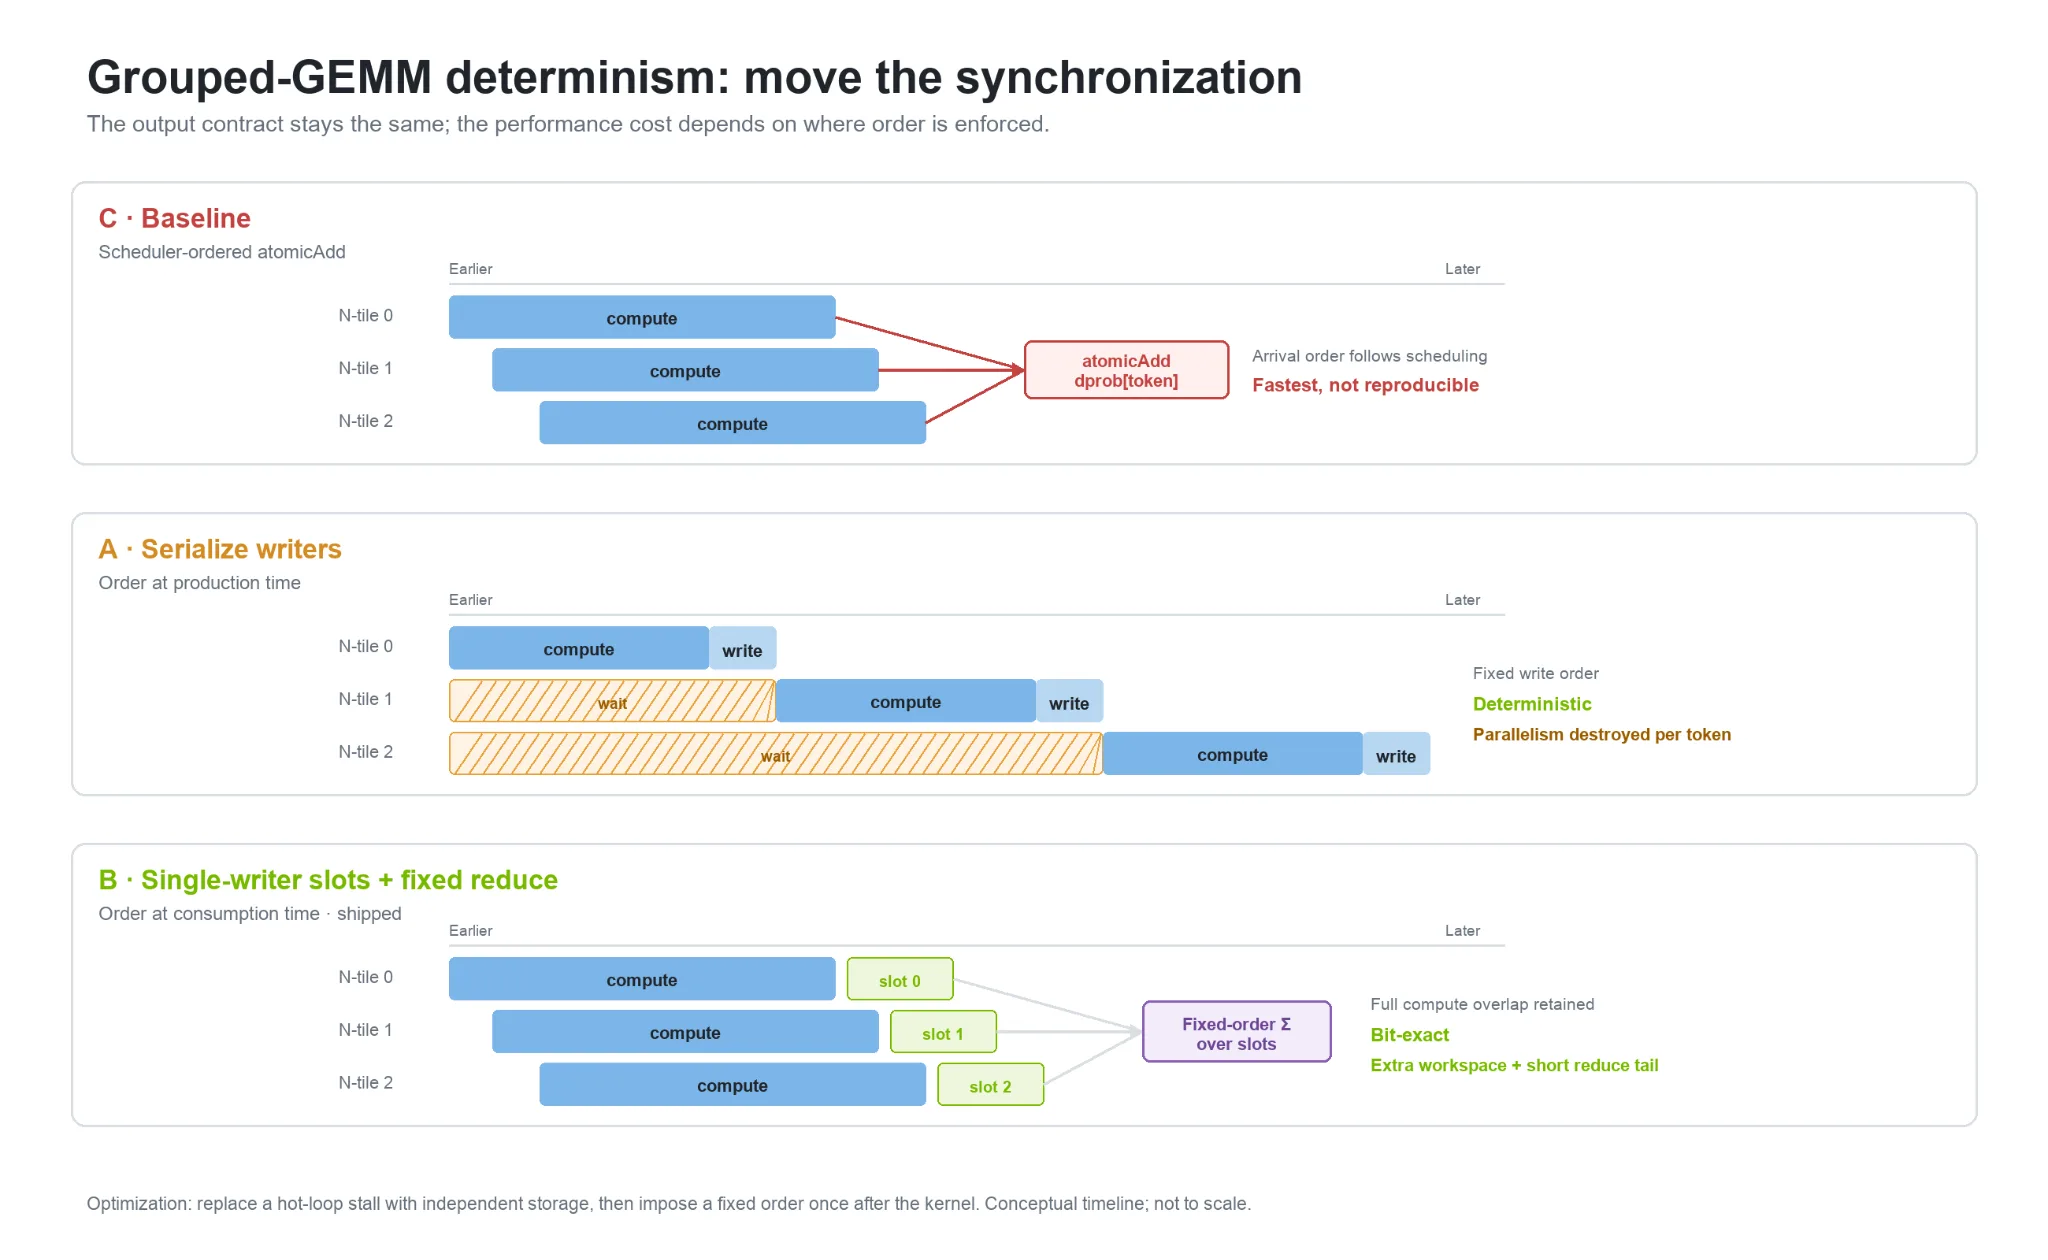
在分组的 GEMM 结语中,多个 N 图块最初累积到同一个 dprob[token]地址,因此结果取决于其到达顺序。将这些作者序列化恢复了确定性,但减少了并行性。
为每个 N 图块分配专用输出插槽,在内核中保留并行执行,并在所有写入器完成后按固定顺序组合插槽。
大规模验证优化
对几个 GPU 征较低的确定性税并不能保证在生产规模上取得相同的结果。通信、同步、工作流泡沫、专家路由和负载均衡可能会改变相对开销。如果假设在 10000 个 GPU 上以 100 天的非确定性基准运行,将用度从 15% 降低到 5%,则可节省 10 天,即 100000 个 GPU 天。
随着模型、内核和方法的发展,保持确定性
新的内核、融合、精度格式或并行配置可能会引入非确定性。Megatron-LM 通过这些检查防止回归。
- 配方验证:
--deterministic-mode应用规范环境设置,启用 PyTorch 确定性算法,并拒绝无确定性路径的特征。 - 内核测试:内核测试以相同的输入和 RNG 状态重复操作,然后比较输出和梯度字节。
- 模块验证:模块级测试跨并行配置 (包括 FP8 和 FP4) 重复具有恢复 RNG 状态的模型和 Transformer 块。然后,独立的端到端运行会验证全精度训练指标是否保持逐位相同。
有关当前覆盖范围和已知差距,请参阅确定性状态、操作目录和内核测试指南。
非确定性的常见来源
使用表 2 确定不确定性的可能原因,并选择下一个诊断步骤。
| 观察到的症状 | 可能的原因 | 诊断方法 | 分辨率 |
|---|---|---|---|
| 运行结果与第一步不同,但不一致 | 运行时自动调整可选择不同的内核配置 | 比较所选配置并追踪受影响的最早输出 | 固定或缓存经过验证的配置 |
| 仅当启用融合辅助损失函数时,MoE 才会运行离散 | 归约顺序不是固定的 | 禁用单个融合并追踪损失计算 | 使用确定性归约或禁用融合 |
| 继续运行逐渐与连续运行分离 | 不完整的 RNG 状态恢复 | 立即比较恢复前后的 RNG 状态 | 逐位保存并恢复每个 RNG 流 |
| 软件或容器更新后,出现差异 | 底层库内核发生了变化 | 对堆栈进行对等分割并构建最小的内核再现器 | 选择待纠正的确定性内核路径 |
| 加载检查点后,参数会立即发生变化 | 低精度权重或尺度以不同方式重建 | 比较保存/ 加载时的值和缩放元数据 | 保留全精度的事实来源和精确的重建路径 |
| 配方在小规模上通过,但在大规模上失败 | 依赖规模的通信或专家并行路径 | 系统地扩大规模并追踪选定的等级 | 隔离并纠正第一个与规模相关的运算 |
开始使用
逐位确定性使大规模预训练更易于调试和恢复。Nemotron 案例研究展示了内核和配方优化如何降低其性能成本。在您计划使用的硬件和软件环境中验证再现性和开销。
要开始使用,请查看 Megatron Core 用户指南,了解受支持的 recipe,然后比较独立运行和检查点恢复运行,以验证再现性。


