

当团队使用 NVIDIA Dynamo、Slurm 部署和扩展 AI 工作负载时,要跟踪实际运行的内容,需要在谱中捕获的平台配置之外进行查看。应用程序团队独立于平台 recipe 来定义和更新这些工作负载,因此仅凭可复制的部署包无法确定每个节点上正在运行哪些工作负载构件。 :latest 等可变图像标签会增加一层复杂性。两个节点可能会在相同的标签下运行不同的代码,而下周拉取的节点可能会检索先前安全审查未涵盖的图像。
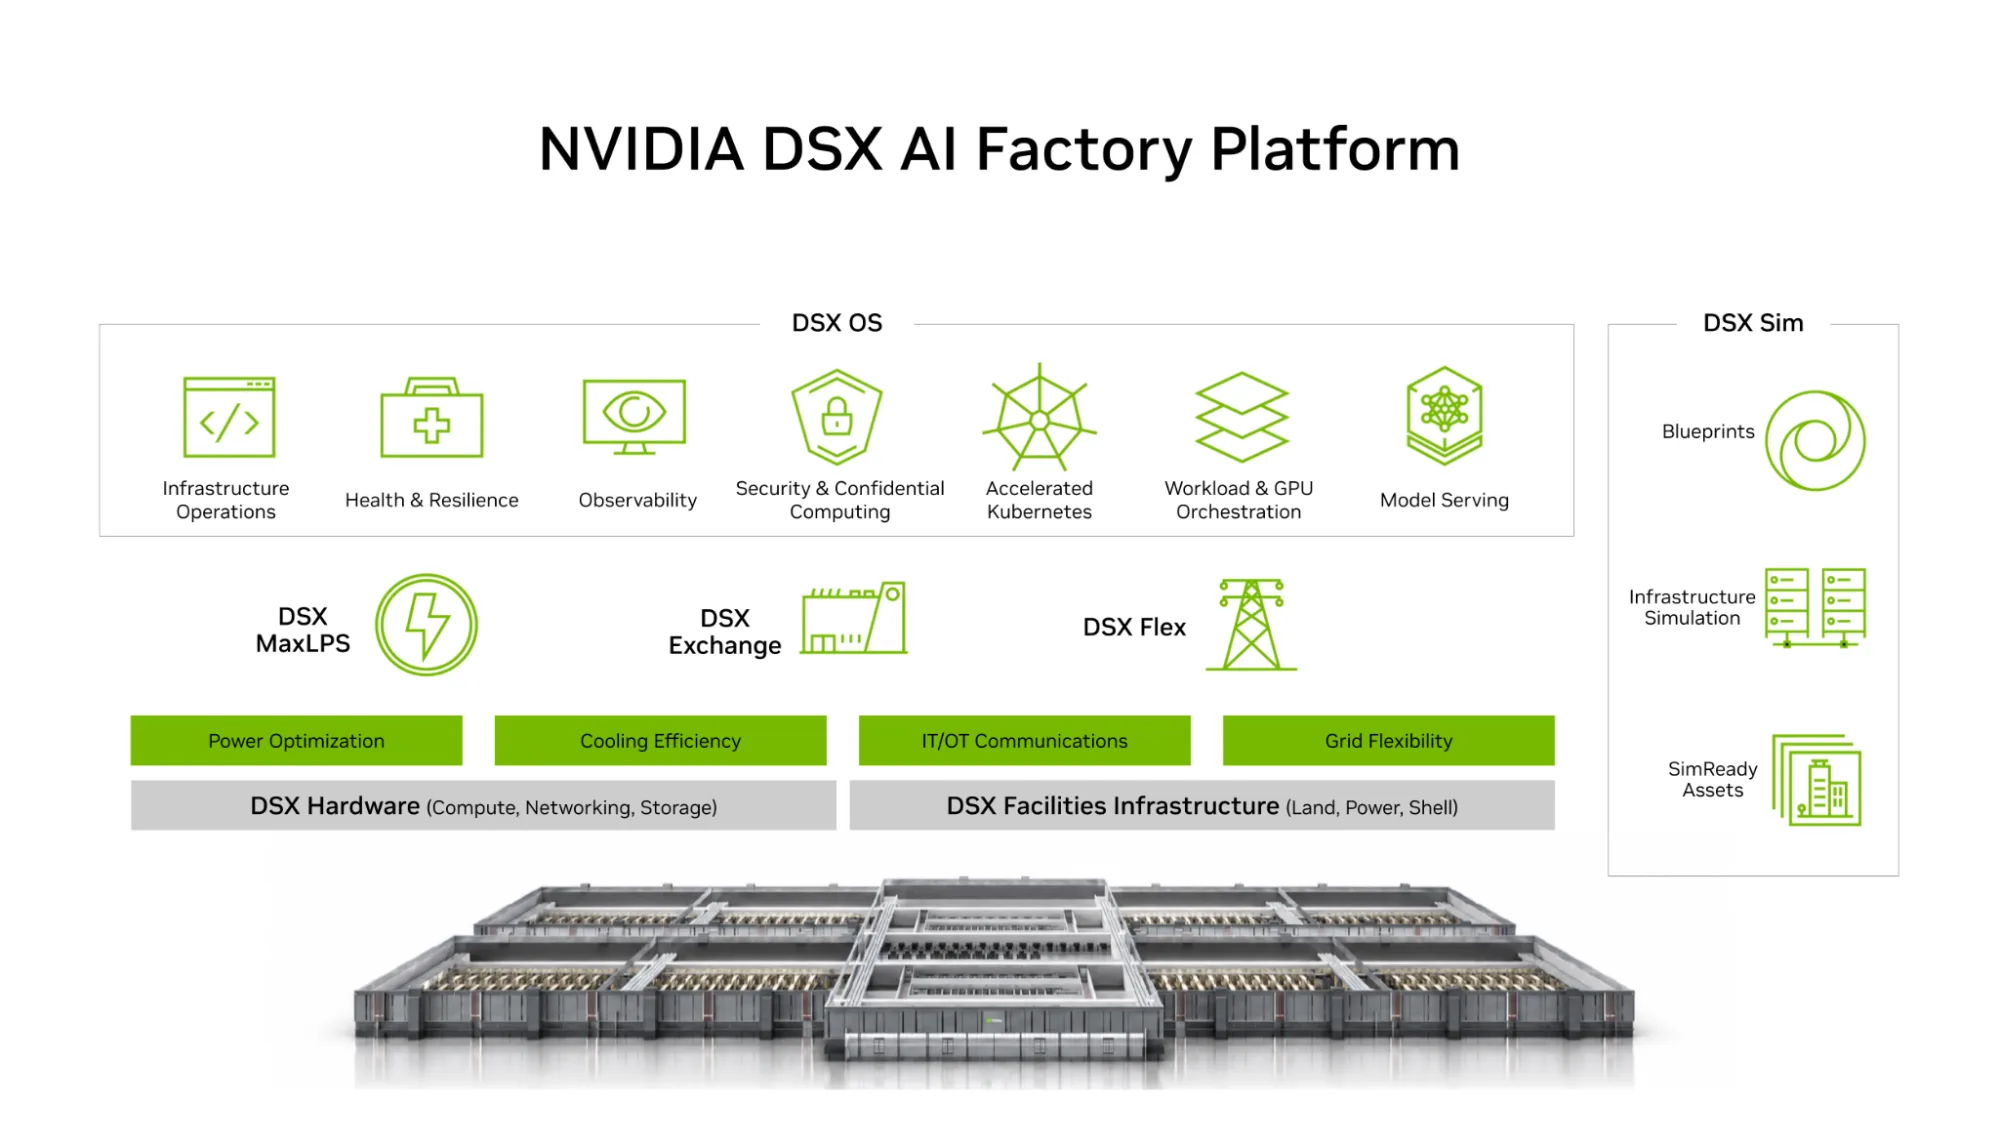
NVIDIA AI 集群运行时 (AICR) 是 NVIDIA DSX AI 工厂平台 的开源模块化组件,现在包含合格的 AI 物料清单 (AIBOM) 组件,以弥补这一差距。k8s-aibom 是 Google 创建的一个开源项目,用于跟踪在 Kubernetes 上运行的 AI 工作负载。默认情况下,两个标准方法选择 k8s-aibom:h100-gke-cos-inference 和 h100-gke-cos-inference-dynamo 。在启用 --runtime-inventory 的情况下,其他 GKE recipe 可以选择在生成期间加入。选中该选项的菜谱可以在禁用 --runtime-inventory 的情况下选择退出。
AICR 可将已知的出色 GPU 平台配置转化为锁定版本的方案和可复制的部署包。每个 recipe 都记录了一个硬件、云、操作系统和意图组合所需的配置:其组件、版本引脚、值、约束条件、部署顺序和验证期望。AICR 可根据固定的 recipe、catalog 和 bundle 输入生成可复制的部署构件。捆绑包包括 checksum;通过 aicr bundle --attest 签名是可选的。
获得 k8s-aibom 的资格只是一项具体的声明,而不是橡皮图章。AICR 将确切的上游源、图表、CRD 和摘要固定控制器镜像绑定为一个测试集,根据 Google 预期的构建标识验证出处,审查渲染的 RBAC 和安全默认设置,并在其测试的部署路径上练习安装、升级、运行状况和卸载。
您可以在此博客中使用 AICR 配置 Kubernetes 运行时,以便为集群提供经过验证的高性能配置。
同一个问题的两端
AICR 和 k8s-aibom 着眼于 AI 基础设施生命周期的不同部分。AICR 可帮助平台团队为 GPU 加速的 Kubernetes 生成和验证已知的良好配置。它适用于运行时部署层:驱动、运算符、内核、Kubernetes 组件、部署配置。
k8s-aibom 位于堆栈上方,之后则位于集群的生命周期中。它会监视 Kubernetes 工作负载和 pod API,并为每个已识别的 AI 工作负载发出 CycloneDX 1.6 AIBOM。覆盖范围是有限的:只有携带可识别 AI 信号的受支持的工作负载类型才会被记录在清单中。覆盖范围包括原生 Dynamo 图形、NIMService、LeaderWorkerSet、DisaggregatedSet 和 CronJob 资源。追踪的子工作负载被整合到其所有者的 AIBOM 中。
| AICR 答案 | k8s-aibom 答案 |
|---|---|
| GPU 基础架构是否基于已知且经过验证的配置构建? | 该基础架构上实际运行了哪些 AI 资产? |
一种是为 GPU 加速的 Kubernetes 提供配置的控制和再现性,另一种是在该集群中增加工作负载发现和可追溯性。具体来说,AIBOM 可以帮助您:
- 在所选报告命名空间中查找未注册或影子 AI 工作负载
- 识别模型、推理运行时、智能体和 RAG 组件
- 跟踪外部 AI API 和向量数据库
- 检测 AI 依赖项的变化或漂移
- 支持安全审查、事件响应和合规性审计
这两个项目都是从同一问题的相反方面得出的结果,并由此认识到了这一点。AICR 记录符合要求的部署意图,并在某个时间点根据集群对其进行评估。这两个项目从同一问题的不同侧面切入,最终都得出了这一结论,并且也都意识到了这一点。k8s-aibom 会观察受支持的 AI 工作负载,并记录找到的内容,包括确定每个属性的置信度。这两种观点都不足以单独进行 AI 治理,而两者之间的界限正是当今缺少问责的地方。
将 AICR 与 k8s-aibom 结合使用
这些示例反映了 AICR v1.2.0 及其目录,其中引脚为 k8s-aibom 1.6.2 。使用与此目录相匹配的 CLI 构建来重现示例。
从运行 Kubernetes 1.32 或更高版本的 Google Kubernetes Engine (GKE) 集群开始,使用容器优化操作系统的 NVIDIA H100 GPU 节点以及 GKE 管理的驱动程序和设备插件。以下工作流程会生成一个 recipe,将其渲染为捆绑包,然后进行部署并验证结果。没有任何东西是手动组装的,也没有任何东西是手动调整的。
对于相同的 AICR 版本、目录和生成输入,配方分辨率会产生相同的配置。最后一步针对集群进行检查。这是 AICR 为这一组合带来的一半:快速且可重复地验证 GPU 平台。然后,k8s-aibom 会记录受支持的 AI 工作负载。
生成谱
aicr recipe \
  --service gke \
  --accelerator h100 \
  --os cos \
  --intent inference \
  --output recipe.yaml
新的 k8s-aibom 组件被选中作为 recipe 的一部分,之后不会使用螺栓固定。您可以查询任何已解析的值,而无需生成文件:
aicr query \
  --service gke --accelerator h100 --os cos --intent inference \
  --selector components.k8s-aibom.version
# 1.6.2
捆绑和部署
使用默认的 Helm 部署器创建部署包。将示例节点选择器替换为系统和 GPU 节点池上的标签:
aicr bundle \
  --recipe recipe.yaml \
  --system-node-selector nodeGroup=system-pool \
  --accelerated-node-selector nodeGroup=gpu-worker \
  --output ./bundles
该捆绑包为每个组件提供一个目录,按依赖关系图排序,每个组件都带有自己的值、checksum 和安装脚本。AICR 通过 --deployer 标志支持许多部署器,包括 helmfile、flux 和 argocd。
验证生成的捆绑包,然后进行安装:
(cd ./bundles && aicr verify . && chmod +x deploy.sh && ./deploy.sh)
部署完成后,k8s-aibom 控制器将在 k8s-aibom-system 命名空间中运行。AICR 使用主图表的 CRD,而非配套的 k8s-aibom-crds 图表。Helm 包包括 CRD 应用步骤;Flux 和 Argo CD 通过其控制器处理更新。Helmfile、Terraform 和 Fleet 需要文档中记录的手动 CRD 更新当过渡需要时。检查已安装的存储版本:
kubectl get crd aiboms.aibom.k8saibom.dev \
  -o jsonpath='{.spec.versions[?(@.storage==true)].name}'
# v1beta1
验证
aicr snapshot --output snapshot.yaml
aicr validate --recipe recipe.yaml --snapshot snapshot.yaml \
  --phase deployment --phase conformance
k8s-aibom 运行状况检查作为部署阶段的一部分运行。这需要控制器部署可用,集群范围内的 AIBOMControllerConfig 报告当前的 Ready=True ,两个 CRD 报告固定图表所期望的存储版本。匹配的存储版本并不能证明完整的 CRD 架构是最新的。在升级期间,还要验证目标模式,并检查是否存在 Degraded=True ,并给出 SchemaPredatesController 的合理性;请参阅运行状况和就绪情况。
选择命名空间
按命名空间选择加入清单。标签控制哪些命名空间会发送 AIBOM 记录;它不会缩小控制器读取的内容。告密者仍会缓存整个集群的工作负载和 Pod 规格,包括容器参数和内联环境值。默认情况下,系统不会配置接收端和机密访问,因此如果没有明确的决策,任何内容都不会离开集群。
kubectl create namespace prod-jobs
kubectl label namespace prod-jobs aibom.k8saibom.dev/enabled=true
运行推理工作负载
当支持的工作负载的命名空间加入时,系统会自动清点这些工作负载所携带的可识别 AI 信号。简单演示一下,这是一个服务于 Qwen 的 vLLM 部署。请注意,它会提取 vllm/vllm-openai:latest 而不是摘要,这种模式在某些环境中并不少见。 nvidia-h100-mega-80gb 选择器和容限必须与 GPU 池的标签和污点相匹配:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-qwen
  namespace: prod-jobs
spec:
  replicas: 1
  selector:
    matchLabels: {app: vllm-qwen}
  template:
    metadata:
      labels: {app: vllm-qwen}
    spec:
      # Adjust to match your GPU node pool's taints and labels.
      tolerations:
        - key: dedicated
          operator: Equal
          value: gpu-workload
          effect: NoSchedule
      nodeSelector:
        cloud.google.com/gke-accelerator: nvidia-h100-mega-80gb
      containers:
        - name: vllm
          image: vllm/vllm-openai:latest
          args: ["--model", "Qwen/Qwen2.5-0.5B-Instruct",
                 "--max-model-len", "4096",
                 "--gpu-memory-utilization", "0.30"]
          ports:
            - containerPort: 8000
          resources:
            limits:
              nvidia.com/gpu: "1"
          volumeMounts:
            - {name: shm, mountPath: /dev/shm}
      volumes:
        - name: shm
          emptyDir: {medium: Memory, sizeLimit: 2Gi}
将此清单文件另存为 vllm-qwen.yaml ,然后创建工作负载:
kubectl apply -f vllm-qwen.yaml
查看清单
应用工作负载后,您可以跟踪库存:
kubectl -n prod-jobs get aiboms.aibom.k8saibom.dev
输出示例:
NAME                        WORKLOAD     NAME        CATEGORY    RUNTIME   READY   AGE
apps-deployment-vllm-qwen   Deployment   vllm-qwen   inference   vllm      True    28m
控制器会自动对工作负载类别和服务运行时进行分类。需要了解的一点是:记录是根据工作负载规范构建的,因此在任何 Pod 运行之前,AIBOM 都可以存在。当 POD 仍在提取图像时,AIBOM 会出现并报告 Ready=True。AIBOM 会告诉您已声明的内容,以及一旦 Pod 存在,它会解析到的内容。它无法证明调度或执行成功。
查看状态条件:
kubectl -n prod-jobs get aibom apps-deployment-vllm-qwen \
  -o jsonpath='{range .status.conditions[*]}{.type}={.status} {end}'
# Ready=True Synced=True SinkFailed=False Stale=False
验证 AIBOM
当文档足够小时,它会以内联方式存储在资源上,并在标准字节上使用已发布的 SHA-256:
kubectl -n prod-jobs get aibom apps-deployment-vllm-qwen -o json > aibom.json
jq -r '.status.bomDocument.inline.data' aibom.json | base64 -d > bom.json

jq -r '.status.bomDocument.sha256' aibom.json
shasum -a 256 bom.json | awk '{print $1}'
以下是所有这些功能的组合:
jq -r '.components[] | "\(.type)\t\(.name)"' bom.json
响应应如下所示:
application              vllm
container                vllm/vllm-openai
machine-learning-model   Qwen/Qwen2.5-0.5B-Instruct
常规 SBOM 会告诉您正在运行的是哪个镜像。AIBOM 会告诉您哪个模型正在服务,哪个运行时正在为其服务。属性带有四个置信度层 ( declared、inferred、unresolved 或 verified ) 中的一个,以及证据定位器,因此审查者可以看到每个声明的达成方式。
资源影响
上游在 GKE 上使用 NVIDIA Dynamo 和 AICR 配置测量 k8s-aibom v1.6.1 。测试使用了仅使用 CPU 的节点,工作负载 pod 仍处于待处理状态,因此这些图描述了控制器库存开销:
- 在 15 分钟的稳定状态观察窗口期内,每分钟大约 4 个 API 服务器请求
- 控制器 CPU 的平均使用率为 2.2 毫核
- 控制器内存工作集 ( 28 至 34 MiB)
- 当测试工作负载的图像标签发生变化时,一次 AIBOM 更新
未来趋势
该集成有意阻止了几件事,每个事情都有自己的决定,而不是疏忽。
有符号的运行时观察:运行时 AIBOM 被写成 Kubernetes 资源,但观察本身是无符号的。签名将使截取的观察结果变得显而易见;它无法证明每个工作负载声明都是真的,也无法建立成功执行。上面显示的标准字节和已发布的 SHA-256 使签名变得易于处理。
连接经过验证的来源: k8s-aibom 可以根据运营商配置的信任根来验证模型声明上的 Sigstore 签名、执行签名者身份限制、检查 Rekor 包容性,并将符合条件的声明分配给经过验证的置信度级别。默认情况下,AICR 会禁用此验证。在启用签名时,AICR 还可以生成透明度记录的捆绑证明;将该平台来源与运行时 AI 清单连接仍是未来的集成工作。
意图和观察到的工作负载: AICR recipe 描述了部署意图。运行时 AIBOM 会记录观察到的工作负载规格和可用的 Pod 状态证据。关联它们需要共享的伪影标识、新鲜度规则以及基础架构和工作负载覆盖范围之间的映射。这种比较仍是未来的集成工作;AIBOM 不会建立成功执行或集群完全一致性。
AICR 可从 NVIDIA/aicr 获取。k8s-aibom 可从 GoogleCloudPlatform/k8s-aibom 获取。两者都是开源的。如果您在 Kubernetes 上运行 GPU 工作负载,此集成会添加已识别 AI 工作负载的清单,以及显示每个属性如何确定的证据。
