

一个包含 300 亿个参数的模型如何仅对每个 token 激活 300 亿个参数,同时仍然使用更大模型的容量?Nemotron 3.5 Lightning 说明了答案:它使用的是多专家模型 (MoE) 架构,该架构仅为每个 token 选择其参数的子集。
有两种主要的模型架构:密集模型和 MoE。模型如何组织参数与它有多少参数一样重要。与原始参数计数相比,正确的选择对吞吐量、内存成本和服务复杂性的影响更大。因此,在两者之间进行选择取决于部署限制。
想象一下总排量相同的两个引擎之间的区别。一个循环会在每个循环中启动每个圆柱体,另一个则仅激活所需的圆柱体。
本文将介绍:
- 稠密和 MoE 架构的工作原理
- 它们如何影响性能
- 何时选择
密集模型与 MoE 模型
简而言之,密集模型和 MoE 模型在使用参数方面存在差异。稠密模型会为每个 token 激活其所有参数。MoE 模型可存储多个专家网络,但每个 token 仅通过选定的子集进行路由。
密集模型通常有利于更简单、更可预测的部署,而当内存和服务复杂性易于管理时,MoE 模型可以提供更高的容量和吞吐量。
参数的不同之处在于
在稠密模型中,每个参数都参与每次前向传递。通过每个解码器层的单个共享前馈网络 (FFN) 块,一个 27B 模型的所有 270B 参数可对应每个 token。
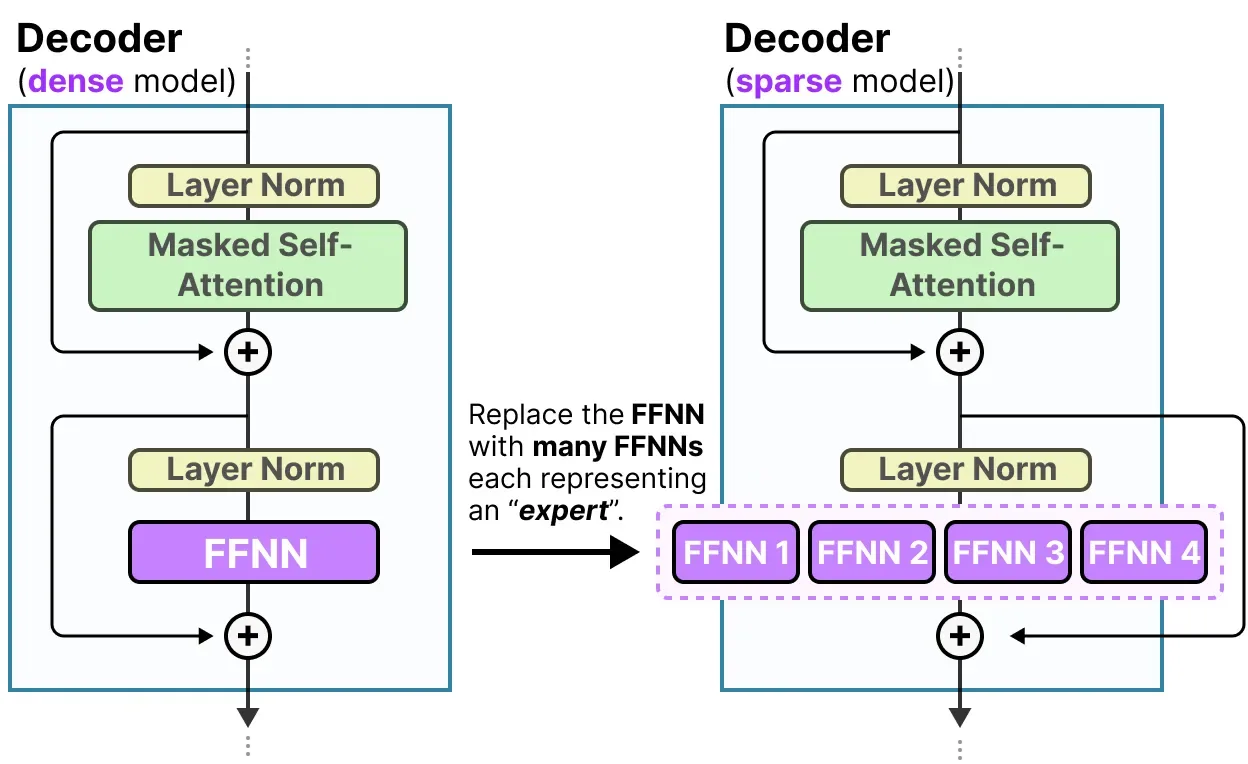
MoE 模型将单个共享 FFN 替换为多个 FFN 块 (也称为专家) 。通过内部路由过程,传入的 token 通过一小部分专家 (而非每个参数) 进行处理。从结构上讲,在每个解码器层 (其中稠密模型将具有一个 FFN) 内部,MoE 层具有多个 (例如。8、64 或 128) 。习得的门网络 (通常称为路由器网络) 位于所有门网络的前面,并将每个传入token分配给排名前 k 的评分专家。选定的 FFN 块是为该 token 运行的块,而为该特定层跳过的其余块。不过,大多数现代 MoE (例如 Mistral Small 4) 也会运行一个“共享”专家,每个 token 都会路由到该专家。
MoE 路由的工作原理
对于 MoE 模型,每个层的路由决策都是独立的,这意味着 token 不会路由给专家,而是会一直保留在那里进行其余的计算。在每个解码器层,它都会根据token在网络中该点所代表的内容重新路由。每一层的这些专家都不是传统意义上的专家,他们专注于某一主题,而是主要专注于语法和标记类型模式 (标点符号、数字等) ,尽管这因架构或训练方法而异。
虽然路由器机制决定在每个解码层跳过哪些 FFN 块,但token仍然像往常一样通过完全注意力机制。当模型卡显示“3B active parameters” ( 3B 活跃参数) 时,它会包括每个 token 的注意力和嵌入权重,以及选定的 FFN 权重。
MoE 变体
MoE 也有一些变体,其中之一是用于 Nemotron 3.5 Lightning 的 NVIDIA 模型卡,该卡指定了 Mamba-2+ MoE+ Attention 混合模式。在大多数层中,Mamba-2 层是注意力的集中点,具有恒定大小的循环状态,而不是不断增长的 KV 缓存。这改变了长上下文的内存配置文件,而稀疏性本身并不能解释这一点。
Lightning 不是使用完整模型的广度来做出这些路由决策,而是首先将它们压缩到更小的空间中,从而使路由决策对模型来说更便宜。下图 1 描述了通用 Transformer-MoE 案例。请注意,MoE 模型是一种稀疏模型。
密集模型还是 MoE 模型?
MoE 模型的 token 吞吐量通常更快,因为它们只为每个 token 激活了前馈参数的子集。密集模型可激活整个网络,但可以提供更简单的服务和更可预测的延迟。
在高并发情况下,路由和内存移动会缩小 MoE 的优势。结果还取决于硬件、精度、推理框架和模型设计。例如,Nemotron 3.5 Lightning 具有 Mamba-2 层和预测解码。
关键模型性能差异
两者之间的性能差异主要表现在两个方面。首先,在总参数计数相等的情况下,跳过的 FFN 块可加快 MoE 速度。两者之间更重要的区别在于,MoE 将内存 (总参数 = VRAM 到主机) 与计算 (活动参数 = 每个token的 FLOPS) 解。
在稠密模型中,托管和推理成本共同增加,MoE 打破了这种联系。有了 MoE,VRAM 就会预先得到回报。当每个专家加载到内存中时,计算按 token 支付,并且仅随着启动的专家进行扩展。空闲专家无需任何成本即可运行,同时仍需支付存储所需的内存费用,因此从按标记变量计算到固定内存的转变成为主要权衡。
在批量大小为 1 时,解码受可用内存而非计算的约束,这正是 MoE 的出色表现,因为它读取的每个token的权重字节数较少。随着批量大小的增加,token 最终会共同使用网络中的大多数专家,而这种优势会缩小,而每个 token 的工作量会继续减少。MoE 在批量大小方面具有吞吐量优势,但与经过良好优化的密集模型相比,其延迟幅度在高并发下进行压缩。
现代推理框架通常在不丢弃 token 的情况下处理路由,但所有专家必须同时位于 GPU 显存中。与同等规模的稠密模型通常拥有的空间相比,这给 KV 缓存留下的空间更小。
比较示例
下表 1 显示了直接比较。在相同的总参数大小下,稀疏性在吞吐量方面明显可见:Gemma 4 31B 和 Nemotron 3.5 Lightning 总计约 300 亿,但在 NVIDIA GPU 提供商之间,其输出速度范围并不重叠。每个 token 激活 30 亿个参数是一个主要原因,但这并不是唯一的原因。Lightning 的 Mamba-2 层及其预测性解码功能独立于混合 MoE 架构。
| 模型 | 架构 | 总参数 | 活动参数 | 显存 (原生) | 显存 ( 4 位) | 人工智能分析智能指数 | 输出速度* | $/ M 输出* |
|---|---|---|---|---|---|---|---|---|
| Gemma 4 31B | 密集;多模态 | 31B | 31B | 61 GB BF16 ( 1 H100) | ~ 16 GB | 30 | 36.9 至 2022.4 吨/ 秒 | 0.40 美元 |
| Qwen3.8-27B | 密集;混合线性/ 全注意力;MTP 头;多模态 | 270 亿 | 270 亿 | 56 GB BF16 ( 1 H100) | ~ 14 GB | 52 | 46.8 t/ s | $ 3.00 美元 |
| Nemotron 3.5 Lightning | MoE+ Mamba-2 注意力混合 | 300 亿 | 3B | 60 GB BF16 ( 1 H100) | ~ 20 GB | 24 | 235.7 至 494.2 吨/ 秒 | 0.22 美元 |
| Mistral Small 4 | MoE;多模态 | 119B | 6B (包括 80B) 。嵌入) | 121 GB FP8 ( 4 块 H100 以上) | ~ 71 GB | 20 | 147.3 t/ s | 0.60 美元 |
可以观察到两者的权衡;例如,Lightning 以 14 倍的价格提供 Qwen3.8-27B 4 到 5 倍的输出速度,而在一般能力方面得分不到一半。对于批量运行明确指定步骤的代理执行层来说,这是正确的,而对于一个硬推理通道决定结果的情况则是错误的。
何时应使用稠密模型或 MoE 模型?
在决定使用哪种模型时,取决于哪种模型最适合您的部署环境。
需要考虑以下几个因素:
- 显存占用: 显存占用追踪的是总参数而非活动参数,因此一个 30B MoE 和一个 30B 密集模型大约需要 60 GB。真正的问题在于这些千兆字节会得到什么:dense 将它们转化为能力,MoE 转化为吞吐量。
- 并发:MoE 在单个请求中明显获胜。它的吞吐量优势随着并发规模的增加而保持不变,但延迟差距会缩小。如果您对高并发延迟很敏感,请在做出决策之前对两者进行基准测试。
- 微调计划:密集模型微调更简单;所有参数激活,梯度均匀流动。对 MoE 模型进行全面微调会使路由器失去平衡,使一些专家比其他专家更受欢迎,或者完全淘汰某些专家。LoRA/ PEFT 方法有助于避免这种情况,只需冻结路由器即可。NeMo 的 Lightning 监督式微调方法专门针对该模型进行了正确的处理
- 量化: 压缩比不在架构差异所在的位置。在实践中,有两点更重要。首先,检查检查点已达到的精度:Mistral Small 4 原生为 FP8,因此 4-bit 会再购买+ 1.7% ( 121GB = 71GB) ,而不是 4%。其次,两种架构都有量化不佳的模组,而且它们并不相同。在 MoE 中,它是路由器,其中的小干扰会颠覆离散的路由决策。配方使路由器、嵌入和输出端更高,而在混合注意力模型中,则是反复预测来颠覆路由决策。例如,量化的 Qwen3.8-27B 版本正是出于这个原因,在 BF16 中保留了线性注意力块。
核心权衡
Dense 和 MoE 是一种权衡的两个答案:每个参数的能力与每个token的计算。Dense 可让一切变得简单,让一切变得活跃,这使得微调和服务变得更加容易。MoE 利用内存购买吞吐量,并在服务复杂性方面为此付出代价。
Nemotron 3.5 Lightning 完全开放,包含权重、数据和方法,因此您可以根据工作流程进行调整,并将其部署到任何地方。要开始使用,请在 NVIDIA 官网 或 OpenRouter 上试用。从 Hugging Face 和 ModelScope 中下载权重。
对于物理 AI工作负载,AgiBot GO-1和腾讯 Hy-Embodyed-VLM-1.0是生态系统中的热门选择。
