

多专家模型 (MoE) 已成为大规模 AI 模型训练中的关键架构趋势之一。DeepSeek、Qwen 和 Mixtral 是 MoE 模型的示例,这些模型的性能达到甚至超过了密集模型对应模型的性能,但只是训练计算的一小部分。
MoE 模型通过条件计算提供高效训练。MoE 不是由所有 token 共享的一个密集前馈网络 (FFN) ,而是将其替换为许多较小的专家网络和一个学习到的路由器,以决定要激活哪些 Top-K 专家。
但是,大规模地提高 MoE 训练的效率具有挑战性。在基于 NVIDIA GB200 的 DeepSeek-V3 训练中,未优化的基准仅实现了 103 TFLOPS/ GPU,而 GPU 间通信消耗了 84% 的累积内核时间。借助 JAX Python 库和 NVIDIA Transformer Engine 定向内核优化,该数字上升到 1068 TFLOPS/ GPU,提高了 10.4 倍。本文将讨论 Transformer 引擎 (一个用于在 NVIDIA GPU 上加速 Transformer 模型的库) 如何借助 JAX 显著提高 MoE 模型运算的性能。
MoE 训练涉及哪些挑战?
生产级 MoE 训练引入了稠密模型不存在的瓶颈:token 路由、专家调度和收集、多对多通信以及破烂的专家 GEMM。
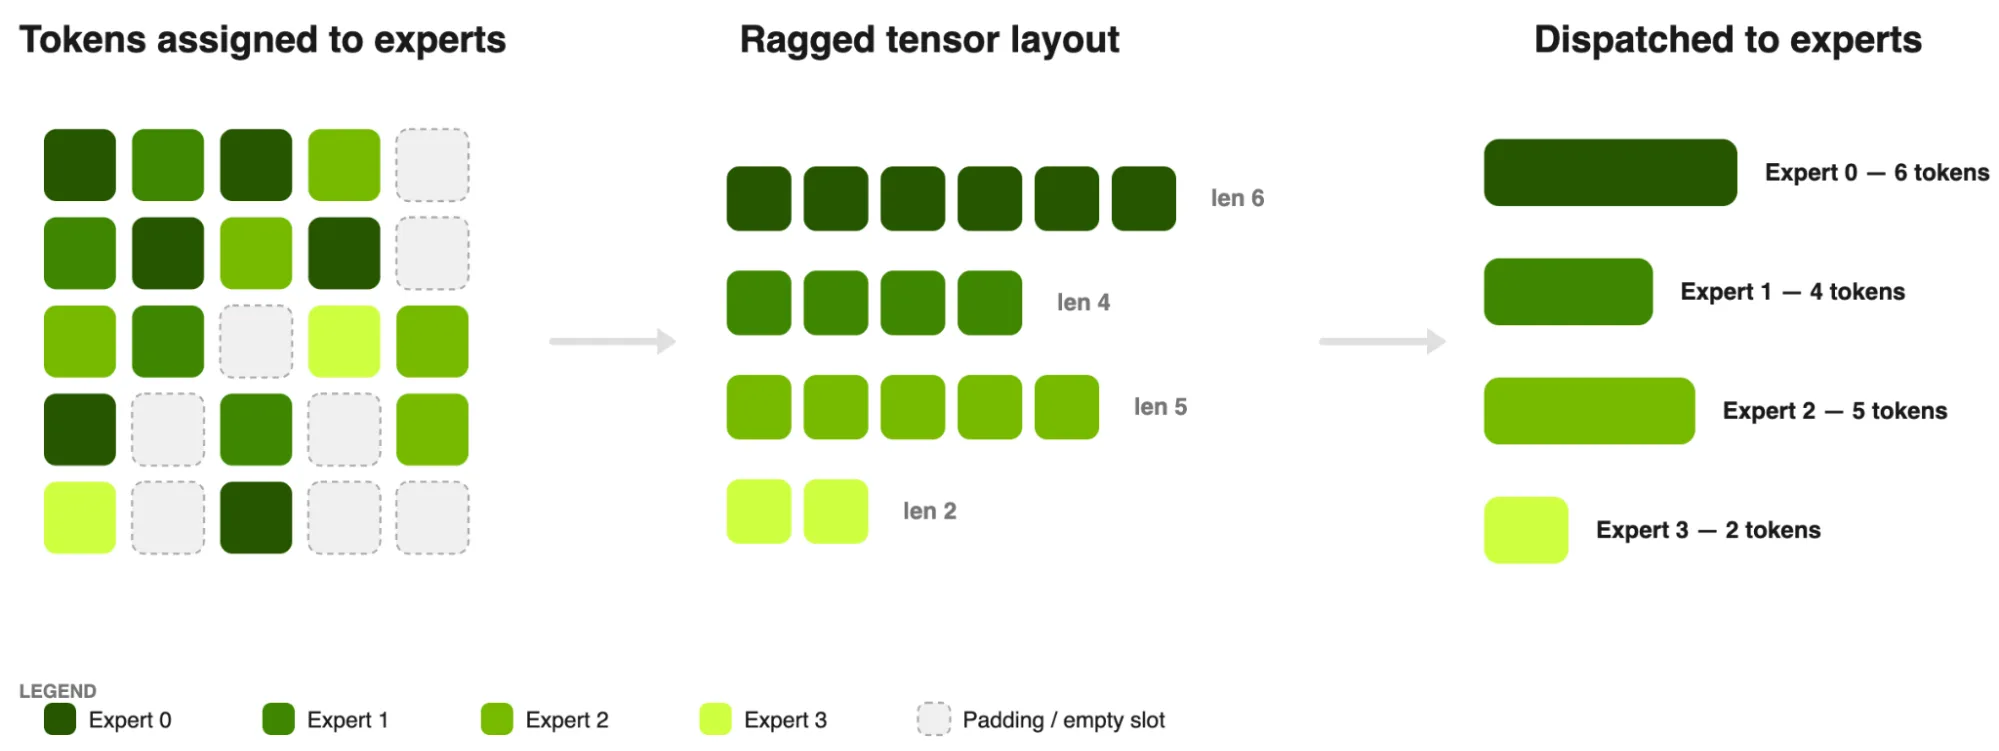
因为路由器是学习的,所以问题变得更加复杂。在整个训练过程中,随着路由器对某些专家产生偏好,分布可能会严重倾斜。没有两个批次会产生相同的专家负载,并且在一个批次中,一位专家可能会收到比另一位专家多得多的 token。每个专家收到的token数量不同,因此没有干净的矩形 GEMM 要批处理和发送。这会导致张量模糊不清。
在 MoE 中,token 会动态路由到不同的专家。这意味着分配给每个专家的 token 数量变化莫测,从而导致张量不连贯 (图 1) 。这是一项挑战,因为大多数库都针对需要统一的矩形数据结构的张量运算进行了高度优化。
借助专家并行 (EP) ,必须分发token,并且必须组合输出并将其恢复到原始token顺序。如果调度和合并路径未得到优化,通信将占据主导地位,GPU 将未得到充分利用。如果多对多优化效果欠佳,则会迫使 GPU 在执行任何有用的工作之前暂停并等待数据。
解决此问题需要能够原生处理破烂布局的专用内核。这正是 Transformer 引擎 MoE 优化旨在解决的问题。
裸滴 MoE 与基于容量的 MoE 有何不同?
Dropless 和基于容量的 MoE 是处理 token 路由给专家的两种不同方式。
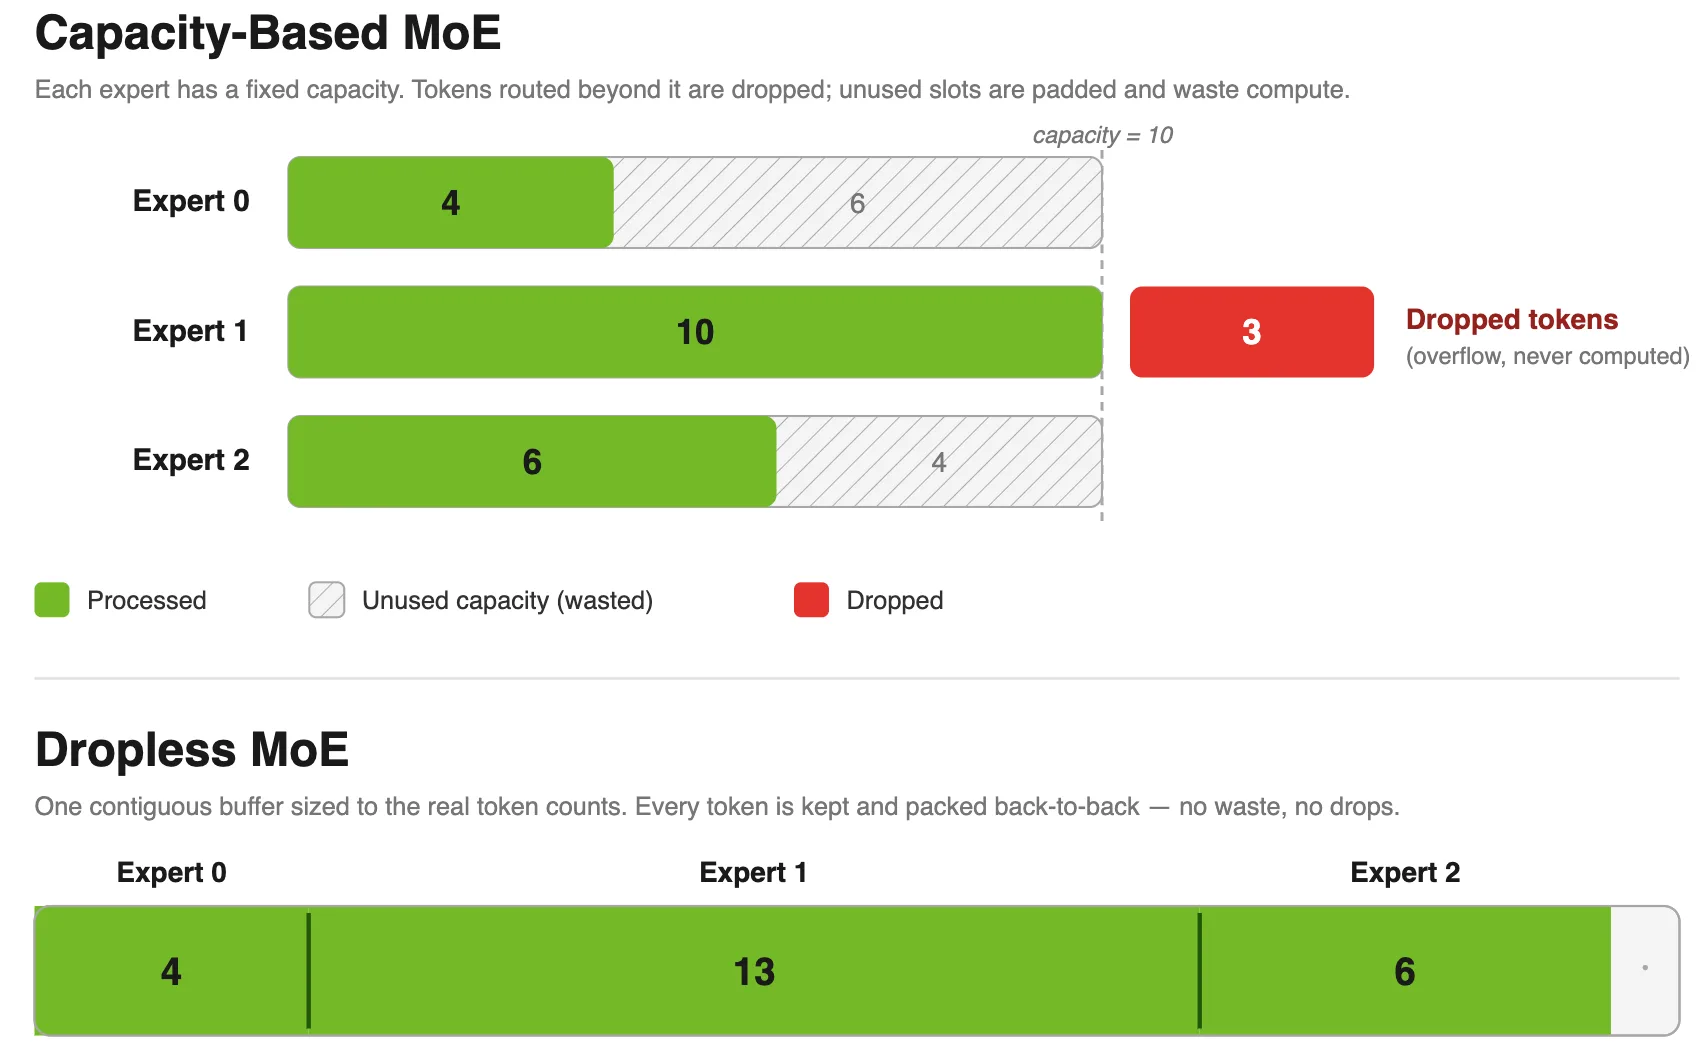
在裸照 MoE 中,无论负载有多不均匀,每个 token 都由其选定的专家进行处理。这对模型质量很有吸引力,但对系统要求很高。MegaBlocks:使用混合专家进行高效稀疏训练,通过将专家计算重新表述为块稀疏矩阵乘法来解决这一问题,允许每个专家在不丢弃或填充的情况下对不同数量的 token 进行操作。这需要新的块稀疏 GPU 内核、经过优化的分组 GEMM,以及调度和组合基元,所有这些都是专为可变token数量设计的。
相比之下,基于标准容量的 MoE 训练框架通过限制动态路由来规避复杂性。系统会为每位专家分配固定的 token 预算,并且会根据具体情况对溢出部分进行裁剪或填充。这可保持计算规律且对硬件友好,但也会强制在模型质量和效率之间作出直接权衡:删除溢出token,然后在不完整的数据或衬垫 (pad) 上训练模型,以避免丢弃,并在浪费的计算和内存中付出代价。
无滴 MoE 需要哪些专门的优化?
承诺无下降 MoE 意味着训练堆栈不再依赖于固定的专家形状。每个涉及专家计算的内核都必须高效处理可变token数量。此外,这意味着每个专家的 token 数量可变且依赖于数据,因此内核不仅必须接受动态形状,而且还必须在 CPU 无法访问这些形状时发挥作用,以启用 CUDA 计算图并避免重新编译。
Transformer 引擎提供以下构建块,使这种方法在 JAX 中切实可行:
- 组感知型 MXFP8 量化
- 基于专业 Matmuls 的 MXFP8 分组 GEMM
- 针对调度和合并优化 EP 操作
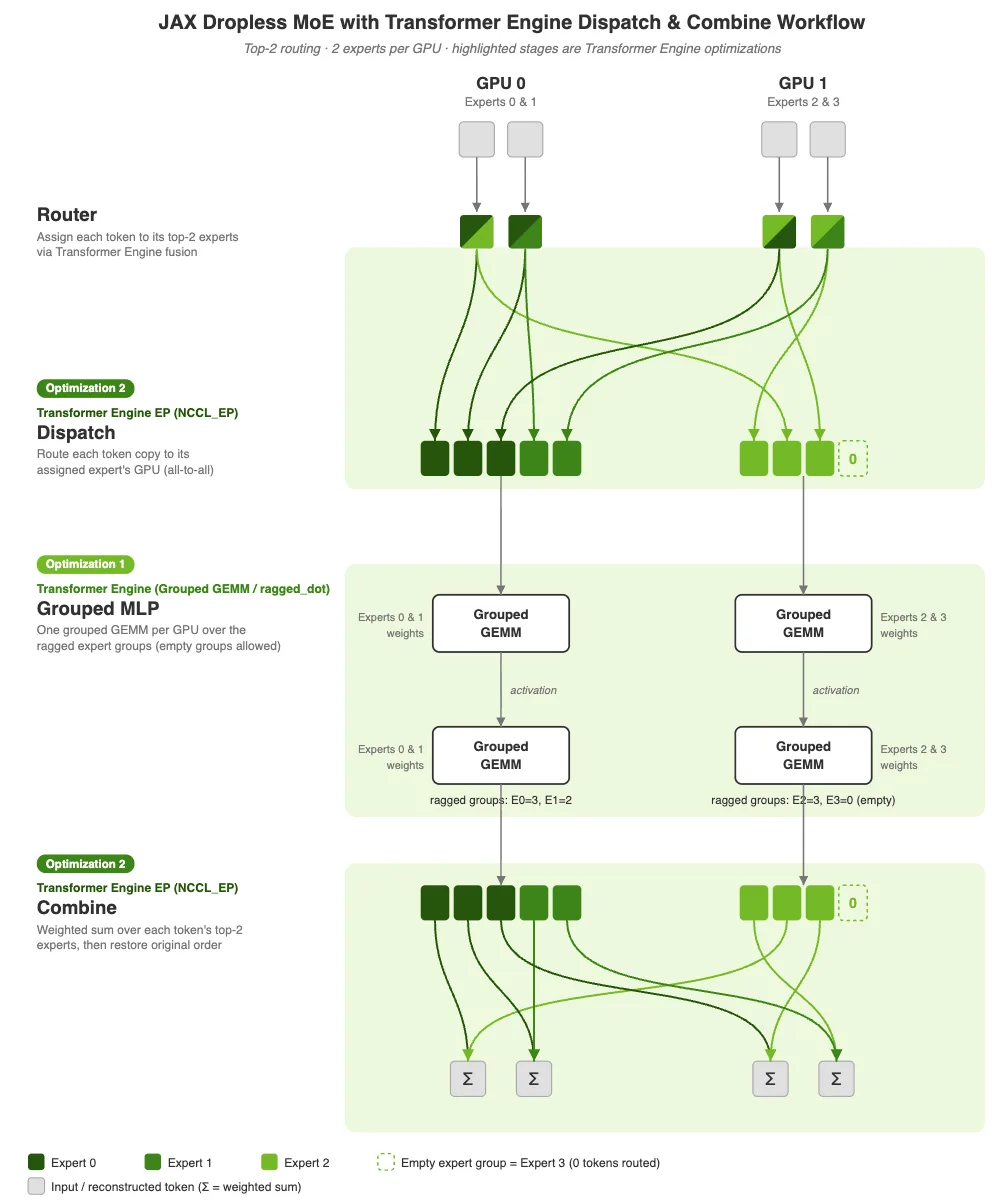
图 3 显示了跨两个 GPU 的专家并行 MoE 层。路由器将每个 token 分配给专家,并将 token 分发给其专家的 GPU。分组后的 MLP 在这些可变长度组上运行两个分组的 GEMM,并通过组合反向交换来恢复原始token顺序。
优化 1:分组 GEMM
在密集 FFN 中,每个 token 都经过相同的权重矩阵。在 MoE 中,路由器分配的 token 不均匀,因此每个专家每个步骤都会收到不同数量的 token,打破了典型内核优化的常规 GEMM 形状。
以前的方法包括 GEMM 内核循环和批量 GEMM。该循环需要从设备到主机复制token数量。这发生在关键路径上,这会导致设备到主机传输的延迟,并破坏 CUDA 计算图。即使使用的token较少,批量 GEMM 也会计算最差情况下的token容量,因为填充token是为了强制进行固定的专家计算,从而导致额外的计算。
分组的 GEMM 通过在单个内核调用中处理所有专家 matmuls 来解决这一问题,每个 matmuls 都有其实际 token 数量。它仅计算具有有效token的区域,因此性能更高。
Transformer 引擎 grouped_gemm /ragged_dot 通过 cuBLAS 和 cuBLASLt 提供支持,直接映射到性能最佳的 NVIDIA GEMM 库,即使在处理不规则的专家形状时也能充分利用 Tensor Core。在 NVIDIA Blackwell GPU 上,此路径还利用 Transformer 引擎 分组量化内核为专业级 matmuls 开启了 MXFP8 块缩放。
优化 2:集成 Dispatch 和 Combine 的专家并行性
在融合后的路由器内核将每个 token 分配给其专家后,模型必须将这些 token 物理地移动到正确的设备,对其进行处理,然后返回结果。
此过程分为两个不同的阶段:Dispatch 和 Combine。
- 分配:发生 Token 移动的环节:Token 经过置换并跨 GPU 传输至其指定的专家单元;这一步骤既包含本地重排序,也涉及多 GPU 间的通信。
- 合并:处理后的 token 会路由回其原始 GPU,并累加每个专家的结果。
在原生实现中,这些阶段作为独立操作的串行链运行,GPU 在步骤之间停止运行,数据被多次读取和写入内存,通信在计算运行时处于空闲状态,反之亦然。
Transformer 引擎 EP 实现将 Dispatch 和 Combine 阶段集成到紧密融合的内核路径中。此集成由 NCCL EP 提供支持,后者是一个通信后端,专门针对专家并行路由产生的不规则、不平衡的流量模式进行了调整。
NCCL EP 还采用了 token 重复数据删除机制:当 token 被分配给同一秩上的多个专家或远程 IB 节点上的多个 rank 时,它只遍历网络一次,并在接收节点上复制,从而节省网络带宽。EP 与分组的 GEMM 相对应:分组的 GEMM 负责处理每个专家内部发生的事情;EP 负责处理周围的一切。
其他优化
其他优化包括 JAX 主机卸载和 XLA 多流群集。
JAX 主机卸载
对于整个正向传递,中间激活函数不必保存在设备上。JAX 提供重新材质化 API,用于将激活函数卸载到主机内存。要在 DSv3 训练中节省内存,请将查询和值投影结果卸载到主机。如需了解更多信息,请参阅使用主机卸载减少基于 JAX 的 LLM 训练中的高带宽内存瓶颈。
XLA 多流群集
虽然 EP 由 Transformer 引擎 NCCL EP 驱动,但优化的 FSDP 是在 XLA 中原生处理的。默认情况下,XLA 在单个流上运行通信,因此可以并行执行的集合被序列化,一些集合最终会暴露在关键路径上。多流群集允许编译器在单独的 CUDA 流中同时调度独立的群集,将跨节点 InfiniBand 传输与节点内 NVIDIA NVLink 通信重叠,以便同时在两个结构上绘制,而无需等待一个序列化流。
延迟隐藏调度程序 (LHS) 通过分析其副本组并检查死锁风险来确定哪些群集可以安全重叠,因此内存带宽增益是自动的,不需要手动标注。这显著降低了 DSv3 训练中公开集合的百分比。
使用 Transformer 引擎的 JAX 中的 MoE 对训练性能有什么影响?
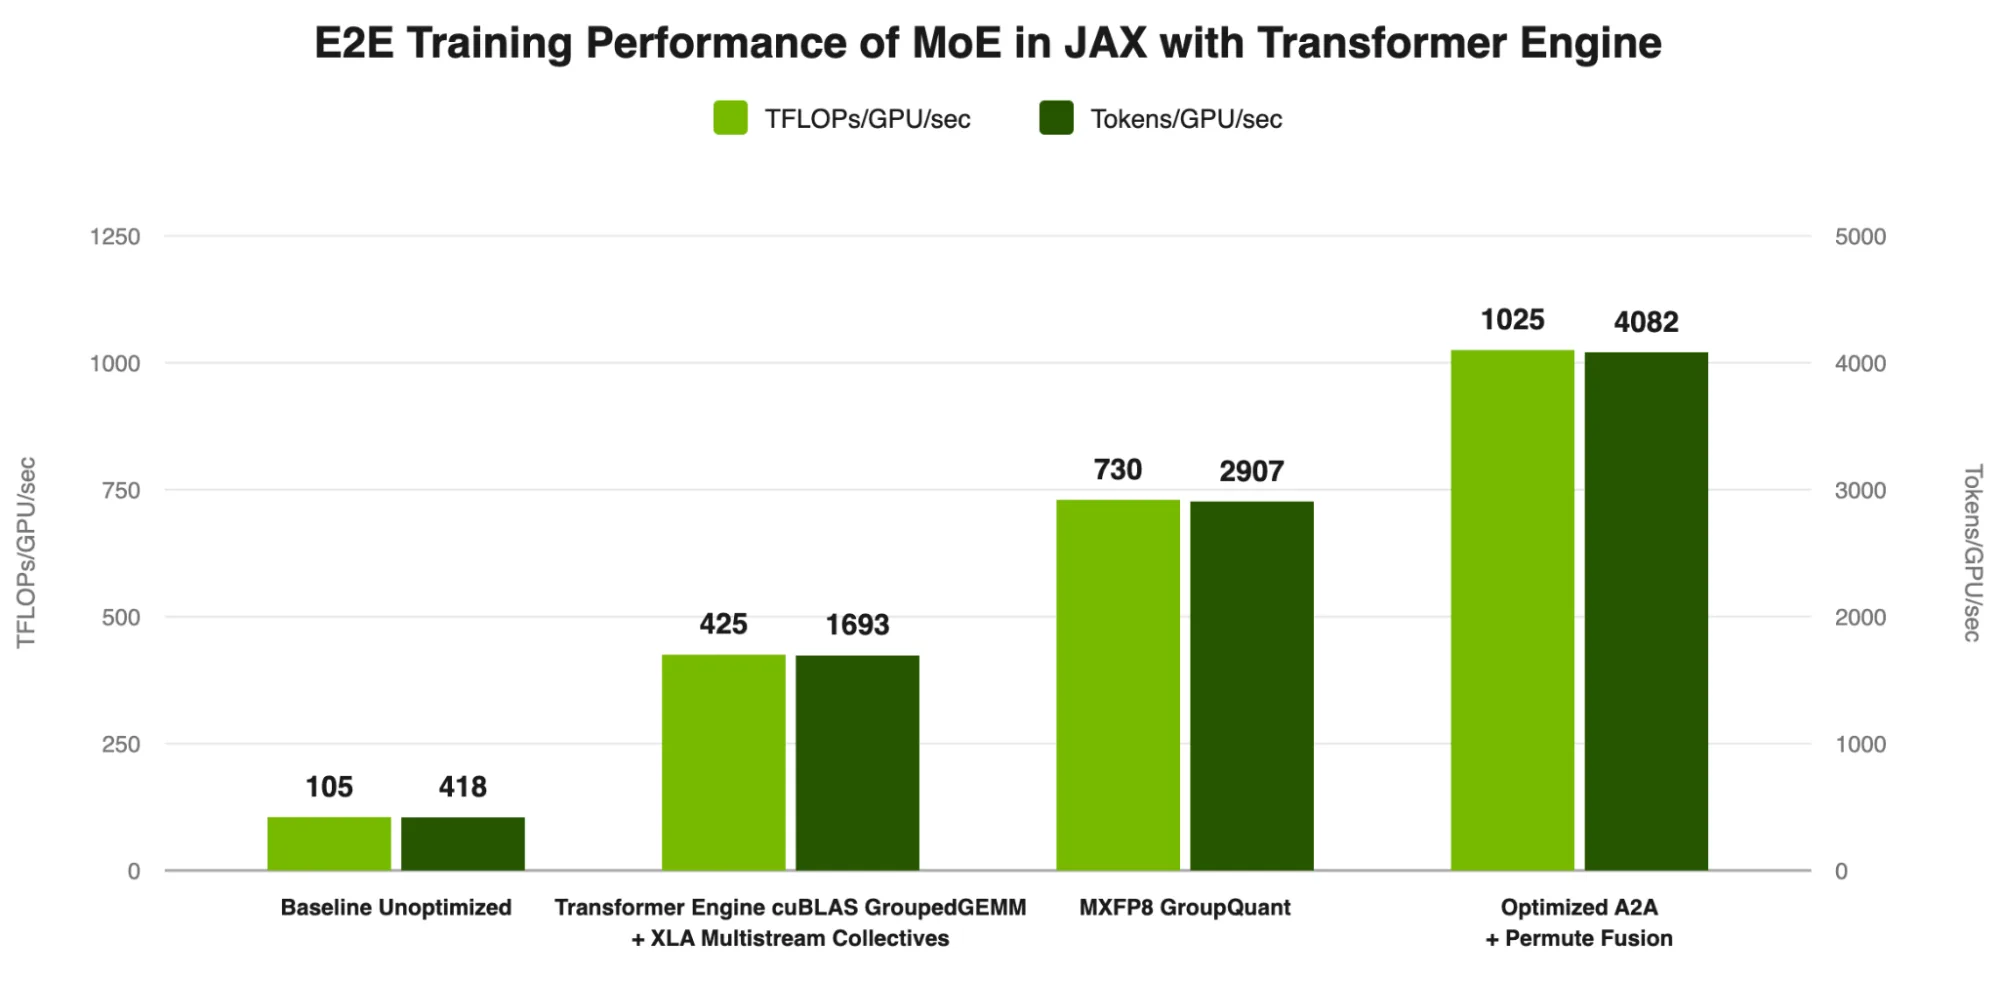
我们观察到,在经过 Transformer 引擎优化的 JAX 中,通过 MoE,DeepSeek-V3 671B 的端到端吞吐量提高了 10 倍。
回想一下,基准 JAX 训练堆栈将大部分硬件潜力保留在桌面上。针对每一层的堆栈,我们添加了 cuBLAS GroupedGEMM、XLA 多流群集、MXFP8 GroupQuant、主机激活卸载,最后是优化的 EP 实现。
我们计划添加 NVFP4、与 GEMM 融合的量化以及 A2A 重叠。如需详细了解 Transformer 引擎 JAX 绑定将支持的未来内核融合,请参阅 使用高级融合内核提升 MoE 训练吞吐量。
借助 JAX 实现出色的多机架扩展性能
大规模训练大型模型需要积极的优化。在生产规模上,这相当于数万亿个 token,而大规模的批量效率低下。虽然这些问题在单个节点上几乎可以忽略不计,但它们可以在数千个 GPU 上快速复合,因此解决计算、内存和通信中的每一个瓶颈都至关重要。
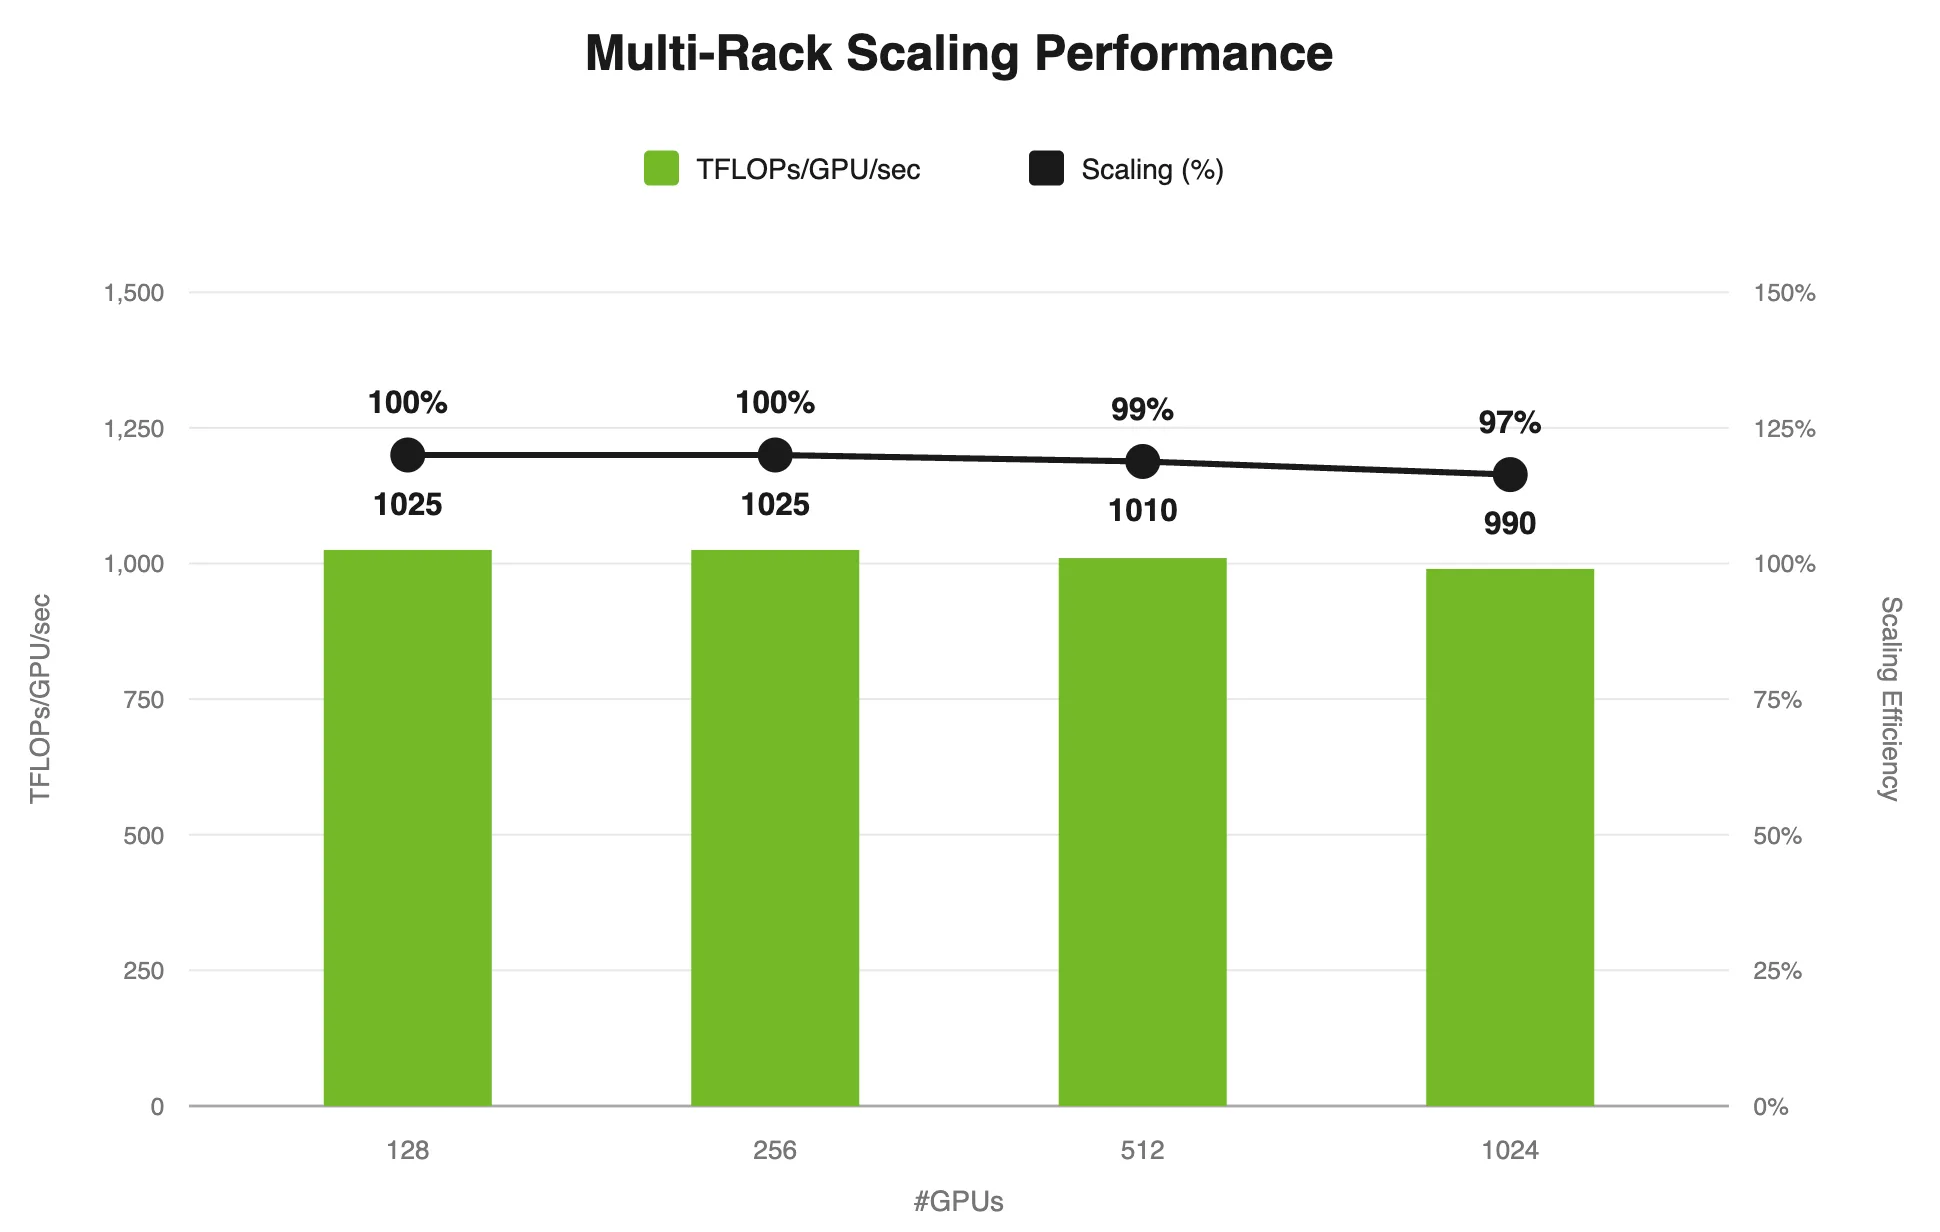
多机架扩展是大多数系统难以处理的问题,因为通信开销的扩展速度往往快于计算。应用 JAX MoE 和 Transformer 引擎堆栈后,这种性能下降趋势会得到显著遏制。该系统可在 1024 个 GPU 上保持 97% 的效率,这一结果直接关系到底层通信优化在保持集群增长吞吐量方面的有效性。
如何开始使用裸机 MoE 训练
优化功能在内置 Transformer 引擎的 NVIDIA NGC MaxText 容器中提供,因此您可以直接在其上复制和构建。要开始使用,请尝试使用启用 Transformer 引擎的 NVIDIA NGC MaxText 容器优化 JAX MoE 路径。
从参考配置开始,验证小型 MoE 模型的正确性,然后在跟踪步长时间、TFLOPS/ GPU、MFU、分组 GEMM 延迟和 MoE 调度/ 合并延迟的同时进行纵向扩展。
基本使用配置:采用 MaxText 的 TE MoEBlock
要在 MaxText 中启用 TE MoEBlock,请将以下标志添加到您的 MaxText YAML 配置中,或将其作为命令行参数传递到训练脚本。
容器
使用 2026 年 9 月 9 日发布的容器 (ghcr.io/nvidia/jax:maxtext-2026-09-09-09) 或更新版本。有关更多详情,请参阅 NVIDIA/ JAX-Toolbox GitHub 存储库的容器镜像部分。
MaxText 配置 (MaxText moe_configuration.md) :
te_moe_block: true
te_gmm_quantization: "te_mxfp8"
ragged_buffer_factor: 2.0
te_ep_overflow_check_every_n_steps: 20
sparse_matmul: true
prefuse_moe_weights: true
DeepSeek V3 的性能再现
为了准确再现本文中展示的 DeepSeek-V3 671B 结果,请使用以下 MaxText 配置标志、XLA 标志和环境变量扩展基本使用配置。请注意,此配置是 DeepSeek-V3 特有的;不同的模型需要不同的调优。无需使用 TE MoEBlock 本身。
MaxText 配置
MaxText 配置如下所示。有关参数详情,请参阅 MaxText MoE 配置指南。
# Model parameters
model_name: "deepseek3-671b"
max_target_length: 4096
hardware: "gpu_multiprocess"

# Training settings
per_device_batch_size: 6
gradient_accumulation_steps: 1
steps: 15
attention: "cudnn_flash_te"
remat_policy: "custom"

# Transformer Engine MoEBlock with MXFP8 grouped GEMMs
quantization: "te_fp8_currentscaling"
te_moe_block: true
te_gmm_quantization: "te_mxfp8"
ragged_buffer_factor: 2.0
te_ep_overflow_check_every_n_steps: 20
prefuse_moe_weights: true

weight_dtype: "bfloat16"
mu_dtype: "bfloat16"

# Features
pgle: true
profiler: "xplane"
scan_layers: true
zero_one: false
shardy: true
use_segment: false

skip_first_n_steps_for_profiler: 4

custom_remat_enabled: true
logits_dot_in_fp32: false
use_iota_embed: false

custom_remat_config:
  mlpwi: device
  mlpwi_0: device
  mlpwi_1: device
  mlpwo: device
  moe_mlpwi_0: offload #remat
  moe_mlpwi_1: offload #remat
  moe_mlpwo: device
  query_proj: remat #offload
  key_proj: remat
  value_proj: remat #offload
  query_wa_proj: device
  kv_wa_proj: device
  out_proj: device
  context: device

# MoE routing parameters
n_routing_groups: -1
topk_routing_group: -1
capacity_factor: 1.0
megablox: false

# 128 GPUs: total FSDP=16 (ICI 8 × DCN 2) × EP=8.
nodes: 32
ici_data_parallelism: 1
ici_fsdp_parallelism: 8
ici_tensor_parallelism: 1
ici_expert_parallelism: 8
dcn_data_parallelism: 1
dcn_fsdp_parallelism: 2
dcn_tensor_parallelism: 1
dcn_expert_parallelism: 1
shard_optimizer_over_data: false

shard_exp_on_fsdp: false
XLA 标志调优
有关 XLA 标志调优的指导,请参阅 XLA GPU 标志指南和 JAX Toolbox GPU 性能指南。
xla_gpu_all_reduce_combine_threshold_bytes: 33554432
xla_gpu_all_gather_combine_threshold_bytes: 6442450944
xla_gpu_reduce_scatter_combine_threshold_bytes: 201326592
xla_gpu_experimental_enable_nccl_symmetric_buffers: false
xla_gpu_enable_command_buffer: "'FUSION,CUBLAS,CUDNN,DYNAMIC_SLICE_FUSION'"
xla_gpu_experimental_max_unroll_factor: 8
xla_gpu_memory_limit_slop_factor: 99
环境变量
XLA_PYTHON_CLIENT_MEM_FRACTION: 0.88
CUDA_DEVICE_MAX_CONNECTIONS: 16
XLA_PJRT_GPU_HOST_MEMORY_PREALLOCATE: false
XLA_PJRT_GPU_HOST_MEMORY_LIMIT_GB: 180
了解详情
Dropless MoE 训练可保持模型质量,而 Transformer 引擎 分组的 GEMM 和 EP 内核可大规模提高其效率。这种方法使 DeepSeek-V3 671B 上的 1024 个 GPU 的吞吐量提高了约 10 倍,扩展效率提高了 97%。这些优化在内置 Transformer 引擎 的 NVIDIA NGC MaxText 容器 中提供,因此您可以直接复制和构建这些优化。
有关在 MaxText 中使用 Transformer 引擎 MoE 模块的信息,请参阅 MaxText MoE 配置指南。有关 Transformer 引擎的更多信息,请参阅 Transformer 引擎文档。
致谢
特别感谢 Abhinav Goel、MD Fahim Faysal Khan、Jane Liu、Terry Sun、Tj Xu、Ming Huang、Chase Roberts 和 Oleg Goncharov 为在 JAX、XLA 和 Transformer Engine 中实现和优化 MoE 所做的贡献。感谢 Artem Polyakov、Ke Wen 和 Subhadeep Bhattacharya 为 NCCL EP 做出的贡献,并感谢 Igor Safanov 为 cuBLASLt 做出的贡献。


