

当服务器加载真实模型并处理请求时,AI 编码代理的补丁可能会通过测试,但却失败。因此,评估对推理服务软件的更改需要检查完整的服务路径,包括系统是否通过其公共接口返回正确的结果。
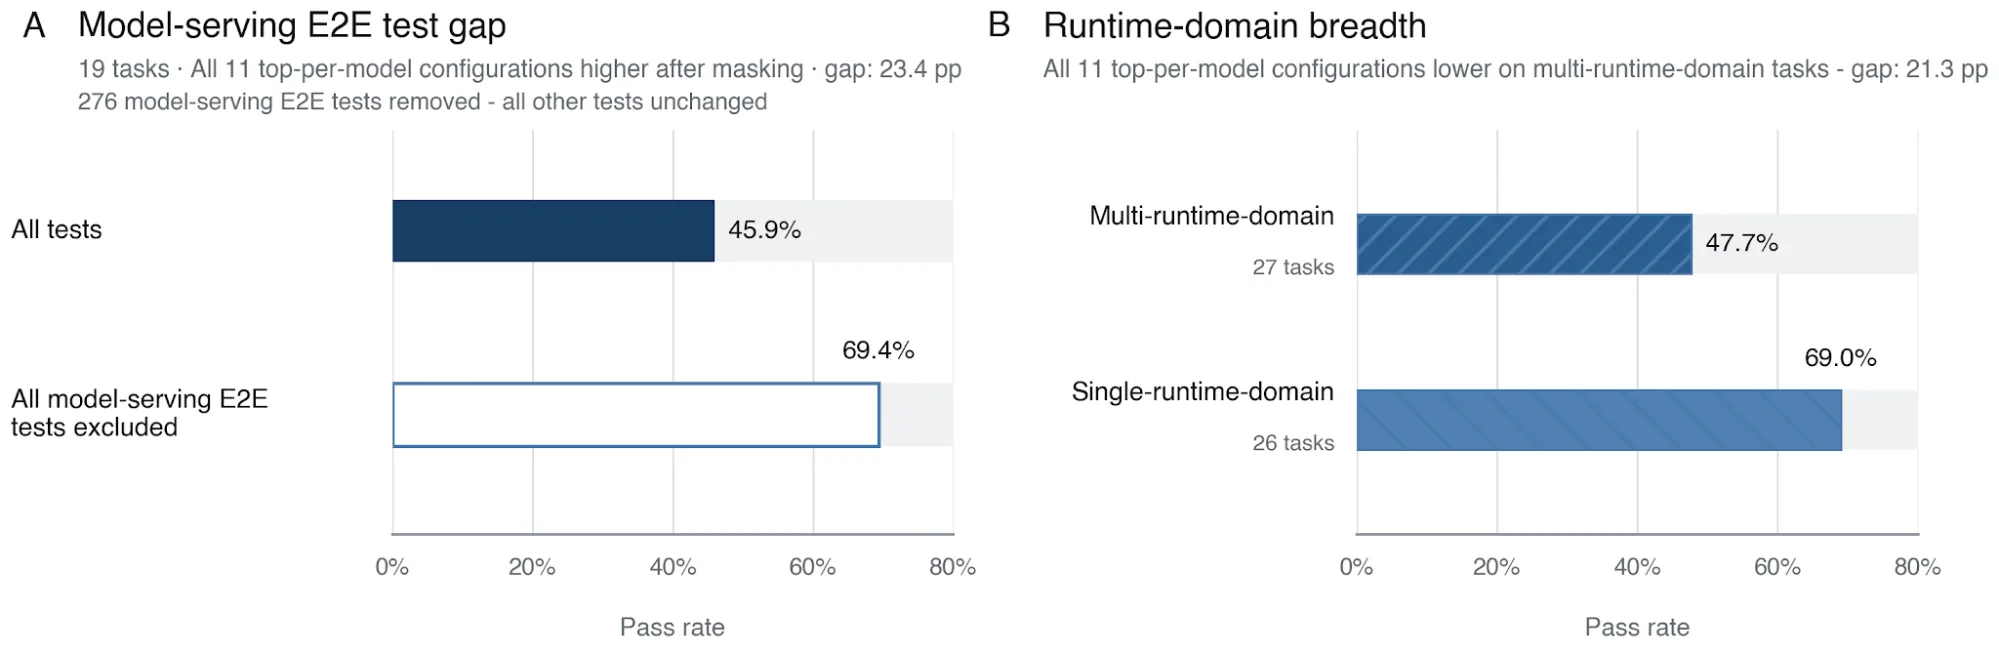
在 SGLang 团队的协助下开发的 SWE-Serve,通过对 SGLang (一个用于服务大语言模型的开源系统) 的合并更改衍生的 53 项任务来评估这一差距。在采用实时服务检查的 19 项任务中,在排除这些检查的情况下,相同的补丁通过率为 69.4%,而完整的验证器通过率仅为 45.9%。通过其他检查的大约三分之一的补丁未能通过实时服务测试。
快速链接: 阅读论文 | 浏览排行榜 | 在 GitHub 上运行 SWE-Service
哪些 SWE-Serve 测试
现有的存储库级基准测试用于评估通用软件工程任务中的编码代理,而推理基准测试通常侧重于内核生成或性能优化。相反,SWE-Serve 会在整个推理服务堆栈中测试存储库规模的更改,包括模型启用、解码、缓存、调度、提供 API 和运行时性能。
为了评估这项更广泛的工程工作,SWE-Serve 将 83 个 SGLang 合并拉取请求转换为 53 个可执行任务,涉及 6 个推理工程系列。
| 工程系列 | 任务 |
|---|---|
| 预测和高级解码 | 14 |
| 模型和后端支持 | 12 |
| 内核、量化和性能 | 8 |
| 服务 API 和运行时正确性 | 8 |
| 缓存和运行时状态 | 7 |
| 分布式执行和调度 | 4 |
12 项任务在 CPU 上运行,41 项任务使用单个 NVIDIA H100。此首个版本不评估其他推理引擎、多 GPU 执行或多节点服务。
37 项任务来自单个上游提取请求。其余 16 项合并了两到六个相关更改。该基准测试总共利用了 83 个 SGLang 合并拉取请求。SGLang 团队是 SWE-Serve 的启动合作伙伴,他们为识别具有挑战性的任务提供了想法,提出了要求特别苛刻的提取请求,并帮助我们确定了验证正确性的方法。
在更改目标之前,每个任务都会为智能体提供指令和容器化 SGLang checkout。如果代理的补丁在声明的硬件上满足任务的隐藏验证器,则该补丁会通过。我们从未将其与参考实现进行比较。
这些都是巨大的变化。中间值参考解决方案修改了七个文件中的 553 行。典型的验证器包括针对新行为的七项测试和 10 项回归测试。19 项任务可启动真实服务器,3 项任务可在 H100 上执行经过校准的性能门。
一项任务是什么
其中一项任务要求智能体为密集和混合专家 (MoE) Qwen3.5 模型添加服务支持。从不支持 Qwen3.5 的修订版开始,智能体必须在一个 H100 上同时加载 0.8 B 密集模型和 35B-A3B MoE 模型并通过正常的 SGLang 接口提供服务。
其验证器通过 MoE 模型的路由专家检查模型注册、配置和权重加载、图像和视频输入、兼容 OpenAI 的请求、原生批量生成、日志概率和执行情况。
实时服务测试的结果
只有在真实服务器启动后才会出现一些故障。SGLang 团队提出了端到端验证的想法,包括针对特定模型服务测试的建议。SWE-Serve 包含 19 项任务,这些任务可加载所需的模型,并通过实时服务接口测试智能体的补丁。
在这些任务中,相同的 627 个分块在完整验证器下通过时间为 45.9%。如果排除了实时服务测试,该比例将上升至 69.4%。换言之,在排除实时服务测试时,有 147 个补丁因未能通过而发生改变。
这 19 项任务包含 276 项实时服务测试。其中,有 242 个来自 SGLang 或改编自 SGLang。当没有合适的上游测试可用时,相应的合并更改引入的其余 34 种覆盖行为。
Gemma 4 MoE 任务使结果具体化。在 33 个补丁中,有 16 个通过了其他检查,但至少通过了一次实时服务测试。这些测试涵盖模型加载、专家路由、文本和图像服务,以及具有正确顺序和日志概率的批量生成。
SWE-Serve 通道的含义较为狭:补丁程序满足基准验证器的要求。SWE-Server 的测试并非 SGLang 的上游评审流程。它们并不确定智能体补丁或基准参考解决方案是否可部署、可随时合并或由 SGLang 维护人员认可。
其中代理得分较低
我们将请求到输出路径划分为四个运行时域:请求处理和 I/ O、调度和请求生命周期、模型执行以及 KV 缓存和运行时资源管理。
在这 11 个模型的最佳设置中,限制在一个运行时域内的 26 项任务的通过率为 69.0%。跨多个运行时域的 27 项任务的通过率为 47.7%,相差 21.3%。每个模型设置都显示相同的差异方向。
不同模型的性能差异很大
模型性能差异很大。在每个模型经过最佳测试的配置中,pass@1 的范围在 34.6% 到 75.5% 之间。没有哪种模型在每个任务类别中得分最高,而且总体得分相似的配置的成本和运行时间可能会非常不同。
我们使用 mini-swe-agent 评估了 11 个模型和 31 个模型工作配置,NV_skp_2 是一个最小的软件工程代理,在封闭式帐户条件下仅使用 Bash。我们在五个工作级别测试了两个克劳德模型和三个 GPT-5.6 模型;其他六个模型分别在一个设置下运行。
每个配置都运行了三次完整的 53 项任务基准测试。每个代理会话的上限为 210 分钟和 350 步。只有当代理的补丁通过任务声明硬件上的完整验证器时,任务才算完成。该表报告了每个模型的最高得分努力设置。
| 模型 | 推理设置 | pass@1 (均值 = SD,运行 3 次) |
平均成本/ 任务 | 平均墙面时间 |
|---|---|---|---|---|
| Claude Opus 5 | 最大值 | 75%+ 3% | $ 17.40 美元 | 57.5 分钟 |
| GPT-5.6 Sol | 最大值 | 75%+ 6% | $ 12.26 美元 | 29.5 分钟 |
| Claude Sonnet 5 | xhigh | 64%+ 3% | $ 6.61 美元 | 40.6 分钟 |
| Kimi K3 | 最大值 | 64%+ 5% | $ 7.24 美元 | 99.9 分钟 |
| GPT-5.6 Luna | 最大值 | 64%+ 4% | 0.95 美元 | 28.9 分钟 |
| GPT-5.6 Terra | 最大值 | 64%+ 4% | $ 5.06 美元 | 25.5 分钟 |
| DeepSeek V4 Flash (0731) | 最大值 | 55%+ 4% | 0.69 美元 | 36.4 分钟 |
| GLM-5.2 | 最大值 | 48%+ 2% | $ 2.10 美元 | 34.0 分钟 |
| Gemini 3.6 Flash | 高 | 48%+ 6% | $ 4.84 美元 | 37.3 分钟 |
| Laguna S 2.1 | 最大值 | 46%+ 5% | 0.33 美元 | 56.9 分钟 |
| Inkling S | xhigh | 35%+ 3% | $ 0.44 美元 | 17.6 分钟 |
原生工具并没有改善这两个领先者的表现:GPT-5.6 Sol 在 Codex 中获得 73.6% 的分数,而克劳德作品 5 版在克劳德代码中获得 69.8% 的分数,而在 mini-swe-agent 中获得 75.5% 的分数。
成本无法完全映射到性能。在这四种模型中,每项任务的平均成本介于 0.95 美元到 7.24 美元之间,而平均墙面时间介于 25.5 到 99.9 分钟之间。
没有一个模型领先于所有六个工程系列,而且总分相同的模型可能具有不同的优势。最高分表明,许多 SWE-Service 任务是当前智能体可以完成的;差异表明,性能远非统一。
我们如何验证基准
我们筛选了 786 个潜在任务源,构建了 156 个可执行候选项,并录入了 53 个。
每项获准的任务都在其声明的硬件上进行了测试。未经修改的仓库必须通过新行为测试,同时继续通过回归测试。参考补丁必须通过完整的验证器。我们还在发现具体问题时,通过智能体创建补丁、修复、缩小或排除任务来挑战验证器。
报告的评估结果已关闭。我们屏蔽公共 Web 和上游源代码库,同时允许 Hugging Face 访问模型权重,因为一个开放网络试点向模型展示了如何检索任务特定的上游代码。我们审核了排行榜背后的所有 1749 次审判;阻止了 199 次被禁止的检索尝试,但都没有成功。该论文介绍了完整的资格认证和评估完整性流程。
运行 SWE-Serve
SWE-Service 包括任务环境、验证器和基准配置。它可以测量通过本地检查与完成完整服务路径之间的差距。
探索 SWE-Service 排行榜,然后在 GitHub 上运行 SWE-Serve,以评估您的编码智能体在 SGLang 推理工程任务中的表现。


