

Kubernetes 管理节点上运行的内容。管理节点本身是一项挑战:内核设置、系统包、存储布局、安全代理以及 GPU 工作负载所依赖的主机级调优。许多团队都使用 Ansible 剧本、自定义脚本和手册来管理此任务。直到本周在不同区域出现新集群、内核升级破坏 RDMA,或者整个集群必须修复 CVE 时,这种方法才会有效。
GPU 基础架构使挑战更加艰巨。您不能简单地丢弃某个 GPU 节点而启动一个新节点。硬件稀缺,替换可能需要数小时,而且长时间运行的训练任务无法简单地重新安排。操作问题不在于如何更改节点,而在于如何在不终止训练的情况下更改所有节点。现在,答案通常是电子表格、维护窗口,以及工程师在凌晨 3 点监视终端。
NVIDIA DSX 平台可帮助您设计和运营 AI 工厂,将整个设施视为单个系统,而非机器集合。主机配置遵循相同的逻辑:更改单位是车队,而不是节点。NVIDIA DSX OS 是开源软件层,而 NodeWright 是其中的项目,用于配置和更新底层主机操作系统。
从脚本到声明性节点管理
DSX OS 通过涵盖 AI 就绪型基础、资源和工作负载编排以及生产级 AI 服务的模块化开源项目组合来应对这一挑战。AI-Ready Foundation 定义、配置、验证并确保加速 Kubernetes 基础架构。NVIDIA GPU Operator、NVIDIA Network Operator、Topograph、适用于 NVIDIA GPU 的 DRA 驱动程序、NodeWright、NVIDIA 集群就绪引擎 (NVCRE) 和 NVSentinel 提供支持的基础设施功能。
NodeWright 以声明方式配置并安全更新 Kubernetes 节点操作系统,而不会中断工作负载。它是一个开源的 Kubernetes 原生包管理器,用于大规模修改和维护主机基础设施。可以将 NodeWright 想象成整个集群的 apt 或 yum:了解工作负载、了解中断预算,并能够在整个集群中逐步推出更改。
NodeWright 以 Skyhook 的形式在 NVIDIA 的生产环境中运行,并以开源形式提供。本文正式介绍了 NodeWright 的名称。
为什么 Kubernetes 需要自己的包管理器
出色的机器配置工具已经存在。Ansible 和 Puppet 已经这样做了多年。它们专为这样的环境而设计,即单独管理机器,而不是作为主动运行敏感工作负载的集群的一部分。
当您需要跨 200 个 GPU 节点更新内核参数时,最困难的部分不是运行脚本。这样做不会中断这些节点上的训练作业。传统的配置管理无法识别 Kubernetes。它不会在进行更改之前先封锁节点,也不会等待关键 POD 完成,也不会在重启之前耗尽工作负载。它不会跟踪集群内的成功或失败,因为您的其余可观测性已经存在。
NodeWright 弥补了这一差距。它管理主机级别更改的整个生命周期,从安装到配置、升级和卸载。这样做的同时,它尊重工作负载已依赖的 Kubernetes 基元:PodDisruptionBudgets、节点选择器、污染和容限。NodeWright 包定义为自定义资源,因此它们可以像您集群中的其他一切一样进行部署:通过 kubectl、Helm、Argo CD、Flux 或您已运行的任何 GitOps 工具。
NodeWright 的工作原理
NodeWright 包含三个主要组件:Operator、自定义资源和软件包。
Operator 是一个 Kubernetes 控制器,用于监视 NodeWright 自定义资源,并管理节点更改的生命周期。软件包是带有实际修改 (脚本、配置和二进制文件) 的容器镜像。软件包还包括验证脚本,这些脚本会出现故障,并在修改不正确时停止推出。
apiVersion: nodewright.nvidia.com/v1alpha1
kind: NodeWright
metadata:
  name: gpu-node-tuning
spec:
  nodeSelectors:
    matchLabels:
      nodepool: gpu
  interruptionBudget:
    percent: 33
  podNonInterruptLabels:
    matchLabels:
      workload: long-running-training
  packages:
    nvidia-tuned:
      version: 0.9.0
      image: ghcr.io/nvidia/nodewright-packages/nvidia-tuned
应用 NodeWright 自定义资源时,Operator 会在每个目标节点上精心编排序列。图 1 显示了完整序列以及受保护的工作负载如何将其暂停。
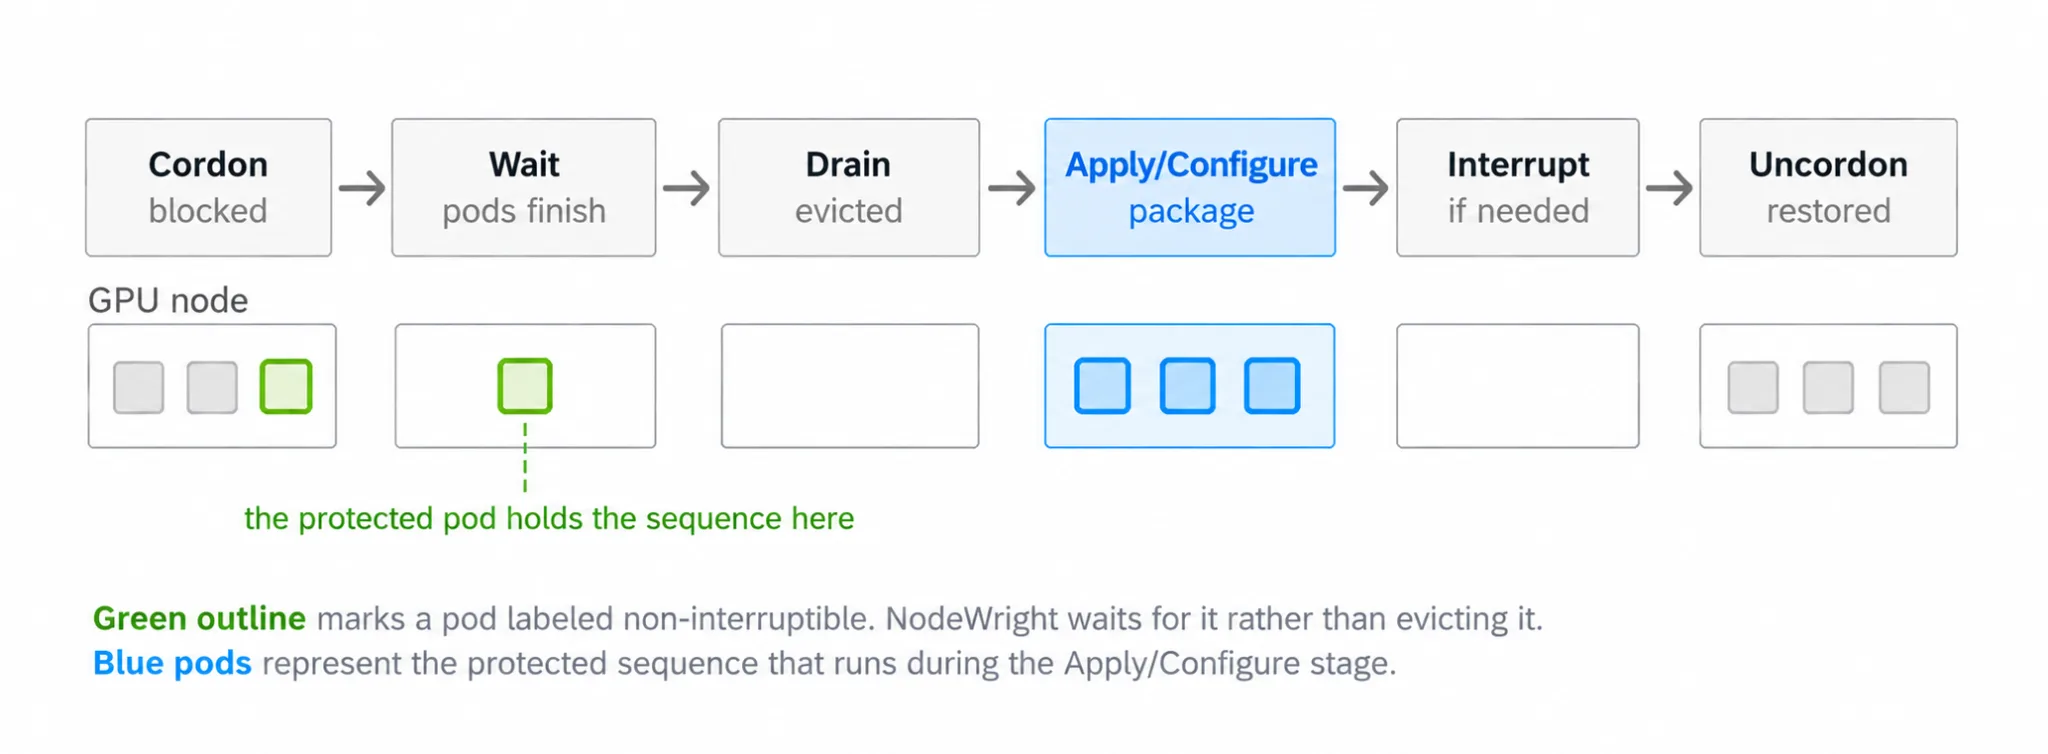
- Cordon. 将节点标记为不可调度,确保节点上不会出现新的工作负载。
- 等待. 让关键工作负载顺利完成。您可以通过标签声明不得中断的 Pod。
- 排水. 驱逐剩余的 POD,默认情况下履行 PodDisruptionBudgets,并在默认设置不足时使用可配置的漏水行为。
- 应用和配置. 运行软件包:设置内核参数、安装代理和配置系统服务。
- 中断. 如果需要更改,请重启服务或重启节点。
- Uncordon. 将节点返回集群,为工作负载做好准备。
此序列是指在内核更新中损失一半的训练运行,而在不中断工作负载的情况下在集群中实现相同的更新。
NodeWright 软件包可以执行许多主机级操作,这些操作通常需要 root 访问权限,而无需回收节点。他们可以设置 sysctl 和 GRUB 参数、配置崩溃转储文件收集、创建逻辑卷、安装安全代理、修复 CVE 以及执行其他系统级配置任务。NodeWright 会跟踪每个节点上每个软件包的状态和语义版本,以便区分新安装、升级和降级。软件包还可以声明依赖项,NodeWright 使用该依赖项来确定正确的执行顺序。
验证内置于软件包生命周期中。应用、配置、升级、卸载和中断后工作都可以与检查搭配使用,该检查通过 Kubernetes 验证预期节点状态和表面故障。例如,CVE 修复包可以检测漏洞重重的内核模块是否仍处于加载状态,并将包标记为失败,从而使操作员能够立即查看受影响的节点,而不是让他们稍后通过工作负载故障发现问题。
随着集群规模的扩大,该模型还扩展到节点就绪性。否则,在应用所需的配置和调优之前,新置备的节点可以变为可调度节点。NodeWright 可以要求新节点加入具有 Kubernetes 污点的集群,完成所需的包操作和验证检查,并仅在节点通过后消除污点。这创建了从调配到配置,再到验证再到可调度的受控路径,确保新容量在真正准备就绪之前不会接受生产工作负载。
大规模安全部署
将更改推送到一个节点非常简单。将其推送到 1000 个 GPU 节点上运行生产训练作业则是另一个问题。
NodeWright DeploymentPolicy 资源提供渐进式部署策略,可控制更改在车队中的传播方式。定义分区,这些分区是由标签选择的节点命名组,每个节点都有自己的中断预算和部署策略。图 2 显示三种可用策略。
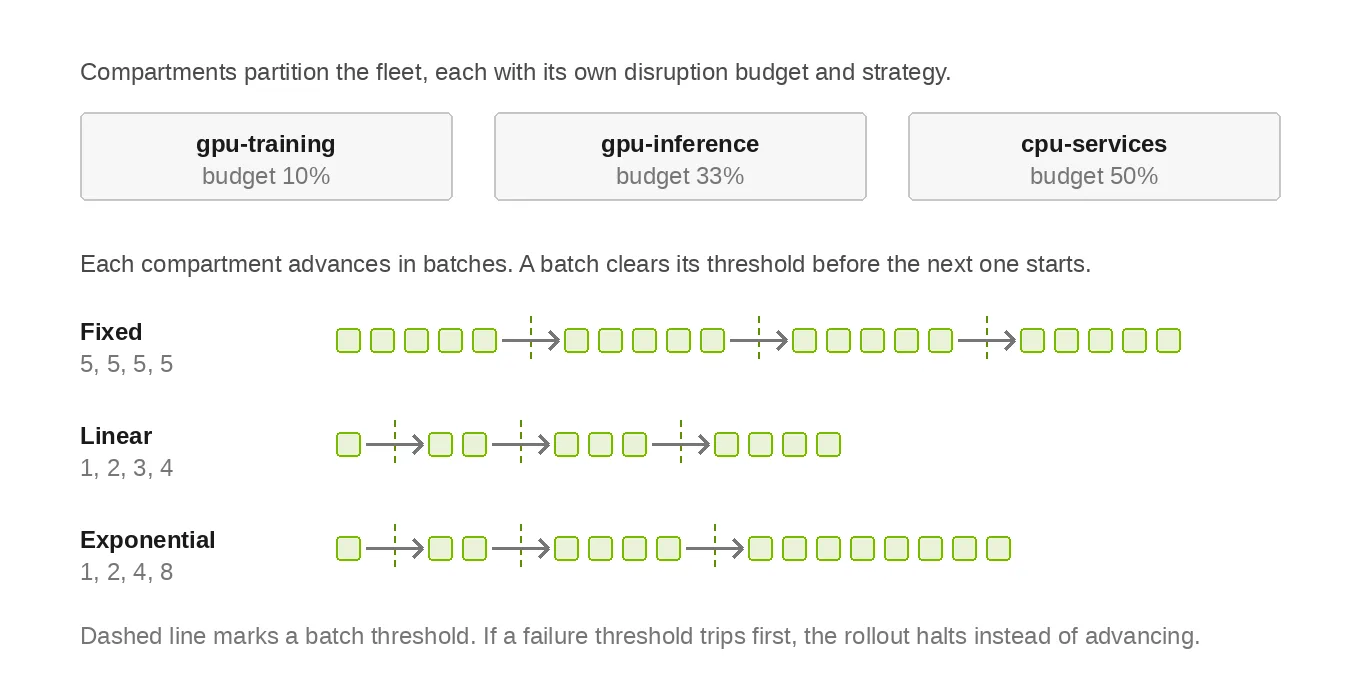
- 修复。恒定批量大小。每次更新五个节点。
- 线性。按固定增量增加批量。从 1 开始,然后是 2,然后是 3,不断增强自信。
- 指数级增长。将批量乘以生长因数。从 1 开始,然后是 2,然后是 4,然后是 8。只需您信任即可快速运行。
每个策略都包括一个批量值,这是升级到下一批之前所需的最小成功百分比。如果过多连续批量失败,可选的故障值会阻止该分区。您设置了风险承受能力。NodeWright 强制执行。
这意味着您可以使用单个金丝雀节点启动整个集群的内核更新,验证其是否正常运行,并自动加速部署。
如果出现问题,更新将停止而不是级联。NodeWright 会报告其状态错误,标记失败的作业,并为每个受影响节点添加标签和条件。您可以通过 Kubernetes API 快速识别和分类原因。
NodeWright 软件包和 NVIDIA AI 集群运行时
NodeWright 是一个多功能包管理平台。由于软件包执行的操作需要根级权限,因此主机修改直接依赖于原生 Kubernetes 基元:细粒度的 RBAC 控制用户权限,权限控制器验证规范,集成验证检查可确保每个步骤的状态一致性。公共包存储库提供模块化基础组件,用于运行 shell 命令、管理绑定挂载和建立内核崩溃转储收集器。
NVIDIA 还根据 NVIDIA 团队在大规模运行 GPU 集群时开发的操作知识 发布软件包。
调整软件包使用基于意图的模型。与其命名配置文件,不如声明加速器及其用途,例如 NVIDIA Blackwell GPU 和多节点训练。软件包会自动组合正确的配置文件:内核参数、电源管理和系统设置。覆盖范围涵盖 NVIDIA Hopper 和 Blackwell GPU,并针对任何 NVIDIA GPU 和不同云环境的变体提供通用基准配置文件。专用软件包涵盖运行容器优化操作系统的 Google Kubernetes Engine (GKE) 节点,其中常规调优堆栈不可用。
节点设置包可自动执行特定云和加速器组合的启动步骤,处理搭载 NVIDIA Hopper 或 Blackwell GPU 的 Amazon Elastic Kubernetes Service (Amazon EKS) 集群的内核版本管理和 Elastic Fabric Adapter (EFA) 驱动安装。
这些软件包是更广泛工作的一部分。NodeWright 与 NVIDIA AI 集群运行时 (AICR) 集成。AICR 可捕获驱动、运算符、内核和系统配置的已知良好组合,并将其发布为版本锁定型方案。其组件目录固定了 NodeWright Operator 和进行特定环境调优的 NodeWright 自定义项,然后将其渲染为适用于 Helm、Argo CD、Flux 或 Helmfile 的部署就绪型捆绑包。NodeWright 将这些 recipe 的主机级部分应用于正在运行的节点。
两个配套的 NVIDIA 开源项目 NVCRE 和 NVSentinel 完善了整个生态系统。NVCRE 处理预工作负载验证,以验证加速基础设施是否已就绪,而 NVSentinel 则监控运行时故障,并促进封锁、排水和补救操作。这些工具与 NodeWright 一起支持 GPU 加速的 Kubernetes 集群的调配、维护和自我修复。
范围需明确:NodeWright 不会取代 NVIDIA GPU Operator 或 NVIDIA Network Operator。它会管理其下的主机操作系统层。
开始使用
NodeWright 使用 Helm 将其安装到任何 Kubernetes 集群中。该图表作为 OCI 构件分发,因此无需添加任何资源库:
helm install nodewright oci://ghcr.io/nvidia/nodewright/charts/nodewright \
  --version <chart-version> \
  --namespace nodewright \
  --create-namespace
接下来,使用您要应用的软件包定义 NodeWright 自定义资源,按标签定位节点,然后由 Operator 处理其余工作。
- NodeWright 资源库:来源、问题和讨论
- 软件包存储库:NVIDIA 和社区软件包
- NodeWright 文档:架构、CLI 参考和部署策略
- NVIDIA AI 集群运行时:更广泛的验证配置系统
参与
NodeWright 根据 Apache 2.0 获得许可,也是 DSX OS 的一部分,DSX OS 是一个模块化开源项目组合,涵盖 AI 就绪型基础、资源和工作负载编排以及生产 AI 服务。采用一个项目、集成多个项目或将其组合成一个平台。其价值在于开放接口、独立采用和一致的生命周期,而不是单一的堆栈。
在客户规模上运行此堆栈会及早发现故障模式,NVIDIA 团队会与社区成员分享这些观察结果。对于 NodeWright 而言,软件包存储库就是其中之一。NodeWright 团队对目录尚未涵盖的硬件和云组合软件包以及运行该团队尚未确定的配置的运营商配置文件特别感兴趣。
Kubernetes 改变了团队管理工作负载的方式。底层节点 (尤其是运行要求严苛的 AI 工作负载的 GPU 节点) 仍然依赖于脚本和手动运行手册。NodeWright 将同样的声明性、自动化、安全的方法引入主机层。采用您需要的功能。帮助塑造未来。
项目参考: NodeWright 存储库 和 NodeWright 软件包存储库。
