

与以往相比,供应链问题正在扩展到更多的 SKU、通道和限制条件,而能源网络正在实时平衡更多的分布式来源。为了应对这些挑战,团队需要在实际规划窗口中评估更大的模型和更多的不确定性。
NVIDIA cuOpt GPU 加速的决策优化在单个 GPU 上的处理速度比 CPU 求解器快 10 倍以上。然而,当今的大型规划问题可能需要数小时才能收或超过单个 GPU 的显存容量。这些限制会对推动业务决策的工作流程造成瓶颈。
从历史上看,规模庞大且极具挑战性的 LP 问题一直是研究人员和从业者关注的焦点。其中一个问题是 zib03,由 Thorsten Koch 于 2008 年提出,具有超过 1.04 亿个非零值,已成为新算法和求解器的广泛研究基准。图 1 显示了使用新算法和新硬件解决此问题在该领域取得的进展。现在,cuOpt 正在使用 mPDLP 解决多个 GPU 上的问题,从而进一步突破极限,解决率比一年前提高了近 10 倍。
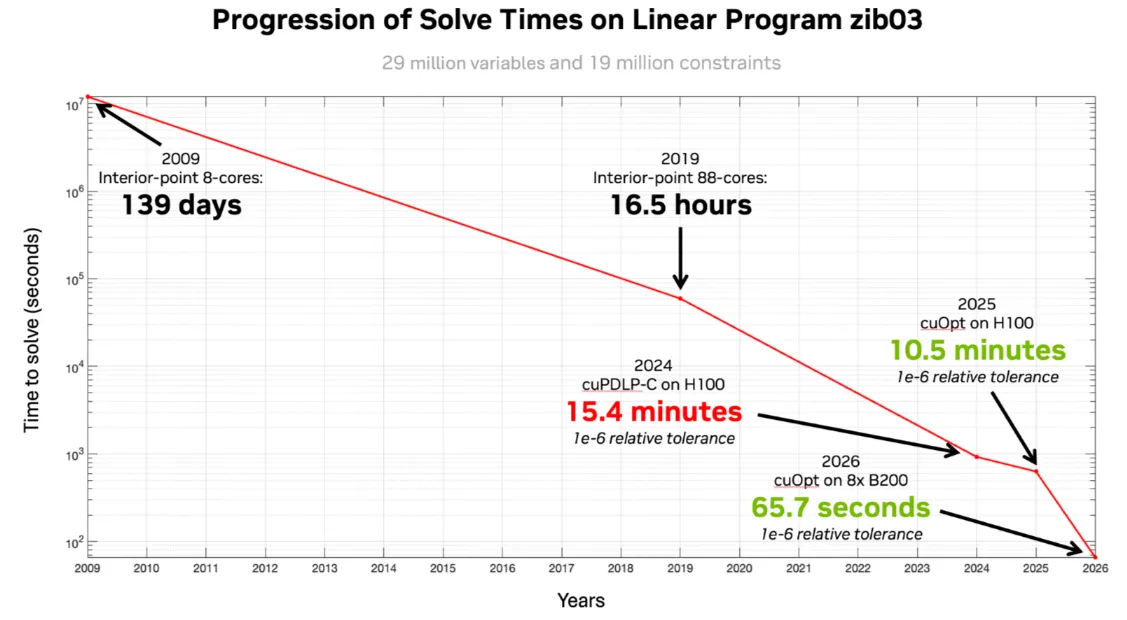
本文将介绍适用于线性规划 (NVLink) 连接的 GPU 上,实现了两个主要结果:
- 缩短在规划人员可用的时间窗口内无法解决的大型问题的解决时间
- 与单 GPU PDLP 相比,每个 GPU 的峰值显存占用率降低高达 6 倍 ( LP 问题上限为 21 亿非零)
这篇博文还通过两个合作伙伴应用强调了这种方法的优势:Kinaxis 用于全球受限的供应和生产规划,以及 PSR 用于大规模能源系统容量扩展模型。
PDLP 算法如何解决 LP 问题?
求解 LP 包括为以下方程找到 \(x\):
\begin{aligned} \min_{x} \quad & c^\top x \\ \text{s.t.} \quad & Ax = b \\ & l \leq x \leq u \end{aligned}
用于 LP (PDLP) 的 Primal-Dual 混合梯度是求解 LP 的一阶方法。它基于类似梯度下降的方法,具有高度并行性和 GPU 友好性,可实现显著的加速。
该算法的热循环是稀疏矩阵向量乘法 (SpMV),然后是几个地图运算。
此方法在两个向量上进行迭代:
- 原始解决方案 (\(x\))
- 双重解决方案 (\(y\))
LP 的约束条件被抽象化为矩阵 (\(A\)) 。这是 SpMV 循环中使用的矩阵。还有该矩阵 (\(A\)T) 的转置。
迭代算法由以下运算组成:
\begin{aligned} x^{k+1} &= \text{proj}_{[l,\, u]}\!\left(x^k – \tau(c – A^\top y^k)\right) \\ y^{k+1} &= y^k + \sigma\left(b – A(2x^{k+1} – x^k)\right) \end{aligned}
这里,和是原始步长和对偶步长,proj = [l,u] 表示对变量边界的投影 \(l ≤ x ≤ u\),\(b\) 是线性相等约束的右侧,\(c\) 是我们试图最小化的目标函数的成本向量。
此算法主要由元素级运算组成:预测和基本运算。在多个 GPU 上分布时,这些运算非常简单,因此在开发分布式算法时可以忽略这些运算。简单来说就是简单的通信步骤,算法是:
\begin{aligned} x^{k+1} &= A^\top y^k \\ y^{k+1} &= Ax^{k+1} \end{aligned}
\(y\) 的最后一个值用于计算使用 SpMV 的下一个 \(x\),\(x\) 的最后一个值用于计算使用另一个 SpMV 的下一个 \(y\)。
分发 PDLP
在 PDLP 中分配的唯一重要任务是 SpMV,这是一种受内存限制的运算。这意味着,增加可用带宽可以提高运行速度。要增加带宽,您可以选择等待下一代 NVIDIA GPU 发布,也可以选择使用更多 GPU,有效地将总可用带宽乘以 GPU 数量。但是,这会带来与分布式算法相关的成本。
在分发算法时,必须尽量减少两种主要开销:
- 通信用度:等待其他 GPU 信息所花费的时间
- 负载不平衡:GPU 之间的工作分配不均匀,导致一些 GPU 等待其他 GPU
NVIDIA 为硬件和软件堆栈提供高效分布式计算所需的通信工具。
对于硬件堆栈,NVLink 和 NVSwitch 提供计算主干。NVLink 可实现两个 GPU 之间快速、优化的数据交换,而 NVSwitch 可高效编排多个 GPU 之间的通信。
对于软件堆栈,NCCL 是一个 C/ C++ 库,可在 GPU 之间访问 GPU 直接点对点通信和集合运算 ( AllReduce、AllGather、Broadcast) 。这些操作在本地使用 NVLink 和 NVSwitch 来充分发挥其功能。
借助 NVLink、NVSwitch 和 NCCL,多个不同的 GPU 成为一台快速共享机器。数据以高带宽和低开销在设备之间移动,因此分布式算法可以在不离开 GPU 的情况下进行扩展。
2D 分区 D-PDLP
之前在多个 GPU 之间分配 PDLP 的工作包括 D-PDLP。首先,可以重新排序矩阵以改善负载平衡。然后,系统会将其行和列划分为多个子块,这些子块分布在各个 GPU 上。最后,对每个子块执行 SpMV,并对对应于同一行的结果部分输出求和,以重建最终结果,以此计算原始矩阵的 SpMV。
这意味着需要通过多个 GPU 之间的通信来构建输出向量的每个结果。这项技术效果不错,D-PDLP 用它来展示多 GPU 加速的潜力。但是,D-PDLP 中的 2D 分区会独立计算每个 SpMV,而 cuOpt mPDLP 则利用了一个事实,即连续的 SpMV 通过 \(x\) 和 \(y\) 向量共享依赖项。
最小分区 PDLP
最小分割利用在每次 PDLP 迭代中执行的两个 SpMV 之间共享的依赖关系。与独立处理 SpMV 的 2D 分区方法不同,在确定如何在 GPU 之间分配约束矩阵时,最小切分分区会同时考虑这两种运算。
关键理念是对矩阵进行划分,以便尽可能在同一 GPU 上保持输入和输出向量之间紧密连接的依赖关系。利用 \(A\) 的稀疏模式,最小化连续 SpMV 之间的通信。
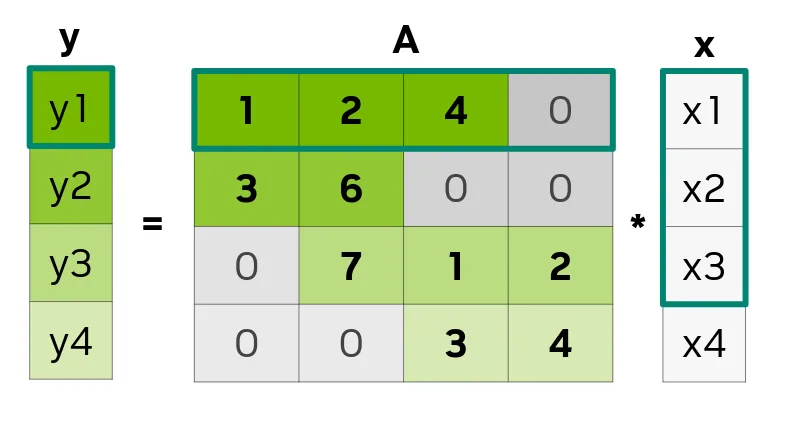
执行 \(y^{k+1} = Ax^{k+1}\) 时,底层操作如下:
\begin{aligned} y_1 &= 1x_1 + 2x_2 + 4x_3 + \textcolor{gray}{0x_4} \\ y_2 &= 3x_1 + 6x_2 + \textcolor{gray}{0x_3} + \textcolor{gray}{0x_4} \\ y_3 &= \textcolor{gray}{0x_1} + 7x_2 + 1x_3 + 2x_4 \\ y_4 &= \textcolor{gray}{0x_1} + \textcolor{gray}{0x_2} + 3x_3 + 4x_4 \end{aligned}
在计算 \(y\) 时,没有必要为 \(y\) 中的不同组件 \(y\)1、\(x\)22、\(y\)3、\(y\)4 使用完整向量 NV_ltx_20。这是由于 \(A\) 的稀疏性。执行运算以计算 \(y\)1 时:不需要 NV_ltx_ 304。对于 \(y\)2:不需要 \(x\)4 和 NV_ltx_214。图 3 的二分图对此进行了说明。
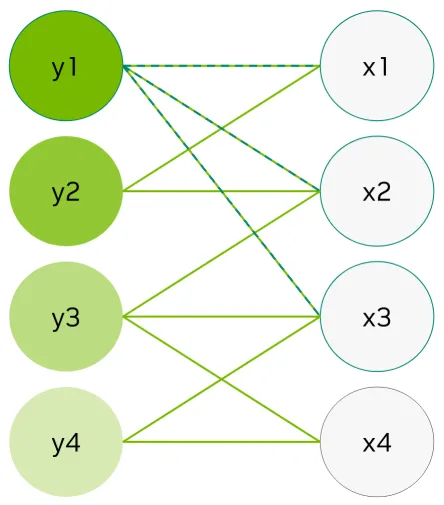
图 3 大致概述了计算每行所需的数据 (如果从右向左读取,此图还表示 AT 对 SpMV 的依赖关系) 。这也意味着,如果图形以 k – 方式进行分区,k 是 GPU 的数量,则可以在本地计算分区内的边缘,而分割到两个分区的边缘将需要与边缘关联的两个 GPU 之间进行通信。
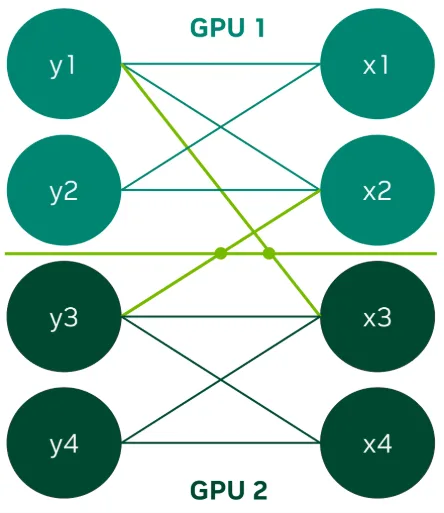
返回示例,在图 4 中,对图形进行分区,其中 GPU 1 拥有 (即负责计算) 上层组中的 \(y\)1、\(y\)2、\(x\)1、\(x\)2,而 GPU 2 拥有下层组中的其他行和列。这种分割允许在执行 SpMV 时增加局部性。在 GPU 1 上,计算 \(y\)1 时,需要来自 \(x\)1、\(x\)2 和 \(x\)3 的数据。但是,\(x\)1 和 \(x\)2 是局部的,且已在上一步中进行计算。只需从 GPU 2 (远程) 中提取 \(x\)3 即可。
沟通与边缘切割紧密相关。\(y\)1-\(x\)3 边缘在分区之间切割,这将导致计算 \(y\)1 需要额外一个通信。这意味着,根据 \(A\) 的稀疏模式,在对图形进行分区的同时减少切边次数,可能会大大减少通信需求。这正是最小裁剪分区的作用:减少边缘裁剪的图形分割。
总结如下:
- \(A\) 是表示线性程序约束的稀疏矩阵
- 首先,实现矩阵 \(A\) 定义的二分图
- 然后对图形进行 K 路分区 (适用于 k 个 GPU) ,以减少边缘切割
- 根据分区中的节点,为每个 GPU 分配一个行和列子集
- 执行 PDLP 迭代;工作主要在 GPU 本地进行,通信发生在分区中被切割的边缘
此方法高度依赖于图形中的边缘切口数量,这会导致性能变化,具体取决于矩阵 \(A\) 的稀疏模式。
基准测试结果
此处提供的基准测试结果将 mPDLP 与其他两种 PDLP 实现进行了比较:单 GPU cuOpt PDLP 和基于多 GPU 的 D-PDLP。
我们在涵盖多个数据集的 100 多个 LP 实例上运行了基准测试,包括:
- Hans Mittleman LPFeas 基准测试集
- Hans Mittleman LPFeas 大型问题附录
- PDLP 基准测试数据集
- D-PDLP 基准测试数据集
- 开放能源基准测试
- 来自 NVIDIA 行业合作伙伴的问题
对于每个实例,我们都使用目标容差 10−6,时间限制为 1 小时。分布式求解器 mPDLP 和 D-PDLP 在配备 NVIDIA DGX B200 GPU 的节点上进行评估,这些 GPU 通过 all-to-all NVLink 拓扑连接。单 GPU cuOpt PDLP 实施使用单个 B200 GPU 进行评估。
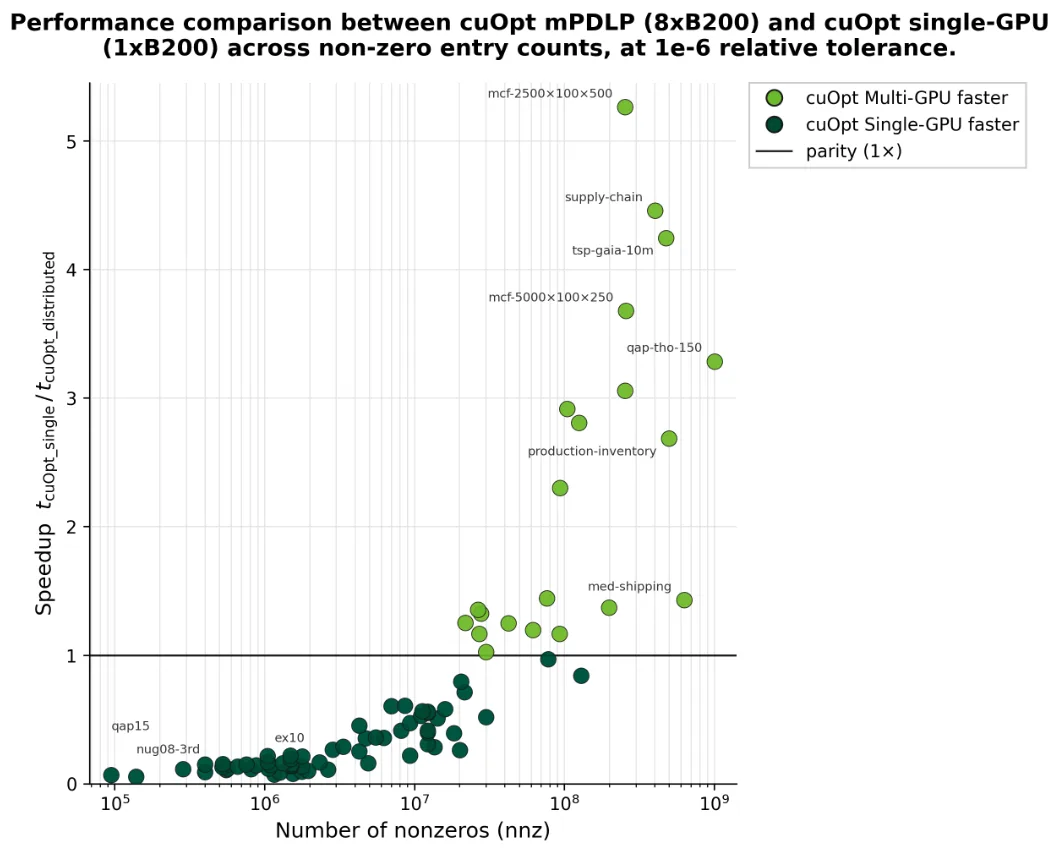
图 5 比较了 mPDLP cuOpt 和单 GPU cuOpt。结果表明,加速与问题规模密切相关。当非零条目的数量 (nnz) 超过 107 时,速度会显著提升。超过此值后,速度会随着问题规模的增加而增加,这意味着与单 GPU 版本相比,多 GPU 实施对更大问题的益处更大。
请注意,这些运行时间包括一些与迭代无关的开销:预解析、主机侧 A 转置、图形分区和后解析。只有 PDLP 步长分布在工作节点之间,因此只有它们才能从额外的 GPU 中受益。仅通过测量 PDLP 步骤的加速,mPDLP 在 tsp-gaia-10m 上的速度最高可达 11.4 倍,远高于端到端测量的 4.2 倍。
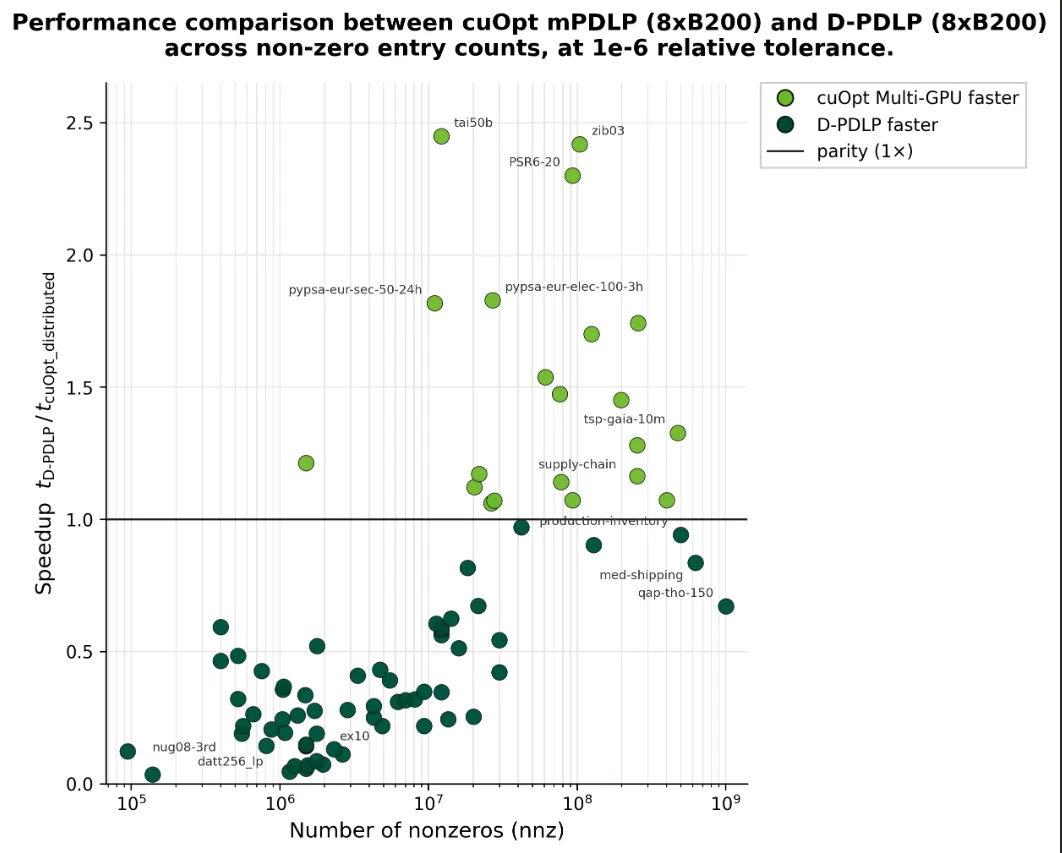
图 6 比较了 mPDLP 和 D-PDLP。同样,在小问题上观察到性能较低,而一旦非零条目数量超过 107,mPDLP 的竞争力就会变得更加激烈。在大多数大规模实例 (nnz> 107) 上,mPDLP 的速度比 D-PDLP 快 1.2 到 2.5 倍。
但是,在三个超大规模实例中,mPDLP 的速度比 D-PDLP 慢。值得注意的是,这些实例来自既定的优化基准测试,可能并不代表在调整 cuOpt mPDLP 所基于的现实问题中发现的稀疏模式。这可能会导致观察到的速度减慢,尽管超大规模实例数量较少,也很难得出一般结论。
多 GPU PDLP 仅在问题规模足够大 (与计算时间相比,通信开销可以忽略不计) 时提供加速。在较小的问题上,每次迭代中 GPU 同步和数据传输的固定成本超过了并行优势。
稀疏结构也很重要:在最小切分分区后,边缘切分比高的问题会产生大量跨 GPU 通信,从而抵消或逆转加速。
在整个优化生态系统中集成多 GPU PDLP
NVIDIA 正在与整个优化生态系统中的合作伙伴合作,将多 GPU PDLP 求解器功能引入开发者已经使用的工具和平台中。
- Kinaxis 在其 Maestro 平台上使用 NVIDIA cuOpt mPDLP,使用 8 块通过 NVLink 连接的 NVIDIA H100 GPU,将 CPG 供应链 LP 模型的速度提高了 3.3 倍,变量超过 1.35 亿。
- PSR 在具有 1.85 亿个变量的随机能量扩展 LP 模型上使用 8 个 NVLink 连接的 NVIDIA B200 GPU 上的 NVIDIA cuOpt mPDLP 实现了 5 倍以上的加速。
继续改进 cuOpt mPDLP
NVIDIA 还致力于以下 cuOpt mPDLP 改进和功能:
- 最小值分区:当前分区未考虑每个 GPU 的计算负载。权重感知型最小裁剪和超图分区将使分布具备负载感知能力,从而减少 GPU 之间的不平衡和通信开销。
- 隐藏通信:当前的 SpMV 热循环按顺序通信和计算;将矩阵拆分为本地和远程组件,将允许本地计算和远程数据传输并行运行,从而减少 GPU 空闲时间。
- 可行性优化:大规模 LP 通常需要数百万个 PDLP 步骤才能收。可行性打磨以最优性换取速度,以更少的迭代次数提供可行的解决方案,并扩展了 mPDLP 可以在实际时限内解决的问题集。
开始在 NVIDIA cuOpt 中使用 mPDLP
阅读 cuOpt mPDLP 教程,在多个 GPU 上运行您的 LP 模型。按照 Notebook 安装 cuOpt,配置求解器,并比较 GPU 数量的求解时间。从提供的示例开始,然后加载您自己的 MPS 文件,以衡量工作负载的性能。
在 NVIDIA/cuopt GitHub 资源库中探索 cuOpt 源代码,并参阅 API、求解器设置和部署指南的产品文档。
在 cuOpt GitHub 论坛上与开发者社区互动。通过订阅 NVIDIA 新闻并在 LinkedIn、 X、 Discord和 YouTube上关注 NVIDIA AI,及时了解 NVIDIA cuOpt。


