

在设计工具、图像编辑器和视觉制作工作流中部署扩散模型时,开发者必须考虑推理延迟。生成图像需要对具有数十亿参数的模型进行多次连续遍历,而更高的分辨率会增加注意力成本。
FLUX 3 Image Klein 是 Black Forest Labs (BFL) 的图像编辑和生成模型,在 NVIDIA GB200 NVL72 上进行训练,并针对 NVIDIA GPU 进行了优化。它提供了 Base 和 distilled 检查点,可满足不同的延迟和保真度要求。
本教程展示了如何在 NVIDIA TensorRT LLM VisualGen 中配置 FLUX 3 Image Klein,以利用融合内核、多 GPU 并行、FP8/ NVFP4 支持、缓存和注意力优化。它比较了各种优化的延迟和生成输出的变化。在报告的基于单个 NVIDIA B200 GPU 的 2048 至 2048 测试中,与未编译的 BF16 推理相比,FLUX 3 Image Klein Base 的组合优化可将文本生成图像 (T2I) 的速度提高 3.46 倍,将图像生成图像 (I2I) 的速度提高 4.45 倍。本教程包括部署说明和 YAML 配置,用于将这些优化应用于您的工作负载。
使用 TensorRT 进行 FLUX 3 推理 LLM VisualGen
FLUX 3 Image Klein 结合了用于文本调节的 Qwen3-VL-4B-Instruct、用于优化图像隐性的扩散转换器 (DiT) ,以及用于将隐性解码为图像并编码 I2I 参考输入的自动编码器。在通过联合注意力将文本、噪声目标图像和可选参考图像流合并之前,Klein 会独立处理这些数据流。
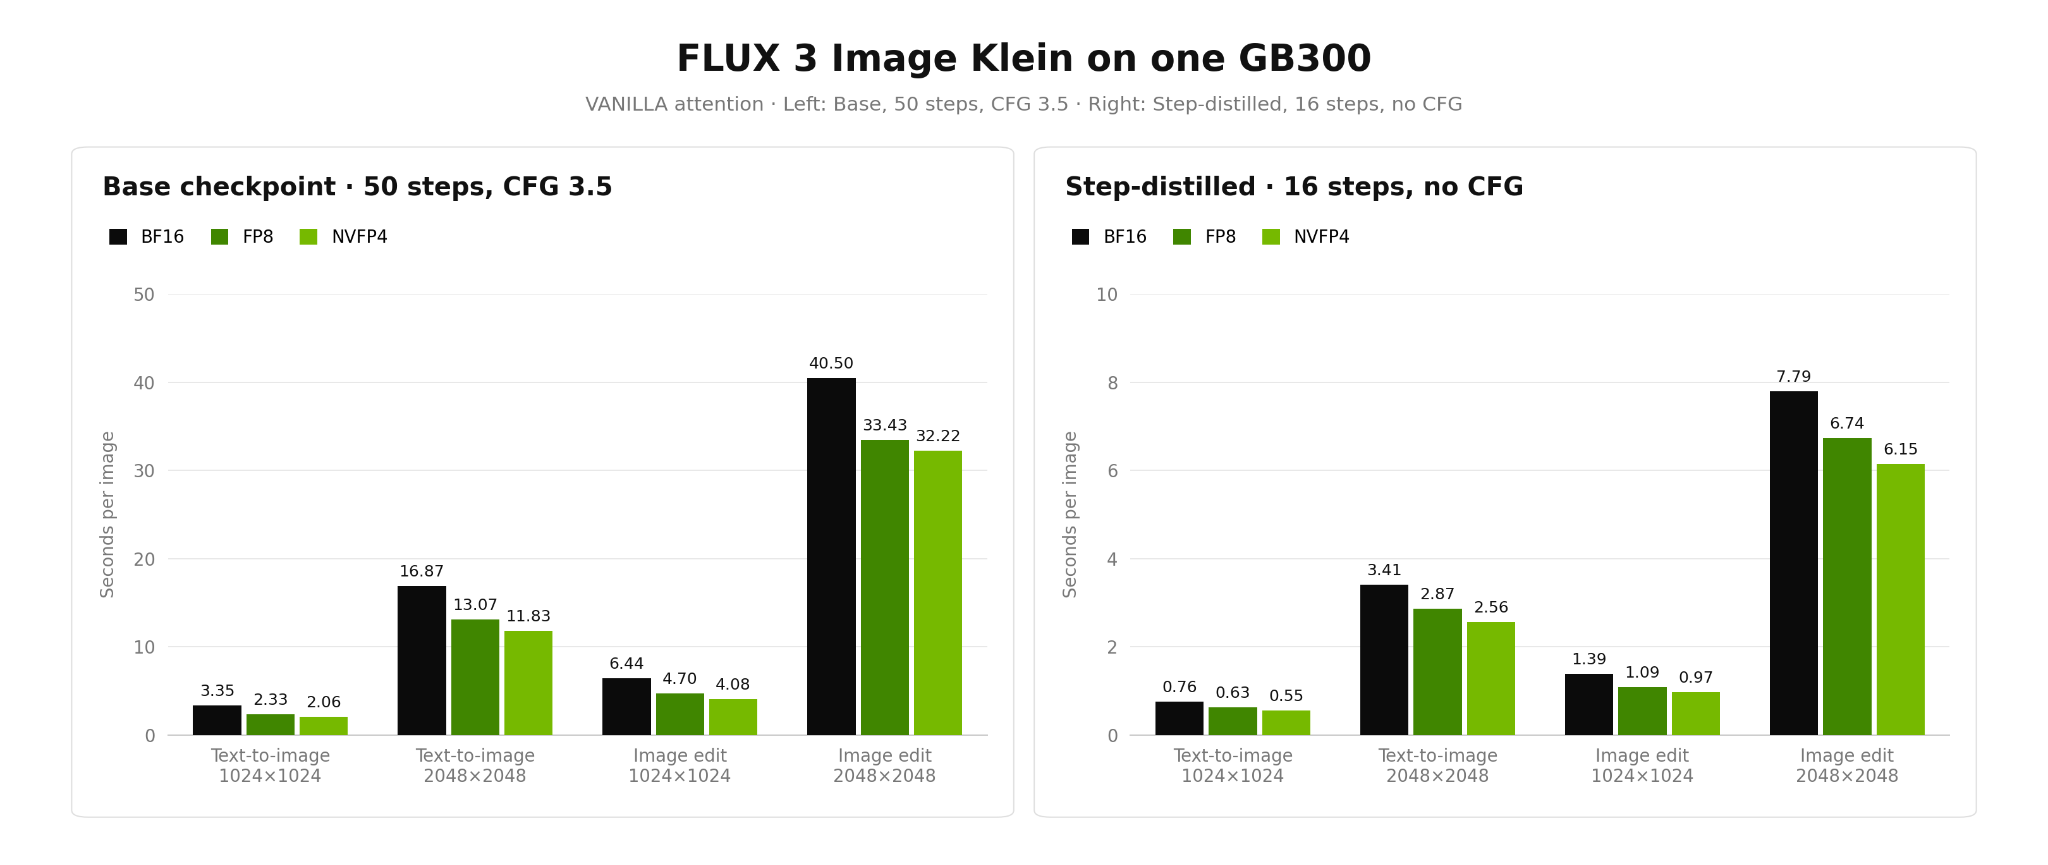
TensorRT LLM VisualGen 是 TensorRT LLM 中的专用运行时,在发布时即支持 BF16、FP8 和 NVFP4 变体。与 BF16 相比,NVFP4 在 NVIDIA Blackwell GPU 上实现了高达 1.62 倍的 T2I 速度提升和 1.58 倍的 I2I 生成速度提升。图 2 比较了生成延迟,而图 1 比较了示例输出。以下各节以 NVFP4 作为进一步优化的起点。
图 1 比较了 2048 × 2048 分辨率下的输出。摘要的 T2I 提示描述了厨房的静物;摘要的 I2I 提示请求更改太空场景,包括一个红色气体巨人、一条银龙和一块雕刻的牌。
.flux-image-comparison .wp-block-image { margin-bottom: 0 !important; }
.flux-image-comparison .wp-block-image > a { display: block; line-height: 0; }
.flux-image-comparison .wp-block-image img { display: block; margin-inline: auto; }
.flux-image-comparison .wp-block-image figcaption { text-align: center !important; margin-top: 4px !important; margin-bottom: 0 !important; line-height: 1.35; }
.flux-image-comparison .wp-block-columns { margin-bottom: 8px !important; }
.flux-image-comparison p { text-align: center !important; margin-top: 4px !important; }


图 1. 适用于 T2I 和 I2I 的 BF16 和 NVFP4 输出
以 NVFP4 为起点,VisualGen 优化转向了降噪,这在 B200 的整体生成时间中占据主导地位。因此,加速 FLUX 3 的 DiT 是以下章节的重点。
表 1 显示了使用 NVFP4、VANILLA 注意力和 torch.compile 在一个 NVIDIA B200 GPU 上 2048 × 2048 时的工作流延迟。在两次热身请求后,对超过 10 个请求的结果求平均值。Base 使用 50 个降噪步长,无分类器引导 (CFG) 标度为 3.5;蒸后的 Klein 使用 16 个步骤,而不使用 CFG。
| 任务 | 模型 | 文本+ 准备 | 降噪 | 解码+ 后处理 | 总计 | 降噪比例 |
|---|---|---|---|---|---|---|
| T2I | Base | 47 毫秒 | 14.24 秒 | 416 毫秒 | 14.70 秒 | 96.8% |
| T2I | Distilled | 24 毫秒 | 2.28 秒 | 410 毫秒 | 2.71 秒 | 84.0% |
| I2I | Base | 468 毫秒 | 39.40 秒 | 417 毫秒 | 40.29 秒 | 97.8% |
| I2I | Distilled | 407 毫秒 | 6.65 秒 | 418 毫秒 | 7.48 秒 | 89.0% |
在 TensorRT LLM VisualGen 中优化 FLUX 3
TensorRT LLM VisualGen 通过优化的通用矩阵乘法 (GEMM) 内核和结语融合、低精度和稀疏注意力、缓存以及多 GPU 执行来加速 NVFP4 DiT 推理。除非另有说明,否则以下基准测试使用 torch.compile 和种子 0。Base 使用 50 个降噪步骤,CFG 刻度为 3.5;蒸出的 Klein 使用 16 个降噪步骤。
NVFP4 推理
VisualGen 支持 BFL 针对 FLUX 3 Image Klein 和 FLUX 3 Image Klein Base 的预量化 NVFP4 DiT 检查点。要使用这些检查点,请在 pipeline_config 中将 variant 设置为 nvfp4:
pipeline_config:
  variant: nvfp4
GEMM 内核优化
TensorRT LLM VisualGen 使用 FlashInfer 的 PrimsTS FP8/NVFP4 GEMM 内核 (基于 CUTLASS 基元和任务调度构建) 来加速量化推理。它们针对 FLUX 3 张量形状进行了调整,并默认启用,将优化的 GEMM 与融合的结语相结合,包括使用 SwiGLU 的 GEMM,以及使用查询/密钥归一化和旋转位置嵌入 (RoPE) 的查询、键和值 (QKV) 预测。有关更多详情,请参阅 FlashInfer PR #5758。
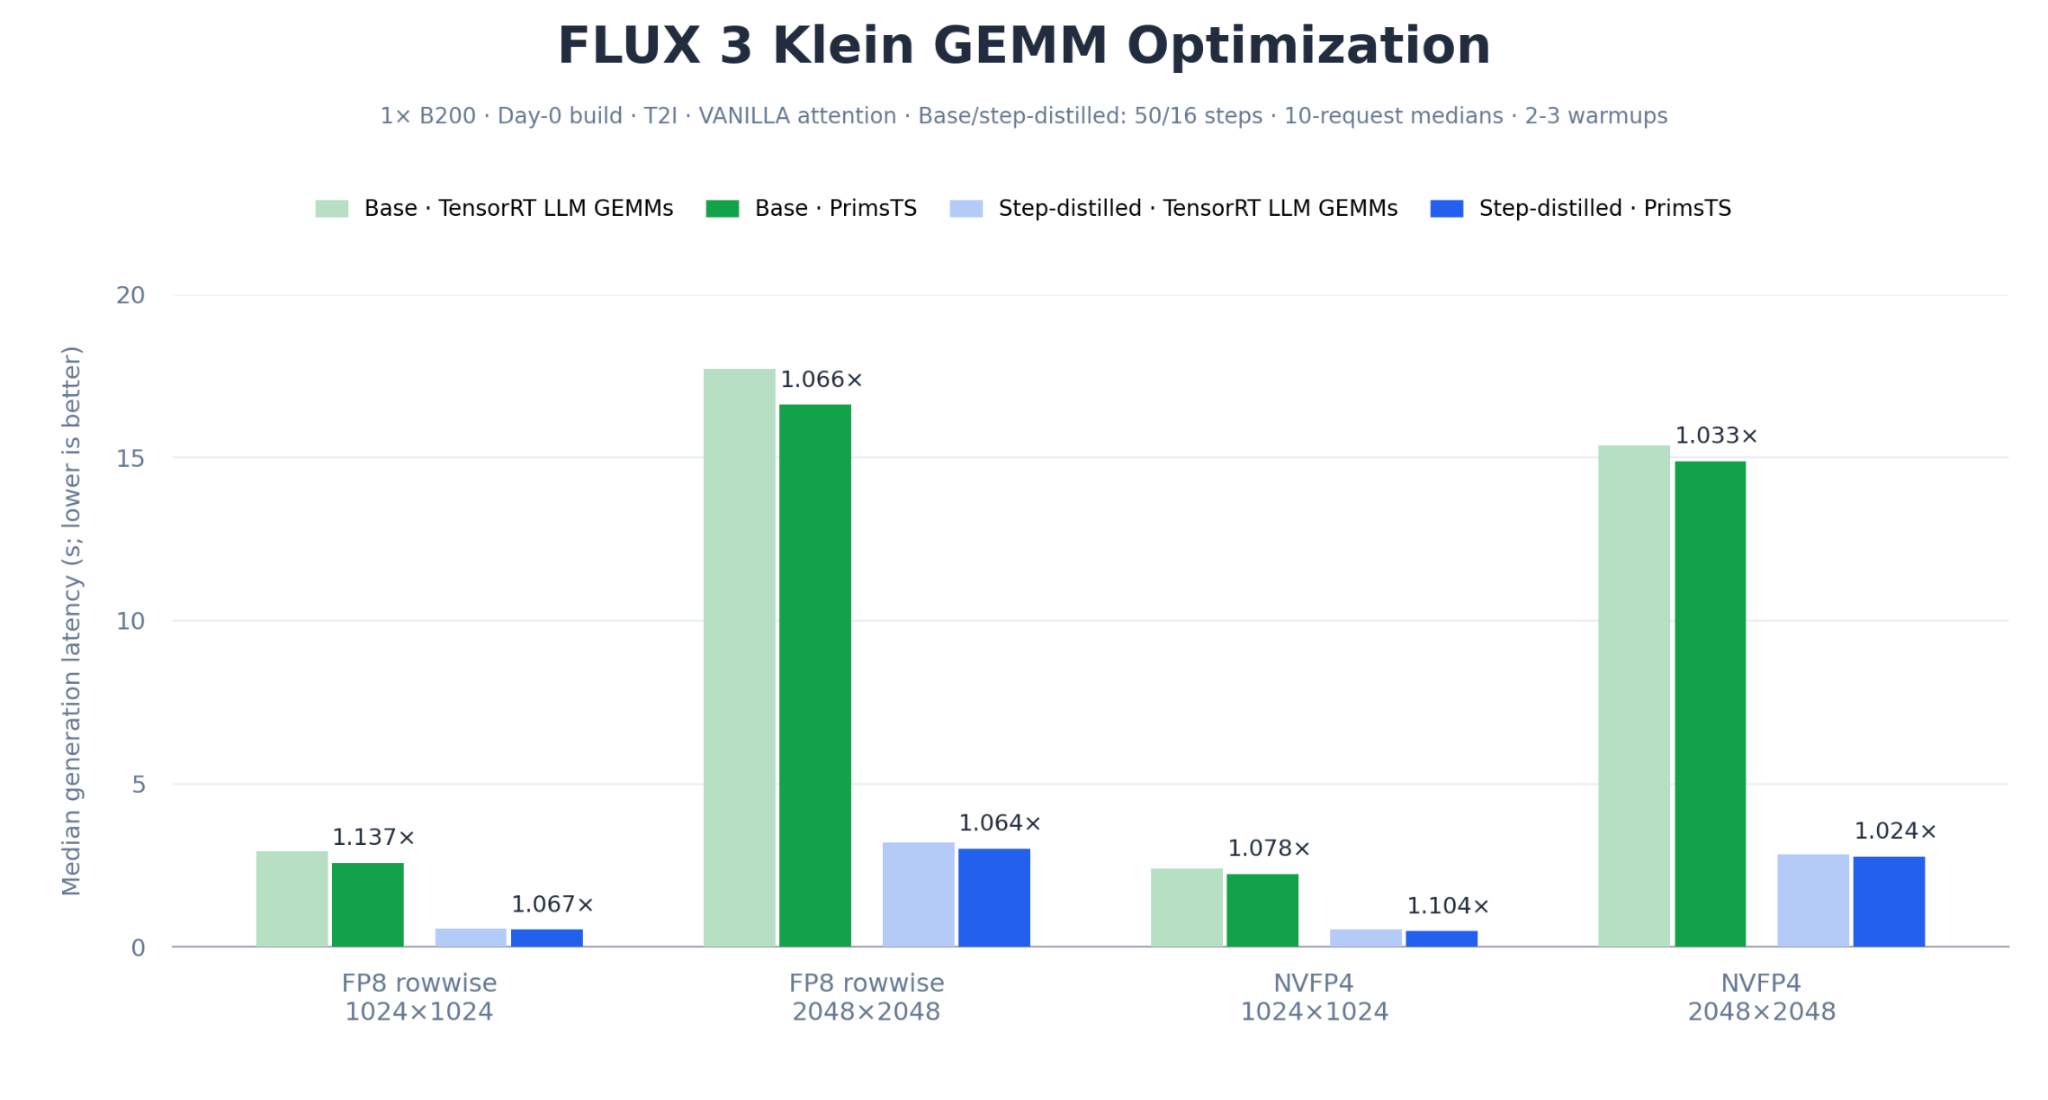
在发布时,固定的 NVFP4 PrimsTS 内核在 B200 上的 T2I 生成速度比自动调整的 TensorRT LLM NVFP4 GEMM 实现快 1.02 – 1.10 倍。
量化和稀疏注意力
注意力是生成高分辨率图像的主要瓶颈。在 B200 上报告的 2048 × 2048 NVFP4 T2I 测试中,对于 Base 和蒸 Klein,VANILLA BF16 注意力约占 DiT GPU 内核时间的 60%。VisualGen 支持两种方法来降低这种成本:一种是使用 cuDNN FP8 或 VC-Attention FP8 量化注意力,另一种是使用 Sol-Attention 稀疏注意力。VC-Attention FP8 是 VC-Attention 论文 中所述方法的 TensorRT LLM 变体。
习得的感知图像块相似度 (LPIPS) 用于测量生成图像之间的感知差异。在以下比较中,分数较低表示与相应的 VANILLA 基准输出更相似。
与关注的 VANILLA BF16 相比,cuDNN FP8 在 Base 中的生成速度提高了 1.08 倍,在 16 步蒸 Klein 中的生成速度提高了 1.09 倍。相应的 LPIPS 分数为 0.072 和 0.161。VC-Attention FP8 使 Base 的速度提高了 1.18 倍,蒸克莱因的速度提高了 1.16 倍,相应的 LPIPS 评分为 0.086 和 0.151。
图 4 比较了启用 CUDA 计算图时,FLUX 3 Image Klein Base NVFP4 在 2048 × 2048 分辨率下的输出。
这些测量结果建议在 B200 上使用 VC-Attention FP8 在 2048 × 2048 下量化注意力。所测试的配置使用低于 0.005 的修复预算来选择量化误差最高的标记部分以进行残差校正。要使用量化注意力,请将 attention_config 替换为以下配置之一:
对于 cuDNN FP8:
attention_config:
  backend: CUDNN
  quant_attention_config:
    qk_dtype: fp8
    v_dtype: fp8
对于 VC-Attention FP8:
attention_config:
    backend: TRTLLM
    quant_attention_config:
        qk_dtype: fp8
        v_dtype: fp8
        vc_attention: true
        vc_repair_budget: 0.005


图 4. BF16、cuDNN FP8 和 VC-Attention FP8 示例输出
Sol-Attention 通过稀疏性控制来减少 DiT 计算。所报告的测试使用了 TensorRT LLM 中基于 PrimTS 的通用块稀疏注意力核函数。将 Sol-Attention 配置如下:
attention_config:
  backend: TRTLLM
  sparse_attention_config:
    algorithm: sol_attn
    tau: 1.0
    disabled_until_timestep: 0.96
对于基于 B200 的 2048 × 2048 分辨率的 NVFP4 FLUX 3 Image Klein Base,与使用 16 个初始密集步骤的编译密集型 VANILLA 相比,使用 = 1.0 时,Sol-Attention 的降噪和自编码器解码速度提高了 1.24 倍,使用 12 步时提高了 1.30 倍。
这些测量结果建议使用 16 个初始密集步骤来确定保真度的优先顺序,或使用 12 个初始密集步骤来确定速度的优先顺序。更高的输出质量 = 降低的输出质量,而额外的加速很少。
图 5 比较了启用 CUDA 计算图时 2048 × 2048 分辨率下的 NVFP4 FLUX 3 Image Klein 基本输出,以及 = 1.0 分辨率下的输出。


图 5. 密集注意力和 Sol-Attention 输出,包含 16 或 12 个初始密集步骤
步骤缓存
Cache-DiT 通过在降噪步骤中重复使用中间 Transformer 输出来减少 FLUX 3 Image Klein 的推理延迟,而无需重新训练或修改模型权重。残差差值控制着何时重复使用缓存输出,因此您可以调整推理速度和输出质量之间的平衡。使用所需参数配置 Cache-DiT:
cache_config:
  cache_backend: cache_dit
  Fn_compute_blocks: 1
  Bn_compute_blocks: 0
  max_warmup_steps: 4
  max_continuous_cached_steps: 3
  residual_diff_threshold: 0.24
当值为 0.24 时,Cache-DiT 在两种测试分辨率下将 NVFP4 Base T2I 延迟几乎减半,而蒸 Klein 的延迟增益较小。在 1024 × 1024 分辨率下,Base 的速度提高了 1.97 倍,蒸克莱因的速度提高了 1.26 倍,相对于未缓存的输出,LPIPS 的得分分别为 0.038 和 0.036。在 2048 × 2048 下,Base 的速度提高了 1.94 倍,蒸克莱因的速度提高了 1.20 倍 (图 6) 。


图 6. 使用和不使用 Cache-DiT 的基础和蒸 Klein 输出
多 GPU 推理
TensorRT LLM 中的 VisualGen 运行时使用无分类器引导 (CFG) 和 Ulysses 序列并行来扩展 FLUX 3 Image Klein。Base 将正/ 负分支分配给单独的 GPU 组,并使用 Ulysses 对每个分支的序列进行分区;蒸运行时不使用 CFG,仅使用 Ulysses。
VisualGen 可处理序列分割、分布式注意力和输出收集。对于 8 – GPU NVFP4 基本推理,请使用以下配置:
parallel_config:
    cfg_size: 2
    ulysses_size: 4
对于蒸模型,请设置 cfg_size: 1、ulysses_size: 8,然后使用 flux-3-image-klein 检查点。
在 2048 × 2048 分辨率下,在 NVIDIA DGX B200 上从 1 个 GPU 扩展到 8 个 GPU 后,Base 的平均 T2I 延迟从 14.90 秒降低到 3.00 秒,蒸时从 2.73 秒降低到 1.08 秒。降噪速度提升幅度更大,Base 为 6.01 倍,蒸 Klein 为 4.44 倍,但在 8 个 GPU 的蒸生成时间中,约有一半时间未进行降噪,限制了端到端收益。
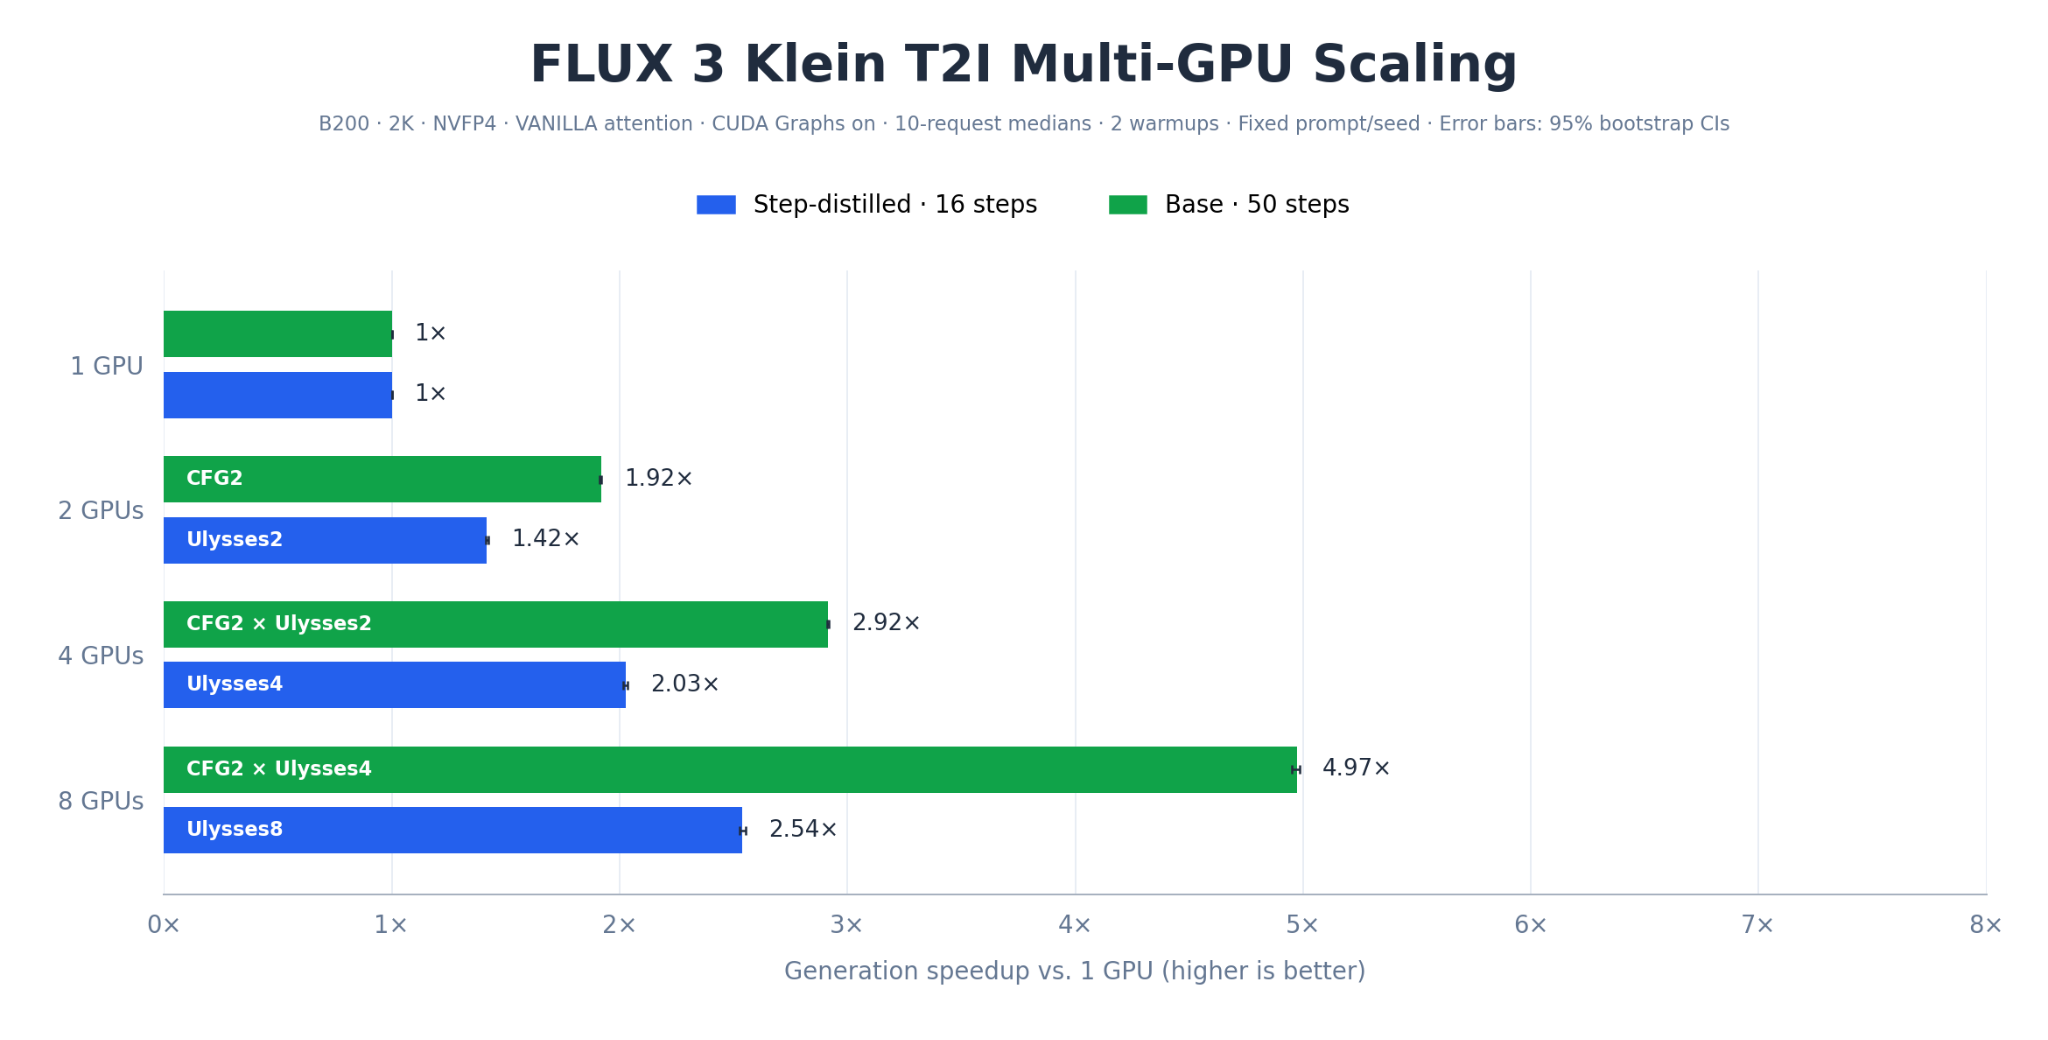
在较小的分辨率下,随着每个 GPU 的工作量减少,CUDA 计算图通过减少内核启动用度来补充并行性。在针对 8 个 B200 的 1024 × 1024 NVFP4 实验中,添加 CUDA 计算图进行编译,将基础延迟从 1.823 秒降低到 0.809 秒 (两个 GPU 组的 CFG 为 2.25 倍,每组 4 个 GPU 为 Ulysses) ,蒸延迟从 0.791 秒降低到 0.366 秒 ( 8 个 GPU 为 2.16 倍,Ulysses) 。使用以下配置启用 CUDA 计算图:
cuda_graph_config:
    enable: true
FLUX 3 端到端性能
在 2048 × 2048 下,图 8 将连续 TensorRT LLM VisualGen 优化阶段的端到端生成加速与未编译的 BF16 VANILLA 推理进行了比较。
在单个 B200、编译、搭载 PrimsTS GEMM、Sol-Attention 和 Cache-DiT 的 NVFP4 上,T2I 的速度提高了 3.46 倍,延迟从 22.36 秒缩短到 6.46 秒,I2I 的速度提高了 4.45 倍,延迟从 54.64 秒缩短到 12.28 秒。16 步蒸 Klein 实现了高达 2.34 倍的端到端加速。
在单个 NVIDIA RTX PRO Blackwell Server Edition GPU 上,编译、融合 CuTe DSL 内核的 NVFP4 和 Cache-DiT 可实现 1.73-3.25 倍的代际加速,使这两个平台的性能得到进一步提升。图 9 和 10 比较了各个优化阶段的示例输出。
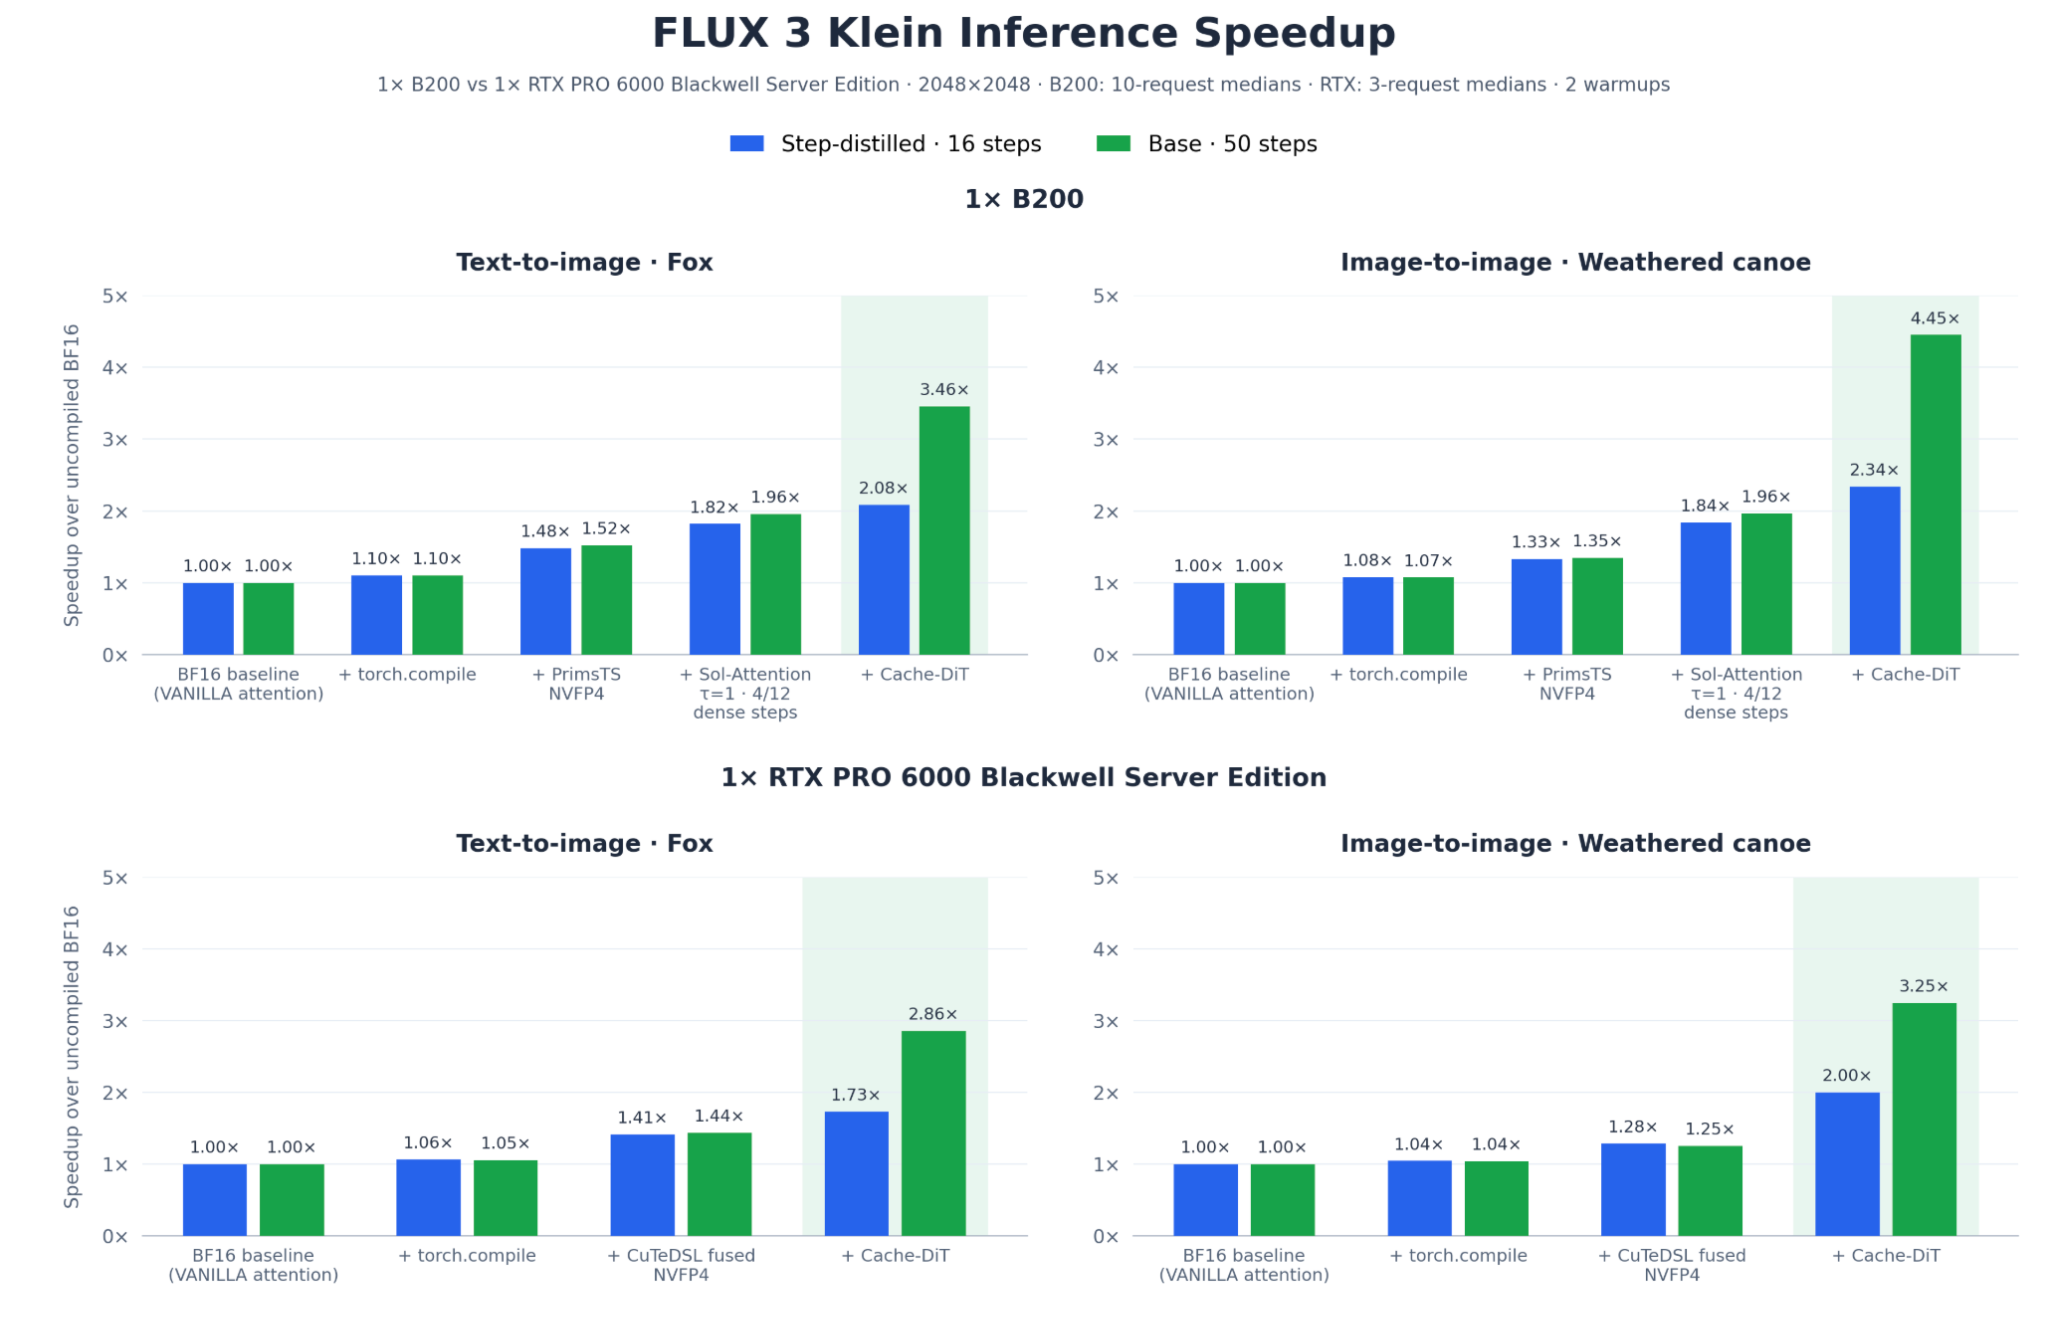
图 9 和 10 中的示例在单个 B200 GPU 上生成。


图 9. FLUX 3 图像 Klein Base T2I 在各个优化阶段的输出
编辑提示要求独木舟保持风化外观,同时保留其形状、位置和周围场景。


图 10. FLUX 3 图像 Klein Base I2I 在各个优化阶段的输出
要将这些优化应用于您自己的工作负载,请按照以下部分中的运行时设置、推理命令和 YAML 配置进行离线生成或在线服务。
预备知识
使用以下命令启动预构建的 TensorRT LLM 容器。要从 feat/flux3-image-klein 分支构建它,请按照 FLUX 3 部署指南进行操作。
docker run --rm -it --ipc=host --gpus all -p 8000:8000 \
      --name tensorrt_llm \
      -e TLLM_FMHA_LIBS=+prims_ts \
      -e HF_TOKEN=<your_hf_token> \
      -v ~/.cache:/root/.cache:rw \
      nvcr.io/nvidia/tensorrt-llm/release:feat-flux3-image-klein-1.4.0a0.dev202610280436
TLLM_FMHA_LIBS=+prims_ts 启用 VC-Attention 内核所需的 PrimsTS 注意力。本文中的优化和结果重点介绍了 NVIDIA Blackwell 数据中心 GPU 和 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU。
开始使用 TensorRT LLM VisualGen
运行时环境准备就绪后,您可以离线运行 FLUX 3 或通过图像生成端点提供服务。使用以下部分中的示例 YAML 配置,应用之前报告的结果所使用的优化设置。
这些示例不会展开提示词。如果您使用 BFL 的 prompt upsampler,请在推理之前单独运行它。报告的延迟排除了提示上采样。
离线推理
在容器内运行 FLUX 3 示例:
cd /app/tensorrt_llm/examples/visual_gen
python models/flux3.py \
  --model black-forest-labs/flux-3-image-klein-base \
  --visual_gen_args configs/flux3-images-1gpu.yaml \
  --prompt "A small robot tending a rooftop garden at sunrise" \
  --height 2048 --width 2048 --seed 0 \
  --output_path flux3.png
对于 Blackwell 上的 NVFP4,添加 --variant nvfp4;对 FP8 行使用 --variant fp8r,或对 BF16 省略 --variant。选择 black-forest-labs/flux-3-image-klein 作为蒸模型。对于编辑,添加编辑提示和 --image /path/to/reference.png;重复 --image 进行多次引用。
在线服务端点
从同一容器目录,启动兼容 OpenAI 的 /v1/images/generations 端点:
cd /app/tensorrt_llm/examples/visual_gen
trtllm-serve black-forest-labs/flux-3-image-klein-base \
  --host 0.0.0.0 --port 8000 \
  --visual_gen_args configs/flux3-images-1gpu.yaml
服务器准备就绪后,打开第二个终端,进入正在运行的容器,然后运行客户端:
docker exec -it tensorrt_llm bash
python examples/visual_gen/serve/sync_image_gen.py \
  --base-url http://localhost:8000/v1 \
  --model black-forest-labs/flux-3-image-klein-base \
  --size 2048x2048 \
  --prompt "A small robot tending a rooftop garden at sunrise" \
  --output flux3-served.png
对于 NVFP4 服务,请在启动服务器之前将 pipeline_config: {variant: nvfp4} 添加到 YAML;对于 FP8,请使用 fp8r。
优化的单 GPU 部署
对于一个 B200 上的 2048 × 2048 推理,请将以下内容另存为 configs/flux3-nvfp4-vc-fp8-1gpu.yaml,后者结合了 NVFP4 权重、torch.compile 和 VC-Attention FP8。
pipeline_config:
  variant: nvfp4
torch_compile_config:
  enable: true
compilation_config:
  resolutions: [[2048, 2048]]
  num_frames: [1]
  modes: [t2i, i2i]
attention_config:
  backend: TRTLLM
  quant_attention_config:
    qk_dtype: fp8
    v_dtype: fp8
    vc_attention: true
    vc_repair_budget: 0.005
对于 Sol-Attention 和 Cache-DiT,将此文件复制到 flux3-nvfp4-sol-cache-1gpu.yaml,替换 attention_config,然后添加 cache_config:
pipeline_config:
  variant: nvfp4
torch_compile_config:
  enable: true
compilation_config:
  resolutions: [[2048, 2048]]
  num_frames: [1]
  modes: [t2i, i2i]
attention_config:
  backend: TRTLLM
  sparse_attention_config:
    algorithm: sol_attn
    tau: 1.0
    disabled_until_timestep: 0.96
cache_config:
  cache_backend: cache_dit
  Fn_compute_blocks: 1
  Bn_compute_blocks: 0
  max_warmup_steps: 4
  max_continuous_cached_steps: 3
  residual_diff_threshold: 0.24
时间步长截止值为 0.96,对于 50 步 FLUX 3 Image Klein Base,前 12 步保持密集降噪,对于封装后的 < = 6.93 时间表下的 16 步蒸 Klein,前 4 步保持密集降噪。对于上述推荐的 16 步密集设置,请设置 disabled_until_timestep: 0.94。截止值用于指定噪声级别,而非步长数。删除 cache_config,使用无 Cache-DiT 的 Sol-Attention。
将离线推理或服务命令中的 --visual_gen_args 设置为所选 YAML 文件的路径。将图像大小设置为 2048 × 2048 以匹配性能示例。
结论和后续步骤
TensorRT LLM VisualGen 通过可配置的性能优化支持 FLUX 3 Image Klein 推理。NVFP4、融合内核、编译、多 GPU 执行和 CUDA 计算图可加速执行;量化和稀疏注意力与缓存可进一步降低延迟,并对输出质量产生可衡量的影响。与未编译的 BF16 VANILLA 推理相比,在 NVIDIA DGX B200 上使用单个 GPU,T2I 和 I2I 生成速度分别提高了 3.46 倍和 4.45 倍。
开始使用:
- 运行端到端 FLUX 3 示例
- 探索 TensorRT LLM VisualGen 运行时和优化实用程序
- 在 TensorRT LLM GitHub 上提交问题或分享结果
致谢
Nikita Kerobov、Harrison Zhang、Pamela Peng、Kanghwan Jang、Yuhang He 和 Charlotte Mallo


