

越来越多的天气敏感型行业可以获得观测结果,从而更早、更局部地了解不断变化的天气状况。能源公司收集风能和太阳能资产的测量数据,应急管理团队依靠雷达和本地传感器,而卫星提供商则不断观察地球。这些数据有助于企业组织了解和管理跨行业 (如资本市场、保险、农业和物流) 的物理风险。
借助 NVIDIA Earth-2 中的 AI 数据同化工具,您可以更高效地处理这些观察结果。通过整合专有或第三方数据,您可以使用这些工具更频繁地发布预测,根据实时条件调整估算,并根据特定区域和应用程序定制预测流程。
本教程涵盖两项技巧:
- 使用点观测限制扩散模型,通常用于区域模型。
- 将不同的数据集同化为一致状态,通常用于全局模型。
预备知识
在本教程中,您需要:
- 已安装 Earth2Studio 的开发环境
- NVIDIA RTX PRO 或数据中心 GPU
- Python 基础知识
- 约 30 分钟
通过观测改进区域预测
您可以运行区域天气预报管道来管理能源生产和需求,从风能和太阳能公园、传输走廊或人口密集地区提取观测结果。借助 AI 数据同化,您可以使用这些观察结果在局部准确性最重要的地方限制预测,从而帮助您改进运营决策。利用来自生产现场、活动场地、物流网络或其他当地条件直接驱动决策的资产的观察,相同的技术可以为其他行业提供支持。
您可以使用基于评分的数据同化 (SDA) 将观测结果整合到基于扩散的 AI 降尺度和预测模型中,例如 CorrDiff 和 StormCast。SDA 可引导模型做出与您的观察结果一致的预测,而无需重新训练模型。
下面的图 1 显示了该流程的基本运作方式。扩散模型通过一系列降噪步骤生成高分辨率预测。在每个步骤中,SDA 会将中间预测与您的观察结果进行比较,并将模型推向正确的方向。SDA 的输出是概率性的,观测位置附近的不确定性较小,并且传播得更远,在这种情况下,预测越来越受其他模型输入和底层 AI 模拟的控制。
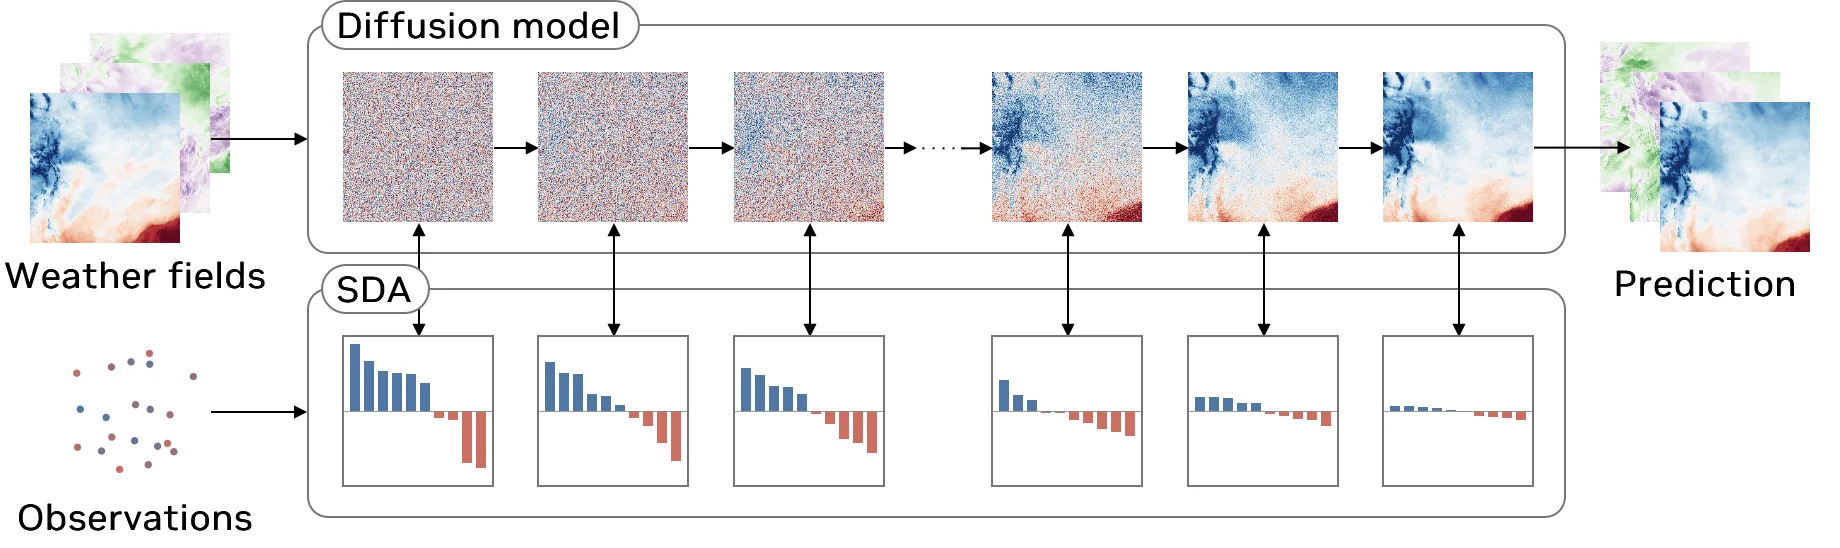
为了推动模型,您需要定义一个观察运算符,该运算符将模型输出映射到您期望在每个测量位置观察到的数量。对于物理量 (如温度或风速) 的现场测量而言,这一点尤为直接。在本例中,最简单的运算符形式是将附近的网格值插入到每个观察位置。还可以创建用于代理测量或观察到的影响的运算符。例如,风力涡轮机的输出功率可以作为风速的代理测量值。
SDA 解锁了两项主要功能:
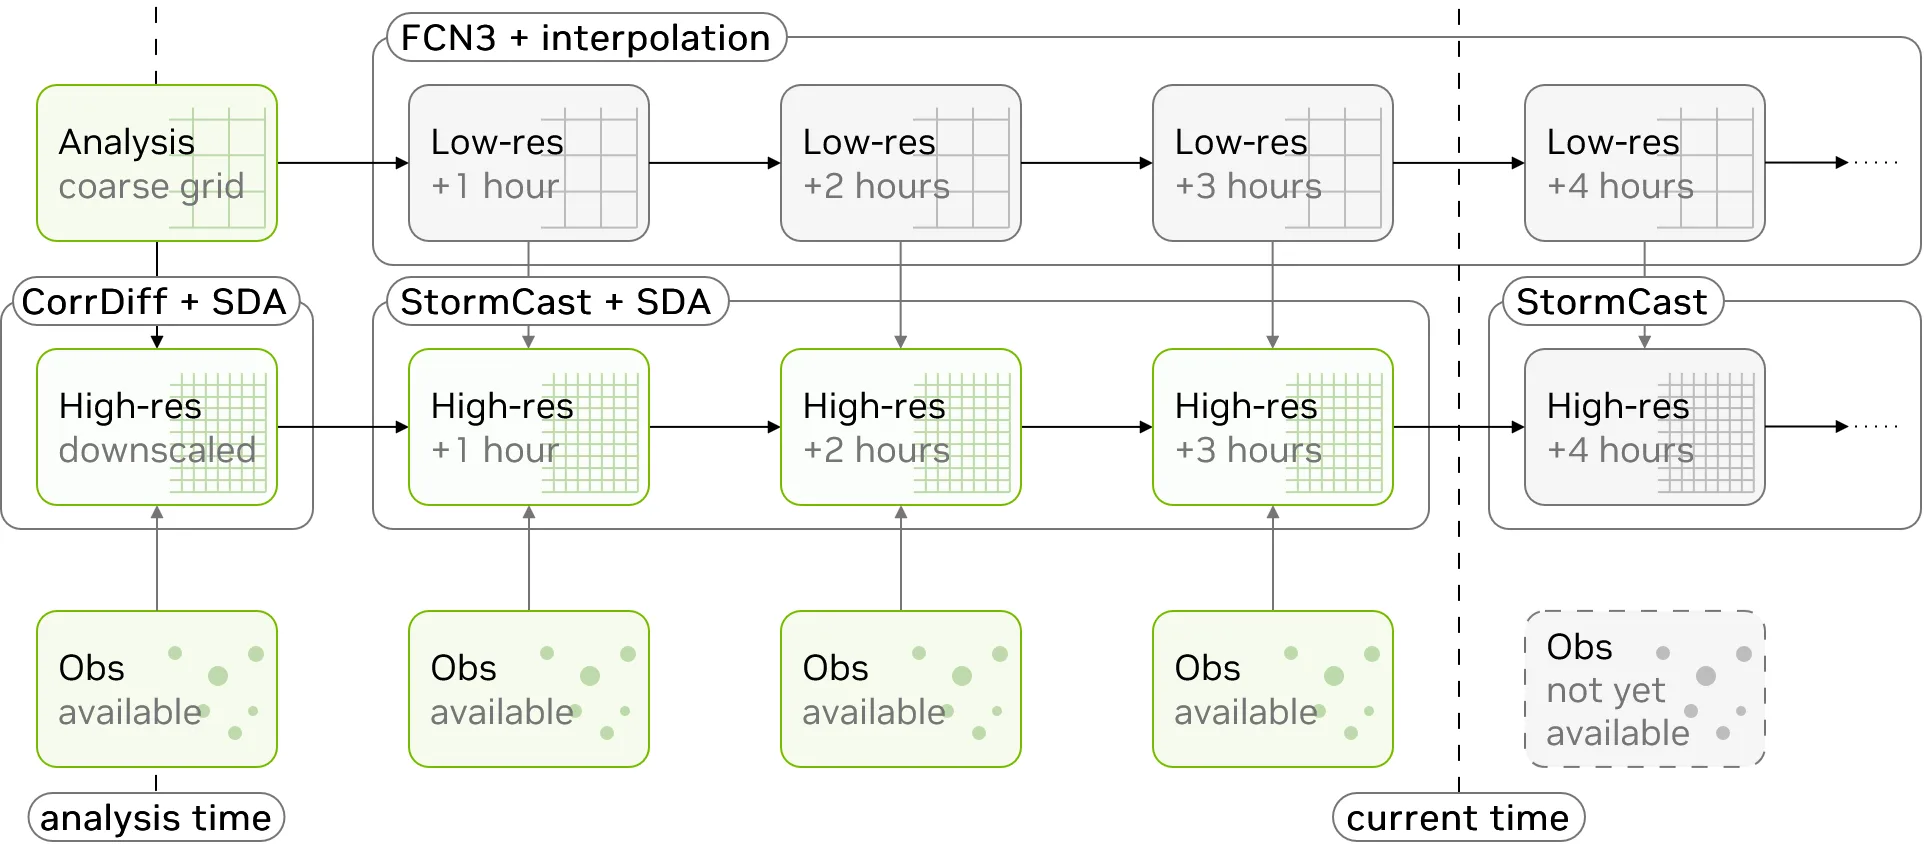
- 更快地更新预测。数值分析需要大量的处理时间,并按照固定的时间表发布。借助 SDA,您可以不断整合观察结果。下面的图 2 展示了按一小时间隔进行管道预测的具体示例,该预测依赖于具有六小时发布计划的全球分析。
- 整合专有、区域或特定领域的观察结果。数值分析基于广泛的观察结果。SDA 允许您整合来自自己来源的数据,以便将预测重点放在特定资产位置或下游应用程序上。
SDA 的有效性取决于几个因素:您的观察结果的数量、空间分布和准确性;您预测的领域的特征长度尺度;以及观察运算符的质量和良好姿态。
如何在 Earth2Studio 中运行 CorrDiff-SDA
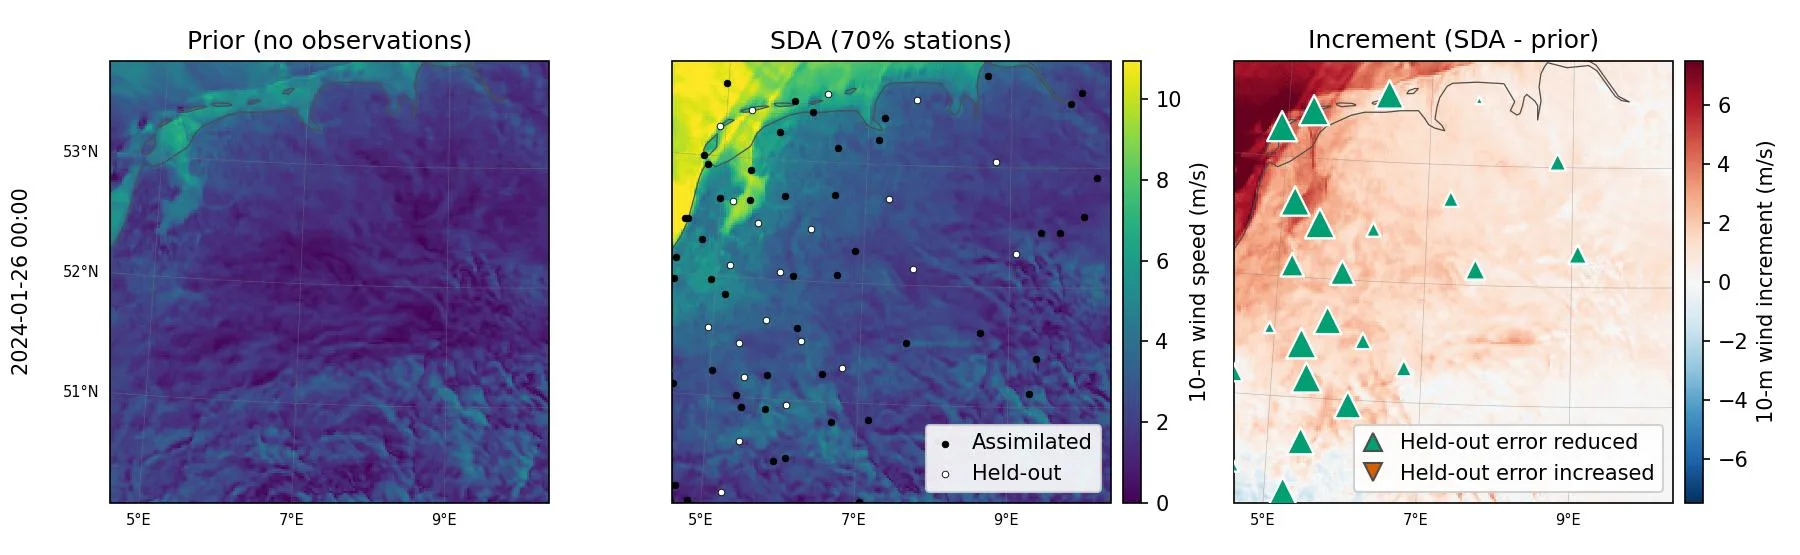
CorrDiff 是一种基于 AI 的降尺度技术。Earth2Studio 提供了一个在欧洲预训练的 CorrDiff 模型,可将 0.25% 的天气场转化为 2.2 公里的预测。借助 AI 数据同化,您可以在局部准确性至关重要的情况下通过观察改进这些预测。借助经过优化的输出,您可以初始化区域预测或创建再分析数据集,用于校准下游模型。
首先加载预训练模型。我们将该域名限制在荷兰和德国西北部的一部分,并选择吸收 10 米的风速。
from datetime import datetime
from earth2studio.data import GHCNHourly
from earth2studio.models.da import CorrDiffCosmoEra5SDA

domain = dict(lat_min=50.2, lat_max=53.8, lon_min=4.6, lon_max=10.4)
sda = CorrDiffCosmoEra5SDA.load_model(
    CorrDiffCosmoEra5SDA.load_default_package(),
    assimilate_variables=("u10m", "v10m"),
    resolution="rea2",
    domain=domain,
    number_of_samples=1,
    sampler_steps=12,
    amp=True,
).to("cuda")
获取 ERA5 数据,以在域上进行低分辨率条件调节和 GHCN 风观测。
# Fetch and regrid ERA5 inputs onto the high resolution regional grid
# Follow the link to the example below for the full implementation
init_time = datetime(2024, 1, 26)
x = fetch_and_regrid_era5(init_time, domain)

# Fetch GHCN hourly 10-m wind observations over the model domain
lat, lon = sda.model.lat_output_numpy, sda.model.lon_output_numpy
bbox = lat.min(), lon.min(), lat.max(), lon.max()
ghcn = GHCNHourly(stations=GHCNHourly.get_stations_bbox(bbox))
obs = ghcn(init_time, ["u10m", "v10m"]).dropna(subset=["observation"])
最后,使用输入数据运行模型。我们执行两次试验,以测量额外观察结果对结果的影响。
prior = sda(x)  # free downscaling, no observations
analysis = sda(x, obs)  # guide the diffusion toward the observations
有关完整的实现,请参阅 Earth2Studio 中的示例,上面的代码就是根据该示例改编的。
如何在 Earth2Studio 中运行 StormCast-SDA
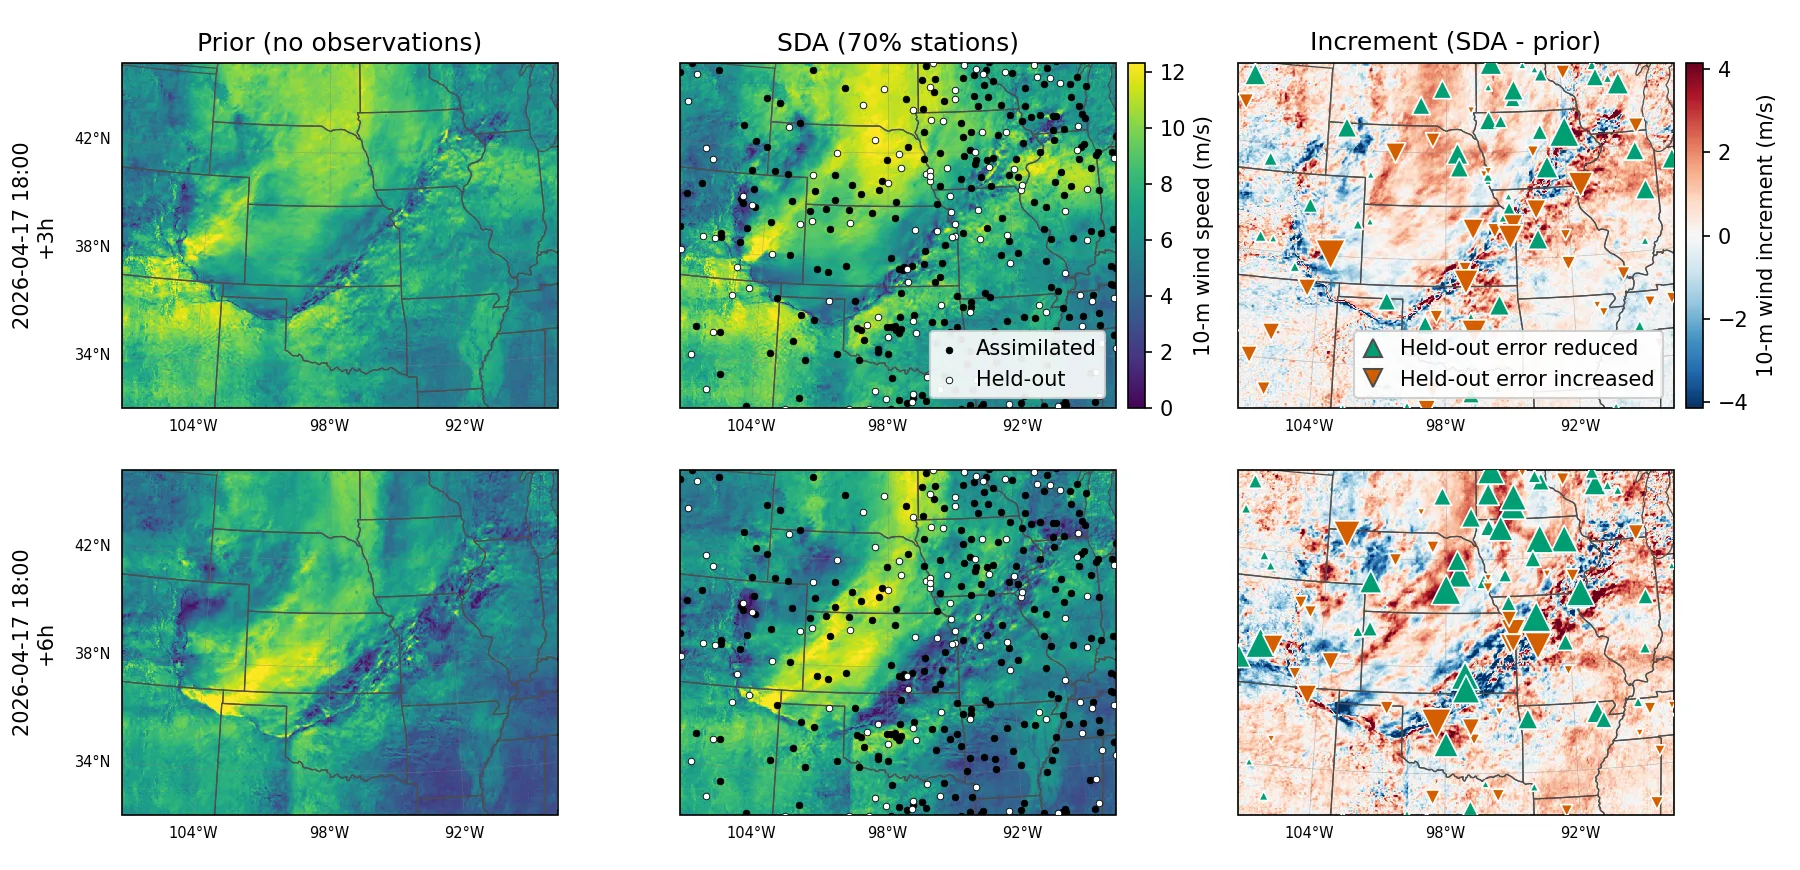
StormCast 技术与 CorrDiff 类似,但专为高分辨率区域预测而设计。Earth2Studio 包含StormCast模型在连续的美国 (CONUS) 上预训练的,该模型使用 HRRR 进行初始化,并以 3 公里的分辨率进行预测。计算和发布新的 HRRR 分析需要一些时间,但您可以使用 SDA 将当前可用的分析与最新观察结果相结合,以更新预测。
首先加载预训练模型。我们将域限制在美国中部。
import numpy as np
from earth2studio.data import GHCNHourly
from earth2studio.models.px import StormCastCONUS

# Limit the domain to the central U.S.
hrrr_lat_lim, hrrr_lon_lim  = (305, 785), (595, 1203)
model = StormCastCONUS.load_model(
    StormCastCONUS.load_default_package(),
    hrrr_lat_lim=hrrr_lat_lim,  # comment out for full CONUS domain
    hrrr_lon_lim=hrrr_lon_lim,  # comment out for full CONUS domain
    num_diffusion_steps=18,
    num_sda_diffusion_steps=96,  # more steps for SDA for better stability
    sda_std_obs=0.15,
    sda_gamma=1e-3,
).to("cuda")
接下来,获取用于模型初始化的 HRRR 分析,并通过模型域定义观察数据源。
# Fetch HRRR initial conditions
# Follow the link to the example below for the full implementation
init_time = datetime(2026, 4, 17, 18)
x, coords = fetch_hrrr(init_time)

# Define GHCN hourly data source for the model domain
lat, lon = model.lat, model.lon
bbox = lat.min(), lon.min(), lat.max(), lon.max()
ghcn = GHCNHourly(
    stations=GHCNHourly.get_stations_bbox(bbox),
    time_tolerance=timedelta(minutes=15),
)
现在,我们可以在初始部署步骤中使用观察结果运行模型,然后在无需额外观察的情况下过渡到预测。与上图 2 中的说明类似,此方法使用观测结果来弥合最新分析与当前状况之间的差距,之后预测将独立进行。
对于使用 HRRR 初始化的工作流,在新分析到来之前,通常只有一个 SDA 信息步骤相关。使用全局分析进行初始化时,多个部署步骤可从 SDA 中受益。
# Initialize generator and get the first output (analysis passthrough)
gen = model.create_generator(x.clone(), coords.copy())
x, coords = next(gen)

# Run the first part of the rollout with SDA
for step in range(nsteps_sda):
    valid_time = np.array(
        [coords["time"][0] + coords["lead_time"][0] + np.timedelta64(1, "h")]
    )
    obs = ghcn(valid_time, ["u10m", "v10m", "t2m"])
    x, coords = gen.send(obs)  # advance one step with observations

# Run the remaining rollout without SDA
for step in range(nsteps_non_sda):
    x, coords = next(gen)  # advance one step without observations
您可以在 Earth2Studio 示例库 中找到该示例的完整实现。
如何将 SDA 与您自己的模型结合使用
您可以通过扩展 Earth2Studio 模型包装器,将观察结果与自定义模型同化。为此,请使用 PhysicsNeMo 中的扩散实用程序。我们从 x0_predictor 开始,这是一个预训练的降噪扩散模型,它将噪声样本及其噪声级别作为输入,并预测无噪点样本。如果没有 SDA,模型的扩散采样将像这样实现:
from physicsnemo.diffusion.noise_schedulers import EDMNoiseScheduler
from physicsnemo.diffusion.samplers import sample

# Construct diffusion scheduler
sigma_min, sigma_max = 0.01, 100
scheduler = EDMNoiseScheduler(sigma_min=sigma_min, sigma_max=sigma_max)

# Get denoiser from scheduler
denoiser = scheduler.get_denoiser(x0_predictor=x0_predictor)

# Generate sample
latents = sigma_max * torch.randn(shape)
sample(denoiser, latents, noise_scheduler=scheduler, num_steps=num_steps)
要使用 SDA,我们需要在 SDA 指导下将 x0_predictor 转换为分数预测模型。我们使用 DataConsistencyDPSGuidance 将每个掩码像素与相应的观察值相关联。您可以使用它来吸收来自气象站、专有传感器或类似点源的观测结果。
from physicsnemo.diffusion.guidance import (
    DataConsistencyDPSGuidance,
    DPSScorePredictor,
)

# Setup SDA guidance
guidance = DataConsistencyDPSGuidance(
    mask=mask,  # binary mask that identifies pixels with observations
    y=y_obs,  # gridded observations
    std_y=sda_std_obs,  # the remaining parameters are SDA settings
    norm=sda_dps_norm,
    gamma=sda_gamma,
    sigma_fn=scheduler.sigma,
    alpha_fn=scheduler.alpha,
)

# Convert x0_predictor to score predictor
score_predictor = DPSScorePredictor(
    x0_predictor=x0_predictor,
    x0_to_score_fn=scheduler.x0_to_score,
    guidances=guidance,
)
denoiser = scheduler.get_denoiser(score_predictor=score_predictor)

# Generate sample (identical to non-SDA example)
latents = sigma_max * torch.randn(shape)
sample(denoiser, latents, noise_scheduler=scheduler, num_steps=num_steps)
如需了解更高级的 SDA 工作流,请使用 ModelConsistencyDPSGuidance 从多个网格点获取模拟观测结果。这种方法需要您提供一个 PyTorch 模型,将每个样本映射到相应的模拟观察结果。借助自定义 PyTorch 模型,您还可以吸收观察到的影响。例如,您可以使用风力发电模型来同化涡轮机输出测量结果。
有关完整的实现,请查看 Earth2Studio 中的 StormCast CONUS 包装器,上面的示例就是基于此。
根据观测结果计算全球天气
大多数全球天气预报管道都是通过数值数据同化获得的当前天气估算进行初始化的。数值数据同化对计算的要求很高,这降低了预测的及时性和刷新率,并使整合自定义观察变得更加困难。
借助基于 AI 的 HealDA 技术,您可以在几秒钟内估计全球大气的状态。这使您能够更接近当前状况发布预测,或计算自定义再分析。
HealDA 将一个时间窗口内的遥感和现场观察映射到全局网格化的大气状态。它由两个主要组件组成:观察编码器和视觉转换器 (ViT) 主干。编码器将异构观测结果提取为激光点云,并将每个标量值与地理位置和时间等元数据一起嵌入到 token 中。然后,这些 token 被聚合到目标网格上,并由 ViT 主干进行处理。
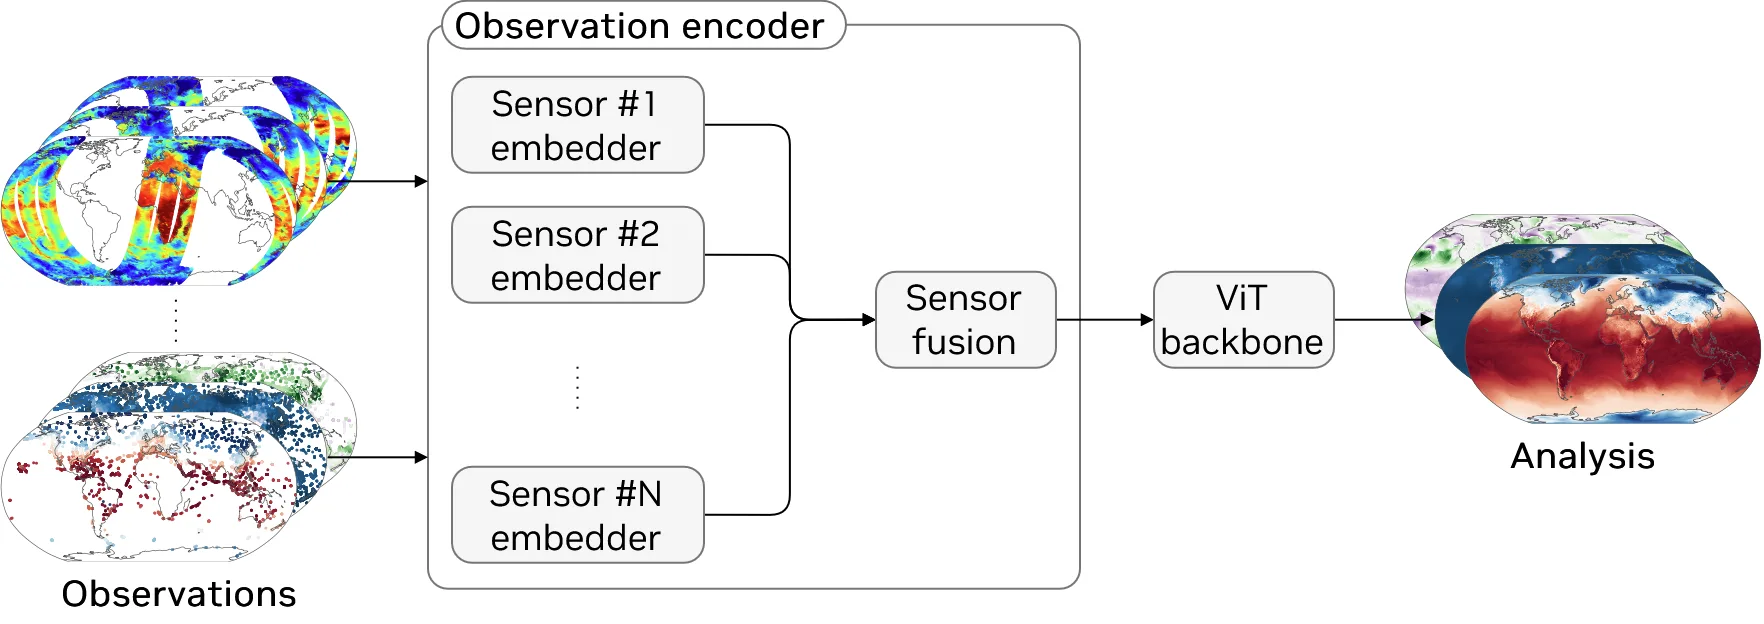
您可以使用预训练的全局数据同化模型作为起点。如果您有自定义常规观察结果,通常无需修改模型即可将其整合在一起。
对于专有卫星数据,您可以调整编码器以支持数据源。这种灵活性可让您根据所在地区或应用程序定制数据同化系统。您可以使用相同的技术来训练区域系统,而不是全局系统。要开始使用,请参阅开源 Python 库 PhysicsNeMo 中的 HealDA 训练管线。
如何在 Earth2Studio 中运行 HealDA
Earth2Studio 提供了一个用于研究目的的预训练全局数据同化模型。它将来自微波探测器、无线电遮蔽、地面站、飞机、浮标和其他来源的数据集成到 1% HEALPix 网格 (HPX64) 上。
首先,加载模型。
from datetime import timedelta

import numpy as np
from earth2studio.data import UFSObsConv, UFSObsSat, fetch_dataframe
from earth2studio.models.da import HealDA

model = HealDA.load_model(
    HealDA.load_default_package(),
    lat_lon=True,  # regrid from HEALPix to regular lat/lon
).to("cuda")
接下来,从 NOAA UFS 回放存储库中获取输入观测结果。我们使用常规和卫星观测。
# HealDA was trained on the UFS replay window: 21h before to 3h after analysis time
time_tolerance = (timedelta(hours=-21), timedelta(hours=3))
analysis_time = np.array([np.datetime64("2024-01-01T00:00")])

# input_coords() returns the schemas the two observation DataFrames must satisfy
conv_schema, sat_schema = model.input_coords()

# fetch_dataframe attaches the request_time metadata the model needs
conv_df = fetch_dataframe(
    UFSObsConv(time_tolerance=time_tolerance),
    time=analysis_time,
    variable=np.array(conv_schema["variable"]),
    fields=np.array(list(conv_schema.keys())),
)
sat_df = fetch_dataframe(
    UFSObsSat(time_tolerance=time_tolerance),
    time=analysis_time,
    variable=np.array(sat_schema["variable"]),
    fields=np.array(list(sat_schema.keys())),
)
然后使用观察数据帧调用模型。
# stateless model - call it directly for a one-shot analysis, or use
# create_generator for cycled assimilation
analysis = model(conv_obs=conv_df, sat_obs=sat_df)
您可以在 Earth2Studio 示例库中找到运行 HealDA 的扩展示例。
使用 Earth2Studio 访问观测数据
Earth2Studio 可让您访问用于开发、初始化和验证天气模型的各种数据源,包括来自不同平台和传感器类型的观测结果。
其中包括来自地球同步卫星 ( GOES、Himawari、Meteosat) 和雷达网络 ( MRMS、OPERA) 的网格数据,您可以直接使用这些数据来训练和快速更新 StormScope 等区域高分辨率预测模型。当您想要预测依赖日光照射或降水的数量 (例如太阳能发电、冷却过程和油藏流入) 时,这些来源尤其有用。
为了开发数据同化系统并对其进行基准测试,Earth2Studio 还允许您访问 GHCN/ ISD、NNJA 和 UFS 等传统观测结果的存档,以及 GDAS 和 ASOS 的操作观测结果。这些来源提供温度和风速等变量作为数据帧。此外,还提供了 MetOp 和 JPSS 等极轨道卫星系统的观测结果。
Earth2Studio 提供跨所有数据源的统一接口。您可以将数据源对象实例化,并使用时间步长和变量名列表调用该对象。预测数据源也接受提前时间列表。通过这种一致的界面,您可以轻松地在同一工作流中组合多个数据源,或将自己的观察结果连接到工作流。
era5 = NCAR_ERA5()
da_era5 = era5(datetime(2025, 7, 15), ["t2m", "z500"])
print(da_era5.shape)  # (1, 2, 721, 1440)

ifs = IFS_FX()
da_ifs = ifs(datetime(2026, 7, 15), timedelta(hours=48), ["t2m"])
print(da_ifs.shape)  # (1, 1, 1, 721, 1440)

goes = GOES(satellite="goes19", scan_mode="C")
da_goes = goes(datetime(2026, 7, 15), ["abi01c", "abi02c", "abi03c"])
print(da_goes.shape)  # (1, 3, 1500, 2500)

ghcn = GHCNHourly(stations=["USW00013301"])
df_ghcn = ghcn(datetime(2026, 6, 15), ["t2m", "ws10m"])
print(df_ghcn.shape)  # (10, 7)
有关受支持数据源的完整列表,请参阅用户指南中的API 参考资料。
开始使用 Earth2Studio
在 Earth2Studio 示例库中探索端到端 AI 数据同化示例。要将您自己的观测结果连接到管道,请遵循 自定义数据源示例。
AI 数据同化可让您整合对您所在地区或组织至关重要的观察结果,从而发布更准确、更及时的预报。
访问Earth2Studio 用户指南,开始使用 AI 数据同化,并探索 AI 天气模型的更广泛功能。


