

NVIDIA CUDA Tile (cuTile) 是一种基于 Python 的 DSL 和并行编程模型,适用于 NVIDIA GPU,可自动利用高级硬件功能为平铺级 GPU 编程提供峰值性能。通过将线程级和线程束级调度抽象化为以图块为中心的高级基元,cuTile 可让您使用 Python 编写 GPU 核函数,而编译器优化可自动针对 Tensor Core 等高级硬件功能。
作为 Jane Street 的 cuTile 的早期采用者,机器学习工程师在 cuTile 中实施了先进的序列模型 Mamba-2,并与 NVIDIA 合作优化了内核。Jane Street 是一家技术含量极高的全球交易公司,利用深度学习推动先进量化研究的创新。本文将向您介绍为 Mamba-2 前向传递提供支持的三个自定义内核及其背后的 cuTile 优化。
概述和预备知识
要使用 cuTile,请确保您的环境符合 cuTile Python 快速入门指南 中概述的要求。将软件包导入为 cuda.tile,并在本文介绍的内核实现中将其公开为 ct。
序列建模计算权衡
序列建模架构需要进行计算权衡:传统的 softmax 注意力训练使用由 Tensor Core 加速的矩阵乘法来快速训练,但在推理时,计算和内存需求会随着序列长度呈线性增长。相比之下,递归神经网络 (RNN) 训练缓慢且不可并行,但无论序列长度如何,都需要恒定的计算和固定的内存占用。
Mamba-2 架构
Mamba-2 架构由一系列旨在实现两全其美的模型组成。与 RNN 类似,它具有固定大小的隐藏状态和循环更新,可以使用 Tensor Core 以计算效率较高的方式进行块级计算。
Mamba-2 的核心递归是:
\(h_t = \exp(A \cdot dt_t) h_{t-1} + dt_t B_t x_t\)
其中:
- \(x_t\)、\(dt_t\)、\(B_t\) 和 \(c_t\) 是 Mamba-2 层的输入 (通过将输入投射到代码块获得,例如注意力层中的查询、键和值) ,其位置为token \(t\)
- \(y_t\) 是token \(t\) 的输出
- \(h_t\) 是跨token传输的固定大小的隐藏状态。它不是 RNN 中的向量,而是矩阵 (更多的数字和更多的表示容量)
- \(A\) 和 \(D\) 是学习模型参数
直观地说:
- \(dt_t\) (每个头一个标量) 表示应更新的状态数量。\(dt\) 中的所有值均为负值由于之前的状态乘以 \(\exp(Adt_t)\),因此在 \(dt_t = 0\) 时,状态保持不变
- \(x_t\) (大小为 H 的向量) 的作用与注意力值相似
- \(B_t\) (大小为 S 的向量) 的作用与注意力键类似
- \(c_t\) (大小为 S 的向量) 表示如何混合状态以产生输出,其作用与注意力查询类似
状态 \(h_t\) 是大小为 S,H 的矩阵 ( \(B_t x_t^\top\) 是外积) 。为使计算更易于编写,请使用 \(a_t = Adt_t\) 并将 \(b_t\) 称为产品 \(dt_t B_t\)。方程如下:
\(h_t = \exp(a_t)h_{t-1} + b_t x_t^{\mathsf{T}}, y_t = c_t^{\mathsf{T}}h_{t-1} + Dx_t\)
这种递归表述是进行顺序推理的理想选择。但是,训练和预填充需要比 for 循环更快的速度。虽然线性状态更新允许并行扫描算法,但这种方法需要实现巨大的隐藏状态张量,使其主要受内存限制,无法利用 Tensor Core。
另一种方法是利用 Tensor Core,通过矩阵乘法直接计算任何未来的隐藏状态。忽略 \(\exp(a_t)\) 术语进行简化,从 \(h_t\) 到 \(h_{t+T}\) 只是:
\(h_{t+T} = h_t + b_{t+1}x_{t+1}^{\mathsf{T}} + b_{t+2}x_{t+2}^{\mathsf{T}} + \cdots + b_{t+T}x_{t+T}^{\mathsf{T}}\)
如果通过堆叠所有 \(b_{t+i}\) 和矩阵 \(X\) (T, H) 并堆叠所有 \(x_{t+i}\) 来构建一个形状为 (T, S) 的矩阵 \(B\),那么这只是 \(h_{t+T} = h_t + BX^T\):
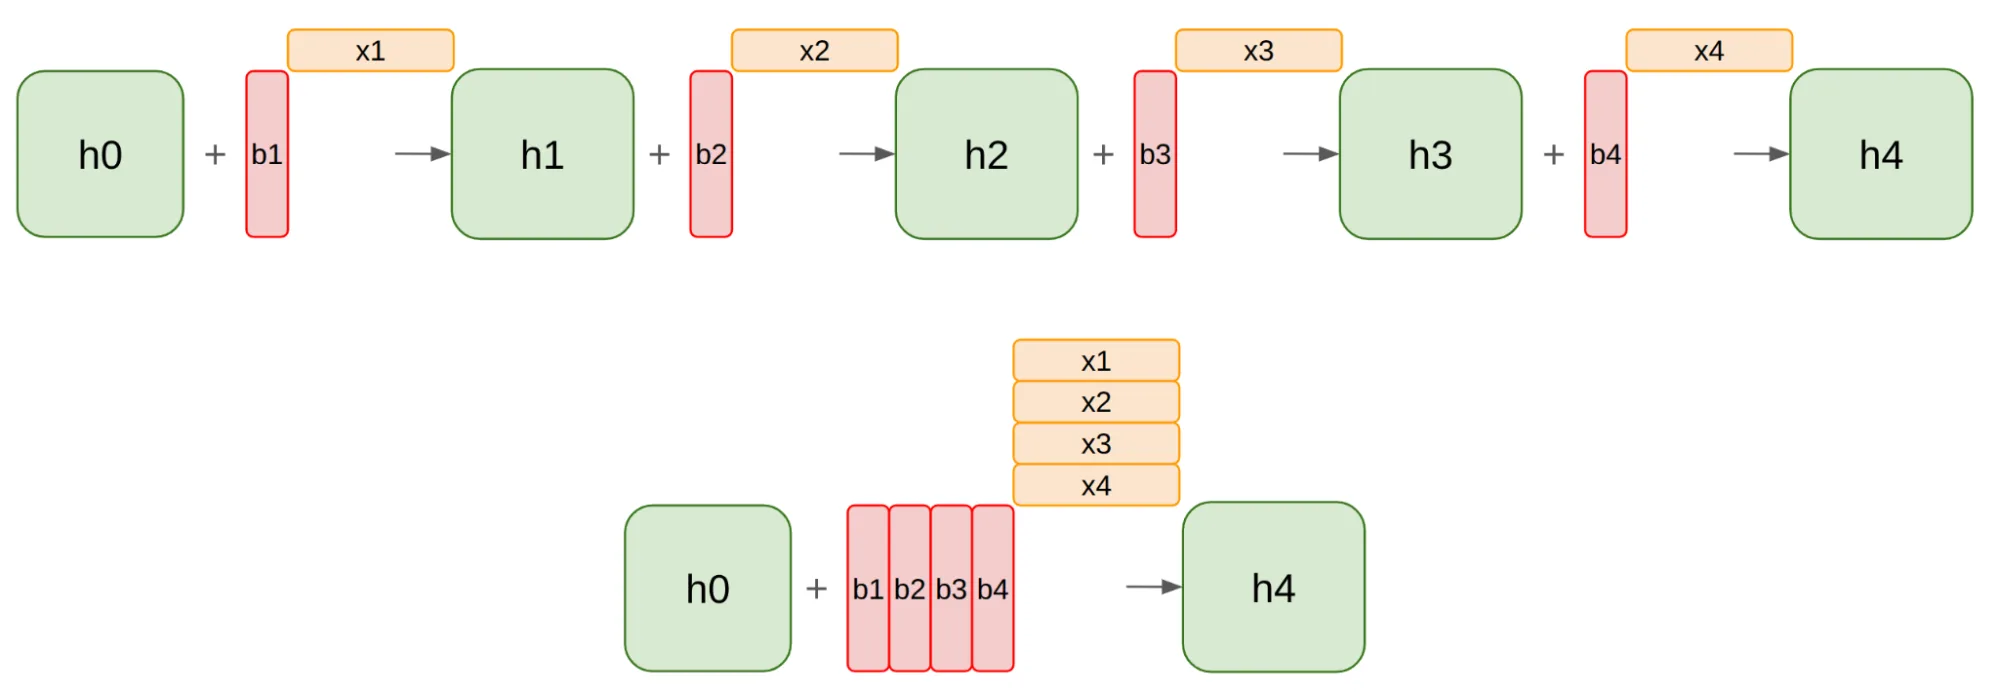
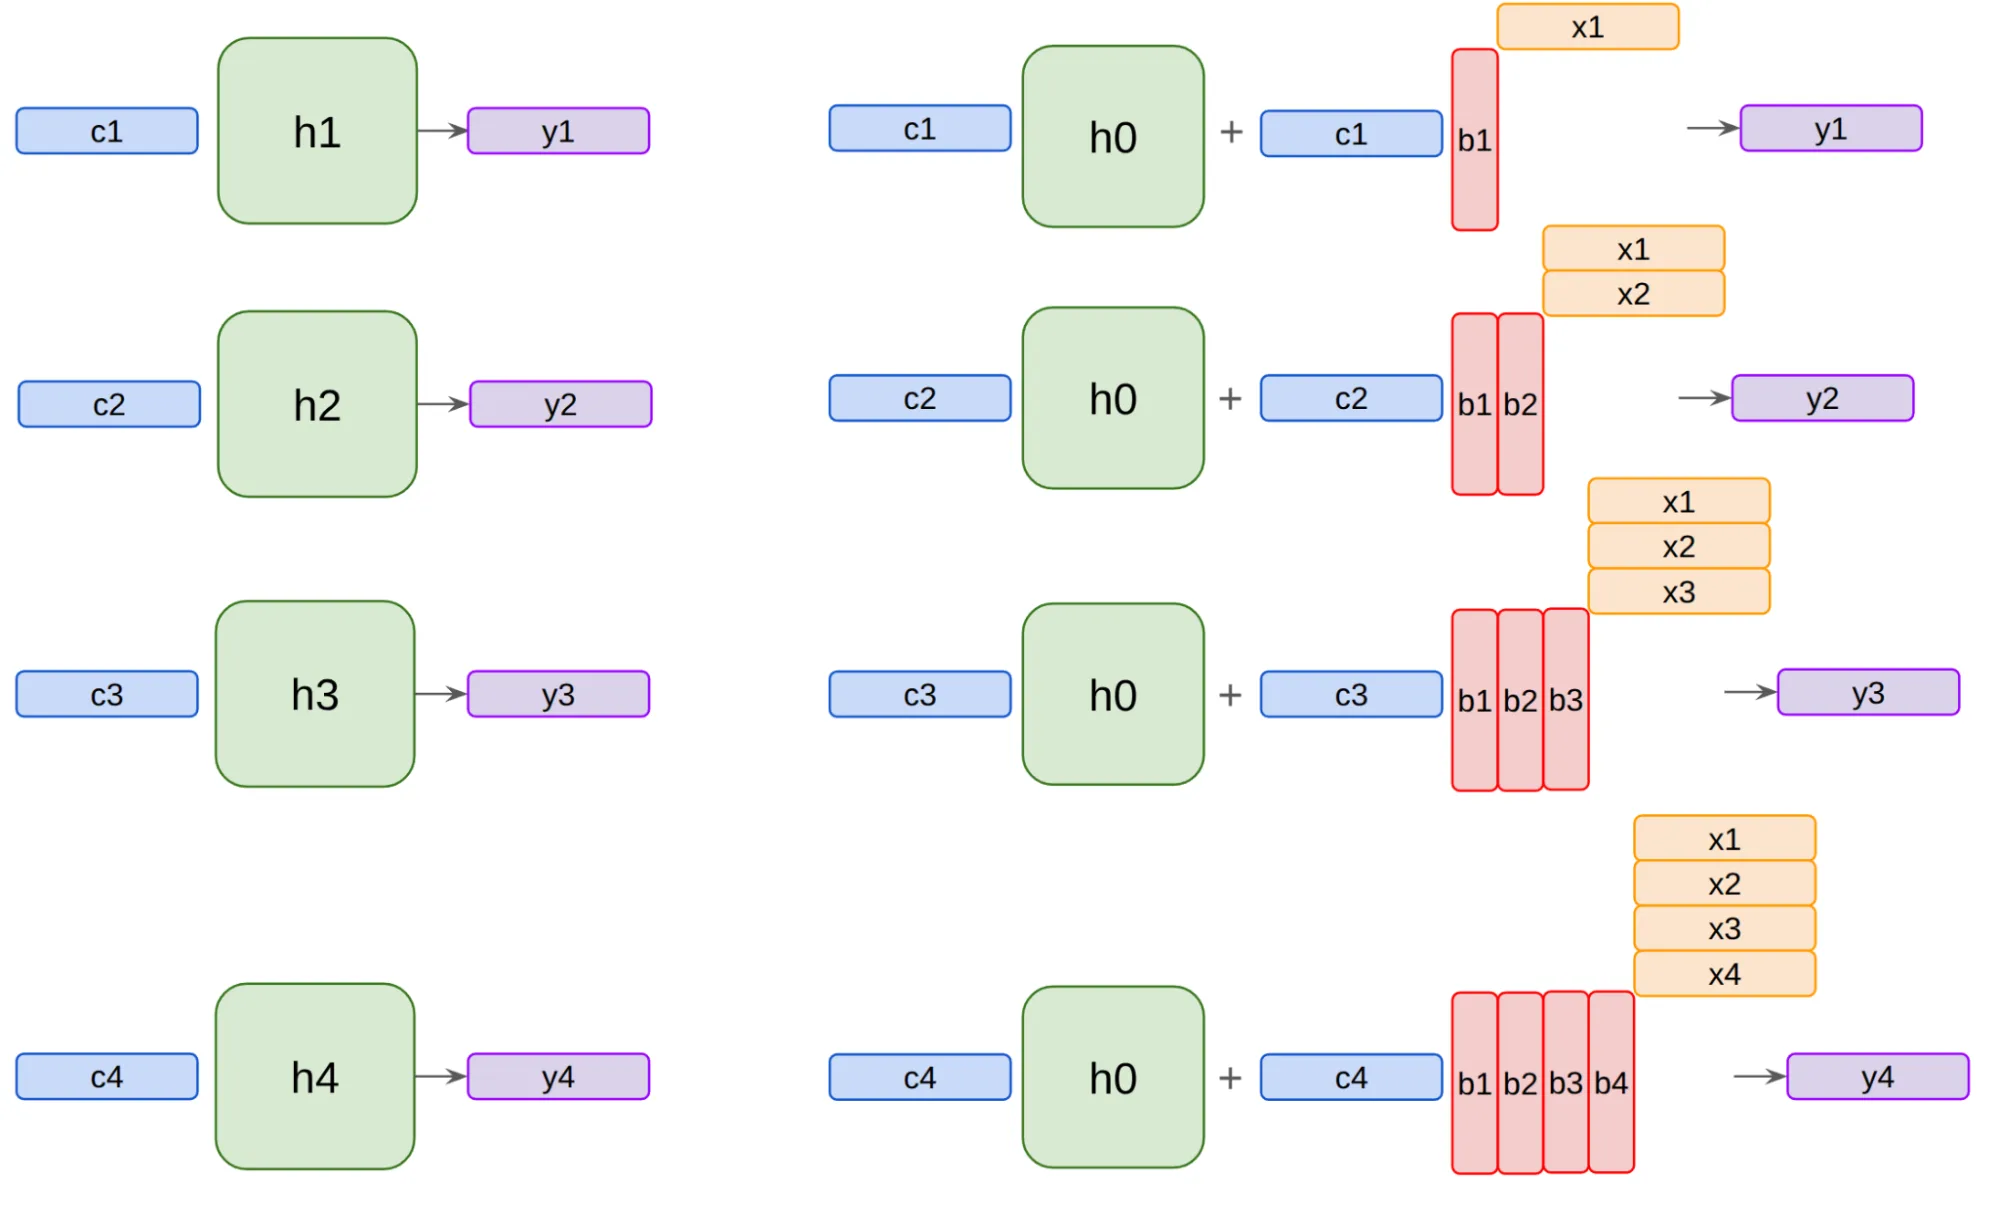
借助此跳跃公式,您可以高效地计算序列中各个块“检查点”的隐藏状态。下一步是找到一种方法来计算输出 \(y_1\)、\(y_2\)、\(y_3\)、\(y_4\) (仅适用于 \(h_0\)) 。如果计算 \(h_1\)、\(h_2\)、\(h_3\)、\(h_4\) …,这很容易,但这样做会破坏跳跃公式的意义。
目前,我们仍然删除了衰减项 \(\exp(a_t)\),目标是计算:
\(y_{t+i} = c_{t+i}^{\mathsf{T}}h_{t+i} + Dx_{t+i} = c_{t+i}^{\mathsf{T}}\left(h_t + b_{t+1}x_{t+1}^{\mathsf{T}} + \cdots + b_{t+i}x_{t+i}^{\mathsf{T}} \right) + Dx_{t+i}\)
其中,之前的公式用于扩展隐藏状态。跳过连接项 \(Dx_{t+i}\) 很容易推理。对于其他系统,如下所示:
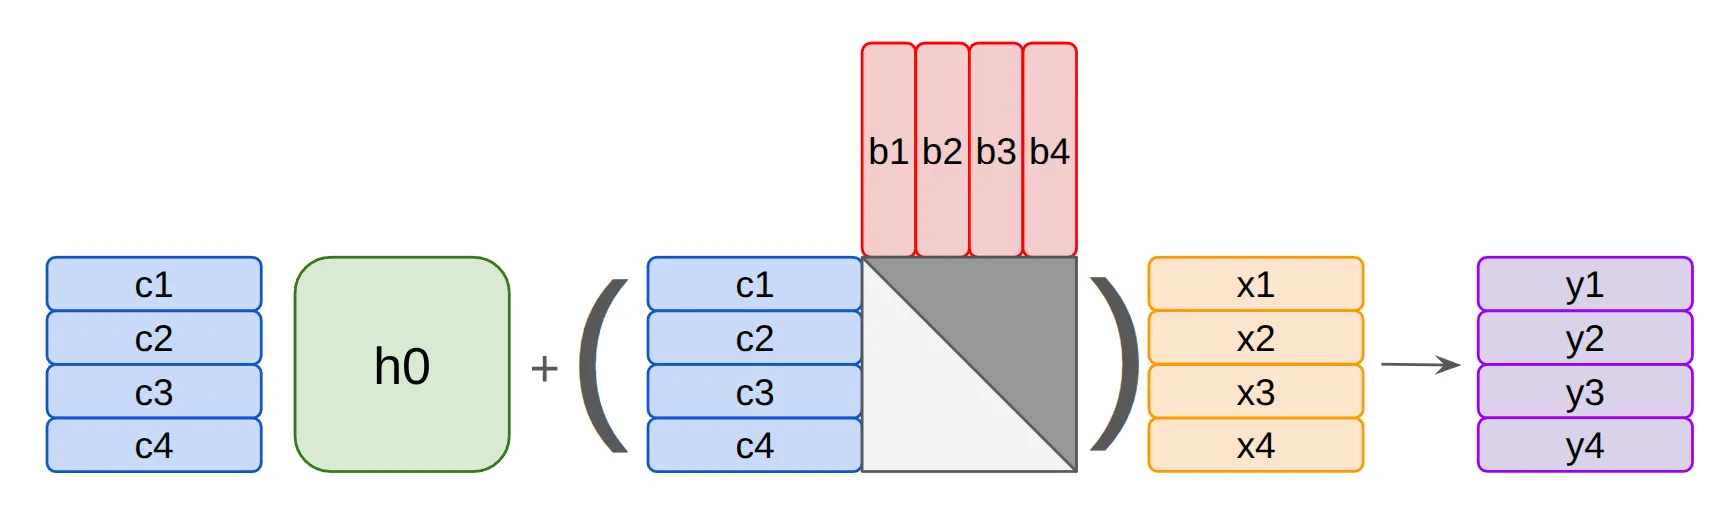
同样,将 \(x_t\)、\(b_t\)、\(c_t\) 和 \(y_t\) 组成的块分组到矩阵中,可以使用 Tensor Core 友好型矩阵乘积 (图 3) 重新表达这一点,其中 \(\mathit{C}\) by \(\mathit{B}\) 乘积中的三角形是因果掩码 (如因果 softmax 注意力) 。
在计算输出 \(y_{t+i}\) 时,\(b_j\) 和 \(j \leq t + i\) 的乘积为 \(c_{t+i}\),因此在计算完整矩阵乘积时,您需要在未来 (对角线上方) 遮罩掉这些乘积。在数学运算中,这将变成 (加回跳转连接) :
\(Y = Ch_t + \left((CB^{\mathsf{T}})\cdot M\right)X + DX\)
使用 \(M\) 时,传统的因果掩码。
请注意,这看起来与注意力非常相似 (未使用 softmax) ,因为当删除衰减项时,Mamba-2 只是线性注意力 (需要进行一些重命名) 。再加上衰减,事情就会变得有点棘手。循环的扩展如下所示:
\(h_(t+T)=exp(a_(t+1)+a_(t+2)+⋯+a_(t+T) ) h_t+exp(a_(t+2)+⋯+a_(t+T) ) b_(t+1) x_(t+1)+exp(a_(t+3)+⋯+a_(t+T) ) b_(t+2) x_(t+2)+⋯+b_(t+T) x_(t+T)\)
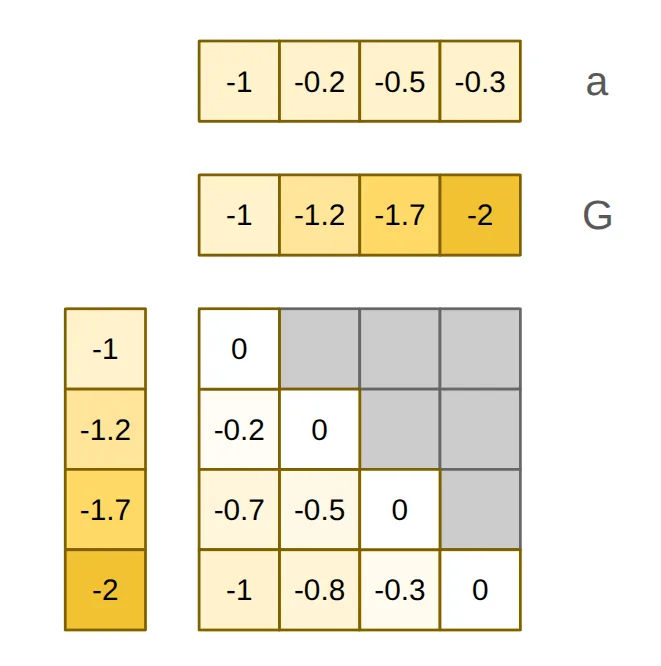
在对数空间中重新公式化允许将顺序乘法替换为累积求和。如果 \(B\) (或 \(X\)) 的行预乘以指数,则这仍然是矩阵运算。通过追踪张量 \(G\) 中 \(a_t\) 的累积和,这将生成以下新方程:
\(h_{t+T} = \exp(G_{last})h_t + \left(\exp(G_{last} – G)\cdot B\right)X^{\mathsf{T}}\)
将新的隐藏状态插入输出计算结果,如下所示:
\(Y = \exp(G)Ch_{kT} + \left(\exp(G – G^{\mathsf{T}})\cdot (CB^{\mathsf{T}})\cdot M\right)X + DX\)
其中,矩阵 \(\exp(G – G^{\mathsf{T}})\) 在 \((i, j)\) 处包含术语 \(\exp(g_i – g_j)\)。请注意,所有 \(i < j\) 将被因果掩码遮罩的项,因此只保留其中 \(g_t\) 是 \(a_t\) 比 \(g_j\) 更多的项的总和的项。根据构造,所有 \(a_t\) 值均为负值,这使得 \(g_i – g_j\) 为负值。永远不会保留任何正数的指数,从而保证数值稳定性。
这将转化为三个内核:
chunk_cumsum:计算每个数据块内 \(a_t\) 的累积和。fwd_pass_state:使用上述跳转公式计算每个数据块开头的隐藏状态。compute_out:使用上一步中计算的数据块的初始隐藏状态来计算每个数据块的输出。
内核 1:计算累积和
第 2 步和第 3 步均需计算 \(a_t = Adt_t\) (之前数学运算中的 \(G\)) 的累加和。为避免多次重新计算,此首个内核将计算一次 \(a_t\) 并将其存储。请注意,这不是全局累加总和,只是每个数据块内的累加总和。
此内核的输入是逐头标量衰减 a 和逐token时间步 dt。头 h 在token t 处的有效衰减是 a[h] * dt[t, h],内核会沿块维度累积该积。这些累加总和都在对数空间中,并且始终采用其指数 (或其某种线性组合) 。由于计算 exp2 (而非 exp) 的成本要低得多,因此结果按 log2(e) 进行了扩展。
此内核引入了所有三个内核都使用的 cuTile 基元:ct.bid, ct.load/ ct.store 和 ct.cumsum。
完整内核较短:
@ct.kernel
def chunk_cumsum_kernel(
    a: torch.Tensor,        # [num_heads]
    dt: torch.Tensor,       # [batch_size, num_tokens, num_heads]
    output: torch.Tensor,   # [batch_size, num_tokens, num_heads]
    chunk_size: ct.Constant[int],
    BLOCK_H: ct.Constant[int],
) -> None:
    chunk_idx, head_tile_idx, batch = ct.bid(0), ct.bid(1), ct.bid(2)
    dt_tile = ct.load(dt, index=(batch, chunk_idx, head_tile_idx),
                          shape=(1, chunk_size, BLOCK_H),
                          padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)
    a_tile = ct.load(a, index=(head_tile_idx,),
                        shape=(BLOCK_H,),
                        padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)

    d_tile = ct.cumsum(a_tile * dt_tile, axis=1) * LOG2E
    ct.store(output, index=(batch, chunk_idx, head_tile_idx), tile=d_tile.astype(output.dtype))
核函数使用 (num_chunks, num_head_tiles, batch_size) 网格启动,第一行使用 ct.bid 确定您在网格中的位置。a_tile (形状为 [BLOCK_H]) 和 dt_tile (形状为 [1, chunk_size, BLOCK_H]) 的广播乘积给出了图块上有效的每 token、每头衰减。然后,ct.cumsum(..., axis=1) 会沿块内标记维度进行扫描,结果将存储在 fwd_pass_state 和 compute_out 期望的布局中。
内核 2:fwd_pass_state
fwd_pass_state 计算每个数据块的初始隐藏状态以及最后一个数据块之后的最终隐藏状态。它不直接计算输出。相反,它会准备承载状态,即 compute_out 稍后会投射到输出中。核函数的核心是之前所述的对数据块的顺序循环。每次核函数启动都会加载一个 (batch, head, head_tile, state_tile) 隐藏状态切片,如下所示。在该切片中,hid_tile 的形状为 [BLOCK_HEAD, BLOCK_STATE],并将包含每个数据块的初始隐藏状态图块。
head_tile_idx, state_tile_idx, batch_head = ct.bid(0), ct.bid(1), ct.bid(2)
batch = batch_head // x.shape[2]
head = batch_head % x.shape[2]
group = head // num_heads_per_group

hid_tile = ct.load(
    init_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    shape=(1, 1, BLOCK_HEAD, BLOCK_STATE),
).reshape((BLOCK_HEAD, BLOCK_STATE))
在循环的每次迭代中,首先存储隐藏状态:
num_chunks = ct.cdiv(b.shape[1], chunk_size)
for chunk_idx in range(num_chunks):
    ct.store(
        hiddens,
        index=(batch, head, chunk_idx, head_tile_idx, state_tile_idx),
        tile=hid_tile.reshape((1, 1, 1, BLOCK_HEAD, BLOCK_STATE)).astype(hiddens.dtype),
    )
循环的其余部分会加载一个 x、b、dt 和 decay_cumsum 数据块,以计算下一个数据块的初始隐藏状态。如前文所示,数学运算为:
\(h_{t+T} = \exp(G_{last})h_t + \left(\exp(G_{last} – G)\cdot B\right)X^{\mathsf{T}}\)
ct.extract 支持从加载的衰减图块中提取最后一个token (以计算 \(G_last\)) 。如前所述,出于性能考虑,请使用 exp2 而非 exp。ct.mma 是一个 API,可在利用 Tensor Core 的同时执行矩阵乘法运算。
 x_tile = ct.load(
        x, index=(batch, chunk_idx, head, head_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_HEAD),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_HEAD))
    b_tile = ct.load(
        b, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    dt_tile = ct.load(
        dt, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_tile = ct.load(
        decay_cumsum, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_last = ct.extract(d_tile, index=(chunk_size - 1,), shape=(1,))

    b_dt_d = b_tile * (dt_tile * ct.exp2(d_last - d_tile))[:, None]
    hid_tile = ct.exp2(d_last) * hid_tile
    hid_tile = ct.mma(x_tile.transpose(), b_dt_d.astype(b.dtype), hid_tile)
在最后一个数据块之后,hid_tile 包含存储的最终隐藏状态。在推理期间,此值可作为下一次调用的 init_state 反馈回来;在训练期间,此值通常会被丢弃。
ct.store(
    final_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    tile=hid_tile.reshape((1, 1, BLOCK_HEAD, BLOCK_STATE)),
)
顺序依赖项位于单个网格点 (程序实例) 内,而独立的 (batch, head, head_tile, state_tile) 切片则在网格中并行运行。
内核 3:compute_out
compute_out 是前向传递中的最后一个内核。它采用 fwd_pass_state 生成的每块初始隐藏状态,并计算token输出,实现之前推导出的输出方程:
\(Y = \exp(G)Ch_{kT} + \left(\exp(G – G^{\mathsf{T}})\cdot (CB^{\mathsf{T}})\cdot M\right)X + DX\)
直接的 PyTorch 实现将分别计算这三个项,并在全局内存中实现完整的 [B, n_chunks, chunk_size, chunk_size] 交互矩阵 C @ B.T。compute_out 将它们融合到一个平铺式内核中,并将该矩阵保留在寄存器中。
每个核函数启动都有一个 (batch, chunk, head, head_tile) 输出图块,并分两个阶段工作。第 1 阶段循环运行状态图块,使用 ct.mma 构建交互矩阵 cb_tile = C @ B.T,并同时累加带载状态项 C @ H.T。
chunk_idx, head_tile_idx, batch_head = ct.bid(0), ct.bid(1), ct.bid(2)
batch = batch_head // x.shape[2]
head  = batch_head %  x.shape[2]
group = head // num_heads_per_group

cb_tile  = ct.full((chunk_size, chunk_size), 0.0, dtype=ct.float32)
out_tile = ct.full((chunk_size, BLOCK_HEAD),  0.0, dtype=ct.float32)

# Phase 1: build CB = C @ B.T and accumulate the carried-state output
for state_tile_idx in range(state_size // BLOCK_STATE):
    b_tile = ct.load(
        b, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE), padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    c_tile = ct.load(
        c, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE), padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    h_tile = ct.load(
        hiddens, index=(batch, head, chunk_idx, head_tile_idx, state_tile_idx),
        shape=(1, 1, 1, BLOCK_HEAD, BLOCK_STATE),
    ).reshape((BLOCK_HEAD, BLOCK_STATE))

    cb_tile  = ct.mma(c_tile, b_tile.transpose(), cb_tile)
    out_tile = ct.mma(c_tile, h_tile.transpose().astype(c_tile.dtype), out_tile)
第 2 阶段将衰减和因果掩码应用于 cb_tile ( ct.arange 和 ct.where 构建下三角形掩码 M,因此未实现任何掩码张量) ,然后添加所有项以获取最终输出图块。这两个累加器都以 ct.full 寄存器图块开头,最后一个 ct.mma 转换为 ct.tfloat32,以接近 FP32 的精度通过 Tensor Core 运行。
# Phase 2: decay + causal mask then final computation
d_tile  = ct.load(decay_cumsum, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
dt_tile = ct.load(dt, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
x_tile  = ct.load(x, index=(batch, chunk_idx, head, head_tile_idx),
                  shape=(1, chunk_size, 1, BLOCK_HEAD), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size, BLOCK_HEAD))
d_val   = ct.load(d, index=(head,), shape=(1,))

cb_tile  = cb_tile * ct.exp2(d_tile[:, None] - d_tile[None, :])  # pairwise decay
idx      = ct.arange(chunk_size, dtype=ct.int32)
cb_tile  = ct.where(idx[:, None] >= idx[None, :], cb_tile, 0.0)  # causal mask
out_tile = out_tile * ct.exp2(d_tile[:, None])                   # decay carried state

dt_x     = dt_tile[:, None] * x_tile
out_tile = ct.mma(cb_tile.astype(ct.tfloat32), dt_x.astype(ct.tfloat32), out_tile)
out_tile = out_tile + d_val * x_tile                            # D * x skip
ct.store(out, index=(batch, chunk_idx, head, head_tile_idx),
         tile=out_tile.reshape((1, chunk_size, 1, BLOCK_HEAD)).astype(out.dtype))
如前所述,虽然在 ct.exp2(d_tile[:, None] - d_tile[None, :]) 行中计算了一些不稳定的数值指数 (其中一些是正数) ,但请立即将其隐藏起来,以免潜在的溢出影响计算。
Mamba-2 性能优化
通过在 cuTile-Python DSL 中定义 Mamba-2 工作负载,引入了几个关键性能优化:
- 延迟提示:cuTile 允许您使用延迟提示标记
ct.load和ct.store操作,以对 DRAM 流量进行建模。编译器利用这些提示来优化指令调度和工作流缓冲区深度。 - 交换 A/B:在 NVIDIA Blackwell 第五代 Tensor Core 上,MMA 操作数是不对称的:操作数 A 可以存在于张量内存中,但操作数 B 必须存在于共享内存中。对于
fwd_pass_state中的 SIMT-op+ Dot-op 等 input-fusion 模式,身份 \(B^{\mathsf{T}}A^{\mathsf{T}} = (AB)^{\mathsf{T}}\) 用于将融合操作数 (b_dt_d) 路由到操作数 A,从而缓解共享内存争用。 - GMEM 布局:
decay_cumsum和dt的默认跨度内存访问降低到对缓存不友好的 LDG 指令。转置到[batch, head, token]布局可确保连续访问,从而实现 TMA 的使用。 - cuTile-Python 自动调整器:由于性能瓶颈会随着输入形状的变化而改变,因此没有一种优化策略适合每种模型配置。这些优化与 cuTile 参数 (
block_size,occupation) 一起集成到一个统一的搜索空间中,并利用 cuTileexhaustive_search自动为每个输入形状找到最佳设置。
Mamba-2 前向传播性能基准测试
此 Mamba-2 前向传递核函数的实现可通过 TileGym 获得。完整示例如下所示。
import torch
import tilegym
from tests import common
from tests.ops.test_mamba2 import Mamba2ProblemSpec

tilegym.set_backend("cutile")
num_tokens, state_size = 16384, 128

torch.manual_seed(0)
spec = Mamba2ProblemSpec(batch_size=4, num_tokens=num_tokens, num_groups=1,
num_heads=8, state_size=state_size, head_size=64,
chunk_size=128, dtype=torch.bfloat16, state_dtype=torch.float32)
fwd_inputs = spec.get_sample_inputs(with_reference=False, with_backward=False)
fwd = common.benchmark(
    lambda: tilegym.ops.mamba2_chunk_forward(**fwd_inputs),
    use_cupti=True,
)
print(f"Forward: {fwd['forward']['median'] * 1000:.2f} us")
已实施的 Mamba-2 前向传递的性能在以下软硬件配置下,根据使用 Triton 编写的 Mamba-2 内核的开源实现进行评估:
软件
- mamba_ssm 2.3.2.post1 ( NVIDIA Dynamo-Triton 参考) 、Triton 3.7.1
- cuTile:
cuda-tile1.5.0 - TileIR 合成器 (
tileiras) 13.4 - PyTorch 2.13.0,CUDA 13.3 (驱动和运行时 API,NVCC V13.3.33) ,驱动 595.58.03
- cuda-python/ cuda-bindings 13.3.1
- Python 3.12.3、Ubuntu 24.04.4 LTS、内核 6.8.0-107
硬件
- 单个 NVIDIA B300 SXM6,计算能力 10.3 (NVIDIA Blackwell Ultra)
- 1920 MHz 最大 SM 时钟,1100 W 功率限制,268 GiB HBM
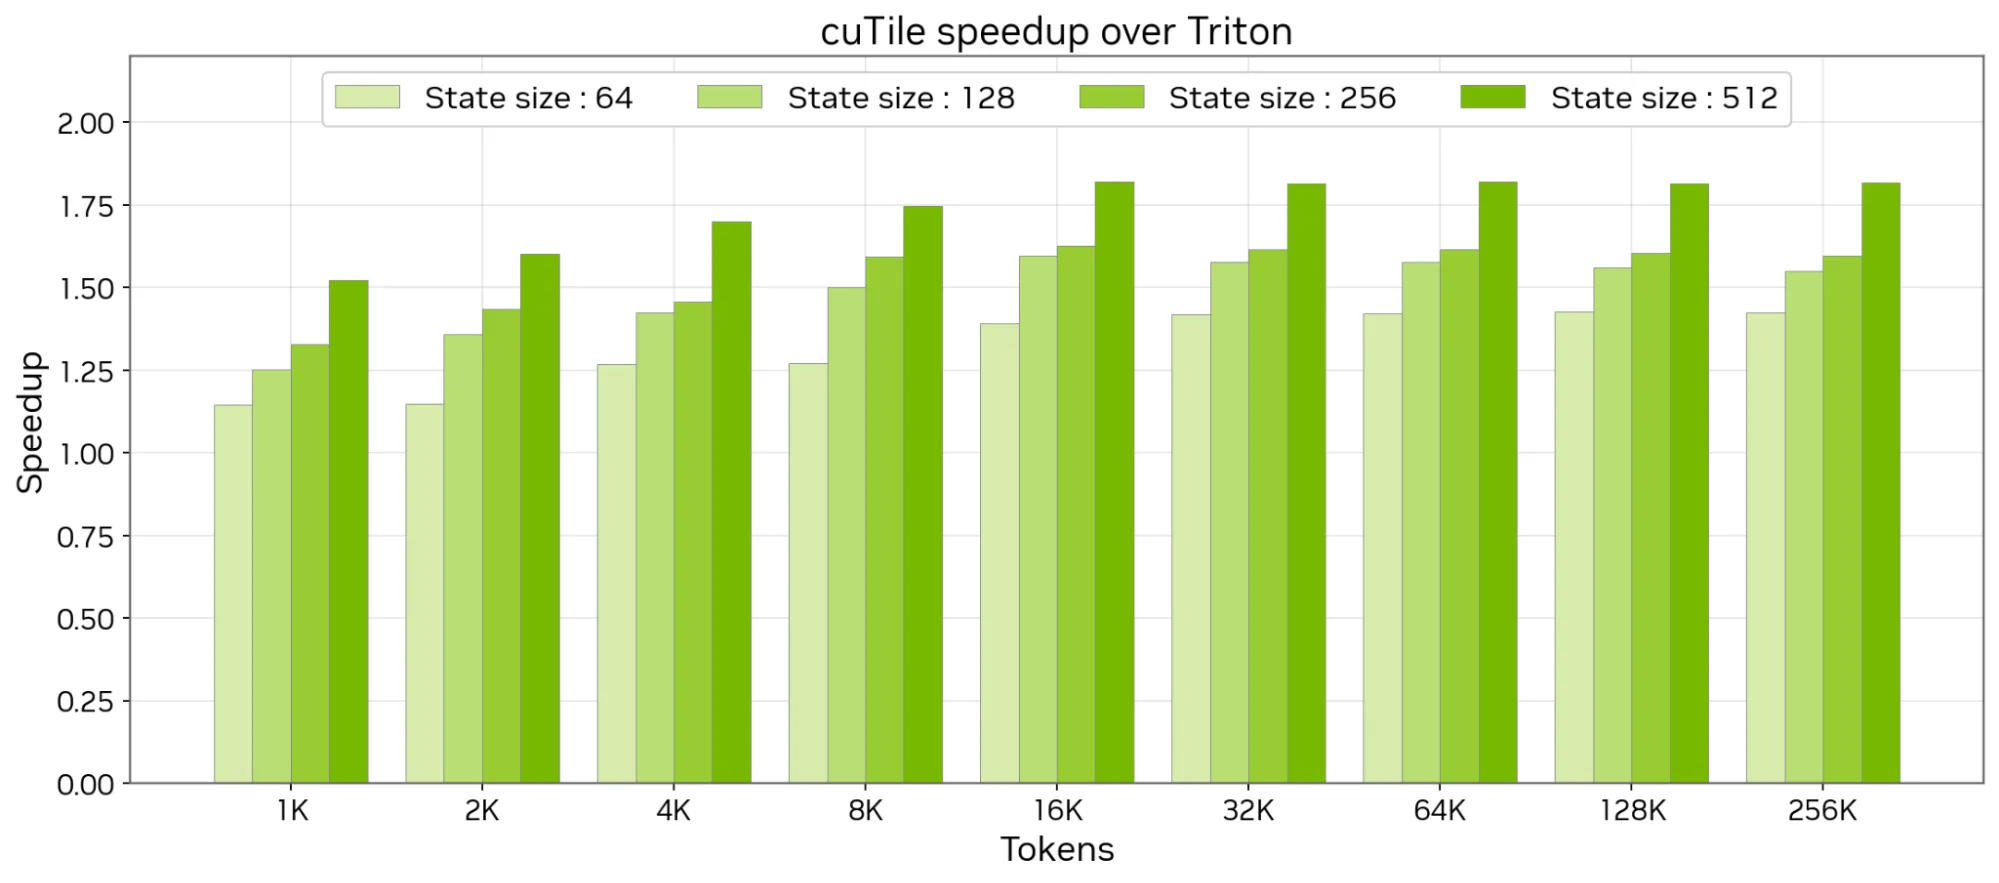
结果表明,经过优化的 cuTile 前向传递内核的速度提高了 1.14 倍到 1.82 倍,并且速度会随着序列长度和状态大小的增加而增长。请注意,这些只是内核级加速,端到端训练结果也取决于反向传递实现。
开始使用 cuTile
借助 cuTile,您可以在 Python 中编写清晰、可读且高性能的内核。请持续关注后续文章,了解如何在 cuTile 中实现反向传递。
开始使用 cuTile 并探索 文档、GitHub 资源库 和 示例代码。


